一文搞懂Agent记忆层原理,大模型入门到精通,收藏这篇就足够了!

AI Agent的记忆系统实现:从短期对话到长期知识 一个好的记忆系统是 AI Agent 智能行为的基础。它不仅要能存储和检索信息,还要像人类大脑一样,能够区分信息的重要性,合理管理记忆的生命周期。在下一篇文章中,我会讲解如何实现 AI Agent 的工具调用系统。如果你对记忆系统的实现有什么想法,欢迎在评论区交流。 阅读详情

一、为何 Agent 需要记忆

当前大语言模型(LLM)本身无状态,受 Transformer 上下文窗口限制,存在短期遗忘(对话超出窗口长度会丢失初始信息,影响连贯性)、无法长期学习(不能从与特定用户交互中积累偏好等信息,每次对话如与陌生人开始)、缺乏个性化(难以形成独特个性和建立长期用户关系,服务较通用)等问题。为打破 “金鱼困境”,实现持续学习、演化和提供个性化体验,记忆机制至关重要。

二、记忆系统构成

(一)短期记忆(STM)

  1. 核心功能:短期记忆如同 Agent 的 “工作台”,在执行当前任务或单次对话时,存储即时对话历史、当前任务状态、中间推理步骤等信息,保障短期交互的连贯性与上下文感知能力。
  2. 挑战:主要挑战在于如何有效管理有限的 LLM 上下文窗口。
  3. 实现路径
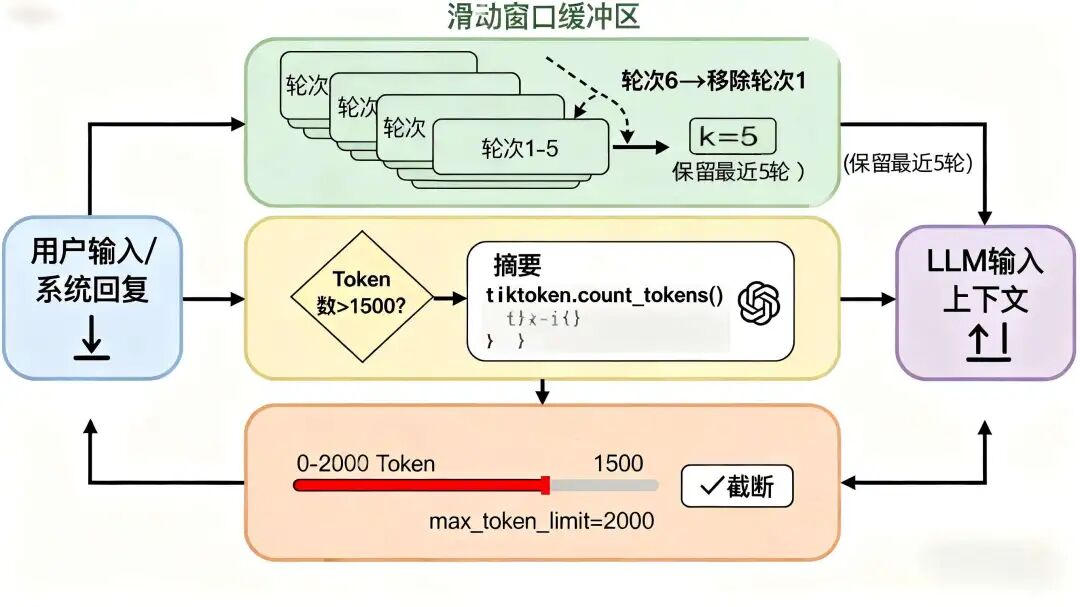
  • 滑动窗口缓冲区:最简单方式,在内存维护固定大小队列,保留最近 K 轮对话。新对话产生时,最早对话移出窗口。例如,若设定保留最近 5 轮对话,当第 6 轮对话产生,第 1 轮对话就会被移除。
  • 技术工具:LangChain ConversationBufferWindowMemory、llama-index WindowMemoryBuffer
  • 核心参数:k(窗口大小,默认 5)、memory_key(存储对话历史的键名,默认 “history”)
  • 代码示例(LangChain):
from langchain.memory import ConversationBufferWindowMemory

memory = ConversationBufferWindowMemory(k=3)  # 保留最近3轮对话

memory.save\_context({"input": "你好"}, {"output": "您好!有什么可以帮您?"})

memory.save\_context({"input": "我叫小明"}, {"output": "很高兴认识你,小明!"})

print(memory.load\_memory\_variables({}))  # 输出前3轮对话
  • 摘要化策略:当对话长度快超出上下文限制,调用 LLM 对早期对话内容摘要,将摘要和最近对话内容保留在上下文。如在一段长对话中,模型会定期对之前的多轮对话进行总结,以精简信息。
  • 技术依赖:LLM 摘要模型(如 GPT-3.5-turbo-1106、Claude 3 Haiku)、LangChain ConversationSummaryMemory
  • 摘要触发条件:对话 Token 数达到阈值(如 GPT-3.5 设为 1500 Token)、对话轮次超预设值(如每 10 轮触发一次)
  • 技术优化:采用 tiktoken 库计算 Token 数(支持多模型 Token 规则),代码示例:
import tiktoken

encoder = tiktoken.encoding\_for\_model("gpt-3.5-turbo")

def count\_tokens(text):

    return len(encoder.encode(text))

\# 当对话历史Token数超阈值时触发摘要

if count\_tokens(memory.load\_memory\_variables({})\["history"]) > 1500:

    summary = llm.generate\_summary(memory.load\_memory\_variables({})\["history"])
  • Token 长度限制策略:依据 Token 数量控制记忆。总 Token 数超预设阈值时,从对话历史开头移除内容直至满足限制。比如,设定阈值为 1000 个 Token,当对话总 Token 数达到 1200 时,从开头逐步删除部分内容,使总 Token 数回到 1000 以下。
  • 技术工具:LangChain ConversationTokenBufferMemory、OpenAIEmbeddings(辅助 Token 计算)
  • 核心参数:max_token_limit(默认 2000)、llm(指定用于 Token 计算的 LLM 模型)
  • 冲突处理:当单轮对话超 max_token_limit 时,触发文本截断(采用 textwrap 库按 Token 分割)
  1. 相关示例(含技术对比):LangChain 中的 ConversationTokenBufferMemory、ConversationSummaryMemory(对整个对话摘要)、ConversationSummaryBufferMemory(保留近期对话并对更早对话摘要)、ConversationBufferWindowMemory 等都是短期记忆的实现方式。其中,ConversationBufferWindowMemory 实现简单,适合短对话,但长对话中会突然丢失早期重要信息;ConversationSummaryMemory 等能在长对话保留核心信息,扩展 “记忆” 长度,不过摘要过程会消耗额外 API 调用成本且可能丢失细节。
记忆类型技术优势适用场景性能开销(Token / 轮)
ConversationBufferWindowMemory无额外 API 调用成本短对话(<10 轮)0(仅内存存储)
ConversationSummaryMemory长对话核心信息保留客服对话、多轮咨询50-200(摘要消耗)
ConversationTokenBufferMemory精确控制 Token 用量低 Token 预算场景0(仅截断无摘要)

(二)长期记忆(LTM)

  1. 核心功能:长期记忆是 Agent 的 “知识库” 与 “经验库”,用于跨会话、跨时间存储和检索信息,是实现个性化、持续学习和积累经验的关键。可存储用户偏好、核心事实、过去成功 / 失败经验、特定领域外部知识文档等。
  2. 挑战:核心挑战是如何从海量外部信息中高效精确检索当前任务所需相关知识。
  3. 实现路径(以 RAG 为核心,含技术细节)

  • 简单拼接:将检索到的文本块直接塞入 Prompt,适用于检索内容不多的情况。比如,若只检索到少量与问题相关的文本片段,可直接将它们组合起来提供给模型。
  • Map - Reduce 策略:检索内容过多时,先对每个文本块独立摘要(Map 阶段),再将所有摘要整合生成最终答案(Reduce 阶段)。例如在处理大量文档时,先分别对每篇文档生成简短摘要,再将这些摘要汇总,得出综合结论。
  • Refine 策略:迭代处理检索到的文本块。先基于第一个文本块生成初步答案,再结合后续文本块和初步答案,让 LLM 优化修正。如在回答复杂问题时,模型先依据部分信息给出初步回答,再根据新检索到的相关信息对答案进行完善。
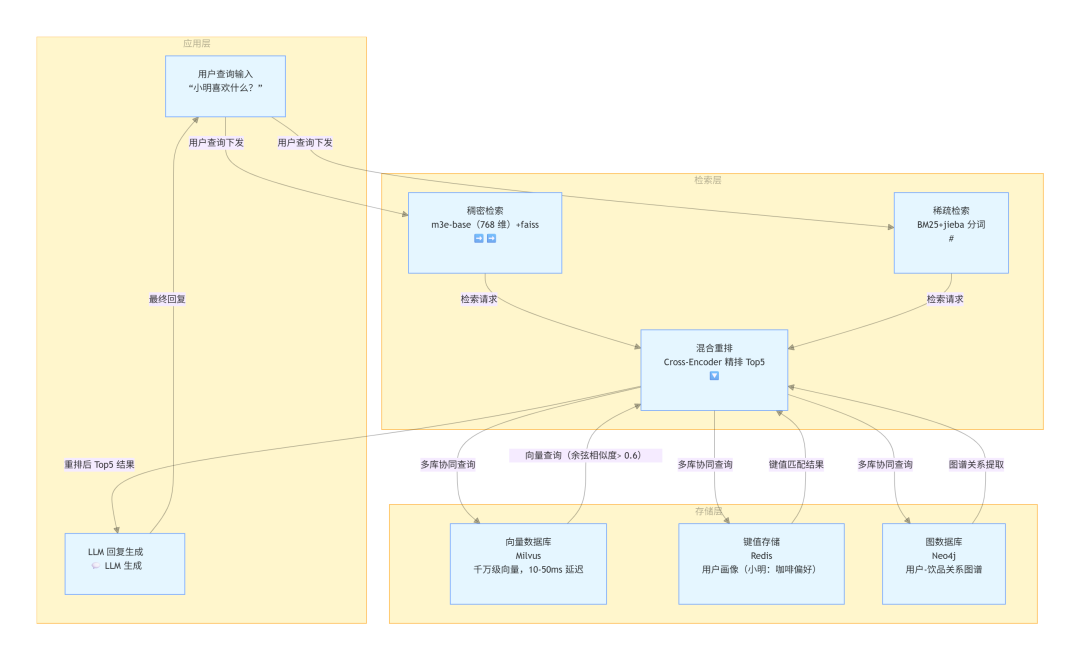
  • 稠密检索:基于 Embedding 模型进行语义相似度搜索,是主流方式。需选择合适 Embedding 模型,如 BERT、m3e - base、OpenAI 的 text - embedding - ada - 002 等。例如,将用户问题和文档都转换为向量形式,通过计算向量间余弦相似度来查找最相关文档。
  • 模型选型:中文用 m3e-base(维度 768,开源免费)、英文用 text-embedding-ada-002(维度 1536,精度高)
  • 向量计算库:faiss(CPU 环境)、faiss-gpu(GPU 加速,支持 1000 万级向量检索)
  • 代码示例(m3e + faiss):
from sentence\_transformers import SentenceTransformer

import faiss

\# 加载Embedding模型

model = SentenceTransformer('moka-ai/m3e-base')

\# 生成文档向量

docs = \["用户小明偏好咖啡", "用户小红对茶敏感"]

doc\_embeddings = model.encode(docs)

\# 构建FAISS索引

index = faiss.IndexFlatL2(doc\_embeddings.shape\[1])

index.add(doc\_embeddings)

\# 检索相似文档

query = "小明喜欢什么饮品"

query\_embedding = model.encode(\[query])

distances, indices = index.search(query\_embedding, k=1)  # 返回Top1相似文档
  • 稀疏检索:基于关键词匹配的传统方法,如 BM25 算法,对关键词明确的查询很有效。当用户输入包含明确关键词的问题时,该方法能快速定位相关文档。
  • 算法:BM25(rank_bm25 库)、TF-IDF(scikit-learn 库)
  • 技术优化:中文需先分词(jieba 或 THULAC),英文用 nltk 分词
  • 混合检索:结合稠密和稀疏检索优点,先分别搜索,再通过重排序模型融合结果,提高检索鲁棒性和准确性。在实际应用中,先利用稀疏检索快速筛选出一批可能相关文档,再用稠密检索对这些文档进行更精确排序。
  • 融合方案:ColBERT(稠密检索)+ BM25(稀疏检索),通过 Cross-Encoder 重排序(如 cross-encoder/ms-marco-MiniLM-L-6-v2)
  • 向量数据库:存储非结构化数据(如文档、对话记录)语义向量,是实现 RAG 的核心。像 Pinecone、Milvus、Weaviate、Chroma 等。数据经 Embedding 模型转换为向量存入,通过计算向量间余弦相似度等方式快速语义检索。例如,将大量文章转换为向量存储在向量数据库中,当用户提问时,能迅速找到语义相似的文章。
  • 键值存储 / 文档数据库:存储半结构化数据,如用户画像、会话 ID 等。如 Redis(用于快速缓存)、MongoDB。可方便地存储和查询与用户相关的特定信息。
  • 图数据库:存储实体及其复杂关系,构建知识图谱,如 Neo4j。对需要深度推理和关系发现的 Agent 很重要。例如在构建智能客服系统时,可通过图数据库存储客户信息、产品信息以及它们之间的关系,帮助客服更好地理解客户问题和提供解决方案。
存储类型技术工具适用数据量检索延迟(单条)部署成本
向量数据库Pinecone(云服务)亿级向量<100ms较高
Milvus(开源)千万级向量10-50ms中
Chroma(轻量开源)万级向量<50ms低
键值存储Redis(内存数据库)百万级键值对<1ms中
图数据库Neo4j(开源)百万级节点关系10-30ms较高
  1. 记忆合成流程
  • 存储层:记忆的物理载体,根据数据类型选择合适存储方案。如文本数据可存储在普通文件系统或数据库中,向量数据存储在向量数据库。
  • 检索层:负责从存储层 “提取” 记忆。通过上述检索策略,从存储的大量信息中找到与当前任务相关内容。
  • 记忆合成层:将检索到的信息与当前查询整合成有效 Prompt,供 LLM 生成最终回复。例如,把用户问题、从长期记忆中检索到的相关知识以及短期记忆中的当前对话状态组合成一个完整的输入,提供给 LLM 进行处理。
  • Prompt 拼接模板(LangChain PromptTemplate):
from langchain.prompts import PromptTemplate

template = """

短期对话历史:{short\_memory}

长期记忆检索结果:{long\_memory}

用户当前问题:{user\_query}

请结合上述信息,生成自然语言回复。

"""

prompt = PromptTemplate(

&#x20;   input\_variables=\["short\_memory", "long\_memory", "user\_query"],

&#x20;   template=template

)
  • 多源信息融合:采用 LangChain SequentialChain 或 llama-index MultiDocumentQueryEngine,支持并行处理短期 + 长期记忆

通过上述短期记忆和长期记忆的实现路径,共同构成动态、可扩展的记忆系统,助力 Agent 摆脱 “金鱼困境”,迈向更智能、自主方向。

三、关键技术挑战与解决方案

  1. 短期记忆 Token 溢出:采用 Token 压缩算法(如 gzip 文本压缩)+ 优先级排序(保留用户提问、核心回复,丢弃冗余寒暄)
  2. 长期记忆检索噪声:引入 检索过滤机制(如设置相似度阈值,余弦相似度 < 0.6 过滤)、多轮检索(先粗检索 Top20,再精排 Top5)
  3. 跨模态记忆存储:图像用 CLIP 模型生成向量,音频用 Wav2Vec2 模型,统一存入向量数据库(如 Milvus 支持多模态向量)

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

大模型应用技术之一篇搞懂Agent 本文深入探讨了AI智能体(Agent)的核心架构与应用。Agent不同于传统AI系统,具备推理、规划、学习和动态调整能力,能够处理复杂任务。文章系统介绍了Agent的五大核心组件(感知层、推理层、行动层、记忆层和学习层)及其工作流程,并详细解析了8种关键模式,包括规划与执行、自我提问、ReAct及其与RAG的结合等。此外,还对比了主流Agent框架,分享了Java实现案例和A2A协作模式,为构建智能Agent系统提供了全面的技术指导和最佳实践。 阅读详情

相关推荐

大模型Agent开发实战:从零搭建ReAct循环与工具调用全指南

在大模型应用开发中,Agent正成为连接模型能力与真实业务的关键范式。与普通Chatbot的“有问必答”不同,Agent通过“目标-规划-行动”的ReAct循环,让模型自主决策、调用工具并迭代结果,真正实现任务闭环。这一过程涉及函数调用、提示词工程、记忆管理、工具注册与安全边界等多层架构设计。理解这些基础原理,是搭建稳定Agent的起点,也是评估LangChain等框架价值的前提。无论你是刚入门智能体开发,还是在生产中遇到工具调用失控、死循环或高并发瓶颈,核心都回归到对最小循环的掌控力。本文从零拆解Agen

weixin_31458015的博客 284

【Agents篇】03:Agent 的记忆系统——从短期到长期记忆的实现

或许有一天,Agent 的记忆会像人类一样丰富——不仅记住事实,还记住情感、气味、画面。它们会在梦中整理记忆,会因为某首歌想起某个人,会在岁月中成长和改变。那时的 Agent,或许真的可以称之为"数字生命"。

u013010473的博客 1475

Agent记忆系统的设计与实现——从短时记忆到长期记忆,生产级架构实战指南

凌晨2点,你被叫醒处理线上故障。你打开Agent系统,输入"帮我分析最近的P0告警",一个没有记忆的Agent会一脸茫然——它不知道你维护的是哪套系统、用什么语言开发、有哪些历史告警模式。但一个记得你技术栈、项目结构、历史故障的Agent,能在30秒内给出精准诊断。你和Agent协作开发了3天的微服务项目,中途去开了个会。回来后,没有记忆的Agent已经"失忆",你需要重新解释项目背景、代码规范、中间的决策过程。而有记忆的Agent记得你所有的上下文,直接从断点继续。

软件行业技术文化交流。 820

一文搞懂什么是AI Agent

如果你经常关注AI领域,一定听过“AI Agent”这个高频词——它被称为“下一代AI应用的核心形态”,2025年更是被业内公认为“Agent商用元年”。小到自动整理会议纪要、规划旅行路线,大到新药研发、工厂智能运维,AI Agent正在悄悄改变我们的工作与生活。很多初学者会困惑:AI Agent到底是什么?它和ChatGPT这类大模型有什么区别?普通人能学会用它吗?其实不用怕,AI Agent的核心逻辑非常好懂。

sinat_20277079的博客 925

万字长文!何谓Agent,为何Agent?

以下文章来源于下维NextDimension ,作者萧夫点击上方“”,选择“星标”公众号您想知道的人工智能干货,第一时间送达AI应用层出不穷爆发式涌现出来,在深思护城河深度之后,市场的玩家齐刷刷地转向到是模型能力的不断提升?还是资方的倒逼?本质上是每个人都想有解决特定任务的AI在探寻了算法,工程,数据等核心要素价值后,场景的不断探索,又带来了什么?中,市场更加看好的又是什么呢?Fig.1. 生成式AI产品的分级。

具身机器人和通用AI 2615

Python+whisper/vosk实现语音识别

Whisper 是一个由 OpenAI 开发的人工智能语音识别模型,它能够将语音转换为文本。Whisper 模型特别之处在于它的设计目标是能够理解和转录多种语言的语音,包括但不限于英语。Whisper 模型在训练时使用了大量不同语言的语音数据,这使得它具有很好的跨语言能力。Vosk 是一个开源的语音识别库,它可以在离线环境下工作,不依赖于任何外部服务。Vosk 基于Kaldi语音识别框架,支持多种语言,包括中文。Vosk提供了多种预训练模型,可以根据需求选择适合的模型进行语音识别。

weixin_44458771的博客 5941

给大模型套上缰绳:从 Prompt 到 Harness,彻底搞懂 AI Agent

从Prompt到Harness赛博扫盲

hanya_10086的博客 567

一文读懂:CAN总线Bus-Off的触发条件与自动恢复机制

本文详细解析CAN总线Bus-Off状态的触发条件与自动恢复机制。根据ISO 11898-1标准,当发送错误计数器(TEC)超过255时节点进入Bus-Off状态,并通过检测128次总线空闲条件实现自动恢复。文章结合实战案例,探讨硬件故障、软件配置及电磁干扰等常见触发场景,并提供快慢恢复策略与调试方法,帮助工程师快速定位并解决CAN网络故障。

rgv234567的博客 361

一文搞懂 AI 智能体(Agent):从核心原理到手搓一个能“思考+调工具”的 Agent

把大模型封装进一个会规划、会调工具、会记事儿、会纠错的系统里。写一个 ReAct Loop接两个工具(搜索 + 计算)加一层短期记忆跑通之后,再谈多智能体、MCP、企业级治理。转载请注明出处,欢迎在 优快云 评论区交流 Agent 落地经验。

2601_96633595的博客 251

使用 MATLAB/Simulink 进行锂电池SOC估算和等效电路建模

本文介绍了使用MATLAB/Simulink进行锂电池SOC估算与等效电路建模的方法。首先阐述了SOC估算和等效电路模型的背景及重要性,然后详细讲解了系统结构设计的主要组成部分,包括电池模块、SOC估算模块(采用卡尔曼滤波器算法)和等效电路模型等。文章重点分步说明了建模过程:从创建Simulink项目、搭建电池模块,到实现SOC估算算法(提供示例代码),构建等效电路模型(Thevenin模型示例),添加传感器模块,最后设置仿真参数。通过仿真运行分析关键指标(SOC估算误差、电压偏差等)来评估模型性能,为锂电

xiaoheshang_123的博客 264

SCADA|用KingSCADA实现设备台账的查询功能

以上为用KingSCADA实现设备台账的查询功能,另外还有一些细节功能,比如当点击增加按钮时弹出的信息窗口内的信息希望是在选中的某行信息,只要找到差不多的设备,修改个别参数即可,避免增加时弹出空白页,所有信息都需要填写。以上为实现设备台账查询的最简单实现,实际项目中可能会更复杂,你做过哪些设备台账或相关的功能,有比较好的创意或高难度功能方法,欢迎在留言区评论,或在交流群探讨,互通有无,共同进步。首先完成界面的组态工作,主要是通过查询按钮,查询SQLServer数据库的设备台账数据,然后填充到报表内。

做有价值的事,积累有价值的笔记! 480

收藏!10分钟搞懂Agent记忆系统的四层架构,小白也能学会大模型进阶

文章介绍了Agent记忆系统的四层架构,包括上下文记忆、外部记忆、情景记忆和语义/参数记忆,并详细解释了记忆如何在Agent Loop中流动以及如何构建记忆层。文章还探讨了向量数据库在记忆管理中的应用,以及基于时间的衰减、写入时的重要性打分和定期整合等记忆管理策略。通过理解这些概念,读者可以更好地设计和优化Agent的记忆系统,使其更智能、更可靠。

2401_85375186的博客 681

fast-lio运行步骤(使用velodyne数据)

使用fast-lio运行velodyne数据

ericdowney 4769

大模型Agent开发入门:从ReAct循环到Function Calling实战

大模型Agent是当前AI工程领域的热门方向,其本质并非简单的提示词拼接,而是构建一个让模型自主决策、调用工具并修正错误的闭环系统。理解这一原理,需要从模型底座、规划层、工具层、记忆层与执行循环五个核心组件入手,掌握ReAct循环与Function Calling等关键技术。Agent开发的价值在于将大模型的文本生成能力延伸为任务执行能力,可广泛应用于个人任务助手、文档问答、自动报表等场景。对于初学者,建议先手写最小Agent实现,再借助LangChain等框架工程化落地,同时重视日志、安全与成本控制,才能

weixin_29061465的博客 171

【docker】--- 详解 WSL2 中的 Ubuntu 和 Docker Desktop 的区别和关系!

在编程的艺术世界里,代码和灵感需要寻找到最佳的交融点,才能打造出令人为之惊叹的作品。而在这座秋知叶i博客的殿堂里,我们将共同追寻这种完美结合,为未来的世界留下属于我们的独特印记。

秋知叶i 1314

31、Labview如何搭建程序框架?--状态机到数据采集等常用框架

本文废话不多,直接列举几种框架搭建方式,为了尽量向大家提供干货,本文直接从简介和手把手教搭建框架两方面来讲解,本文提到五种经典框架模式,学会这五种就很够了,分别是:状态机框架(State Machine)、生产者-消费者框架(Producer-Consumer)、主-从框架(Master-Slave)、事件驱动框架(Event-Driven)、分层架构(Layered Architecturep)。这个框架是基于状态机结构的。顾名思义“状态机”就是个“切换程序状态的机器”。本质是一个。

关注我,更多技术问题欢迎私聊~ 3103

AI Agent从入门到落地:核心原理、工具选型与实战避坑

人工智能技术正从对话式交互走向自主执行,大模型作为核心推理引擎,需要借助智能体框架才能真正落地于业务流程中。智能体的本质是给大模型配上规划、记忆与工具调用能力,形成感知-决策-行动-观察的循环。掌握这一原理后,开发者可通过Dify或LangGraph等平台快速搭建具备业务价值的应用,例如销售线索自动清洗与评分。从环境配置、提示词设计到向量数据库与MCP协议,工程化的每一步都决定智能体的稳定性。围绕一条完整的实战路径,梳理从认知框架到落地避坑的关键环节,帮助初学者建立可复用的Agent开发方法论。

weixin_29057065的博客 228

【ubuntu24.04】auto remove后,重启,kernel panic ,please reboot your computer vfs unable to mount root fs

Ubuntu 24.04系统在运行auto remove后出现内核恐慌(kernel panic)无法启动,显示"VFS: unable to mount root fs"错误。该问题是由于当前内核被清除导致系统无法挂载根分区。解决步骤包括:1)尝试用GRUB菜单中的旧内核启动;2)在GRUB中临时编辑启动参数;3)使用Ubuntu启动盘进行chroot修复;4)使用Boot-Repair工具一键修复。成功启动后,需要重新安装linux-generic等元包,重建initramfs并更新

突围 1210

AI Agent 从原理到实践:大模型不只会说话,还能自主干活

大模型应用早已超越单纯文本生成,逐步演化为具备感知、规划、记忆与行动的智能体。AI Agent 的本质,是从确定性规则流程转向自主决策的不确定性执行,其核心挑战在于工具调用、上下文管理与成本控制。理解 LLM、Chatbot、工作流与 RAG 的边界,有助于在真实业务中做出合理的技术选型。从手写最小 Agent 到多步规划与工程落地,只有看清底层循环和常见陷阱,才能真正让模型“会思考、能干活”。本文拆解 Agent 的四层结构与底层原理,结合最小可运行示例和实测优化经验,为技术选型与项目落地提供可复用的方法

weixin_34246529的博客 266

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

10分钟搞懂大模型Agent记忆系统四层架构,附Python实现

文章介绍AI Agent记忆系统四层架构:上下文记忆(工作台)、外部记忆(持久化存储)、情景记忆(事件记录)和语义/参数记忆(内置知识)。详解记忆在Agent Loop中的流动,构建记忆层的代码实现,向量数据库的相似性搜索原理,以及基于时间衰减、重要性打分和定期整合的记忆管理策略,帮助Agent实现持续学习和上下文理解能力。

2401_85325557的博客 593

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Agent Loop实战:从零构建智能体循环机制与工作流

大模型应用开发正从单次问答走向多步骤自主执行的智能体(AI Agent)时代。无论是构建智能助手还是自动化工作流,开发者都绕不开一个底层机制——Agent Loop。所谓 Agent Loop,即“思考→行动→观察”的循环迭代:模型通过工具调用获取外部反馈,再基于新信息决策下一步动作。这种闭环机制让智能体具备连续任务处理与自主纠错能力,使多步骤流程自动化成为可能。在实际工程中,上下文记忆压缩、工具注册规范与循环稳定性控制,往往是决定智能体能否可靠运行的关键。当需要搭建一套可持续工作的智能体工作流时,深入理解

weixin_34220179的博客 384

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

AI Agent是什么:从LLM原理到企业级落地的全拆解

大语言模型(LLM)是当前人工智能应用的核心引擎,但它本质上是基于输入文本预测下一个token的生成器,本身不具备自主执行任务的能力。AI Agent则是在LLM之上构建的完整智能系统,通过规划、记忆、工具调用等模块,实现了从“对话”到“干活”的能力跃迁。理解这一区别,是正确选型与评估效果的前提。在工程实践中,Agent可借助LangChain、Dify、Spring AI等框架快速搭建,并用于知识库问答、代码协助、自动化运维等场景。企业级落地还需重点关注服务化部署、权限安全、多智能体协作与可观测性,才能真

weixin_29038155的博客 301

想做AI大模型开发?必须收藏这个AI学习路线

AI Agent工程师学习路线与前景分析 岗位前景 2026年AI Agent开发岗位需求激增(同比增速455%),供需比仅0.43,中位数月薪30K-60K,资深岗可达130K。门槛呈现K型分化:顶尖人才稀缺(多智能体架构师年薪中位数218万),但47%岗位要求硕博学历,需掌握LangChain/AutoGen等实战技能(掌握者不足5%)。 三阶段学习路线 基础阶段(1-3周):掌握Python编程(FastAPI框架)、Git管理、MySQL数据库及Linux部署能力,完成可演示的小项目开发。 核心阶段

2401_84494441的博客 286

Java开发者视角:彻底搞懂Agent与工具调用的核心原理与工程实践

人工智能技术的演进正在重塑软件架构的设计范式,其中大语言模型驱动的智能体成为备受关注的前沿方向。与传统的确定性程序不同,Agent以目标驱动为核心,通过感知、决策、行动、反思的循环机制动态规划执行路径,从而应对现实世界中的开放性问题。其技术体系可拆解为模型层、工具层、记忆层和规划层,模型负责推理、工具负责执行、记忆维护上下文、规划拆解任务,四者协同才能构建真正的智能体。在Java生态中,开发者可以借助LangChain4j或Spring AI等框架快速搭建具备工具调用能力的最小Agent,将现有Servic

weixin_29048775的博客 28

Prompt 已过时?Harness Engineering 才是 AI Agent 时代的程序员核心竞争力

本文深入解析了AI工程化中的提示词工程、上下文工程和HarnessEngineering(驾驭工程)的本质关联,指出三者是层层递进的体系化管控方案。提示词工程解决单次交互优化,上下文工程实现动态信息管理,而HarnessEngineering则构建完整的Agent管控体系。文章详细拆解了HarnessEngineering的四层架构(记忆层、执行层、反馈层、编排层)及其落地方法,并介绍了规范驱动开发(SDD)的实战模式。最后强调在AI时代,程序员的核心竞争力将转向搭建可控的AI工程体系。全文提供了从理论到实

爱人爱己,风生水起 1325
上一篇: 在本地部署Qwen3大模型与Dify环境中亲测制作“合同审查智能体”应用
下一篇: 从RAG到GraphRAG:知识图谱、本体论与更智能的AI
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值