


1.什么是RAG系统?
RAG系统,全称是“检索增强生成系统”,它是一种结合了信息检索和文本生成技术的 AI 系统。RAG 系统的核心思想是:不要让 LLM 单打独斗,而是给它提供相关的外部知识,让它在生成答案的时候有所依据,从而提高答案的质量和可靠性。 它可以解决 LLM 在知识更新方面滞后,以及容易产生幻觉(捏造事实)等问题。
在开始深构建核心检索增强生成(RAG)系统之前,我们需要首先进行一些必要的准备工作。其中一个关键步骤是配置好我们的开发环境,以便能够有效地跟踪和管理实验过程中的各种活动,并顺利执行其他相关的任务。这包括设置必需的环境变量,以便程序能够正确运行并访问必要的资源。一个具体的例子就是选择并配置我们将要使用的语言模型(LLMs)API提供程序。
import os# Set LangChain API endpoint and API keyos.environ['LANGCHAIN_ENDPOINT'] = 'https://api.smith.langchain.com'os.environ['LANGCHAIN_API_KEY'] = <your-api-key> # Replace with your LangChain API key# Set OpenAI API keyos.environ['OPENAI_API_KEY'] = <your-api-key> # Replace with your OpenAI API key
核心 RAG 流水线是高级系统的基石,理解其组件至关重要。因此,在探讨高级组件之前,我们将首先介绍 RAG 系统的核心逻辑。
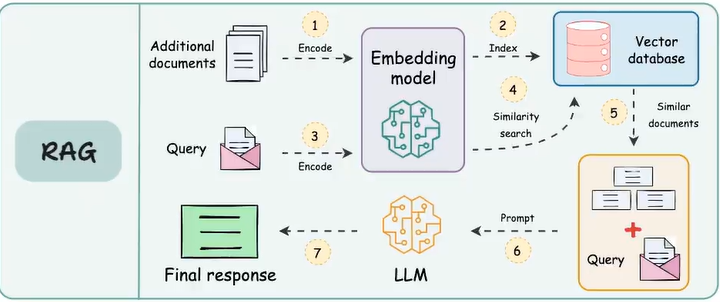
一个最简单的 RAG 可以分为三个部分:
-
索引
:以结构化格式组织和存储数据,以实现高效搜索。当你向 RAG 系统提出一个问题时,它首先会从一个大型的知识库(比如文档库、数据库等)中,检索出与你的问题相关的文档或信息片段。 就像你在搜索引擎里输入关键词,搜索引擎会返回与关键词相关的网页一样。
-
检索
:根据查询或输入搜索并获取相关数据。RAG 系统会把检索到的信息和你提出的问题结合起来,形成一个更全面的“输入”。 相当于给 AI 系统提供了更多的上下文信息,帮助它更好地理解你的问题。
-
生成
:使用检索到的数据创建最终响应或输出。RAG 系统会利用大型语言模型 (LLM),根据增强后的输入,生成最终的答案。 LLM 会利用检索到的信息来完善答案,使其更准确、更相关。
1.1 索引
在 RAG 系统能够回答任何问题之前,它首先需要从中汲取知识。为此,我们将使用WebBaseLoader直接从子鱼的博客文章中提取内容。
import bs4from langchain_community.document_loaders import WebBaseLoader# Initialize a web document loader with specific parsing instructionsloader = WebBaseLoader( web_paths=("https://blog.341359.xyz/article/1d4ed29d-c23f-818a-908f-d2eaf450cd1b",), # URL of the blog post to load bs_kwargs=dict( parse_only=bs4.SoupStrainer( class_=("post-content", "post-title", "post-header") # Only parse specified HTML classes ) ),)# Load the filtered content from the web page into documentsdocs = loader.load()
利用bs_kwargs,我们可以从一开始就针对性地清理HTML数据,例如post-content和post-title等标签。获取文档后,我们需要将海量文档输入LLM,但这既低效又受上下文窗口限制。因此,分块至关重要,需将文档分解为更小、语义完整的片段。
使用RecursiveCharacterTextSplitter则能智能地保持段落和句子的完整性。
from langchain.text_splitter import RecursiveCharacterTextSplitter# Create a text splitter to divide text into chunks of 1000 characters with 200-character overlaptext_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)# Split the loaded documents into smaller chunkssplits = text_splitter.split_documents(docs)
接着,我们通过设置chunk_size=1000创建1000字符的块,并使用chunk_overlap=200确保块之间存在200字符的重叠,以保留上下文信息。
现在虽然文本已被分割,但仍需转换为数值表示,即“嵌入”,以便进行相似性搜索。这些嵌入随后会被存储在向量存储中,这是一种专门为高效向量搜索而设计的数据库。
然后我们可以借助Chroma向量存储OpenAIEmbeddings,这将使得嵌入和索引过程变得非常简单。一行代码即可完成所有操作。
from langchain_community.vectorstores import Chromafrom langchain_openai import OpenAIEmbeddings# Embed the text chunks and store them in a Chroma vector store for similarity searchvectorstore = Chroma.from_documents( documents=splits, embedding=OpenAIEmbeddings() # Use OpenAI's embedding model to convert text into vectors)
这便是索引的全部流程,在知识索引之后,我们便可以在此基础上进行检索。
1.2 检索
向量库就像一个图书馆,检索器则是一个智能图书管理员。它接收用户的查询,将其嵌入,然后从向量库中获取语义最相似的块。而创建检索器只需要一行代码。
# Create a retriever from the vector storeretriever = vectorstore.as_retriever()
然后我们可以测试一下这个检索器,也就是问一个问题,然后看看检索器会如何输出。
# Retrieve relevant documents for a querydocs = retriever.get_relevant_documents("What is Foundation Agent?")# Print the content of the first retrieved documentprint(docs[0].page_content)#### OUTPUT ####一个自主、自适应的智能系统,旨在主动感知来自环境的多样化信号 ...
如你所见,检索器成功地从博客文章中提取出了最相关的内容,这些内容直接讨论了"Foundation Agent"。这段上下文正是语言模型形成准确答案所需要的。
1.3 生成
现在有了上下文,但需要 LLM 来进行解读,并形成一个通俗易懂的答案。这就是RAG 中的“生成”步骤。首先,我们需要一个好的提示模板。它会指导 LLM 如何操作。你可以自己进行编写,但如果你是新手,我建议还是从 LangChain Hub 导入一个预先优化好的模板。
from langchain import hub# Pull a pre-made RAG prompt from LangChain Hubprompt = hub.pull("rlm/rag-prompt")# printing the promptprint(prompt)#### OUTPUT ####humanYou are an assistant for question-answering tasks. Use the following piecesof retrieved context to answer the question. If you dont know the answer,just say that you dont know. Use three sentences maximum and keep theanswer concise.Question: {question} Context: {context}
然后使用gpt-3.5-turbo来初始化LLM,这一步也只需要一行代码。
from langchain_openai import ChatOpenAI# Initialize the LLMllm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0)
现在我们就可以将所有内容链接在一起。使用 LangChain 表达式语言 (LCEL),将一个组件的输出通过管道传输到下一个组件的输入。
from langchain_core.output_parsers import StrOutputParserfrom langchain_core.runnables import RunnablePassthrough# Helper function to format retrieved documentsdef format_docs(docs): return "\n\n".join(doc.page_content for doc in docs)# Define the full RAG chainrag_chain = ( {"context": retriever | format_docs, "question": RunnablePassthrough()} | prompt | llm | StrOutputParser())
这个链条由下面四个部分组成:
-
{“context”: retriever | format_docs, “question”: RunnablePassthrough()}
:此部分并行运行。它将用户的问题发送到retriever以获取文档,然后由 将其格式化为单个字符串format_docs。同时,RunnablePassthrough将原始问题原封不动地传递过去。
-
| prompt
:上下文和问题被输入到我们的提示模板中。
-
| llm
:格式化的提示将发送给LLM。
-
| StrOutputParser()
:这会将 LLM 的输出清理为一个简单的字符串。
然后,我们可以调用整个链条。
# Ask a question using the RAG chainresponse = rag_chain.invoke("What is Foundation Agent?")print(response)#### OUTPUT ####一个自主、自适应的智能系统,旨在主动感知来自环境的多样化信号,通过不断学习经验来完善和更新结构化的内部状态(如记忆、世界模型、目标、情感状态和奖励信号), ...
2.总结
这便是一个比较详细的构建核心RAG系统的简易教程了。通过本文的介绍,您应该大致会对RAG系统构建的基本原理和实现方法有了初步了解,包括索引、检索和生成这三个核心步骤。虽然这只是一个入门级的教程,但它的确涵盖了构建一个功能完整的RAG系统所需的所有基本要素。希望能够对有需要的人有所帮助,诸君共勉~
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 202


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


