利用anythingLLM轻松搭建AI本地知识库,大模型入门到精通,收藏这篇就足够了!

AnythingLLM 对接硅基流动 DeepSeek R1 【代码】AnythingLLM 对接硅基流动 DeepSeek R1。 阅读详情

最近爆火的Deepseek,不仅在AI圈掀起地震,也掀起了全名AI的时代。AI正在深刻地改变生物行业,包括生物科技、制药、农业和医疗健康等领域。对于生物行业的我们,如何使用大模型高效地管理和利用生物学和内部知识,同时解决大模型专业应用方向的能力,成为了迫切需要解决的问题。

由于大模型的构建需要高性能GPU才能完成,Retrieval-Augmented Generation (RAG)技术应运而生。它是一种结合了信息检索(retrieval)和文本生成(generation)的混合方法,旨在通过利用大规模文本数据库中的相关信息来增强生成模型的表现。这种方法特别适用于需要高精度、上下文丰富回答的任务,如问答系统、对话系统等。能够从大规模知识库中检索相关信息并生成高质量的反馈。
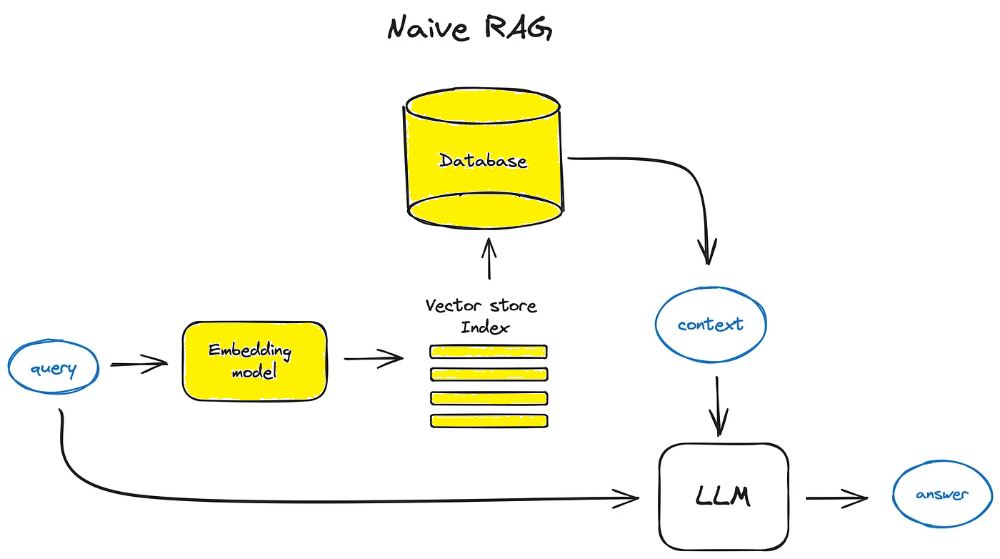
RAG 模型的工作流程可以分为两个主要阶段:检索阶段和生成阶段。由于直接引用了具体、准确的数据源,因此对于事实性问题的回答通常更加可靠,减少大模型幻觉。可以追踪到具体的来源,便于验证结果的真实性。能够处理多样化的任务类型,包括问答、摘要等。

02

RAG系统搭建

2.1 Ollama下载安装

Ollama是一个开源框架,专为在本地机器上便捷部署和运行大型语言模型(LLM)而设计。进入Ollama的官方网站https://ollama.com/,下载适合你操作系统的安装包。
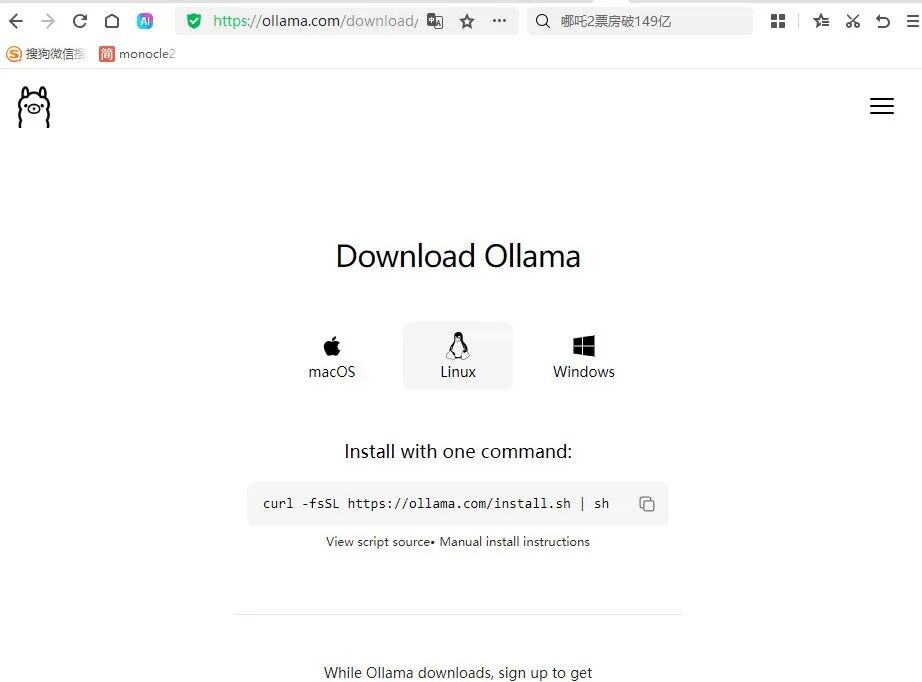
windows版点击安装即可,Linux版执行下面的命令自动安装。

curl -fsSL https://ollama.com/install.sh | sh

打开终端或命令行,输入ollama,出现如下帮助信息即代表安装成功。
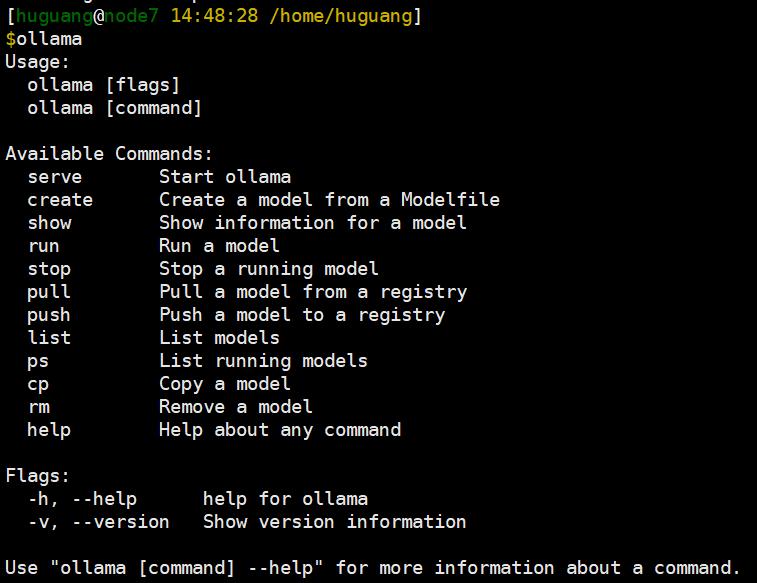
2.2 Ollama 模型下载

从Ollama的官方网站下载DeepSeek R1 8b模型文件。首次使用需要先下载新模型,如果已经使用过则直接运行。

ollama run deepseek-r1:8b

Ollama默认只允许127.0.0.1:11434访问,我们可以修改配置,让所有IP都可以访问。修改文件:/etc/systemd/system/ollama.service,在[Service]这块最下面新增

Environment="OLLAMA_HOST=0.0.0.0"Environment="OLLAMA_ORIGINS=*"

保存

重启Ollama服务

systemctl daemon-reloadsystemctl enable ollama

再下载一个语义向量嵌入模型。后面做知识库的时候会用到。

ollama pull nomic-embed-text

目前用得比较多的有BEG-v3和nomic-embed-text。

2.3 anythingLLM下载安装

进入官方下载链接,大家可以点击安装windows版自己使用即可。
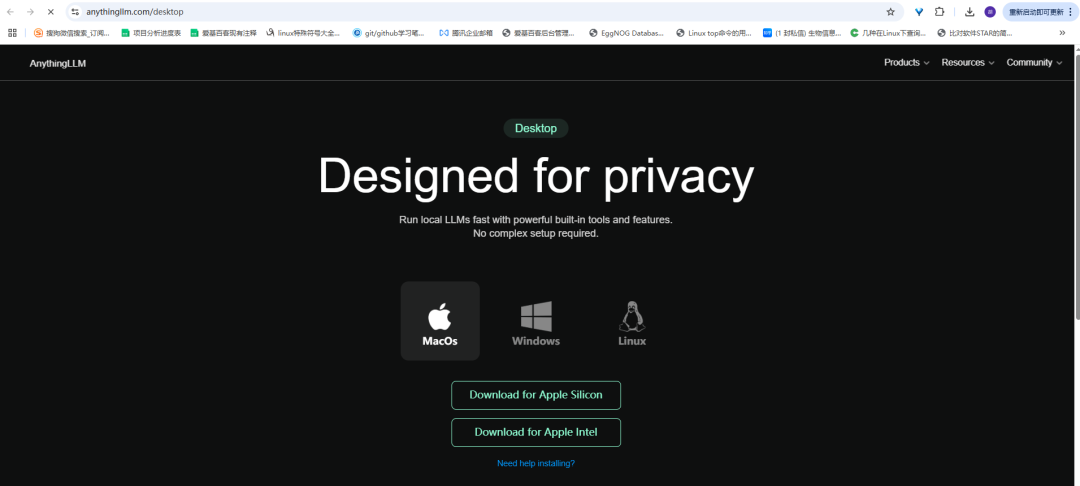
由于我这边是Linux操作系统,并且只有Docker版本可以分享,所以我这边安装Docker版。

拉取官方Docker镜像

docker pull mintplexlabs/anythingllm

如果镜像拉不下来,则需要配置一下docker镜像源。创建/etc/docker/daemon.json文件,写入以下配置

{    "registry-mirrors": [        "https://mirror.ccs.tencentyun.com",        "https://docker.m.daocloud.io"    ]}

下载完成后执行下面的命令启动镜像。windows版本直接打开应用即可。这边使用的是3001端口,也可根据自己的个人需求修改。

export STORAGE_LOCATION="/var/lib/anythingllm" && \mkdir -p $STORAGE_LOCATION && \touch "$STORAGE_LOCATION/.env" && \docker run -d -p 3001:3001 \--cap-add SYS_ADMIN \-v ${STORAGE_LOCATION}:/app/server/storage \-v ${STORAGE_LOCATION}/.env:/app/server/.env \-e STORAGE_DIR="/app/server/storage" \mintplexlabs/anythingllm

windows版本安装好之后直接打开app,Linux通过IP地址加端口的方式访问。
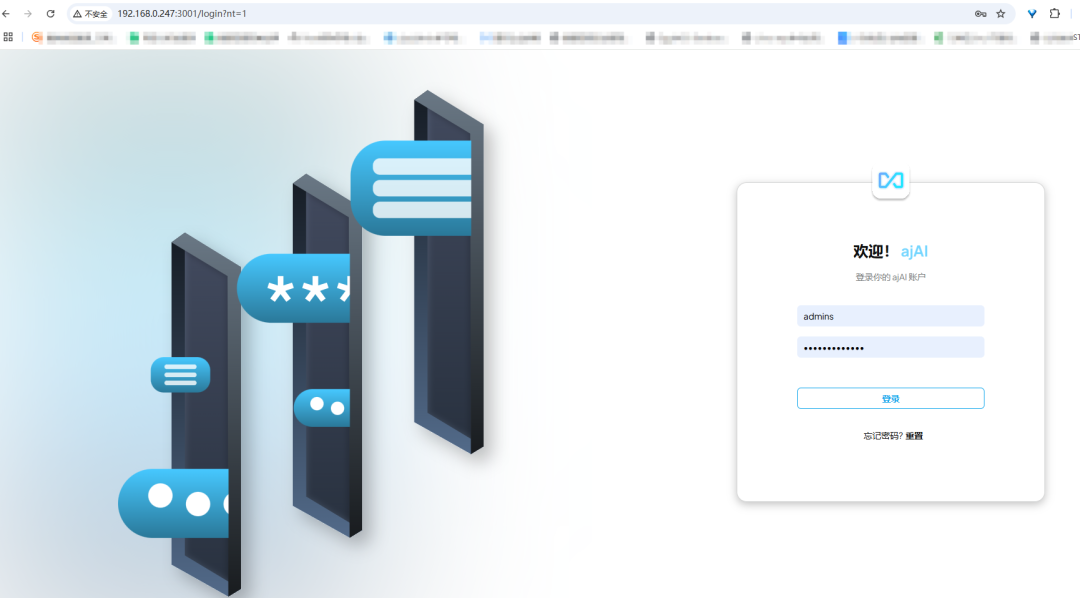
注册登录,添加新工作区,就创建好了一个工作环境。
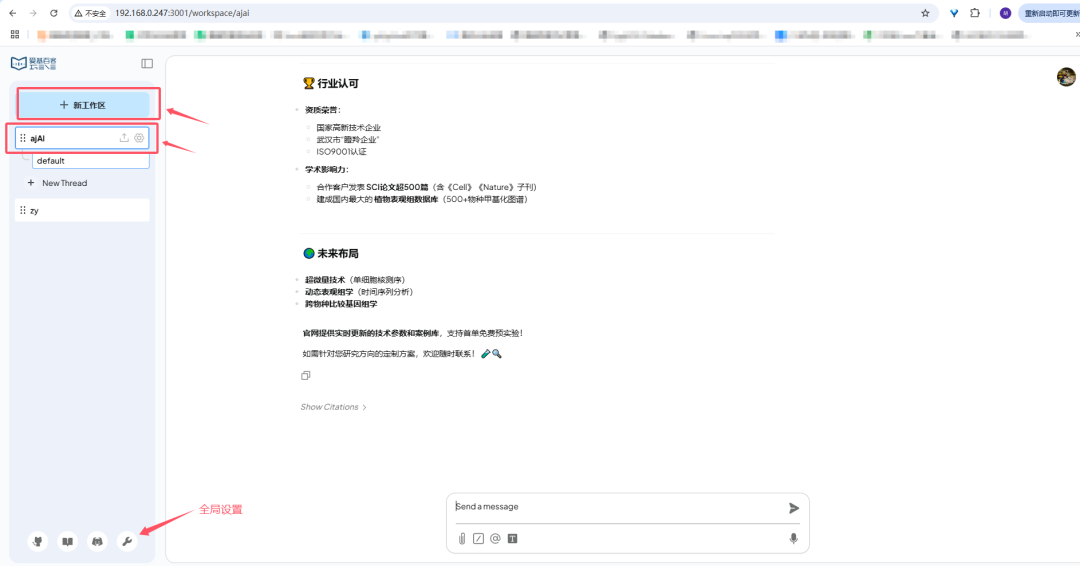
2.4 配置大模型

上面我们已经配置好了大模型运行环境Ollama,我们进入到全局设置里面进行配置。
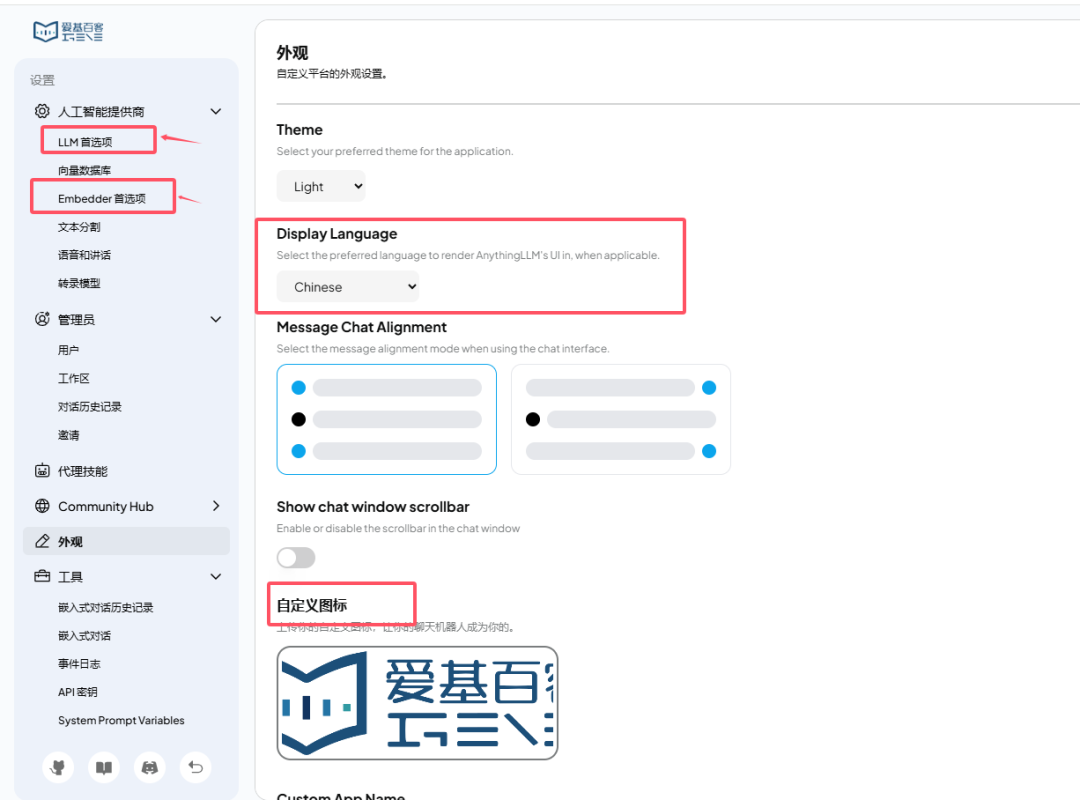
点击LLM首选项
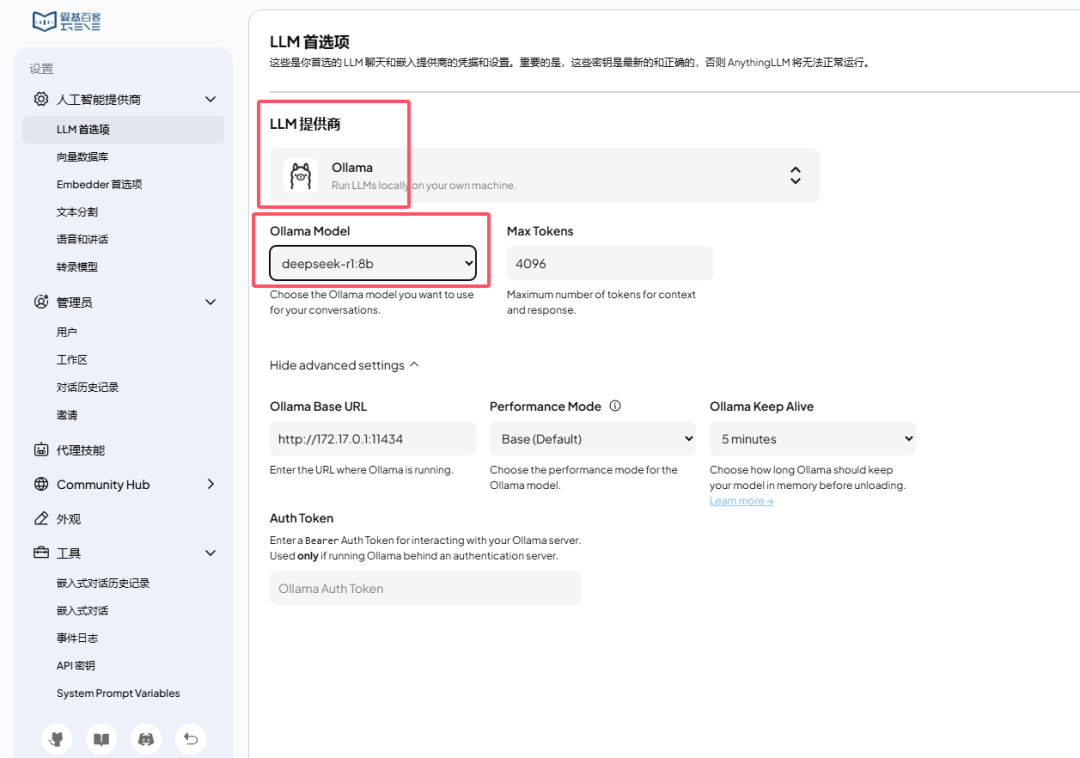
LLM提供商选择Ollama,Ollama Model选择刚才配置好的deepseek-r1::8b模型,这样就配置好了。由于本地运行模型硬件资源有一定的要求。我们可以选择API连接来高效调用大模型。可以使用硅基流动提供的接口,也可以使用抖音火山方舟提供的接口,目前注册都有送token。

以火山方舟为列,填入如下信息。LLM提供商选择通用型openAI接口,如下所示输入官方提供的API key等信息。
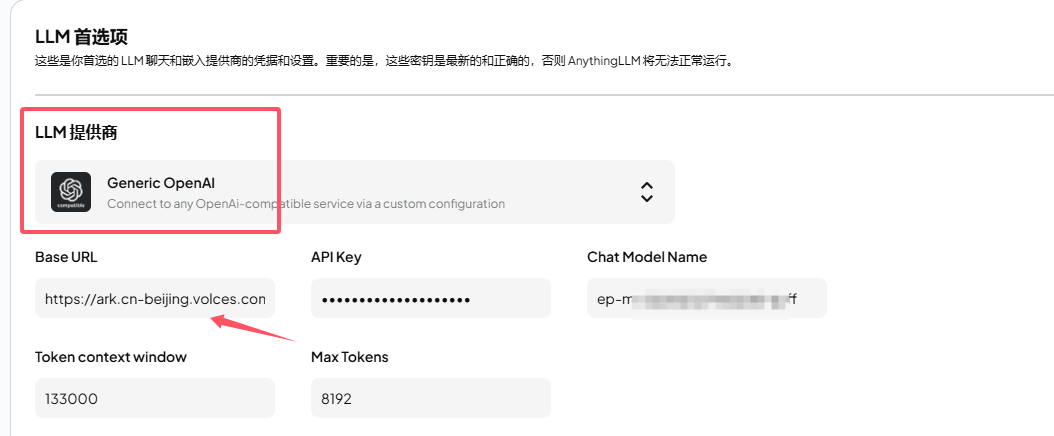
2.5 配置嵌入模型

向量数据库使用默认的LanceDB即可。这里可以使用前面下载好的嵌入模型nomic-embed-text。这里依然选择API接入的方式。使用硅基流动平台选择模型BEG-v3。
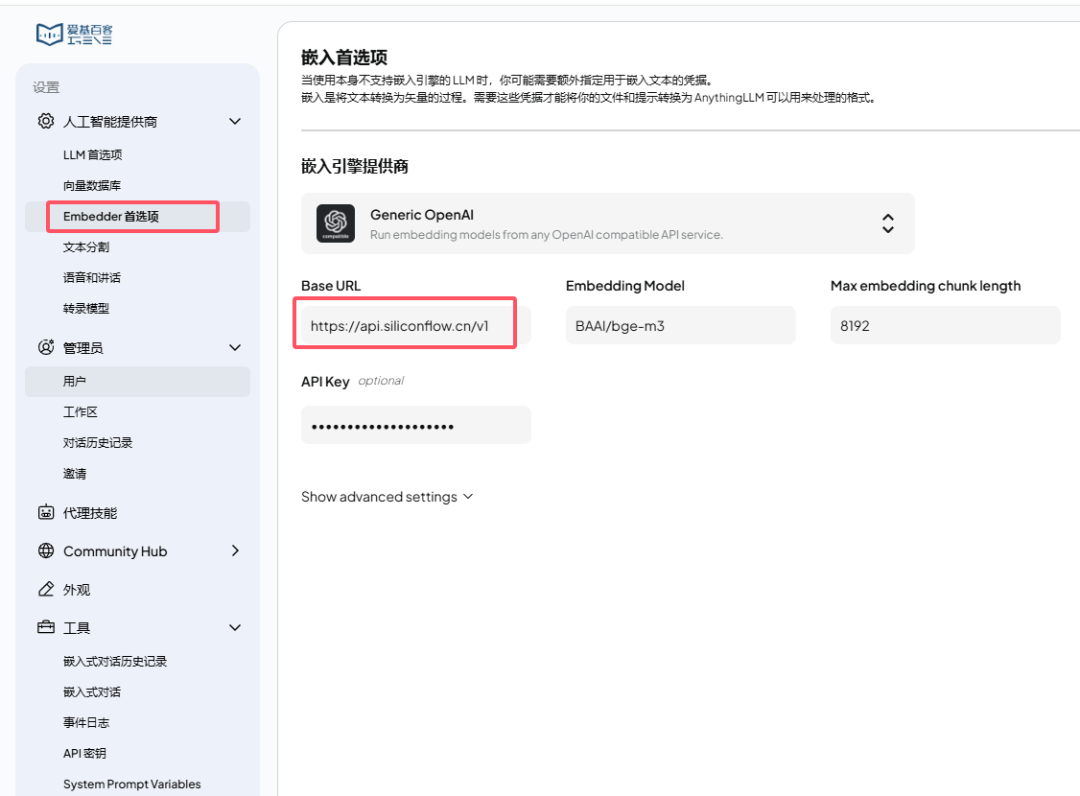
比较遗憾的是当前不支持reranker模型,期待后期官方更新。

2.6 知识库构建

回到工作区主面板,点击工作区的文件上传按钮或者拖动文档。然后移动到工作区,点击Save and Embed等待。等待向量数据库构建完成即可使用。
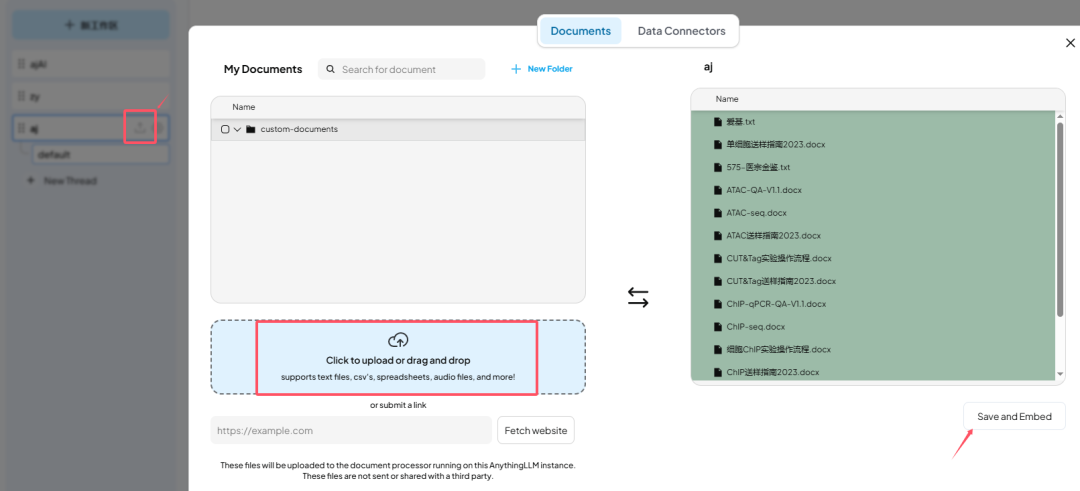
2.7 使用与共享

至此,所有相关配置均已完成,我们来测试一下效果。
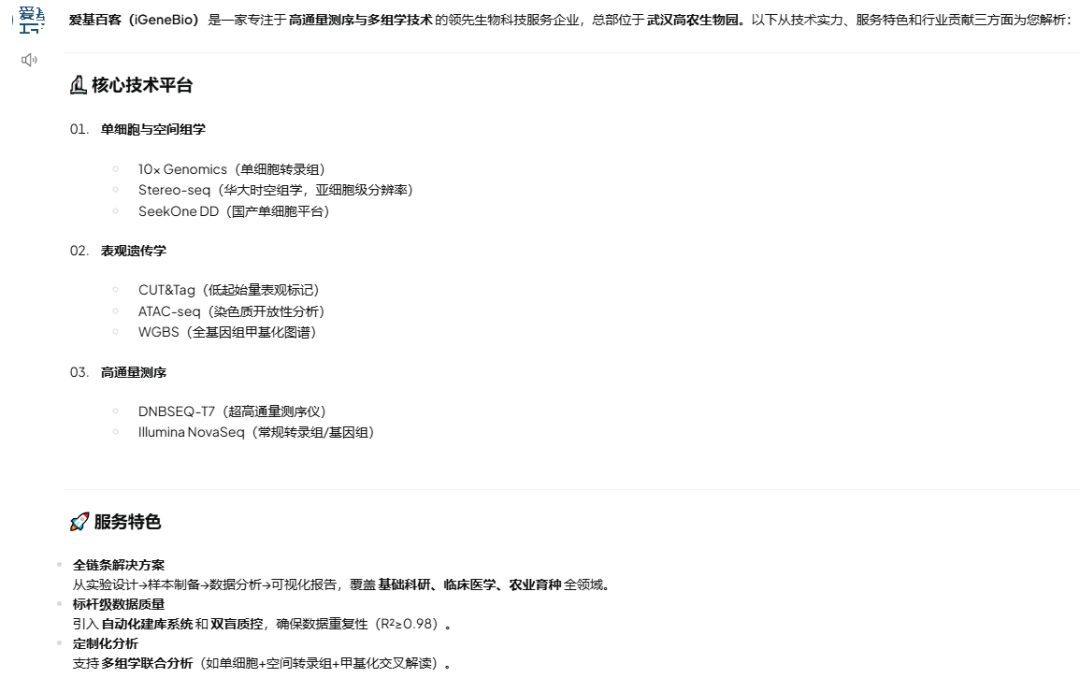
再来一个问题
可以看到,回答还是比较全面的,综合了我们提供的知识文档。最后docker共享版还可以将工作区嵌入到网站共享使用。希望这篇文章能帮助大家构建自己的本地知识库。

IGENEBOOK

关于我们

武汉爱基百客生物科技有限公司(简称爱基百客)是一家专注于表观组学、单细胞时空组学和高通量测序分析服务的新型生物科技企业。公司办公面积逾3000m2,员工已达到百余人,业务覆盖全国,核心团队来自国内知名高校和基因测序公司。公司先后引入ChIP、ATAC-seq、CUT&Tag、单细胞(进口、国产多平台)、DNBSEQ-T7和STOmics时空组学等实验平台,同时配备MGISP-960和AlphaTool等自动化设备。

运营至今合作科研客户超2000家,涵盖国内知名科研院所、高校及相关企业。多项合作成果发表在Science、Cancer Cell、Circulation、Nature Communications和Plant Cell等国际顶级期刊,广受客户好评,成为国内成长最迅速的高通量测序科研服务企业之一。爱基百客将秉承服务至上的理念,发挥自身优势,期待与海内外科研学者精诚合作,共探生命百科全书。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

手把手教你用Ollama & AnythingLLM搭建AI知识库,无需编程,跟着做就行! 本地运行大模型耗资源,需要选择较小的模型作为基础模型。在终端中运行时可能会出现 CUDA 错误,表示显存不足,导致提供的端口失效。中文支持不够完善。\3. 文中提到的技术软件工具有:Ollama、Chatbox、Open WebUI、向量数据库、嵌入模型、本地模型 Gemma、AnythingLLM。 阅读详情

相关推荐

ollama + deepseek + anythingllm构建本地知识库

ollama + deepseek + anythingllm构建本地知识库

wcx18526659867的博客 5804

手把手教你将本地部署的DeepSeek R1集成到Dify

今天,手把手教大家在本地部署DeepSeek R1,并将其集成到Dify中,实打实提升你的工作效率!本部分介绍在本地通过ollama部署DeepSeek R1。在ollama官网,选择操作系统,下载ollama应用程序并安装命令行输入ollama,出现下面的提示,则说明安装成功。在ollama官网,点击「Models」,选择第一个「DeepSeek R1」根据自己的显存选择对应的版本大小。推荐GPU:- 7B和16B之类的较小型号,消费者GPU(例如NVIDIA RTX 4090)是合适的。

m0_63171455的博客 6896

利用AI大模型构建本地知识库

维度传统知识库具有AI的知识库数据存储方式结构化数据为主(表格、文档),依赖手动分类和标签支持非结构化数据(文本、图片、音视频),利用嵌入技术(Embedding)自动编码为向量存储检索机制基于关键词匹配或固定规则(如SQL查询)支持语义搜索,通过向量相似度匹配理解用户意图(如“性价比高的手机”≈“低价高性能手机”)交互方式用户需输入精确关键词,返回静态结果支持自然语言对话(如提问“如何解决打印机卡纸?”),生成动态答案或分步骤指导知识更新依赖人工录入和定期维护,更新滞后。

小小笔记大大用处 2158

如何利用AnythingLLM部署在线硅基流动的DeepSeek满血版API

是一款开源的全栈应用程序,旨在帮助用户构建基于检索增强生成(RAG)技术的私有知识库。通过将本地的 PDF、Word 文档、文本文件等嵌入到本地向量库,并连接大型语言模型(LLM),用户可以通过对话或搜索的方式获取答案、见解,甚至生成摘要。通过AnythingLLM,可以方便的构建自己的知识库,不用再手动上传文档到模型中了。2025年02月14日 09:27。

kft1314的博客 3679

IBIS模型中的Pullup和Pulldown曲线详解:如何避免信号完整性设计中的常见错误

本文深入解析IBIS模型中Pullup和Pulldown曲线的关键作用,揭示其在信号完整性设计中的黄金法则。通过详细分析曲线特性、常见误区及验证方法,帮助工程师避免设计错误,优化高速PCB设计。文章还展示了曲线数据在动态终端匹配、串扰预测和电源完整性分析中的高级应用,提升设计效率和可靠性。

weixin_30275415的博客 451

AI驱动的CNC闭环加工系统:边缘实时控制与IIoT反馈实践

闭环控制是工业自动化的核心概念,指通过实时反馈调节系统输出以逼近目标值;其技术原理在于构建短于被控对象时间常数的确定性反馈链路,从而保障动态响应精度与稳定性。在智能制造落地中,AI正从离线分析工具演进为嵌入式实时决策单元,其核心价值在于将工艺知识模型化、控制指令轻量化、执行路径边缘化。典型应用场景包括CNC加工过程中的振动自适应调参、刀具磨损在线补偿及多机协同优化。本实践聚焦FANUC 0i-MF平台,基于Modbus TCP硬实时通信与轻量LSTM+CNN融合模型,实现217毫秒级AI推理与PMC寄存器直

weixin_29704001的博客 323

满血版deepseek操作流程: cherry和anything的在线版671B使用

添加模型时,进入模型广场,找到deepseek-r1模型然后点击弹出窗口后点击复制,放入模型添加的界面中的模型ID中,点击添加模型,就好了,理论可以添加多个模型,请在模型广场看到很多模型的介绍后根据自己的需要进行添加。打cherry软件后,点击左下角的小齿轮,点击进入设置,选择硅基流动,将之前生成的api密钥复制放入其中,然后点击检查,下方出现绿色提示框就代表成功,没有成功刷新几次,删除其中的所有模型信息,然后点击下方的添加。网址:https://cherry-ai.com/

qq_45872037的博客 3835

BurpSuite实战:5分钟搞定DVWA的CSRF漏洞测试(附详细截图)

本文详细介绍了如何使用BurpSuite在DVWA靶场中进行CSRF漏洞测试,包括环境配置、攻击原理剖析、分步攻击演示及企业级防御方案。通过实战案例,帮助读者深入理解CSRF漏洞的危害与防护措施,提升Web应用安全防护能力。

weixin_30879169的博客 494

DeepSeek + AnythingLLM 简单三步搭建个人知识库,现在的我强的可怕!

你想过和自己聊天吗?你想通过对话的方式读一本书,或看一篇几万字的论文吗?如果你有以下需求之一:1. 想将自己积累了很久的笔记整合起来,方便自己分析。2. 想建立自己的素材库。3. 你(或你的孩子)想通过对话聊天的方式学习新知识。那么建议你跟着这篇教程,赶紧搭建一套个人知识库,来快速检自己想要的信息。主流的个人知识库软件有 AnythingLLM、Dify、Cherry Studio、MaxKB 等。产品Github 关注数使用方式知识库说明官网地址Dify64.7kweb。

2301_81940605的博客 7074

黑马程序员Pink的javaScript课程APIday4

本文摘要:介绍了JavaScript中日期对象的实例化方法(有参/无参)及三种获取时间戳的方式。讲解了DOM节点操作,包括节点查找(父、子、兄弟节点)、增加/克隆/删除节点的方法。详细说明了移动端touch事件和Swiper插件的使用,包括自动播放和小圆点配置。最后提及学成在线案例中表单验证和取消默认跳转的实现。

JLY19970726的博客 825

PyTorch深度学习实战(36)——Pix2Pix详解与实现

Pix2Pix 是基于生成对抗网络的图像转换框架,能够将输入图像转换为与之对应的输出图像,能够广泛用于图像到图像转换的任务,如风格转换、图像修复、语义标签到图像的转换等。Pix2Pix 的核心思想是通过对抗训练将输入图像和目标输出图像进行配对,使生成网络可以学习到输入图像到输出图像的映射关系。在本节中,将学习使用 Pix2Pix 根据给定轮廓生成图像。

盼小辉丶的博客 1万+

利用anythingLLM轻松搭建AI本地知识库

它是一种结合了信息检索(retrieval)和文本生成(generation)的混合方法,旨在通过利用大规模文本数据库中的相关信息来增强生成模型的表现。这种方法特别适用于需要高精度、上下文丰富回答的任务,如问答系统、对话系统等。

瓦罗兰特顶级C位的博客 1849

基于ADMM的TV正则化最小化稀疏实现图像重建

ADMM算法是一种求解带有约束条件的优化问题的有效方法,它可以将原问题分解成两个子问题,然后交替求解这两个子问题,直到收敛。为了解决这些问题,研究人员提出了许多图像重建方法,其中一种常用的方法是基于正则化的方法。在图像重建中,TV正则化是一种比较常用的正则化方法,可以有效地降低图像的噪声,并保持图像细节特征。通过本文的介绍和源代码的演示,我们可以看出基于ADMM的TV正则化最小化稀疏实现图像重建的方法是一种简单、高效、有效的图像重建方法,能够在一定程度上提高图像质量,对于实际应用具有一定的参考意义。

学习使你进步。 1762

全民AI时代:手把手教你用Ollama & AnythingLLM搭建AI知识库,无需编程,跟着做就行!

全民AI时代:手把手教你用Ollama & AnythingLLM搭建AI知识库,无需编程,跟着做就行!

Python单行客的博客 3万+

iqoo11如何获取root权限?

🏆本文收录于专栏,主要记录项目实战过程中所遇到的Bug或因后果及提供真实有效的解决方案,希望能够助你一臂之力,帮你早日登顶实现财富自由🚀;同时,欢迎大家!持续更新中,up!up!up!!

**My Coding Family** 5825

MinerU 系列教程 | 第二课:快速上手 -- 安装与第一次解析

本篇教程作为的第二课,将带你从零完成 MinerU 的环境搭建、模型下载,并成功运行第一次文档解析。上一课我们从宏观视角认识了 MinerU,本课开始正式动手实践。

weixin_43674738的博客 301

RAG 知识库搭建:Ollama+AnythingLLM 搭建本地知识库,大模型入门到精通,收藏这篇就足够了!

RAG就像是为大型语言模型(LLM)配备了一个即时查询的“超级知识库”。这个“外挂”不仅扩大了模型的知识覆盖范围,还提高了其回答特定领域问题的准确性和时效性。

瓦罗兰特顶级C位的博客 1108

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

【RAG检索增强生成】Ollama+AnythingLLM本地搭建RAG大模型私有知识库

本文将引导您通过结合使用Ollama和AnythingLLM这两个创新工具,在本地搭建一个高效、安全且易于管理的RAG(Retrieval-Augmented Generation)大模型私有知识库。这一过程不仅将简化模型的部署流程,还将使您能够在完全控制数据的前提下,充分利用LLM的强大能力。

寻道AI,探索AI无限可能! 3240

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

超简单!用 AnythingLLM+DeepSeek搭建个人AI 知识库,大模型入门到精通,收藏这篇就足够了!

今天给大家推荐一个 “懒人神器”——AnythingLLM。有了它,把电脑里的文档(不管是 PDF、Word,还是代码文件)变成能聊天的知识库,就像把文件拖进文件夹一样轻松!

huang9604的博客 1240

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

使用 AnythingLLM 轻松部署本地知识库,大模型入门到精通,收藏这篇就足够了!

AnythingLLM 是一个功能强大且灵活的工具,专为在本地环境中部署和管理知识库而设计。它支持多种数据格式的导入,并提供高效的搜索、索引和管理功能,适用于个人、团队或企业用户。

瓦罗兰特顶级C位的博客 614

利用DeepSeek与AnythingLLM搭建本地个人知识库指南

今天要介绍的是如何利用DeepSeek来搭建本地个人知识库。依托上一篇所述内容为基础,构建一个本地化的个人知识库系统。这一过程始于安装AnythingLLM——一款强大的工具,它赋予用户能力,利用先进的大型语言模型打造专属的智能知识库及聊天系统。想象一下,教师能轻松转化教学素材、课件为知识宝库,为学生提供定制化的学习辅导与即时答疑;学生则可在探索知识的旅途中,随时向这一智能系统提出疑问,迅速获得详尽解答与指引。首先,访问AnythingLLM官方网站。进行客户端的下载与安装。

m0_59164520的博客 3851

Ollama+AnythingLLM本地部署大模型DeepSeek,打造自己本地AI知识库

【喂饭教程】20分钟教会你本地部署DeepSeek-R1,并搭建自己的知识库(附Windows安装包+使用技巧),【AI】CherryStudio结合 Ollama 本地模型实现个人知识库,五分钟教你一键在WPS接入Deepseek,轻松配置API,实现智能对话、文档翻译等功能,全B站最用心的DeepSeek教程(没有之一),三分钟本地部署Qwen大模型,保姆级教程!超简单的部署教程,附安装包和微调文档!大模型如火如荼,DeepSeek异军突起,打造自己的AI知识库,学习大模型相关软件的使用和配合。

山塘小鱼儿的博客 1777

DeepSeek+AnythingLLM 搭建专属知识库,小白也能轻松拿捏!

DeepSeek+AnythingLLM 搭建专属知识库,小白也能轻松拿捏!

Gblfy_Blog 5748

【大模型】Ollama+WebUI+AnythingLLM搭建本地知识库

部署属于自己的大模型,优点:离线运行、隐私保护、开发和测试,配合AnythingLLM搭建本地知识库,同时支持API接口调用。

春天的波菜 2585

AI大模型 | 本地部署DeepSeek搭建知识库,Ollama+AnythingLLM

行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,,所以不管是我们总结内化的文件,还是在网上刷到的有用的信息,都可以用来丰富知识库。

star_nwe的博客 947
上一篇: 使用 Hugging Face Transformers 微调和部署 GPT 模型 | 教程
下一篇: 基于Ollama+DeepSeek+AnythingLLM轻松构建本地大模型知识库
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
