真牛!5分钟快速搭建一个AI知识库,大模型入门到精通,收藏这篇就足够了!

快速上手!LLaMa-Factory最新微调实践,轻松实现专属大模型 近日,源2.0开源大模型与LLaMA-Factory框架完成全面适配,用户通过LLaMA-Factory,即可快捷、高效地对不同参数规模的源2.0基础模型进行全量微调及高效微调,轻松实现专属大模型。 阅读详情

PandaWiki 是一款AI大模型驱动的开源知识库搭建系统,它最大的亮点就是将AI能力深度集成到知识管理中,提供:AI辅助创作 - 智能生成文档内容和建议AI智能问答 - 直接对话式查询知识库AI语义搜索 - 理解搜索意图,精准定位信息简单来说,这不只是一个文档管理工具,更像是一个会思考的智能助手!
下来进行安装。
脚本地址:

https://release.baizhi.cloud/panda-wiki/manager.sh

执行安装:

plaintext
[root@localhost ~]# chmod +x manager.sh[root@localhost ~]# bash manager.sh

关闭防火墙

plaintext
[root@localhost ~]# systemctl stop firewalld[root@localhost ~]# systemctl disable firewalld

浏览器访问:

plaintext
https://192.168.59.128:2443/  账号admin,密码:rscHzHcKdAktOEsEkGw4n68T2O55SMnM

点击文档,去获取KEY。

在这里插入图片描述

也可以通过URL导入

知识库访问地址:

​plaintext http://192.168.59.128/ ​

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书
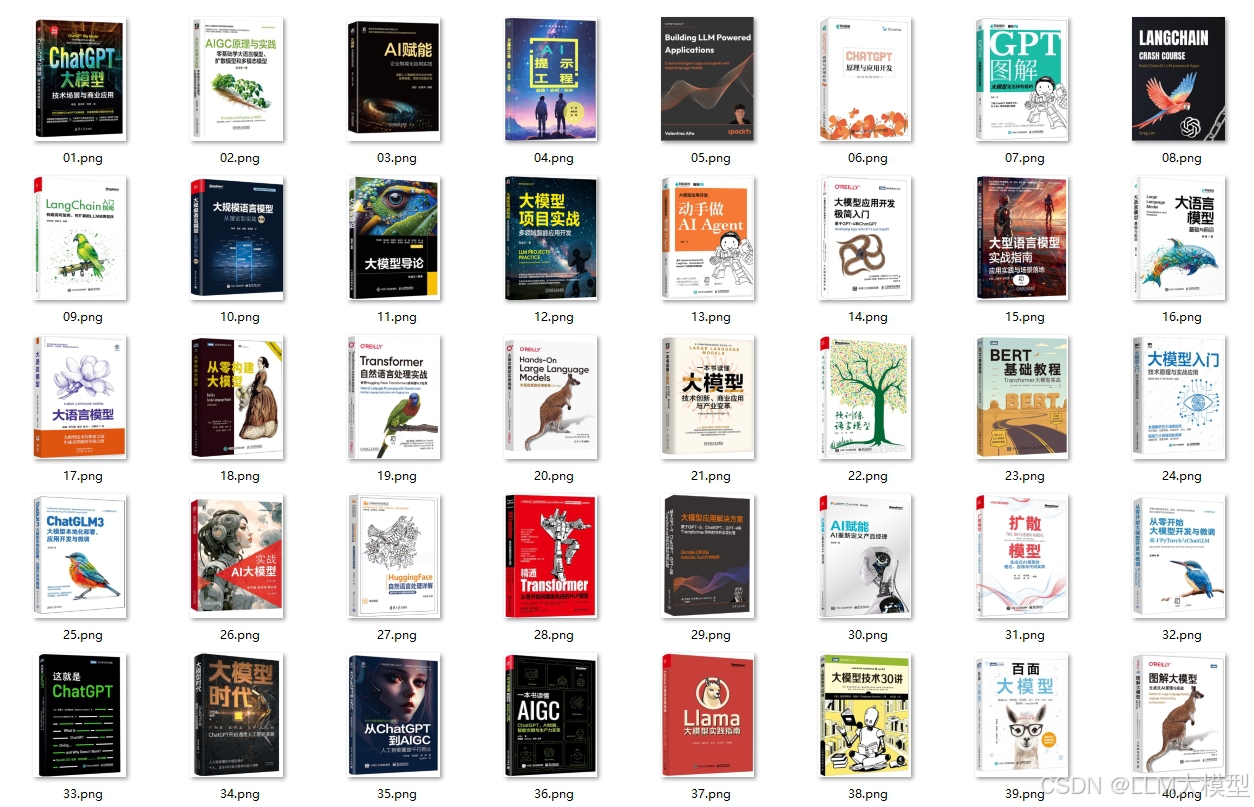
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
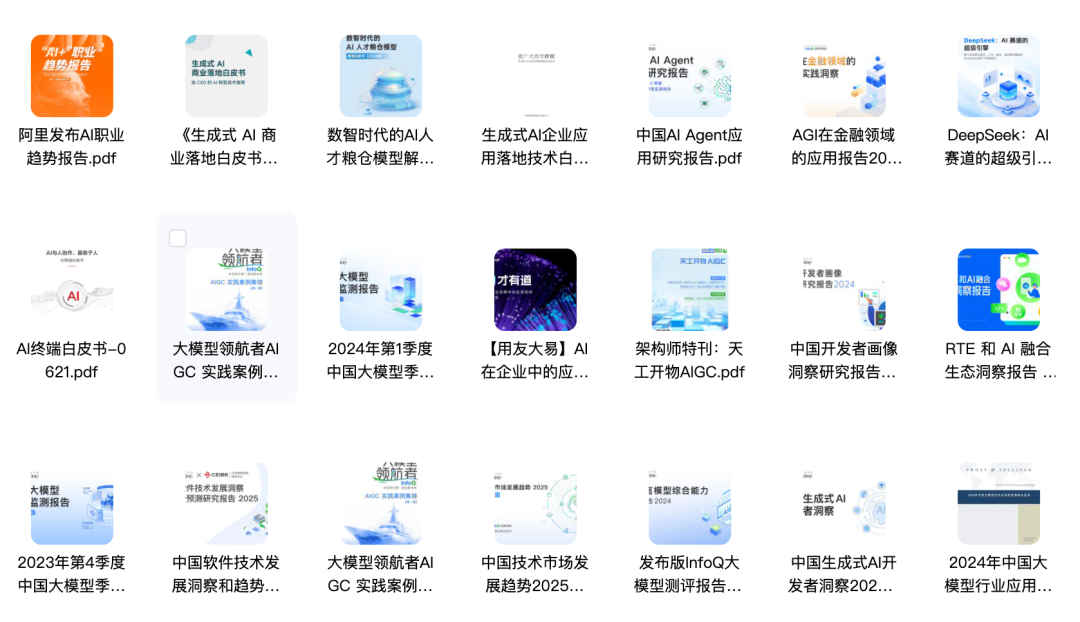
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

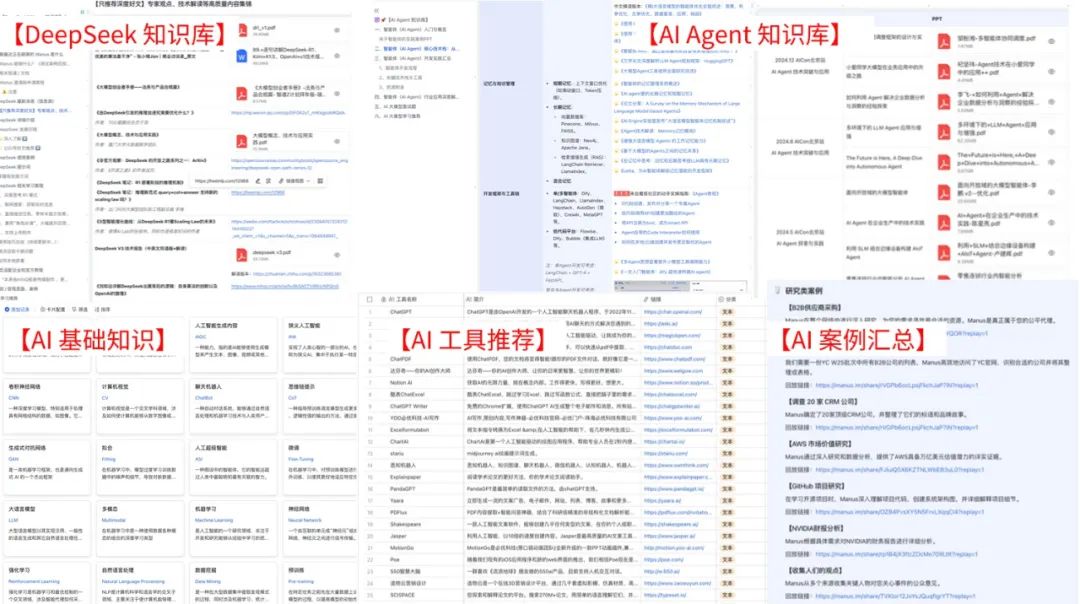
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
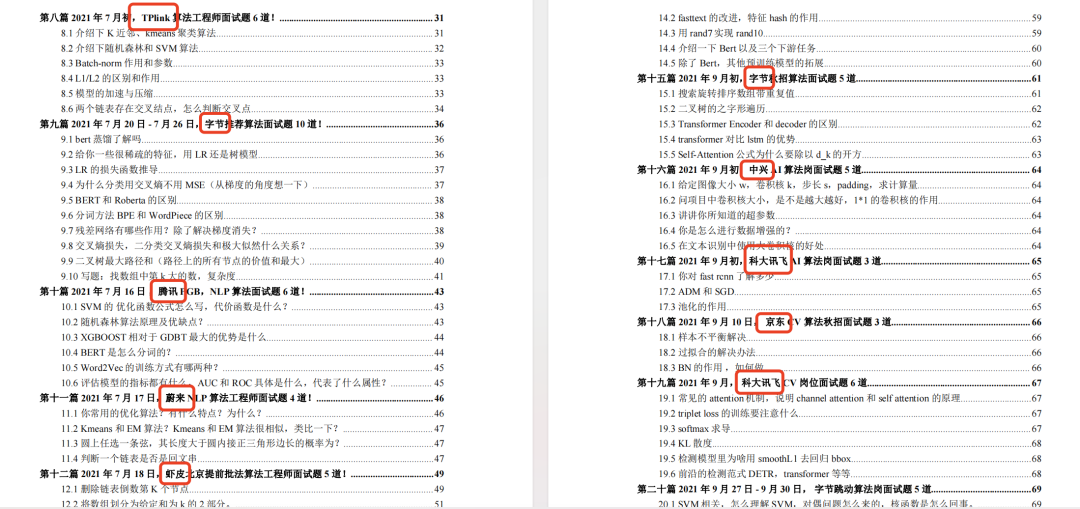
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
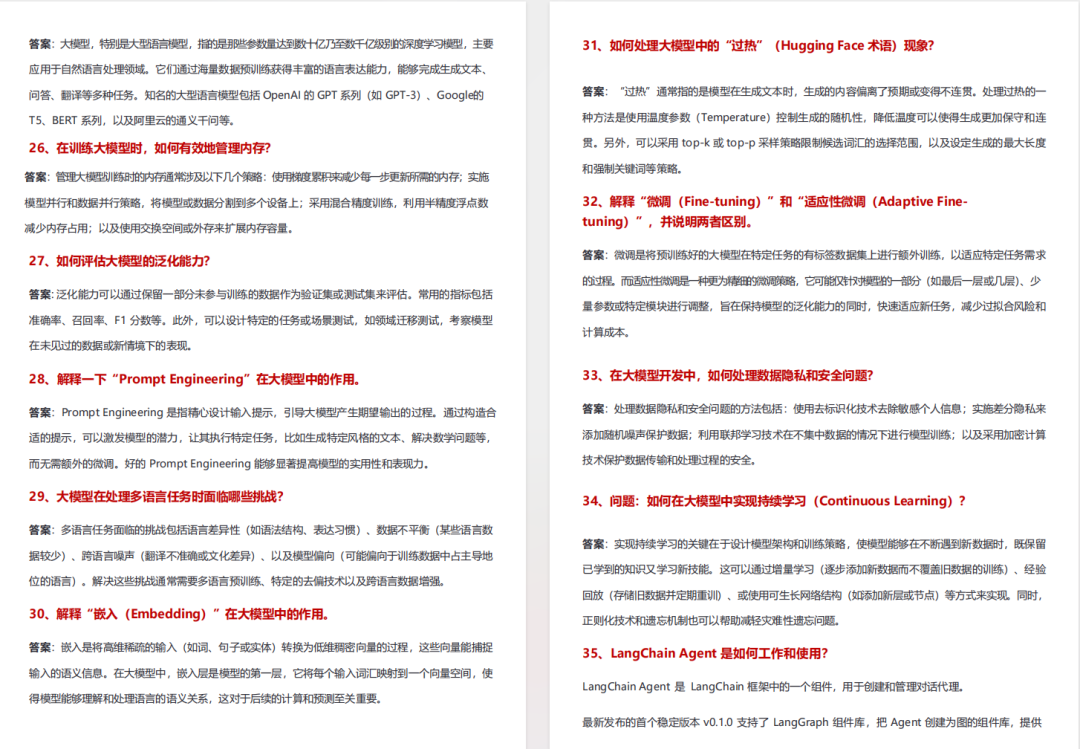
2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
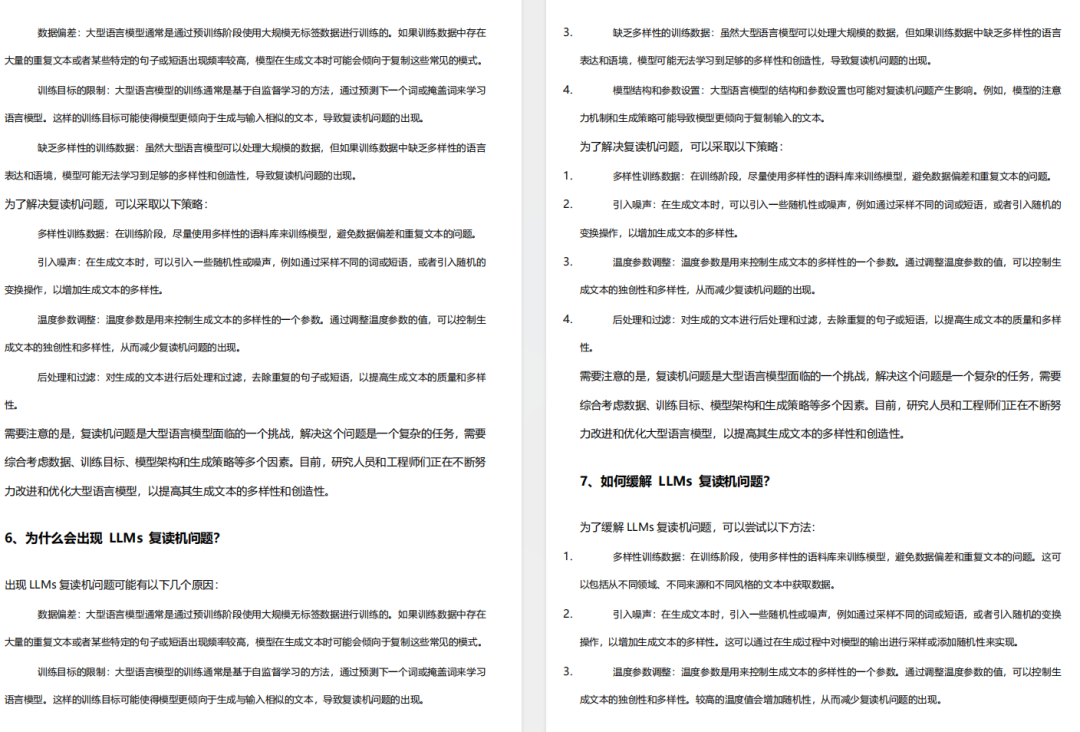
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

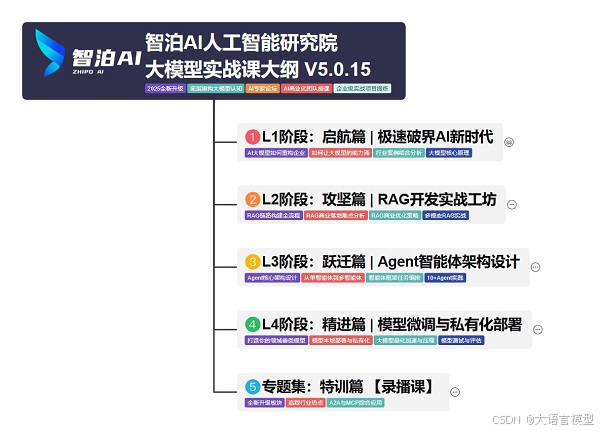
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
img

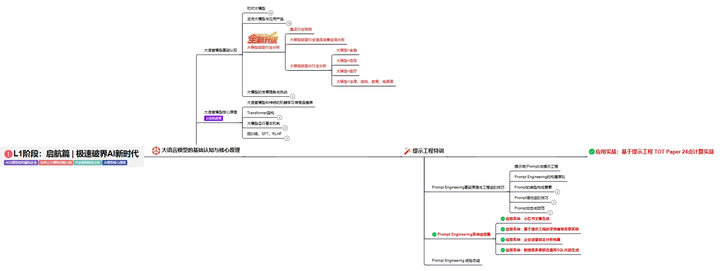
L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
img

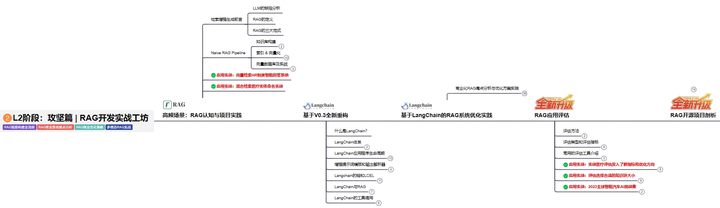
L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
img

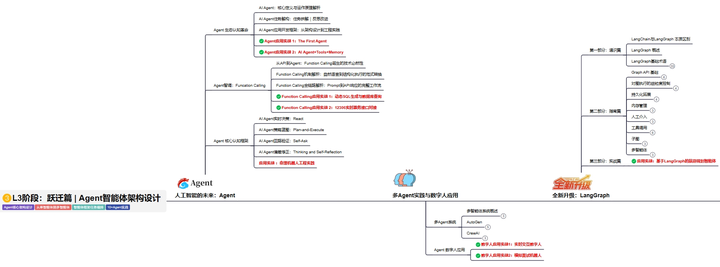
L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
img

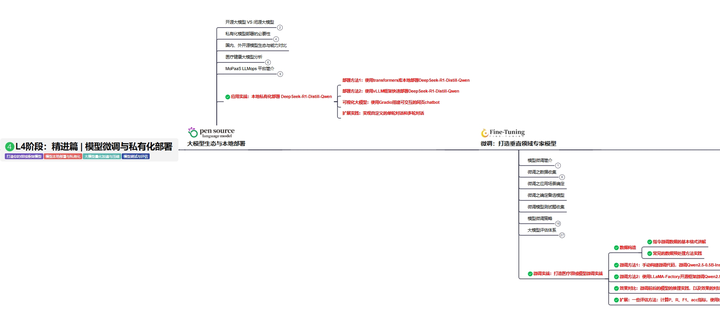
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

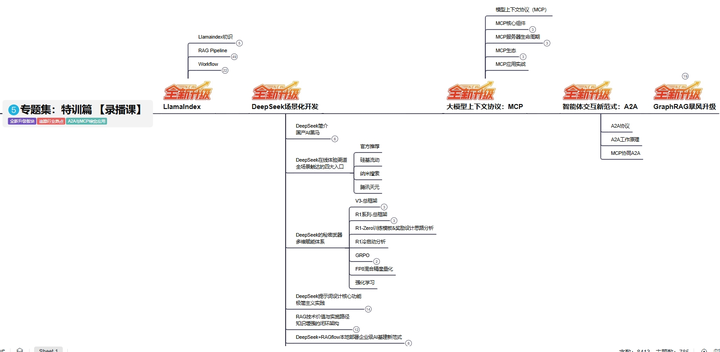
L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

保姆级教程:用RAGFlow从零搭建本地知识库,并实现精准检索(附Python代码) 本文提供了一份详细的RAGFlow实战指南,帮助用户从零搭建本地知识库并实现精准检索。通过Docker部署、PDF文档处理、高级配置技巧和检索API优化等步骤,结合Python代码示例,全面提升知识库的构建效率和检索精度。特别适合需要处理技术文档的开发者和团队。 阅读详情

相关推荐

2021年AI落地三大利器:模型即服务与低代码AI实践

AI模型即服务(MaaS)和低代码AI是推动人工智能从实验室走向产业应用的关键范式。其核心原理在于将预训练模型封装为高可用API或可视化界面,大幅降低数据准备、多语言适配与模型开发门槛。技术价值体现在缩短AI项目周期至7天内、重构团队协作模式,并实现按需付费的弹性成本结构。典型应用场景覆盖智能工单分类、方言语音识别、市场舆情分析等业务闭环环节。本文聚焦2021年5月真实产线验证的三项代表性能力——Roboflow自动标注、AssemblyAI方言ASR、Hugging Face Spaces低代码部署,揭示

chuliaoqiao4046的博客 361

一文读懂RAGFlow:从 0 到 1教你搭建RAG知识库

RAGFlow是一种融合了数据检索与生成式模型的新型系统架构,其核心思想在于将大规模检索系统与先进的生成式模型(如Transformer、GPT系列)相结合,从而在回答查询时既能利用海量数据的知识库,又能生成符合上下文语义的自然语言回复。该系统主要包含两个关键模块:数据检索模块和生成模块。数据检索模块负责在海量数据中快速定位相关信息,而生成模块则基于检索结果生成高质量的回答或文本内容。

python12345_的博客 8021

llama.cpp本地部署核心参数调优指南

大语言模型本地推理涉及模型量化、内存管理、硬件协同等基础技术概念。其核心原理在于将GGUF格式模型通过C/C++轻量运行时,按需加载至CPU/GPU内存并执行前向计算。技术价值体现在极致内存效率、跨平台一致性与细粒度硬件调度能力,广泛应用于边缘设备部署、离线代码生成、嵌入式AI及私有化知识问答等场景。本文聚焦llama.cpp实战中-c上下文长度、-t线程数、-ngl GPU卸载层数等关键参数的物理意义与协同调优逻辑,结合Qwen系列模型在MacBook、RTX 4090、树莓派等多平台实测数据,揭示参数背

aocaiti5781的博客 466

RAGFlow:基于OCR和文档解析的下一代 RAG 引擎

在对 RAGFlow 的探索中,我们可以清晰地看到其在RAG(Retrieval-Augmented Generation)领域中的重要地位和显著优势。RAGFlow作为一款下一代开源RAG引擎,不仅在问答对话方面表现出色,还具备高级内容生成的能力,例如长文生成等。这使得RAGFlow能够为用户提供更为全面和深入的服务,满足不同场景下的需求,尤其在企业级应用中发挥着重要作用。

FrenzyTechAI的博客 4万+

LLaMA-Factory可视化界面微调chatglm2;LoRA训练微调模型 简单案例

lore模型训练 参考:https://github.com/huggingface/peft。

weixin_42357472的博客 7795

当AI换脸遇上内容审核:Facefusion NSFW检测的技术伦理与用户自主权之争

本文探讨了Facefusion开源AI换脸工具中NSFW检测机制的技术伦理困境与用户自主权之争。分析了其多层次防御机制的技术实现与社区规避方法,揭示了开源软件在安全与自由之间的平衡难题,并提出了分层权限设计等社区实践方案。

weixin_29165725的博客 678

一键快速部署StableDiffusion的产品!真牛!

其弹性计算云服务器提供广泛、深入的计算平台,具有弹性、多样化选择、安全性、可靠性、易用性等特点。核心是一键安装脚本,包含所有必要的安装步骤,会自动配置环境并安装 Stable Diffusion 模型,还提供预设的配置文件和详细的文档说明,能帮助用户在本地环境中轻松部署,无需手动处理复杂的依赖关系和配置问题。:官网为www.aicpn.cn,用户注册登录并实名制后,可点击新建工作空间,选择想用的 GPU 和需要部署的镜像,部署完成状态变为运行中后,点击 Webui 就可以开始 AI 绘画体验。

2301_80471322的博客 539

stm32f103运行FreeRTOS使用DMA实现USART1不定长接收

使用DMA是实现USART1的不定长接收和发送数据。接收采用FIFO缓存和队列的方式向应用层抛数据。首先定义接收和发送的缓存区,缓存区的大小根据收发数据量确定。DMA接收开启转移完成和转移一般中断。在中断中从缓存向FIFO转移数据。串口开启空闲中断,实现接收数据的分帧。分帧后的数据节点通过写入到队列。发送数据缓存的大小根据发送数据量调整。然后初始化串口和DMA。串口的发送数据接口函数。...

polaris_zgx的博客 1991

想试bge-large-zh-v1.5但没GPU?云端环境打开就能用

本文介绍了如何在星图GPU平台上自动化部署bge-large-zh-v1.5镜像,无需本地GPU即可快速调用中文文本嵌入模型。该镜像适用于语义搜索、内容聚类等场景,支持API调用与批量处理,帮助用户高效构建AI应用,实现开箱即用的模型推理与知识库集成。

SapphireFox37的博客 684

【OD统一考试(B卷)】比赛的冠亚季军,Python 解答

比赛的规则是 0 号和 1 号比赛,2 号和 3 号比赛,以此类推,每一轮,相邻的运动员进行比赛,获胜的进入下一轮,实力值大的获胜,实力值相等的情况,id 小的情况下获胜,轮空的直接进入下一轮。第一轮比赛,id 为 0 实力值为 2 的运动员和 id 为 1 实力值为 3 的运动员比赛, 1 号胜出进入下一轮争夺冠亚军,id 为 2 的运动员和 id 为 3 的运动员比赛,3 号胜出进入下一轮争夺冠亚军;2 号与 0 号,比赛进行季军的争夺,2 号实力值为 4,0 号实力值 2,故 2 号胜出,得季军。

梦想橡皮擦,专栏100例写作模式先行者,现象级专栏 《Python 爬虫 100 例》作者、《滚雪球学 Python 专栏》原创者 1万+

微波技术仿真:微波谐振器分析_(2).微波谐振器理论

谐振器是一种能够在特定频率范围内存储和释放电磁能量的器件。在微波频段,谐振器通常用于滤波、频率选择和能量存储等应用。一个理想的谐振器在谐振频率下能够存储无限大的能量,但在实际应用中,由于损耗的存在,谐振器的性能会受到一定限制。微波谐振器在微波通信、雷达系统、微波测量和微波电路设计等领域中发挥着重要作用。谐振器的设计需要考虑多个因素,包括谐振频率的精确控制、损耗的最小化、频率稳定性的提高和小型化设计。通过理论分析和仿真工具的使用,可以有效优化谐振器的性能,满足实际应用的需求。

2401_87715305的博客 932

看完50篇 AI for DV 论文,我觉得验证工程师暂时安全,但工作已经回不去了

《AI for DV:从50篇论文看芯片验证的智能化演进》摘要 芯片验证领域正经历AI技术带来的深刻变革。本文通过系统分析2012-2026年间50篇AI for DV领域论文,揭示了三个关键发现: 当前最成熟的AI应用是辅助决策(如测试选择、覆盖率优化),而非完全替代验证工程师; 技术演进呈现从单点工具到验证操作系统的转变,知识图谱和多智能体架构成为新趋势; 验证工程师角色将转向定义规则、设置边界和风险管控,类似"自动驾驶监督员"。 核心结论指出:AI不会短期内取代验证签字权,但会重构

weixin_41468466的博客 469

【GlobalMapper精品教程】094:GlobalMapper26简体中文版安装教程(附安装包下载)

【GlobalMapper精品教程】094:GlobalMapper26简体中文版安装教程(附安装包下载)- 基于深度学习的图像分析工具,用于自动识别土地覆盖分类、建筑物提取和车辆检测。新的太阳阴影分析工具,用于计算加载地形和 3D 要素的阴影。新的 GENERATE_SHADOWS 脚本命令允许自动执行这些计算。新增点云模型关键点自动识别。能够在自动点云分析工具中保存和加载自定义创建的要素模型。改进了像素到点中各种潜在重叠图像中 GCP 的自动识别。

智慧空间实验室 4882

bert-base-chinese实战指南:预置镜像赋能快速原型验证

本文介绍了如何在星图GPU平台上自动化部署bert-base-chinese预训练模型镜像,快速搭建中文NLP开发环境。该镜像预置了完整的依赖和模型,用户无需配置即可直接使用,可高效应用于文本情感分析、智能客服问答等场景,极大加速AI原型验证流程。

OnyxPanther23的博客 176

Simulink仿真模块 -Scope

如果您将 Scope 模块放在具有锁定链接的库或者锁定的库中,当尝试打开示波器窗口时,Simulink 会显示错误。要显示某个库模块中的内部数据,请为库模块添加一个输出端口,然后将此端口连接到您模型中的 Scope 模块。当您在示波器内可视化多个基于帧的信号时,部分帧大小为 1 的信号采样可能不会显示。当在示波器内可视化多个基于帧的信号时,部分帧大小为 1 的信号采样可能不会显示。如果在仿真开始时波形视图关闭,则当在仿真后打开波形视图时,波形视图将显示附加的输入信号的仿真结果。

jk_101的博客 3788

大语言模型原理与工程实践:手把手教你训练 7B 大语言模型 自动化训练框架

近年来,大语言模型(Large Language Models,LLMs)在自然语言处理领域取得了突破性进展。从GPT-3到ChatGPT,再到最新的GPT-4,这些模型展现出了惊人的语言理解和生成能力,引发了学术界和产业界的广泛关注。然而,训练如此庞大的模型不仅需要海量的数据和计算资源,还需要复杂的工程实践和优化技巧。本文将深入探讨大语言模型的原理,并以7B参数规模的模型为例,详细介绍如何构建一个自动化训练框架,使读者能够亲自动手训练自己的大语言模型。

AI天才研究院 1920

我靠AI写周报,结果被老板当场抓包

<p>上周五下午,我花了三分钟,让AI帮我生成了一份看起来无比完美的周报。它逻辑清晰、用词专业,甚至把我“摸鱼”的时间都包装成了“深度思考”。我满意地发给了老板。结果半小时后,我被叫进办公室。老板指着屏幕上的周报,面无表情地问:“你写的‘本周重点推进了与马斯克诉OpenAI案相关的法律风险研究’,是

365

微信小程序 - 下单账号和支付账号不一致,请核实后再支付(微信小程序或微信H5页面/微信公众号网页支付时报错:“下单账号和支付账号不一致,请核实后再支付”,买家微信支付时提示错误)详细排查和解决方案!

微信支付出现 “下单账号与支付账号不一致,请核实后再支付”微信小程序下单账号与支付账号不一致不让支付,微信公众号网页 微信H5页面JS-SDK支付时出现错误:下单账号和支付账号不一致,请核实后再支付,openId导致的微信中“下单账号和支付账号不一致”原因及解决办法,调用统一下单所传openId与实际支付用户的openId不一致,微信支付jssdk报错,检查了没有不一致依然报错怎么办,微信支付下单账号和支付账号不一致,请核实后再支付,微信支付功能用JSAPI支付,H5页面负责下单并支付jsapi,微信调起支

🏆 前端领域优质创作者 5328

绝对值得安装的 24 款 App

欢迎关注天善智能,我们是专注于商业智能BI,人工智能AI,大数据分析与挖掘领域的垂直社区,学习,问答、求职一站式搞定! 对商业智能BI、大数据分析挖掘、机器学习,python,R等数据领域感兴趣的同学加微信:tstoutiao,邀请你进入数据爱好者交流群,数据爱好者们都在这儿。 作者:  苏克1900公众号:第2大脑脑 这是「每周...

简书博客搬家测试账号 580

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

手把手教你微调大模型,零基础也能学会的AI实战教程,收藏这篇就够了

同时课程详细介绍了。

jennycisp的博客 1501

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

手把手带你搭建RAGflow,专业AI知识库的开源工具,RAGflow零基础入门到精通,看这一篇就够了!

在大模型应用的蓬勃发展中,检索增强生成(Retrieval-Augmented Generation,RAG)技术占据了举足轻重的地位。它就像是大模型的智慧助手,通过从外部知识库中检索相关信息,并将其融入到大模型的回答生成过程中,有效提升了大模型回答的准确性、可靠性和时效性,在问答系统、智能客服、文档摘要等多个领域都发挥着关键作用。上图是一个常见的AI应用的数据流向图,文档分块之后向量化存储到向量数据库,然后输入文本内容,形成prompt,从向量数据库检索相关的知识背景,发送给LLM之后,返回结果。

2401_85375298的博客 9287

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

【收藏】RAGFlow完全指南:手把手教你搭建大模型知识库

RAGFlow是一种融合了数据检索与生成式模型的新型系统架构,其核心思想在于将大规模检索系统与先进的生成式模型(如Transformer、GPT系列)相结合,从而在回答查询时既能利用海量数据的知识库,又能生成符合上下文语义的自然语言回复。该系统主要包含两个关键模块:数据检索模块和生成模块。数据检索模块负责在海量数据中快速定位相关信息,而生成模块则基于检索结果生成高质量的回答或文本内容。

大模型研究中心 3594

基于 RAGFlow 构建企业级智能知识库全流程指南(含图文详解)

此外,用户权限管理也是重要环节,不同部门、不同职级的员工应具备不同的访问和操作权限,以确保知识的安全与合理利用。例如,可分为技术研发、市场销售、人力资源、行政后勤等一级分类,每个一级分类下再细分具体的子类别,如技术研发下可分为软件开发、硬件设计、系统架构等。元数据包括数据的标题、作者、创建时间、所属部门、关键词、文件类型、来源等。通过以上步骤,企业可以成功搭建基于 RAGFLOW 的内部知识库,实现知识的高效管理、快速检索和智能问答,提升企业的知识共享和创新能力。(二)数据清洗与预处理​。

beijingyaoyao的博客 3341

RAGFlow:重型知识库引擎

给大家推荐一款重磅产品。如果你对现在的知识库产品不满意,想要提升检索精确度,我推荐你试一试RAGFlow。它提供了更深度、更细致的选项,你可以根据自己文档的情况做针对性的调整。如果你们团队或者公司想要搭建一套本地知识库,我也建议你们先研究一下RAGFlow。我之前就在社群里说过:大概率,你们自己捣鼓出来的东西不会比它更好——还不如在它的基础上做定制化。RAGFlow是一套开源的RAG引擎。它重度集成了各种技术,而且更新很快。

m0_59164520的博客 7963

RAG+Agent人工智能平台:RAGflow实现GraphRA知识库问答,打造极致多模态问答与AI编排流体验

环节要求CPU >= 4 核如果你并没有在本机安装 Docker(Windows、Mac,或者 Linux), 可以参考文档 Install Docker Engine 自行安装。是Linux内核中的一个重要参数,它定义了一个进程可以拥有的最大内存映射区域数。内存映射区域通常指的是内存映射文件、匿名内存映射等。性能优化:通过增加vm.max_map_count的值,可以允许应用程序创建更多的内存映射区域,从而提高性能和效率。特别是对于需要频繁访问大量文件或数据的应用程序,这种优化效果尤为明显。

python1234_的博客 1万+
上一篇: AI Agent 的体系化分类与产品形态分析,大模型入门到精通,收藏这篇就足够了!
下一篇: 吴恩达教授开新课了!还是亲自授课,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2021原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值