探索Llama 3.1:开源模型的本地部署与创新应用实践

本地环境运行Llama 3大型模型:可行性与实践指南 Llama 是由 Meta(前身为 Facebook)的人工智能研究团队开发并开源的大型语言模型(LLM),它对商业用途开放,对整个人工智能领域产生了深远的影响。继之前发布的、支持4096个上下文的Llama 2模型之后,Meta 进一步推出了性能更卓越的 Meta Llama 3系列语言模型,包括一个8B(80亿参数)模型和一个70B(700亿参数)模型。Llama 3 70B 的性能媲美,全面超越 Claude 大杯,而 400B+ 的模型则有望与 Claude 超大杯和新版掰手腕。 阅读详情

1 Llama 3.1模型的突破性进展

在数字化转型的浪潮中,大型语言模型(LLM)以其卓越的处理能力和广泛的应用潜力,正在成为人工智能领域的新宠。

这些模型不仅在自然语言处理(NLP)领域取得了显著的进展,还在计算机视觉(CV)、多模态学习和科学计算等多个领域展现了巨大的应用潜力。

随着开源LLM的兴起,全球的Java开发工程师和研究者获得了一个宝贵的机会,可以在本地环境中部署和定制这些模型,以创造具有独特价值的应用程序。

2024年7月23日,Meta公司推出了Llama 3.1系列,这一举措为开源模型领域带来了新的活力。

特别是Llama 3.1 405B模型,它凭借其4050亿的参数量和128K Tokens的上下文长度,成为了Meta公司迄今为止规模最大的模型之一。
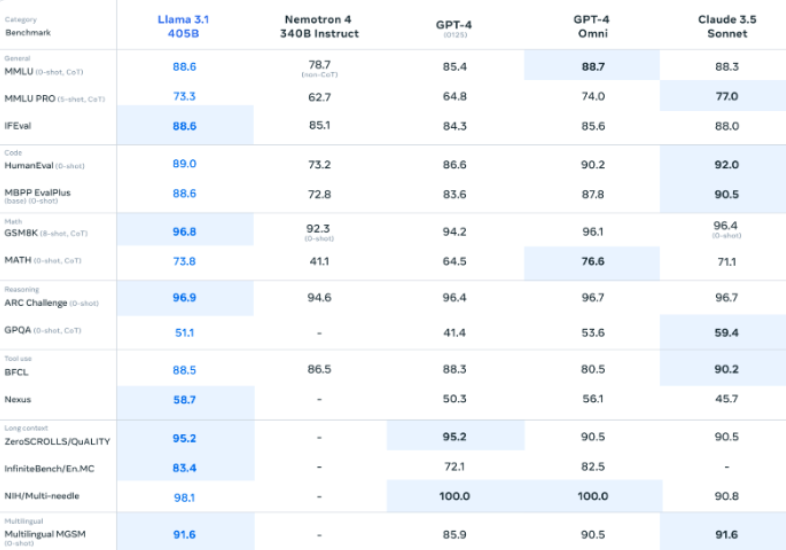
这一成就的背后,是超过15万亿的Tokens和超过1.6万个H100 GPU的强大计算资源,Llama 3.1在规模和性能上的显著提升,不仅在技术上实现了飞跃,更在多种任务中展现出了前所未有的灵活性和潜力。

2 Llama 3.1模型在业务场景中的实践案例

作为一名Java开发工程师,我对这一进展感到无比振奋。这些大型模型的出现,不仅推动了技术的进步,也为我们的日常工作带来了新的挑战和机遇。

它们提供了强大的工具,使我们能够构建更加智能和高效的系统,我们也面临着如何优化这些模型以适应特定应用场景的问题,以及如何确保这些模型的可解释性和安全性。

在实际工作中,我尝试将Llama 3.1 405B模型集成到一个客户服务机器人中,这个机器人需要处理大量的用户查询,并提供准确的回答。

通过使用Llama 3.1 405B模型,机器人能够更好地理解用户的意图,提供更加个性化的服务。这不仅提高了用户的满意度,也提高了服务的效率。

此外之外,我还尝试将Llama 3.1 405B模型应用于一个复杂的数据分析项目中,在这个项目中,模型需要从大量的数据中提取有价值的信息,并生成报告。

Llama 3.1 405B模型的上下文理解能力,使得它能够从数据中提取出更深层次的关联和模式,这对于数据分析来说是非常宝贵的。

这些大型模型也带来了新的挑战。它们的训练和部署需要大量的计算资源,这对于许多组织来说可能是一个负担,以及模型的可解释性仍然是一个挑战。尽管它们能够执行复杂的任务,但它们是如何做出决策的,对于人类来说往往是一个黑箱。

安全性也是一个重要的考虑因素。随着这些模型在各个领域的应用越来越广泛,确保它们的决策不会带来潜在的风险变得尤为重要。

3 使用教程

(1)模型下载好后,准备加载模型及启动Web服务等工作,新建 llamaBot.py 文件并在其中输入以下内容:

代码语言:python

代码运行次数:0

复制

Cloud Studio 代码运行

from transformers import AutoTokenizer, AutoModelForCausalLM

import torch

import streamlit as st


# 创建一个标题和一个副标题

st.title("💬 LLaMA3.1 Chatbot")

st.caption("🚀 A streamlit chatbot powered by Self-LLM")


# 定义模型路径

mode\_name\_or\_path = '/root/workspace/Llama-3.1-8B-Instruct'


# 定义一个函数,用于获取模型和tokenizer

@st.cache\_resource

def get\_model():

    # 从预训练的模型中获取tokenizer

    tokenizer = AutoTokenizer.from\_pretrained(mode\_name\_or\_path, trust\_remote\_code=True)

    tokenizer.pad\_token = tokenizer.eos\_token

    # 从预训练的模型中获取模型,并设置模型参数

    model = AutoModelForCausalLM.from\_pretrained(mode\_name\_or\_path, torch\_dtype=torch.bfloat16).cuda()


    return tokenizer, model


# 加载LLaMA3的model和tokenizer

tokenizer, model = get\_model()


# 如果session\_state中没有"messages",则创建一个包含默认消息的列表

if "messages" not in st.session\_state:

    st.session\_state["messages"] = []


# 遍历session\_state中的所有消息,并显示在聊天界面上

for msg in st.session\_state.messages:

    st.chat\_message(msg["role"]).write(msg["content"])


# 如果用户在聊天输入框中输入了内容,则执行以下操作

if prompt := st.chat\_input():


    # 在聊天界面上显示用户的输入

    st.chat\_message("user").write(prompt)


    # 将用户输入添加到session\_state中的messages列表中

    st.session\_state.messages.append({"role": "user", "content": prompt})


    # 将对话输入模型,获得返回

    input\_ids = tokenizer.apply\_chat\_template(st.session\_state["messages"],tokenize=False,add\_generation\_prompt=True)

    model\_inputs = tokenizer([input\_ids], return\_tensors="pt").to('cuda')

    generated\_ids = model.generate(model\_inputs.input\_ids,max\_new\_tokens=512)

    generated\_ids = [

        output\_ids[len(input\_ids):] for input\_ids, output\_ids in zip(model\_inputs.input\_ids, generated\_ids)

    ]

    response = tokenizer.batch\_decode(generated\_ids, skip\_special\_tokens=True)[0]


    # 将模型的输出添加到session\_state中的messages列表中

    st.session\_state.messages.append({"role": "assistant", "content": response})

    # 在聊天界面上显示模型的输出

    st.chat\_message("assistant").write(response)

    print(st.session\_state)

(2)在终端中运行以下命令,启动 streamlit 服务,server.port 可以更换端口:

代码语言:bash

复制

streamlit run llamaBot.py --server.address 0.0.0.0 --server.port 1024

需注意服务地址务必指定位0.0.0.0,否则无法通过浏览器访问

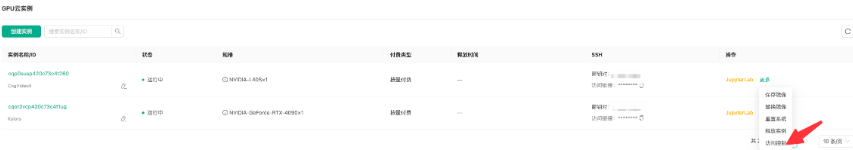
(3)接下来我们需要通过丹摩平台提供的端口映射能力,把内网端口映射到公网;

进入GPU 云实例页面,点击操作-更多-访问控制:
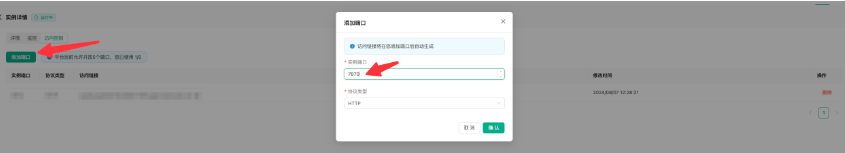
(4)点击添加端口,添加streamlit服务对应端口:
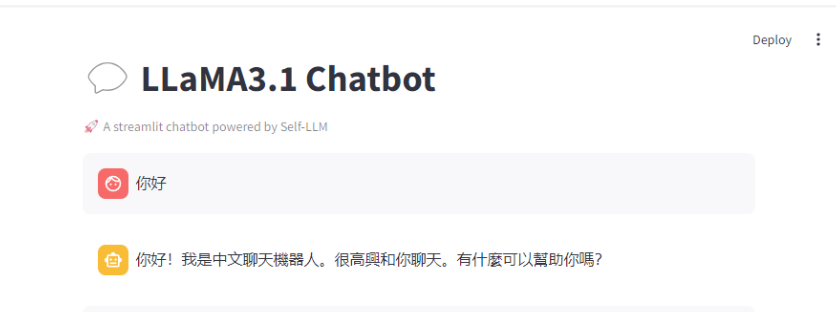
(5)添加成功后,通过访问链接即即可打开LLaMA3.1 Chatbot交互界面,并与其对话:
4 Llama 3.1在客户服务中的运用

在实际应用中,我尝试将Llama 3.1 405B模型集成到一个客户服务机器人中,这个机器人需要处理大量的用户查询,并提供准确的回答。

通过使用Llama 3.1 405B模型,机器人能够更好地理解用户的意图,提供更加个性化的服务。这不仅提高了用户的满意度,也提高了服务的效率。

我还尝试将Llama 3.1 405B模型应用于一个复杂的数据分析项目中,在这个项目中,模型需要从大量的数据中提取有价值的信息,并生成报告。

Llama 3.1 405B模型的上下文理解能力,使得它能够从数据中提取出更深层次的关联和模式,这对于数据分析来说是非常宝贵的。

程序员为什么要学大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

丹摩|探索Llama 3.1:提升开源模型部署与应用创新的最佳实践 对于数据分析这一领域而言,这一特性无疑是价值连城的,宛如熠熠生辉的明珠,为数据分析人员照亮了探索数据奥秘的道路,帮助他们更加高效地挖掘数据价值、洞察数据背后的真相。在这一商业应用实践中,模型通过从大量数据中提取有价值的信息,并生成报告,实现了数据分析过程的自动化与智能化,提升了业务决策的效率和精准度。我将Llama 3.1 405B模型应用于一个复杂的数据分析项目,模型能够从海量数据中提取关键信息,识别趋势和模式,并自动生成准确的分析报告,帮助决策者快速获取洞察,提升数据处理效率。安全性也是关键考虑因素。 阅读详情

相关推荐

最强开源模型 Llama 3.1 部署推理微调实战大全

在人工智能的浪潮中,大型语言模型(LLMs)已成为推动技术进步的关键力量。随着Meta公司最新开源的Llama 3.1模型的问世,我们见证了开源AI领域的一大飞跃。Llama 3.1以其卓越的性能和广泛的应用潜力,为开发者和研究者提供了一个强大的工具,以探索和实现各种复杂的AI应用。

寻道AI,探索AI无限可能! 9525

太强了!LIama 3.1正式发布

Datawhale干货编辑:量子位、Datawhale刚刚,LIama 3.1正式发布,登上大模型王座!在150多个基准测试集中,405B版本的表现追平甚至超越了现有SOTA模型GPT-4o和Claude 3.5 Sonnet。也就是说,这次,最强开源模型即最强模型。各大云厂商也在第一时间上线了的Llama 3.1的支持,价格是酱婶的:LIama 3.1官方正式发布首先来看模型能力。Llama...

Datawhale 649

R语言时间序列模型arima模型.rar

精心编写的R语言时间序列模型(主要为Arima模型),程序里我给出了很详细的备注,相信即使是编程小白或者统计小白也可以看懂。内容包含数据集

Google Colab 部署自己的机器学习项目

目录1. 介绍2.准备工作3.步骤3.1 进入 google driver:https://drive.google.com3.2 右键上传项目所在的文件夹:![在这里插入图片描述](https://img-blog.csdnimg.cn/20190703225748367.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,sha...

CaoChengtai的博客 6697

arima.zip_MATLAB arima_arima matlab_matlab_matlab arima_sarima

Matlab有关于ARIMA的源代码,内含几个M文件,包括估计、滤波、预报等。

VTK的编译和部署,配合c++和visual studio2022,VTK开发环境的配置

在官网选择最新的版本下载之后进行解压,然后再里面创建build目录,方便后面使用cmake进行编译。

dz131lsq的博客 3223

Llama3.1正式发布,Meta引领开源新时代

Llama 3.1系列模型包括8B、70B和405B三个尺寸,其中405B模型以其卓越的性能成为全球最强大的开源大模型之一。它在常识、可操纵性、数学、工具使用和多语言翻译等方面可与顶级AI模型相媲美。Llama 3.1 405B的上下文长度扩展到了128K,支持八种语言,并且在长文本摘要、多语言对话智能体和编码助手等高级用例中展现出色的表现。

2301_76161259的博客 1112

NeRF必读:Mip-NeRF总结与公式推导

由于远景近景的分辨率不同,导致经典NeRF对于多尺度场景的表达存在明显瑕疵:NeRF对于近景的重建比较模糊而对于远景的重建出现锯齿。简单粗暴的策略是supersampling,但是费时费力。相较于NeRF使用的位置编码(PE)方式,Mip-NeRF提出了积分位置编码的方式(IPE).这种编码方式可以多尺度地描述空间中的信息分布,make sense.

i_head_no_back的博客 6079

手把手教你免费使用【最强开源大模型Llama3.1】做医疗报告脱敏

大家好,今天我手把手教大家如何下载和使用目前最强大的开源模型llama3.1。只需要基本的Python基础即可!7月23日,Meta公司的LIama 3.1正式发布,登上大模型王座!在150多个基准测试集中,405B版本的表现追平甚至超越了现有SOTA模型GPT-4o和Claude 3.5 Sonnet。也就是说,这次,**开源模型第一次战胜了闭源模型!回头再看看百度CEO李彦宏前两天的话“开源是智商税”(如下图),只能说李彦宏又错了!

ytt0523_com的博客 1226

ComfyUI入门学习-教程篇

深入的 ComfyUI 教程,不同功能节点的详细指南。一个比较有意思的Comfyui教程,动画式学习。从安装到基础教程、高级教程再到各种工作流。非常全面,有教程有搭建好的工作流。

wincyfu的博客 1327

视频流推理的工程架构:YOLO模型如何做到单卡处理16路1080P实时流?

<think>我们只需要根据内容生成摘要,不超过150字。内容是关于YOLO模型单卡处理16路1080P实时流的技术分析,包括方案对比、架构设计等。摘要要简洁,突出关键点。</think>本文深度解析了YOLO模型单卡处理16路1080P实时流的技术方案,对比EagleEye、TensorRT+DeepStream、华为CANN及RK3588四条路线,重点介绍流水线架构、并发模型及显存优化,指出消费级显卡(如RTX 4090)即可实现高并发智能视觉分析。

2601_95807009的博客 162

DAMODEL平台|Llama 3.1 开源模型快速部署:从零到上线

传统的模型往往在面对长篇大论时会出现信息丢失或生成不连贯的情况,但Llama 3.1 405B不仅能够理解复杂的长文本,还能生成条理清晰、逻辑性强的回应。例如,如何优化这些庞大的模型以适应特定的应用场景,如何提高模型的可解释性,确保其决策过程透明且可信,如何保证模型在实际使用中不会出现安全隐患,都是我们在未来需要面对的重要问题。总的来说,Llama 3.1 405B的发布不仅推动了自然语言处理技术的发展,也为我们带来了更多创新的机会。Llama 3.1作为强大的语言模型,在客户服务领域展现出巨大潜力。

专注于 C/C++ 后端开发,涵盖基础语法、Linux系统与网络、MySQL数据库、常见算法及项目经验。 6881

到底什么是Harness工程?一篇文章从入门到企业落地全解析

随着OpenClaw爆火,Harness Engineering(驾驭工程)成为AI编程时代的热门概念,很多小白对其感到陌生。本文用通俗类比和真实案例,避开复杂术语,从基础定义入手,讲清Harness Engineering的核心逻辑——人类工程师设计“约束系统”(马具),让AI模型(烈马)安全高效地完成代码工作,同时拆解其核心组件、企业落地场景和实战成果,帮小白快速入门,读懂这项能解放人力、提升效率的新技术,轻松掌握它的核心价值和落地思路。

program哲学 3270

带你玩转,开源模型Llama3.1

开源LLM的生态系统非常活跃,出现了很多引人注目的模型,比如国际上的LLaMA和Alpaca,以及国内的ChatGLM、BaiChuan和InternLM(书生·浦语)等。 这些开源模型给开发者提供了在本地进行部署和定制的机会,帮助我们构建出具有独特价值的应用。 2024年7月23日,Meta公司推出了Llama 3.1系列,标志着开源模型发展的一个新阶段。 特别是Llama 3.1 405B模型,拥有惊人的4050亿参数和128K Tokens的上下文长度,成为Meta迄今为止最大的模型之一。

忆~遂愿的博客 3484

华为eNSP镜像包全集下载,包含CE6800、CE12800、NE系列等!

你好,这里是网络技术联盟站。昨天给大家介绍了win11、10下安装eNSP最新系列(1.3.00)并完美运行,附下载。从文章发布到发文前,一直有朋友想让瑞哥提供一下华为ENSP镜像包,今天安排!eNSP安装包、以及eNSP中所需要的镜像包(设备包)(CE、CX、NE40E、NE5000E、NE9000、USG)例如:导入一个USG设备包,eNSP中的USG5500和USG6000V都是可以启动的。如果你的报错“40”的话,那么打开Oracle VM VirtualBox这个虚拟机,删除对应报错的虚拟机,然后

网络技术联盟站 3万+

AI学习指南RAG篇(19)-API调用与集成

通过上述API调用示例,您可以方便地将RAGFlow与其他系统集成,实现数据集管理、文档处理、会话管理等功能。希望本文的介绍能帮助您更好地理解和使用RAGFlow的API。

俞兆鹏的博客 2546

亲身体验Llama 3.1:开源模型的部署与应用之旅

在人工智能的浪潮中,大型语言模型(LLM)正以其独特的魅力和潜力,成为深度学习领域的一颗耀眼明星。 这些模型不仅在自然语言处理(NLP)领域取得了令人瞩目的成就,还在计算机视觉(CV)、多模态学习和科学计算等多个领域展现出了巨大的应用前景。 开源LLM的兴起,为全球的开发者和研究者提供了一个广阔的舞台,他们可以在这个舞台上自由地探索、实验和创新。 2024年7月23日,Meta公司发布了Llama 3.1系列,这一事件无疑为开源模型领域注入了新的活力。

L040821的博客 2055

史上最详细的sqlmap使用教程

sqlmapsqlmap是一个自动化的SQL注入工具,其主要功能是扫描,发现并利用给定的URL进行SQL注入。目前支持的数据库有MySql、Oracle、Access、PostageSQL、SQL Server、IBM DB2、SQLite、Firebird、Sybase和SAP MaxDB等Sqlmap采用了以下5种独特的SQL注入技术基于布尔类型的盲注,即可以根据返回页面判断条件真假的注入。

大河之犬的博客 5万+

保姆级教程:Linux和Windows下本地化部署Vicuna模型

这是一篇详尽的Vicuna模型部署指南,它拥有强大的性能,可以与ChatGPT媲美,而且免费提供,甚至还支持微调。本文将带你一步步掌握在Windows和Linux系统下的部署过程,提供了全套必需的安装包及转化好的本地模型。下载即用。通过本文,你将能够自行启动并运行Vicuna模型,从而利用其强大的功能提升你的工作效率。详细的部署文档,让你清晰掌握每一个步骤。

无敌小怪兽_Zz的博客 4354

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Llama 3.1 模型:从部署到微调的全方位应用手册

在人工智能的浪潮中,大型语言模型(LLMs)已成为推动技术进步的关键力量。随着Meta公司最新开源的Llama 3.1模型的问世,我们见证了开源AI领域的一大飞跃。Llama 3.1以其卓越的性能和广泛的应用潜力,为开发者和研究者提供了一个强大的工具,以探索和实现各种复杂的AI应用。本文将深入探讨Llama 3.1模型的各个方面,从性能评估到模型的推理和微调,为读者提供一份全面的实战指南。

lvaolan168的博客 4778

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

本地安装Llama3.1与LobeChat可视化UI界面并实现远程访问大模型实战

本篇文章主要介绍如何在本地安装 Llama3.1,以及在本地部署 LobeChat 可视化 UI 界面,并且结合 Cpolar 内网穿透,实现公网远程使用 Llama3.1。就在前一阵,Meta 宣布推出迄今为止最强大的开源模型——Llama3.1 405B,Llama 3.1 是 Meta 最新推出的开源大语言模型,支持八种语言。它能够提供通用知识、数学计算、多语言翻译和工具使用能力,开放下载并允许开发者定制和微调。

优快云站内信: https://i.youkuaiyun.com/#/msg/chat/qyj19920704 2万+

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

教你轻松本地电脑部署最新Llama3.1,搭建免费本地大模型助手

在开始之前,我们要先搞懂两个概念和。看似写法差不多,但意思相差很大。是 Meta(Facebook 的母公司)发布的一系列最先进的开源大语言模型。Llama 3.1 系列包括 8B(80 亿参数)、70B(700 亿参数)和 405B(4050 亿参数)模型。其中,405B 是 Meta 迄今为止最大的模型,也是首个“前沿级”的开源模型。是一个开源的大模型管理工具,它提供了丰富的功能,包括模型的训练、部署、监控等。通过Ollama,你可以轻松地管理本地的大模型,提高模型的训练速度和部署效率。

m0_59164520的博客 2020

DAMODEL|Llama3.1的实践体验

人工智能技术正以惊人的速度重塑我们的日常生活与工作模式。在AI的广阔领域中,大型语言模型(LLM)凭借卓越的自然语言处理、强大的知识推理及广泛的适用场景,已成为众多企业和开发者竞相追逐的热点。其中,Llama3.1作为该领域的明星产品,凭借其高效性、智能性及高度的可扩展性,收获了广泛的认可与赞誉。

2301_78941518的博客 2027

【本地部署大模型】本地部署开源大模型的完整教程:LangChain + Streamlit+ Llama

在过去的几个月里,大型语言模型(llm)获得了极大的关注,这些模型创造了令人兴奋的前景,特别是对于从事聊天机器人、个人助理和内容创作的开发人员。大型语言模型(llm)是指能够生成与人类语言非常相似的文本并以自然方式理解提示的机器学习模型。这些模型使用广泛的数据集进行训练,这些数据集包括书籍、文章、网站和其他来源。通过分析数据中的统计模式,LLM可以预测给定输入后最可能出现的单词或短语。以上是目前的LLM的一个全景图。背景知识。

顶峰 944

Window 11本地部署 Meta Llama3-8b

近年来,随着大语言模型的飞速发展,大模型的本地化部署和应用技术也得到了充分重视,各种一键式安装程序层出不穷,大大降低了大模型的部署复杂性,进一步促进了大模型的应用。本文采用Ollama安装和部署Llama3,并利用开源WebUI接入,整个过程非常简单高效。

sheex2012的博客 6956
上一篇: Ollama完成本地模型的运行
下一篇: 有手就行的大模型教程:如何在个人电脑上部署盘古大模型
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值