AI机器人本地免费部署(部署Llama 3.1详细教程)

私有化部署 Llama3 大模型, 支持 API 访问 原文 https://ducafecat.com/blog/llama3-model-api-local通过 ollama 本地运行 Llama3 大模型其实对我们开发来说很有意义,你可以私有化放服务上了。然后通过 api 访问,来处理我们的业务,比如翻译多语言、总结文章、提取关键字等等。你也可以安装 enchanted 客户端去直接访问这个服务 api 使用。 阅读详情

图片

Meta公司发布了人工智能模型——Llama 3.1。

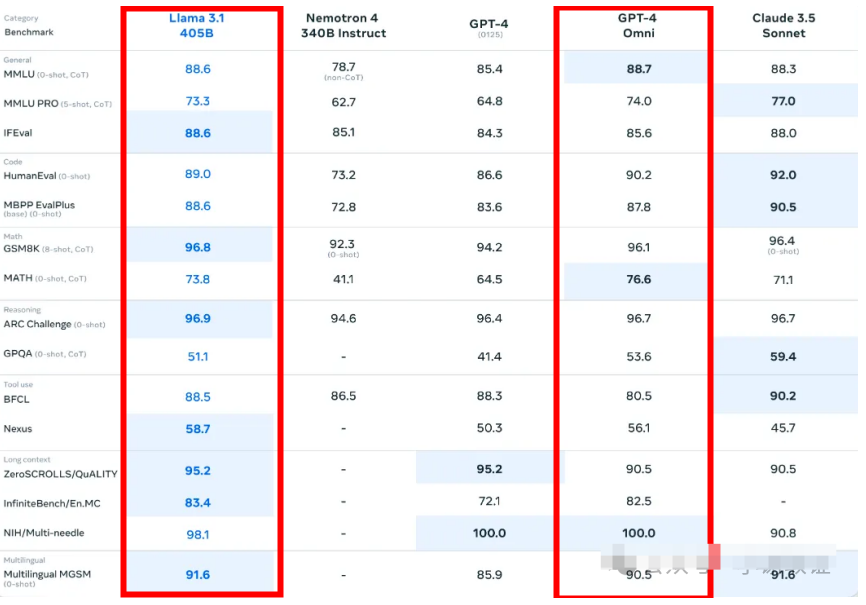
那么Llama 3.1 405B的效果怎么样?我们来对比一张图,横向对比一下GPT-4。
在这里插入图片描述

可以看出,Llama 3.1 405B在各类任务中的表现可以与GPT-4等顶级的模型相差无几。

那么,我们怎样才能用到这款强大的Llama 3.1 405B模型呢?最直接的方式是通过Meta.ai平台,但目前这一途径仅对美丽国的用户开放。
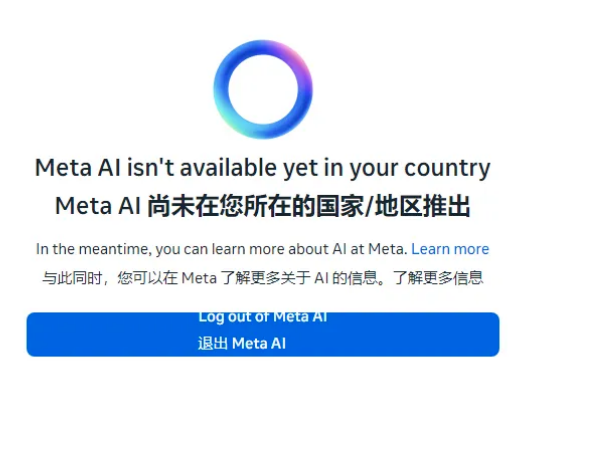
在这里插入图片描述

那有无适合平民用的大模型嘞。

接下来我们将在本地部署Llama 3.1 8B(环境所迫)

1.环境准备

(1)Windows10系统及以上的计算机

(2)内存要求:8GB内存可运行7B模型,16GB可运行13B模型,32GB运行可33B模型

(3)网络环境:不需要科学上网(翻墙)

(4)小谢此次搭建的电脑环境如图,又无GPU,这配置只能搭个入门级别的大模型。若有GPU,响应速度则更快。
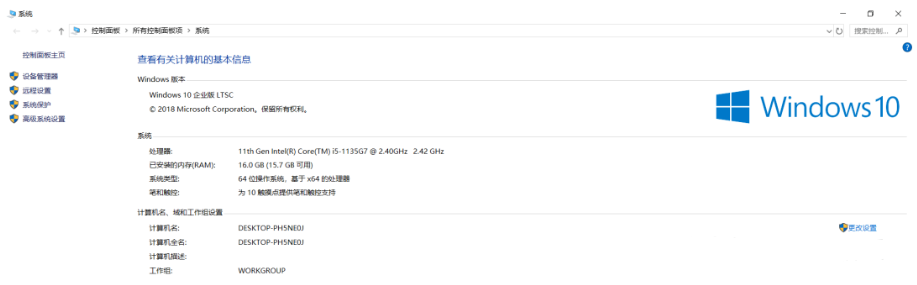
在这里插入图片描述

​

2.部署安装过程:

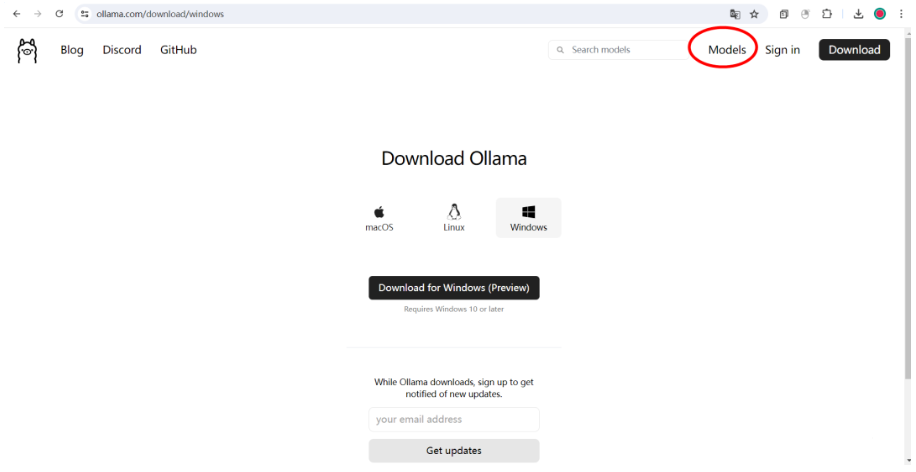
(1)从官网进行下载:https://ollama.com/download 选择windows系统版本,也可以看到它也同时支持mac系统和Linux系统。
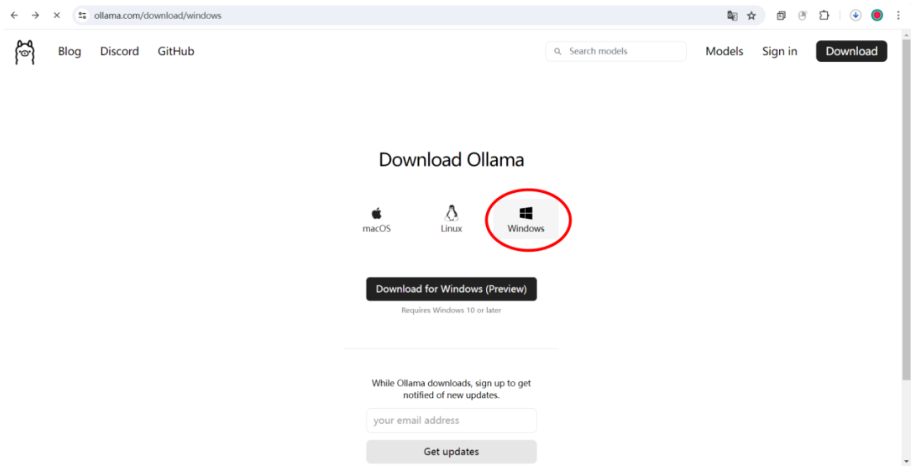
在这里插入图片描述

但似乎它的下载速度对我来说太不友好了。于是进行科学上网下载了安装包,如有需要后台私信回复Ollama即可获取百度网盘下载地址。
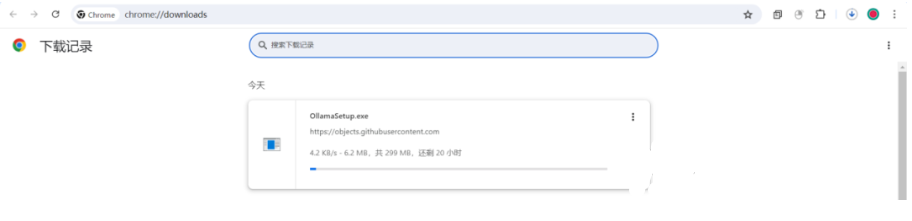
在这里插入图片描述

​

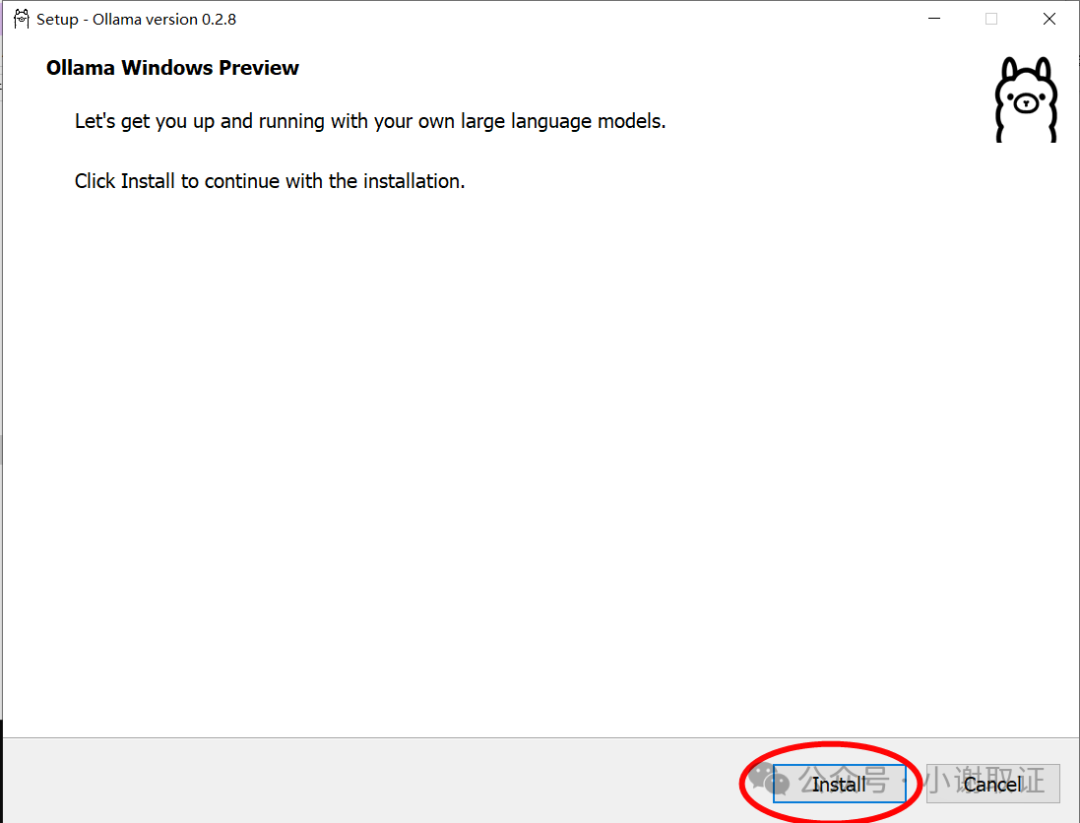
安装包下载完成点击安装

图片

​

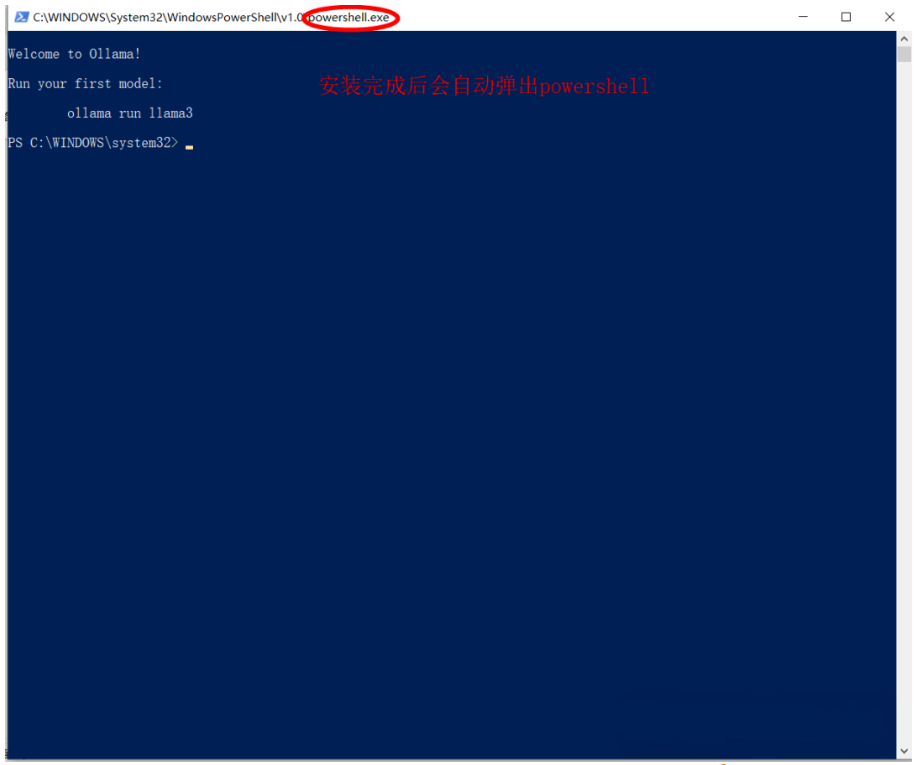
在这里插入图片描述

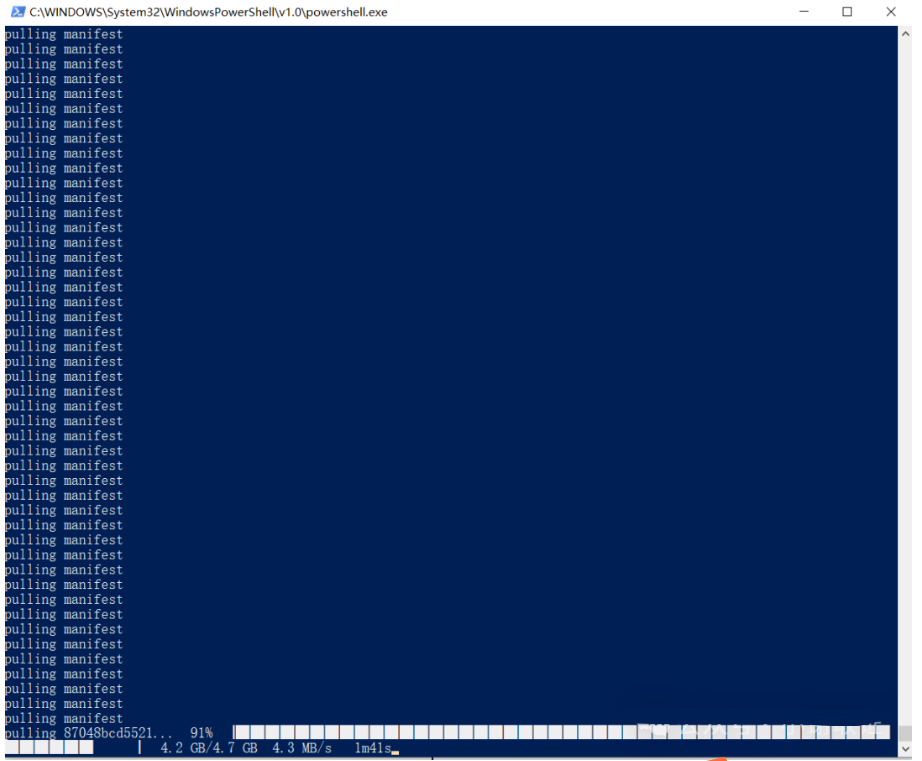
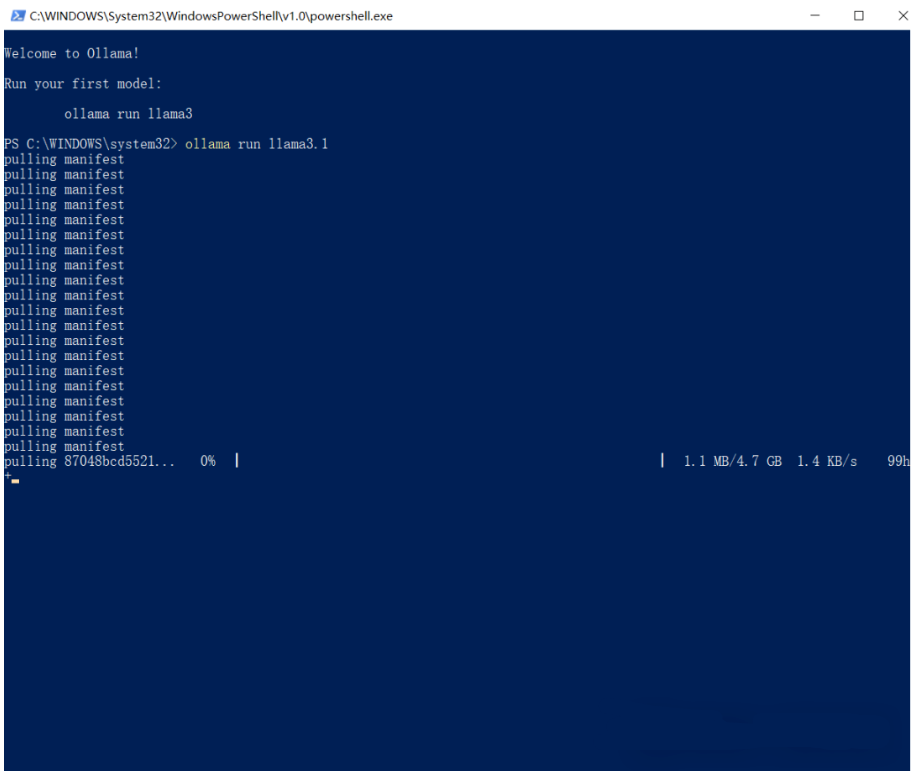
在此界面直接运行命令ollama run llama3.1,此时国内网络速度就非常快
在这里插入图片描述

耐心等待进度条跑完即可。

在这里插入图片描述

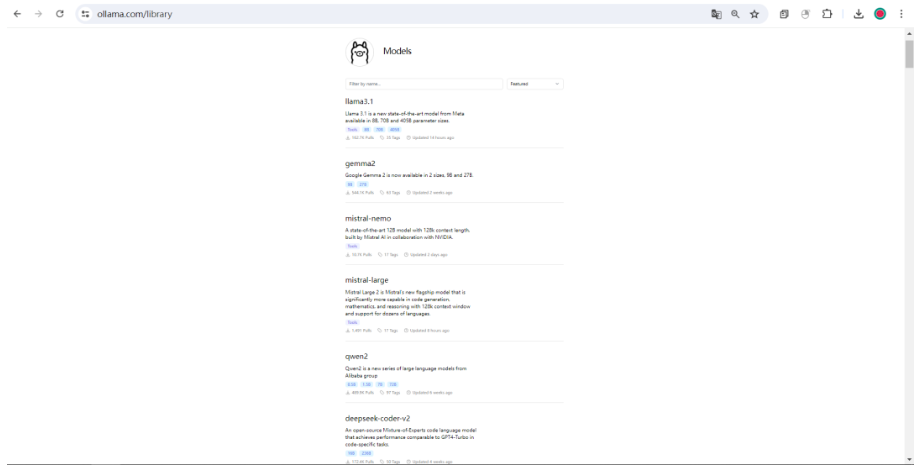
当然你想要其他的大模型可以回到官网,点击Models

在这里插入图片描述

在这里插入图片描述

​

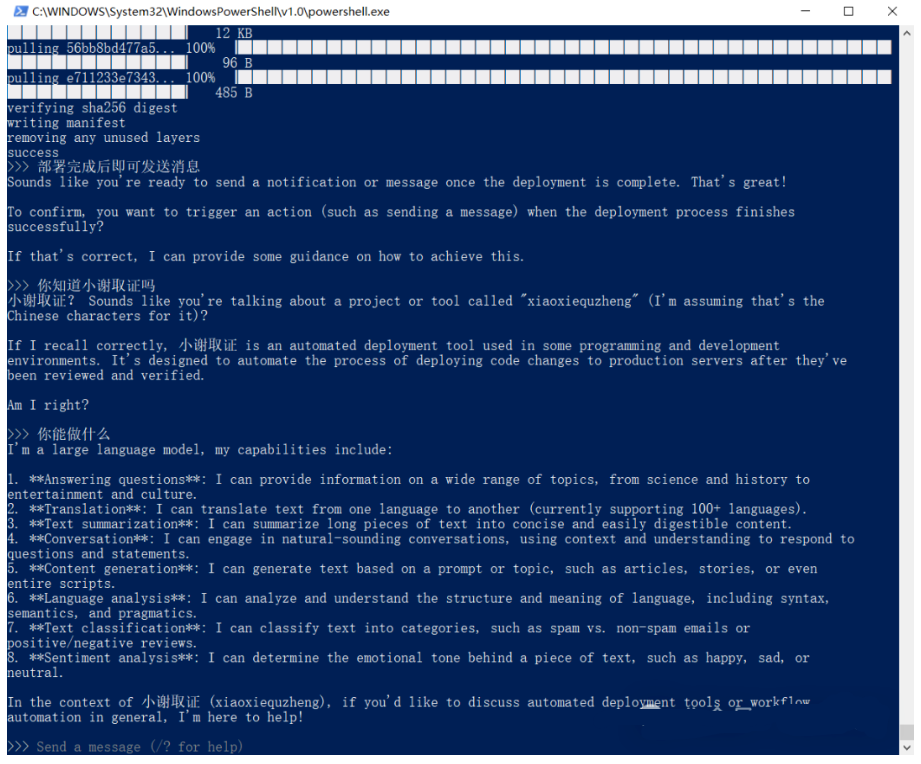
部署完成后可直接发送消息提问

在这里插入图片描述

所以它能做什么呢?

我们来看看它的自述:

I’m a large language model, my capabilities include:

\1. Answering questions: I can provide information on a wide range of topics, from science and history to

entertainment and culture.

\2. Translation: I can translate text from one language to another (currently supporting 100+ languages).

\3. Text summarization: I can summarize long pieces of text into concise and easily digestible content.

\4. Conversation: I can engage in natural-sounding conversations, using context and understanding to respond to

questions and statements.

\5. Content generation: I can generate text based on a prompt or topic, such as articles, stories, or even

entire scripts.

\6. Language analysis: I can analyze and understand the structure and meaning of language, including syntax,

semantics, and pragmatics.

\7. Text classification: I can classify text into categories, such as spam vs. non-spam emails or

positive/negative reviews.

\8. Sentiment analysis: I can determine the emotional tone behind a piece of text, such as happy, sad, or

neutral.

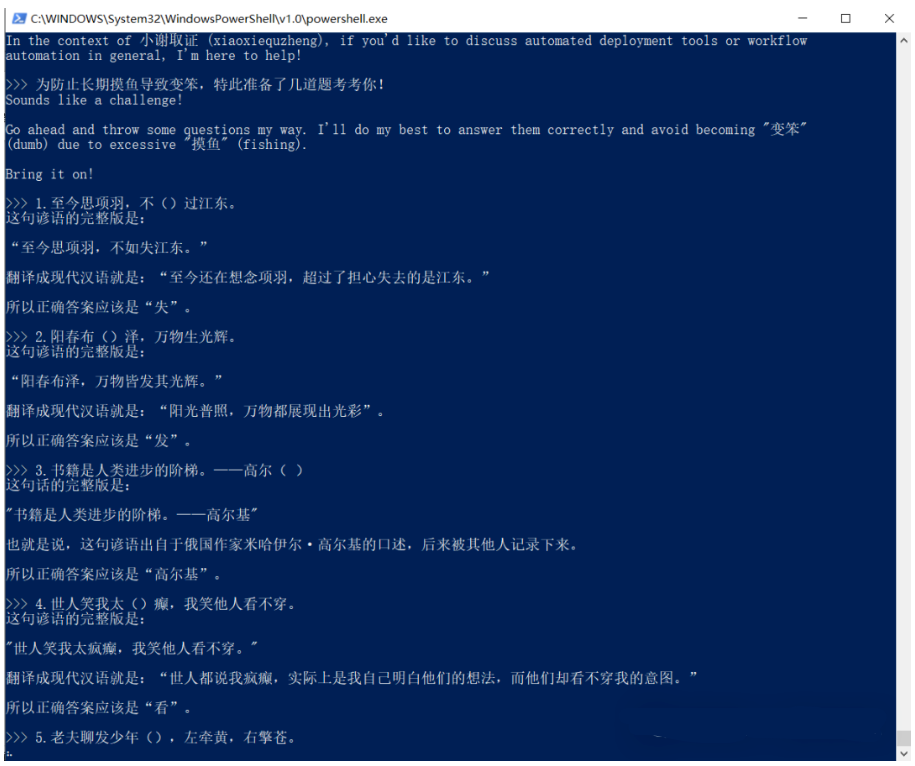
那咱们来看它的效果!我向它抛出了一个问题:

为防止长期摸鱼导致变笨,特此准备了几道题考考你!

1.至今思项羽,不()过江东。

2.阳春布()泽,万物生光辉。

3.书籍是人类进步的阶梯。——高尔( )

4.世人笑我太()癫,我笑他人看不穿。

5.老夫聊发少年(),左牵黄,右擎苍。

6.危楼高百尺,手可摘()辰。

7.君问归期未有( ),巴山夜雨涨秋池。

8.( )面边声连角起,千嶂里,长烟落日孤城闭。

9.料峭春风吹酒醒,( )冷,山头斜照却相迎。

10.( )闻琵琶已叹息,又闻此语重唧唧。

11.锦瑟无端()()弦,一弦一柱思华年。

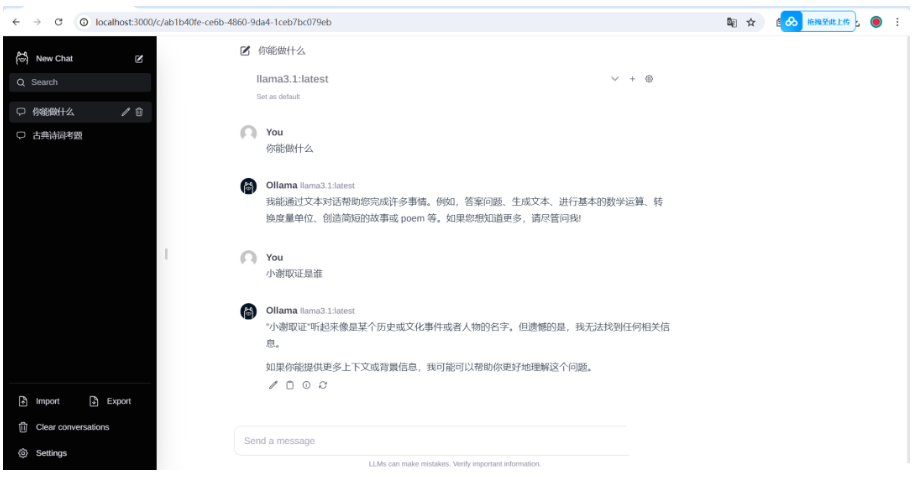
我们先来看一下部署在本地的大模型Llama 3.1 8B,看来效果不错。
在这里插入图片描述

​

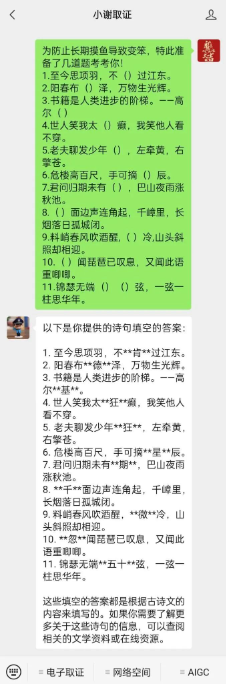
对比一下“小谢取证”的回答:

在这里插入图片描述

“小谢取证”直接出答案,部署在本地的大模型Llama 3.1 8B提供了更为详细的翻译。但是两者给出的答案都有些许错误。当然,这也取决于他们的模型是否强大。

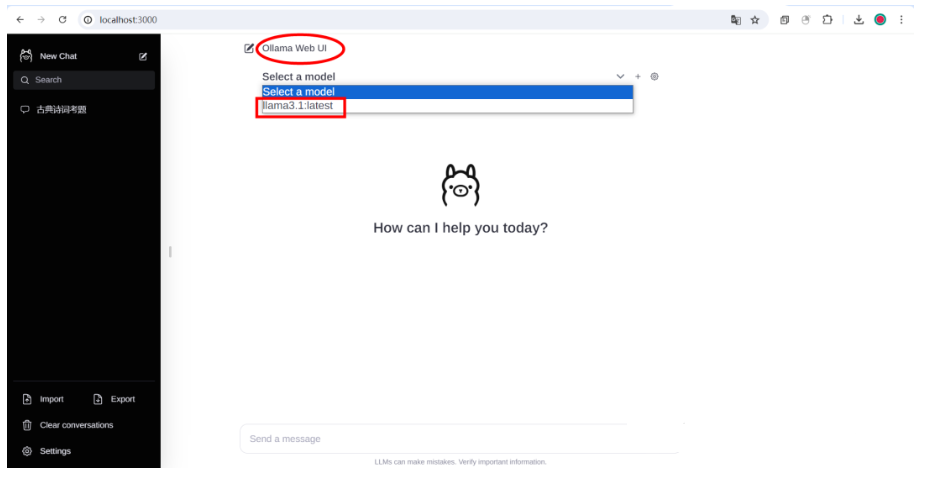
我们可以看到,我们部署到本地的界面是cmd界面下运行的,如果我们想可视化呢?先上效果图。
在这里插入图片描述

​

在这里插入图片描述

​

具体是用到Ollama Web UI,这边咱们直接使用大佬已集成好的环境直接使用。
在这里插入图片描述

​

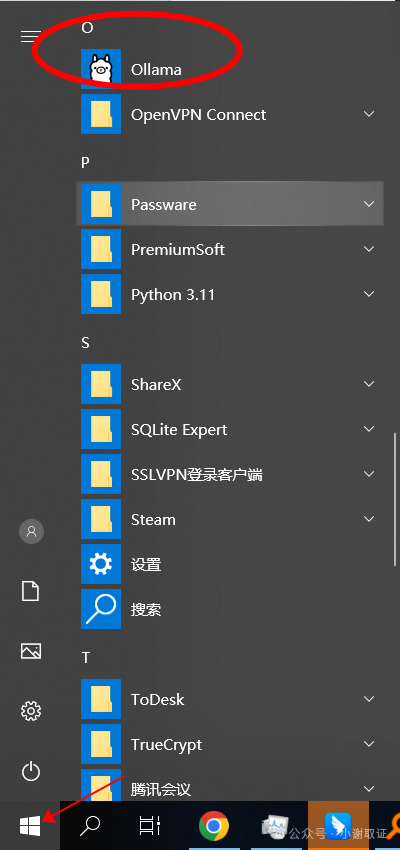
在我们使用完后,关闭该模型。那么我们下次如何重新打开呢

直接点击“开始”菜单,选择字母“O”,启动Ollama
图片

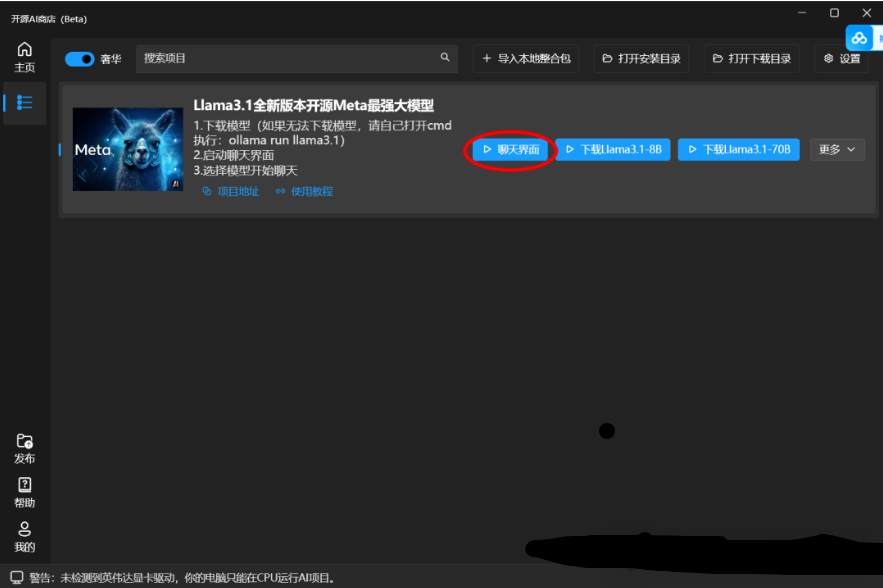
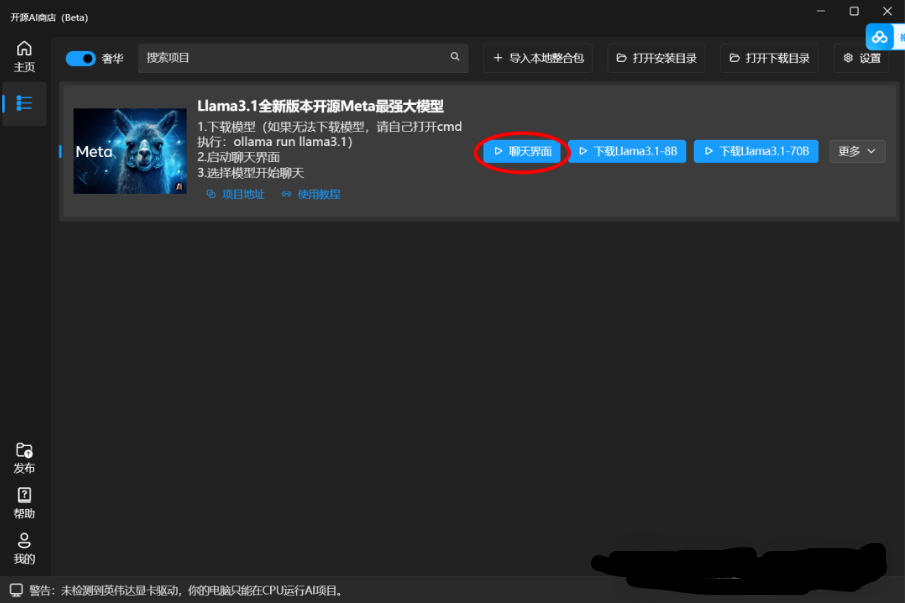
其次,直接打开该软件,点击聊天界面即可。在这里插入图片描述

​

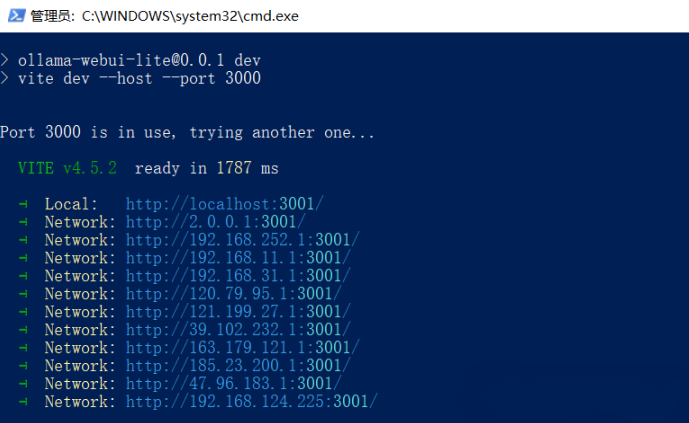
此时它就会自动调用命令。可以看到访问端口是3000

在这里插入图片描述

​

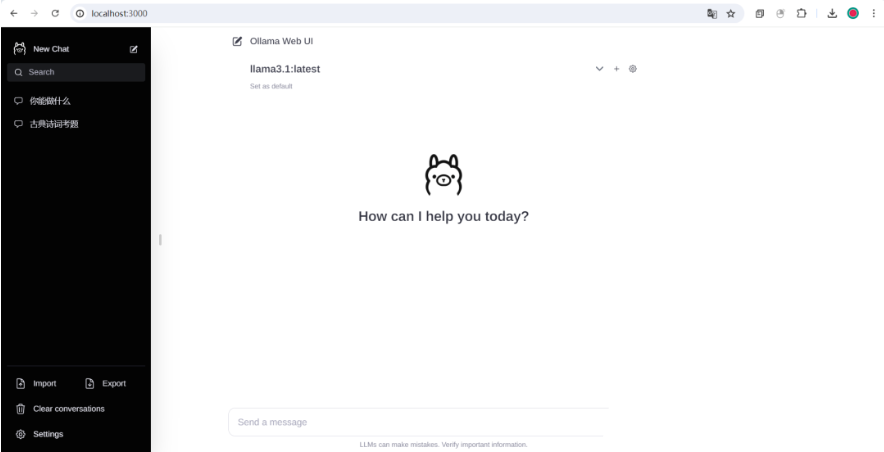
再使用http://localhost:3000/在浏览器访问即可。

在这里插入图片描述

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

AI本地部署全流程指南(2025年3月更新) 本文整合了Ollama官方文档、深度求索技术白皮书、清华大学实践案例等权威资料,如需获取完整部署脚本和测试数据集,可访问优快云资源库获取最新工具包。建议技术团队优先选择7B/32B模型进行商业化部署,个人开发者可尝试1.5B轻量版实现快速验证。 阅读详情

相关推荐

Ollama 本地部署大模型 | Windows本地部署 Llama3.1 大模型

Ollama是一个开源的大型语言模型部署工具,它可以帮助用户快速在本地部署运行大模型。类似于Docker一样,仅仅用几行命令就可以运行一个大模型。”,之后重启ollama,我把下载模型的目录设置在了"D:\ollama"目录下。由于Ollama在下载模型时,会自动下载到C盘,因此需要设置下载目录。Ollama有一套用于运行和管理模型的 REST API。这样就基本完成了Ollama在本地部署大模型。在安装模型之前需要到模型仓库中获取模型信息。剩下的就是通过三方工具开发自己的大模型应用。

静愚AGI 3115

AI大模型企业应用实战:Prompt让LLM理解知识

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

2401_84204413的博客 3212

Llama3.1的部署与使用

Llama3.1 是 Meta(原 Facebook)公司开发的一款超大型语言模型。它的发布时间是在2024 年 7 月 23 日,模型系列包括和。性能与特点详情1. 处理能力提升长文本处理能力增强,所有三款模型都具备改进的 128k 上下文长度,相比之前版本增加了 12 万个标记(token),模型容量是上一版本的 16 倍。多语言能力进步,提升了在英语、德语、法语、意大利语、葡萄牙语、印地语、西班牙语和泰语等八种语言对话场景中的推理能力。2. 语言理解与推理能力。

白乐天_ξ( ✿>◡❛)的博客 2759

(超详细)AI大模型部署安装,傻瓜式安装配置步骤,解决一切问题

Rerankers是Github上支持rerank模型本地化的一个开源项目,支持不同类型的rerank模型,比如transformer-based, API-based,RankGTP等。我理解transformer-based cross-encoder类型的模型是主流,所以后续采用的也是这种。我了解有限,建议参考github项目文档了解更全面的信息。

大模型研究中心 1万+

基于Llama 3搭建中文版(Llama3-Chinese-Chat)大模型对话聊天机器人

前面两篇博文,我们在笔记本部署了Llama 3 8B大模型,使用Ollama搭建了基于Web 可视化对话机器人。在使用过程中,大模型经常出现中文问题英文回答的问题。本博文就用Llama3-Chinese-Chat微调模型来解决这个问题……

老牛啊 9239

PPPoE上网配置不求人:华为路由器命令行操作指南(2023最新版)

本文提供2023年最新的华为路由器PPPoE上网配置命令行操作指南。通过详细的步骤讲解,从连接设备、创建拨号接口、绑定PPPoE客户端到配置内网与NAT,手把手教你完成配置,并附有验证排错方法,助你轻松实现稳定上网。

s4t5u6v的博客 679

保姆级教程:Linux和Windows下本地化部署Vicuna模型

这是一篇详尽的Vicuna模型部署指南,它拥有强大的性能,可以与ChatGPT媲美,而且免费提供,甚至还支持微调。本文将带你一步步掌握在Windows和Linux系统下的部署过程,提供了全套必需的安装包及转化好的本地模型。下载即用。通过本文,你将能够自行启动并运行Vicuna模型,从而利用其强大的功能提升你的工作效率。详细的部署文档,让你清晰掌握每一个步骤。

无敌小怪兽_Zz的博客 4354

Zabbix在Ubuntu 22.04上的性能优化与监控实战:从基础安装到高级配置

本文详细介绍了在Ubuntu 22.04系统上部署和优化Zabbix监控系统的完整流程,从基础安装到高级配置。内容包括MySQL数据库设置、Zabbix服务器与Web前端优化、性能调优策略以及实战监控场景应用,帮助用户构建高效的企业级监控解决方案。

sss66的博客 895

【LLMs+小羊驼】23.03.Vicuna: 类似GPT4的开源聊天机器人( 90%* ChatGPT Quality)

Vicuna(音标 vɪˈkjuːnə ,小羊驼、骆马)是基于LLaMA的指令**微调**模型(类似GPT的文本生成模型)与LLaMA: 是基础大语言模型,用大量质量一般的互联网文本数据训练,与GPT3 、PaLM类似Vicuna 用ShareGPT网站的用户分享的7w条ChatGPT对话记录,对 LLaMA进行监督质量微调训练(Supervised Finturning),性能超越了LLaMa和Stanford Alpaca,达到了与ChatGPT相似的水平。将单词切分为。

进一寸有一寸的欢喜 2021

FlashAttention 快速安装指南(避免长时间编译)

FlashAttention 编译太慢?本篇提供无需编译的预编译 wheel 快速安装方案,适配多版本 Python、PyTorch 和 CUDA,极大节省部署时间!

Junseer的博客 9720

Unreal5 从入门到精通之 如何实现 离线语音识别

本文介绍了如何使用离线语音识别插件 Offline Speech Recognition 进行本地语音转文本处理。该插件支持离线运行,用户可以通过下载并运行语言服务器(如 Vosk)来处理语音数据。文章详细说明了如何设置语言服务器、下载语言模型,并在虚幻引擎(UE)项目中配置麦克风和语音捕获。此外,还介绍了如何将 SoundWave 作为输入,以及如何通过节点将语音数据发送到语言服务器进行处理。最后,提供了相关文档链接以供进一步参考。

TxNet 906

教你轻松本地电脑部署最新Llama3.1,搭建免费本地大模型助手

在开始之前,我们要先搞懂两个概念和。看似写法差不多,但意思相差很大。是 Meta(Facebook 的母公司)发布的一系列最先进的开源大语言模型。Llama 3.1 系列包括 8B(80 亿参数)、70B(700 亿参数)和 405B(4050 亿参数)模型。其中,405B 是 Meta 迄今为止最大的模型,也是首个“前沿级”的开源模型。是一个开源的大模型管理工具,它提供了丰富的功能,包括模型的训练、部署、监控等。通过Ollama,你可以轻松地管理本地的大模型,提高模型的训练速度和部署效率。

m0_59164520的博客 2020

基于STM32的智能手环心率血氧体温监测系统(完整设计)

本文设计了一款基于STM32单片机的多功能智能手环系统,集成心率、血氧、体温实时监测功能,并支持运动数据管理与健康预警。系统采用MAX30102传感器实现心率血氧监测,DS18B20检测体温,ADXL345进行步数统计,通过OLED屏幕显示数据。研究通过低功耗硬件选型与模块化软件架构设计,实现了多参数同步采集、阈值预警及蓝牙数据传输功能。测试结果表明,系统在健康监测精度、续航能力及用户交互体验上均达到预期目标,为个人健康管理提供了实用解决方案。

3254968421的博客 701

Llama3.2 震撼发布,教你轻松本地电脑部署Llama3.2,搭建免费本地大模型助手

是 Meta(Facebook 的母公司)发布的一系列最先进的开源大语言模型。Ollama 是一个开源的大模型管理工具,它提供了丰富的功能,包括模型的训练、部署、监控等。通过Ollama,你可以轻松地管理本地的大模型,提高模型的训练速度和部署效率。此外,Ollama还支持多种机器学习框架,如TensorFlow、PyTorch等,使得你可以根据自己的需求选择合适的框架进行模型的训练。官网下载地址:https://ollama.com/download。

m0_59235699的博客 1852

Far planner 代码系列(33) 关于real_world_contour和contour_graph

我们知道far planner前部分的流程是这样子的: 对于特定的地图,如下: 我们要从surround_obs_cloud里抽取生成realworld_contour_,如下图所示: 在这时候,每个node的z坐标都是以机器人的高度定的。如图所示: 先去吃饭啦~待会回来在写 ...

博客 763

RH850从0搭建Autosar开发环境【23】- Davinci Configurator之DCM实操实现DID的读取写入

RH850从0搭建Autosar开发环境【23】- Davinci Configurator之DCM实操实现DID的读取写入,结合Developer实现

weixin_42412049的博客 1810

探索Llama 3.1:开源模型的本地部署与创新应用实践

在数字化转型的浪潮中,大型语言模型(LLM)以其卓越的处理能力和广泛的应用潜力,正在成为人工智能领域的新宠。 这些模型不仅在自然语言处理(NLP)领域取得了显著的进展,还在计算机视觉(CV)、多模态学习和科学计算等多个领域展现了巨大的应用潜力。 随着开源LLM的兴起,全球的Java开发工程师和研究者获得了一个宝贵的机会,可以在本地环境中部署和定制这些模型,以创造具有独特价值的应用程序。 2024年7月23日,Meta公司推出了Llama 3.1系列,这一举措为开源模型领域带来了新的活力。

忆~遂愿的博客 3564

mediasoup源码分析(二十)服务端架构设计

目录 简介 信令服务(房间服务) 调度服务 媒体服务 简介 流媒体服务器大的方向上可以分为上述三个模块。目前行业内都是分布式服务,独立部署。mediasoup信令与媒体之间虽然可以管道通信。但在行业内,服务之间通过管道通信用的少。 一般是rpc、mq,或者传统的tcp。这块licode架构比较不错,licode是信令和媒体服务通过MQ消息队列解耦。 下面介绍一下这三个服务主要功能,当然文中所说也是一家之言。 信令服务(房间服务) 信令服务也称为房间服务。有的企业把信令和房间分开,信..

lcalqf的专栏 1545

群晖本地搭建基于Llama2大语言模型的Chatbot聊天机器人详细教程

本文主要分享如何在群晖NAS本地部署并运行一个基于大语言模型Llama 2的个人本地聊天机器人并结合内网穿透工具发布到公网远程访问。本地部署对设备配置要求高一些,如果想要拥有比较好的体验,可以使用高配置的服务器设备.目前大部分大语言模型的产品都是基于网络线上的,如果我们本地想自己部署一个自己的大语言模型,该如何操作呢,下面介绍一款可以在自己本地部署运行的大语言模型Llama 2。

“路漫漫其修远兮,吾将上下求索。” 1782

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

打造本地ChatGPT,部署LlaMA3最简单的方法来了!

Llama3 本地部署大模型,这是最精简的一种方法,推荐大家先按照此方法去实践,使用起来。

xx_nm98的博客 1706

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

在langchian中集成本地部署的llama3.1大模型

Ollama是一个工具和框架,主要用于本地部署和使用大语言模型(Large Language Models, LLMs)。它旨在帮助开发者和组织方便地在本地或私有环境中运行和交互这些模型,避免依赖外部API或云端服务,保护隐私并降低成本。

huang9604的博客 1980

保姆级教程!本地部署最强开源语言大模型 Llama3 和中文微调版

2.1。

xzp740813的博客 7225

LLaMA 3.1 模型在DAMODEL平台的部署与实战:打造智能聊天机器人

LLama3.1 是 Meta(Facebook 母公司)发布的系列大语言模型之一,属于 LLaMA(Large Language Model Meta AI)模型系列。LLaMA 模型的目标是通过更高效的设计在保持模型性能的前提下,显著降低其计算和资源需求。LLaMA 3.1 是该系列的最新版本,继承了前面版本,如 LLaMA 1 和 LLaMA 2的许多技术优势,并对模型架构、训练数据和推理能力进行了改进。本文介绍了 LLaMA 3.1 模型的特点、优势以及在 DAMODEL 平台上的部署流程。

易辰的博客 3299
上一篇: 2024中国智能算力行业白皮书:产业图谱、市场规模等
下一篇: 大模型 Agent 应用的6种架构设计模式,你知道几种?
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值