【AI大模型】Transformer模型:Postion Embedding概述、应用场景和实现方式的详细介绍。

Transformer模型中的位置嵌入层 Transformer模型中位置嵌入层的设计目的是为了给输入序列中的每个位置提供一个独特的向量表示,因为Transformer摒弃了循环结构,无法像RNN那样通过递归过程直接捕捉序列的位置信息。这种编码方式确保了不同的位置会有不同的向量表示,并且在连续的位置之间,位置嵌入的变化体现出一种平滑过渡和周期性的特性,理论上可以覆盖任意长度的序列。在实际编程实现中,位置嵌入矩阵可以预先计算并存储,也可以在运行时动态生成,然后与输入序列的词嵌入矩阵相加,得到完整的带有位置信息的输入向量序列。 阅读详情

一、位置嵌入概述

\1. 什么是位置嵌入?

位置嵌入是一种用于编码序列中元素位置信息的技术。在Transformer模型中,输入序列中的每个元素都会被映射到一个高维空间中的向量表示。然而,传统的自注意力机制并不包含位置信息,因此需要额外的位置嵌入来补充这一信息。

位置嵌入通常是一个可学习的参数矩阵,其大小为 [sequence_length, embedding_dim]。这意味着对于每个位置,都有一个对应的嵌入向量。这些向量在训练过程中会被不断调整,以捕捉序列中各个位置的重要性。

\2. 位置嵌入的作用

位置嵌入的作用主要有两个方面:

(1)提供位置信息:使模型能够区分序列中的不同位置,从而更好地理解序列结构。

(2)增强模型表达能力:通过引入位置信息,模型可以更好地捕捉到序列中的依赖关系,从而提高整体的性能。

二、位置嵌入的类型

位置嵌入主要分为两种类型:

1.固定位置嵌入(Fixed Position Embedding):

(1)这种位置嵌入通常是根据预先计算的公式得到的,并在整个训练过程中保持不变。

(2)最著名的固定位置嵌入公式是基于正弦和余弦函数的,公式如下:

𝑃𝐸(𝑝𝑜𝑠,2𝑖)=sin⁡(𝑝𝑜𝑠100002𝑖𝑑𝑚𝑜𝑑𝑒𝑙)PE(pos,2i)=sin(10000dmodel2ipos)

𝑃𝐸(𝑝𝑜𝑠,2𝑖+1)=cos⁡(𝑝𝑜𝑠100002𝑖𝑑𝑚𝑜𝑑𝑒𝑙)PE(pos,2i+1)=cos(10000dmodel2ipos)

其中,𝑝𝑜𝑠pos 表示位置索引,𝑖i 是嵌入维度的索引,𝑑𝑚𝑜𝑑𝑒𝑙dmodel 是模型的隐藏层维度。

2.可学习位置嵌入(Learnable Position Embedding):

(1)这种位置嵌入是作为模型的一部分进行学习的,即在训练过程中通过反向传播不断更新位置嵌入。

(2)通常初始化一个形状为 [sequence_length, embedding_dim] 的张量,并在训练过程中通过反向传播更新这个张量。

三、应用场景

位置嵌入广泛应用于多种场景,包括但不限于:

1.自然语言处理(NLP):

(1)文本分类:在文本分类任务中,位置嵌入可以帮助模型理解句子中词语之间的相对位置关系。

(2)机器翻译:在机器翻译任务中,位置嵌入可以使模型更好地捕捉到源语言和目标语言之间的对应关系。

(3)情感分析:在情感分析任务中,位置嵌入有助于模型理解句子的情感倾向,尤其是在长句子中。

2.语音识别:在语音识别任务中,位置嵌入可以捕捉音频信号的时间序列特征,帮助模型更好地识别语音内容。

3.图像处理:在图像处理任务中,位置嵌入可以用于编码图像中像素的位置信息,帮助模型更好地理解图像的结构。

4.序列生成:在序列生成任务中,位置嵌入可以帮助模型生成有序的序列,如文本生成、音乐生成等。

四、Python实现示例

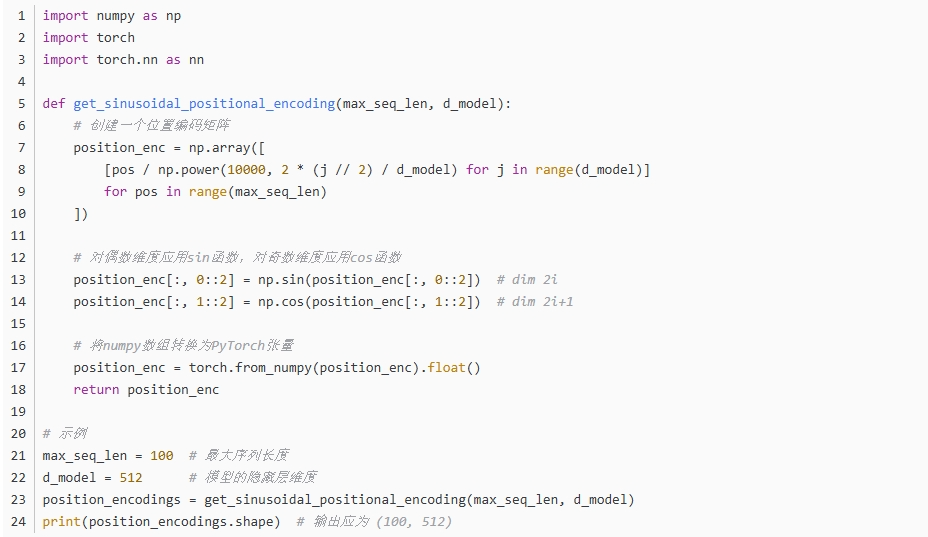
下面分别给出固定位置嵌入和可学习位置嵌入的具体实现。

\1. 固定位置嵌入的实现
图片

2.可学习位置嵌入的实现

图片

五、具体示例

\1. 自然语言处理中的应用

假设我们在进行一个文本分类任务,输入是一段英文文本。我们首先将这段文本中的每个单词转换为其词嵌入表示,然后加上位置嵌入,最后输入到Transformer模型中进行分类。

图片

\2. 语音识别中的应用

在语音识别任务中,输入是一个音频信号的时间序列。我们可以将每个时间点的声音片段转换为其特征表示,然后加上位置嵌入,最后输入到Transformer模型中进行识别。

图片

六、总结

位置嵌入是Transformer模型中一个重要的组成部分,它帮助模型理解输入序列中每个元素的位置信息。通过位置嵌入,模型可以更好地捕捉到序列中的依赖关系,从而提高整体的性能。位置嵌入可以分为固定位置嵌入和可学习位置嵌入,每种类型都有其适用的场景

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

深度解析 Transformer 模型中的位置嵌入(Positional Embedding) 在自然语言处理中,词语的顺序对句子的意义至关重要。然而,传统的自注意力机制无法区分词语的位置。本文深入浅出地介绍了**位置嵌入(Positional Embedding)**的概念及其在Transformer模型中的作用,解释了它如何帮助模型理解词语的顺序,从而提升文本处理的准确性。通过简单的例子和代码实现,带你一步步了解位置嵌入的原理与应用。无论你是NLP初学者还是进阶研究者,这篇文章都将为你揭开Transformer架构中这一关键组件的神秘面纱…… 阅读详情

相关推荐

Position Embedding 的解释及具体应用

Position Embedding 的解释及具体应用 这是我的第一篇博客,想把博客作为分享巩固自己学习感悟的地方。 最近做了一个要用到Position Embedding 的项目,于是就研究了一下。 词向量 词向量,顾名思义就是把每一个单词变成一个向量,以便于后续对文本进行处理,词向量在pytorch中是用nn.Embedding(n_letters + 1, dim)来实现的,这个函数相当定义了一个词向量矩阵,n_letters 是你文本中所有单词的个数,dim是你设置的词向量维数。为什么是max_s

qq_43613342的博客 2万+

transformer中的位置嵌入

本文为《Attention Is All You Need》精读中的一个拓展 论文- 《Attention Is All You Need》 由于transformer模型没有循环神经网络的迭代操作, 所以我们必须提供每个字的位置信息给transformer, 才能识别出语言中的顺序关系。 现在定义一个位置嵌入的概念,也就是现在定义一个位置嵌入的概念, 也就是???????????????????????????????????????? ????????????????????????????????,

scu-liu的博客 6836

【Transformer】学习笔记

参考视频提示:以下是本篇文章正文内容,下面案例可供参考词嵌入:将单词转换为向量表示,捕捉语义信息。位置编码:提供序列中每个位置的位置信息。位置嵌入:将词嵌入与位置编码相加,结合语义信息和位置信息。

qq_53236757的博客 1638

深度解析理解 Transformer 中的3大位置嵌入:绝对位置嵌入、相对位置嵌入和旋转位置嵌入

Transformer的关键组件之一是位置嵌入。你可能会问:为什么呢?因为Transformer中的自注意力机制是排列不变的;这意味着它计算输入中每个标记从序列中其他标记接收的注意力程度,但它没有考虑标记的顺序。实际上,注意力机制将序列视为一个标记集合。因此,我们需要另一个称为位置嵌入的组件,它可以考虑标记的顺序,并对标记嵌入产生影响。但是,位置嵌入有哪些不同类型,它们又是如何实现的呢?

star_nwe的博客 2500

BERT 详解

抛弃了传统的RNN和CNN,通过Attention机制将任意位置的两个单词的距离转换成1,有效的解决了NLP中棘手的长期依赖问题。Transformer的结构在NLP领域中已经得到了广泛应用,并且作者已经发布在TensorFlow的tensor2tensor库中。 海量的语料的基础上运行自监督学习方法为单词学习一个好的特征表示,所谓自监督学习是指在没有人工标注的数据上运行的监督学习。在以后特定的NLP任务中,我们可以直接使用BERT的特征表示作为该任务的词嵌入特征。所以BERT提供的是一个供其它任务迁

具身机器人和通用AI 7131

【十万字拆解】从零开始实现GPT-2(完整版)

本文是一篇 14 万字、从零硬核实现 GPT 的保姆级指南。内容全面覆盖四个阶段:①从最基础的 Bigram 语言模型切入,跑通数据处理与训练闭环;②仿照 Transformer 架构,深度研究 Multi-Head Attention、残差网络、LayerNorm 及 Dropout 的底层数学与代码实现;③从零构建BPE 分词器,对齐 GPT-2 规范;④从头搭建 GPT-1/2 工业级预训练流程,包含混合精度、梯度累积等十余项硬件级工程调优,并在 AutoDL 算力平台上从0开始训练!适合所有层次!

Pi_Nick的博客 1228

【AIGC】Transformer模型:Postion Embedding概述、应用场景和实现方式的详细介绍。

位置嵌入(Position Embedding)是Transformer模型中一个重要的组成部分,它解决了传统自注意力机制(Self-Attention)缺乏位置信息的问题。在本节中,我们将详细介绍位置嵌入的概念、应用场景以及为什么它对于Transformer模型如此重要。

weixin_51306394的博客 1570

WRF模型下中国土地利用数据替换USGS-24分类的完整实践指南

本文提供了在WRF模型中,将中国土地利用数据替换默认USGS-24分类的完整实践指南。详细阐述了替换下垫面数据的必要性,并分步讲解了数据准备、坐标转换、分类体系重映射、格式转换及配置文件修改等核心操作,旨在帮助用户提升针对中国区域的模拟精度。

salt的博客 777

LLM-learn-1

维度,使得输出特征维度与输入特征维度保持一致,方便后续的层归一化(Layer Normalization)和残差连接(Residual Connection)操作。具体实现:在 Transformer 中,MLP 通常包含两层全连接层。维度,然后经过激活函数(常用 ReLU)引入非线性,接着第二层全连接层再将特征从。它是一种最基础的前馈神经网络,由多层全连接(Dense/Linear)层组成。一般结构是:输入层 → 多个隐藏层(每层都是全连接+激活函数)→ 输出层。是两层全连接层的权重矩阵,

m0_53203911的博客 1218

TSMC40nmLP版图实战:从Design Rule解读到Cadence高效布局布线

本文详细解析了TSMC40nmLP工艺的版图设计实战,从Design Rule解读到Cadence高效布局布线技巧。重点介绍了40nm工艺中的关键设计规则,如最小线宽、间距规则和深N阱规则,并分享了Cadence Virtuoso中的高效工作流和射频模块设计技巧,帮助工程师提升版图设计效率和质量。

weixin_29250403的博客 378

1.3-----Simplify 3D切片软件:从新手困惑到高效打印的进阶设置指南

本文详细介绍了Simplify 3D切片软件在大型模型打印中的高效设置技巧,包括切片效率、支撑结构智能生成和精细参数调节等核心优势。通过实战案例和进阶参数设置指南,帮助用户从新手快速进阶到高效打印,显著提升3D打印质量和效率。

weixin_42552716的博客 422

嵌入(Value Embedding)和位置嵌入(Positional Embedding)的概念

嵌入(Value Embedding)和位置嵌入(Positional Embedding)的概念。不过,需要澄清的是,在标准的NLP术语中,"值嵌入"这个表述并不常见,而"词嵌入"(Word Embedding)是一个更为常见和标准的术语,用于表示将词汇表中的每个单词映射到一个高维向量空间中的技术。而"位置嵌入"则是用来处理序列数据中元素位置信息的嵌入技术。下面,我将分别用"词嵌入"和"位置嵌入"来举一个形象的例子,以便更好地解释这句话的意图。

weixin_52153243的博客 1262

Google antigravity 不支持你所在地区?手把手教你把账号改成支持地区

Google antigravity功能火爆,但国内老账号根本用不了🤬本文分享几种有效的账号国家地区切换方法,最快几分钟就能让antigravity直接亮起🔥

XiaoqiangClub的博客 2万+

视觉Transformers中的位置嵌入 - 研究与应用指南

注意力公式中的第一个矩阵乘法是 Q·Kᵀ=A,其中得到的矩阵 A 是一个大小等于 token 数量的正方形。当我们用 Qₛ 和 Kₛ 计算 Aₛ 时,得到的 Aₛ 的行 [0, 2] 和列 [0,2] 都与 A 交换。下一个矩阵乘法是 A·V=A,其中生成的矩阵 A 与初始 Q、K 和 V 矩阵具有相同的形状。注意力是根据三个矩阵(查询、键和值)计算得出的,每个矩阵都是通过将token传递到线性层而生成的。其中 PE 是位置嵌入矩阵,i 是沿着标记的数量,j 是沿着标记的长度,d 是标记长度。

冷冻工厂 1589

[Dify 案例实战] 构建一个基于 Dify 的个人写作助理工具-带绑定资源

想要一个懂你风格、能帮你写文章、润色文字、生成大纲的 AI 写作助手? 本文将带你从 0 到 1,完整实现一个 基于 Dify 工作流的个人写作助理工具。 我们会利用 Dify 的 LLM 节点、变量传递、文本处理、知识库与多轮对话能力.

技术小甜甜:传播可落地技术,帮助个人和企业降低解决真实场景问题的成本 276

华为OD机试 - 单词倒序(Python/JS/C/C++ 2025 A卷 100分)

华为OD机试 2025A卷题库疯狂收录中,刷题。

学Java,找哪吒 1226

transformer-位置编码: Position Embedding

(位置嵌入)用于在神经网络中为输入序列中的每个位置编码位置信息,以便模型能够识别输入元素的顺序,从而帮助模型更好地理解数据结构。例如,在模型中,输入数据通常是一个无序的序列。即使一个句子被分割成一系列单词或词向量后,模型无法直接感知这些词的顺序关系。而序列中的位置顺序可能对任务(如翻译、文本生成或分类)至关重要。因此,需要通过将位置信息显式地融入模型的输入中。位置编码能够提供一种的通用机制,使模型不仅能够理解绝对位置信息,还能捕获序列中元素的相对关系,从而提高序列处理能力。

liu7418520963的博客 2453

【R语言】基于Biomod2集成平台探究物种分布区的构建流程(SDMs)

我为什么想要写这个内容呢?其实我已经想了很久了,但是一直没有把所有的代码给理清楚,此外这将是我之后研究的主要方向。本博客讲述了如何基于Biomod2集成平台构建物种分布模型的全流程,以及我在使用该模型时的一些心得,同时还有我提供的一些小福利(一键处理代码),可以十分快捷的帮助你完成SDMs的构建,写出你的中英文论文。

amyniez的博客,欢迎交流讨论 3889

transformer-词嵌入和位置嵌入详解

答:一句话概括,Positional Encoding就是句子中词语相对位置的编码,让Transformer保留词语的位置信息。Attention 对位置不敏感的原因,因此其无法捕捉到输入序列中 token 的位置信息。一种可行的办法就是在输入的时候加入每个 token 的位置信息。首先,在任何一门语言中,词语的位置和顺序对句子意思表达都是至关重要的。传统的RNN模型在处理句子时,以序列的模式逐个处理句子中的词语,这使得词语的顺序信息在处理过程中被天然的保存下来了,并不需要额外的处理。

qq_45893319的博客 1087

Open3D 计算FPFH特征【2025最新版】

FPFH特征描述子的python实现,本文最新更新时间为:2025年3月18日。

点云侠的博客 5275

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

机器学习笔记:Transformer

1 传统Seq2Seq的不足 传统seq2seq 使用 bi-direction RNN 生成每个b的时候,输入的这整个序列都看过一遍了

qq_40206371的博客 2179

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

【深度学习】详解 Vision Transformer (ViT)

【深度学习】详解 Vision Transformer (ViT)

闻韶 20万+

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

CNNs Transformer的position位置编码、位置嵌入

CNNs Transformer多种position分析比较

MengYa_Dream的博客 4614

【理论篇】是时候彻底弄懂BERT模型了(收藏)

看完本篇文章后,你就真的理解BERT模型的理论知识了。

日积月累,天道酬勤 9万+
上一篇: Dify大语言模型私有化部署秘籍:Linux+yum源+Git+Docker,环境备好
下一篇: 吴恩达新书封神!吹爆这份最真实的AI求职指南《如何构建自己的AI职业》
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值