


本文分享了作者从纯前端开发者转型为全栈并整合AI能力的实战经验。文章指出,在AI时代,前端开发者的核心价值正在被重塑,单纯的前端技术边界日渐模糊。作者建议前端开发者学习Node.js中间层开发、数据库基础以及AI API集成等技能,并提供了一套实用Prompt模板。同时,文章还强调了全栈视角的重要性,以及如何利用AI工具提升学习效率。最后,作者提出,在AI时代,前端工程师的护城河并非技术栈,而是解决复杂问题的综合能力。
不久前,一位读者朋友在后台找我私信,说他被公司给优化了。
他35岁,有8年资深前端经验,主流框架Vue、React玩得转,组件库亦可从零构建,然而面试时HR却抛出一个问题:"你懂后端开发吗?能否独立完成一个完整的功能闭环?"他当场就懵了。
坦白讲,我看到这条私信时内心五味杂陈。倒不是出于同情——这个行业向来如此,技术更新迅猛,任何人都可能掉队。真正触动我的是,我察觉到,这个难题或许是许多人共同的窘境。
如今已是2026年,人工智能编写代码已非新鲜事。市面上那些AI编程助手,其产出的代码质量有时甚至超越了初阶工程师的手笔。那么,前端开发的真正壁垒何在?仅仅会页面布局、调用API、编写组件,这条路还能走多远?
前端开发者的核心价值正在被彻底重塑
先分享一个真实数据。
我们团队去年招聘了15位前端工程师,其中有8位是工作经验不足三年的。在面试环节,我们新增了一个考核:要求候选人借助AI工具,独立完成一个微型全栈项目(涵盖前端界面、Node.js构建的中间层以及基础的数据库交互)。
结果相当耐人寻味。那些仅精通前端框架的应聘者,即便算法题刷得再溜,在这一关也大都束手无策。相反,有几位具备后端知识、或曾自己探索过全栈项目的候选人,纵使框架使用不算顶尖,最终却成功让功能运转起来。
这并非意味着前端知识不再重要,而是纯粹的前端技术边界日渐模糊。AI可以协助你生成组件、美化CSS,甚至编写出相当不错的TypeScript类型定义,然而它目前尚无法做到的是:
洞悉业务逻辑深处的权衡,规划具备扩展性的系统架构,以及在前后端技术栈间做出明智的抉择。
讲到这里,多说一句。不少人对“全栈”存在误解,认为必须精通各类后端语言,但实际上完全不必如此。对前端背景的开发者而言,全栈的核心意义在于能够贯穿整个技术链路,而非在每个细分领域都成为顶尖专家。
我个人的发展路径是:从主流前端框架出发 → 掌握Node.js中间层 → 学习数据库基础 → 实践AI API整合 → 涉猎基础的DevOps。这套技能组合拳下来,我发现独立交付完整功能的成本几乎降低了一半。
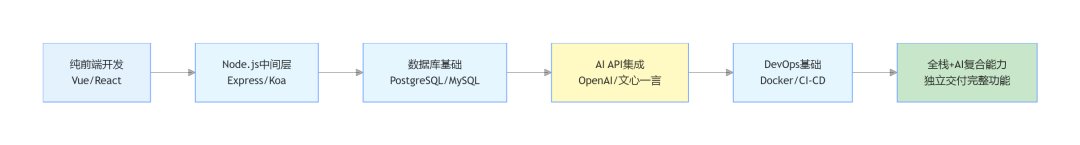
以全栈视角剖析AI集成能力的实战应用
去年我承接了一个外包项目,客户需求是构建一个智能客服机器人。
需求表面上听着不复杂:用户在前端界面输入问题,由后端请求大模型API获取回答并呈现。然而,若仅将其视为“前端调用一个接口”那么简单,就大错特错了。
真正落地时才发现一连串的问题:
首个挑战在于流式响应的处理。大模型返回答案是逐字输出的,前端如果用传统的fetch一次性等待,用户体验会很差——得等好几秒才能看到第一个字。破局之法是采用ReadableStream进行流式解析,实现边接收数据边渲染页面。
// 流式响应处理示例
async functionstreamChatResponse(prompt, onChunk) {
const response = await fetch('/api/chat', {
 method: 'POST',
 headers: { 'Content-Type': 'application/json' },
 body: JSON.stringify({ prompt })
 });

const reader = response.body.getReader();
const decoder = new TextDecoder();
let fullText = '';

while (true) {
const { done, value } = await reader.read();
if (done) break;

const chunk = decoder.decode(value, { stream: true });
const lines = chunk.split('/n');

for (const line of lines) {
if (line.startsWith('data: ')) {
const data = line.slice(6);
if (data === '[DONE]') return fullText;

try {
const parsed = JSON.parse(data);
const content = parsed.choices?.[0]?.delta?.content || '';
 fullText += content;
 onChunk(fullText); // 实时回调更新UI
 } catch (e) {
 console.error('解析失败:', e);
 }
 }
 }
 }

return fullText;
}

// 使用示例
streamChatResponse('你好', (text) => {
 document.getElementById('response').textContent = text;
});
这段代码看似直白,实则调试过程颇费周折。最麻烦的地方在于,不同的大模型服务商其流式输出格式各异,需要专门构建一个适配层来兼容它们。
接踵而至的第二个难题是上下文管理。随着对话轮次的增加,token的消耗急剧攀升,导致成本难以为继。之后的对策是引入滑动窗口机制,仅保留最近的几轮对话,并结合向量数据库来实现长期记忆的检索。
此处便涉及到了后端技能。我采用的技术栈是Node.js配合PostgreSQL及其pgvector扩展,核心逻辑大致如下:
// 对话历史管理(Node.js中间层)
import { Pool } from'pg';
import OpenAI from'openai';

const pool = new Pool({ connectionString: process.env.DATABASE_URL });
const openai = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

// 存储对话到数据库
async functionsaveConversation(sessionId, role, content) {
await pool.query(
'INSERT INTO conversations (session_id, role, content, created_at) VALUES ($1, $2, $3, NOW())',
 [sessionId, role, content]
 );
}

// 获取最近N轮对话作为上下文
async functiongetRecentContext(sessionId, limit = 5) {
const result = await pool.query(
'SELECT role, content FROM conversations WHERE session_id = $1 ORDER BY created_at DESC LIMIT $2',
 [sessionId, limit]
 );
return result.rows.reverse(); // 按时间正序
}

// 构建带上下文的提示词
functionbuildPromptWithContext(question, context) {
const contextText = context
 .map(msg => `${msg.role}: ${msg.content}`)
 .join('/n');

return`你是一个智能客服助手。以下是历史对话:

${contextText}

用户当前问题:${question}

请基于以上信息回答问题,如果历史对话与当前问题无关,可以忽略。`;
}

// API路由处理
app.post('/api/chat', async (req, res) => {
const { sessionId, question } = req.body;

// 保存用户问题
await saveConversation(sessionId, 'user', question);

// 获取上下文
const context = await getRecentContext(sessionId);

// 构建提示词并调用AI
const prompt = buildPromptWithContext(question, context);
const completion = await openai.chat.completions.create({
 model: 'gpt-4',
 messages: [{ role: 'user', content: prompt }],
 stream: true
 });

// 流式返回
 res.setHeader('Content-Type', 'text/event-stream');
let fullResponse = '';

for await (const chunk of completion) {
const content = chunk.choices[0]?.delta?.content || '';
 fullResponse += content;
 res.write(`data: ${JSON.stringify({ content })}/n/n`);
 }

 res.write('data: [DONE]/n/n');
 res.end();

// 异步保存AI回复
 saveConversation(sessionId, 'assistant', fullResponse);
});
这套代码部署后,整个对话系统的用户体验得到了显著提升。用户能够清晰地感知到系统“记住”了先前的对话,同时成本也不会因token暴增而失控。
其实还有一个优化细节,为降低响应延迟,我在Node.js层实施了缓存策略——对于短时间内重复的提问,系统不再请求AI,而是直接返回缓存中的答案。这一改进使API调用次数下降了约三成,有效节约了开销。
AI纪元下前端开发者必备的三大核心技能
说到这,也许有朋友会疑惑:全栈能力范围如此之广,应从何处补起?
基于我个人的实践经验,我归纳出三个优先级最高的学习方向。
首当其冲的是Node.js中间层开发能力。
这不要求你成为后端大牛,但起码要能编写RESTful API、进行数据库交互、并处理用户认证与权限控制。Express或Koa任选其一即可,无需纠结于工具好坏,能解决问题才是王道。
我当初学习Node.js的方法颇为直接:找一个开源的全栈项目(比如Next.js的官方范例),从头到尾研读其代码,然后自己模仿实现一个简化版本。此过程约耗时两周,但其收获远胜于阅读十篇教程。
其次是数据库基础与数据建模的思维。
无需精通SQL性能调优,但必须了解如何设计数据表结构、编写基础的查询,并明白索引的功用。PostgreSQL或MySQL选一个,掌握CRUD便已足够。
这里补充一点,很多人觉得前端开发者接触数据库是“越界”行为,但实际上理解数据在系统中的流转对前端开发大有裨益。譬如,当你知晓某个查询因缺少索引而缓慢时,在设计前端交互时便会主动考虑分页或懒加载,而非被动地等待后端优化。
第三点,AI API的集成与基础的提示词工程。
重点不在于训练模型,而是要学会如何调用现成的AI服务、处理流式数据,以及如何设计精妙的Prompt以引导AI产出符合预期的内容。
分享一个我个人在多个项目中反复打磨后总结的实用Prompt模板:
// Prompt构建工具函数
functionbuildStructuredPrompt(task, context, constraints) {
 return`## 任务描述
 ${task}

 ## 背景信息
 ${context}

 ## 输出要求
 ${constraints}

 ## 注意事项
 - 如果信息不足,请明确指出需要补充的内容
 - 优先给出可执行的方案,而非理论分析
 - 代码示例需包含必要的注释`;
}

// 使用示例
const prompt = buildStructuredPrompt(
 '生成一个Vue3组件,实现表格数据展示和分页功能',
 '项目使用TypeScript + Element Plus,数据源为REST API',
 '- 组件需支持排序、筛选、分页/n- 使用Composition API/n- 包含完整的 TypeScript类型定义'
);
这个模板的优势在于其结构化足够清晰,能让AI输出的结果更精准地命中你的预期。亲测非常有效,远比随意抛给AI一句话要可靠得多。
唉,说到这儿想起一件往事。起初利用AI辅助编程时,我总期望它能一步到位生成完整代码,但结果往往是代码无法运行或不满足项目标准。后来我才领悟到,AI的角色更像一个“能力超强的实习生”——你必须给予明确的指令和充分的上下文,并且需要仔细审查它产出的代码。
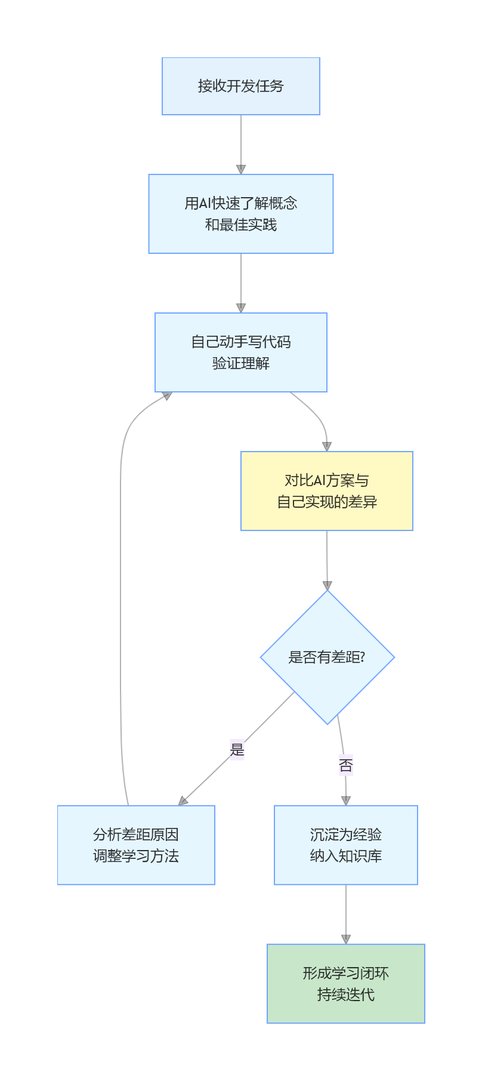
关于从前端到全栈+AI的转型路线图建议
如果你也在考虑职业转型,我愿提供几条可操作的建议。
切忌幻想一步登天。
我目睹过太多人收藏了海量的“全栈学习蓝图”,然后从第一天便开始攻读艰深的底层知识,不出两周便偃旗息鼓。正确的打开方式是:找一个具体而微的项目,在实践中学习。
比如构建一个个人博客系统,前端可选用Vue或React,后端用Node.js实现几个API,数据库则用来存储文章与评论。功能无需追求复杂,能跑通即可。在此过程中,你会自然而然地碰到各种难题:跨域如何解决、身份认证如何实现、数据库如何设计……每一个难题都是一次宝贵的学习契机。
要善于利用AI来加速学习,但绝不能产生依赖。
我如今掌握新技术的标准流程是:首先借助AI迅速把握核心概念与业界最佳实践,接着亲手编码进行验证,最后再将自己的实现与AI提供的方案进行对比分析。这个学习循环下来,对知识的理解会比单纯阅读文档要深刻得多。
但有一个陷阱必须避开:绝不能让AI代替你思考。例如,在设计数据库表结构时,你可以让AI提供建议,但最终的决策必须由你自己做出。因为业务场景的细微之处只有你最了解,AI给出的“标准答案”未必完全契合你的实际情况。
构建你个人的技术雷达系统。
前端领域日新月异,今日的热门框架明日或许就已过时。与其盲目追逐每个新出的工具,不如构建一个属于自己的“技术雷达”——明确哪些是核心能力(例如JavaScript基础、HTTP协议、数据结构),哪些只是锦上添花的工具(例如某个特定的UI库)。
我的做法是每季度进行一次复盘,列出这三个月接触到的新技术,并进行分类:
持续投入:对职业发展有长远价值的技能,如系统设计、性能优化
观察跟踪:值得关注但暂时无需深入研究的,如新兴的前端框架
暂缓关注:目前应用场景不多或成熟度不足的,如某些实验性技术
这个方法帮助我规避了大量“学完即忘”的无效时间投入。
其实还有一个隐藏的建议:多与业务方沟通。
这听起来似乎与技术无关,但实际上,洞察业务的痛点能让你更精准地判断技术学习的方向。例如,你发现公司近来在大力推广智能化功能,那么AI API的集成能力就应当提上议程;倘若团队正在进行微服务改造,那么容器化和DevOps的相关知识就亟待补充。
结语:你的壁垒并非技术栈,而是解决复杂问题的综合能力
回到开篇的那个问题:在AI时代,前端工程师的护城河究竟是什么?
我的回答是:一种融合了快速学习、系统性思维以及深刻业务洞察的复合能力。
技术栈总在更迭,框架亦会陈旧,然而洞察问题本质、设计有效方案、并推动项目落地的能力,这些核心素养在短期内是AI无法取代的。AI是一个强大的助推器,但它放大的是你已有的能力,而非为你从零创造能力。
近两年我从纯前端转向全栈并融合AI,最深的感触并非“掌握了多少新技能”,而是“观察问题的视角发生了根本转变”。过去接到任务,本能反应是“这个组件该如何实现”;如今则会先思考“整个技术链路应如何规划、数据如何流转、在哪个环节可以利用AI来提升效率”。
这种思维模式的跃迁,方是真正的核心竞争力。
最后
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。
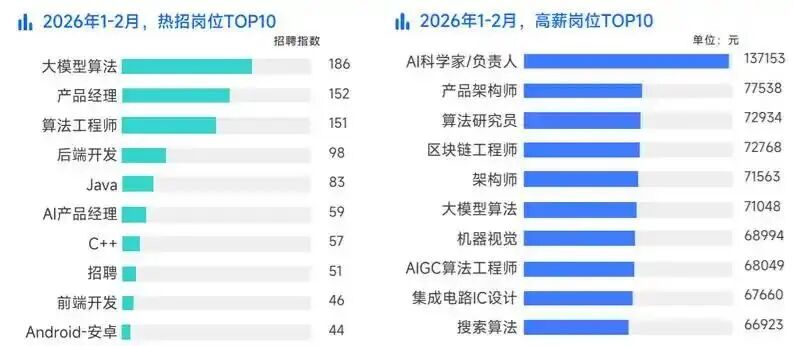
现在的市场,已经用数据给程序员指明了方向:学AI大模型,就是冲刺高薪的最优解!
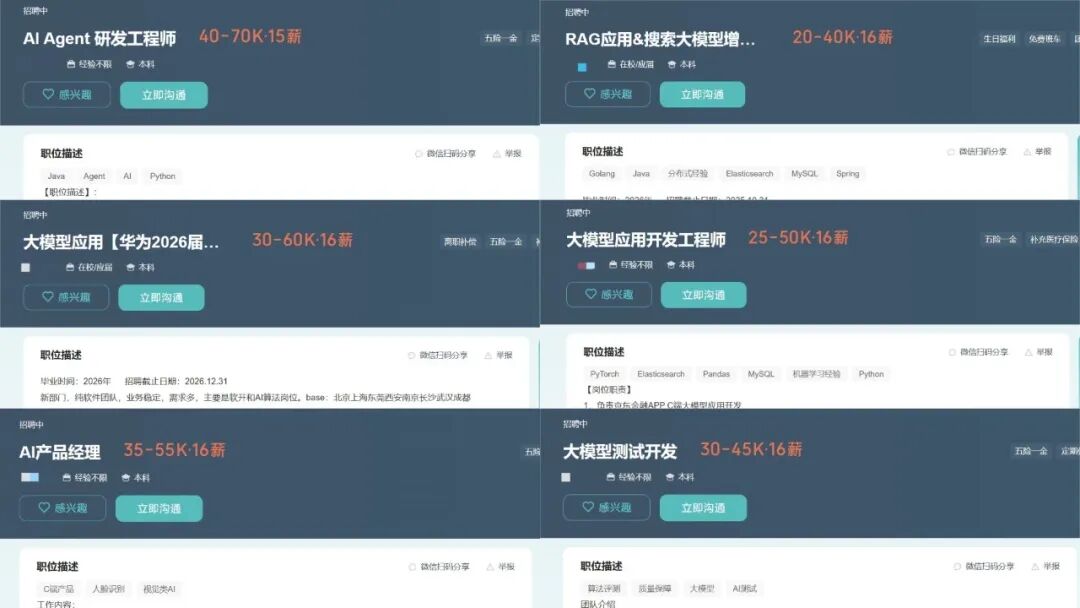
看着身边越来越多的同行转型大模型、拿到高薪offer,很多人心里都动了心,但真正的难题来了:零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?
别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序员和小白!
👇👇扫码免费领取全部内容👇👇

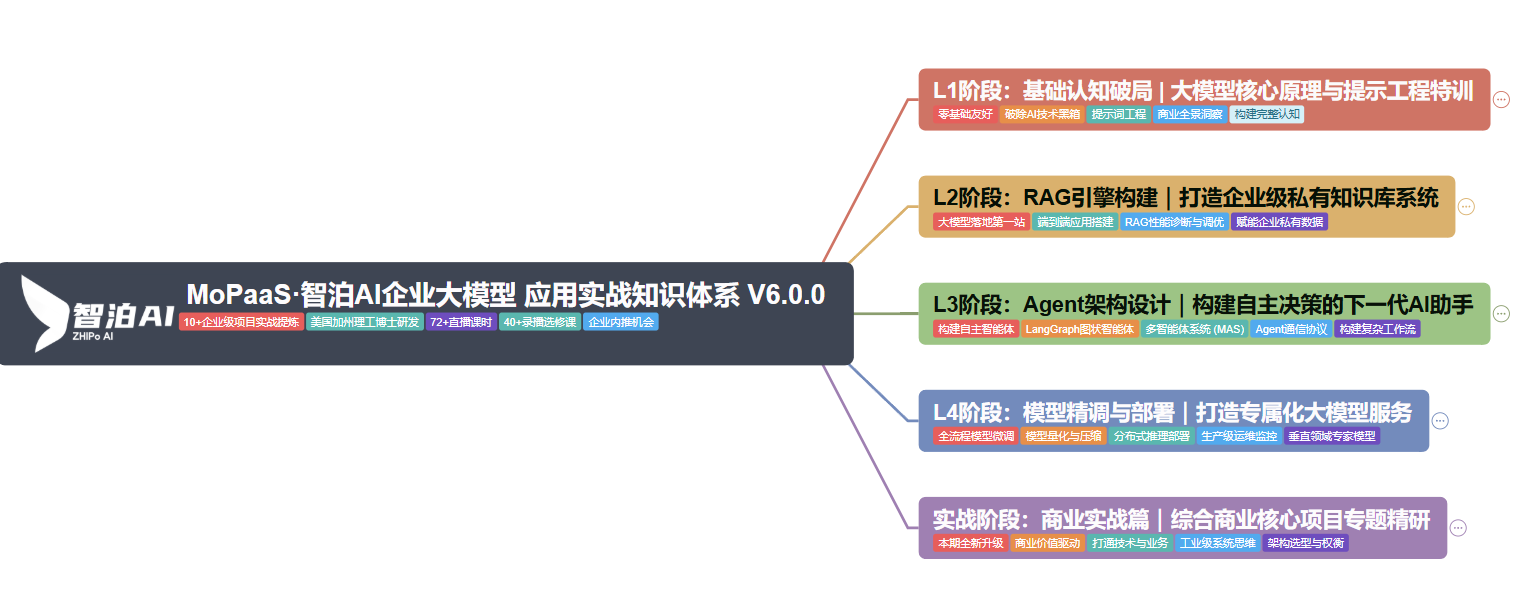
1、大模型系统化学习路线
2、大模型学习书籍&文档

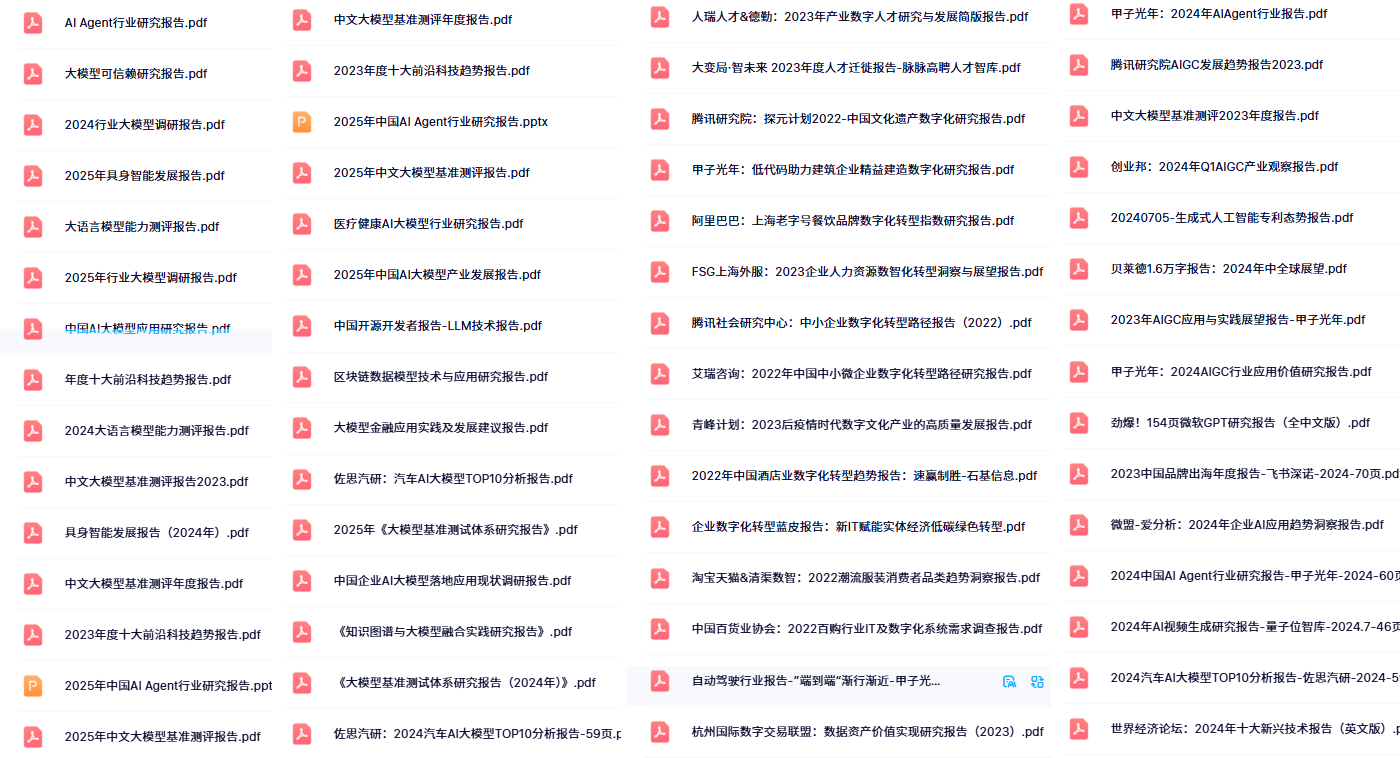
3、AI大模型最新行业报告
4、大模型项目实战&配套源码

5、大模型大厂面试真题

四阶段精细化学习规划(附时间节点,可直接照做)
结合上述资源,给大家整理了一份可直接落地的四阶段学习规划,总时长约2个月,小白可循序渐进,程序员可根据自身基础调整节奏,高效掌握大模型核心能力,快速实现从“入门”到“能落地、能面试”的跨越。
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
👇👇扫码免费领取全部内容👇👇
6、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 2012


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


