从零搭建企业级RAG知识库问答系统_从零开始构建企业级rag系统

【实际动手】搭建MaxKB 大模型和 RAG 的知识库问答系统 MaxKB,作为企业级知识库问答系统,以其强大的功能和灵活的部署方式,为企业提供了一种高效、智能的信息处理方案,更在AI技术的持续进步中展现出无限的潜力。它通过深度整合自然语言处理和机器学习技术,使得企业能够轻松应对数据洪流,实现信息的快速检索、精准分析和智能决策。展望未来,随着AI技术的进一步发展,MaxKB有望在知识管理和智能问答领域发挥更大的作用。它将继续推动企业知识资产的有效管理和利用,助力企业在激烈的市场竞争中保持领先。 阅读详情

RAG 是什么

RAG(Retrieval-Augmented Generation,检索增强生成) 是一种融合信息检索与大模型生成能力的技术架构。其核心逻辑分三步:

  • 检索(Retrieve):从企业知识库(产品文档、技术手册等)中定位与用户问题相关的片段;

  • 增强(Augment):将检索结果作为上下文输入大模型;

  • 生成(Generate):模型基于上下文生成精准、可溯源的答案。

RAG 能为企业解决哪些问题?
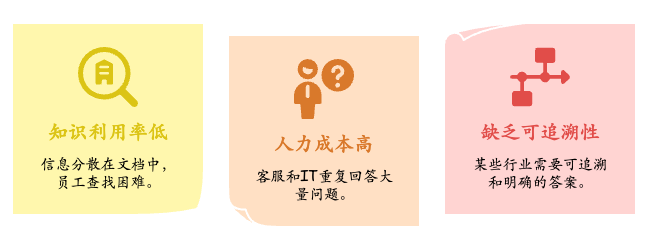
RAG 能为企业解决哪些问题

RAG 能为企业解决哪些问题

如何搭建 RAG 知识库问答系统

搭建 RAG 知识库问答系统

搭建 RAG 知识库问答系统

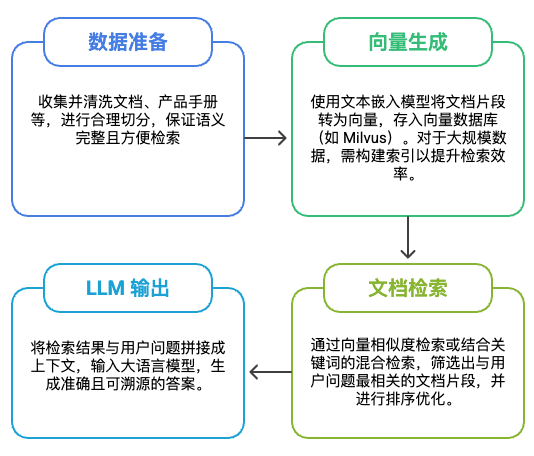
实现过程

1. 数据准备

数据准备是构建 RAG 知识库的基础,影响检索与生成质量,主要包括如下步骤:

  • 文档准备:整理产品文档、FAQ、会议记录等内部资料。

  • 格式清洗:统一处理各种文件格式,去除噪声。

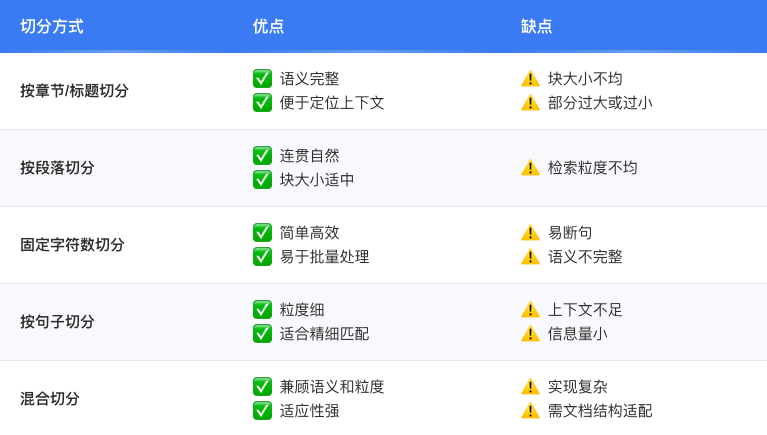
  • 文本切分:按章节、段落等方式拆分文本,便于向量化。

  • 去重脱敏:清理重复内容,脱敏敏感信息,确保数据安全。

数据切分方式

数据切分方式

2. 向量生成与存储

文本切分完成后,需调用文本嵌入模型将每个文本片段转换为高维向量表示,便于后续的语义检索和匹配。

2.1 选择嵌入模型

选择嵌入模型时,主要考虑以下因素:

  • 语义相关性:模型能否捕捉深层语义;

  • 语言适配:支持中文、英文或多语言场景;

  • 向量维度:维度越高,精度可能提升,但计算成本更大;

  • 推理速度:响应时延和吞吐能力;

  • 召回精度:检索的准确率和覆盖率。

推荐模型:text-embedding-v3、paraphrase-multilingual-MiniLM-L12-v2、BAAI/bge-small-zh-v1.5等

2.2 向量生成

文本切分后,需要使用嵌入模型将每个文本片段转换为向量表示,以支持后续的语义检索。常见调用方式如下:
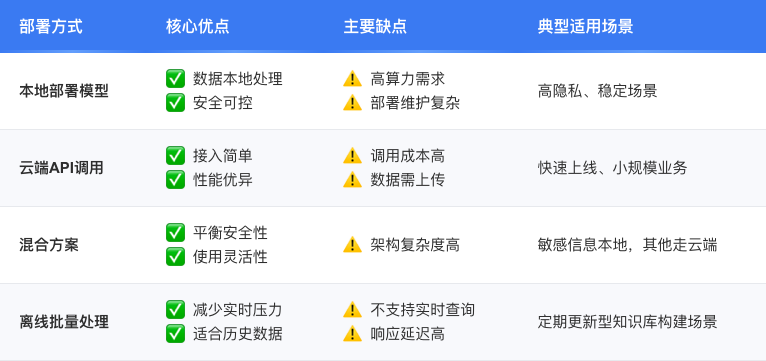
模型调用方式

模型调用方式

注意:本地模型推理时,默认使用 CPU 推理时速度较慢,建议配备 GPU 和批量推理机制提升速度。

2.3 将向量入库(以Milvus为例)

向量入库主要分为以下步骤:

  1. 连接数据库:初始化 Milvus 客户端;

  2. 创建集合(Collection):定义包含向量字段的 Schema;

  3. 插入数据:将生成的密集/稀疏向量连同元数据一并写入;

  4. 创建索引:为向量字段构建索引,提升检索效率(如 IVF_FLAT)。

🔍 向量索引说明

当数据量超过 10,000 条时,建议为向量字段显式创建索引,以加快查询速度。
如未指定索引类型,Milvus 默认采用 FLAT(全量暴力比对)方式,准确但效率低。
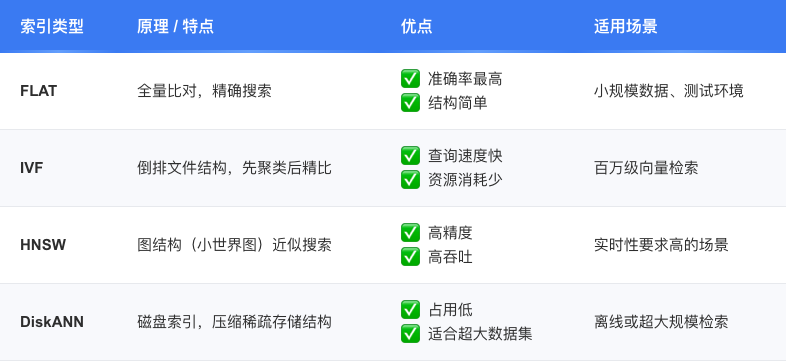
索引类型

索引类型

📌 提示:索引通常会引入近似搜索机制,提升速度的同时可能带来轻微的精度损失。实际应用中,可根据数据规模和业务需求灵活选择是否建立索引。


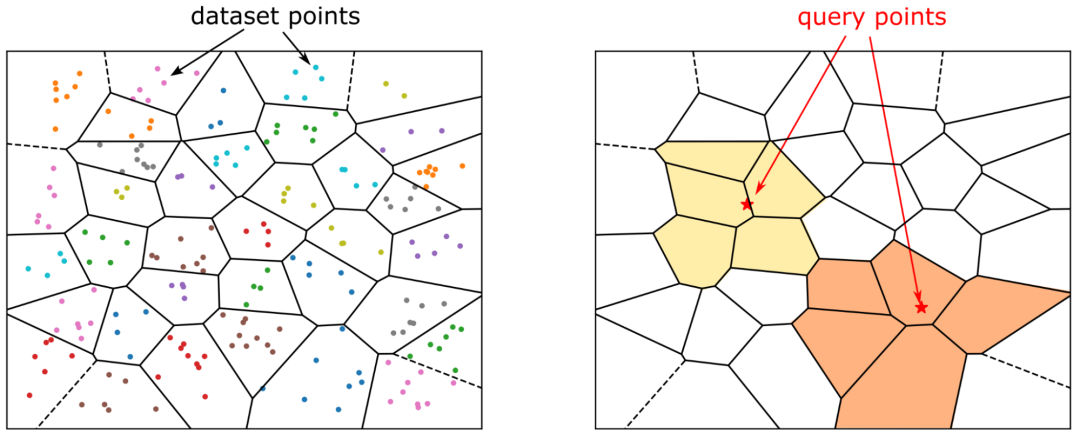
📘 IVF_FLAT 索引原理简述
  1. 聚类划分:使用 KMeans 算法将所有向量划分为 nlist 个簇,每个簇对应一个中心向量;

  2. 粗筛阶段:查询时,先将查询向量与所有簇中心比对,选出最相关的 nprobe 个簇;

  3. 精比阶段:只在选中的簇中进行精确比对,大幅缩小搜索范围、提升性能。

IVF_FLAT 索引原理

3. 文档检索

文档检索在实际应用中有多种方案,需要根据不同的数据类型与业务需求选择。以下是常见的几种检索方式:

3.1 关键词检索(Keyword Search)
  • 基于倒排索引,依赖关键词精确匹配

  • 优势:查询结果可控,适用于数字、代码、命名实体等精确查询

  • 局限:无法理解语义,易遗漏表达方式不同但含义相同的内容

📌 例如:

  • 查询:“这是一只猫”

  • 文档包含:“这是一只英短”

在关键词检索中,由于“猫”与“英短”字面不同,即使“英短”是一种猫,系统也无法识别两者之间的关系,因此这条文档可能无法被检索出来。

3.2 语义检索(Semantic Search)
  • 基于密集向量(Dense Vector),通过语义相似度进行模糊匹配

  • 优势:对自然语言理解能力强,适用于问答、推荐、摘要等任务

  • 局限:术语召回弱,缺乏精确控制,可能忽略关键词命中

📌 例如:

  • 查询:“这是一只猫”

  • 文档包含:“这是一只英短”

在语义检索中,模型能够理解“英短”是“英短蓝猫”的简称,是“猫”的一种,因此即使没有出现“猫”这个字,也可以通过向量相似度成功召回该文档。

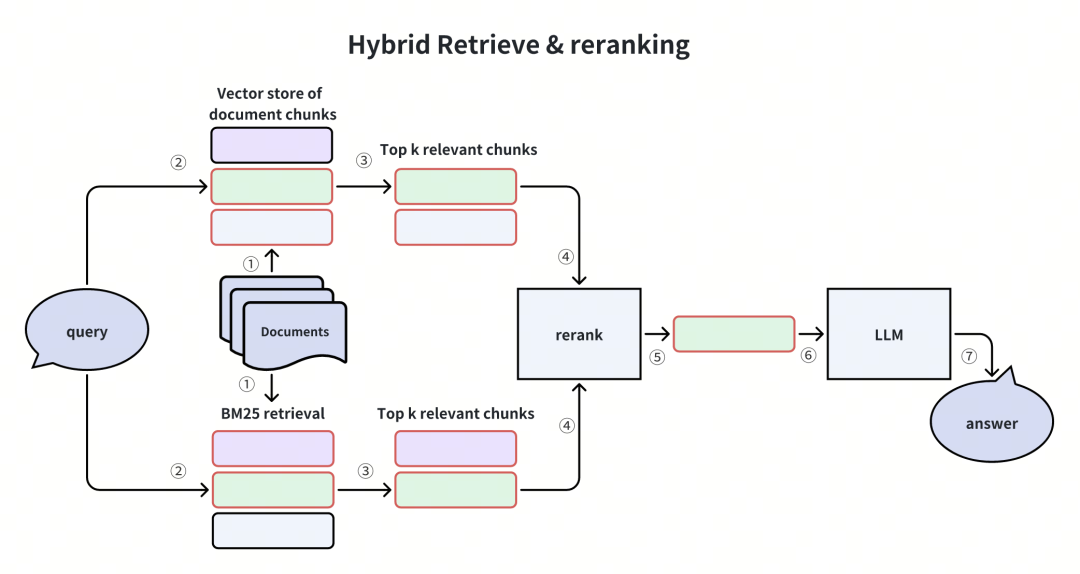
3.3 混合检索(Hybrid Search)
  • 综合使用稀疏向量(如 BM25)与密集向量,融合关键词与语义相似度

  • 优势:兼顾精确性与语义理解,提升召回率和相关性

  • 应用广泛,适用于大多数通用检索场景,如文档问答、知识库搜索等

混合检索

混合检索

💡 示例:查询语句为 这是一只猫,待检索内容为 这是一只英短。

  • 稀疏向量部分(关键词匹配):无法命中“猫”这个关键词,匹配失败;

  • 稠密向量部分(语义匹配):理解“英短”是“英短蓝猫”的简称,与“猫”语义接近,匹配成功;

  • 混合策略:结合两者结果,系统可通过语义匹配部分召回该文档,并综合打分排序,提升整体相关性。

3.4 多向量检索(Multi-Vector Search)
  • 针对同一文本生成多个向量,分别表示不同语义片段或视角

  • 优势:丰富语义表达,提升多样性召回能力

  • 典型场景:复杂问答系统、长文档片段匹配、多角色对话分析等

3.5 多模态检索(Multimodal Search)
  • 融合文本、图像、音频等多模态信息进行统一向量化与搜索

  • 优势:支持跨模态查询,如“以图搜文”“语音查图”等

  • 应用场景:电商搜索、内容推荐、媒体检索、跨语言信息检索等


💡 提示:在大多数文本场景中,建议采用 混合检索 作为基础方案,结合业务需求逐步扩展为多向量或多模态检索。

4. 上下文构建与答案生成

在 RAG 流程中,构建高质量的 Prompt,并将其输入语言模型生成准确、有依据的回答,是智能问答的核心。


4.1 构建 Prompt
  • 控制上下文长度
    保留前 3~5 条高相关文档,避免超出模型上下文窗口限制。

  • 结构化文档内容
    使用 XML、Markdown 或自然语言标签组织段落;
    对 <, >, & 等特殊字符做转义,防止格式解析错误。

  • 设置角色与任务指令
    明确模型身份(如“你是企业知识助手”);
    给出具体任务目标(如“请结合文档内容回答问题”)。

  • 增强可解释性
    添加 doc_id、检索得分(score)等辅助信息,支持内容追溯和引用。


4.2 输入模型并生成回答
  • 输出风格控制
    根据需求配置生成格式,如 Markdown、列表或简洁段落。

  • 引用增强
    指导模型标明参考来源(如“根据文档 #2…”),提升回答可信度。

  • 兜底机制
    当检索结果不足或无匹配内容时,引导模型输出“未能在知识库中找到直接答案”的声明。

后续优化

以上介绍了基础的 RAG 检索流程,但实际应用中还有多方面细节需要持续优化:

  1. 数据质量与文本切分
    合理设计文本切分策略,确保语义完整且检索粒度适中,提升检索准确性和效果。

  2. 向量模型、推理性能与多模态策略
    根据业务场景选择或微调合适的文本和多模态向量模型,结合 IVF、HNSW 等索引结构,保证检索效率与精度。

  3. 向量库索引与存储管理
    针对数据规模和响应需求,选择合适的索引结构和存储方案,确保检索速度和系统稳定性。

  4. 上下文构建与 Prompt 优化
    合理控制上下文长度,设计清晰Prompt,提升生成回答的准确性和可读性。

  5. 系统稳定性与持续优化
    完善接口重试与降级机制,结合用户反馈定期评估和优化检索及生成效果,保障系统的可用性和长期价值。

计算机毕业何去何从?

现如今大模型岗位需求越来越大,但是相关岗位人才难求,薪资持续走高,AI运营薪资平均值约18457元,AI工程师薪资平均值约37336元,大模型算法薪资平均值约39607元。
在这里插入图片描述

掌握大模型技术你还能拥有更多可能性:

• 成为一名全栈大模型工程师,包括Prompt,LangChain,LoRA等技术开发、运营、产品等方向全栈工程;

• 能够拥有模型二次训练和微调能力,带领大家完成智能对话、文生图等热门应用;

• 薪资上浮10%-20%,覆盖更多高薪岗位,这是一个高需求、高待遇的热门方向和领域;

• 更优质的项目可以为未来创新创业提供基石。

可能大家都想学习AI大模型技术,也_想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。为了让大家少走弯路,少碰壁,这里我直接把都打包整理好,希望能够真正帮助到大家_。

零基础如何高效学习大模型?

为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

在这里插入图片描述

【大模型全套视频教程】

教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。

从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。

同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
在这里插入图片描述

深耕 AI 领域技术专家带你快速入门大模型

跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

在这里插入图片描述

【精选AI大模型权威PDF书籍/教程】

精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
在这里插入图片描述

【AI 大模型面试题 】

除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。

【大厂 AI 岗位面经分享(92份)】
图片

【AI 大模型面试真题(102 道)】

图片

【LLMs 面试真题(97 道)】

图片

【640套 AI 大模型行业研究报告】

在这里插入图片描述

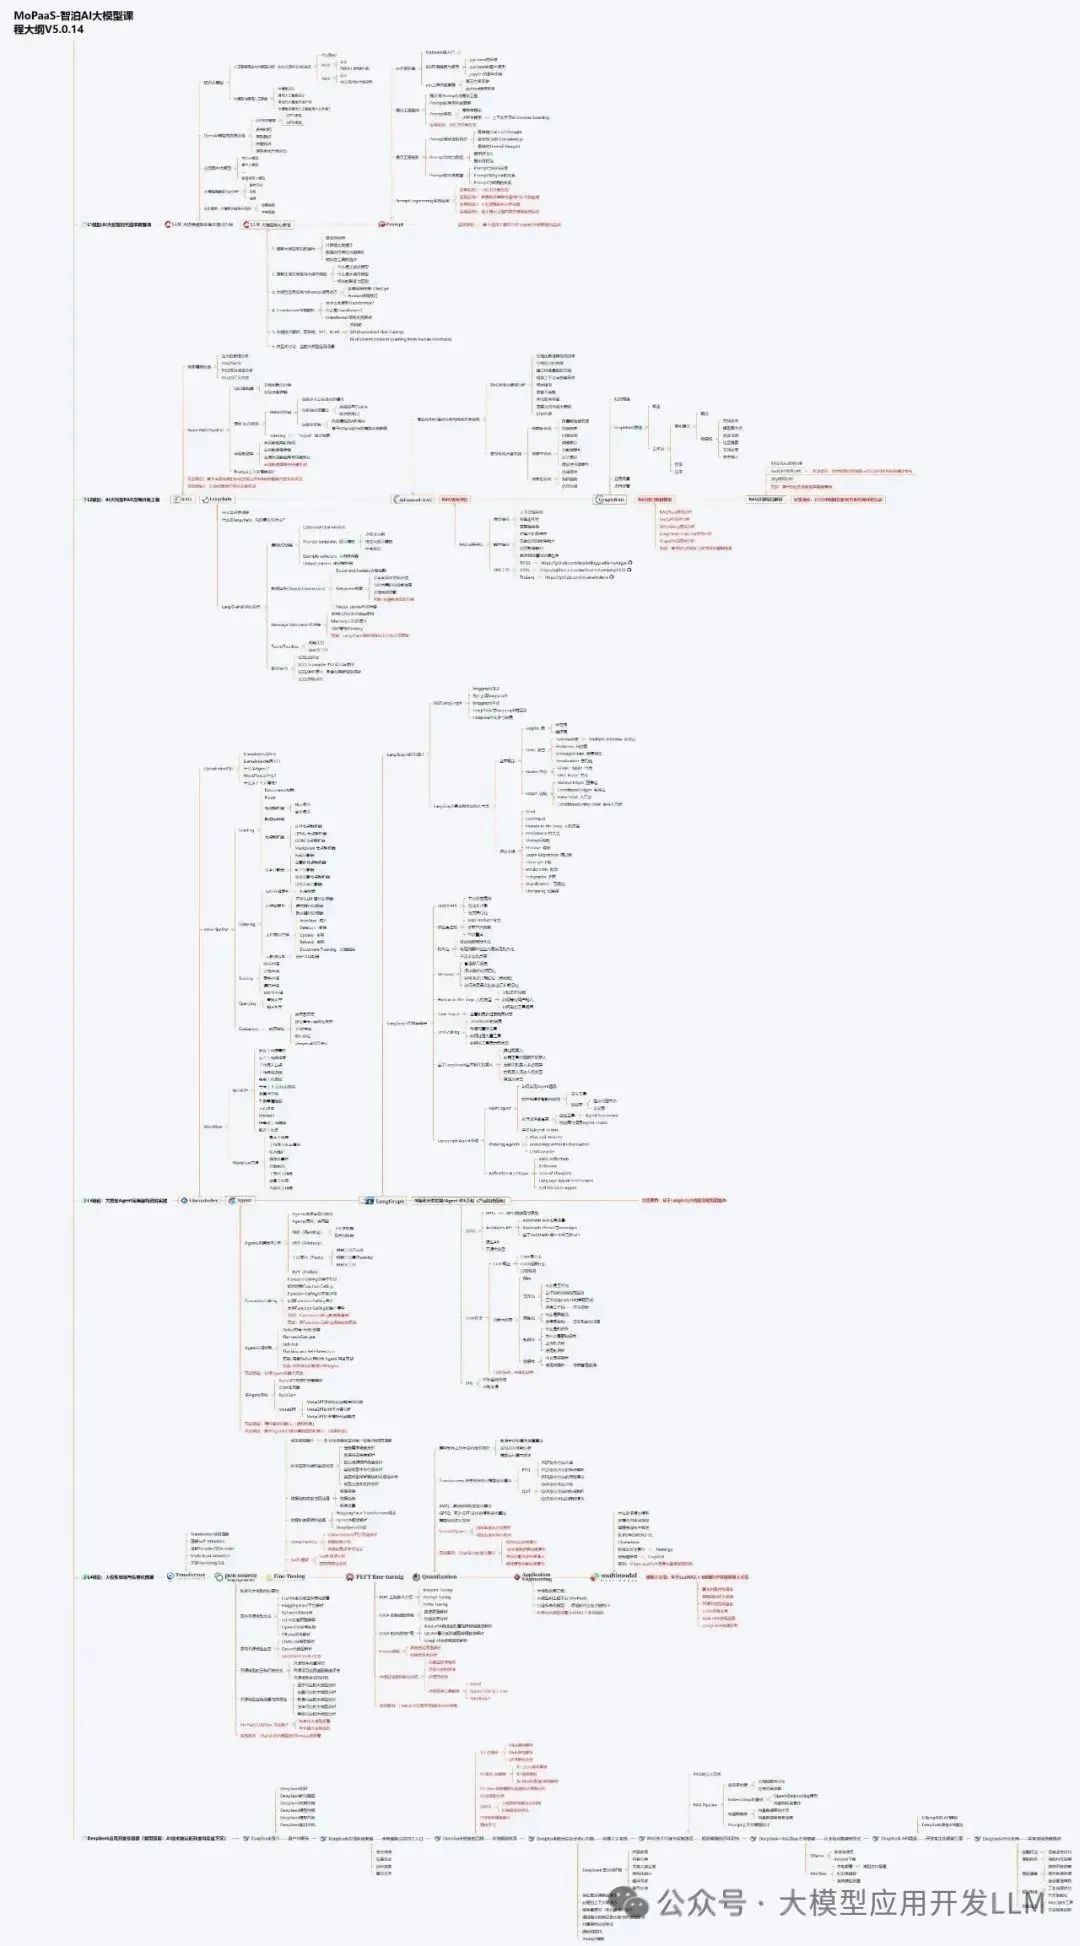
【AI大模型完整版学习路线图(2025版)】

明确学习方向,2025年 AI 要学什么,这一张图就够了!
img

👇👇点击下方卡片链接免费领取全部内容👇👇

在这里插入图片描述

抓住AI浪潮,重塑职业未来!

科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。

行业趋势洞察:

  • 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
  • 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
  • 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。

与其观望,不如行动!

面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
在这里插入图片描述

01 为什么分享这份学习资料?

当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。

因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!

我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。

*02 这份资料的价值在哪里?*

专业背书,系统构建:

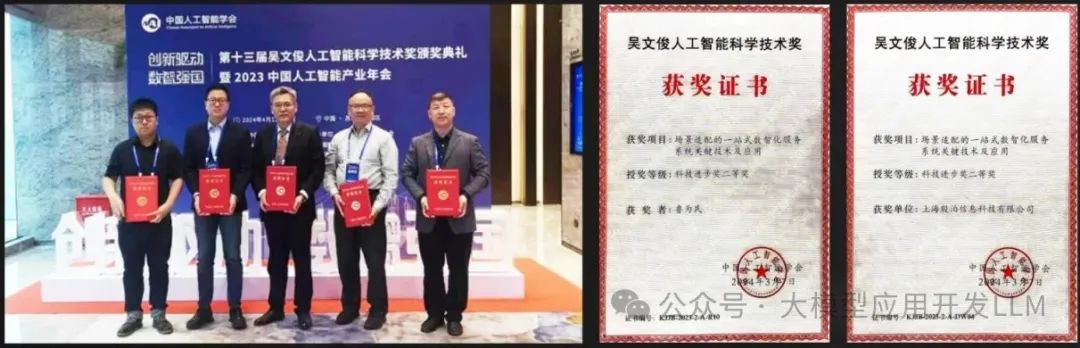
  • 本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:

    • 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
    • 拥有多项中美发明专利。
    • 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
  • 目前,我有幸与鲁博士共同进行人工智能相关研究。

在这里插入图片描述

内容实用,循序渐进:

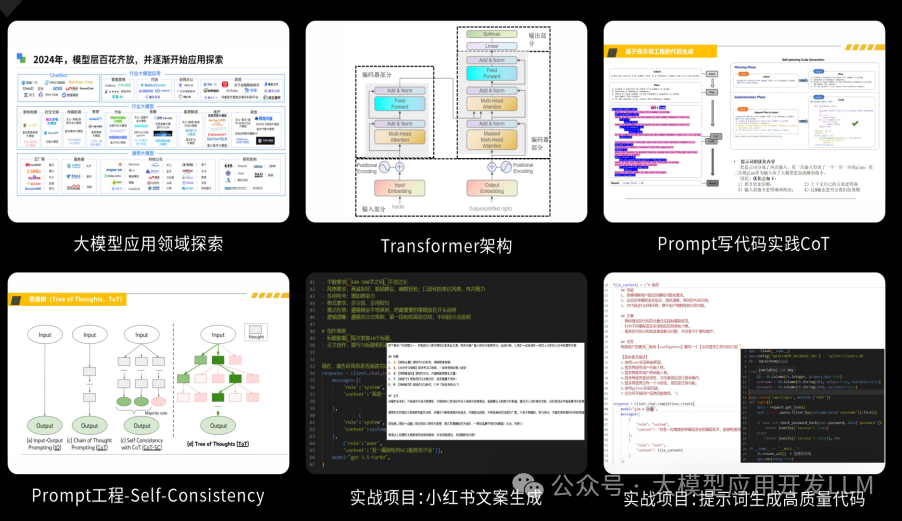
  • 资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。

  • 包含丰富的视频教程与实战项目案例,强调动手实践能力。

  • 无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
    在这里插入图片描述在这里插入图片描述在这里插入图片描述

抓住机遇,开启你的AI学习之旅!

在这里插入图片描述

使用RAG技术构建企业级文档问答系统之基础流程 本文是本系列(使用RAG技术构建企业级文档问答系统)的第二篇,将介绍检索增强生成(Retrieval Augmented Generation,简称RAG)最基础流程。所谓检索增强生成,是大语言模型兴起之后发展迅速的一个应用领域,简单说就是,这项技术,可以根据用户输入的问题,从文档(如PDF、Word、PPT、TXT、网页等)中自动检索跟问题相关的文本片段(或称为知识片段、上下文),然后将一段指令、用户输入的问题、文本片段拼装成一个Prompt(也就是大语言模型的输入),让大语言模型生成一个回答。 阅读详情

相关推荐

【人工智能】从零开始构建本地智能问答系统:DeepSeek 与知识库的深度融合

随着人工智能技术的快速发展,大规模语言模型(LLM)在问答系统中的应用日益广泛。本文深入探讨如何利用 DeepSeek 模型与知识库结合,构建一个高效的本地智能问答系统。系统采用检索增强生成(RAG)技术,通过本地部署实现数据隐私保护和实时响应。我们将详细介绍系统的架构设计,包括数据预处理、知识库构建、模型微调与推理优化等关键步骤。同时,提供丰富的代码示例(基于 Python),涵盖从文档加载到问答实现的完整流程,并辅以中文注释以便理解。本文还探讨了数学基础,如余弦相似度在向量检索中的应用,并以 LaTeX

一个被知识诅咒的人 1126

半路出家程序员感受:非科班出身如何转行程序员?

同时课程详细介绍了。

HJS123456780的博客 937

AI知识库实战:如何用LangChain构建智能问答系统?

当你面对企业海量的产品文档、内部政策,或是个人积累的数千条笔记时,是否曾希望有一个“智能助手”能像人类专家一样,快速准确地回答你的问题?比如:“我们公司的年假政策是怎样的?”“这个API接口的参数格式是什么?”“我去年写的关于LangChain的笔记里提到了哪些核心组件?传统搜索工具(如Elasticsearch)只能返回关键词匹配的文档片段,而纯大语言模型(如GPT-4)则可能生成“幻觉”答案(即没有事实依据的内容)。检索增强生成(RAG)

AI算力网络与通信的博客 1198

科班与非科班,找工作时的差别到底有多大?

科班与非科班,找工作时的差别到底有多大?

qq_46094651的博客 1611

Ragflow-Plus实战指南:从零搭建企业级知识库问答系统

本文详细介绍了如何从零开始搭建企业级知识库问答系统Ragflow-Plus,涵盖其核心技术RAG、部署步骤、模型配置及知识库管理。Ragflow-Plus通过离线部署确保数据安全,提升专业问答准确率至92%,并支持细粒度权限控制。适合企业快速构建高效、安全的内部知识管理系统。

y7z8a9的博客 874

计算机基础知识.pdf

这是一本是程序员必知的硬核基础知识,一本非常入门的经典 PDF,看完能让你对计算机有一个基础的了解和入门,是培养你 内核 的基础。基本上涵盖了计算机所有基础知识,从 CPU 到内存、讲解什么是二进制、磁盘、压缩算法、操作系统、汇编等知识。

从零搭建企业级RAG知识库问答系统

RAG(Retrieval-Augmented Generation,检索增强生成) 是一种融合信息检索与大模型生成能力的技术架构。

2301_81940605的博客 1505

[详细完整版]计算机基础.pdf

第一章:计算机基础 1 本章内容提要 2 1 微机的发展历史,微机系统组成,三总线概念 2 微处理器构造及其指令执行过程 3 进位计数值(2、8、10、16进制)及其相互转 换,二进制数的运算规则 4 编码(BCD码,ASCII码,汉字码,图形信息编 码) 5 无符号数及带符号数的表示方法;机器数和真 值;带符号数的编码和运算;定点数和浮点数 ¾ 本章难点: 机器数与真值、溢出的判断方法 第一节:计算机的基本概念 3 4 ¾ 电子计算机的定义: 电子计算机是一种能够自动而又精确地对信 息进行处理的现代化电子设备。 ¾ 电子计算机的起源: 为了加快计算速度与精度,人们一直在尝试 制造计算机——从机械计算机到电子计算机 第 一 台 具 有 现 代 意 义 的 电 子 计 算 机 ENIAC (Electronic Numerical Integrator And Computer) 电子计算机理论的创立 5 ‹ 冯·诺依曼(Von Neumann)确立了现代计算机 的基本理论 ¾ 计算机由5个基本部件构成: 输入器、输出器、运算器、存储器和控制器 ¾ 采用二进制进行运算 ¾ 引入存储器存储

RAG智能体实战:构建企业内部知识库问答系统

RAG(Retrieval-Augmented Generation)智能体作为一种结合了信息检索和大语言模型生成的强大工具,可以有效缓解大模型幻觉、提升知识时效性以及信息可追溯性,正在为我们提供更为可行的解决方案。本文将介绍RAG的基本概念,并展示如何构建一个企业内部知识库问答系统。

m0_59164520的博客 3021

大学计算机基础(第四版)杨振山龚沛曾主编.pdf

大学计算机基础(第四版)杨振山龚沛曾主编.pdf

计算机基础.pdf

计算机基础.pdf

Web开发者实战LangChain RAG:构建企业级知识库问答系统

在Web开发中,我们熟悉“数据 → 处理 → 展示”的经典流程:从前端表单收集用户输入,后端查询数据库,再将结果渲染成页面。而如今,当企业希望用自然语言查询内部文档(如产品手册、技术规范、HR政策),这套逻辑依然成立——只是“数据库”换成了向量数据库,“SQL查询”换成了语义搜索。 这就是 RAG(Retrieval-Augmented Generation) 的核心思想: 先从海量文档中检索出与问题最相关的片段,再将这些片段作为上下文喂给大模型,生成精准回答。对于Web开发者而言,RAG 并非全新

沛哥儿的专栏 1931

WPF插件架构-如何动态加载封装好的第三方DLL的界面

插件架构中如何自动加载第三方DLL中的UI界面

lg24k的博客 1882

【值得收藏】企业级RAG知识库构建全解析:从零开始构建智能问答系统

静态摘要缓存:对常见问题和热词,预先生成摘要答案,命中后直接响应,无需模型调用召回预热池:对于高频提问构建 Query → Top-K chunk 映射缓存,避免每次重复召回在培训/客服场景中可节省 30~60% 的 token 调用。

EnjoyEDU的博客 1888

别再被SpringerLink虐了!手把手教你搞定LaTeX源文件提交(附正确文件顺序和类型选择)

本文详细解析了SpringerLink投稿系统中LaTeX源文件提交的常见问题与解决方案,包括文件打包、类型选择和顺序排列等关键步骤。通过实战经验,帮助科研人员避开隐形陷阱,一次性完成LaTeX提交,提升投稿效率。特别针对`.bst`和`.cls`文件的正确处理提供了专业指导。

weixin_42522964的博客 445

Python + DeepSeek 完美结合:本地部署提效指南

随着生成式 AI 和深度学习技术的快速发展,如何将智能搜索工具与本地部署结合以提升效率成为了许多企业和开发者关注的重点。DeepSeek 是一款开源的智能搜索框架,结合 Python 的灵活性,能够实现高效、可靠的本地部署方案。本文将介绍如何通过 Python 和 DeepSeek 的完美结合,实现本地化部署并提升工作效率。通过将 Python 与 DeepSeek 结合,可以快速实现语义搜索的本地化部署,确保数据安全的同时提升工作效率。文件可直接作为 DeepSeek 的输入数据。

weixin_44872675的博客 1万+

基于RAG架构搭建医疗智能问答系统

LLM大语言模型的出现,让许多系统或产品都有了更大的构建空间。这篇文章介绍了自己基于主流的RAG架构搭建一个医学智能问答系统的过程,一起来看看本文的梳理和解读。医疗智能问答是一个比较经典的医疗应用场景,在该场景下用户首先在对话系统中描述自己的症状,然后问答系统会根据输入的信息回复初步的医学建议。传统实现方法如规则引擎和知识图谱等由于缺乏对语境和语义的深层理解,导致无法处理过于复杂的问题。

weixin_58753619的博客 3258

从DBC到ARXML:详解DaVinci Configurator中通信栈的自动化配置逻辑

本文深入解析了Vector公司DaVinci Configurator工具如何将DBC文件自动转换为符合AUTOSAR标准的ARXML配置,详细介绍了从DBC到ARXML的映射逻辑、自动化配置的边界与陷阱,以及工程实践中的优化策略。帮助工程师高效配置汽车电子系统中的通信协议,提升项目开发效率。

weixin_30279671的博客 717

从零搭建企业级RAG知识库问答系统,大模型入门到精通,收藏这篇就足够了!

RAG(Retrieval-Augmented Generation,检索增强生成) 是一种融合信息检索与大模型生成能力的技术架构。

2401_82469710的博客 1153

保姆级教程:SAP ABAPer如何为VF01销售发票和MIRO发票校验配置凭证替代(含AC_DOCUMENT BADI完整代码示例)

本文详细解析了SAP ABAP中通过AC_DOCUMENT BADI实现VF01销售发票和MIRO发票校验的凭证替代技术。从技术选型到BADI实施步骤,再到核心逻辑代码示例,为ABAP开发者提供了一套完整的解决方案,帮助应对财务部门复杂的业务需求。

weixin_30421809的博客 352

爬取信用中国里面的行政处罚

result字段名为行政处罚文书号、处罚决定日期、处罚内容、处罚金额、违法事实、处罚机关、公司名称,行政处罚次数。file_path=r'E:\Data analyze\python\行政处罚爬虫/'#路径需要按实际修改。writer = pd.ExcelWriter('统计.xlsx')# 写入Excel文件。src_workbook=file_path+r'行政处罚(名单).xls' #表格名称也要更改。# keyword = input("输入爬取的公司全称必须是全称")

qq_42863025的博客 1674

RAG 知识库搭建实战教程:从零到一构建本地问答系统

本文是一份面向初学者的RAG(检索增强生成)技术实战指南,帮助用户在Windows系统上从零搭建完整的RAG问答系统。指南分为六个阶段:1)环境准备(安装Python和VS Code);2)创建项目文件夹;3)安装必要的Python依赖库;4)创建测试文档;5)编写并运行RAG检索脚本(本地测试);6)集成大语言模型API实现完整问答功能。教程详细说明了每个步骤的操作方法,包括如何获取API密钥、处理中文文档、配置向量数据库等,确保即使没有AI开发经验的用户也能在30分钟内完成系统搭建。最终实现的效果是系统

weixin_46191006的博客 1590

proteus仿真51单片机操作指南:串口通信仿真配置详解

深入讲解如何在proteus仿真51单片机中实现串口通信,涵盖虚拟串口设置、电路连接与调试技巧,帮助开发者高效完成通信仿真验证。

weixin_36197669的博客 570

如何用 Java 构建企业级 RAG 私有知识库系统?

用 Java 构建企业级 RAG 私有知识库,核心不是“和 Python 比模型调用便捷性”,而是“用 Java 生态解决企业最关心的安全、高可用、可扩展问题”。你的 Spring 微服务经验、分布式架构设计能力、安全管控经验,都是纯 Python 方案难以替代的。按“知识库构建→检索增强→大模型调用→工程化保障”的流程推进,复用 Java 成熟工具链,就能搭建出满足企业需求的 RAG 系统。

2501_91798322的博客 1257

IDC 数据中心工程师面试题汇总

(适用于:IDC运维、机房值班、机房工程师、机柜运维、IDC基础设施、IDC网络运维岗)

老韩的Linux云计算架构师进阶之路 1078

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

上一篇: 从 0 到 1 掌握 LangChain Agents:自定义工具 + LLM 打造智能工作流!
下一篇: 聊天 Chat复现之前代码
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值