


本文详细解析了Transformer模型的架构和工作原理,包括Encoder和Decoder两大部分。重点介绍了输入表示(单词Embedding和位置Embedding)、Self-Attention机制、Multi-Head Attention结构,以及Encoder和Decoder的组件构成。Transformer通过并行训练和位置Embedding解决了传统RNN的顺序依赖问题,成为大模型的核心架构,其自注意力机制能够有效捕捉单词间的关联关系。
1.Transformer 整体结构
首先介绍 Transformer 的整体结构,下图是 Tansformer 用于中英文翻译的整体结构:
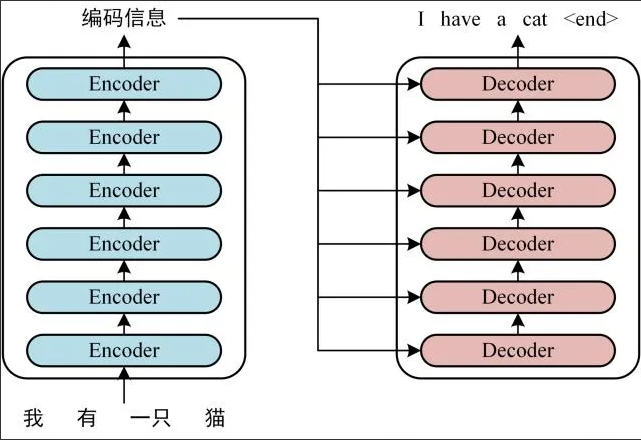
Transformer 的整体结构,左图Encoder和右图Decoder
可以看到Transformer由Encoder和 Decoder 两个部分组成,Encoder和Decoder都包含6个block。
Transformer 的工作流程大体如下:
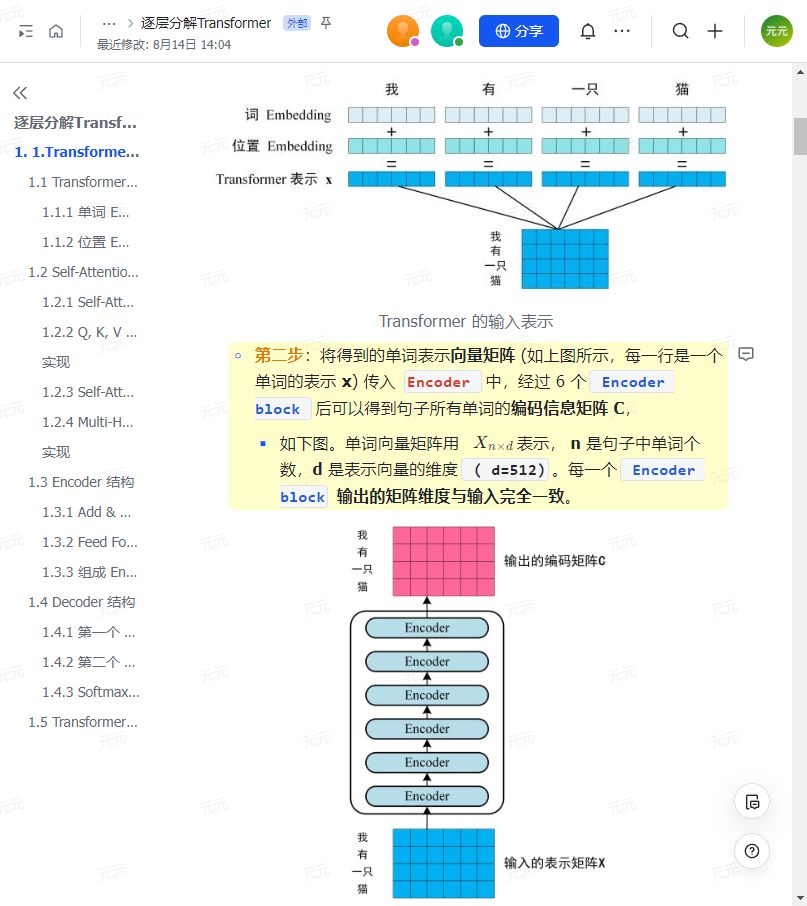
第一步:构建输入句子中每个单词的表示向量X,该向量通过单词的Embedding(即从原始数据提取的特征)与单词位置的Embedding叠加生成。
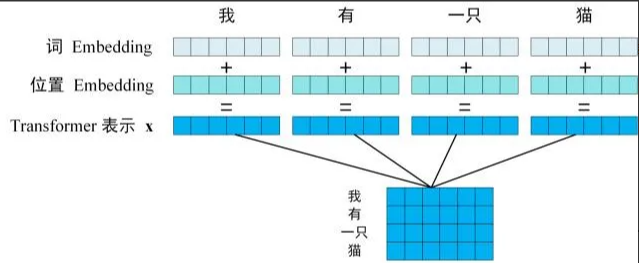
Transformer的输入表示
第二步:将形成的单词表示向量矩阵(如图示,每行对应一个单词的表示x)输入至Encoder,经过6个Encoder模块处理后,输出包含句子全部单词编码信息的矩阵C。

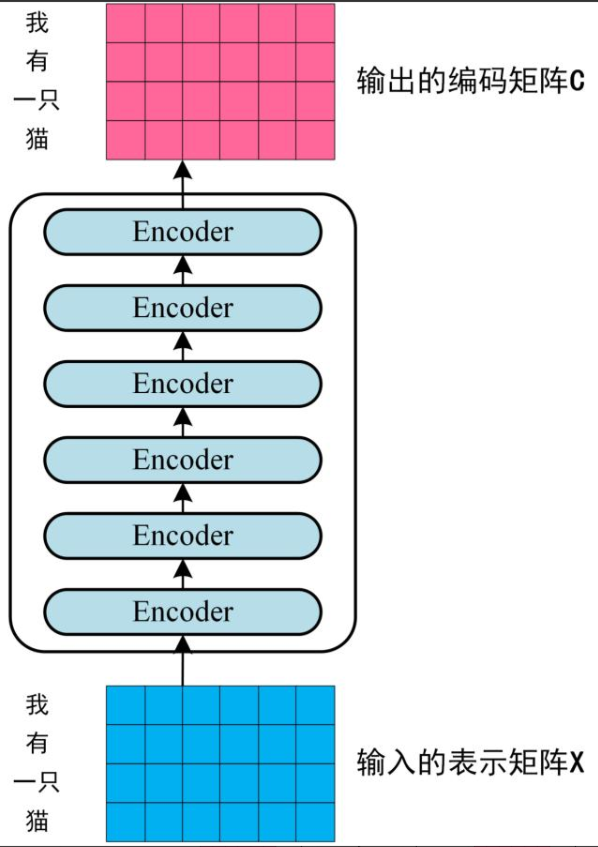
Transformer Encoder 编码句子信息
第三步:将Encoder生成的编码矩阵C传递至Decoder,Decoder按序基于已翻译的单词1~i预测后续单词i+1,如图示流程。
在预测i+1时需通过Mask操作遮蔽i+1之后的单词信息。
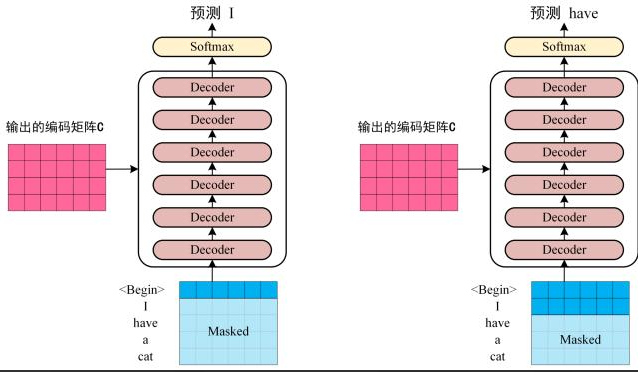
Transofrmer Decoder 预测
图示中,Decoder首先接收编码矩阵C并输入起始符"“,首轮预测结果为"I”;随后结合"“与"I"预测"have”,逐步推进。
此为Transformer模型的基本工作流程,后续将详解各组件细节。
1.1 Transformer 的输入
Transformer 中单词的输入表示x由 单词 Embedding 和 位置 Embedding(Positional Encoding)相加得到。
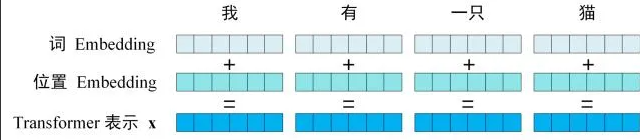
Transformer 的输入表示
1.1.1 单词 Embedding
单词的 Embedding 有很多种方式可以获取,例如可以采用 Word2Vec、Glove 等算法预训练得到,也可以在Transformer 中训练得到。
1.1.2 位置 Embedding
在Transformer模型中,除词Embedding外,还需引入位置Embedding(PE)以表征单词在句子中的位置信息。
由于Transformer摒弃了RNN结构,采用全局注意力机制,无法直接获取单词的顺序信息,而这正是自然语言处理(NLP)任务中的关键要素。
因此,位置Embedding被用于编码序列中单词的相对或绝对位置关系。
位置Embedding(PE)的维度与词Embedding保持一致。
其实现方式可分为两种:通过训练学习或基于公式计算。原始Transformer论文选择了后一种方法。
计算公式如下:
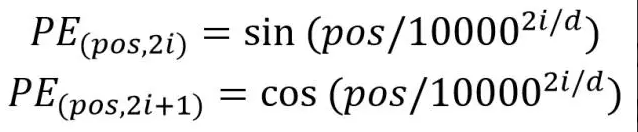
其中,pos 表示单词在句子中的位置索引,d 代表位置编码(PE)的维度(与词向量维度相同),2i 对应偶数维度的编号,2i+1 对应奇数维度的编号(需满足 2i≤d 且 2i+1≤d)。
采用公式化计算位置编码(PE)的主要优势在于其动态扩展性和相对位置计算的便捷性。
当输入句子的长度超出训练集最大长度(例如训练集中最长句子为20个单词,而新句子包含21个单词时),公式可以直接计算新增位置(如第21位)的编码,无需依赖预定义的最大长度限制。
此外,对于任意固定间距 k,模型可以通过 PE(pos) 直接推导出 PE(pos+k) 的编码值,从而简化了相对位置关系的建模过程。
这种设计使得位置编码能够灵活适应不同长度的句子,并便于模型捕捉单词间的相对位置信息。
因为 Sin(A+B)= Sin(A)Cos(B)+Cos(A)Sin(B),Cos(A+B)= Cos(A)Cos(B)-Sin(A)Sin(B)。
1.2 Self-Attention(自注意力机制)
Transformer 的内部结构图
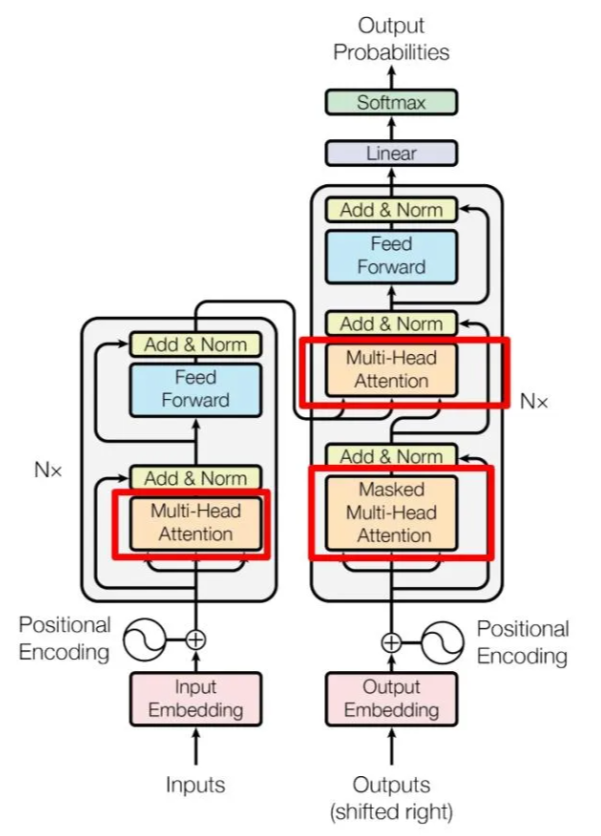
左侧为 Encoder block
右侧为 Decoder block
红色圈中的部分为 Multi-Head Attention,是由多个 Self-Attention 组成的
1)可以看到 Encoder block包含一个 Multi-Head Attention
2)而 Decoder block包含两个 Multi-Head Attention(其中有一个用到 Masked).
3)Multi-Head Attention 上方还包括一个 Add & Norm 层
4)Add 表示残差连接(Residual Connection)用于防止网络退化
5)Norm 表示Layer Normalization,用于对每一层的激活值进行归一化。
因为 Self-Attention是 Tansformer 的重点,所以我们重点关注 Mu1ti-Head Attention 以及 se1f-Attention,首先详细了解-下 self-Attention的内部逻辑。
1.2.1 Self-Attention 结构
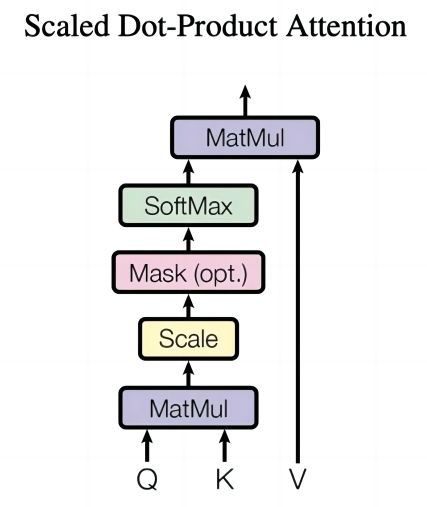
Self-Attention 结构
上图是 se1f-Attention 的结构,在计算的时候需要用到矩阵Q(查询),K(键值),V(值)。
在实际中,Self-Attention 接收的是输入(单词的表示向量x组成的矩阵X)或者上一个 Encoder block 的输出。
而Q,K,V正是通过Self-Attention 的输入进行线性变换得到的。
1.2.2 Q,K,V 的计算
Self-Attention 的输入用矩阵X进行表示,则可以使用线性变阵矩阵WQ,WK,WV计算得到Q,K,V。
计算如下图所示,注意 X,Q,K,V的每一行都表示一个单词。
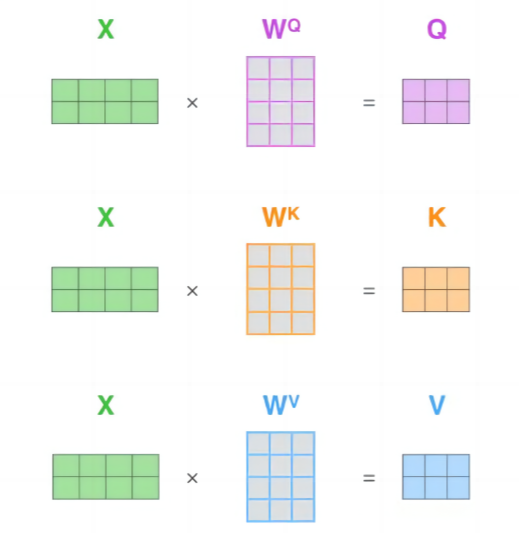
Q,K,V计算
实现
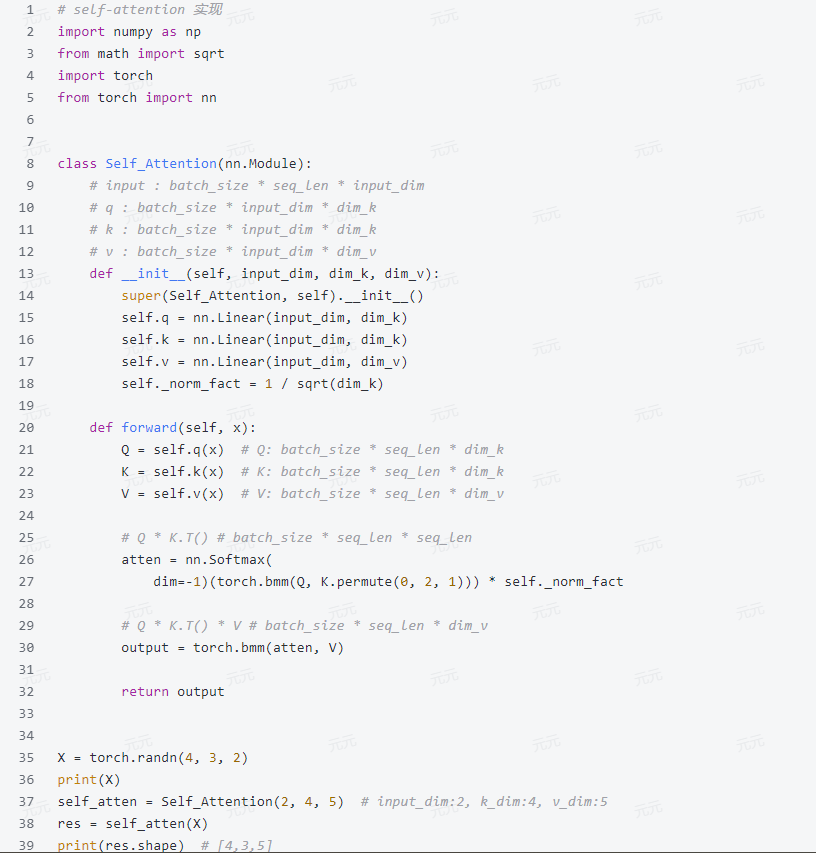
1.2.3 Self-Attention 的输出
得到矩阵 Q,K,V之后就可以计算出 Self-Attention 的输出了,计算的公式如下:
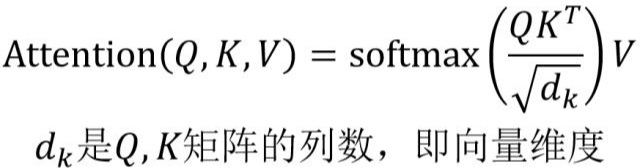
Self-Attention 的输出
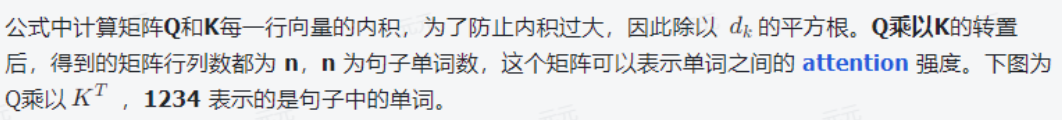
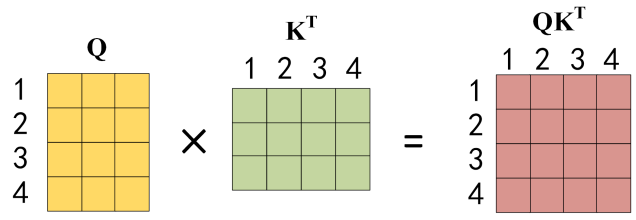
Q乘以K的转置的计算

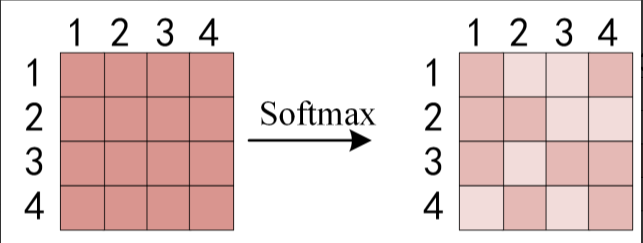
对矩阵的每一行进行 Softmax
得到 softmax 矩阵之后可以和V相乘,得到最终的输出Z。
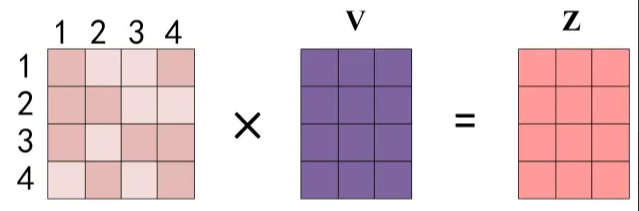
Self-Attention输出
上图中 softmax 矩阵的第1行表示单词1 与其他所有单词的 attention 系数,最终单词1的输出 2,等于所有单词i的值 V: 根据 attention 系数的比例加在一起得到,如下图所示:
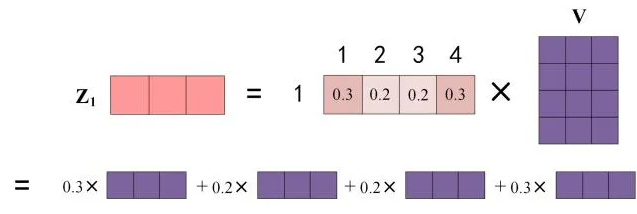
Zi 的计算方法
1.2.4 Multi-Head Attention
在前一步骤中,我们已经掌握了如何利用 Self-Attention 机制生成输出矩阵 Z。
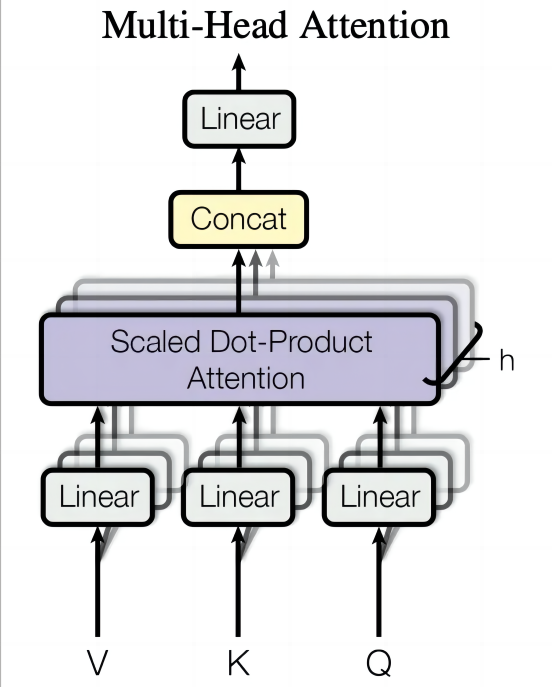
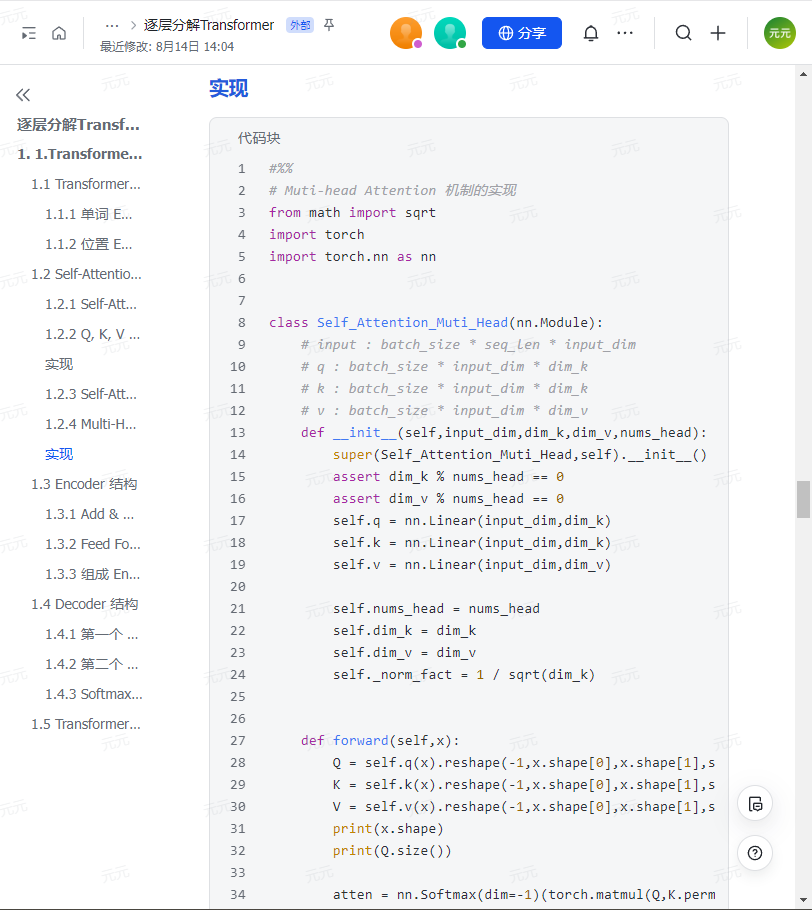
而 Multi-Head Attention 的本质是多个 Self-Attention 的集成结构,论文中的 Multi-Head Attention 架构图如图所示。
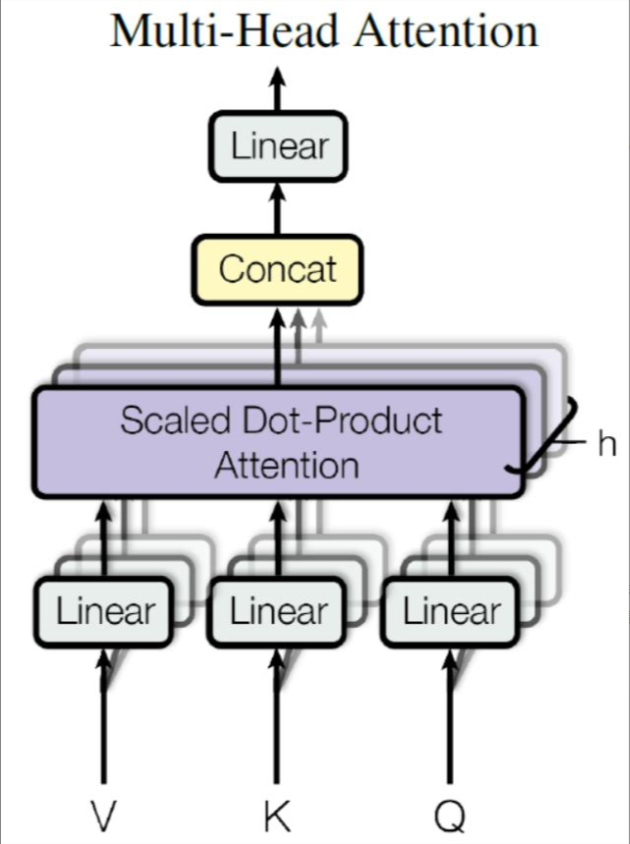
Multi-Head Attention
通过图示可以明确:
Multi-Head Attention 由多个独立的 Self-Attention 层构成,其过程是将输入 X 并行分配到 h 个不同的 Self-Attention 模块中,最终输出 h 个矩阵 Z。
以 h=8 为例,此时系统会生成 8 个独立的输出矩阵 Z。
实现
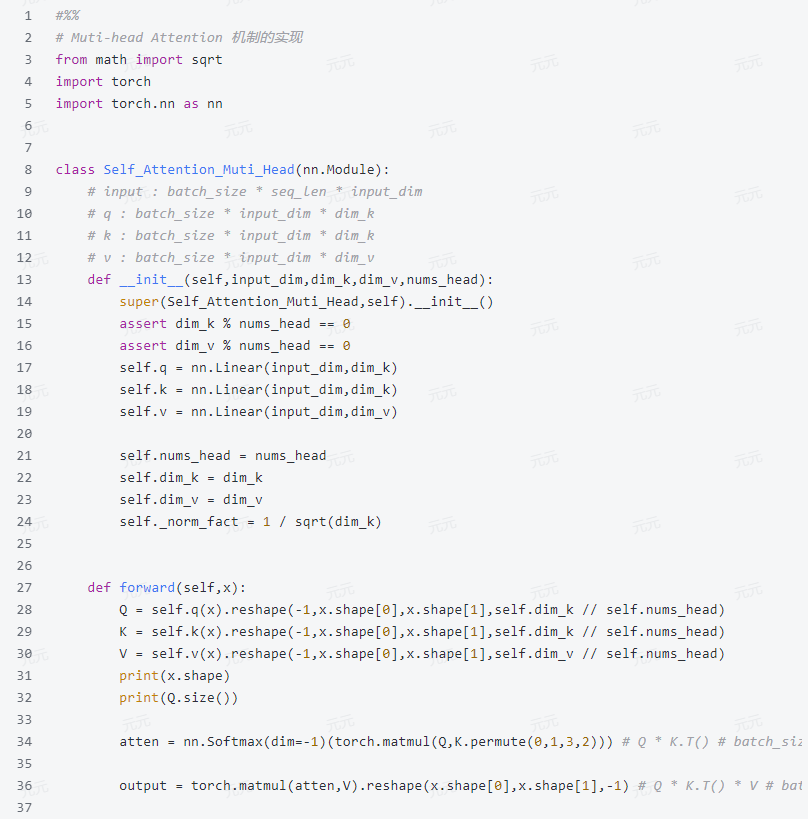
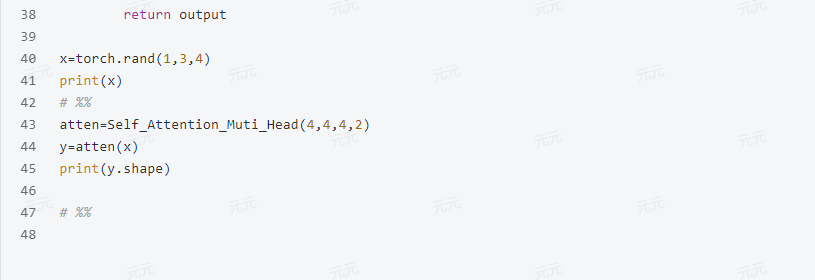
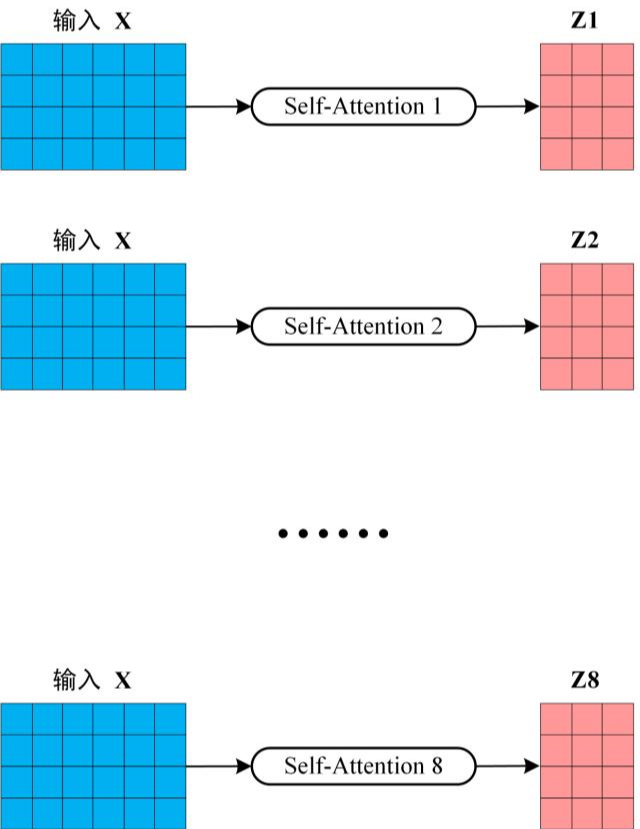
多个Self-Attention

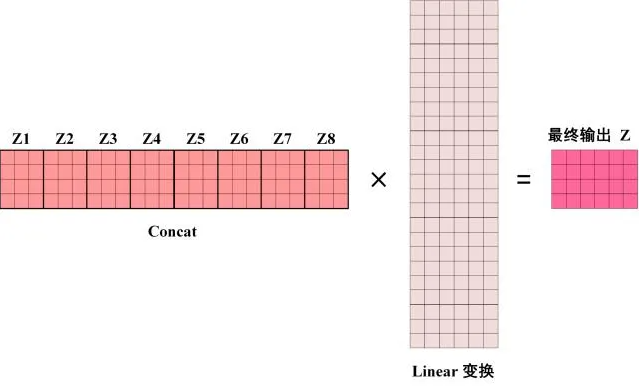
Multi-Head Attention的输出
可以看到 Multi-Head Attention输出的矩阵Z与其输入的矩阵X的维度是一样的。
1.3 Encoder 结构
红色部分展示了 Transformer 的 Encoder block 架构,其核心组件依次为 Multi-Head Attention、Add & Norm、Feed Forward 以及重复的 Add & Norm。
此前已详细解析了 Multi-Head Attention 的运算逻辑,接下来将重点探讨 Add & Norm 和 Feed Forward 的具体实现机制。
Transformer Encoder block
1.3.1 Add & Norm
Add & Norm 层由 Add 和 Norm 两部分组成,其计算公式如下:
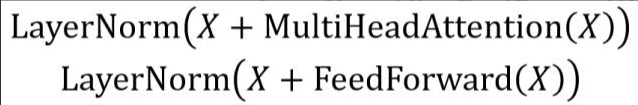
Add & Norm 公式
其中X代表Multi-Head Attention或Feed Forward的输入,MultiHeadAttention(X)与FeedForward(X)作为输出(由于输出与输入X维度相同,二者可直接相加)。
Add操作即X+MultiHeadAttention(X),属于残差连接机制,主要应用于缓解深层网络训练难题,使网络聚焦于差异特征的学习,该设计在ResNet架构中被广泛采用。
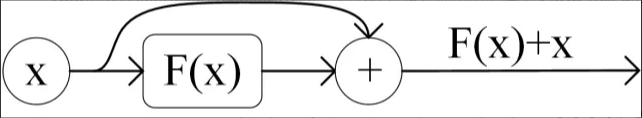
残差连接
Norm表示Layer Normalization,常见于RNN结构,其作用是通过标准化使数据分布具有统一的均值和方差,从而提升模型收敛速度。
1.3 .2 Feed Forward
Feed Forward 层比较简单,是一个两层的全连接层,第一层的激活函数为 Relu,第二层不使用激活函数,对应的公式如下。
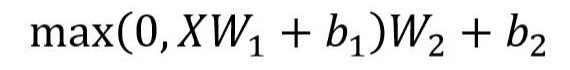
Feed Forward
X是输入,Feed Forward 最终得到的输出矩阵的维度与X一致。
1.3.3 组成 Encoder
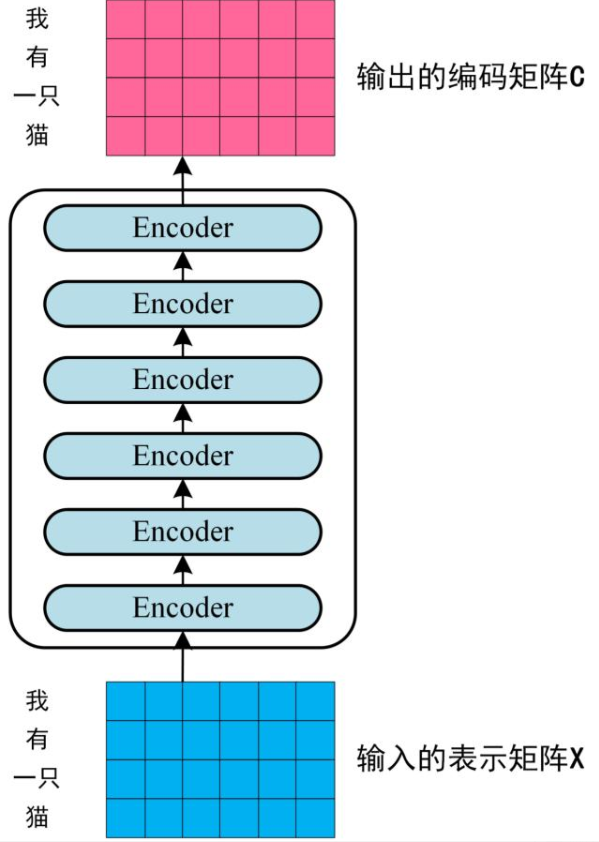
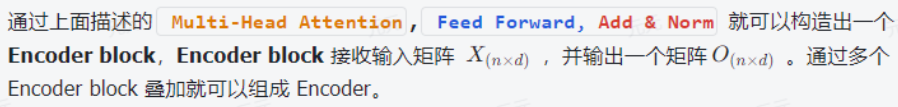
第一个 Encoder block的输入为句子单词的表示向量矩阵
后续 Encoder block 的输入是前一个 Encoder block 的输出
最后一个 Encoder block 输出的矩阵就是编码信息矩阵 C,这一矩阵后续会用到 Decoder 中。
1.4 Decoder 结构
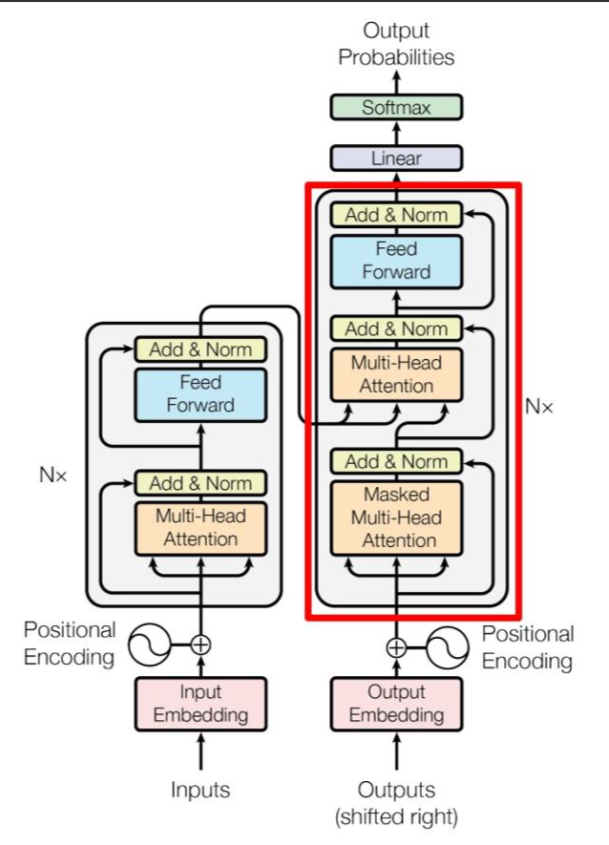
红色部分为 Transformer 的 Decoder block 结构与 Encoder block 相似,但是存在一些区别:
包含两个 Multi-Head Attention 层。
第一个 Multi-Head Attention 层采用了Masked 操作。
第二个 Multi-Head Attention 层的K,V矩阵使用 Encoder 的编码信息矩阵C进行计算,而Q使用上一个 Decoder block 的输出计算。
最后有一个 Softmax 层计算下一个翻译单词的概率。
1.4.1 第一个 Multi-Head Attention
在Transformer模型的Decoder block中,首个Multi-Head Attention模块会应用Masked机制。
这是由于机器翻译属于典型的序列生成任务——必须等第i个词完成解码后,才能处理第i+1个词。
这种设计通过掩码(Masked)有效阻断了当前位置词对后续词信息的获取。
例如,将中文句子"我有一只猫"转换为英文"I have a cat"时,Masked操作确保了翻译过程的单向依赖性。
在解码阶段,Decoder需要基于已生成的翻译结果,推断当前最可能的翻译输出。
如图所示,其工作流程如下:初始输入"“时,模型会预测首个单词为"I”;随后,当输入变为"I"时,模型将继续预测下一个单词"have"。
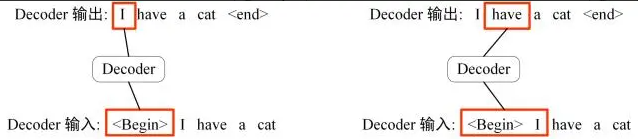
Decoder预测
Decoder 可以在训练的过程中使用 Teacher Forcing 并且并行化训练,即将正确的单词序列(I have a cat)和对应输出(I have a cat)传递到 Decoder。
那么在预测第 i 个输出时,就要将第 i+1 之后的单词掩盖住。
注意 Mask 操作是在 self-Attention 的 Softmax 之前使用的,下面用012345 分别表示I have a cat
第一步:
1)这里展示的是Decoder的输入矩阵与Mask矩阵结构。输入矩阵由序列’I have a cat’的五个单词(0,1,2,3,4)的向量表示组成,对应一个5×5的Mask矩阵。
通过观察Mask矩阵可见,单词0仅能访问自身信息(位置0),单词1可访问位置0和1的信息,该约束机制确保模型只能使用当前位置之前的上下文信息。
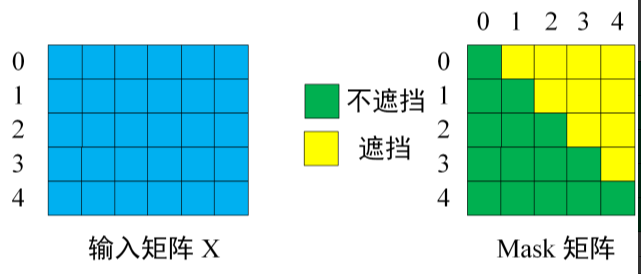
输入矩阵与Mask矩阵
第二步:

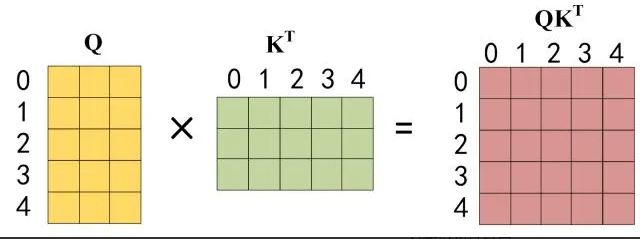
Q乘以K的转置
第三步:

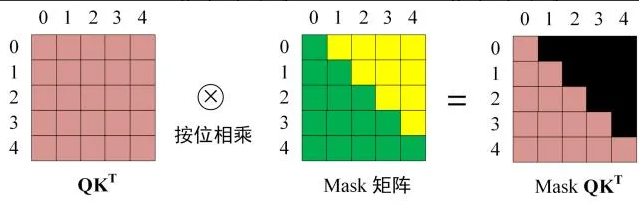
Softmax 之前 Mask

第四步:

第五步:
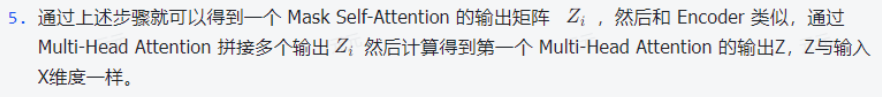
1.4.2 第二个 Multi-Head Attention
在Decoder block的第二个Multi-Head Attention模块中,其核心机制与常规设计基本一致。
关键差异体现在Self-Attention的K(键)、V(值)矩阵生成方式上:这里并非采用前一个Decoder block的输出作为输入来源,而是直接引用了Encoder输出的编码信息矩阵C进行计算。
通过Encoder的输出C生成K和V,Q的计算则基于前一个Decoder block的输出Z(若为首个Decoder block,则采用输入矩阵X作为计算基础),其余计算流程与前述方法相同。
这样做的好处是在 Decoder 的时候,每一位单词都可以利用到 Encoder 所有单词的信息 (这些信息无需Mask).
1.4.3 Softmax预测输出单词
Decoder block 最后的部分是利用 softmax 预测下一个单词,在之前的网络层我们可以得到一个最终的输出Z,因为 Mask 的存在,使得单词0的输出Z0只包含单词0的信息,如下:
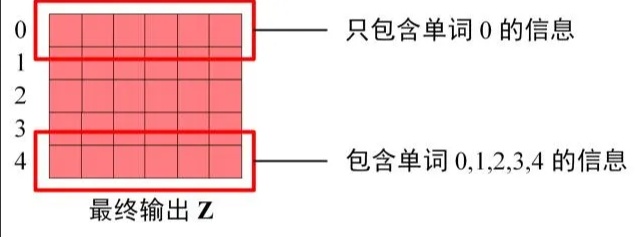
Decoder Softmax 之前的 Z
Softmax根据输出矩阵的每一行预测下一个单词:
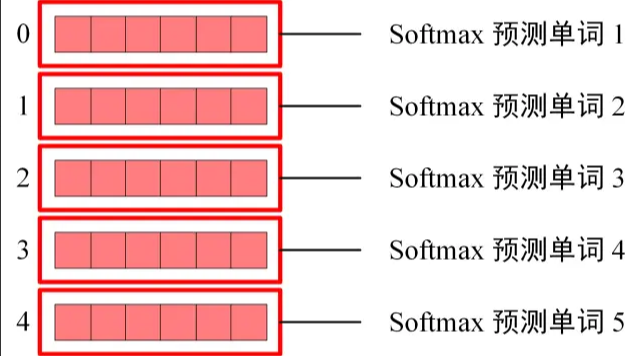
Decoder Softmax 预测
这就是 Decoder block的定义,与Encoder一样,Decoder是由多个Decoder block组合而成
1.5 Transformer 总结
Transformer 与 RNN 不同,可以比较好地并行训练。
Transformer 本身是不能利用单词的顺序信息的,因此需要在输入中添加位置 Embedding,否则Transformer 就是一个词袋模型了。
Transformer 的重点是 Self-Attention 结构,其中用到的 Q,K,V矩阵通过输出进行线性变换得到。
Transformer 中 Multi-Head Attention 中有多个 Self-Attention,可以捕获单词之间多种维度上的相关系数 attention score。
以上配套文档(完整版)可分享↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓
零基础如何高效学习大模型?
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

【精选AI大模型权威PDF书籍/教程】
精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
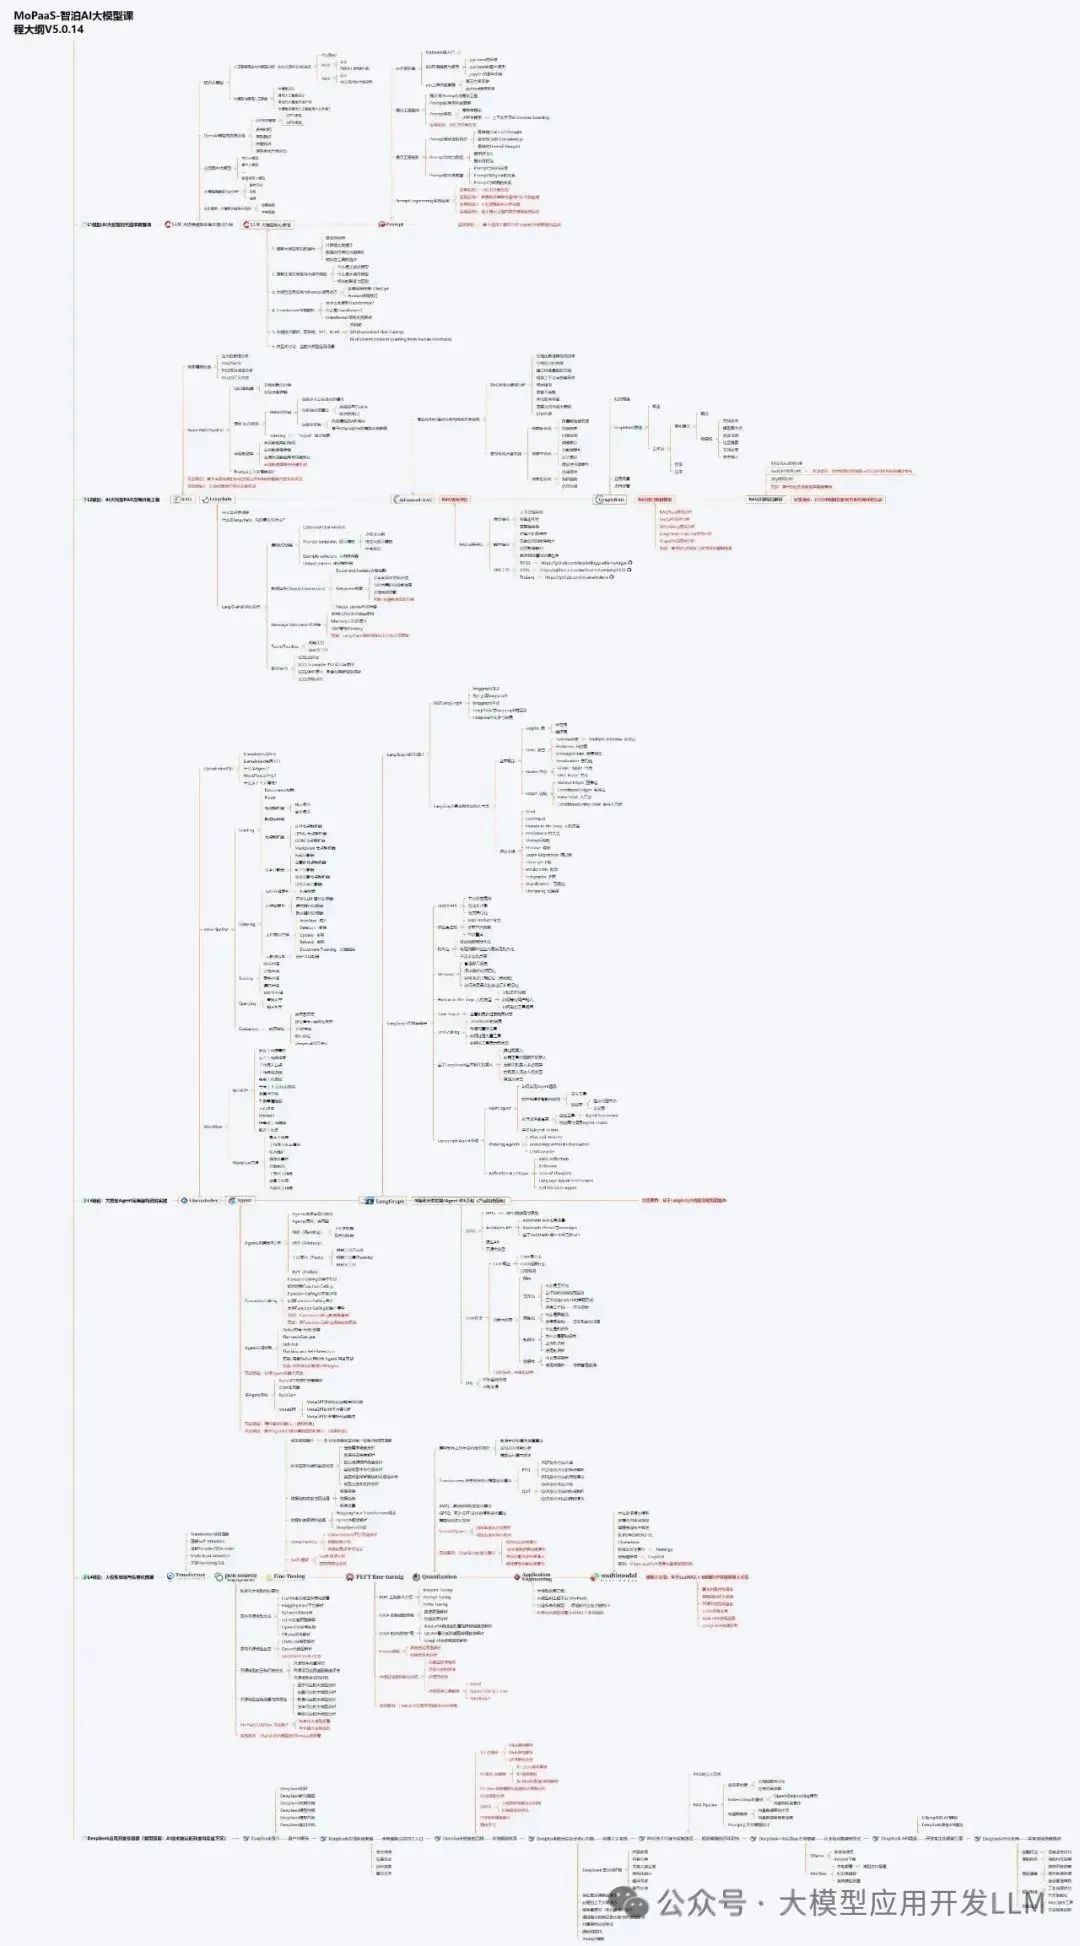
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
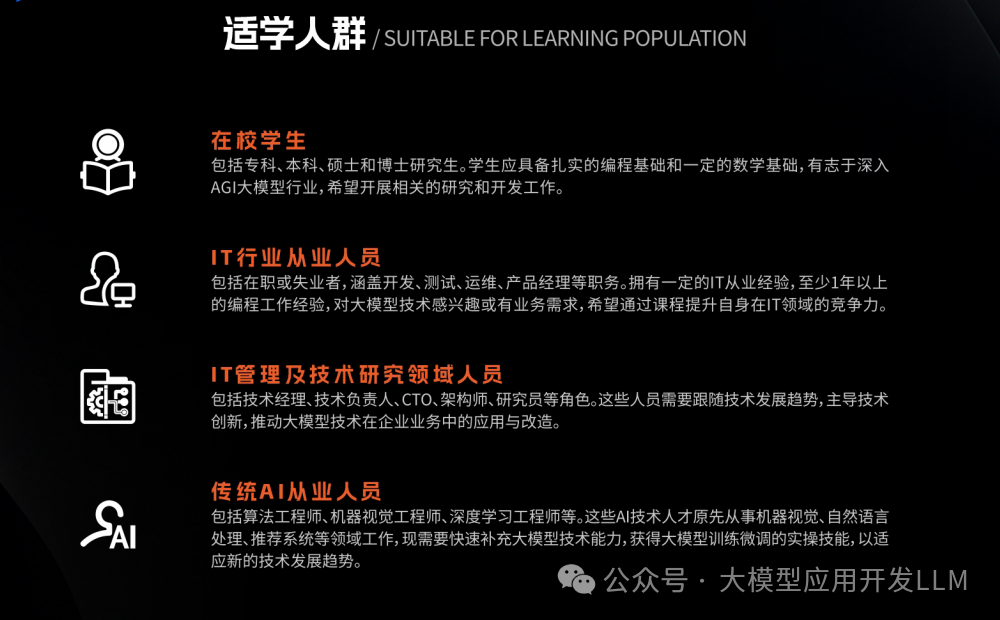
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
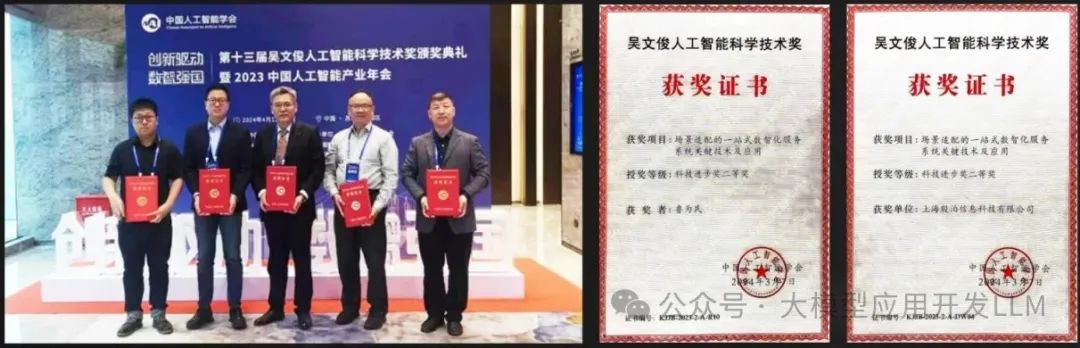
内容实用,循序渐进:
-
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
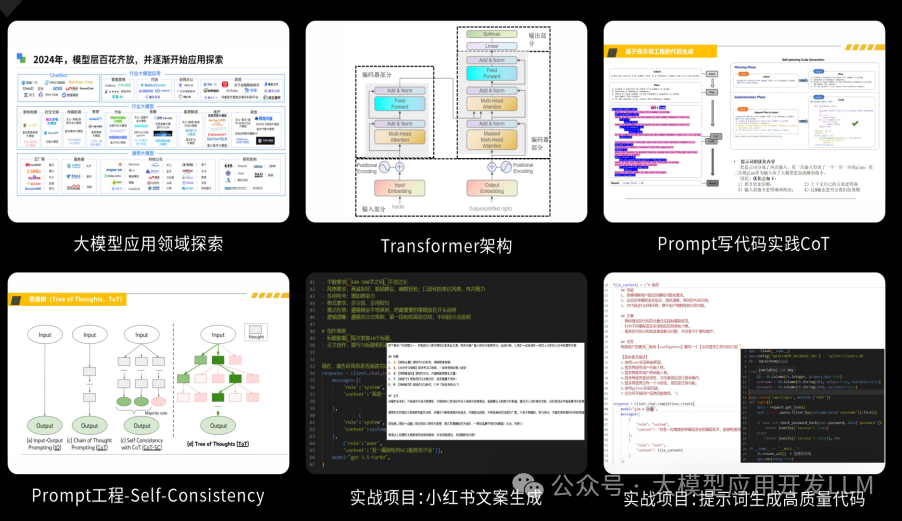
抓住机遇,开启你的AI学习之旅!
 5628


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


