大模型面经—分布式训练指南

vLLM 多机多卡推理测试与验证(Kubernetes)vLLM 多机多卡推理 Kubernetes 验证 本文记录在两台 L20 机器,每台机器 4 块 L20 显卡(46G)的环境下,使用 vLLM 部署 Qwen2.5-32B-Instruct-GPTQ-Int4 模型并提供多节点多卡推理服务的过程。服务(Serving)模型服务是指将模型部署到生产环境中,通过 API 或其他接口提供预测服务的过程。【分布式推理与服务】(Distributed Inference and Serving)是指在多个机器或设备之间部署和管理机器学习模型,以高效地处理推理请求并满足大规模服务需求。3、启动 vLLM 服务。 阅读详情

本篇来总结一些分布式训练的知识,还是按照面经的形式给出,希望能给到大家一些帮助。

题目

1 训练一个LLM,需要的显存规模跟参数的关系是什么?

\2. 如果有N张显存足够大的显卡,怎么加速训练?

\3. 如果有N张显卡,但每个显卡显存都不足以装下一个完整的模型,应该怎么办?

\4. PP推理时是串行的,1个GPU计算但其他空闲,有什么其他的优化方式?

\5. DP、TP、PP这3种并行方式可以叠加吗?

\6. 3D并行或者直接上多机多卡的ZeRO的条件是什么?

答案

1. 训练一个LLM,需要的显存跟参数的关系是什么?

主要公式是 模型本身占用显存 + 多个batch数据运算的存储 , 跟实际精度,模型大小、中间变量计算以及batch邮官

2. 如果有N张显存足够大的显卡,怎么加速训练?

数据并行(DP),充分利用多张显卡的算力。

3. 如果有N张显卡,但每个显卡显存都不足以装下一个完整的模型,应该怎么办?

PP,流水线并行,需要分层加载,把不同的层加载到不同的GPU上(accelerate的device_map)

4. PP推理时是串行的,1个GPU计算但其他空闲,有什么其他的优化方式?

  1. 流水线并行(PP), 横向切分,也就是分层加载到不同的显卡上。

  2. 张量并行(TP),纵向切分,在 DeepSpeed 里叫模型并行(MP)

下面来简单梳理一下DP,PP,TP,ZeRO以及其中MP的关系。

  • DP Data parallelism

数据并行算法在多个设备上都拷贝一份完整的模型参数,彼此之间可以独立计算,所以每个设备传入的输入数据不一样,这也是为什么叫数据并行。

只不过每隔一段时间(比如一个batch或者若干个batch)后需要彼此之间同步模型权重的梯度。

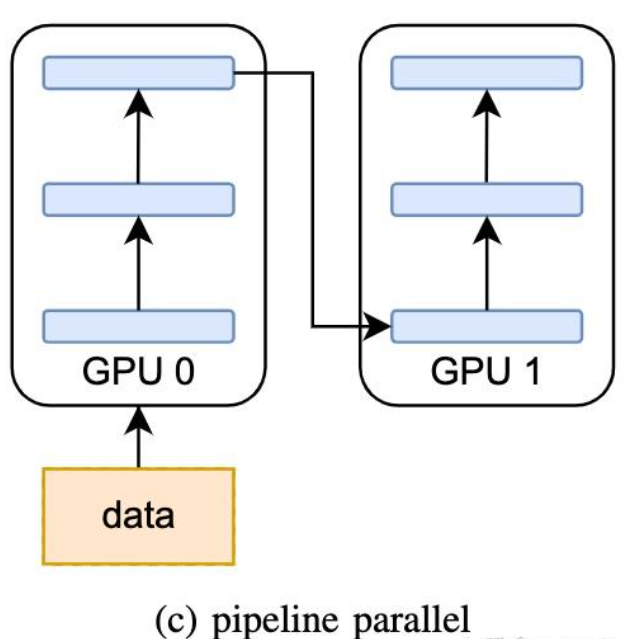
  • PP Pipeline Parallelism

属于 Model Parallelism (MP), 模型并行算法,它是模型做层间划分,即inter-layer parallelism。

以下图为例,如果模型原本有6层,你想在2个GPU之间运行pipeline,那么每个GPU只要按照先后顺序存3层模型即可。
img

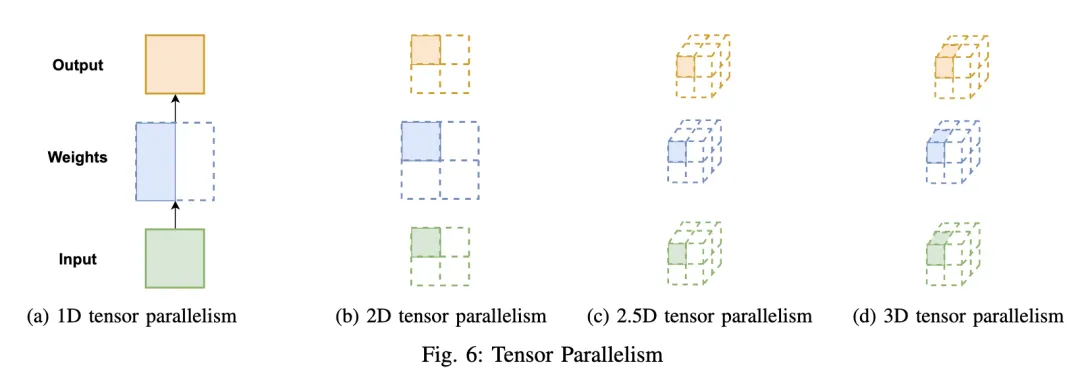
  • TP Tensor Parallelism

Tensor Parallelism就是对模型层内做划分,也叫inter-layer parallelism。

就是把一个变量分散到多个设备并共同完成某个或多个计算操作。对于单个 Tensor/Op 很大 或者模型很大(如GPT3, chatGPT等)的情况,Tensor parallelism 的重要性非常明显。
在这里插入图片描述

TP最好带入到不同的模型中去学习,比较好的参考是Megatron-LM,这个可以参考 【 深度学习并行训练算法一锅炖: DDP, TP, PP, ZeRO 】 - https://zhuanlan.zhihu.com/p/581677880 ;另外还有GPT模型训练,这个可以参考【 LLM(六):GPT 的张量并行化(tensor parallelism)方案】 - https://zhuanlan.zhihu.com/p/603908668 这篇。

  • ZeRO

这个之前有比较详细的介绍。

5. DP、TP、PP这3种并行方式可以叠加吗?

可以,DP+TP+PP,这就是3D并行。

如果真有1个超大模型需要预训练,3D并行是必不可少的。

单卡80g,可以完整加载小于40B的模型,但是训练时需要加上梯度和优化器状态,5B模型就是上限了,更别说 activation的参数也要占显存,batch size还得大。而现在100亿以下(10B以下)的LLM只能叫small LLM。

6. 3D并行或者直接上多机多卡的ZeRO的条件是什么?

3D并行的基础是,节点内显卡间NVLINK超高速连接才能上TP。显卡有没有NVLINK都是个问题。

Zero3 需要满足通信量,假设当65B模型用Zero3,每一个step的每一张卡上需要的通信量是195GB(3倍参数量),也就 是1560Gb。万兆网下每步也要156s的通信时间,非常不现实。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

大模型并行:TP, PP, DP,MP 大模型并行:TP, PP, DP,MP 张量并行(TP) 数据并行(DP) 模型并行(MP) 流水线并行(PP) 阅读详情

相关推荐

VS2019 从零构建 OSG+OSGEarth+OSGQt 开发环境实战指南

本文提供了一份详细的实战指南,指导开发者如何在Windows系统下使用VS2019从零开始编译和配置OSG、OSGEarth与OSGQt开发环境。文章涵盖了从环境准备、源码获取、CMake配置、Visual Studio编译到最终测试的完整流程,并分享了关键的避坑技巧,旨在帮助三维GIS与可视化开发者高效搭建稳定、可控的专业开发平台。

weixin_28826961的博客 367

四张GeForce RTX3090进行TP/PP/TP+PP推理实验

在单机多卡3090 通过PCIe 4.0互联场景,使用张量并行的端到端时延(e2e),GPU利用率等指标,相对PP,混合并行都有明显优势.

goodgood_UP的博客 1014

基于CANoe的车载以太网测试

以太网测试 CANoe

Yafet 4553

解密AI大模型训练的三大并行策略:DP、TP、PP

随着人工智能领域的迅速发展,深度学习模型变得越来越大,参数数量也从数百万增加到了数十亿甚至更多。为了应对这些大规模模型带来的挑战,研究者们开发了多种并行化策略以加速训练过程和提高计算资源利用率。在大模型训练领域,数据并行(Data Parallelism, DP)、张量并行(Tensor Parallelism, TP)和流水线并行(Pipeline Parallelism, PP)是三个关键的并行策略。它们在处理大规模模型训练时发挥着重要作用,合理运用这些策略能够显著提升训练效率和效果。

2401_84208172的博客 7293

Maven的下载安装配置教程(详细图文)

目录 一、简单了解一下什么是Maven 二、maven的下载 三、maven的安装 四、maven的环境变量配置 五、setting文件配置 六、开发工具配置Maven 一、简单了解一下什么是Maven Maven就是一款帮助程序员构建项目的工具,我们只需要告诉Maven需要哪些Jar 包,它会帮助我们下载所有的Jar,极大提升开发效率。 1.Maven翻译为“专家“, ”内行”的意思,是著名Apache公司下基于Java开发的开源项目。 2.Maven项目对象模型(POM)是一..

bakelFF的博客 12万+

Android定位权限全解析:从基础配置到后台持续定位的完整解决方案

本文全面解析Android定位权限体系,从基础配置到后台持续定位的完整解决方案。涵盖LocationManager和FusedLocationProviderClient等主流API的对比选型,详细讲解动态权限申请、精确定位与模糊定位的智能切换,以及Android 10+的后台定位适配策略。帮助开发者构建兼顾精准度与电量友好的定位方案,适用于导航、运动轨迹记录等多种场景。

weixin_29310605的博客 608

VLLM轻松部署DP模型

设置V1引擎。

weixin_45918935的博客 541

【STK】手把手教你利用STK进行覆盖分析05-方位覆盖分析、覆盖网络检查工具和单对象覆盖分析

这一篇是我们STK覆盖模块的理论部分的最后一篇文章,之后会找尽可能多的论文来复现论文中关于STK覆盖模块的仿真的部分,到时候大家遇到不会的就可以结合前面的理论部分来看。

weixin_44184852的博客 1493

【vllm】源码解读:vLLM 中 Data Parallelism DP=8 核心原理详解

vLLM DP=8架构通过8个独立进程(DPEngineCoreProc)实现数据并行,每个进程包含GPU组和TP=8张量并行配置。核心特点包括:1) 采用ZMQ通信实现进程间协调;2) 智能负载均衡机制分发请求;3) 通过DP Coordinator进行全局同步。架构优势在于独立进程设计提升吞吐量,支持动态批处理和请求调度,适用于大规模推理场景。关键技术包含无状态进程组初始化、全局同步检查(每32步执行all-reduce)和虚拟批次执行机制,在保持低延迟的同时实现8倍吞吐提升。

jack.li的博客 1563

FISCO BCOS 系列(一)—— 搭建第一个区块链网络&配置控制台指南

本文详细介绍了FISCO BCOS区块链网络的搭建与配置过程,包括环境准备、单机四节点网络搭建、控制台配置使用等核心内容。从系统要求、依赖安装开始,逐步指导如何通过脚本快速搭建区块链网络,配置控制台连接,并演示了账户管理、合约部署调用等基础操作。同时提供了多节点网络配置、常见问题解决方案以及生产环境安全建议,为开发者提供了从入门到进阶的完整指南。

分享AI、区块链技术及应用,未来已来 809

告别 DIFY 构建卡顿 / 失败!巧用 Makefile 一键构建本地 WEB 镜像,附核心避坑指南

本文详细介绍了DIFY本地源码构建WEB镜像的完整流程,重点解决因官方npm源不稳定导致的构建失败问题。通过修改web/Dockerfile文件启用国内npmmirror镜像源,可大幅提升依赖下载速度和稳定性。在DIFY根目录执行封装好的make build-web命令即可一键完成构建,无需手动编写复杂docker命令。文章还提供了前置环境准备、构建结果验证等实用指导,帮助开发者高效完成DIFY前端二次开发后的镜像构建验证。

2501_93651177的博客 182

大模型-性能优化-训练、推理

本文总结了当前大模型训练和推理优化的关键技术及工具库。在推理优化方面,介绍了vLLM、TensorRT等主流推理引擎,以及KV Cache、FlashAttention等性能优化方法。训练优化包括模型结构优化(MQA/GQA)、工程优化(混合精度、并行训练框架)以及微调技术(LoRA等)。此外,还提出了系统级优化策略,如实时转非实时处理、工作并行化等,通过计算复用和流程优化提升整体效率。这些方法共同构成了大模型高效训练和推理的技术体系。

乐于创作,乐于分享,志于创作高价值博文 943

C++11、C++14 和 C++17 标准新特性详解

特性C++11C++14C++17auto类型推导✅范围 for 循环✅Lambda 表达式✅✅✅智能指针✅移动语义✅nullptr✅统一初始化{}✅✅constexpr✅✅✅✅数字分隔符✅结构化绑定✅✅✅文件系统库✅。

h a 6 6 6 c k 为 你解决复杂难题! 440

vLLM-Omni分布式推理指南:TP/PP/DP并行策略详解

vLLM-Omni是一个专为全模态模型设计的高效推理框架,支持文本、图像、音频和视频等多种模态的输入输出。作为vLLM的扩展,它不仅继承了vLLM在自回归模型上的优化特性,还针对扩散模型等非自回归结构进行了深度优化。 ## 什么是分布式推理?🤔 分布式推理是指将一个大型模型的计算任务分解到多个计算设备上并行执行的技术。在vLLM-Omni中,主要支持三种并行策略: ### 张量并行(TP)

gitblog_00259的博客 867

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

分布式训练

将 mini-batch 进一步划分成更小的 micro-batch,同时利用 pipipline 方案,每次处理一个 micro-batch 的数据,得到结果后,将该 micro-batch 的结果发送给下游设备,同时开始处理后一个 micro-batch 的数据,通过这套方案减小设备中的 Bubble(把网络分成 4 块,每一块放在一个 GPU 上,不同的颜色表示不同的 GPU),于是就有了 F0、F1、F2、F3 这 4 个管级的前向路径,然后是 B3、B2、B1、B0 的逆序后向路径。

EveyD的博客 990

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

大模型TP、SP、EP切分

文章摘要:本文对比了传统Dense大模型和MoE大模型在并行计算方式上的差异。传统模型采用TP切分,Attention和FNN部分都需进行前向和反向各一次AR计算。而加入SP并行后,计算模式发生变化:前向的g{}变为AG,反向的g{}变为RS。文中以FNN部分为例说明计算模式转变,指出Attention部分也可采用类似处理方式。这反映了模型并行计算策略的演进过程。

hliyuxin的专栏 464

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

数据并行(DP)、张量模型并行(TP)、流水线并行(PP)

数据集分为n块,每块随机分配到m个设备(worker)中,相当于m个batch并行训练n/m轮,模型也被复制为n块,每块模型均在每块数据上进行训练,各自完成前向和后向的计算得到梯度,更新后,再传回各个worker。以确保每个worker具有相同的模型参数。下图1:每个设备分1份数据下图2:每个设备分4份数据数据不切分的话,就是总共N-1次传输中每次传输数据大小为O(O是模型参数量),数据流转完整一圈仍然需要(N-1)*O的时间,传统参数服务器的总时间没区别了。

yuanyuanxingxing的专栏 4万+

昇腾大模型性能分析思路

我们根据性能问题的场景,按照单机和集群场景进行分类,再明确性能问题属于哪一类,明确好性能问题背景之后,才方便进行下一步问题的定位;在明确问题背景后,参考,选择对应的性能工具,采集性能数据并拆解性能,找到需要提升性能的模块;在明确性能瓶颈模块后,将问题细化定位到下发、计算和通信等模块,并通过本文目录搜索到对应章节找到对应优化算法。

记录个人日常所学所思 3058

图解大模型计算加速系列:vLLM源码解析1,整体架构

图中左侧是用户使用界面,罗列了上述所说的两种调用方式(注意,如前文所说,做demo用的api server官方已经不再维护了,openai_api_server才是官方推荐的使用方式,user custom server目前还没有实现)。右侧则是开发者界面,LLMEngine是vLLM的核心逻辑。:该方法将每一个请求包装成vLLM能处理的数据类型(SequenceGroup,后面我们会详细解释),并将其加入调度器(Scheduler)的waiting队列中。

python1234567_的博客 2730

推理引擎使用与实践:vLLM × DeepSpeed × TensorRT 全流程拆解

你训练好了大模型、调好了 Prompt、模型表现也不错,但一上线就掉帧、延迟飙升、显存爆炸? 问题不在模型本身,而在你还没有真正理解推理引擎的工作方式。 本篇文章从一名 AI 系统专家视角,系统讲解如何基于 vLLM、DeepSpeed-Inference 与 TensorRT 构建高吞吐、低延迟的推理服务,涵盖从模型加载、KV Cache 管理、动态批处理、量化部署到多模型切换的关键机制与实践技巧。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 2088

大模型训练,DP/PP/TP/SP/EP到底怎么选?

并行策略DP 数据并行PP 流水线并行TP 张量并行SP 序列并行EP 专家并行Efficient training of large language models on distributed infrastructures: a survey 中的 overview如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

2401_85375186的博客 3801

理解大模型训练并行技术:DP/TP/PP/SP/EP

在深度学习训练中,单个GPU的内存限制引发了数据并行(DP)和模型并行(TP/PP/EP/SP)的需求。数据并行适用于模型小但数据量大的情况,通过切分数据到不同卡上计算并汇总,效率高但仅适用于微小模型。模型并行则用于大模型,通过切分模型到多张卡上,包括张量并行(TP)、流水线并行(PP)、专家并行(EP)和序列并行(SP)。张量并行通过切分模型内部的参数矩阵进行计算,但通信开销较大;流水线并行按层切分模型,通信量较小但气泡率较高;序列并行对输入矩阵按序列维度切分,减少激活值;专家并行则针对MoE模型,解决专

lyy2017175913的博客 1748

万字长文:模型部署与训练中的DP、EP、TP、PP、SP深度解析

在当今大模型(Large Model)时代,模型规模的急剧增长对计算资源提出了前所未有的挑战。单张计算卡(如GPU)的算力和显存已远不能满足千亿甚至万亿参数模型训练与部署的需求。为了应对这一挑战,分布式训练与推理技术应运而生,通过将计算任务和模型参数分解到多张乃至成千上万张计算卡上,实现了对庞大模型的有效处理。在分布式策略中,数据并行(Data Parallelism, DP)、专家并行(Expert Parallelism, EP)、张量并行(Tensor Parallelism, TP)、流水线并行(P

2401_85116933的博客 2576

大模型最新面试题系列:训练篇之分布式训练

模型并行显存最优,但通信开销最大;数据并行显存压力大但通信简单;流水线并行适合长模型,需平衡气泡与显存。

zhangzhentiyes的博客 1454
上一篇: 一文读懂:从RAG到多模态RAG
下一篇: 大模型 | 实战:从一张订单照片入手,大模型带你快速成为高手
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


