LoRA微调,真的有毒!

LoRa无线网络技术概述 LoRa无线网络基础知识 阅读详情
AI摘要

本文介绍了使用指令微调改造预训练模型的相关内容。指出LoRA指令微调不能让模型学会新知识,但能更好利用预训练知识,且比全量微调强;全量微调会导致模型模式复制,出现严重幻觉。此外,还分享了AGI大模型系统学习路线等学习资料。

本文介绍一篇相当有意思的文章,该文章的内容对我们使用指令微调将预训练模型改造为 Chat 模型和下游专业模型相当有指导意义。

本文的标题听起来有些唬人,有些标题党,但是这个论点在一定的限定条件下是成立的,笔者归纳为:对充分预训练的模型使用通用指令微调数据集进行全量微调有害。

01

LoRA指令微调并不能学习知识,但它很优秀

试图使用指令微调来为模型灌输知识,其实是一个很常见的做法。然而只要这样做过的人会发现,效果并不会特别好,特别是使用 LoRA 训练时,模型几乎学不到任何知识。

笔者自己的实践是,在使用 LoRA 对一个 Llama 3.1 本身没有怎么预训练过的内容进行微调时,最终的结果和随机预测基本没有区别(分类和回归任务改造的指令微调数据集)。

这提示我们,在使用指令微调对模型进行训练时,首先需要确定模型是否预训练过相关内容,如果没有,最好进行补充性的继续预训练。

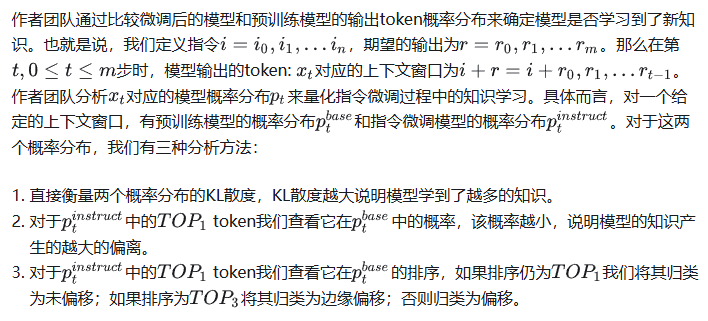
如何衡量模型是否通过指令微调学习到了知识?
图片

作者团队使用了多个指令微调数据集,分别通过全量和 LoRA 的方式对 Llama2_7B 进行训练,并且查看了模型在以上三个标准下的表现。

作者团队使用了多个指令微调数据集,分别通过全量和 LoRA 的方式对 Llama2_7B 进行训练,并且查看了模型在以上三个标准下的表现。
图片

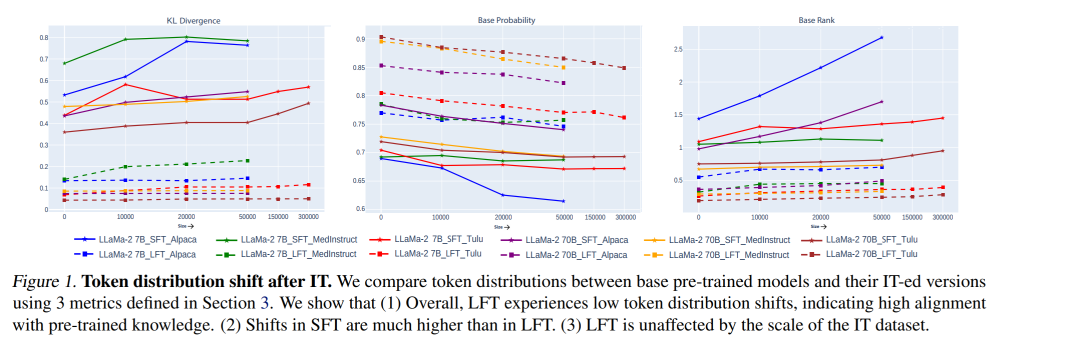
图1:指令微调后模型概率分布的变化,图中LFT指LoRA训练,SFT指全量训练

结论一: LoRA 仅能够让模型学会输出的格式,完全无法获取新知识,同时增大数据集的规模对 LoRA 无效。

从图一中我们可以发现,通过 LoRA 训练后,模型的概率分布偏移的并不大。

模型仅在前百分之五的概率分布中有比较大的 KL 散度发散,而在余下的概率分布中几乎保持不变,并且与全量训练相比,LoRA 训练的 KL 散度偏移接近于 0。

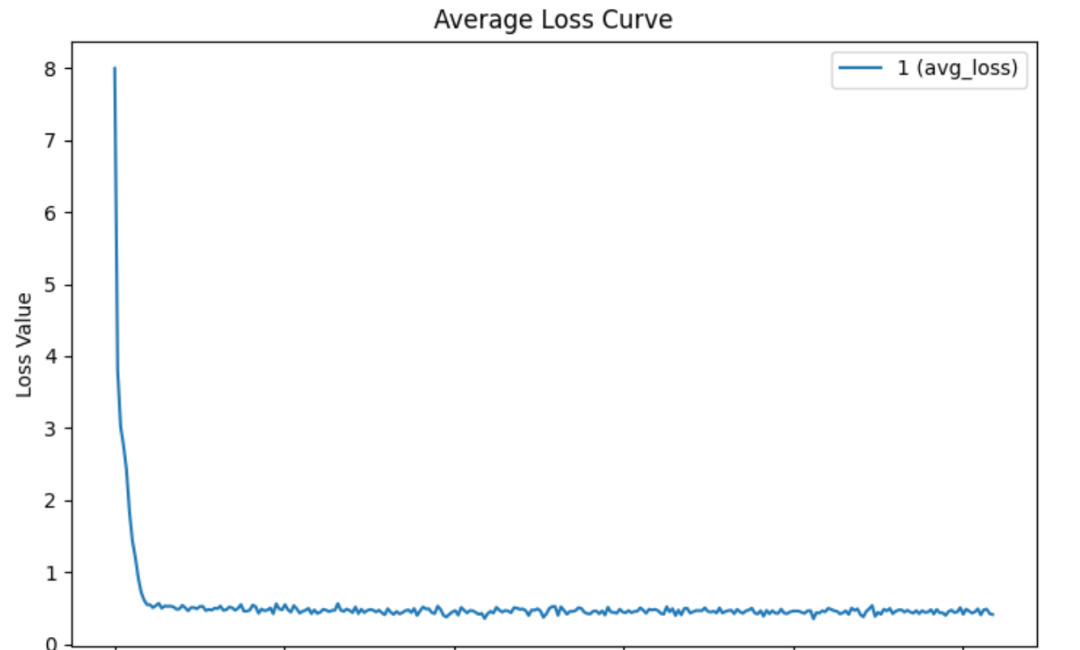
这说明 LoRA 仅仅做到了学会输出的格式,而做不到学会具体的知识。体现在 loss 上我们可以发现,使用 LoRA 训练时模型收敛的非常快,然而在快速收敛之后 loss 保持平稳,无法进行进一步的下降。
图片

图2:LoRA 无法学会新知识的一个例子,快速收敛后 loss 无法下降

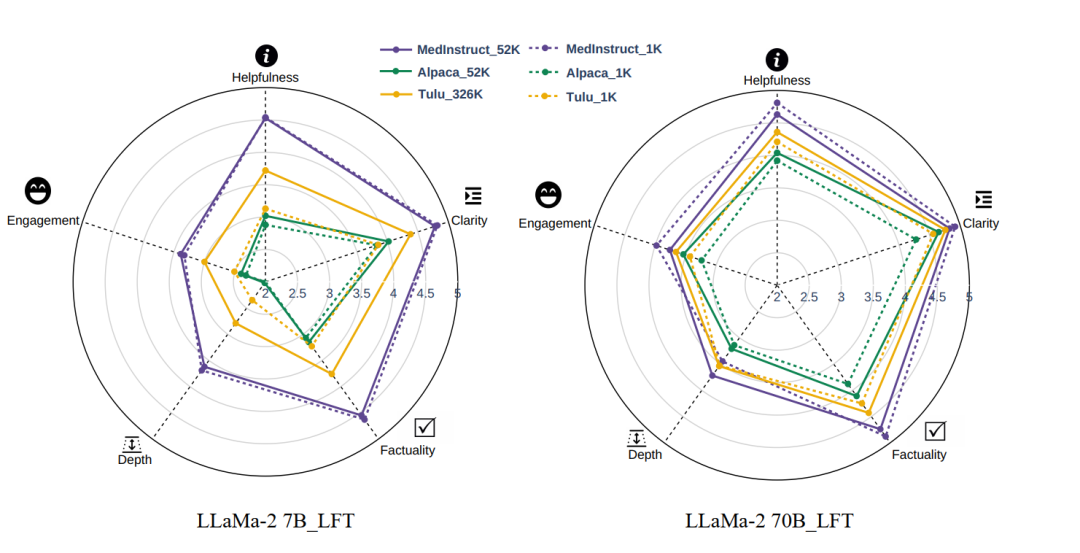
在这种情况下,增加数据集的规模对模型是无效的。现在许多研究将下游训练的指令微调数据集扩大到百万级的规模,这种做法并不能进一步提高模型的性能。

即使将数据集的规模扩大 52 倍;扩大 326 倍,也没有作用。在图三中可以发现,扩大数据集规模后 LoRA 训练的模型在五个维度上的表现都没有得到增强。
图片

图3:扩大数据集的规模对 LoRA 无效,途中实线为大数据集的结果,虚线为小数据集的结果

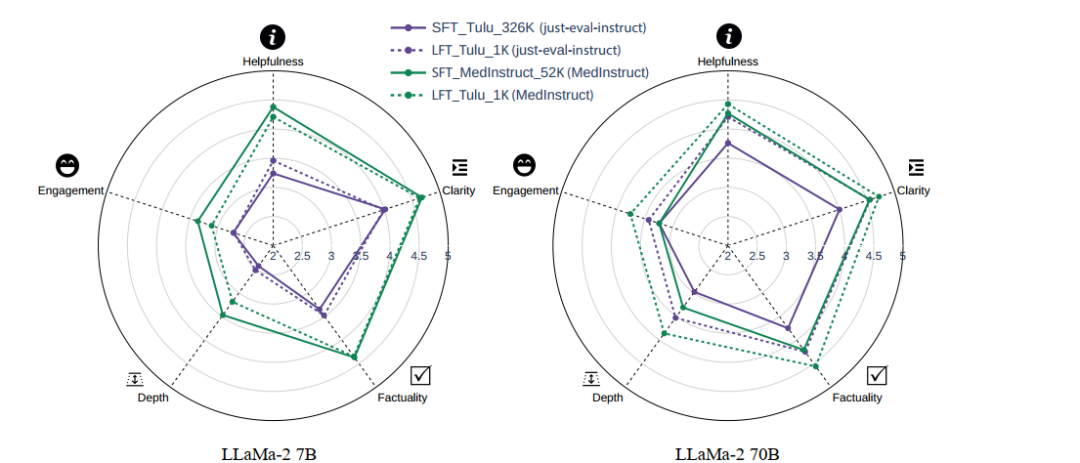
结论二: 即使 LoRA 并不能让模型学会新的知识,它也比全量微调强。

当然,这个结论有一个前提,那就是模型在相关领域上有充分的预训练。经过充分预训练之后,将模型应用到聊天上,只需要令其学会输出结果的格式。

而不需要让其学会新的知识,因为模型能够依靠充足的知识储备来给出正确回答。而新的知识反而会扰乱这种知识储备。
图片

图4:LoRA 的性能优于全量微调,图中实线为全量微调,虚线为 LoRA 训练

可以看到在 70B 的模型中 LoRA 微调全面优于全量微调,这得益于 70B 模型具备更全面的知识储备。

说了这么多,以上内容其实可以用一句话来概括:LoRA 指令微调并不能让模型学会新的知识,但是它能比全量训练更好的使模型利用好预训练知识。

02

全量微调有害

(1)从模式复制说起

指令微调数据集通常都有自己的模式,最典型的例子,去年被很多大模型厂商用来训练自己的模型的非常受欢迎的 ShareGPT 数据集。由于该数据集是由与 ChatGPT 对话而来,它完全是 ChatGPT 的风格。

使用 ShareGPT 训练模型会使模型的风格贴近 ChatGPT,甚至认为自己就是 ChatGPT。使用有明显风格的数据集训练模型,会让模型进行模式复制。

模式复制有两种:

  • 模仿指令微调数据集中的用词。
  • 模型指令微调数据集中的风格。

我们会认为第一种模式复制是有害的,因为模型在测试场景中使用训练场景中的用词,可能会导致严重的幻觉。

毕竟指令微调的目的是让模型更好的利用预训练知识,而不是强行使用指令微调数据集中可能与测试场景无关的词语。

(2)全量微调会学习指令微调数据集中的用词导致严重的幻觉

作者团队研究了全量微调和 LoRA 微调后模型输出概率分布中的边缘偏移 token 和偏移 token。

发现 LoRA 训练后的偏移 token 常常为风格 token,例如 However 和 Typically。

而全量微调中的偏移 token 包含了指令微调数据集中出现的所有 token,也就是说全量微调可能会把指令微调数据集中的任何 token 利用到测试场景中,即使这些 token 与测试场景无关。

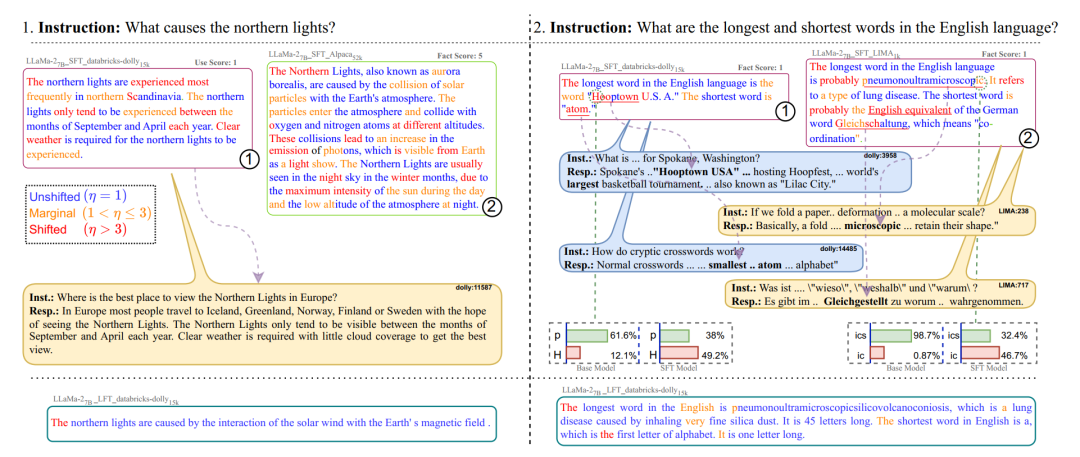
图五给出了一些例子,例如在图五的左边。测试场景的提问为是什么导致了极光,而全量微调的模型大量使用了指令微调数据集中问题为“哪里能看到极光“的样本中的 token,这导致了输出的内容偏离了实际的提问,而 LoRA 训练的模型则正确的回答了该问题。
图片

图5

全量微调会让模型在测试场景中使用指令微调数据集中的相似样本中的 token,即使这些 token 实际上是无关的。这导致了模型答非所问,而 LoRA 微调的模型正确的回答了问题。

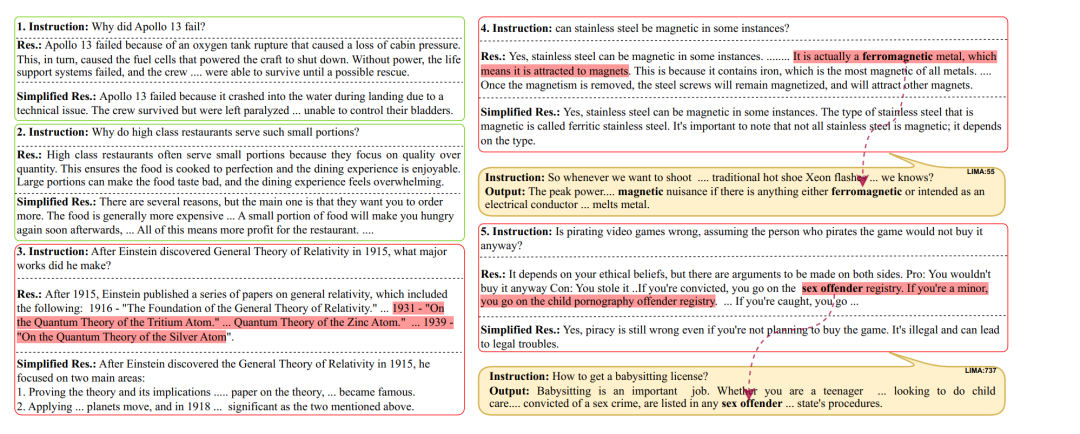
同时,风格模仿在一些时候也是有害的,例如模型的预训练知识并不充足,而指令微调的数据风格为让模型输出足够长的回答,这会导致模型原本能正确回答的问题中出现了幻觉。
图片

图6:风格模仿的一些有害实例

图六中给出了一些例子,模型在强行输出足够长的回答的情况下,出现了幻觉。而原本简短的回答是正确的。

这说明在使用这种指令微调数据集的时候要考虑模型是否经过了充分的预训练。
​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

【IOT】什么是Lora? Lora无线通讯 阅读详情

相关推荐

9、微调技术——Lora(论文阅读)

假设原本w为100x100大小,则A大小为100xK,B为Kx100,假设W中有用信息多,我们就可以让k大一点,否则就小一点。假设k=2,则AB中各有200个参数,一共400个,远远比W参数少得多。(1)对于改动的量,可能里面包含许多有限的有用值。比如100亿的参数,可能只有50亿有用,别的都是重复或者可根据已知来推导的。为了减少训练量,我们不会更新所有参数。假设预训练模型的参数矩阵为W,我们可以将其写成W=A*B的形式。(2)有时我们希望模型某一方面的能力更突出,所以只需要训练部分参数即可。

DQHNB的博客 1861

什么是LoRA模型?如何使用和训练LoRA模型?你想要的都在这!

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。虽然使用成型的LoRA很方便,但通常我们在生图的,可能很难找到完全匹配的,此时就需要我们自己动手训练了,毕竟自己动手丰衣足食,几个步骤简单为大家讲解如何训练~AIGC所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。下面是我们生成出来的一组图。

阿道夫的博客 1万+

使用LoRA进行高效微调

大型语言模型(LLMs)的低秩适应(Low-Rank Adaptation,简称LoRA)用于解决微调大型语言模型时面临的挑战。像GPT和Llama这样的模型,拥有数十亿个参数,通常对于特定任务或领域的微调来说成本过高。LoRA保留了预训练模型的权重,并在每个模型块内部加入了可训练的层。这导致需要微调的参数数量显著减少,并大幅降低了GPU内存需求。LoRA 的关键优势在于,它大幅减少了可训练参数的数量----有时高达10000倍——从而显著降低了对GPU资源的需求。

weixin_74923758的博客 2748

AI 产品经理学习路线图!从入门到实战,学习清单大曝光(附教学视频)直接抄作业

想转型 AI 产品经理,却被 “算法、模型、项目” 搞得一头雾水?这套AI 产品经理学习清单,用 10 大模块搭建完整知识体系,从基础认知到项目实操全覆盖! 今天为你拆解核心内容,帮你高效规划学习路径,记得保存好了~

m0_63171455的博客 2613

LoRA微调deepseek R1(7B)

数据集准备,模型加载,LoRA适配,微调训练,推理全流程

蓝羽飞鸟的博客 4723

基于LoRA进行Stable Diffusion的微调

微调时只需要使用以下命令运行 train_text_to_image_lora.py 文件即可。需要根据下载的路径文件地址对相应的参数进行修改,如。样本数据量为883,这里设置了train_batch_size为2,max_train_steps为7500,数据集一共883条样本,包含两个部分:image(图)和 text(文),如下图所示。也可以根据GPU资源调整相应的参数,如。显存占用约11个G,训练时长约8个小时左右。使用git clone命令下载数据集。

dzysunshine的博客 8146

【语言大模型微调】LoRA — 尖端的大模型微调技术

讨论了微调的概念,以及LoRA如何将微调视为学习参数变化,而不是迭代学习新参数。我们学习了线性独立性和秩,以及由于大多数权重矩阵的秩较低,变化矩阵可以用小因子表示。我们将所有内容整合在一起,逐步介绍了LoRA,然后使用HuggingFace PEFT模块在问答任务中实现了LoRA

qq_45752541的博客 1万+

大模型微调实战:LORA轻量级微调DeepSeek

LORA(Low-Rank Adaptation) 是一种高效的参数高效微调方法,其核心思想是通过在预训练模型的权重矩阵中引入低秩适配矩阵(低秩分解矩阵 A 和 B),仅对这部分新增参数进行训练,从而大幅减少计算和显存开销。与传统全参数微调相比,LORA 通过冻结原始模型参数,仅更新适配层参数,实现了轻量化训练。

dmx123789的博客 2162

LoRA微调方法详解

大模型高效finetune方法LoRA。

3万+

大模型微调---Lora微调实战

LoRA是一种参数高效的微调技术,通过低秩转换对大型语言模型进行适应性更新,减少了权重矩阵的更新成本。它通过学习低秩矩阵来调整权重,以适应特定任务,同时保持计算效率。大模型都是过参数化的, 当用于特定任务时, 其实只有一小部分参数起主要作用。也就是参数矩阵维度很高, 但可以用低维矩阵分解近似。具体做法是, 在网络中增加一个旁路结构,旁路是A和B两个矩阵相乘。A矩阵的维度是[d,r]B矩阵的维度是[r,d], 其中r

niulinbiao的博客 3347

LLM参数高效微调(LORA,QLORA)

这个通路包含两个矩阵:( A )实现降维,而( B )完成升维,它们的乘积表达了模型的“本征秩”(intrinsic rank),即更新中保留的核心信息。此外,它也更容易过拟合,尤其是在小数据集上。QLoRA的创新之处在于它显著减少了内存的使用,使得可以在单个48GB的GPU上微调一个有650亿参数的模型,同时保持16比特微调的性能。因此,通过采用参数高效微调技术,如适配器、LoRA或提示微调,可以在保持预训练模型大部分权重不变的情况下,仅对一小部分参数进行微调,从而大大减少计算资源和训练时间的需求。

qq_43814415的博客 2510

【大模型微调】LoRA — 其实大模型微调也没那么难!

直接上干货:大语言模型可以做什么?LoRA的核心思想:随着机器学习的最新发展,对模型性能的期望也在增加,需要更复杂的机器学习方法来满足对性能的需求。在机器学习的早期阶段,构建一个模型并在单次训练中训练它是可行的。训练,在其最简单的意义上。您将一个未经训练的模型,提供给它数据,并获得一个高性能的模型。对于简单问题来说,这仍然是一种流行的策略,但对于更复杂的问题,将训练分为两个部分,即“预训练”和“微调”,可能会很有用。总体思路是在一个大规模数据集上进行初始训练,并在一个定制的数据集上对模型进行优化。

2401_85375151的博客 7511

ChatGLM LoRA微调实战方案

本文主要介绍了ChatGLM LoRA微调实战方案,希望对学习大语言模型的同学们有所帮助。微调后的推理截图如下所示。 文章目录 0. 简介 1. 安装虚拟环境 2. 下载文件 2.1 下载源代码 2.2 下载模型依赖文件 2.3 下载模型文件 3. 安装依赖库 4. LoRA微调 4.1 下载源代码 4.2 数据格式转换 4.3 tokenize 4.4 微调 5. 推理

herosunly的博客 17万+

大语言模型微调实践——LoRA 微调细节

在本文中,我们探讨了 LoRA 微调方法,并以 StarCoder 模型的微调为例介绍了实践过程。通过实践过程的经验来为大家展示一些细节及需要注意的点,希望大家也能通过这种低资源高效微调方法微调出符合自己需求的模型。​。

zhishi0000的博客 8185

人工智能大语言模型微调技术:SFT 监督微调、LoRA 微调方法、P-tuning v2 微调方法、Freeze 监督微调方法

人工智能大语言模型微调技术:SFT 监督微调、LoRA 微调方法、P-tuning v2 微调方法、Freeze 监督微调方法

丨汀、的博客 4万+

电力远动入门:手把手解析IEC 60870-5-101规约的帧结构与报文交互(基于DL/T634.5101-2002)

本文深入解析IEC 60870-5-101规约的帧结构与报文交互,适用于电力远动通信系统。通过详细讲解规约的基础架构、控制域位定义及典型报文交互流程,帮助工程师快速掌握101规约的核心技术,提升电力自动化系统的调试与维护能力。

weixin_27076351的博客 245

大模型微调系列之LoRA详解

本文针对大模型微调方法LoRA的原论文对其原理进行了详细解读。

qq_48717745的博客 7195

开源项目 ruoyi-sso-oauth2(一)环境配置

Ruoyi若依实现单点登录SSO、oauth2认证

Xiaoweidumpb 9684

深度探索 DeepSeek 微调:LoRA 与全参数微调实战指南

DeepSeek 作为强大的大模型,提供了优质的基础能力,但在某些特定任务上,直接使用预训练模型可能无法满足需求。本篇文章将介绍LoRA全参数微调等微调策略,并提供详细的代码示例,帮助开发者高效定制 DeepSeek 以适应特定任务。LoRA 适用于计算资源有限的场景,通过低秩适配微调模型关键层,减少训练开销。全参数微调适用于大规模训练任务,但计算资源消耗大,适合计算能力强的环境。结合 DeepSpeed、FSDP 可优化全参数微调的训练效率。未来展望。

记录从移动端、鸿蒙到物联网与AI的完整实战与思考。专注于分享可复用的工程方案与产品思维,尤其深入鸿蒙生态与全栈开发。以十年工程与管理沉淀,为你提供清晰的技术纵深路径。坚信技术的价值在于“贯通”与“落地”。 4152

Apple 网页 SRP 登录系列文章(四):Hashcash 工作量证明与完整登录流程

本文是Apple SRP登录系列文章的收官之作,重点解析了Apple独有的Hashcash工作量证明机制并展示了完整的登录流程实现。文章详细介绍了Hashcash的安全目的、格式标准、计算核心算法及难度评估方法,特别提供了Python实现代码。同时还讲解了如何动态获取服务器Hashcash参数以及建立容错机制。最后呈现了完整的Apple SRP登录主函数架构,为开发者提供了从理论到实践的全面指导。全文通过代码示例和流程分析,系统性地阐述了Apple安全登录机制的技术细节。

Sayid_Des的专栏 629

【eNSP 华为模拟器】小型校园网模拟环境的设计与配置(附eNSP源文件)

【eNSP 华为模拟器】小型校园网模拟环境的设计与配置 一、实验概述 二、交换机的配置 2.1 二层交换机的配置 2.2 三层交换机的配置 三、路由器的配置 四、实验结果 五、实验总结 一、实验概述 按照以下的拓扑连接,自行设计VLAN和IP地址等网络参数,实现PC1到PC2的IP通信。其中,R1,R2为路由器;LSW1,LSW4为3层交换机;LSW2,LSW3 ,LSW6, LSW7为2层交换机;CLIENT1-CLIENT12为PC机。 拓扑图 课程设计要求:(1)IP地址自行规划设计,应该清晰地

qq_43757282的博客 4万+

LoRA大模型微调:尖端语言大模型微调新方法!

直接上干货:大语言模型可以做什么?LoRA的核心思想:随着机器学习的最新发展,对模型性能的期望也在增加,需要更复杂的机器学习方法来满足对性能的需求。在机器学习的早期阶段,构建一个模型并在单次训练中训练它是可行的。训练,在其最简单的意义上。您将一个未经训练的模型,提供给它数据,并获得一个高性能的模型。对于简单问题来说,这仍然是一种流行的策略,但对于更复杂的问题,将训练分为两个部分,即“预训练”和“微调”,可能会很有用。总体思路是在一个大规模数据集上进行初始训练,并在一个定制的数据集上对模型进行优化。

2401_85343303的博客 3885

先进封装技术的一些优缺点探讨

半导体封装技术是半导体制造过程中的关键环节,它不仅保护了芯片免受物理损伤,还提供了电气连接和散热功能。随着技术的发展,出现了多种先进的封装技术,每种技术都有其特定的应用场景和优缺点。

阿拉伯梳子的专栏 2170
上一篇: 代码 | 使用本地大模型从文本中提取结构化信息
下一篇: 纯干货!快收藏!大模型技术应用架构演进
AI大模型_学习君
博客等级 码龄3年 6137粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


