带指令的embedding是否更配RAG?

Text embedding 模型总结 目前,随着的火热,除了层出不穷的大模型外,因为检索的能力会很大程度影响最终的问答效果,文本的嵌入模型也是大家比较关注的。本文主要介绍效果较好的几种文本嵌入模型。 阅读详情

在这里插入图片描述

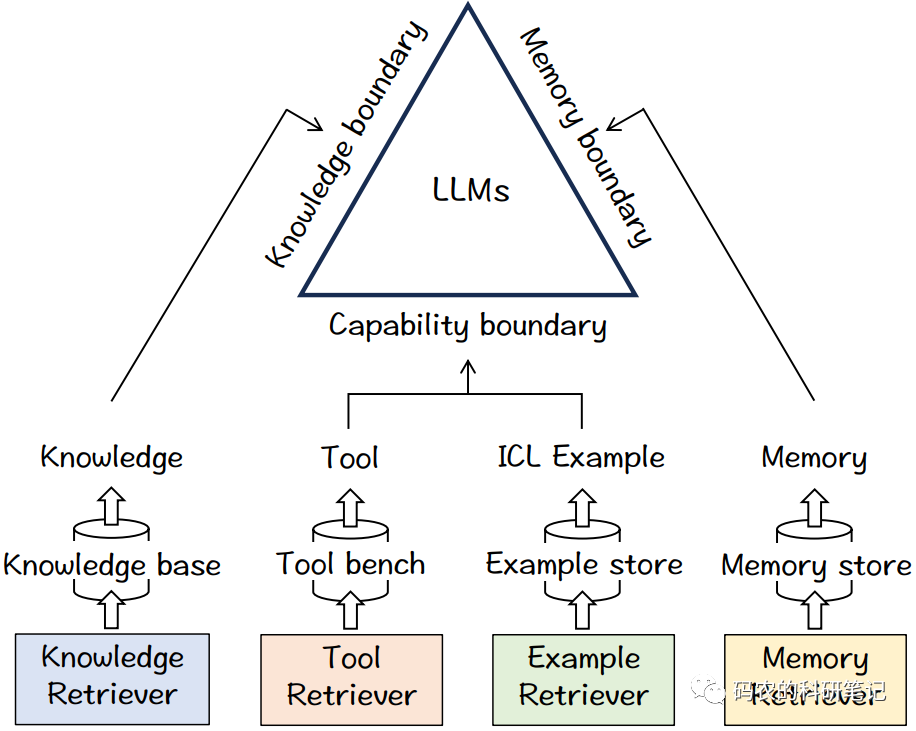
带指令的嵌入模型通过结合大规模预训练和指令微调,能够根据简单的文本指令适应多种任务和领域,如文本分类、相似度计算、信息检索等。这种模型的优势在于无需针对每个特定任务进行微调,显著提高了使用效率和灵活性。用户只需根据需要构造指令,就能快速获得适应特定任务的文本嵌入,适用于多种不同的应用场景,特别适合于资源有限或对机器学习了解不深的用户。本文就主要介绍当先两类支持指令的嵌入模型:Instructor、BGE 和 LLM Embedder。

1 Instructor Embedding

Instructor是由香港大学自然语言处理实验室团队推出的。Instructor模型通过简单的指令,能够生成适用于任何任务(如分类、检索、聚类、文本评估等)和领域(如科学、金融等)的文本嵌入,而无需进行任何微调。它在70个不同的嵌入任务上取得了最好的性能。其主要特点就是:

  • 无需微调: 仅通过提供任务指令,即可生成针对任何任务和领域的文本嵌入。
  • 多种使用场景: 适用于自定义文本的嵌入计算、文本间相似度计算、信息检索和聚类等多种用途。
  • 易于安装和使用: 提供了详细的安装和使用指南,包括一个可以直接在Colab上尝试的笔记本。
  • 多种模型大小: 提供了多个不同大小的Instructor模型版本。

https://github.com/xlang-ai/instructor-embedding

1.1 计算自定义文本的嵌入

假设你需要为特定领域的文本计算嵌入,可以按照以下步骤操作:

from InstructorEmbedding import INSTRUCTOR

# 加载模型
model = INSTRUCTOR('hkunlp/instructor-large')#

 准备带有指令的文本
 text_instruction_pairs = [
     {"instruction": "Represent the Science title:", "text": "3D ActionSLAM: wearable person tracking in multi-floor environments"},    
     {"instruction": "Represent the Medicine sentence for retrieving a duplicate sentence:", "text": "Recent studies have suggested that statins, an established drug group in the prevention of cardiovascular mortality, could delay or prevent breast cancer recurrence but the effect on disease-specific mortality remains unclear."}
]
     
# 计算嵌入
customized_embeddings = model.encode([[pair["instruction"], pair["text"]] for pair in text_instruction_pairs])

# 输出嵌入结果
for pair, embedding in zip(text_instruction_pairs, customized_embeddings):    
    print("Instruction: ", 
    pair["instruction"])    
    print("Text: ", 
    pair["text"])    
    print("Embedding: ", embedding)    
    print("")

1.2 计算文本间相似度

使用INSTRUCTOR模型计算两组文本间的相似度:

from sklearn.metrics.pairwise import cosine_similarity

# 定义两组文本
sentences_a = [['Represent the Science sentence: ','Parton energy loss in QCD matter'],
               ['Represent the Financial statement: ','The Federal Reserve on Wednesday raised its benchmark interest rate.']]
sentences_b = [['Represent the Science sentence: ','The Chiral Phase Transition in Dissipative Dynamics'],
               ['Represent the Financial statement: ','The funds rose less than 0.5 per cent on Friday']]

# 计算嵌入
embeddings_a = model.encode(sentences_a)
embeddings_b = model.encode(sentences_b)

# 计算相似度
similarities = cosine_similarity(embeddings_a, embeddings_b)

# 输出相似度结果
print(similarities)

1.3 信息检索

使用INSTRUCTOR模型进行信息检索的一个例子:

import numpy as np
from sklearn.metrics.pairwise import cosine_similarity

# 定义查询和文档
query = [['Represent the Wikipedia question for retrieving supporting documents: ','where is the food stored in a yam plant']]
corpus = [['Represent the Wikipedia document for retrieval: ','Capitalism has been dominant in the Western world since the end of feudalism...'],
          ['Represent the Wikipedia document for retrieval: ',"The disparate impact theory is especially controversial..."],          
          ['Represent the Wikipedia document for retrieval: ','Disparate impact in United States labor law refers to practices...']]

# 计算嵌入
query_embeddings = model.encode(query)
corpus_embeddings = model.encode(corpus)

# 计算相似度并找到最相关文档
similarities = cosine_similarity(query_embeddings, corpus_embeddings)
retrieved_doc_id = np.argmax(similarities)

# 输出最相关文档的
IDprint(retrieved_doc_id)

2 BGE

BGE(BAAI General Embedding),是由智源研究院(BAAI)团队开发的一款文本Embedding模型。BGE嵌入是一种通用的嵌入模型。一种基于深度学习的自然语言处理工具,专门用于处理和理解文本数据。这个模型可以用于多种语言,包括中文,并且在多个任务上表现出色,如文本检索、语义相似度计算等。

https://github.com/FlagOpen/FlagEmbedding/tree/master/FlagEmbedding/baai_general_embedding

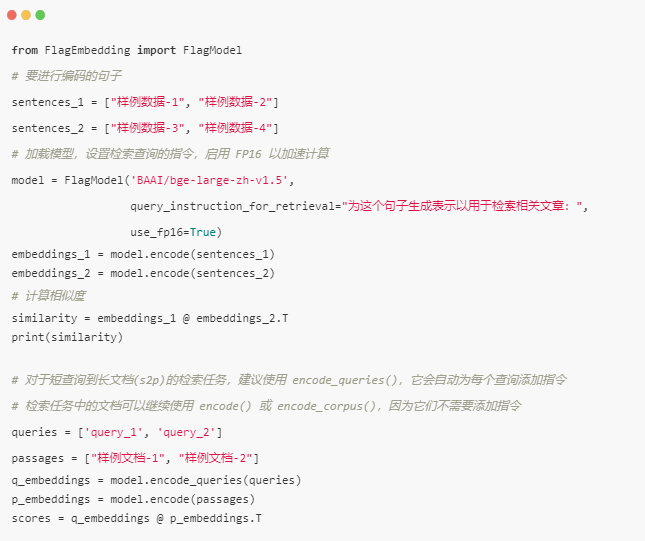
2.1 使用 FlagEmbedding
在这里插入图片描述

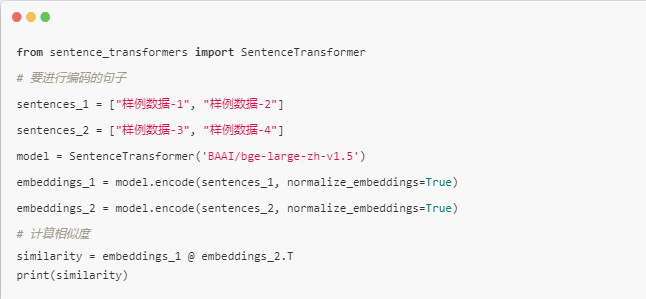
2.2 使用 Sentence-Transformers

你也可以将 bge 模型与 sentence-transformers 一起使用:
在这里插入图片描述

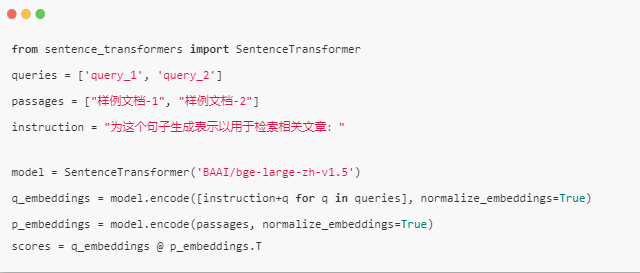
对于短查询到长文档(s2p)检索任务,每个短查询应以指令开头(指令见 模型列表)。 但是,文档不需要添加指令。
在这里插入图片描述

3 LLM Embedder

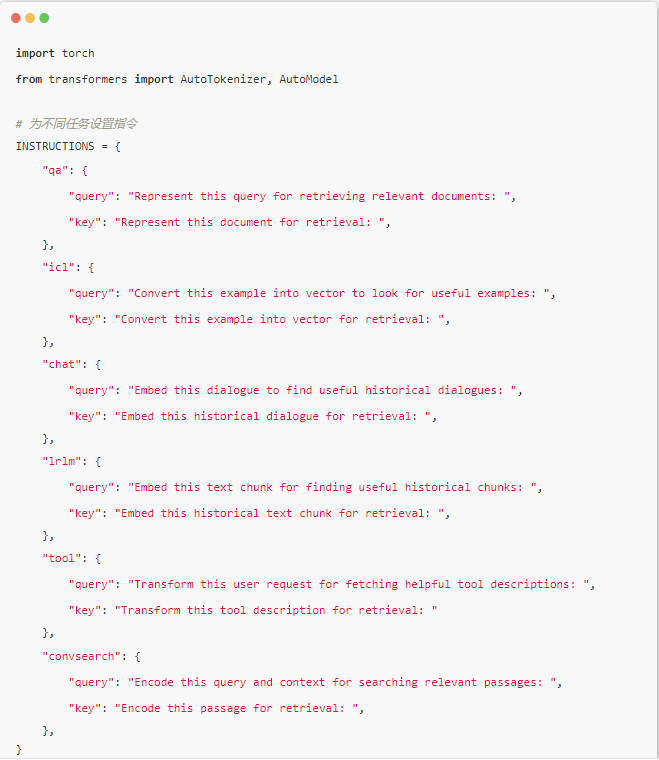
LLM Embedder也是智源研究院(BAAI)团队开发的一款针对LLM场景的嵌入模型。根据 LLM 的反馈进行了微调。它可以支持大型语言模型的检索增强需求,包括知识检索、记忆检索、示例检索和工具检索。它针对 6 个任务进行了微调:问答、会话搜索、长会话、长范围语言建模、上下文学习和工具学习。

https://github.com/FlagOpen/FlagEmbedding/blob/master/FlagEmbedding/llm_embedder/README.md

3.1 使用 FlagEmbedding
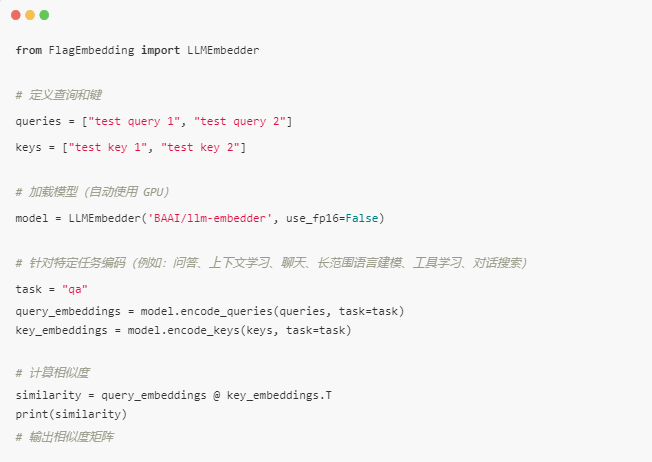
在这里插入图片描述

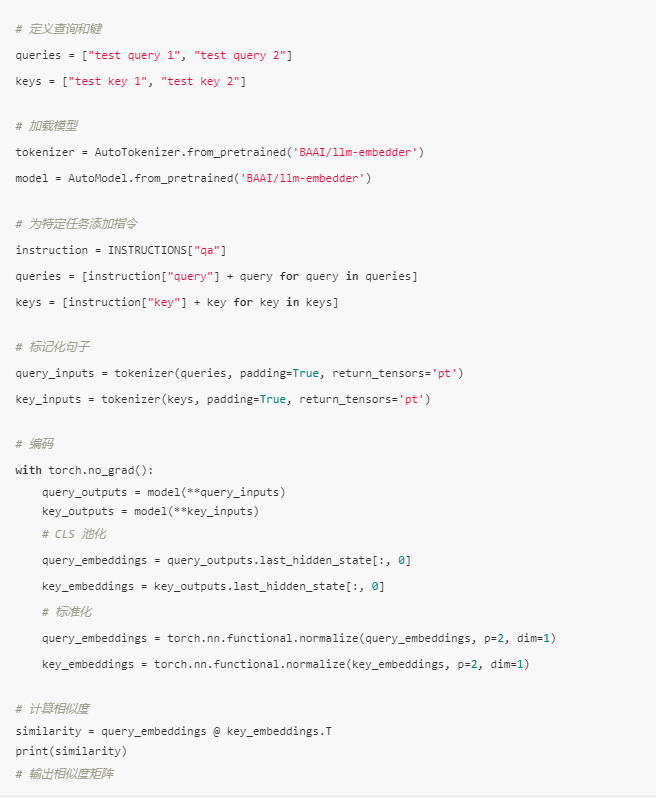
3.2 使用 transformers

在这里插入图片描述
在这里插入图片描述

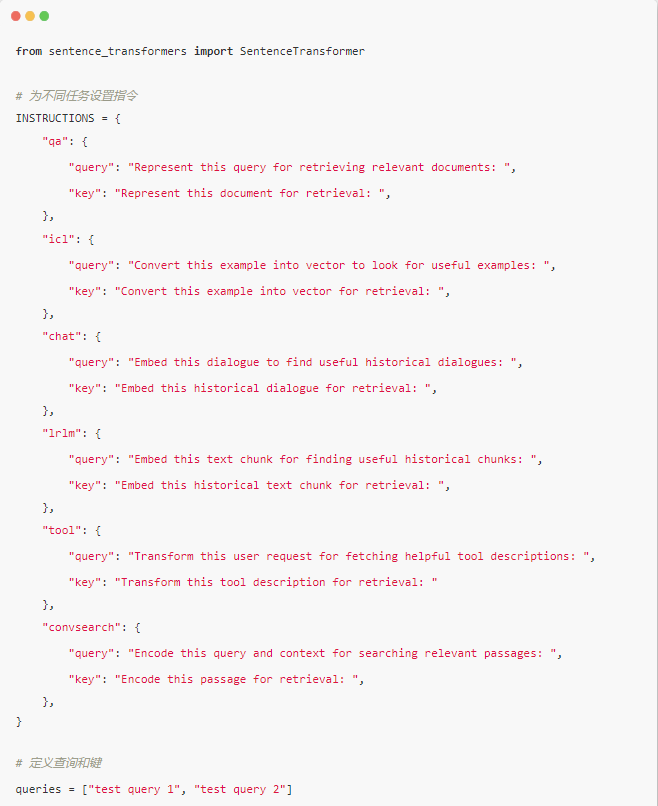
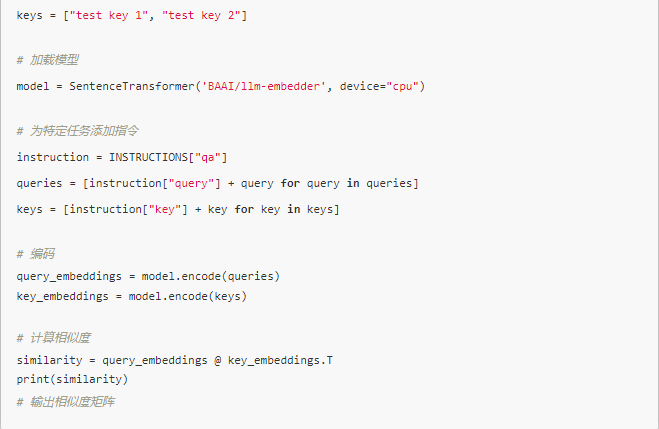
3.3 使用 sentence-transformers

在这里插入图片描述
在这里插入图片描述

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
vllm本地部署bge-m3模型API服务实战教程 本文详细介绍了在Ubuntu 24.04系统上,使用CUDA 12.8和Python 3.12环境,本地部署bge-m3模型API服务的实战教程。首先,通过Miniconda创建并激活虚拟环境,随后安装vllm、对应版本的PyTorch以及flash_attn(安装过程可能耗时较长)。接着,从魔搭社区下载bge-m3模型,并通过命令行启动API服务。最后,提供了调用API服务的示例代码,并展示了运行结果。整个过程涵盖了环境配置、模型下载、服务启动及验证等关键步骤,适合需要在本地部署bge-m3模型的开发者参 阅读详情

相关推荐

Rag中选择合适的embedding

Embedding在rag召回文本中,占有重要的作用,准确的召回能够避免llm的幻觉。一般项目中使用bge-m3或openai向量模型作为rag的选型。其实,还有其他一些embedding模型可供选择,下面我们来探究一下,并讨论下,如何选择一个适合自己场景的embedding模型。Embedding数据是在文档上传时生成,对embedding性能要求并不高,它不影响到问答时间的快慢。

sinat_28694519的博客 3390

FlagEmbedding

是一个功能强大且易于使用的嵌入生成工具,适合自然语言处理任务中的多种应用。通过本文的教程,你已经学会了如何使用生成文本嵌入、计算文本相似性、批量处理文本,并在文本分类等任务中使用它。根据任务的需求,选择合适的预训练模型和下游应用可以极大提高 NLP 任务的效果。

jixiaoyu0209的博客 3560

手工微调embedding模型,让RAG应用检索能力更强

在本文中,我们探讨了微调RAG管道的Embedding模型所涉及的步骤。我们使用开源的模型作为我们的基本Embedding模型,介绍了如何生成用于训练和评估的数据集,如何对其进行微调,以及如何评估基本模型和微调模型之间的性能差异。评估结果表明,微调Embedding模型的性能比基本模型提高了1-6%,与OpenAI的Embedding模型相比,微调模型的性能损失仅为4.85%。这种性能提升可能因数据集的质量和数量而异。

python122_的博客 4917

FlagEmbedding目前最好的sentence编码工具

请注意,预训练的目标是重构文本,预训练后的模型无法直接用于相似度计算,需要进行微调之后才可以用于相似度计算。08/02/2023: 🎉 🎉 发布中英文向量模型BGE(BAAI General Embedding的缩写), 在MTEB和C-MTEB榜单上取得最好的性能。更新向量模型:发布bge-*-v1.5向量模型,缓解相似度分布问题,提升无指令情况下的检索能力(但检索任务仍建议使用指令)10/12/2023: 发布 LLM-Embedder, 专为大语言模型各种检索增强任务设计的英文向量模型。

WitsMakeMen的专栏 2205

​​​​​​​Embedding 的本质:为什么你的知识库 RAG 不准?

RAG(检索增强生成)效果不佳的核心原因往往在于Embedding(向量编码)未能正确理解业务内容。Embedding的本质是将语义投影到特定结构的向量空间,而非真正理解文本。当模型训练数据分布与业务领域不匹配时,就会出现语义距离错乱,导致召回错误。优化RAG效果的关键在于:1)合理切分Chunk以保持语义完整;2)选择适配业务的Embedding模型;3)采用重排序等增强技术;4)构建父子向量结构处理长文档;5)进行术语扩展;6)使用混合检索方法。真正的挑战不是堆积文档,而是构建与业务对齐的语义空间。

aifs2025的博客 1852

Qwen3-Embedding vs OpenAI text-embedding:实测对比哪个更适合你的RAG应用?

本文深度对比了阿里Qwen3-Embedding与OpenAI文本嵌入模型在RAG应用中的表现,重点分析了中文处理能力、长文本理解及成本效益。测试显示Qwen3-Embedding-8B在中文技术文档处理上准确率达86.7%,优于OpenAI的79.2%,且支持32k tokens长文本处理,适合需要高精度中文语义理解的应用场景。

pp12345的博客 644

【LLM-RAG】知识库问答 | 检索 | embedding

RAG流程(写作论文中的background:公式设定、emb、召回内容、召回基准)(工作中的思路《A Survey on Retrieval-Augmented Text Generation》该工作旨在对检索增强文本生成进行研究。主要核心的点如下:1、Retrieval Source知识来源源 训练语料:有标注的训练数据直接作为外部知识;外部数据:支持提供训练数据之外的外部知识作为检索来源,比如于任务相关的领域数据,实现模型的快速适应; 无监督数据:前两种知识源都需要一定的人工标注来完善“检索依据-

发现问题,并解决问题,批判性思维 6193

智源发布最强开源可商用中英文语义向量模型 BGE,超越同类模型,解决大模型制约问题

智源发布最强开源可商用中英文语义向量模型 BGE,超越同类模型,解决大模型制约问题

丨汀、的博客 3248

【AI大模型】RAG 与 Embedding

从而在几乎不影响最终效果的情况下降低向量检索与相似度计算的复杂度。text-embedding-ada-002 只支持1536维计算。

lmj3732018的博客 1万+

RAG系统中Embedding模型选型实战

本文详细介绍了RAG系统中Embedding模型选型实战,希望能对学习RAG的同学们有所帮助。 文章目录 1. 前言 2. 思路解析 3. 测评数据集构建 3.1 步骤一 3.2 步骤二 3.3 数据示例 3.4 总结 4. 实战代码 4.1 本地模型 4.2 使用第三方的Embedding模型API

herosunly的博客 17万+

嵌入式开发中Tab与空格混用的危害与统一规范实践

在软件工程中,代码格式一致性是保障可读性与团队协作效率的基础。从原理上看,制表符(Tab)与空格(Space)在存储与显示机制上存在本质差异:Tab是控制字符,其显示宽度取决于编辑器设置;空格则是固定宽度的字符。这种差异导致混用时会引发代码对齐错乱、版本控制冲突及跨平台兼容性问题,严重影响工程的可维护性。尤其在嵌入式开发领域,资源受限环境与高可靠性要求使得统一的编码规范更为关键。通过配置编辑器、集成clang-format等自动化工具,可以强制实现缩进风格的一致性,从而提升代码质量与团队协作效率。本文聚焦于

weixin_42545636的博客 276

RAG构建中Embedding的理解

embedding:可以理解为向量化,也就是引言提到的,将物理世界实体 转成 数学空间的向量,以便可以进行计算。本质上是一系列float数据组成的向量,可正可负。例如一个词语:[0.3874,0.1235,0.8155,0.8824,0.2718,...]我们也需要思考一个问题,是否特征向量的维度越大越好?维度多大比较好呢?特征向量的维度表示的是对应实例的描述角度和维度,所以理应越多越好,但是对应的算力消耗也会增加。列举常见的embedding模型,对应的向量维度作为参考。Embedding模型。

m0_75137505的博客 1058

水下探测小白必看:单波束vs多波束声呐,5分钟搞懂核心区别

本文为水下探测新手清晰解析了单波束与多波束声呐的核心区别。单波束声呐如同精准的“手电筒”,进行逐点扫描,适用于定点测深和目标探测;而多波束声呐则像“聚光灯”,能一次性覆盖一个扇区,高效获取海底地形三维信息,是海底测绘和水下三维建模的理想选择。文章通过生动的比喻和对比表格,帮助读者快速理解两者原理、效率差异及适用场景。

linux6sysadmin的博客 1048

RAG中的Embedding技术

Embedding技术是RAG系统的核心,通过将非结构化数据转化为高维向量,实现语义检索。其本质是将语义相似性映射为向量空间距离,使机器能理解文本深层含义。主流模型包括商用API(如OpenAI)和开源本地模型(如BERT),选择时需考虑语义捕捉能力、维度、速度等特性。Embedding使RAG能实现高效存储、快速匹配和精准召回,是连接自然语言与机器计算的关键桥梁。

Vita_min_C的博客 1412

YOLOv8中Bottleneck模块详解

Bottleneck 模块在YOLOv8中的作用是进行特征提取和增强,是网络中的核心构建模块之一。它的主要功能是通过卷积操作来处理输入特征图,并在适当情况下应用残差连接,使得信息能够有效地通过网络层进行传播

zzzyyy8的博客 8061

【信号与系统】Multisim 仿真信号合成与分解

软件 Multisim 进行方波信号的产生、分解和合成,观察信号波形的分解与合成,加深对信号频谱的理解。

AXYZdong的博客 2万+

Embedding在RAG中的构建与应用

本文主要详细介绍Embedding在RAG中的原理、优缺点、构建方式和应用场景

weixin_56175042的博客 1913

vectorCast——Probe point 功能实现故障注入,局部变量打印,断点调试。

选择一个测试用例,选择coverage窗口进行查看。点击edit probe point,如图所示绿色的小圆圈。 选代码中选择需要打断点的地方进行点击。黑色的小圆点都可以选。 点击黑色小圆点,小圆点变绿,表示打断点成功。 此时就可以根据自己的需求在打断点的位置编写一些C语言的命令语句。 点击编译,成功会弹出窗口显示编译成功,失败会在下方报错error,并显示错误的原因。 点击应用保存,选择yes to all就可以了。 点击用例执行就可以看到打断点情况下的执行结果了。

weixin_59334478的博客 2072

RAG-embedding篇

Embedding(嵌入向量)是将文字、图片、语音等“人类语言”转换为“计算机语言”的关键一步。它的作用,是把一句话或者一个词,变成一串可以进行数学运算的数字向量,让模型能“理解”我们在说什么。计算机不懂“情绪”“背景”“常识”,它只能处理数字。所以如果我们问它:“北京和上海哪个更大?”它必须先把这句话变成数字(向量),再去和知识库里的内容做匹配——这就靠 embedding。如果没有 embedding,AI 就像一个英语六级都没过的“文盲”,你说什么,它都回你:“对不起,我不明白。

和大家一起涨芝士 972

k8s篇之underlay网络和overlay区别

underlay和overlay

小橙子的笔记屋 2142

Unreal5从入门到精通 专栏目录

欢迎来到“UE5从入门到精通”专栏!在这里,我们将带您踏上一段精彩的旅程,深入探索虚幻引擎5(Unreal Engine 5)的无限可能。不论您是游戏开发的新手,还是希望提升技能的开发者,这里都有适合您的内容。基础知识:了解虚幻引擎5的界面、功能和基本操作,为您的学习打下坚实的基础。项目实战:通过实际项目案例,帮助您从理论走向实践,真实体验游戏开发的每个环节。高级技巧:分享各种高级功能和技巧,包括蓝图、C++编程、材质编辑、光照和渲染等,让您能够创作出更具专业水准的作品。

TxNet 2987

RAG 、Embedding与向量数据库

向量是一种有大小和方向的数学对象。它可以表示为从一个点到另一个点的有向线段。例如,二维空间中的向量可以表示为 (x,y),表示从原点 (0,0) 到点 (x,y) 的有向线段。以此类推,我可以用一组坐标 (x0,x1,…,xN−1) 表示一个 N 维空间中的向量,N 叫向量的维度。文本向量是N维表示,一般的嵌入式模型,维度一般是1000+,对于openai来说:维度为 1536,是 OpenAI 较为常用的文本嵌入模型,能在多种自然语言处理任务中表现出色,可捕捉文本中较为细致的语义信息。

weixin_36998410的博客 2361

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

如何选择RAG的Embedding模型?

中文模型:bge-large-zh-v1.5, multilingual-e5-large, bce-embedding-base_v1,m3e-base,acge_text_embedding。最近在学习RAG技术,遇到了一个关于如何选择合适的Embedding模型的问题。如果你去搜索Embedding模型,你会发现现在有很多的Embedding模型,那么该如何来选择这种模型呢?大系列有:bge, jina, gte, bce, e5, m3e。既包含开源,也包含API,鱼目混杂,需要进一步验证和确认。

不积跬步,无以至千里;不积小流,无以成江海。 1226

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

RAG 实战指南(四):RAG-embedding篇

前面我们介绍了RAG系统中的文档解析,RAG 的文档解析:PDF 篇,在解析文档得到数据后,由于数据规模很可能非常庞大,整体存储具有难度,并且在查询的时候可能仅仅和其中的一个或几个段落有关系,所以需要分块技术将解析后的文档内容切分为适当的片段一分钟读懂RAG的切分策略。

Y525698136的博客 1337

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

【一文读懂】RAG的重要组成-Embedding Model

在学习嵌入模型之前,首先要搞明白什么是Embedding?Embedding 是将离散的非结构化数据转换为连续的向量表示的技术。在自然语言处理中,Embedding 常常用于将文本数据中的单词、句子或文档映射为固定长度的实数向量,使得文本数据能够在计算机中被更好地处理和理解。通过 Embedding,每个单词或句子都可以用一个实数向量来表示,这个向量中包含了该单词或句子的语义信息。以文本处理为例,假设你有一句话:“猫喜欢鱼。”在计算机中,单词是以文字的形式存在的,但计算机并不能直接理解这些文字。

2401_85375186的博客 1791
上一篇: Embedding的概念和展开
下一篇: 吴恩达LangChain教程:Embedding与文档解析
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值