教大模型自己跳过“无用”层,推理速度×3性能不变,谷歌MIT这个新方法火了

Transformer推理硬件专用加速器 当前大模型的基础架构正在向 Transformer 结构收敛,Transformer架构自谷歌2017年提出后比较稳定,因此针对Transformer的计算设计专用的ASIC加速器很有必要。 阅读详情

大语言模型用着爽,但推理速度实在太慢了?

而且,增加模型体积,推理效果也并不一定就比之前更好。

为了解决这一问题,谷歌MIT的研究人员提出了一个新框架CALM,让它自己来决定计算量。

如果CALM意识到某些层“可有可无”,那么它在计算时就会跳过这些层。

论文被po到网上后,立刻火了一波:

在这里插入图片描述

有网友表示,我们就是需要这样更智能和自适应的模型,显然CALM的解码器已经做到了:

在这里插入图片描述

直接用中间层输出结果

CALM全称Confident Adaptive Language Modeling,即置信自适应大语言模型。

这一模型基于Transformer架构,为了加速它的计算,研究人员提出了一个名叫“提前退出”*(early exiting)*的方法,让模型根据不同的输入,动态决定要用多少层网络来计算。

也就是说,在计算的过程中,模型不需要经过每一层计算再输出结果,而是能直接用中间层的特征输出token,从而降低模型计算量。

在这里插入图片描述

所以,模型如何决定“退出”的时机呢?

这就需要训练模型学会自己判断了。

其中,Yfull是标准模型输出的结果,Yearly是模型“提前退出”时输出的结果。为了让Yearly的效果更好,就需要尽可能让它与Yfull保持一致。

在这里插入图片描述

当然,不同的任务对于文本输出一致性也有不同的要求,例如对生成结果要求没那么严格(可以生成更多样的语句)的任务,对于Yfull和Yearly的一致性要求就没那么高。

因此作者们也在论文中给出了两个不同的公式,可根据实际情况选用:

在这里插入图片描述

在实际操作上,论文通过设置一个局部的token置信度,来检查其对整个生成序列的影响。

模型在解码过程中,会计算每一层的置信度c,并将它与达到“提前退出”的阈值λ相比,如果c大于λ,则模型“提前退出”。

在这里插入图片描述

所以,这样的模型实际测试效果究竟如何?

归纳翻译QA任务表现都不错

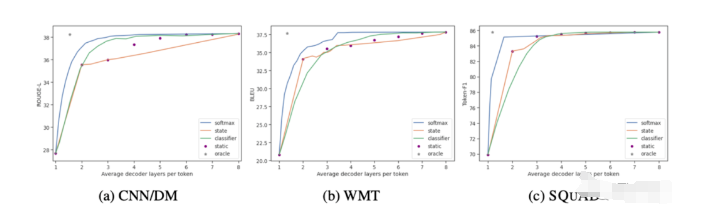
论文在CNN/DM、WMT和SQuAD三个数据集上进行了测试。
在这里插入图片描述

其中,CNN/DM是一个新闻文章数据集,需要输出一个几句话概括文章的结果;WMT15 EN-FR是一个机器翻译数据集,主要是法译英句子的结果;Open-book SQUAD 1.1则是一个根据维基百科提问的QA数据集。

在这里插入图片描述

据一作Tal Schuster介绍,在保持相同性能的情况下,CALM使用的解码器层数平均比之前降低了3倍。

在这里插入图片描述

对于这篇论文,有网友表示赞同:模型确实不需要总是“长时间深入思考”,有时候几层就能推理出正确答案了。

在这里插入图片描述

据作者表示,这一加速解码的思路,适用于任何Seq2seq模型。

在这里插入图片描述

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

MIT 6.S191深度学习实战路径:从课堂到产线的闭环能力构建 深度学习不是数学公式堆砌,而是解决真实数据缺陷、模型行为诊断与业务可解释性的系统工程。其核心原理在于建立‘数据—模型—评估—部署—监控’的完整反馈闭环,技术价值体现在降低工业场景中的调试成本、提升模型可信度与上线效率。典型应用场景包括图像分类中的注意力偏差定位、NLP鲁棒性测试、金融风控可审计决策生成,以及边缘设备上的传感器级模型漂移检测。本文基于MIT 6.S191官方课程与Towards AI生态整合实践,聚焦Grad-CAM热力图分析和Shapash可解释性框架两大关键能力,揭示如何将学术内容转化为可 阅读详情

相关推荐

Gemma 4开源大模型:端侧可用、参数高效、全模态原生

大模型轻量化与端侧部署正成为AI工程落地的核心命题。其本质是通过参数高效设计(如MoE稀疏激活、PLE逐层嵌入)和系统级优化(共享KV缓存、交替注意力),在有限算力下维持专业级推理质量。技术价值在于打破‘参数量=能力’的旧范式,实现消费级硬件承载工业级任务——例如26B MoE在RTX 4090上超越Llama 3 70B,E4B在树莓派5实现实时工业图像结构化分析。典型场景覆盖边缘智能终端、SaaS Agent服务、教育硬件及离线质检设备。Gemma 4正是这一演进的关键实践样本,将端侧可用、全模态原生从

weixin_33739523的博客 1021

教大模型自己跳过“无用”层,推理速度×3性能不变,谷歌MIT这个新方法火了...

萧箫 发自 凹非寺量子位 | 公众号 QbitAI大语言模型用着爽,但推理速度实在太慢了?而且,增加模型体积,推理效果也并不一定就比之前更好。为了解决这一问题,谷歌MIT的研究人员提出了一个新框架CALM,让它自己来决定计算量。如果CALM意识到某些层“可有可无”,那么它在计算时就会跳过这些层。论文被po到网上后,立刻火了一波:有网友表示,我们就是需要这样更智能和自适应的...

量子位 263

开源大模型选型避坑指南:破除榜单迷信,回归场景验证

开源大模型并非单一维度可排序的技术产品,其本质是面向特定任务、硬件与数据分布的工程化组件。理解模型架构原理(如RoPE、GQA、SwiGLU)是判断适配性的前提;技术价值体现在中文长文本解析、量化推理效率、LoRA微调兼容性等可测量指标;典型应用场景包括政企知识库、多语言客服、边缘端代码辅助等;而真实落地成败取决于本地GPU上的首token延迟、领域测试集准确率与许可证合规性。本文聚焦Qwen2系列与Llama-3、Phi-3等主流开源模型的实操对比,揭示‘衍生模型’定义模糊、榜单统计口径失真等常见认知偏差

weixin_30402343的博客 437

【大模型入门必看】大模型推理能力如何实现的

推理大模型之所以拥有推理能力,根本原因在于大模型在训练过程中,通过高质量大规模逻辑数据(例如程序源代码、数学题等等)进行强化学习即可自主演化出复杂的推理能力,并出现了推理能力的“涌现”现象。训练完成后,在使用推理大模型时再辅以Prompt优化(包括推理Token和提示词优化),进一步提升推理效果。推理大模型不再像非推理大模型那样快速生成答案,而是像人类一样通过“长思维链”(Long CoT)分解问题、自我纠错、探索多路径解决方案,尤其在数学、编程等高难度任务中表现优异。

weixin_59191169的博客 2225

Gemma 4:首款真正属于用户的本地AI大模型

本地大模型是指无需联网、不依赖云端API即可在终端设备(如手机、笔记本)上完整运行的AI系统,其核心原理在于模型轻量化、硬件协同优化与离线推理引擎的深度集成。技术价值体现在数据主权保障、实时响应确定性及边际成本趋零,广泛应用于隐私敏感场景(医疗咨询、法律文书)、弱网环境(通勤、野外)和中小企业降本增效。Gemma 4凭借动态稀疏注意力、量化感知训练与Apache 2.0彻底开源等关键突破,成为首个兼顾高性能、低功耗与真落地的本地AI代表,标志着AI从‘租用服务’迈向‘拥有智能体’的时代拐点。

weixin_33747129的博客 419

全同态加密与大语言模型融合:隐私计算下的加密推理技术路径与实践

全同态加密(FHE)是一种允许在密文上直接进行计算的加密技术,其核心原理是基于数学难题构建的加密方案,使得数据在加密状态下仍能执行加法和乘法运算。这项技术的核心价值在于实现了数据的“可用不可见”,为隐私计算提供了理想的安全基础。在人工智能和大语言模型(LLM)广泛应用的背景下,如何在保护数据隐私的同时利用模型能力成为关键挑战。通过将全同态加密与大语言模型推理相结合,可以在金融风控、医疗诊断等对数据隐私有极端要求的场景中,实现敏感数据的加密处理与分析。本文探讨了实现加密大语言模型的几种主流技术路径,包括端到端

weixin_34405557的博客 688

最全的SD界面大揭秘,让你一次知道所有功能

AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,AIGC技术将继续得到提高,同时也将与人工智能技术紧密结合,在更多的领域得到广泛应用。感兴趣的小伙伴,赠送全套AIGC学习资料和安装工具,包含AI绘画、AI人工智能等前沿科技教程,模型插件,具体看下方。

qq_41314882的博客 3731

Gemini 3 Deep Think:科研工作流的底层重写与Agentic Vision实践

大模型正从‘问答式AI’迈向‘问题解决型智能体’,其核心在于将科研中隐性的思维过程——如前提质疑、多源验证、不确定性管理——转化为可执行的推理协议。这背后涉及深度思考(Deep Think)能力、跨模态理解(Agentic Vision)与动态工作流编排三大技术支柱。尤其在材料科学、集成电路、临床研究等强专业场景中,模型需融合文献知识图谱、实验数据语义解析、设备级API调用等能力,实现从图像/图纸/代码到可运行工程包的端到端生成。本文基于KULAAI平台实测,详解如何通过思考深度调控、角色化提示、跨文档语义

weixin_34055787的博客 848

#今日论文推荐# 教大模型自己跳过“无用”层,推理速度×3性能不变,谷歌MIT这个新方法火了

归纳翻译QA三大任务都能hold住。

w1hsxn的博客 218

用户和实体行为分析(UEBA)基础指南及解决方案

用户和实体行为分析(UEBA)或异常检测是一种网络安全技术,它使用机器学习(ML)算法来检测网络中用户、主机和其他实体的异常活动。

ITmoster的博客 2893

【OpenBMC 系列】4.启动流程 使用qume模拟ast2600-evb

1.安装openbmc适配的qume 2.启动bmc 3.使用bmc web

AiFool的博客 4461

深度学习的推理优化:加速模型的推理速度

1.背景介绍 深度学习技术在近年来得到了广泛的应用,其中深度学习的推理优化技术在提高模型推理速度方面具有重要意义。随着数据量的增加以及模型的复杂性,传统的推理方法已经无法满足实际需求。因此,深度学习的推理优化技术成为了研究的热点。 在这篇文章中,我们将从以下几个方面进行阐述: 背景介绍 核心概念与联系 核心算法原理和具体操作步骤以及数学模型公式详细讲解 具体代码实例和详细解释说明 未来发展...

AI天才研究院 1697

PyBioMed学习

PyProtein。

weixin_63016274的博客 1401

大模型自己跳过“无用”层,推理速度×3,谷歌MIT这个新方法火啦!

来源:量子位大语言模型用着爽,但推理速度实在太慢了?而且,增加模型体积,推理效果也并不一定就比之前更好。为了解决这一问题,谷歌MIT的研究人员提出了一个新框架CALM,让它自己来决定计算量。如果CALM意识到某些层“可有可无”,那么它在计算时就会跳过这些层。论文被po到网上后,立刻火了一波:有网友表示,我们就是需要这样更智能和自适应的模型,显然CALM的解码器已经做到了:...

深度学习技术前沿 308

关于MOS管栅极和栅介质(氧化物)的材料选择

大概解释了高K材料作为栅介质的好处,以及为什么会带来好处,同时引出了金属栅的优点,总结了使用高K材料和金属栅的原因。

qq_52054477的博客 1万+

【Halcon】双目立体视觉引导机械手有序抓取,案例分享

本文介绍了一个基于双目视觉的工件定位与抓取系统。该系统使用两个工业相机组成双目视觉系统,通过标定获取相机参数,采用模板匹配算法识别任意摆放且可能交叠的工件。重点阐述了三维坐标获取方法,特别是通过Z方向高度实现有序抓取的策略。文章详细说明了系统搭建、双目标定、模板创建等关键步骤,并展示了特征点匹配和定位结果。该案例为初学者和开发者提供了双目视觉系统的基本实现参考,展示了机器视觉与机械手协同工作的典型应用场景。

机器视觉从业者 2490

谷歌更新Transformer架构,更节省计算资源!50%性能提升

来源:量子位谷歌终于更新了Transformer架构。最新发布的Mixture-of-Depths(MoD),改变了以往Transformer计算模式。它通过动态分配大模型中的计算资源,跳过一些不必要计算,显著提高训练效率和推理速度。结果显示,在等效计算量和训练时间上,MoD每次向前传播所需的计算量更小,而且后训练采样过程中步进速度提高50%。这一方法刚刚发布,就马上引发关注。MoE风头正盛,Mo...

深度学习技术前沿 182

Anomalib库安装以及使用

Anomalib是一个专注于异常检测的深度学习库。它的目标是收集最新的异常检测算法,并提供用于在公共和私有数据集上进行基准测试的工具。该库提供了一系列已实现的异常检测算法,这些算法在最近的文献中有所描述。此外,Anomalib还提供了一套工具,方便开发人员开发和实现自定义模型。该库特别注重基于图像的异常检测,旨在识别数据集中的异常图像或图像中的异常像素区域。通过使用Anomalib,用户可以快速构建和评估各种异常检测算法,以满足其特定需求。

mingo_敏 5202

谷歌最新力作!MoD:Transformer的动态分配计算,显著加速!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba和Transformer】微信交流群添加微信:CVer5555,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!明敏 发自 凹非寺转载自:量子位(QbitAI)谷歌终于更新了Transf...

阿木寺的博客 976

服务器搭建原神私服教程

项目的稳定版分支提供了编译好的服务端程序,但是博主觉得还是用dev版本的比较好。dev版本需要自己编译的,不要听到编译这两个字就头大,相反,这个服务端的编译相当简单。把文件中的两个IP地址127.0.0.1修改为你服务器的地址,修改完成后按 esc 输入 :wq。Mongodb作为服务端的数据库使用,我们这里安装最新版的Mongodb5。注意:如果想要使用最新版的服务端,必须安装>=17版本的java。tmux可以保证你关掉控制台的时候,程序依然继续运行。至此,服务端所需要的运行环境全部配置完成。

用最简单的方式说最重要的事!服务器、存储、云计 算、A智能的大数据产品、游戏开发技术。致力于广 大开发者、政企用户、各项机构等,构建云上世界提供全方位云计算解决方案。旨在打造差异化的开放式闭环生态系统帮助用户快速构建稳定、安全的云计算环境。 1万+

深度学习-176-知识图谱技术之langchain与neo4j的嵌入向量Neo4jVector

使用Neo4jVector将输入的文档向量化,并创建向量索引,然后进行语义检索。

qq_20466211的博客 440

CV技术指南 | 「乘法变加法」!MIT清华校友全新方法优化Transformer:Addition is All You Need

Transformer计算,竟然直接优化到乘法运算了。MIT两位华人学者近期发表的一篇论文提出:Addition is All You Need,让LLM的能耗最高降低95%。

csdn_xmj的博客 1365

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

MIT团队发明“智能减肥法“让AI训练快1.6倍:只需要一半的算力就能教会大模型新技能

SparseLoRA提供的解决方案让更多的研究者和开发者能够以更低的成本训练和部署先进的AI模型,这对于AI技术的普及和发展具有重要意义。近年来,研究人员开发了一些"偷懒"的方法,比如LoRA、QLoRA和DoRA,它们通过只训练模型的一小部分参数来节省内存,就像给学生发一本薄薄的补充教材,而不是厚厚的全科教科书。例如,在LLaMA3-8B的数学推理任务中,他们对第3到第30层的FFN应用99%的稀疏性,对第14到第29层的某些注意力投影应用75%的稀疏性。SVD分解的秩选择也是一个重要的技术考量。

weixin_49122920的博客 498

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2319

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

【大模型学习】AI大事件,每日更新

AI相关新闻每日汇总

weixin_44463519的博客 424
上一篇: 人工智能(AI)真的会带来大规模失业吗?
下一篇: 搞了一年大模型,科大讯飞怎么样了?
少喝冰美式
博客等级 码龄3年 6846粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
