


目录
3.1 模式一:顺序链式工作流 (Sequential Chain)
3.3 模式三:多智能体协作工作流 (Multi-Agent Collaboration)
报告副标题: 从单一任务自动化到多步复杂问题求解的范式转移
报告日期: 2025年9月7日
撰写单位: 人工智能与自动化研究中心
执行摘要
本报告旨在深入调研智能体工作流(Agentic Workflows) 这一引领下一代人工智能应用的核心范式。与传统单次调用的AI模型不同,智能体工作流通过让大型语言模型(LLM)担任“协调者”,自主调用工具、循环执行“思考-行动-观察”步骤,直至完成复杂多步任务。报告发现,该技术正从电商、金融、研发等数字化程度高的行业开始落地,其核心价值在于将AI从“被动应答的工具”转变为“主动解决问题的伙伴”。实现高效可靠的工作流需攻克规划、记忆、评估等关键技术挑战,但其未来发展将重塑软件自动化形态和人机协作模式。
一、 核心概念:什么是智能体工作流?
1.1 定义
智能体工作流是指由大型语言模型(LLM)驱动,能够自主理解复杂目标、进行任务分解、规划执行步骤、调用外部工具(API、函数、数据库),并根据执行结果动态调整策略,最终完成任务的自动化过程。
1.2 与传统自动化的区别
| 特征 | 传统自动化 (e.g., RPA脚本) | 智能体工作流 (Agentic Workflow) |
|---|---|---|
| 范式 | 过程驱动 | 目标驱动 |
| 灵活性 | 僵硬、需预设所有路径 | 灵活、可应对不确定性 |
| 处理能力 | 处理结构化、规则明确的任务 | 处理模糊、非结构化、需推理的任务 |
| 核心 | 流程(Flow) | 认知(Cognition)+ 行动(Action) |
| 示例 | “如果收到A邮件,则回复B模板。” | “帮我分析本季度销售数据,找出下滑原因并做一份PPT报告。” |
1.3 核心循环:ReAct (Reason + Act)
这是智能体工作流最基本的执行单元,构成了其“自主”能力的基石。
图表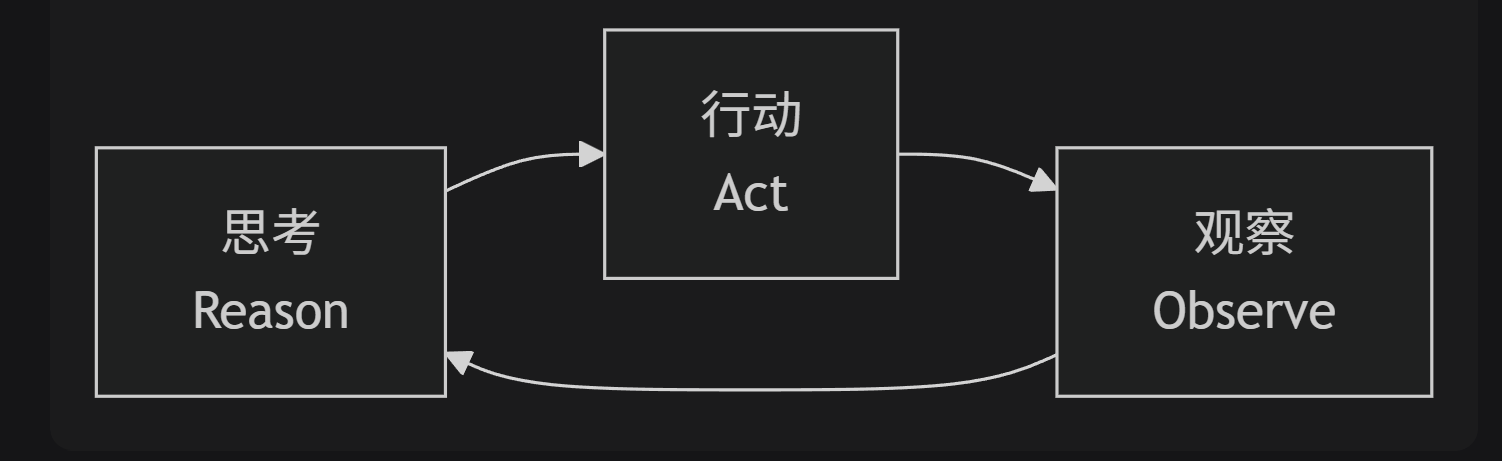
代码
下载
思考
Reason
行动
Act
观察
Observe
一次ReAct循环的伪代码示例:
text
复制
下载
思考: “用户想订机票。我需要先知道他要去哪、什么时候走。”
行动: 调用【询问用户函数】(“请问您的目的地和出行日期是?”)
观察: 用户回复:“明天从北京去上海。”

思考: “用户提供了信息。现在我需要搜索航班。”
行动: 调用【搜索航班API】(出发地=北京, 目的地=上海, 日期=明天)
观察: API返回了航班列表[CA123, MU456...]

思考: “搜索成功。现在需要展示结果让用户选择。”
行动: 调用【展示结果函数】(航班列表)
观察: 用户选择“CA123”

思考: “用户已选择航班,现在需要帮他订票。”
行动: 调用【创建订单API】(航班=CA123, 用户=当前用户)
...
这个循环会持续进行,直到任务完成或无法继续。
二、 智能体工作流的通用技术架构
一个成熟的智能体工作流系统通常包含以下核心模块,其协同工作关系如下图所示:
图表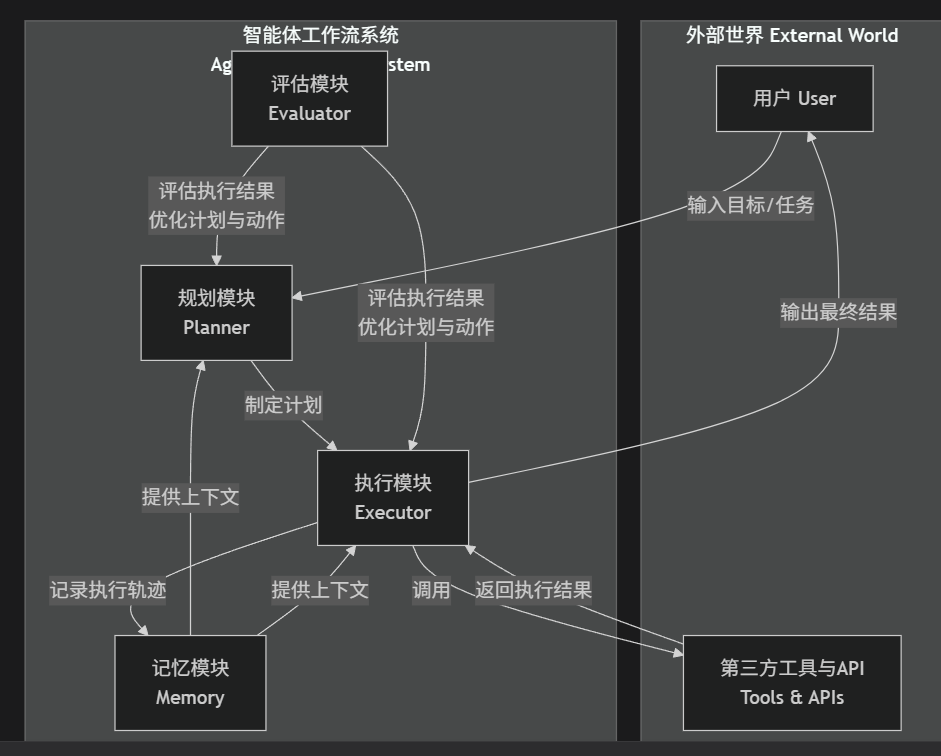
代码
下载
智能体工作流系统
Agentic Workflow System
外部世界 External World
制定计划
记录执行轨迹
提供上下文
提供上下文
评估执行结果
优化计划与动作
评估执行结果
优化计划与动作
输入目标/任务
调用
输出最终结果
返回执行结果
用户 User
第三方工具与API
Tools & APIs
规划模块
Planner
执行模块
Executor
记忆模块
Memory
评估模块
Evaluator
各模块核心功能与关键技术:
-
规划模块 (Planner):
-
功能:将抽象目标分解为具体可执行的子任务序列(Plan)。可分为:
-
战略规划:生成高级别的任务列表(如:1. 数据获取 -> 2. 数据分析 -> 3. 报告生成)。
-
战术规划:为每个任务选择具体工具和参数。
-
-
技术:Chain-of-Thought (CoT), Tree-of-Thought (ToT), LLM + 约束求解器。
-
-
执行模块 (Executor):
-
功能:负责运行规划好的步骤,核心是工具调用(Tool Use)。
-
技术:LLM的函数调用(Function Calling)能力。框架如LangChain、LlamaIndex提供标准化工具调用接口。
-
-
记忆模块 (Memory):
-
功能:存储工作流执行过程中的上下文,包括历史动作、观察结果、用户偏好等,防止遗忘。
-
技术:
-
短期记忆:在对话或单次工作流中记住上下文。
-
长期记忆:通过向量数据库存储和检索历史经验,供未来任务参考。
-
-
-
评估模块 (Evaluator):
-
功能:监控工作流的执行质量,判断当前步骤是否成功,决策是继续、重试还是终止。
-
技术:由LLM自身评估(Self-Correction),或通过规则、模型进行验证。
-
三、 典型工作流模式与应用案例
3.1 模式一:顺序链式工作流 (Sequential Chain)
案例:电商购物助手
工作流:
-
需求澄清:与用户多轮对话,明确商品属性、预算、偏好。
-
商品检索:调用搜索API,获取初始商品列表。
-
筛选比价:调用比价API、情感分析API,过滤出最优选项。
-
决策确认:将选项生成图文并茂的列表,交由用户确认。
-
下单支付:调用订单API、支付API完成购买。
特点:步骤线性推进,是最常见的模式。
3.2 模式二:分支判断工作流 (Branching)
案例:医疗AI助手
工作流:
-
信息提取:从医患对话中提取症状。
-
决策点:LLM判断症状是否清晰。
-
分支1 (清晰):直接检索知识库,提供诊断建议。
-
分支2 (模糊):调用【追问函数】,向医生提示需要询问患者的其他问题(如“疼痛是锐痛还是钝痛?”)。
-
-
继续执行:根据新的信息,继续流程。
特点:引入条件判断,工作流路径动态变化。
3.3 模式三:多智能体协作工作流 (Multi-Agent Collaboration)
案例:AI软件团队
工作流:
-
项目经理Agent:接收需求(“开发一个登录功能”),进行任务分解,分配给其他Agent。
-
后端开发Agent:负责创建API、数据库模型。
-
前端开发Agent:负责编写用户界面。
-
测试工程师Agent:负责编写和运行测试用例。
-
协调者:所有Agent将工作结果汇报给“项目经理”,由其进行集成和部署。
特点:模拟人类团队分工,解决超复杂任务,是Agent技术的终极形态。
四、 挑战与未来趋势
4.1 当前挑战
-
可靠性:LLM的“幻觉”可能导致工作流走向错误方向。
-
成本与延迟:多步循环调用LLM和API,成本高昂且耗时。
-
复杂状态管理:长工作流的状态跟踪和错误恢复非常复杂。
-
评估与测试:缺乏标准化框架来评估工作流的整体有效性。
4.2 未来趋势
-
小型化与专业化:训练小型、专用于工作流规划和工具调用的模型,以降低成本。
-
工作流即代码:出现声明式语言或DSL,用于直观地定义和编排智能体工作流。
-
增强记忆与学习:工作流能够从历史执行中学习成功经验和失败教训,不断优化。
-
人机协同回路:工作流能在关键决策点主动“询问”人类,形成人机混合的增强智能。
结论
智能体工作流不是单一技术的突破,而是LLM的认知能力、软件工具生态和自动化技术的一次深度融合。它标志着AI应用开发正从“编写逻辑”转向“定义目标”,从“功能制造”走向“能力组装”。
尽管面临可靠性与成本的挑战,但其方向是明确的:成为连接数字世界能力的“万能胶水”和“自动执行者”。率先掌握智能体工作流设计和实施能力的企业与开发者,将在新一轮的生产力革命中占据绝对优势。
工具和组件
工具调用、LangGraph、AutoGen、LangChain 工具包 是什么、在智能体里怎么配合、有什么差异**。
① 工具调用(Tool Calling)
一句话:让大模型像人一样“拿起锤子敲钉子”——把自然语言转成 JSON 去调函数/接口。
LangGraph 内用法(官方 create_react_agent):
Python
复制
from langgraph.prebuilt import create_react_agent
from langchain_community.tools.tavily_search import TavilySearchResults

tool = TavilySearchResults(max_results=5)
agent = create_react_agent(model, [tool])   # ← 一行完成 ReAct 循环
answer = agent.invoke({"messages": [{"role": "user", "content": "台风最新路径"}]})作用:模型→JSON→调工具→结果回模型→继续推理,直到满足停止条件。
② LangGraph 工具包
一句话:LangChain 的“状态机+图”升级版,专门画循环流程图(ReAct、Multi-Agent、Human-in-the-loop)。
核心类:
-
StateGraph:画节点和边 -
ToolNode:自动把工具调用转成 HTTP/函数 -
create_react_agent:一键生成“思考-行动-观察”循环 -
interrupt():人工介入/审批(非WebSocket,可中断几小时)
典型图(ReAct):
用户问 → LLM → ToolNode → 结果 → LLM → … → 回答
多智能体示例(Supervisor+Swarm):
Python
复制
from langgraph_supervisor import supervisor
from langgraph_swarm import swarm

supervisor_agent = supervisor([agent1, agent2])   # 自动路由
swarm_agent = swarm([agent1, agent2]) # 无中心广播作用:画循环、存状态、插人工、一键部署到LangGraph Platform。
③ AutoGen 工具包
一句话:微软的“多智能体群聊”框架,角色+对话即服务。
核心类:
-
UserProxyAgent:代表人 -
AssistantAgent:LLM -
GroupChat:群聊房间 -
register_function:把Python函数变成工具
群聊代码:
Python
复制
from autogen import GroupChat, AssistantAgent, UserProxyAgent

user = UserProxyAgent(name="user")
assistant = AssistantAgent(name="assistant", llm_config={"config_list": [...]})
groupchat = GroupChat(agents=[user, assistant], messages=[], max_round=5)
user.initiate_chat(groupchat, message="生成台风疏散剧本")作用:零代码实现“辩论-投票-协作”,适合金融、医疗多角色会诊。
④ LangChain 工具包
一句话:最早、最全的“LLM工具链”底座,被LangGraph/AutoGen都拿来当插件。
核心工具(LangGraph可直接调用):
表格
复制
| 类别 | 工具示例 | 作用 |
|---|---|---|
| 搜索 | TavilySearchResults, SerpAPIWrapper | 实时网页 |
| 计算 | PythonREPLTool, LLMMathTool | 代码/数学 |
| 数据 | SQLDatabaseToolkit, PandasDataframeTool | SQL/表格 |
| 网络 | RequestsGetTool, PlaywrightBrowserToolkit | HTTP/浏览器 |
| 文件 | ReadFileTool, WriteFileTool | 本地文件 |
| LLM | ChatOpenAI, ChatAnthropic | 模型封装 |
| 自定义 | @tool 装饰器 | 任意函数→工具 |
LangGraph内调用:
Python
复制
from langchain.tools import @tool
@tool
def weather(city: str) -> str:
    return f"{city} 台风级 12级"
agent = create_react_agent(model, [weather]) # ← 一行注册作用:让LangGraph/AutoGen瞬间拥有“几百种现成工具”,无需再造轮子。
⑤ 横向对比(一句话记忆)
表格
复制
| 框架 | 核心能力 | 典型代码 | 最佳场景 |
|---|---|---|---|
| Tool Calling | 把语言→JSON→工具 | create_react_agent | 单模型+工具循环 |
| LangGraph | 画循环图+状态机 | StateGraph+ToolNode | 多Agent/人工审核/复杂流程 |
| AutoGen | 群聊式多Agent | GroupChat | 角色辩论、会诊、投票 |
| LangChain | 工具链底座 | @tool+内置工具 | 提供工具库,被上面三个调用 |
一句话总结:LangChain供工具,LangGraph画循环,AutoGen组群聊,ToolCalling是底座——四件套叠加,就是“会看、会想、会动、会社交”的完整智能体。
代码
电商购物助手智能体工作流核心代码
我们将使用 LangGraph 来构建这个工作流,它是专门为构建有状态的、多步骤的智能体工作流而设计的框架,比传统的LangChain Agent更强大、更灵活。
1. 项目结构与依赖
安装依赖:
bash
复制
下载
pip install langgraph langchain-openai python-dotenv
项目结构:
text
复制
下载
shopping_agent/
├── .env                    # 存储API密钥
├── requirements.txt        # 项目依赖
├── tools.py               # 定义工具函数
├── agent_workflow.py      # 定义智能体工作流图
└── main.py               # 主入口文件
2. 定义工具(智能体的“手和脚”)
首先,我们定义智能体可以调用的所有工具函数。
python
复制
下载
# tools.py
import json
from typing import List, Dict, Any
from langchain.tools import tool
import requests  # 假设我们使用requests调用外部API

class ShoppingTools:

    @tool("clarify_user_intent")
    def clarify_user_intent(question: str) -> str:
        """
        当用户需求模糊时,向用户提出澄清性问题。
        参数 question: 要向用户提出的问题。
        返回: 用户的回答。
        """
        # 在实际应用中,这里会连接到你的前端聊天界面
        print(f"[Agent asks user]: {question}")
        # 模拟用户输入(实际中应从聊天接口获取)
        user_response = input("Your answer: ")
        return user_response

    @tool("search_products")
    def search_products(query: str, category: str = None, max_results: int = 10) -> str:
        """
        根据查询条件搜索商品。
        参数:
            query: 搜索关键词
            category: 商品类别(可选)
            max_results: 最大返回结果数
        返回: 商品列表的JSON字符串。
        """
        # 这里是模拟数据!真实情况应该调用淘宝/京东/Amazon的API
        print(f"[Agent is searching for]: {query} in {category}")

        # 模拟API返回
        mock_products = [
            {"name": "便携式野餐垫", "price": 59.9, "rating": 4.8, "sales": 2000, "store": "户外旗舰店"},
            {"name": "一次性烧烤架", "price": 129.9, "rating": 4.5, "sales": 1500, "store": "烧烤世家"},
            {"name": "不锈钢保温箱", "price": 299.0, "rating": 4.9, "sales": 800, "store": "保鲜专家"}
        ]
        return json.dumps(mock_products, ensure_ascii=False)

    @tool("get_product_details")
    def get_product_details(product_id: str) -> str:
        """
        获取商品的详细信息和用户评价。
        参数 product_id: 商品ID
        返回: 商品详情的JSON字符串。
        """
        # 模拟获取商品详情
        print(f"[Agent is getting details for product]: {product_id}")
        mock_details = {
            "description": "超大防水防潮野餐垫,适合8-10人使用",
            "specs": ["材质: 牛津布", "尺寸: 200*200cm", "重量: 1.2kg"],
            "reviews": ["质量很好!", "户外野餐必备!"]
        }
        return json.dumps(mock_details, ensure_ascii=False)

    @tool("add_to_cart")
    def add_to_cart(product_id: str, quantity: int = 1) -> str:
        """
        将商品加入购物车。
        参数:
            product_id: 商品ID
            quantity: 数量
        返回: 操作结果。
        """
        print(f"[Agent is adding {quantity} of {product_id} to cart]")
        return f"已成功将商品 {product_id} (x{quantity}) 加入购物车"

    @tool("check_budget")
    def check_budget(selected_items: List[Dict], budget: float) -> str:
        """
        检查已选商品总价是否超出预算。
        参数:
            selected_items: 已选商品列表
            budget: 预算金额
        返回: 预算检查结果和推荐调整。
        """
        total = sum(item['price'] * item.get('quantity', 1) for item in selected_items)
        result = {
            "total_price": total,
            "within_budget": total <= budget,
            "difference": budget - total
        }
        return json.dumps(result, ensure_ascii=False)

# 获取所有工具
def get_tools():
    shopping_tools = ShoppingTools()
    return [
        shopping_tools.clarify_user_intent,
        shopping_tools.search_products,
        shopping_tools.get_product_details,
        shopping_tools.add_to_cart,
        shopping_tools.check_budget
    ]
3. 定义智能体工作流状态
LangGraph 使用状态机来管理工作流的执行。我们首先定义状态的结构。
python
复制
下载
# agent_workflow.py
from typing import TypedDict, List, Annotated, Optional
from langgraph.graph import StateGraph, END
from langchain_openai import ChatOpenAI
from tools import get_tools
from langchain.tools.render import format_tool_to_openai_function
from langchain_core.messages import HumanMessage, AIMessage
import operator

# 1. 定义状态结构
class AgentState(TypedDict):
    # 用户原始输入
    user_input: str
    # 对话消息历史
    messages: Annotated[List, operator.add]
    # 已澄清的用户需求
    clarified_needs: Optional[dict]
    # 搜索到的商品列表
    search_results: Optional[List[dict]]
    # 已选中的商品
    selected_items: Optional[List[dict]]
    # 预算检查结果
    budget_status: Optional[dict]
    # 工作流是否完成
    complete: bool
4. 定义工作流节点(Nodes)
我们将工作流分解为多个节点,每个节点负责一个特定任务。
python
复制
下载
# agent_workflow.py (续)
# 2. 初始化LLM和工具
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
tools = get_tools()
functions = [format_tool_to_openai_function(t) for t in tools]

# 3. 定义各个节点函数
def clarify_needs_node(state: AgentState):
    """节点1: 澄清用户需求"""
    print("=== 阶段1: 澄清需求 ===")

    # 让LLM判断是否需要澄清需求,以及要问什么问题
    system_prompt = """你是一个购物助手。用户说: {user_input}
    请分析是否需要进一步澄清以下信息:商品类别、预算、具体规格、数量等。
    如果需要澄清,请提出具体问题;如果不需要,直接返回"proceed"。
    """.format(user_input=state["user_input"])

    response = llm.invoke([HumanMessage(content=system_prompt)])
    need_clarification = "proceed" not in response.content.lower()

    if need_clarification:
        # 需要澄清,调用工具提问
        clarification_question = response.content
        user_answer = tools[0].invoke({"question": clarification_question}) # clarify_user_intent

        return {
            "clarified_needs": {
                "original_query": state["user_input"],
                "clarification_q": clarification_question,
                "clarification_a": user_answer
            },
            "messages": [AIMessage(content=f"需要澄清: {clarification_question}")]
        }
    else:
        # 需求明确,继续下一步
        return {
            "clarified_needs": {"original_query": state["user_input"]},
            "messages": [AIMessage(content="需求已明确,开始搜索商品。")]
        }

def search_products_node(state: AgentState):
    """节点2: 搜索商品"""
    print("=== 阶段2: 搜索商品 ===")

    # 基于澄清后的需求构建搜索查询
    needs = state["clarified_needs"]
    search_query = f"{needs['original_query']} {needs.get('clarification_a', '')}"

    # 调用搜索工具
    results = tools[1].invoke({"query": search_query, "max_results": 5}) # search_products
    products = json.loads(results)

    return {
        "search_results": products,
        "messages": [AIMessage(content=f"找到了{len(products)}个相关商品")]
    }

def select_and_validate_node(state: AgentState):
    """节点3: 选择商品并验证预算"""
    print("=== 阶段3: 选择商品和预算验证 ===")

    # 让LLM基于需求和商品列表进行选择
    system_prompt = """你是一个购物助手。用户需要: {user_input}
    现有商品列表: {products}
    请为用户选择最合适的商品,考虑价格、评分、销量等因素。
    返回格式: JSON {{"selected_items": [{{"name": "...", "price": ..., "quantity": ...}}]}}
    """.format(
        user_input=state["clarified_needs"]["original_query"],
        products=json.dumps(state["search_results"], ensure_ascii=False)
    )

    response = llm.invoke([HumanMessage(content=system_prompt)])
    # 解析LLM的输出,提取选择的商品
    selected_items = json.loads(response.content)["selected_items"]

    # 检查预算(假设预算500元)
    budget_check = tools[4].invoke({ # check_budget
        "selected_items": selected_items,
        "budget": 500.0
    })
    budget_status = json.loads(budget_check)

    return {
        "selected_items": selected_items,
        "budget_status": budget_status,
        "messages": [AIMessage(content=f"已选择{len(selected_items)}件商品,总价{budget_status['total_price']}元")]
    }
5. 构建工作流图(Graph)
这是最核心的部分,我们将节点连接起来,并定义执行逻辑。
python
复制
下载
# agent_workflow.py (续)
def should_continue(state: AgentState):
    """判断条件:根据预算状态决定下一步"""
    if state["budget_status"]["within_budget"]:
        return "add_to_cart"  # 预算内,继续加入购物车
    else:
        return "adjust_selection"  # 超预算,需要调整

def add_to_cart_node(state: AgentState):
    """节点4: 加入购物车"""
    print("=== 阶段4: 加入购物车 ===")

    for item in state["selected_items"]:
        # 模拟加入购物车,实际中需要真实的商品ID
        tools[3].invoke({ # add_to_cart
            "product_id": f"prod_{hash(item['name'])}",
            "quantity": item.get('quantity', 1)
        })

    return {
        "complete": True,
        "messages": [AIMessage(content="所有商品已成功加入购物车!")]
    }

def adjust_selection_node(state: AgentState):
    """节点5: 调整选择(如果超预算)"""
    print("=== 阶段5: 调整选择(超预算) ===")

    # 让LLM基于超预算情况重新选择
    system_prompt = """当前选择已超出预算{over_budget}元。
    原商品列表: {products}
    请调整选择,确保在预算内,优先保留评分高、更符合需求的商品。
    返回新的选择方案。
    """.format(
        over_budget=-state["budget_status"]["difference"],
        products=json.dumps(state["search_results"], ensure_ascii=False)
    )

    response = llm.invoke([HumanMessage(content=system_prompt)])
    new_selection = json.loads(response.content)["selected_items"]

    # 更新状态,然后重新检查预算
    return {
        "selected_items": new_selection,
        "messages": [AIMessage(content="已重新选择商品,将重新检查预算")]
    }

# 构建工作流图
def create_workflow():
    builder = StateGraph(AgentState)

    # 添加节点
    builder.add_node("clarify_needs", clarify_needs_node)
    builder.add_node("search_products", search_products_node)
    builder.add_node("select_and_validate", select_and_validate_node)
    builder.add_node("add_to_cart", add_to_cart_node)
    builder.add_node("adjust_selection", adjust_selection_node)

    # 设置入口点
    builder.set_entry_point("clarify_needs")

    # 添加边(连接节点)
    builder.add_edge("clarify_needs", "search_products")
    builder.add_edge("search_products", "select_and_validate")

    # 条件边:根据预算检查结果决定下一步
    builder.add_conditional_edges(
        "select_and_validate",
        should_continue,
        {
            "add_to_cart": "add_to_cart",
            "adjust_selection": "adjust_selection"
        }
    )

    # 调整选择后重新验证预算
    builder.add_edge("adjust_selection", "select_and_validate")

    # 结束边
    builder.add_edge("add_to_cart", END)

    # 编译图
    graph = builder.compile()
    return graph
6. 主程序入口
python
复制
下载
# main.py
from agent_workflow import create_workflow, AgentState
from langchain_core.messages import HumanMessage
import asyncio

async def main():
    # 1. 创建工作流
    workflow = create_workflow()

    # 2. 定义初始状态
    initial_state: AgentState = {
        "user_input": "我想为周末的8人户外野餐准备必需品",
        "messages": [HumanMessage(content="我想为周末的8人户外野餐准备必需品")],
        "clarified_needs": None,
        "search_results": None,
        "selected_items": None,
        "budget_status": None,
        "complete": False
    }

    # 3. 执行工作流
    print("🚀 启动购物助手工作流...")
    final_state = await workflow.ainvoke(initial_state)

    # 4. 打印结果
    print("\n🎉 工作流执行完成!")
    for msg in final_state["messages"]:
        if hasattr(msg, 'content'):
            print(f"{msg.content}")

if __name__ == "__main__":
    asyncio.run(main())
执行流程与输出示例
当你运行 main.py 时,工作流会按以下步骤执行:
-
澄清需求:Agent可能会问:“请问您的预算是多少?对品牌有偏好吗?”
-
搜索商品:基于你的回答搜索相关商品。
-
选择与验证:LLM智能选择商品并检查是否超预算。
-
决策点:
-
如果未超预算 -> 加入购物车 -> 结束。
-
如果超预算 -> 调整选择 -> 跳回第3步重新验证。
-
-
完成:输出最终结果。
这个代码示例完美展示了智能体工作流的精髓:
-
状态管理:通过
AgentState在不同节点间传递和更新数据。 -
条件路由:根据预算检查结果动态决定下一步路径。
-
工具调用:无缝集成外部API和函数。
-
循环机制:超预算时可以循环调整直到满足条件。
你可以通过扩展工具集(集成真实电商API)和增加更多节点(如支付、物流查询)来使这个工作流变得更加强大和实用。

 284


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


