
【多任务损失】用不确定度来自适应设定各损失函数的权重

Uncertainty Loss不确定损失 Uncertainty Loss不确定损失 背景:用于multi-task learning多任务学习 论文:Multi-task learning using uncertainty to weigh losses for scene geometry and semantics. 过去:两个子任务的Loss简单加权和。权重是超参数,需要人力调参。 本文思想:权重也作为可训练参数。 具体来说是建模任务间的同方差不确定性 。 (1)多任务学习 多任务学习可以认为是归纳知识迁移,通过共享互补任务的域信息提升泛 阅读详情
AI摘要

本文基于JDE算法中多任务损失的自适应设定,用数学推导讲解多任务损失函数权重设定原理。介绍了多任务独立性下的概率估计与损失融合,分别阐述连续类损失(回归)、离散类损失(分类)的处理方式,给出多任务损失组合公式,最后说明实际操作中的近似处理方法。


🌔在多任务中,总损失常常是各分任务损失的线性加权,此时各分任务损失的权重设定就显得尤为重要。

比如在JDE算法中就使用了多任务损失的自适应设定:
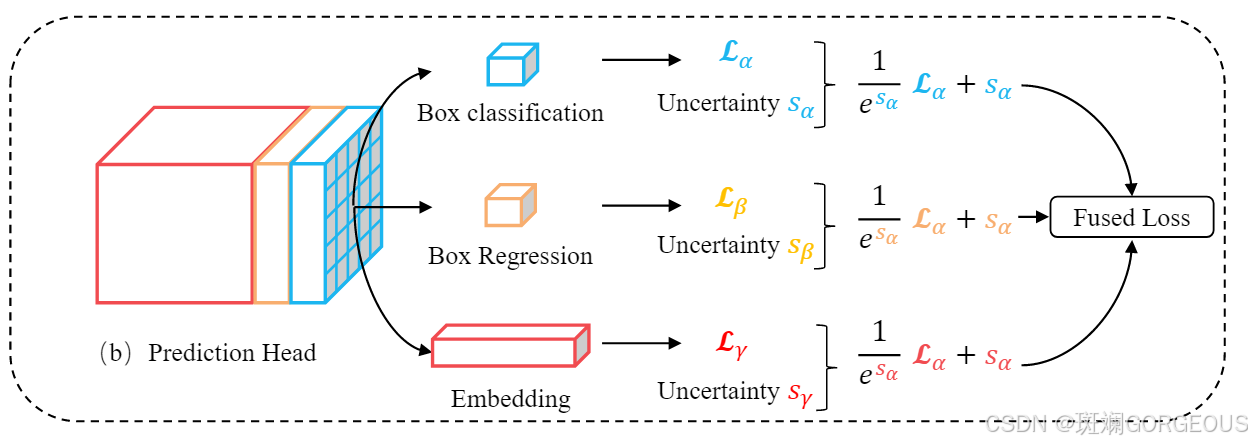
在这里插入图片描述
这里使用的权重自适应方法便来自以下这篇文章发掘的不确定度与权重的关系:

Multi-Task Learning Using Uncertainty to Weigh Losses for Scene Geometry and Semantics

本文正是基于此,用步步衔接的数学推导,讲解多任务损失函数权重设定原理。

总的来说用不确定度估计多任务损失权重的核心是:

各任务的权重与其对应的噪声成反相关

0️⃣ 多任务独立性

⭐️对于模型输出 f W ( x ) \mathbf{f^W(x)} fW(x)以及对应的真值 y \mathbf{y} y,多任务(假设是相互独立的)的概率估计可以表示为以下这种形式:
p ( y 1 , … , y K ∣ f W ( x ) ) = p ( y 1 ∣ f W ( x ) ) … p ( y K ∣ f W ( x ) ) p(\mathbf{y_1,\dots,y_K|f^W(x)})=p(\mathbf{y_1|f^W(x)})\dots p(\mathbf{y_K|f^W(x)}) p(y1​,…,yK​∣fW(x))=p(y1​∣fW(x))…p(yK​∣fW(x))
假设使用 − log ⁡ -\log −log来计算损失,则有:
L t o t a l = − log ⁡ [ p ( y 1 , … , y K ∣ f W ( x ) ) ] = ( − log ⁡ [ p ( y 1 ∣ f W ( x ) ) ] ) + ⋯ + ( − log ⁡ [ p ( y K ∣ f W ( x ) ) ] ) = L 1 + ⋯ + L K L_{total}\\=-\log[p(\mathbf{y_1,\dots,y_K|f^W(x)})]\\=(-\log[p(\mathbf{y_1|f^W(x)})])+\dots+ (-\log[p(\mathbf{y_K|f^W(x)})])\\=L_1+\dots+L_K Ltotal​=−log[p(y1​,…,yK​∣fW(x))]=(−log[p(y1​∣fW(x))])+⋯+(−log[p(yK​∣fW(x))])=L1​+⋯+LK​
因而,基于此就可以使用概率估计来融合各分任务的损失表达。

1️⃣ 连续类损失(回归)

⭐️以回归问题为例,讲解对连续类损失的处理方式。

假设回归问题的概率满足Gaussian分布,依此估计其概率,则有:
p ( y ∣ f W ( x ) , σ ) = 1 2 π σ e − ( y − f W ( x ) ) 2 2 σ 2 p(\mathbf{y|f^W(x),\sigma})=\frac{1}{\sqrt{2\pi}\sigma}e^{-\frac{(y-f^W(x))^2}{2\sigma^2}} p(y∣fW(x),σ)=2π ​σ1​e−2σ2(y−fW(x))2​
写成损失的形式:
− log ⁡ ( y ∣ f W ( x ) , σ ) = ( y − f W ( x ) ) 2 2 σ 2 − log ⁡ ( 1 2 π σ ) ≈ ∥ y − f W ( x ) ∥ 2 2 σ 2 + log ⁡ ( σ ) -\log(\mathbf{y|f^W(x),\sigma})={\frac{(y-f^W(x))^2}{2\sigma^2}}-\log(\frac{1}{\sqrt{2\pi}\sigma})\approx {\frac{\parallel y-f^W(x)\parallel_2}{2\sigma^2}}+\log({\sigma}) −log(y∣fW(x),σ)=2σ2(y−fW(x))2​−log(2π ​σ1​)≈2σ2∥y−fW(x)∥2​​+log(σ)

2️⃣ 离散类损失(分类)

⭐️以分类问题为例,讲解对离散类损失的处理方式。

使用Softmax对分类输出进行处理,依此估计其概率,其中 σ \sigma σ是一个尺度因子:
p ( y = c ∣ f W ( x ) , σ ) = S o f t m a x ( y , 1 σ 2 f W ( x ) ) = e 1 σ 2 f c W ( x ) ∑ c ′ e 1 σ 2 f c ′ W ( x ) p(\mathbf{y}=c|\mathbf{f^W(x),\sigma})=Softmax(\mathbf{y},\frac{1}{\sigma^2}\mathbf{f^W(x)})=\displaystyle \frac{e^{\frac{1}{\sigma^2}f^W_c(\mathbf{x})}}{\sum_{c'}e^{\frac{1}{\sigma^2}f^W_{c'}(\mathbf{x})}} p(y=c∣fW(x),σ)=Softmax(y,σ21​fW(x))=∑c′​eσ21​fc′W​(x)eσ21​fcW​(x)​
写成损失的形式:
− log ⁡ ( p ( y = c ∣ f W ( x ) , σ ) ) = − 1 σ 2 f c W ( x ) + log ⁡ ( ∑ c ′ e 1 σ 2 f c ′ W ( x ) ) -\log(p(\mathbf{y}=c|\mathbf{f^W(x),\sigma}))=-\frac{1}{\sigma^2}f^W_c(\mathbf{x})+\log({\sum_{c'}e^{\frac{1}{\sigma^2}f^W_{c'}(\mathbf{x})}}) −log(p(y=c∣fW(x),σ))=−σ21​fcW​(x)+log(∑c′​eσ21​fc′W​(x))

3️⃣ 多任务损失组合

⭐️假设有两个任务:回归任务1(连续),分类任务2(离散),则有:
L ( W , σ 1 , σ 2 ) = − log ⁡ ( p ( y 1 , y 2 = c ∣ f W ( x ) ) ) = − log ⁡ [ ( 1 2 π σ 1 e − ( y 1 − f W ( x ) ) 2 2 σ 1 2 ) ⋅ ( e 1 σ 2 2 f c W ( x ) ∑ c ′ e 1 σ 2 2 f c ′ W ( x ) ) ] = ∥ y 1 − f W ( x ) ∥ 2 2 σ 1 2 + log ⁡ ( σ 1 ) − 1 σ 2 2 f c W ( x ) + log ⁡ ( ∑ c ′ e 1 σ 2 2 f c ′ W ( x ) ) = ∥ y 1 − f W ( x ) ∥ 2 2 σ 1 2 + log ⁡ ( σ 1 ) + [ − 1 σ 2 2 f c W ( x ) + 1 σ 2 2 log ⁡ ( ∑ c ′ e f c ′ W ( x ) ) ] − 1 σ 2 2 log ⁡ ( ∑ c ′ e f c ′ W ( x ) ) + log ⁡ ( ∑ c ′ e 1 σ 2 2 f c ′ W ( x ) ) = 1 2 σ 1 2 L 1 ( W ) + 1 σ 2 2 L 2 ( W ) + log ⁡ ( σ 1 ) + log ⁡ [ ∑ c ′ e 1 σ 2 2 f c ′ W ( x ) ( ∑ c ′ e f c ′ W ( x ) ) 1 σ 2 2 ] ≈ 1 2 σ 1 2 L 1 ( W ) + 1 σ 2 2 L 2 ( W ) + log ⁡ ( σ 1 ) + log ⁡ ( σ 2 ) L(\mathbf{W},\sigma_1,\sigma_2)\\=-\log(p(\mathbf{y_1,y_2}={c}|\mathbf{f^W(x)}))\\=-\log[(\frac{1}{\sqrt{2\pi}\sigma_1}e^{-\frac{(y_1-f^W(x))^2}{2\sigma_1^2}})\cdot(\displaystyle \frac{e^{\frac{1}{\sigma_2^2}f^W_c(\mathbf{x})}}{\sum_{c'}e^{\frac{1}{\sigma_2^2}f^W_{c'}(\mathbf{x})}})]\\={\frac{\parallel y_1-f^W(x)\parallel_2}{2\sigma_1^2}}+\log({\sigma_1})-\frac{1}{\sigma_2^2}f^W_c(\mathbf{x})+\log({\sum_{c'}e^{\frac{1}{\sigma_2^2}f^W_{c'}(\mathbf{x})}}) \\ ={\frac{\parallel y_1-f^W(x)\parallel_2}{2\sigma_1^2}}+\log({\sigma_1})+[-\frac{1}{\sigma_2^2}f^W_c(\mathbf{x})+\frac{1}{\sigma_2^2}\log(\sum_{c'}e^{f^W_{c'}(x)})]-\frac{1}{\sigma_2^2}\log(\sum_{c'}e^{f^W_{c'}(x)})+\log({\sum_{c'}e^{\frac{1}{\sigma_2^2}f^W_{c'}(\mathbf{x})}}) \\ =\frac{1}{2\sigma_1^2}L_1(\mathbf{W})+\frac{1}{\sigma_2^2}L_2(\mathbf{W})+\log(\sigma_1)+\log[\frac{\sum_{c'}e^{\frac{1}{\sigma_2^2}f^W_{c'}(\mathbf{x})}}{(\sum_{c'}e^{f^W_{c'}(\mathbf{x})})^\frac{1}{\sigma_2^2}}]\\\approx \frac{1}{2\sigma_1^2}L_1(\mathbf{W})+\frac{1}{\sigma_2^2}L_2(\mathbf{W})+\log(\sigma_1)+\log(\sigma_2) L(W,σ1​,σ2​)=−log(p(y1​,y2​=c∣fW(x)))=−log[(2π ​σ1​1​e−2σ12​(y1​−fW(x))2​)⋅(∑c′​eσ22​1​fc′W​(x)eσ22​1​fcW​(x)​)]=2σ12​∥y1​−fW(x)∥2​​+log(σ1​)−σ22​1​fcW​(x)+log(c′∑​eσ22​1​fc′W​(x))=2σ12​∥y1​−fW(x)∥2​​+log(σ1​)+[−σ22​1​fcW​(x)+σ22​1​log(c′∑​efc′W​(x))]−σ22​1​log(c′∑​efc′W​(x))+log(c′∑​eσ22​1​fc′W​(x))=2σ12​1​L1​(W)+σ22​1​L2​(W)+log(σ1​)+log[(∑c′​efc′W​(x))σ22​1​∑c′​eσ22​1​fc′W​(x)​]≈2σ12​1​L1​(W)+σ22​1​L2​(W)+log(σ1​)+log(σ2​)
其中,
{ L 1 ( W ) = ∥ y 1 − f W ( x ) ∥ 2 L 2 ( W ) = − log ⁡ [ S o f t m a x ( y 2 , f W ( x ) ) ] = − log ⁡ ( e f c W ( x ) ∑ c ′ e f c ′ W ( x ) ) 1 σ 2 2 ∑ c ′ e 1 σ 2 2 f c ′ W ( x ) ≈ ( ∑ c ′ e f c ′ W ( x ) ) 1 σ 2 2 \begin{cases}L_1(\mathbf{W})=\parallel y_1-f^W(x)\parallel_2\\L_2(\mathbf{W})=-\log[Softmax(y_2,f^W(x))]=-\log(\displaystyle \frac{e^{f^W_c(\mathbf{x})}}{\sum_{c'}e^{f^W_{c'}(\mathbf{x})}})\\\frac{1}{\sigma_2^2}\sum_{c'}e^{\frac{1}{\sigma^2_2}f^W_{c'}(x)}\approx(\sum_{c'}e^{f^W_{c'}(\mathbf{x})})^\frac{1}{\sigma_2^2}\end{cases} ⎩ ⎨ ⎧​L1​(W)=∥y1​−fW(x)∥2​L2​(W)=−log[Softmax(y2​,fW(x))]=−log(∑c′​efc′W​(x)efcW​(x)​)σ22​1​∑c′​eσ22​1​fc′W​(x)≈(∑c′​efc′W​(x))σ22​1​​

4️⃣ 实际操作中的近似处理

⭐️最后,在实际操作中,通过预测 s : = log ⁡ ( σ 2 ) s:=\log(\sigma^2) s:=log(σ2)来代替预测 σ 2 \sigma^2 σ2,因为这样在数值上更加稳定,而且没有除0等问题,则最后多任务损失可以近似写成:
L ( W , s 1 , s 2 ) = 1 e s 1 L 1 ( W ) + 1 e s 2 L 2 ( W ) + s 1 + s 2 L(\mathbf{W},s_1,s_2)=\frac{1}{e^{s_1}}L_1(\mathbf{W})+\frac{1}{e^{s_2}}L_2(\mathbf{W})+s_1+s_2 L(W,s1​,s2​)=es1​1​L1​(W)+es2​1​L2​(W)+s1​+s2​

【多任务损失权重自适应】从概率视角推导不确定度与损失权重的数学关系 本文从概率视角深入探讨了多任务学习中损失权重自适应的数学原理,揭示了不确定度与损失权重的反比关系。通过回归任务的高斯建模和分类任务的Softmax扩展,推导出统一的多任务损失公式,并提供了工程实践中的数值稳定实现技巧。该方法能自动平衡不同任务的权重,有效解决传统手动调参的困境,适用于目标检测、语义分割等多任务场景。 阅读详情

相关推荐

别再手动调权重了!用PyTorch实现多任务损失自适应加权(附代码)

本文详细介绍了如何使用PyTorch实现多任务损失自适应加权,解决传统手动调整权重耗时且效果不佳的问题。基于不确定度的自适应加权方法能动态平衡不同任务的损失,提升模型性能。文章包含数学原理、工程实现技巧及完整代码示例,适用于回归与分类任务的多任务学习场景。

weixin_42525632的博客 120

【多任务学习的自适应损失权重调整策略的方法】

多任务学习是指在一个模型中学习多个任务,通过共享模型参数来提高效率和泛化能力。自适应损失权重调整策略是指在多任务学习中,根据不同任务的难度和重要性,动态地调整每个任务的损失权重,以提高模型的性能。

m0_56261792的博客 4791

Python实现基于DNN全连接神经网络进行多输入多输出回归预测的详细项目实例

本项目基于DNN全连接神经网络实现了多输入多输出的回归预测,主要特点包括: 采用残差金字塔结构的主干网络,结合自适应不确定度加权损失和相关保持正则化,实现对多个连续目标的联合建模; 提供完整的数据预处理流程,包括鲁棒缩放、分位截断、特征工程等; 实现模型训练、评估、可视化和部署的全流程,支持MCDropout不确定度估计; 应用领域覆盖工业设备健康监测、综合能耗预测、医疗监护等多个场景; 包含精美的GUI界面,方便交互式使用。 项目创新点在于相关性保持正则和自适应不确定度加权机制,有效提升了多目标预测的一致

优质创作者: 人工智能技术领域 对于有一定基础的 MATLAB和Python带具体需求都可以详谈 MATLAB和Python可以提供代码调试服务加油 谢谢 你的鼓励是我前行的动力 谢谢支持 加油 谢谢 2066

多任务学习中各loss权重应该如何设计呢?

在网络架构的设计中,最简单和最流行的方法是硬参数共享(HPS,LibMTL.architecture.HPS),如图1所示,其中编码器在所有任务之间共享,每个任务都有自己的编码器以及特定的解码器。(1)把各loss统一到同一个数量级上,其背后的原因是不同任务的不同损失函数尺度有很大的差异,因此需要考虑用权值将每个损失函数的尺度统一。和每个子任务之间的约束。而对于“不同网络部分梯度的数量级”问题,虽然梯度值相同,但不同的loss在task上的表现也是不同的,所以还是要找不同loss的合适平衡点。

豆芽菜 3275

基于胸部X光片的COVID-19 AI辅助诊断实战指南

胸部X光片(CXR)作为基层医疗最普及的影像检查手段,其低门槛、高可及性使其成为AI赋能传染病早期筛查的关键载体。本文围绕机器学习在CXR上识别COVID-19的核心原理展开:从医学影像与自然图像的本质差异出发,解析迁移学习为何必须依托胸部专用预训练模型(如CheXpert);阐明注意力机制(CBAM)如何提升病灶定位可解释性,解决医生对‘黑箱决策’的信任瓶颈;强调高质量临床数据清洗、三级标签工程与设备自适应预处理(如CLAHE参数调优)对模型泛化能力的决定性影响。技术价值在于将疑似病例初筛压缩至秒级,支撑

weixin_34008784的博客 377

AI上推荐 之 多任务loss优化(自适应权重篇)

1. 写在前面 在多任务学习中,往往会将多个相关的任务放在一起来学习。例如在推荐系统中,排序模型同时预估候选的点击率和浏览时间。相对于单任务学习,多任务学习有以下优势: 多个任务共享一个模型,占用内存量减少; 多个任务一次前向计算得出结果,推理速度增加; 关联任务通过共享信息,相互补充,可以提升彼此的表现。 前面的一篇文章,主要是从模型结构的角度聊了下多任务学习,介绍了工业界非常经典也常用的MMOE模型,然而,对于多任务学习, Loss的优化也非常重要, 因为我们知道通过多个目标去指导网络进行统一的训练

Miracle8070 1万+

多任务学习中损失函数权重的自动调整

多任务学习;同方差不确定性;辅助任务;损失函数权重调参;

m0_63642362的博客 1万+

YOLOv11【第三章:高阶应用与落地篇·第8节】DeepSORT 实战——YOLOv11 + DeepSORT 实现行人/车辆稳定追踪!

🏆 本文收录于专栏 《YOLOv11实战:从入门到深度优化》。本专栏围绕 YOLOv11 的改进、训练、部署与工程优化 展开,系统梳理并复现当前主流的 YOLOv11 实战案例与优化方案,内容目前已覆盖 分类、检测、分割、追踪、关键点、OBB 检测 等多个方向。

**My Coding Family** 631

如何用不确定性自动调节多任务学习中的损失权重?PyTorch实战教程

本文详细介绍了如何利用同方差不确定性原理在PyTorch中实现多任务学习的损失权重自动调节。通过概率建模和可学习的不确定性参数,有效解决了语义分割、深度估计等任务间的量纲差异问题,提升模型整体性能。教程包含网络架构设计、损失函数实现及实战调优技巧,适用于计算机视觉领域的Multi-Task Learning应用。

wine的专栏 592

【信息科学与工程学】【产品体系】第十二篇 制造业生产加工05 控制算法 ——飞行(1)

航空航天控制的高级主题,包括先进飞行控制、航天器高级控制、无人机集群、航空发动机控制和飞行管理。

weixin_49199313的博客 1911

【信息科学与工程学】【数据科学】第一百八十八篇 数据处理方法列表02

编号类型领域数据处理方法适用的数据类型缺陷与优势应用场景关联知识和标准和法律法规1001物理世界数据处理线性代数广义逆矩阵(Moore-Penrose伪逆)在超定线性方程组求解中的应用——当物理实验中获得的观测方程个数多于未知数时(例如通过多个传感器测量同一个物理量的不同线性组合),需要寻找最小二乘意义下的最佳解。该方法通过奇异值分解(SVD)计算伪逆,即 A+=VΣ+UT,其中 Σ+ 是将奇异值的倒数取零(小于阈值的奇异值置零)。超定线性方程组 Ax=b,其中 A 为 m×n 矩阵且 m>n,b 为观测向

weixin_49199313的博客 324

深度学习实用指南:数据预处理、梯度调试与推理优化实战

深度学习模型训练常面临不收敛、梯度异常和过拟合等挑战,其根源多在于数据预处理、反向传播调试和正则化等工程细节。通过标准化数据管道、诊断梯度范数、平衡多任务损失以及应用量化剪枝技术,可显著提升模型稳定性和推理效率。这些方法在图像分类、推荐系统和边缘计算等场景中具有广泛价值。本文聚焦深度学习落地中的实操陷阱与优化策略,涵盖从训练到部署的完整检查清单。

weixin_30607125的博客 287

【信息科学与工程学】计算机科学与自动化——第十篇 芯片设计00 芯片中的基础学科知识03

湿度加速:Peck模型 AF = (RH_stress/RH_use)^n exp(Ea/k(1/T_use-1/T_stress))热循环加速因子:Arrhenius AF = exp(Ea/k (1/T_use - 1/T_stress))等离子体鞘层厚度:d_s = (2/3)√(2e/m) V^{3/4} / (ω_p √(J))过程能力Cpk = min((USL-μ)/(3σ), (μ-LSL)/(3σ))薄膜应力:Stoney公式 σ_f = (E_s t_s²)/(6t_f R)

weixin_49199313的博客 405

卡尔曼滤波与Transformer融合:自适应状态估计新范式

状态估计是动态系统感知与决策的核心基础,旨在从带噪声的观测数据中推断系统内部状态。其经典理论框架以卡尔曼滤波为代表,通过状态空间模型与贝叶斯递推实现最优估计,但依赖精确的数学模型与噪声统计特性,在复杂非线性、时变噪声场景下性能受限。近年来,深度学习为状态估计提供了数据驱动的增强路径,其中Transformer凭借其强大的序列建模与长程依赖捕捉能力,成为提升传统滤波器自适应性的关键技术。通过将Transformer的注意力机制与卡尔曼滤波的递推框架相结合,可以实现对噪声协方差、系统误差或状态预测的在线学习与动

weixin_34343000的博客 555

(SCADA)监控与数据采集系统

SCADA应用于监控和采集数据来控制工业过程软件。它通过收集和传输实时数据,帮助操作员监视和控制各种设备和过程。

软件技术的专栏 4545

SAP系统中PP模块全配置文档

配置路径IMG>SAP NetWeaver>常规设置>维护日历>工厂日历事务代码SCAL要求传输工厂代码描述日历代码日历描述起始日期星期一星期二星期三星期四星期五星期六星期日有效开始日期有效结束日期1000南微医学工厂MT南微医学工厂日历√√√√√√√201820502.4定义工厂配置路径IMG>生产>物料清单>常规数据>定义BOM状态事务代码OS23要求传输配置路径IMG>生产>主数据>资源>常规数据>标准值>定义参数。

yanzibing99的博客 1894

OneTrans-V2:基于Transformer统一召回与排序的推荐系统架构详解

在推荐系统领域,召回与排序长期作为两套独立技术体系存在,双塔模型负责粗筛、深度排序模型负责精排,特征体系与训练方式割裂,导致工程维护成本高且效果难以协同优化。统一建模的核心思路,是借助Transformer强大的序列建模能力,将用户行为序列作为统一信号,实现一个模型打通召回与排序。Transformer通过自注意力机制捕获行为间的上下文关联,配合多任务学习与多兴趣表达,既能在召回侧生成多向量覆盖长尾兴趣,也能在排序侧动态重解读历史行为,提升精细化打分能力。该架构适用于短视频、电商等大规模推荐场景,可显著提升

weixin_30985047的博客 25

Python爬虫:招聘网站岗位要求、薪资与求职者数据爬取与分析

通过本文的教程,我们学习了如何通过 Python 编写招聘数据爬虫,爬取招聘网站上的岗位要求、薪资和求职者数据,并通过数据存储、清洗、分析和可视化,获取有价值的信息。网站如智联招聘、猎云网、前程无忧等,都提供了大量的招聘信息,包括岗位要求、薪资范围、工作经验、学位要求、招聘公司等。本文将介绍如何通过 Python 编写爬虫,爬取招聘网站上的岗位要求、薪资、求职者数据,并通过数据存储、分析和可视化等手段,为求职者或招聘者提供实用的信息和决策支持。通过循环抓取多个页面的数据,可以获取不同岗位的信息。

2201_76125261的博客 723

基于深度学习的癌症生存率预测模型设计与实践

生存分析是医疗AI领域的核心技术之一,通过建模患者生存时间与协变量关系,为临床决策提供量化支持。传统Cox回归模型在处理高维非线性关系时存在局限,而深度学习通过特征自动提取和多任务学习框架,显著提升了预测性能。本文以乳腺癌为例,详细介绍了从SEER数据集特征工程到动态生存曲线预测的全流程实现,重点解析了多任务学习框架中风险评分与生存概率分布的联合建模方法,以及注意力机制、不确定度校准等创新技术的工程应用。该方案在三甲医院真实场景验证中C-index达到0.786,较传统方法提升5%以上,特别在治疗方案模拟和

weixin_34162851的博客 278

YOLO26原创自研: 魔改Bottleneck,具备多尺度和特征通道融合的结构

魔改Bottleneck,具备多尺度和特征通道融合的结构,该模型在检测准确性方面都取得了良好的效果,尤其在缺陷检测方向。

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 317

YOLOv10改进 | 代码逐行解析(三) | YOLO中的Mosaic增强详解(新手入门必读系列)

本文给大家带来的是YOLOv10中的Mosaic增强代码的详解,可能有部分人对于这一部分比较陌生,有的读者可能知道Mosaic增强但是不知道其工作原理,具体来说Mosaic增强就是指我们的数据集中的图片在输入给模型之前的一个处理过程(我们的图片并不是直接就输入给模型了,大家的训练结果中的结果检测图片大家可以看到数据集中多个图片会组合在一起这就是简单的Mosaic增强),下面我就来讲解一下其在YOLOv10中工作原理和代码定义,下面图片为一个Mosaic增强后的图片。​。

Snu77的博客 2077

CNN-BiLSTM-KDE混合模型在时序预测中的实践与优化

时间序列预测是数据分析领域的核心课题,通过挖掘历史数据的时序规律预测未来趋势。其技术原理通常结合特征提取与序列建模,CNN擅长捕捉局部特征模式,BiLSTM能建模长短期时序依赖关系,而KDE则对预测结果进行概率化评估。这种混合架构在工业设备预测性维护、金融风险预警等场景展现显著优势,能有效解决传统ARIMA模型处理多变量数据时的维度灾难问题。以Matlab实现为例,合理设计卷积核宽度、采用门控融合机制优化BiLSTM输出,配合自适应带宽的核密度估计,可使预测精度提升20%以上。特别是在风电功率预测、生产线故

weixin_34301132的博客 555

dolphinscheduler集群服务一键安装启动实现流程剖析

通过以上分析我们基本梳理清楚了整个dolphinscheduler项目的一键安装启动逻辑, 我们现在在通过一张图正好理一下整个实现流程。关于一键停止集群服务及一件查询集群各个角色服务实例运行状态的实现也都在stop-all.sh/status-all.sh及dolphinscheduler-daemon.sh这三个脚本中, 有兴趣自行研究。写这篇文章的核心目的不仅在于给大家分享如何优秀的开源项目的一键安装部署的实现过程。

最爱嫣夜来 1207

多任务自适应损失权重

多任务自适应损失权重 在训练多任务的时候,当不同任务的数据量不平衡、各任务难易程度不同等等情况下,会导致不同任务的损失差异较大, 导致:有些任务学的过快,有些任务学的过慢;简单的任务都已经过拟合了,困难的任务才开始有效果等等结果。 这时候,我们有必要干涉一下不同任务的优化力度,如:给不同任务设置超参,通过超参平衡不同任务的。 eg: 先给困难任务分配一个较大权重,简单任务分配一个较小权重,已使困难样本优化的更快,当困难任务和简单任务差不多平衡后再把两个的权重调整到平衡。 但这样有一个问题就是来回修改超参,繁

吉良的博客 7905

交货单冲销发货过账的正确姿势:用 VL09 与 ABAP 批量反冲 Goods Issue

摘要 本文详细解析了SAP系统中VL09事务码的技术实现与业务应用。VL09用于反冲发货的货物移动,通过标准冲销路径(移动类型602冲销601)确保单据链路一致、状态机正确回退和业务规则生效。文章对比了经典VL09与Fiori应用在不同SAP产品形态中的位置,并针对STO场景提供了ME23N验证方法。核心内容包括WS_REVERSE_GOODS_ISSUE函数模块的调用要点、必须COMMIT的原因(SAP LUW机制),以及处理Handling Unit等限制条件的注意事项。最后给出了将VL09工程化的项目

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 592

Hermes Agent 安装部署完全指南

Hermes Agent安装部署指南提供了两种安装方式:一键脚本安装和手动分步安装。该AI助手支持多平台运行(Linux/macOS/WSL2),核心功能仅需Git作为前置依赖,其他依赖如Python、Node.js等均由安装脚本自动处理。文档详细介绍了系统要求、依赖管理、配置目录结构、环境变量设置以及10个手动安装步骤,并提供了功能模块化选项,用户可根据需求选择安装语音交互、浏览器自动化等扩展功能。安装完成后可通过hermes doctor命令验证环境,并通过交互式向导完成初始化配置。

简简单单Onlinezuozuo 2623
上一篇: 【3D目标检测】2024综述: nuScenes上表现优异的经典/最新/单模态/多模态3D目标检测算法
下一篇: 【对比学习】正交阵/酉矩阵,对称矩阵/Hermite矩阵,正交相似对角化/奇异值分解的内在联系
斑斓GORGEOUS
博客等级 码龄5年 612粉丝 23原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值