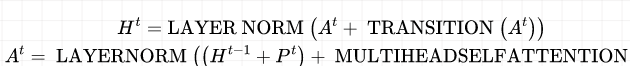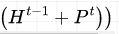Transformer家族简史(PART I)

视觉特征-自监督-同源不同crop视图一致性【2023-04】:DINOv2(无监督学习鲁棒视觉特征)【12 亿张互不重复的图像】【判别式自监督方法】【交叉熵损失+iBOT损失】 近期,自然语言处理领域在大量数据上进行模型 Pretraining 取得的突破,为计算机视觉中类似Foundation Model 的发展开辟了道路。这些模型能够生成通用视觉特征,即无需微调即可跨图像分布和任务发挥作用的特征,从而大幅简化图像在任何系统中的使用。本研究表明,现有的 Pretraining 方法,尤其是自监督方法,如果在来自多样化来源的充足精选数据上进行训练,便能够产生此类特征。我们重新审视了现有方法,并结合不同技术,从数据规模和模型规模两方面扩展我们的 Pretraining。 阅读详情

                                                                            Fly-AI竞赛服务平台 flyai.com

在开始学习之前推荐大家可以多在  FlyAI竞赛服务平台多参加训练和竞赛,以此来提升自己的能力。FlyAI是为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台。每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。 

 摘要: 经过之前一段时间的 NLP Big Bang,现在相对比较平静了,Transformer 派已经占据了绝对的主导地位,在各类应用中表现出色。看标题大家也可以猜个差不多,整理了一系列自《Attention is all you need》之后的对 Vanil ...

经过之前一段时间的 NLP Big Bang,现在相对比较平静了,Transformer 派已经占据了的主导地位,在各类应用中表现出色。看标题大家也可以猜个差不多,整理了一系列自《Attention is all you need》之后的对 Vanilla Transformer 的改进论文,和大家一起梳理整个发展过程。这篇是第一趴,都来自ICLR。


OK,来看看今天的 Transformers:

「 Bi-BloSAN

  from UTS,ICLR2018」

「 Universal Transformers

  from UVA&Google,ICLR2019」

「 Reformer

  from Google,ICLR2020」


BI-DIRECTIONAL BLOCK SELF-ATTENTION FOR FASTAND MEMORY-EFFICIENT SEQUENCE MODELING[1]

这篇论文首先分析了目前几大类特征抽取器 CNN、RNN、Attention 的优缺点,针对其不足提出了一种对 self-attention 的改进,「双向分块自注意力机制(bidirectional block self-attention (Bi-BloSA))」。


1.1 Masked Block Self-Attention

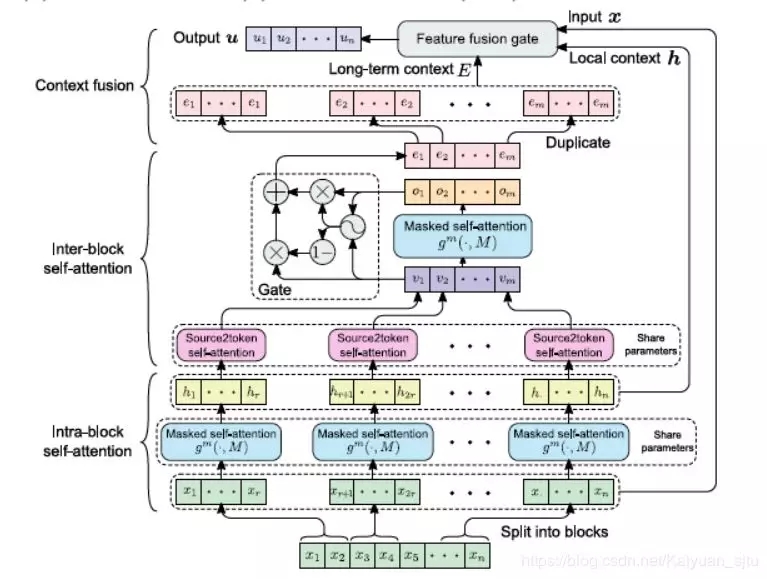
其最主要的组件是「掩码分块自注意力机制(masked block self-attention (mBloSA))」,基本思想是将序列分成几个等长的 block(必要时进行 padding),对每个单独的 block 内应用 self-attention(「intra-block SAN」)捕获局部特征,然后对所有 block 输出再应用 self-attention(「inter-block SAN」)捕获全局特征。这样,每个 attention 只需要处理较短的序列,与传统的 attention 相比可以节省大量的内存。最后通过 Context fusion 模块将块内 SAN、块间 SAN 与原始输入结合生成最终上下文表示。整体框架如下图所示:


1.2 Masked Self-Attention

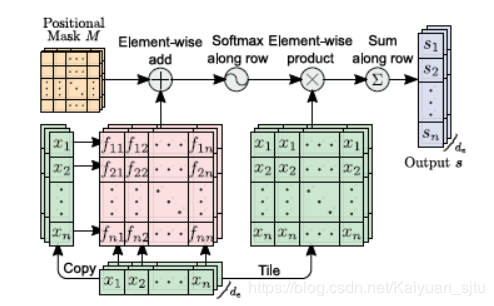
在传统的 self-attention 中时序信息是很难编码进去的,通过对某些位置进行掩码可以实现位置信息的融合,流程如下图。


1.3 Bi-directional Block Self-Aattention Network

最终将上述模块整合后得到的网络框架如下图。

实验工作也非常充分,在九大公开数据集的多类 NP 任务中取得 SOTA,同时模型的计算和内存更高效。


1.4 Reference

Code Here[2]

UNIVERSAL TRANSFORMERS[3]

上一篇论文针对的是 Transformer 内存占用大、对长序列输入不友好的缺陷,除此之外,这篇论文指出其还存在着以下几个问题:


丢弃了 RNN 的归纳偏置(Inductive Bias),而这对一些任务至关重要(EMNLP 2018[4]的一篇文章对比了 Transformer 和 LSTM 得出该结论)。Inductive Bias 也可以理解为「Prior Knowledge」,可以用来预测从未遇到的输入的输出,即模型泛化的能力。(refer:Inductive Bias in Recurrent Neural Networks[5])。


由于固定了 Transformer 的层数,使得模型计算低效。对于一个输入,有些部分是比较好理解的,有些部分是比较含糊不清的,如果采取相同的计算会导致无效计算。


原始 Transformer 是非图灵完备的。(这块没仔细看下面不会涉及)

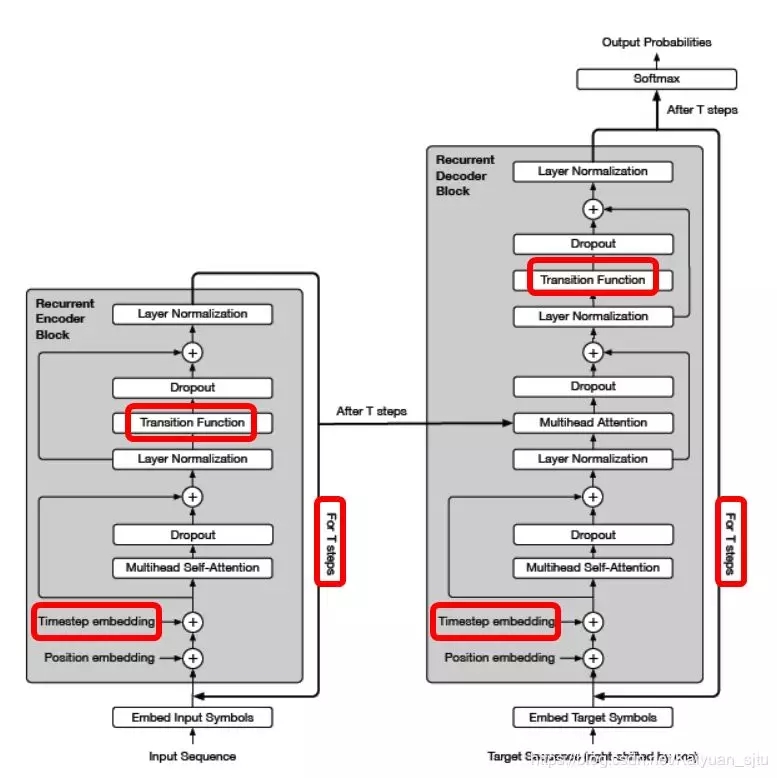
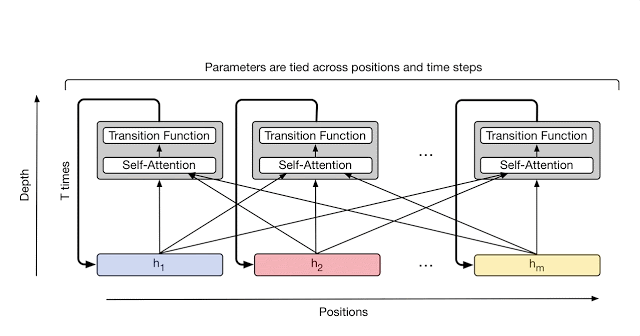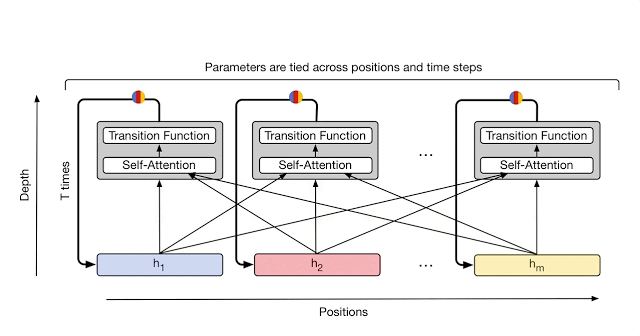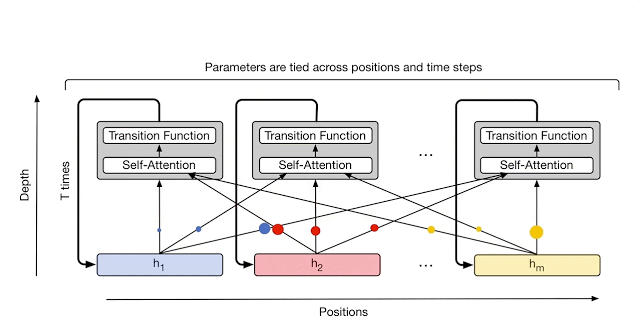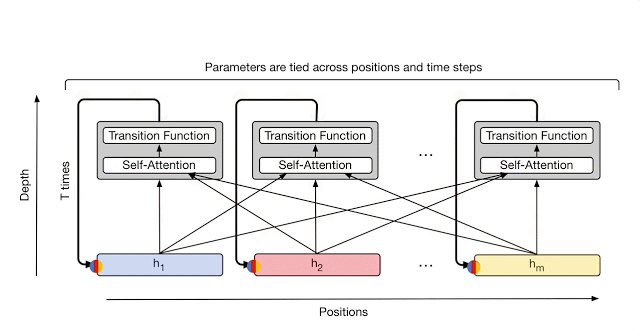
针对以上存在的不足,论文提出了一种 Transformer 的改进模型:「Universal Transformer(UT)」,如下图所示。乍一看与 Transformer 非常相似(不同的地方在下图用红框框起来会在下文介绍),下面我们来仔细看看 UT 是如何解决上述缺陷的。

2.1 Parallel-in-Time Recurrence Mechanism

原始的 Transformer 堆叠层数是固定的(6 层或 12 层),为了结合 RNN 的优势,对每一个 token 设置了一个 Transition Function(「参数共享」),并且可以一次一次循环迭代计算(Transformer 是对 attention 层后直接输入一个 Dense Layer)。如下图,横坐标是输入序列的 token,纵坐标是循环迭代次数 Depth。每一次迭代是在整个序列上进行的,不同于 RNN 需要从左往右依次计算,大大提高了计算效率。当迭代次数 Depth 人为固定时,就变成了原始 Transformer。


其中 Transition Function 可以是深度可分离卷积[6] 也可以是全连接。

2.2 Coodinate Embeddings

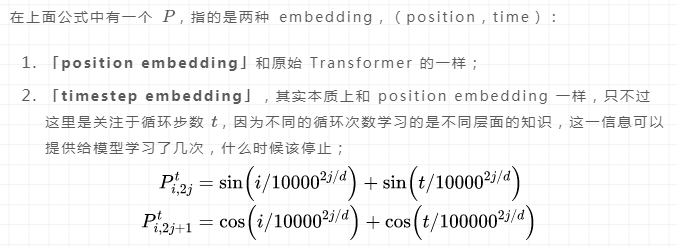
2.3 Dynamic Halting

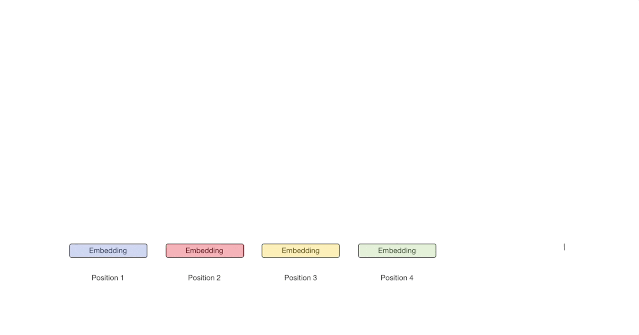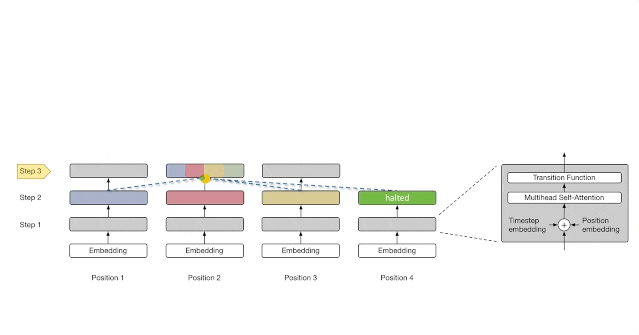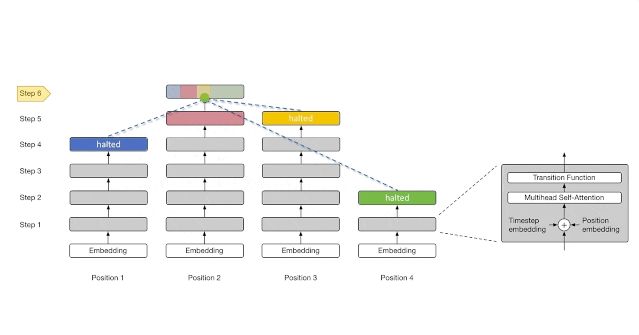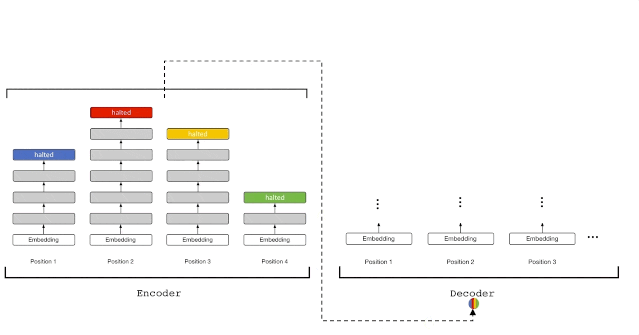
正如前面所说的,输入中的某些部分需要更多次的计算模型才可以理解。例如最常见的I went to the bank to deposit money里bank一词就需要更多次的运算。在 UT 中引入了Adaptive Computation Time (ACT)[7]来实现,ACT 可以基于模型在每步循环中预测的标量「halting probability」,动态调制处理每个输入 token 所需的计算步骤数(即响应时间「ponder time」)。UT 将动态 ACT 暂停机制分别应用于每个位置, 一旦特定的循环块停止,它将其状态复制到下一个步骤,直到所有块都停止,或者直到达到较大步数为止, 编码器的最终输出是以此方式产生的最后一层表示。Dynamic Halting 策略流程可以概括为:

在第  步循环时,有第  步的 halting probability、第  步的 token state 以及提前设置的超参停止阈值;

利用 UT 计算当前 token state;

利用全连接层和 sigmoid 激活函数计算 ponder time,ponder time 表示模型对每个 token 还需要多少次运算的预测;

判断每个 token 当前是否需要停止,规则为:当 (halting probability + pondering) > halt threshold 时,停止;

当 (halting probability + pondering) ≤ halt threshold 时,继续运算;

对于那些仍然在运算的 token,更新停止概率:halting probability += pondering;

当所有位置都停止或者模型达到循环较大步数时,结束。

整体流程如下面动图所示。


2.4 Reference

Code Here[8]

Moving Beyond Translation with the Universal Transformer[9]


REFORMER: THE EFFICIENT TRANSFORMER[10]

传统的 Transformer 仍然存在着一些问题,比如内存占用大、计算复杂度大、无法较好处理长文本等。针对以上不足,本文作者提出了一种更为高效的 Transformer,该方法的主要目标是能够处理更长的上下文窗口,同时减少计算量和提高内存效率,具体做法如下:

使用可逆层(reversible layers),在训练过程中只存储单层激活值,而不是 N 次;

将 FF 层中的激活进行切分并分块处理


3.1 关于注意力机制

Scaled Dot-Product Attention

Transformer 中最关键的部分就是其注意力机制,原始自注意力机制通过三个不同的映射矩阵将输入表示为 Q、K、V 三部分,然后计算下式:


Locality-Sensitive Hashing Attention

LSH attention 使用的是共享 Q、K 策略,这样可以有效降低内存占用,并且下图实验显示共享策略并不会比原始策略效果差。


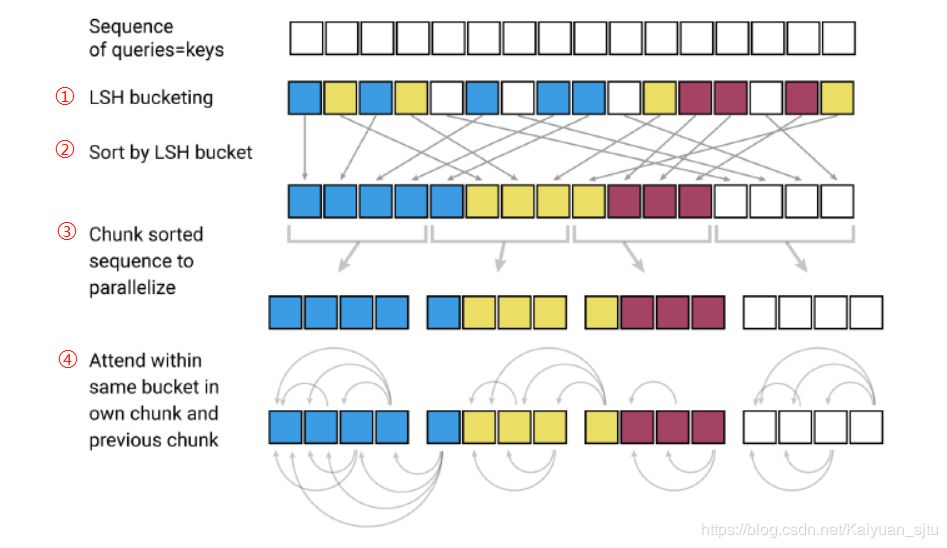
最终 LSH Attention 的整体流程如下所示,① 局部敏感哈希分桶,不同的颜色代表不同的桶,相同的颜色代表相近的向量;② 序列重排,将具有相同颜色的向量放在一起;③ 切分序列,方便并行化计算;④ 在分出来的更小的区块中应用 attention,为了防止溢出向量,会考虑前一个 chunk 中的元素进行 attention

3.2 关于内存

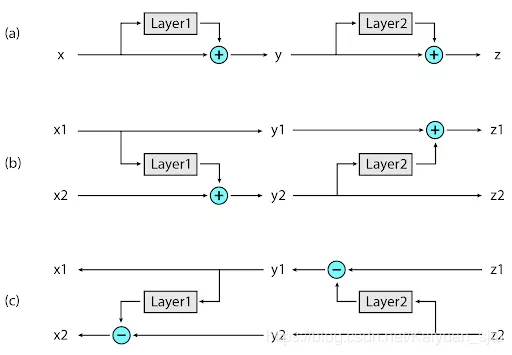
虽然通过 LSH 策略降低了 attention 的复杂度,但是由于模型通常包含好多层,导致在训练过程中保存的中间值数量也非常巨大。为此,Reformer 使用了可逆 Transformer,不在内存中保存所有的值,而是在反向传播时按需计算得出,思想借鉴于RevNet[13]的可逆层。


明白了上述思想,在 Reformer 中就是将 Attention 层和 FeedForward 层带入 F 和 G 即可。


3.3 reference

Code Here[14]

Reformer 应用[15]

Reformer: The Efficient Transformer[16]

Reddit 上关于 Reformer 的讨论[17]

本来还打算再加上 Transformer-XL 的,啊太长了就算了吧....


本文参考资料

[1]

BI-DIRECTIONAL BLOCK SELF-ATTENTION FOR FASTAND MEMORY-EFFICIENT SEQUENCE MODELING: https://arxiv.org/abs/1804.00857

[2]

Code Here: https://github.com/taoshen58/BiBloSA

[3]

UNIVERSAL TRANSFORMERS: https://arxiv.org/abs/1807.03819

[4]

EMNLP 2018: http://xxx.itp.ac.cn/abs/1803.03585

[5]

nductive Bias in Recurrent Neural Networks: https://link.springer.com/chapter/10.1007/3-540-45720-8_39

[6]

深度可分离卷积: https://arxiv.org/abs/1610.02357

[7]

Adaptive Computation Time (ACT): https://arxiv.org/abs/1603.08983

[8]

Code Here: https://github.com/tensorflow/tensor2tensor/blob/master/tensor2tensor/models/research/universal_transformer.py

[9]

Moving Beyond Translation with the Universal Transformer: https://ai.googleblog.com/2018/08/moving-beyond-translation-with.html

[10]

REFORMER: THE EFFICIENT TRANSFORMER: https://openreview.net/forum?id=rkgNKkHtvB

[11]

「illustrated-transformer」: https://jalammar.github.io/illustrated-transformer/

[12]

「illustrated-self-attention」: https://towardsdatascience.com/illustrated-self-attention-2d627e33b20a

[13]

RevNet: http://xxx.itp.ac.cn/abs/1707.04585

[14]

Code Here: https://github.com/google/trax/tree/master/trax/models/reformer

[15]

Reformer 应用: https://colab.research.google.com/github/google/trax/blob/master/trax/models/reformer/image_generation.ipynb

[16]

Reformer: The Efficient Transformer: https://ai.googleblog.com/2020/01/reformer-efficient-transformer.html

[17]

Reddit 上关于 Reformer 的讨论: https://www.reddit.com/r/MachineLearning/comments/eg1wr3/reformer_the_efficient_transformer_anonymous_et/fc8um57/

更多深度学习竞赛项目,大家可移步官网进行查看和参赛!

更多精彩内容请访问FlyAI-AI竞赛服务平台;为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台;每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。

挑战者,都在FlyAI!!!

LangChain文档切分实战:4种核心TextSplitter选型与调优指南 文档切分是RAG系统中连接原始数据与大语言模型的关键预处理环节,其本质是保障语义完整性前提下的上下文窗口适配。原理上需兼顾chunk_size(影响模型token承载)、chunk_overlap(缓解边界信息丢失)及分隔符策略(决定语义断点位置)。技术价值在于显著提升知识库检索准确率、问答连贯性与代码理解鲁棒性。典型应用场景包括PDF白皮书结构化入库、医疗指南问答、API文档智能检索及Python代码助手构建。本文聚焦LangChain生态中CharacterTextSplitter、RecursiveC 阅读详情

相关推荐

从字符嵌入到语言建模:手写三元组MLP实现名字生成

语言建模是自然语言处理的基础任务,其核心在于学习字符或词元间的概率依赖关系。传统n-gram方法受限于维数灾难与数据稀疏性,难以捕捉长程语义模式;而神经语言模型通过可学习的嵌入层将离散符号映射为连续向量,在低维空间中隐式编码发音、语法和统计规律。这种向量化表征不仅支撑了现代大语言模型的底层架构,更在名字生成、拼写纠错、文本补全等轻量级场景中展现出强解释性与工程可控性。本文聚焦字符级建模,以三元组输入、双层MLP与2维可视化嵌入为切入点,完整呈现从数据构造、张量操作到损失优化的端到端实现过程,帮助读者建立对嵌

weixin_34200628的博客 344

Transformer工程落地实战:小模型+强工程破局内存、数据与业务三重约束

Transformer作为现代NLP核心架构,其本质是基于自注意力机制建模长程依赖的深度神经网络;原理上通过Query-Key-Value交互实现上下文感知的动态权重分配,技术价值在于摆脱RNN/CNN的序列局限,支持并行训练与灵活迁移。在真实工业场景中,它常面临内存受限(如2GB边缘设备)、标注稀缺(<500条样本)和目标错位(业务关注投诉率而非F1)等挑战。本文聚焦Transformer轻量化部署、弱监督微调与业务目标对齐三大关键路径,结合电商纠错、工业日志、法律合同及小语种医疗四大fabulous应用

weixin_34268753的博客 432

基于KNN与TensorFlow的可落地电影推荐系统

推荐系统是信息过载时代的关键技术,其核心在于利用用户行为数据建模偏好关系。协同过滤作为最基础且实用的范式,以用户-物品交互矩阵为输入,通过相似度计算实现个性化预测。其中,近邻算法(Nearest Neighbours)因其可解释性强、冷启动友好、工程轻量等优势,在影视类垂直场景中具备独特价值。结合TensorFlow这一工业级数值计算框架,不仅能实现GPU加速的实时相似度检索,还可导出标准化SavedModel,无缝对接线上服务。本文聚焦Movie Recommendation任务,详解如何用User-Ba

weixin_30315905的博客 461

Transformer发展历程 Decoder输出特征利用DCT解码投分割

作为在自然语言处理(NLP)领域应用广泛的深度学习模型,Transformer 近两年强势来袭,不仅横扫 NLP 领域,而且在 CV 上也锋芒毕露。江湖传言,Transformer 架构就像是绝世高手的武林秘籍,得秘籍者得天下!最初的 Transformer 来自于 NLP,它的出现将 NLP 领域向前推动了一大步。其中的关键要素就是Transformer 具备:超强的序列建模能力、全局信息感知能力。得益于这两点优势,Transformer 几乎取代了基于 RNN 的算法在 NLP 中的地位,也被引入到CV

m0_51339444的博客 5961

深度解析:从概念到变革——Transformer大模型的前世今生以及大模型预备知识讲解[知存科技]

深度解析:从概念到变革——Transformer大模型的前世今生以及大模型预备知识讲解[知存科技]

丨汀、的博客 3176

Python使用netmiko配置华为交换机

1.netmiko就是专门为网络设备做的模块,非常强大。1.更适合网络设备的自动化运维模块。2、批量配置变更、备份。1.安装netmiko。2. 创建SSH连接。一、netmiko介绍。

博然的宝藏库 2797

TR1 - Transformer起源与发展

自监督学习(Self-supervised Learning)是一种机器学习方法,其特点在于从数据本身自动生成标签或监督信号,无需人工标注。简单来说就是让机器利用数据本身的结构或特征来进行学习,从而不依赖于外部标签或监督信号。

Loser 1669

保姆级教程:用Ubuntu 22.04搭建RustDesk中继服务器(含Cloudflare避坑指南)

本教程详细指导如何在Ubuntu 22.04上搭建RustDesk中继服务器,解决跨国远程协作的延迟问题。涵盖环境配置、Rust编译优化、服务部署及Cloudflare代理设置等关键步骤,帮助用户实现高性能的私有中继服务。

weixin_29002209的博客 527

Transformer架构的演进之路探究

在2017年的开创性论文《Attention is All You Need(注意力就是你所需要的一切)》中,Vaswani等人提出了Transformer架构,这不仅在语音识别领域引起了一场革命,也对其他多个领域产生了深远的影响。本文将探讨Transformer架构的发展历程,从其最初的设计到当前的先进模型,并重点介绍这一过程中取得的关键性进展。

2401_85379281的博客 2945

grpc安装与简单demo测试

grpc安装: 由于工作需要,最近在学google的rpc开源框架;由于本人菜鸟一枚,而且是从Windows开发转到Linux;由于之前版本控制使用的是svn,没有使用过git,所以从GitHub上下载代码是通过浏览器下载zip格式的压缩文件,折腾了好几天了,发现了各种坑,各种缺少库,各种不知道怎么把这个库给装机器上。对于一个不熟悉Linux的人来说,这个体验简直糟糕透了。没办法了又在机器上装了...

old__captain的博客 4833

STC51单片机串口多字节数据接收的优化策略

本文深入探讨了STC51单片机串口多字节数据接收的优化策略。针对数据丢包、粘包等常见痛点,核心思路是采用“缓冲队列+定时器超时”模式,将实时处理转变为“先收纳,后处理”。文章详细讲解了硬件初始化、中断服务程序优化(快速入队与激活超时裁判)以及主循环的非阻塞设计,并进阶介绍了环形缓冲区实现与错误处理,旨在构建稳定可靠的串口通信系统。

weixin_29264201的博客 374

【LLM】2:Transformer底层算法原理

transformer架构的原理

zzZ_CMing的博客 1983

保姆级教程:在阿里云ECS上用Docker一键部署EMQX MQTT服务器(Ubuntu 20.04)

本文提供在阿里云ECS上使用Docker一键部署EMQX MQTT服务器的详细教程,涵盖从实例创建、Docker环境配置到EMQX部署与优化的全流程。适合物联网开发者快速搭建高效、安全的MQTT消息服务器,适用于智能家居、工业物联网等场景。

weixin_28739079的博客 308

Transformer家族简史(PART II)

Fly-AI竞赛服务平台 flyai.com 在开始学习之前推荐大家可以多在FlyAI竞赛服务平台多参加训练和竞赛,以此来提升自己的能力。FlyAI是为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台。每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。 摘要: Transformer 不同 head 所关注的序列...

iFlyAI的博客 619

《AgentScope-Java 深入浅出教程》第10章 RAG 知识检索

RAG(Retrieval-Augmented Generation,检索增强生成)是一种将信息检索与文本生成相结合的技术架构。它通过从外部知识库中检索相关文档,将检索到的信息作为上下文注入到语言模型的提示中,从而增强模型的回答质量。│ RAG 工作流程 ││ ││ 用户问题 向量检索 上下文增强 生成回答 ││ ▼ ││ │ A │ ││ ││ 1. 接收问题 ││ 2. 将问题转换为向量,在知识库中检索相似文档 ││ 3. 将检索到的文档作为上下文添加到提示词中 │。

步子哥的博客 462

把财务与管理会计装进一张表:读懂 S/4HANA 的 ACDOCA

别慌,这反而是设计所需。只是大量历史上为汇总、加速而建的索引与汇总表被淘汰或改造,很多被兼容视图 compatibility views 替代,通过视图去 ACDOCA 或 ACDOCT 取数,从而保证老代码还能 SELECT 到数据,但失去写权限。它把原来分散在多张表里的信息整合到一起,例如总账、固定资产、物料账、盈利能力分析 CO-PA、成本控制等维度,发布过的资料多次强调这一点。其二,查询必须带上高选择性的条件,尤其是 RLDNR、RBUKRS、GJAHR 这三个维度,能大幅降低列存扫描的代价。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 948

一文带你了解HuggingFace Transformer 理论基础,Transformer 实战,十万字精读

在 Hugging Face 的库中,Pipeline(流水线)是最高层、最易用的推理 API。如果把直接调用 PyTorch 底层代码比作“驾驶手动挡赛车”(需要精细控制离合、油门和换挡),那么 Pipeline 就是一辆开箱即用的“全自动无人驾驶汽车”。你只需要输入目的地(文本),它就能直接把你送到终点(预测结果)。你不需要知道到底该用 BERT 还是 T5。你只需要告诉 Pipeline 你的任务目标文本生成、翻译、问答、图像分类),它就会自动为你匹配一套默认的最佳预训练模型和分词器。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 553

【ArcGIS Pro微课1000例】0023:ArcGIS Pro 3.0中打开GeoPackage数据库(.gpkg)

本文讲解ArcGIS Pro 3.0中打开GeoPackage数据库(.gpkg)的两种方法。

智慧空间实验室 4644

VQGAN【视觉码本】:以感知压缩和对抗训练学习离散视觉词元,融合CNN局部归纳偏置与Transformer长程依赖建模,通过自回归预测视觉组成,用滑动注意力窗口实现条件控制与百万像素级图像生成

德国海德堡大学 IWR 图像处理协作实验室*Both authors contributed equally to this work*两位作者对本工作贡献相同 Figure 1: Figure 1. Our approach enables transformers to synthesize high-resolution images like this one, which contains 1280×460 pixels. 图 1:图 1。我们的方法使 Transformer 能够合成像这样的高分

u013250861的博客 66

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

NewBeeNLP 年中 | From NewBee To NB

哈喽大家好,这里是NewBeeNLP。今天趁着端午休假,归类梳理了下之前的原创文章,不知道你是从哪篇文章开始关注的呢????非常感谢一年多来的喜欢和支持,不管是入门小白还是行业老司机,希...

Kaiyuan_sjtu的博客 948

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

高性能AI视频生成架构设计与实现:基于FramePack Studio的技术演进路线

FramePack Studio作为基于扩散模型的AI视频生成工具,通过创新的Transformer 3D架构和动态内存管理机制,实现了从文本到高质量视频的端到端生成流程。本文深入分析其技术架构演进路径,探讨分布式推理、模型优化和实时渲染等核心技术实现方案,为AI视频生成领域的技术实践提供参考。 ## 技术愿景:构建下一代智能视频创作平台 FramePack Studio的核心技术愿景是打造一

gitblog_00566的博客 392

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Gemini API深度解析:多模态原生架构与企业级AI集成范式

大模型API已从简单接口调用迈入‘能力交付’新阶段。本文围绕多模态原生架构、细粒度工具调用控制、跨尺度推理调度三大核心技术,解析如何将AI真正嵌入业务逻辑流——不再依赖人工拼接OCR+LLM,也不再靠提示词约束函数调用,而是通过声明式意图表达、运行时沙箱验证与动态模型编排,实现高确定性、低运维成本的AI服务集成。面向后端架构师与SaaS技术负责人,覆盖金融投顾、设备预测性维护、跨境电商客服等典型场景,兼顾工程落地细节与成本优化策略。

aodan5477的博客 402

专业 英语

计算机、数学、机械等专业的专业英语词汇

Edward2022的博客 2949

ESP32-P4上运行1.8亿参数离线LLM与Agent推理的技术解析

大语言模型(LLM)通常被认为需要云端GPU集群才能运行,但随着模型量化与边缘计算的发展,在微控制器(MCU)上实现离线AI推理已成为现实。本文以ESP32-P4开发板为例,探讨如何将1.8亿参数的LLM与Agent系统完全离线部署。硬件上依靠大容量Flash和PSRAM,软件上通过INT4量化将模型压缩至约90MB,并利用权重流式读取、KV Cache优化生成效率。该方案适用于工业设备、智能家居等隐私敏感且网络不稳定的场景,展示了小型模型在受限环境下的Agent工具调用闭环能力。它打破了“大模型必须上云”

weixin_33937913的博客 427

# TTS 架构的六代演进(三):第 3 代 · 神经网络两段式 TTS

本篇是「TTS 架构的六代演进」系列第 3 篇。第 3 代 (2016-2020) 是神经网络 TTS 的起点——Gen 2 的 SPSS(HMM + GMM + MLPG + WORLD)整套统计+DSP 流水线,并首次用作为声学模型和声码器之间的中间接口。(Shen et al., 2018)——第一次让合成语音的主观分逼近真人。——文本变音素 ID,神经声学模型端到端预测 mel 谱,神经声码器再从 mel 生成波形。

AI 音频小牛的博客 576

Python统计检验选择指南:从数据类型到检验决策的全链路实战

统计检验是数据分析中连接数据特征与业务结论的关键桥梁。理解变量类型(定类/定序/定距)、验证分布前提(正态性、方差齐性)、匹配研究设计(独立/配对/单样本)是正确选择检验方法的基础原理。忽视这些环节极易导致p值失真、效应误判甚至结论反转。本文聚焦Python工程实践,系统拆解卡方检验、t检验、Mann-Whitney U等核心方法的适用边界与scipy实现细节,特别强调检验选择逻辑和数据前提验证两大高频痛点,覆盖AB测试、转化率分析、用户行为对比等典型业务场景,助力分析师将统计学转化为可复用、可解释、可落地

weixin_30919571的博客 367
上一篇: 手把手教你用 Python Pandas,Keras ,Flask ,Docker和 Heroku 部署机器学习模型(附代码)
下一篇: Transformer家族简史(PART II)
iFlyAI
博客等级 码龄9年 238粉丝 134原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值