Transformer家族简史(PART II)

论文阅读——Self-Attention with Relative Position Representations Self-Attention with Relative Position Representations Abstract 2017年Vaswani等人提出的Transformer需要在输入中添加绝对位置表示。作者在这篇文章中提出将元素与元素之间的相对位置表示引入了self-attention机制,在两个机器翻译(WMT 2014 EN-DE and EN-FR)的任务中,引入相对位置表示的self-attention比绝对位置编码的self-attention有明显的提升。但相对与绝对结合并不会进一步提 阅读详情

                                                                            Fly-AI竞赛服务平台 flyai.com

在开始学习之前推荐大家可以多在   FlyAI竞赛服务平台多参加训练和竞赛,以此来提升自己的能力。FlyAI是为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台。每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。 

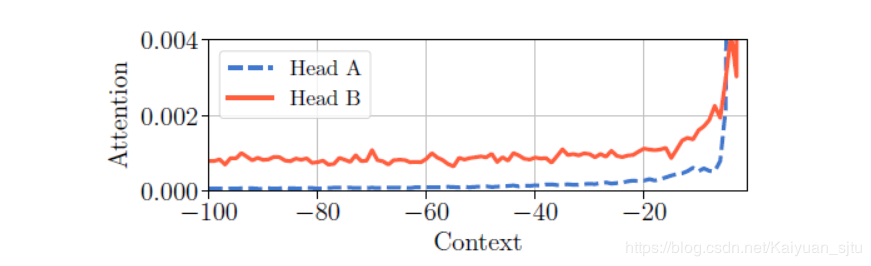
 摘要: Transformer 不同 head 所关注的序列长度 span 是不一样的,一些 head(如 Head A)重点关注附近较短的信息,而另外一些 head(如 Head B)则关注在范围更大的全文。如果能在训练中利用这一特性,就可以显著减少计算 ...

继 Transformer家族简史(PART I),PART II整理了三篇来自Facebook AI Research的论文,都比较好读:

「Span Transformer from FAIR,ACL2019」

「All-Attention from FAIR」

「PKM from FAIR,NeurIPS2019」


Adaptive Attention Span in Transformers[1]

这篇论文的重点是改进 Transformer 的计算效率,vanilla transformer 每个 attention head 处理的是等长的所有输入序列,但是在实验中发现 Transformer 不同 head 所关注的序列长度 span 是不一样的,一些 head(如 Head A)重点关注附近较短的信息,而另外一些 head(如 Head B)则关注在范围更大的全文。如果能在训练中利用这一特性,就可以显著减少计算时间和内存占用,因为两者都依赖于注意力范围的长度。

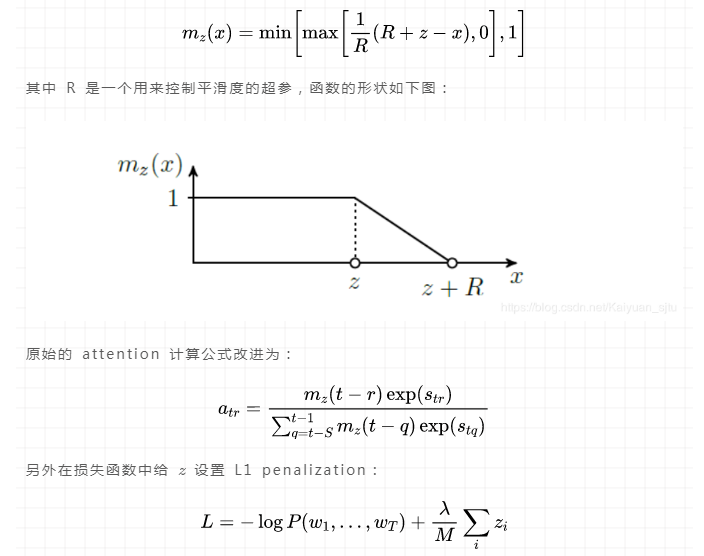
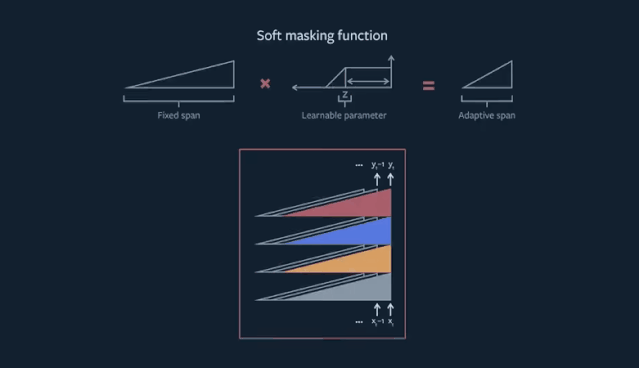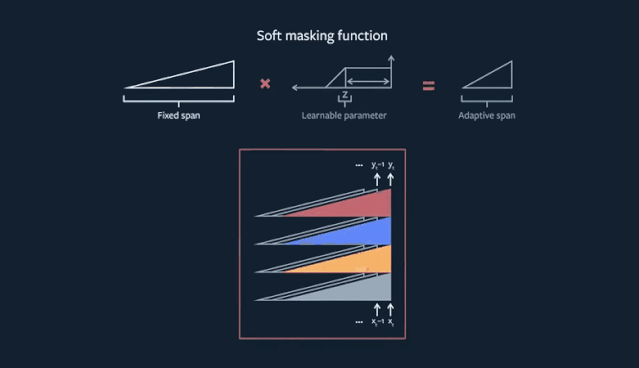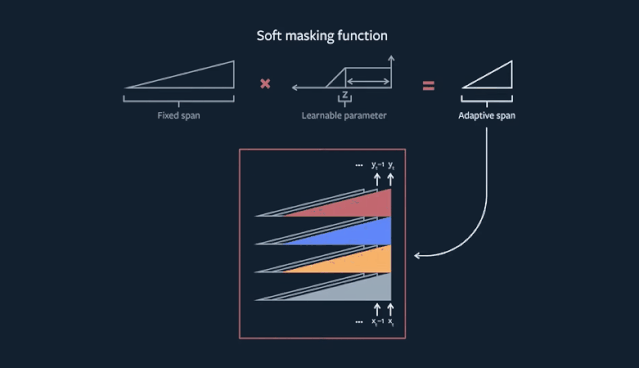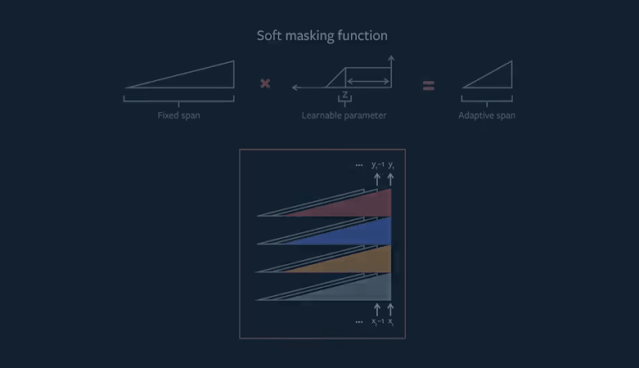
为此,作者提出一种「adaptive attention span」,可以让模型自适应地选择上下文长度进行处理。但是,attention span 的值是整数,因此是不可微的,不能像模型的其他参数那样通过反向传导直接学习它,于是通过 soft-masking function 来将其值转化为连续值。masking 函数是非递增的,将跨度距离映射到[0,1]之间的值。这样,将 masking 函数应用到每一个 attention head 之后,就可以实现 attention span 的自适应控制。具体公式如下:


整体过程如下动图,

此外,考虑了一种扩展「dynamic attention span」,根据输入动态调整 attention span;

在实现中,引用了Self-attention with relative position representations[2]和Transformer-XL[3]中的技巧;

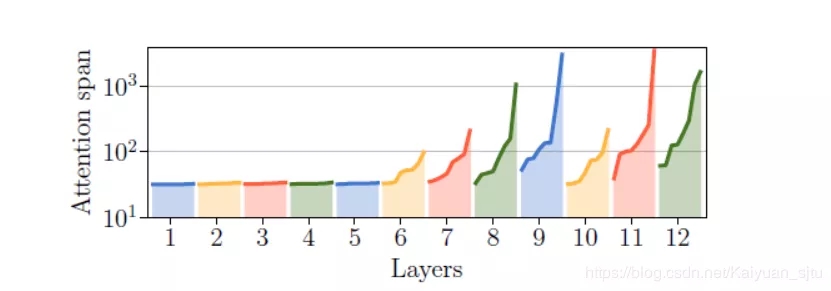
实验结果显示在 12 层模型中,较低层的 attention span 较短,高层(8-12 层)的 attention span 较长

Reference

Code Here[4]

Making Transformer networks simpler and more efficient[5]

Adaptive Attention Span in Transformers 分享视频[6]


Augmenting Self-attention with Persistent Memory[7]

当我们在讨论 Transformer 时,重点都在 self-attention 上,但是不要忘了网络中还有另外一层:前馈层 FFN,其包含了模型中最多的参数,大小通常是其他组件的四倍。FNN 的计算代价如此之高,那么有没有办法将模型简化呢?论文中提出将 FFN layer 替换为 attention layer,在不损失模型性能的前提下将模型结构大大简化。


2.1 FFN --> Attention

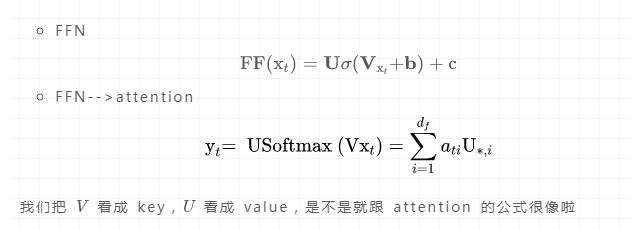
虽然表面上 FFN 和 attention 层看起来完全不同,但是通过将 FFN 中的 RELU 激活换成 Softmax 函数就可以将激活值转化为 attention weight。


2.2 All-attention

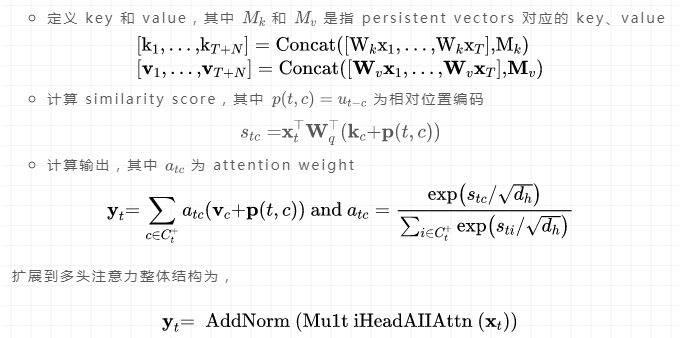
把 FFN 转化为 attention 之后就可以将原来的两层合并为一层,称为「all-attention layer」。

具体做法就是额外定义一组 key-value 向量对,称为「persistent vectors」,这些向量就和前馈子层的权值是一样的:固定的、可训练的且上下文无关的,可以捕获关于任务的 general knowledge。

2.3 Other tricks

relative position embedding & catching mechanism[8]

adaptive attention span[9]

adaptive softmax[10]

实验结果验证了FFN层和persistent vector的重要性,缺少的话效果非常差。每一层persistent vector的数量在N=1024时已经达到比较好的效果。


2.4 reference

Code Here(没找到 - -)

Making Transformer networks simpler and more efficient[11]

Open Review[12]


Large Memory Layers with Product Keys[13]

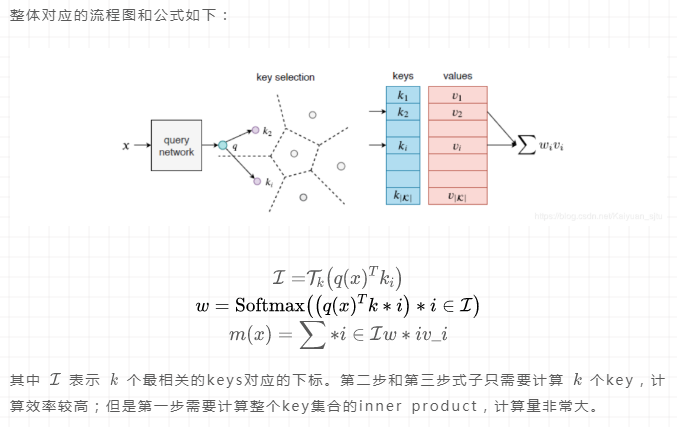
同样来自FAIR的工作,解决的痛点:更好的模型性能——>更大的模型capacity——>更大的计算成本。提出了一种structured memory,在明显增加模型capacity的同时计算成本的增加可以忽略不计,而且是简单可插拔式设计,下图是文中将vanilla transformer中的(部分)FFN层替换为memory layer的示例。

3.1 Overall Structure

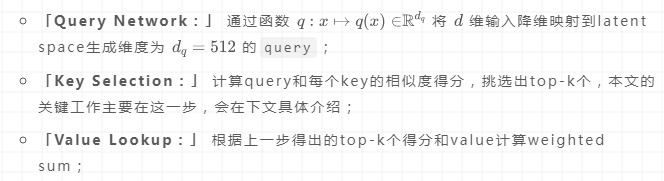
来看整体的设计,包含了三个部分:

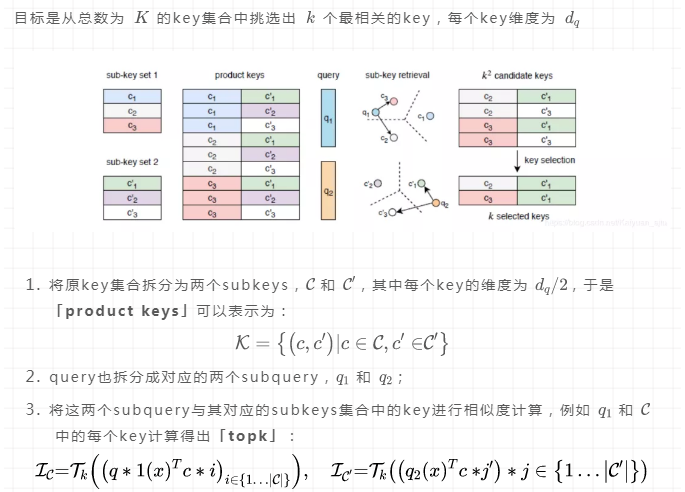
3.2 Product Keys

对上述公式第一步进行优化,思想来源于**product quantization**[14],


Product quantization,乘积量化,这里的乘积是指笛卡尔积(Cartesian product),意思是指把原来的向量空间分解为若干个低维向量空间的笛卡尔积,并对分解得到的低维向量空间分别做量化(quantization)。这样每个向量就能由多个低维空间的量化组合表示。

3.3

所有存储器参数都是可训练的,但是在训练时对于每个输入仅更新了少数( 个)memory slots;

实验显示,模型增加内存比增加网络层数对效果提升更有效(12层+单内存的模型>24层无内存的模型);

在query network配合使用「Batch Normalization」效果更佳;

memory layer放置的较佳位置为模型网络的中间层;


3.4 reference

Code Here[15]

LeCun力荐:Facebook推出十亿参数超大容量存储器[16]

Over,以及预告马上会有的PART III。


本文参考资料

[1]

Adaptive Attention Span in Transformers: https://www.aclweb.org/anthology/P19-1032/

[2]

Self-attention with relative position representations: http://xxx.itp.ac.cn/pdf/1803.02155.pdf

[3]

Transformer-XL: http://xxx.itp.ac.cn/pdf/1803.02155.pdf

[4]

Code Here: https://github.com/facebookresearch/adaptive-span

[5]

Making Transformer networks simpler and more efficient: https://ai.facebook.com/blog/making-transformer-networks-simpler-and-more-efficient/

[6]

Adaptive Attention Span in Transformers分享视频: https://vimeo.com/384007585

[7]

Augmenting Self-attention with Persistent Memory: https://arxiv.org/abs/1907.01470

[8]

relative position embedding & catching mechanism: https://arxiv.org/abs/1901.02860

[9]

adaptive attention span: https://arxiv.org/abs/1905.07799

[10]

adaptive softmax: https://arxiv.org/pdf/1609.04309

[11]

Making Transformer networks simpler and more efficient: https://ai.facebook.com/blog/making-transformer-networks-simpler-and-more-efficient/

[12]

Open Review: https://openreview.net/forum?id=HklJdaNYPH

[13]

Large Memory Layers with Product Keys: https://arxiv.org/abs/1907.05242

[14]

「product quantization」: http://vividfree.github.io/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0/2017/08/05/understanding-product-quantization

[15]

Code Here: https://github.com/facebookresearch/XLM

[16]

LeCun力荐:Facebook推出十亿参数超大容量存储器: https://dwz.cn/td8uuM7v

更多深度学习竞赛项目,大家可移步官网进行查看和参赛!

更多精彩内容请访问FlyAI-AI竞赛服务平台;为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台;每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。

挑战者,都在FlyAI!!!

 

【论文笔记】Self-Attention with Relative Position Representations 本文则是从Self-Attention机制内部出发,通过在计算过程中引入token之间的相对位置关系向量,打破了Self-Attention机制的Permutation-Invariant特性,从而更高效地完成了位置信息的编码,性能得到了提升。本文扩展自注意力以考虑输入元素之间的成对关系,从这个意义上讲,就是将输入建模为标记的(labeled),有向的( directed),完全连接的图( fully-connected graph)。的表示,将输入元素之间的edge表示为。个唯一的edge标签。 阅读详情

相关推荐

视觉特征-自监督-同源不同crop视图一致性【2025-08】:DINOv3【DINOv2+Gram损失=DINO损失+(iBOT损失+Gram损失)+KoLeo正则化损失】

自监督学习有望消除手动数据标注的必要性,从而使模型能够轻松处理大规模数据集以及更复杂的架构。由于无需针对特定任务或领域进行定制,这种训练方式能够利用单一算法从各种来源获取视觉表征,这些来源包括自然图像和航空图像等。本技术报告介绍了 DINOv3,它通过简单而有效的策略,为实现这一目标迈出了重要一步。首先,我们通过精心设计数据准备流程并进行优化,从而提升数据集与模型规模的扩展能力;其次,我们提出了一种名为“Gram 锚定”的新方法,该方法有效解决了在长时间训练过程中特征图质量会下降这一长期存在的难题。

u013250861的博客 353

Transformer的前世今生

引言 Transformer在今天已经非常火了, 不管是NLP, 还是CV, 效果表现均很好. 那么这是Transformer到底是什么呢? 要把Transformer的来龙去脉讲清楚, 首先得从attention开始, attention刚出来时, 直接把Google翻译送上了人生巅峰. 在Transformer的出现之前的NLP相比CV来说并不那么活跃, 同时难度相对也比较大, 用得最多的也就是LSTM那一套, 不可能像CV那样模型可迁移性很强. 而Transformer的出现后, 简直把N

thy_2014的专栏 5813

视觉特征-自监督-同源不同crop视图一致性【2023-04】:DINOv2(无监督学习鲁棒视觉特征)【12 亿张互不重复的图像】【判别式自监督方法】【交叉熵损失+iBOT损失】

近期,自然语言处理领域在大量数据上进行模型 Pretraining 取得的突破,为计算机视觉中类似Foundation Model 的发展开辟了道路。这些模型能够生成通用视觉特征,即无需微调即可跨图像分布和任务发挥作用的特征,从而大幅简化图像在任何系统中的使用。本研究表明,现有的 Pretraining 方法,尤其是自监督方法,如果在来自多样化来源的充足精选数据上进行训练,便能够产生此类特征。我们重新审视了现有方法,并结合不同技术,从数据规模和模型规模两方面扩展我们的 Pretraining。

u013250861的博客 369

2018-Self-Attention with Relative Position Representations

文章目录1. Title2. Summary3. Problem Statement4. Method(s)4.1 Relation-aware Self-Attention4.2 Relative Position Representation4.3 Efficient Implementation5. Evaluation6. Conclusion 1. Title Self-Attention with Relative Position Representations https://github.

小毛激励我好好学习的博客 1347

X-former系列(Transformer大家族)

Transformer提出大致时间线:注意力机制:理想情况下,():可区别位置关系但无法区别前后关系():不同位置随机初始化可学习参数编码绝对位置编码展开:一个基于局部敏感哈希(LSH)的注意力模型,引入了可逆的Transformer层,有助于进一步减少内存占用量。模型的关键思想,是附近的向量应获得相似的哈希值,而远距离的向量则不应获得相似的哈希值,因此被称为“局部敏感”。这个模型通过使用基于核的自注意力机制、和矩阵产品的关联特性,将自注意力的复杂性从二次降低为线性。

noobiee的博客 2536

【信息科学与工程学】计算机科学与自动化——第八十四篇 C++分布式软件高并发/高可用算法01

4. 提交:协调者选择提交时间戳(>所有读时间戳),两阶段提交:a) 写意图预提交到所有参与者,b) 参与者持久化后确认,c) 协调者决定提交,异步清理意图。:客户端请求发送到协调节点,协调节点根据路由转发到主分片所在节点。Span有父子关系。1. 索引文档:客户端发送PUT请求到协调节点,协调节点路由到主分片节点,主分片写入本地,然后并行复制到副本分片,等待确认后响应客户端。3. 搜索:客户端发送搜索请求到协调节点,协调节点广播到所有相关分片,每个分片执行查询,返回结果,协调节点合并、排序、分页后返回。

weixin_49199313的博客 1080

【Transformer】Self-Attention with Relative Position Representations及实现pytorch代码

在Transformer中加入可训练的embedding编码,使得output representation可以表征inputs的时序/位置信息。这些embedding vectors在计算输入序列中的任意两个单词i,j之间的key和value是被加入其中。embedding vector用于表示单词i,j之间的距离,因此命名为“相对位置表征”(Relative Postiion Representation)。 Self-Attention 输入序列xi经过Self-Attention之后输...

qq_40731332的博客 2153

【信息科学与工程学】【数据中心】第三十五篇 云计算数据中心的学科知识04

编号学科(课程)核心知识点在云计算/云存储/云网络/云安全/云MaaS中的作用代表教材/资料/论文 + 数学方程式列表工业界应用D1421​云原生数据库:TiDB​HTAP(混合事务/分析处理)、分布式SQL、水平扩展、强一致(Raft)、自动故障恢复、与MySQL兼容、TiFlash列式引擎提供弹性扩展的分布式数据库;支撑高并发在线交易与实时分析教材:《TiDB in Action》PingCAP(2020) 论文:《TiDB: A Raft-based HTAP Database》(2017)

weixin_49199313的博客 406

VQGAN【视觉码本】:以感知压缩和对抗训练学习离散视觉词元,融合CNN局部归纳偏置与Transformer长程依赖建模,通过自回归预测视觉组成,用滑动注意力窗口实现条件控制与百万像素级图像生成

德国海德堡大学 IWR 图像处理协作实验室*Both authors contributed equally to this work*两位作者对本工作贡献相同 Figure 1: Figure 1. Our approach enables transformers to synthesize high-resolution images like this one, which contains 1280×460 pixels. 图 1:图 1。我们的方法使 Transformer 能够合成像这样的高分

u013250861的博客 66

新手入门:从零开始学习PCB飞针测试全流程(附常见问题解答)

本文详细介绍了PCB飞针测试的全流程,从核心原理、设备解析到实操步骤和常见问题解答,帮助新手快速掌握这一电子制造领域的关键质检技术。内容涵盖测试资料准备、参数设置、设备操作技巧以及故障排查方法,特别适合小批量PCB生产的质量检测需求。

weixin_29295541的博客 392

ubuntu20.04安装nvidia-docker(解决有 Release 文件。 N: 无法安全地用该源进行更新,所以默认禁用该源错误)

然后想都不要想,nvidia+linux安装的东西,那肯定是不能安装成功的,恶毒的nvidia。按照nvidia官网给出的安装nvidia-docker流程来。在sudo apt-get update出现报错。然后再次update,发现还是会有一些警告类似于。,直接点击网页手动下载,发现下载成功!,注意会有安装先后顺序,安装给的提示就行。最后输入命令发现安装成功。然后替换掉里面的内容。直接不管,直接上命令。

weixin_48144140的博客 1236

NewBeeNLP 年中 | From NewBee To NB

哈喽大家好,这里是NewBeeNLP。今天趁着端午休假,归类梳理了下之前的原创文章,不知道你是从哪篇文章开始关注的呢????非常感谢一年多来的喜欢和支持,不管是入门小白还是行业老司机,希...

Kaiyuan_sjtu的博客 948

ENVI5.6+SARscape实战:基于哨兵一号的PS与SBAS时序InSAR地表形变监测全流程解析

本文详细解析了使用ENVI5.6和SARscape软件基于哨兵一号数据进行PS与SBAS时序InSAR地表形变监测的全流程。从数据获取、预处理到PS-InSAR和SBAS-InSAR处理,提供了实用技巧和优化建议,帮助用户高效完成地表形变监测任务。

weixin_29245767的博客 1156

Python统计检验选择指南:从数据类型到检验决策的全链路实战

统计检验是数据分析中连接数据特征与业务结论的关键桥梁。理解变量类型(定类/定序/定距)、验证分布前提(正态性、方差齐性)、匹配研究设计(独立/配对/单样本)是正确选择检验方法的基础原理。忽视这些环节极易导致p值失真、效应误判甚至结论反转。本文聚焦Python工程实践,系统拆解卡方检验、t检验、Mann-Whitney U等核心方法的适用边界与scipy实现细节,特别强调检验选择逻辑和数据前提验证两大高频痛点,覆盖AB测试、转化率分析、用户行为对比等典型业务场景,助力分析师将统计学转化为可复用、可解释、可落地

weixin_30919571的博客 367

别再买错磁铁了!手把手教你为TLE5012B/AS5047等磁编码器选配和安装径向充磁磁铁

本文详细解析了为TLE5012B/AS5047等磁编码器选配和安装径向充磁磁铁的关键要点。从充磁方向的物理本质到供应商沟通技巧,再到安装工艺的黄金法则,帮助工程师避免常见错误,确保磁编码器稳定工作。特别强调了径向充磁的重要性及验证方法,并提供了尺寸选择、温度特性和抗干扰设计的实用建议。

weixin_26750481的博客 316

从零开始:ENSP与VirtualBox的兼容性迷宫与突围指南

本文深入解析eNSP与VirtualBox的兼容性问题,特别是报错40的解决方案。从诊断根源、彻底卸载残留到推荐黄金版本组合,提供了一套完整的实战指南,帮助网络工程师和技术学习者快速解决AR_Base等设备的启动故障,优化虚拟化环境性能。

weixin_29284885的博客 476

论文:Self-Attention with Relative Position Representations

动机 RNN的结构是通过隐状态对序列信息进行编码的。 第二个 I 的输出和第一个 I 的输出是不同的,这是因为输入到其中的隐状态是不同的。对于第二个 I 来说,隐状态经过了单词"I think therefore",而第一个 I 是刚刚经过初始化的。因此,RNN的隐状态会使得处于不同位置的相同词具有不同的输出表示。恰恰相反的是,具有自注意力机制的Transformer(没有位置编码的)会使...

chaojianmo的博客 1194

【DeepSeek+Office/WPS】智能办公新时代的全新利器

DeepSeek是一家专注于通用人工智能技术研发的中国科技公司,其核心产品DeepSeek-R1是一款开源的推理大模型,专注于复杂任务的高效处理,支持智能对话、文本生成、语义理解、计算推理、代码生成与补全等多种应用场景。作为国产、免费、开源且强大的AI平台,DeepSeek不仅致力于为终端用户提供高质量的智能服务,还为开发者提供了一整套完善的技术解决方案,帮助他们快速构建和部署自己的智能应用。

2303_77200324的博客 2791

Self-Attention with Relative Position Representations 解读

原文地址:https://www.jianshu.com/p/cb5b2d967e90 论文链接:Self-Attention with Relative Position Representations 非递归的模型(attention,CNN等)并没有考虑输入序列中元素的顺序,因此在很多任务中可能需要显式地编码位置信息。这篇文章将元素与元素之间的相对位置表示引入了self-attentio...

weixin_41089007的博客 6811

拆开它的“身体”,看懂割草机器人的五层系统架构

这篇文章深入解析了智能割草机器人的五层系统架构。机械层采用铝合金一体式车架和独立悬挂刀盘系统;电子层配备双处理器和多种传感器;固件层实现毫秒级安全响应;算法层融合多种定位技术实现厘米级精度;云服务层提供远程管理和AI优化。这套系统通过精密协同实现了智能割草的全流程闭环,展现了从机械结构到云端智能的完整技术栈,为户外智能设备设立了新的技术标杆。

智能硬件研发,欢迎交流 198

使用Matlab与V-REP联合仿真

在Matlab中,我们可以使用V-REP提供的远程API(Application Programming Interface)来连接到V-REP仿真环境。为了连接Matlab与V-REP,我们需要在Matlab中添加V-REP的远程API函数库。你可以根据具体的需求编写Matlab脚本来控制V-REP场景中的机器人,并进行系统建模和仿真。一旦成功连接到V-REP,我们可以使用Matlab来控制V-REP场景中的机器人。在本文中,我们将介绍如何使用Matlab与V-REP进行联合仿真,并提供相应的源代码。

HackMasterX的博客 1854

Transformer家族

实现了大量的基于Transformer架构的主流训练模型, 不仅仅是自然语言处理模型,包括图像、音视频以及多模态模型。上面表格中的模型只是冰山一角,在最新的2023年《Transformer models: an introduction and catalog》论文有提到更多关于Transformer家族成员,并且提供了相关发布时间以及说明,有兴趣大家可以下载去看看。Encoder 的注意力层都可以访问初始输入句子中的所有单词,而 Decoder 的注意力层则只能访问输入中给定词语之前的词语。

youbingchen的博客 1275

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

论文阅读笔记:Self-Attention with Relative Position Representations

了解Transformer的都知道,与递归和卷积神经网络相反,它没有在其结构中显式地建模相对或绝对位置信息,而是它需要在其输入中添加绝对位置的表示,这是一种完全依赖于注意力机制的方法。在本篇论文中,提出了一种替代方法,扩展了自注意机制,可以有效地考虑相对位置或序列元素之间距离的表示。本文描述了该方法的有效实现,并将其转换为可感知到任意图标记输入的相对位置感知自注意力机制的实例,即提出了一种将相对位置表示形式并入Transformer自注意机制的有效方法,残差连接有助于将位置信息传播到更高的层。

BoCong-Deng的博客 5274

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

人工智能各领域跨界能手——Transformer

导读:Transformer源自于AI自然语言处理任务;在计算机视觉领域,近年来Transformer逐渐替代CNN成为一个热门的研究方向。此外,Transformer在文本、语音、视频等多模态领域也在崭露头角。本文对Transformer从诞生到逐渐壮大为AI各领域主流模型的发展过程以及目前研究进展进行梳理,见证Transformer的过人之处。  

futuregislab的博客 5268

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Transformers 发展一览

总之,Transformer 的分类学和注意力机制的各种进步显着扩展了基于 Transformer 的模型的能力和效率。稀疏注意力技术,例如基于位置和基于内容的稀疏注意力,以及线性化注意力,已经解决了传统密集注意力的计算局限性。最后,对多头机制的修改,例如头部行为建模、限制跨度、精细聚合和其他变体,显示出进一步提高基于 Transformer 的模型性能的潜力。稀疏注意力:该技术试图通过考虑输入的一小部分而不是整个输入序列来降低注意力机制的计算时间和内存要求,从而生成与完整矩阵相反的稀疏矩阵。

冷冻工厂 2240

Transformer发展历程 Decoder输出特征利用DCT解码投分割

作为在自然语言处理(NLP)领域应用广泛的深度学习模型,Transformer 近两年强势来袭,不仅横扫 NLP 领域,而且在 CV 上也锋芒毕露。江湖传言,Transformer 架构就像是绝世高手的武林秘籍,得秘籍者得天下!最初的 Transformer 来自于 NLP,它的出现将 NLP 领域向前推动了一大步。其中的关键要素就是Transformer 具备:超强的序列建模能力、全局信息感知能力。得益于这两点优势,Transformer 几乎取代了基于 RNN 的算法在 NLP 中的地位,也被引入到CV

m0_51339444的博客 5961
上一篇: Transformer家族简史(PART I)
下一篇: 1.6万亿参数,秒杀GPT-3!谷歌推出超级语言模型Switch Transformer,比T5快4倍
iFlyAI
博客等级 码龄9年 238粉丝 134原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值