RLHF-PPO 昇腾训推共卡方案案例总结(下)

DeepSeek V4是否用昇腾训练?分阶段技术验证与实操指南 大模型训练不是单一动作,而是涵盖预训练、监督微调、强化学习和量化部署的多阶段工程。理解BF16混合精度、ZeRO-3优化、模型并行等核心技术原理,有助于评估国产AI芯片在不同阶段的技术适配性与工程可行性。昇腾910B在监督微调和推理部署阶段已具备成熟支撑能力,尤其在MindSpore框架下可稳定运行MoE架构模型;但在V4级端到端预训练中,受限于通信延迟、BF16模拟稳定性及HCCL对高级分布式策略的支持深度,尚难替代A100/H100集群。本文基于真实集群日志、代码指纹与性能实测,为算法团队、平台工程师和 阅读详情

5. 强化学习的可视化和维测设计

RL 是一门非常复杂的算法,而精度维测是深入理解的第一步。突击队结合ICT解决方案的系统DFX设计经验,对PPO流程进行了分层分级(step级、response级、token级三层)的全面打点,使能GPU和NPU的数据比对。同时,我们对接和修改了RL Logging Board(一个将RLHF的训练过程进行可视化的开源工具),方便维测数据的可视化分析。

另外,考虑到生成稳定性对RLHF的训练效果至关重要,我们专门针对生成质量开展了维测设计分析工作。

5.1 step级指标

我们在训练过程中每步迭代增加了全量的维测指标,来监控训练每一步的正常与否。全量指标如下:

  • 总体维测指标:rewards/critic loss/ppo loss
  • 生成阶段维测指标:response len/total len/ppl/kl散度
  • Critic训练维测指标:return/values/critic loss clip/critic learning rate
  • Actor训练维测指标:kl sample and ref/net reward/advantages/actor ratio/actor learning rate 如下图所示,工具可以通过上方tab页切换不同step级指标,从而绘制step级曲线。
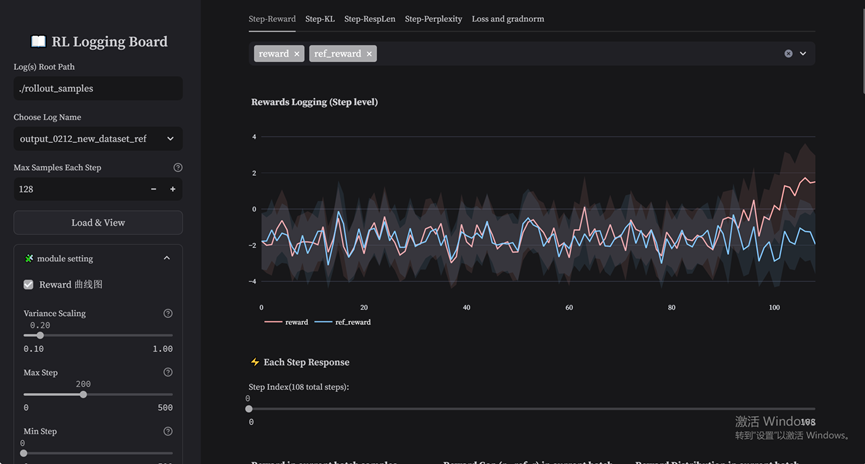
工具原始指标包含:Reward、Ref_reward、KL散度、Response Length四种step级指标。突击队在此基础上添加了:Net_Reward、 Perplexity、Ref_perplexity、Advantage、Return、Actor Loss、PPO Loss、Actor Abs PPO 、Critic Loss、Critic Gradnorm、Actor Ratio等各项指标;同时还在左侧工具栏增加了Min Step和Max Step的滑动轴,用于调节曲线的数据范围,可以在指定step范围内生成曲线数据进行更细致的对比。

5.2 句子级的指标

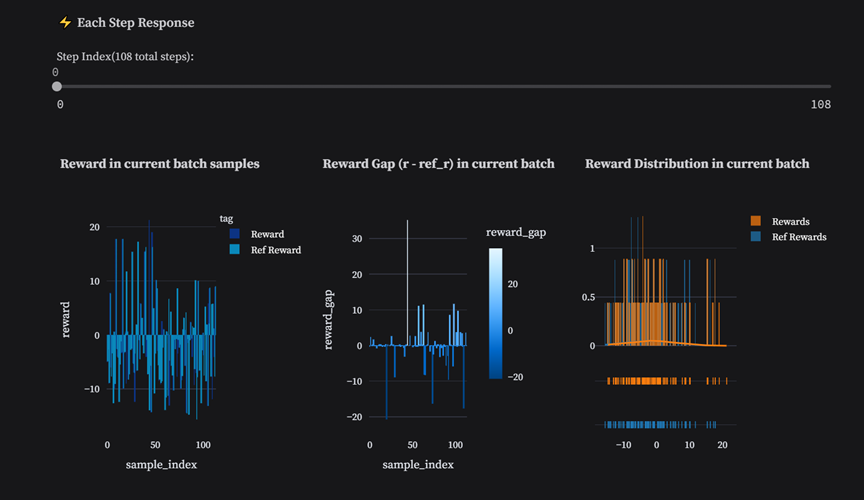
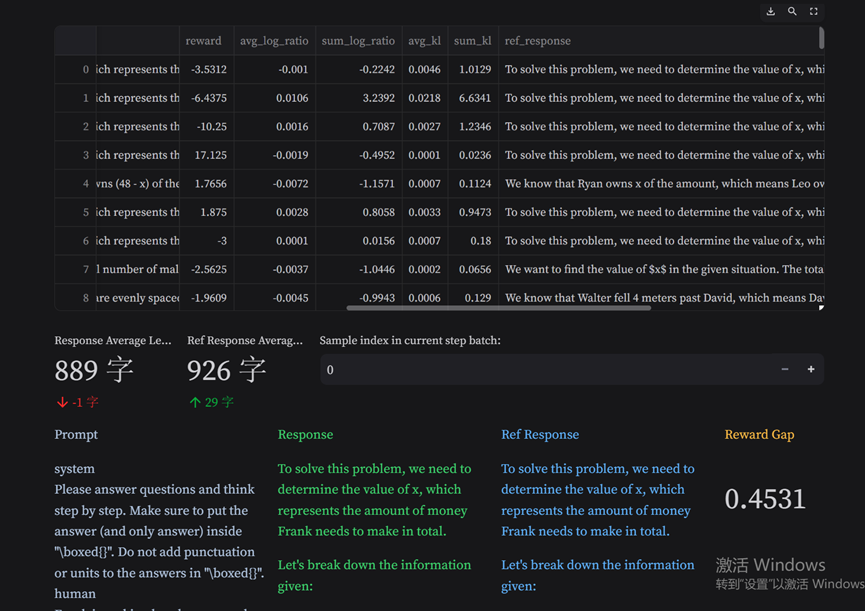
工具可以指定具体step,打开分析内部不同response的reward差异。下图以step0为例,比较Reference和Actor生成response的reward,给出reward差异和分布可视化图。
工具可以选择任意步数,展示response级的指标,其中包含prompt文本、response文本、reward、log_ratio、kl散度、perplexity等。
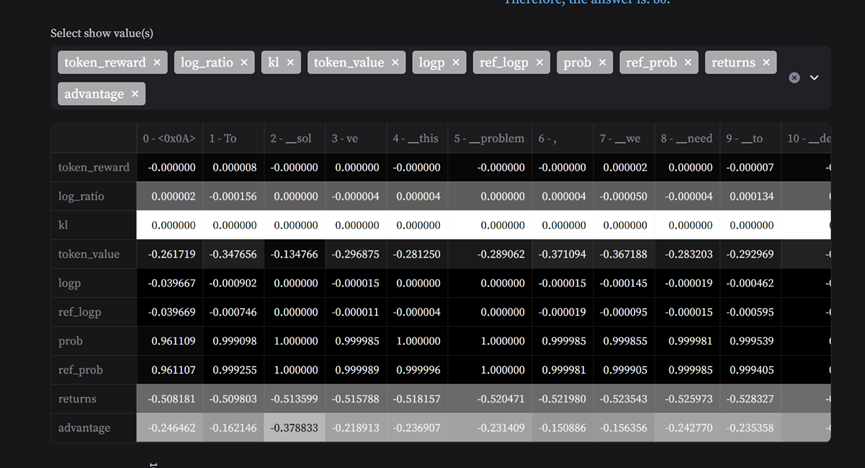
5.3 token级指标和热力图

PPO loss和Critic loss需要重点关注,对这两个参数进行重点拆解:
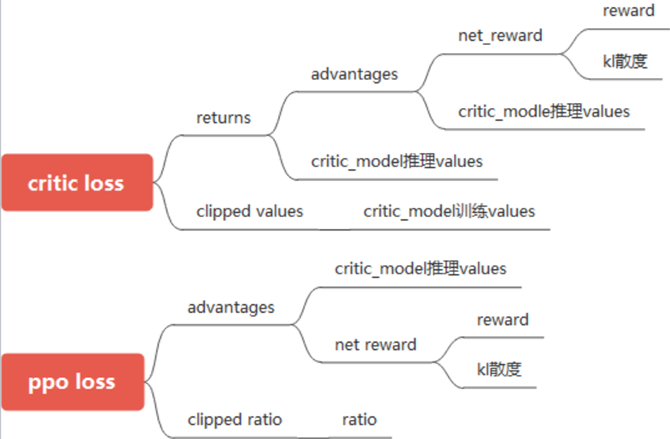
token级别的维测包含:advantages, ratio, returns, values, train_values,net_reward, reward, kl sample_and_ref, ppo_loss, critic_loss, logprobs,ref_logprobs, clip_ratio, clip_values等。 工具可以指定任意句子,展示token级别的数据,并绘制相关热力图。
5.4 生成质量分析

RLHF中,response生成质量的度量非常重要。通常看以下两个指标:

  • 困惑度perplexity
  • response的长度
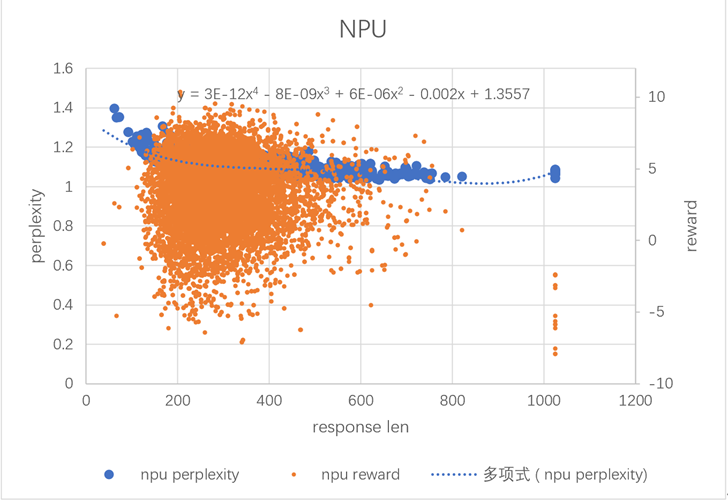
  1. RL过程中生成长度与困惑度、reward的关联分析 下面的图分析了随着response生成长度差异,reward和perplexity的变化趋势:
  • 当生成长度小于200时,困惑度较高;
  • 当生成长度超过800以后,reward打分都是负的;
  • 大量的生成长度区间分布在200到600以内,这个区间内reward跟生成长度没有明显的相关性。 从上图可以看出,生成长度对困惑度和reward打分是有一定影响的。我们希望对每个response,进一步设计指标,分析生成的token困惑程度和困惑个数。
2.Response中每token的top3 prob分析

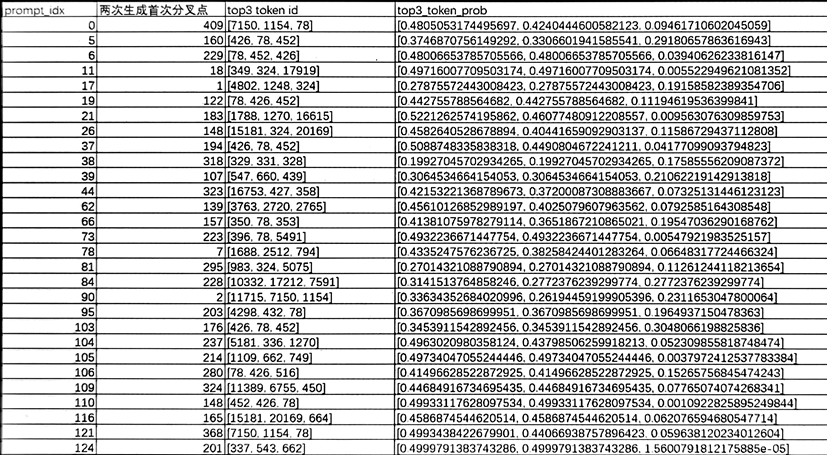
我们对首步的128个prompt生成结果进行分析,每个prompt生成2次,捞出生成结果不一致的prompt,并统计首次生成不一致的token位置,打印出该位置的top3 prob。 从上图可以看出,生成结果初始分叉位置现象比较统一:top1 prob基本低于0.5,并且top2 prob与top1 prob近似相当。
3.生成token困惑度指征:Ambiguity Count 根据上文分析规律,新设计一个监控指标Ambiguity Count (AC):统计单次生成步骤(step)中同时满足 低置信度 和 竞争性分布 条件的 token 绝对数量,反映策略在可配置阈值下的模糊决策强度。 计算公式:

参数说明:

α:Top-1 概率阈值,控制低置信度判定严格性(默认 0.5)

β:Top-2/Top-1 概率比值阈值,控制竞争性分布判定严格性(默认 0.88)

T:当前 step 生成的总 token 数

:第t个token的Top-1的概率

:第t个token的Top-2的概率

对每个生成token,需同时满足以下两条件:

  • 低置性条件:top-1概率
  • 竞争分布条件:top-2与top-1概率比值     
    针对该企业场景设置α=0.5,β=0.88,阈值α、β需通过验证集调优(如网格搜索或贝叶斯优化),不同任务场景需动态调整。

相对于传统的perplexity指标,AC指标的优点:

  • 可解释性:AC的物理意义更为明确,表示的是generation阶段token选择存在疑义的token数量,AC值越大表示这个step中可能出现分歧的token数越多。
  • 灵活性:AC有α、β两个参数可以调节,适配不同风险容忍度和任务需求
  • 可观测性:当NPU和GPU之间、或者NPU多次训练的生成结果有差异时,可以查看分叉点是否满足上述AC统计指标。若满足,则可认为这个分叉是在模型比较困惑的情况下,微小累积误差导致的正常现象。

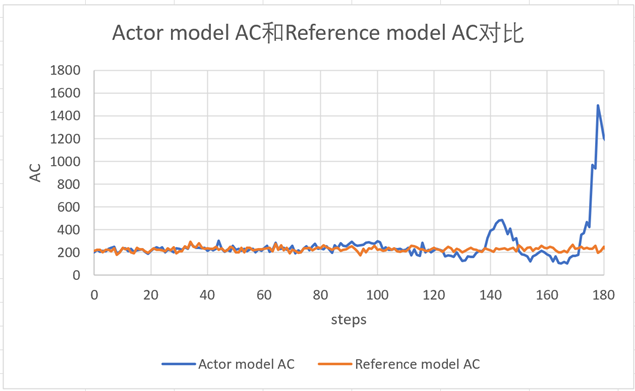
下图呈现的是step级别下reward与AC指标的对比情况。可以明显观察到, reward急剧下降时,AC值会迅速上升。
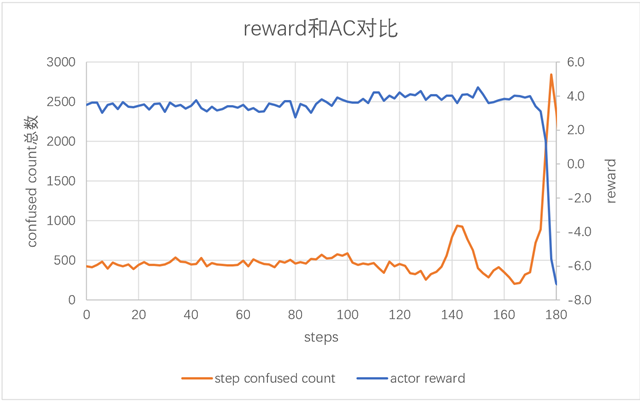
与之形成对照的是,reference model的AC值波动范围比较平稳:
5.5 维测指标分析示例

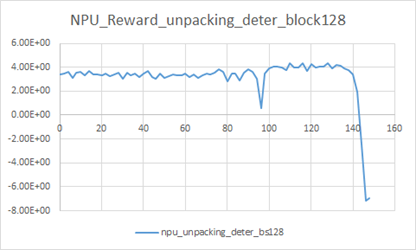
分层的维测打点,可以从异常现象触发层层深入,先从step级别维测中找到异常的reward步数范围,再对该范围查看response级别维测找到异常的prompt id,最后到该prompt id的token级别维测去分析找出异常token。 以确定性reward曲线为例,在94~96步突然掉坑:
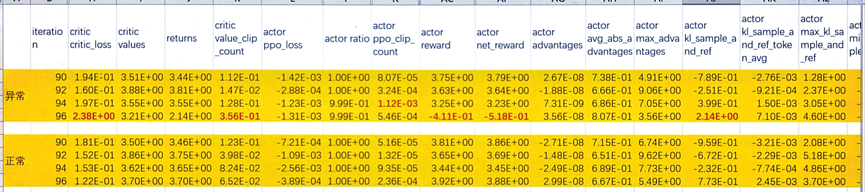
以确定性掉坑的数据为异常基线,从不开确定性的实验中找出一组90~96不掉坑的为正常基线,对比正常和异常数据下的step级维测。从下图可以看出,异常基线96步reward明显下降,伴随着critic模型的loss上升和value clip count的指标上升。另外,从96步的上一步step94维测指标,可以观测到ppo的clip count异常上升。
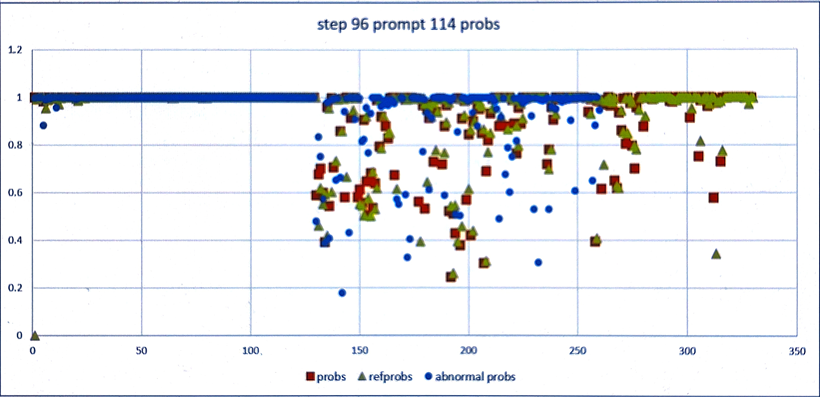
对96步掉坑的数据打开response级别维测,对齐正常和异常配置下的prompt id,找到reward下降最严重的prompt id:114。
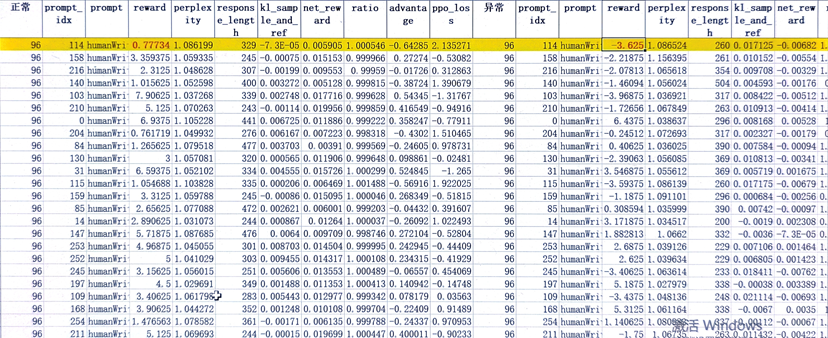
对prompt id 114 token级维测打开分析,在正常、异常配置下,对比每个token的概率,与reference模型生成的差异。下图可以明显看出,正常的reward曲线生成概率与refprobs距离较近;异常的reward曲线生成概率与refprobs距离较远。
六、基于昇腾A300的TensorFlow框架Qwen3模型实现与训练(理论篇) 本文详细阐述了基于昇腾A300硬件和TensorFlow框架的Qwen3大模型实现技术方案。系统采用分组查询注意力(GQA)机制、QK-Norm归一化方法和RoPE位置编码等创新设计,显著提升了模型性能。通过三阶段训练流程(预训练、监督微调、强化学习)和精细的内存优化策略(内存池、动态卸载、内存复用),实现了在64GB内存环境下高效训练235B参数规模的超大规模模型。工程实现上采用分层架构和模块化设计,结合混合精度计算、算子融合等优化技术,充分发挥了昇腾NPU的硬件加速能力。 阅读详情

相关推荐

昇腾集群强化学习训推一体加速:异步流水调度与通信优化实践

强化学习依赖环境交互生成训练数据,其采样过程本质是持续推理,因此训练与推理天然耦合。与传统深度学习训推分离不同,RL场景下推理延迟和吞吐直接制约整体训练效率,尤其在多模型协同(如PPO中actor-critic)时,参数版本同步与资源调度成为挑战。在昇腾集群中,基于HCCL集合通信与异构切分设计,可实现训推共卡或分离部署,并通过版本号驱动的异步流水调度,让采样、训练、参数发布高效重叠。这类技术广泛适用于机器人控制、RLHF、智能决策等大模型及强化学习工程化场景。本文从架构设计到关键参数与踩坑实录,系统介绍了

weixin_34405354的博客 357

RLHF-PPO 昇腾训推共卡方案案例总结(上)

RLHF-PPO 昇腾训推共卡方案案例总结(上)

devascend的博客 905

矩形口径喇叭天线设计——参数设置

我们建立好矩形口径喇叭天线的模型后(模型建立可参考B站相关视频或者李明洋的《HFSS天线设计》),如何修改参数达到我们的指标呢?

m0_57263863的博客 1万+

【硬核利器】实现千亿模型训推全流程的LLM开发工具

背景与简介大语言模型的快速发展对训练和推理技术带来了更⾼的要求,基于飞桨框架3.0版本打造的PaddleNLP大语言模型套件,通过极致的全流程优化,为开发者提供从组网开发、预训练、精调对⻬、模型压缩以及推理部署的一站式解决⽅案。

2401_84494441的博客 1242

利用python爬取东方财富网股吧评论并进行情感分析(一)

利用python爬取东方财富网股吧评论(一) python-东方财富网贴吧文本数据爬取 分享一下写论文时爬数据用到的代码,有什么问题或者改善的建议的话小伙伴们一起评论区讨论。 新的改变 我们对Markdown编辑器进行了一些功能拓展与语法支持,除了标准的Markdown编辑器功能,我们增加了如下几点新功能,帮助你用它写博客: 全新的界面设计 ,将会带来全新的写作体验; 在创作中心设置你喜爱的代码高亮样式,Markdown 将代码片显示选择的高亮样式 进行展示; 增加了 图片拖拽 功能,你可以将本地的图片直

YMG521000的博客 1万+

(详细教程)opencv+pycharm+笔记本摄像头 做一个人脸识别

文章目录 前言 一、pandas是什么? 二、使用步骤 1.引入库 2.读入数据 总结 一、安装opencv-python 这里推荐使用pycharm直接安装opencv-python 打开文件——设置——python解释器——点击+号 搜索opencv-python,点击安装包,等待片刻即可安装好 检查是否安装好,新建一个项目输入以下代码,若无报错则安装好 import cv2 二、准备分类器 咱们使用opencv官方提供的分类器,包括面部识别,侧...

qq_52852432的博客 1万+

大模型RL训练中训推一致性的挑战与华为昇腾解决方案

在深度学习和强化学习领域,模型的计算行为一致性是确保算法从实验到部署成功转化的关键基础。其核心原理在于保证训练与推理阶段在计算图、数值精度和算子实现上的统一,避免因环境差异导致性能下降。这一技术对于提升模型部署的稳定性和可预测性具有重要价值,尤其在自动驾驶决策、游戏AI和大模型对齐等复杂场景中至关重要。华为昇腾AI处理器通过统一动静合一计算图、确定性算子实现和硬件加速专用单元,有效解决了RL场景下训推一致性的工程难题,为大规模强化学习训练提供了稳定高效的部署管道。

axfcjwkbi259888707的博客 460

国科大——形式语言与自动机理论(0812课程)——作业

此次作业题考察,包括但不限于有限自动机、无限自动机、正则文法、正则表达式以及正则语言的性质,题考查下推自动机相关的知识,题考查图灵机相关的知识。此课程建议本科学习过课程的同学选修,成绩占比:考试100%。此课程虽然留有作业,但可做也可不做,且不考勤。

qq_54145399的博客 707

大型央企大模型训推框架研发岗位P6-8,大模型训推框架研发

本文介绍了AI大模型训练与推理框架研发相关的三个岗位,涵盖训练框架优化、推理性能提升等核心职责。岗位一(P6-7)侧重大模型训练框架研发与性能优化;岗位二、三(P8+)为资深专家岗,要求主导AI框架架构设计、推理优化及行业落地。任职要求均强调扎实的工程能力、熟悉主流AI框架及分布式系统,P8岗位还需8年以上AI研发及管理经验。文章同时提供了大模型学习路径,包含提示工程、RAG系统、智能体开发等进阶内容,并附赠学习资料包,助力从业者把握AI发展机遇。

2401_85375151的博客 430

直击高频编程考点:字符串知识及经典算法题总结

字符串相关基本练习题总结(最长公共子串、最长回文子串、最长无重复字符子串、最小覆盖子串、字符串相乘、中文数字表达转实际数字格式等)

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 172万+

C#图像处理:OpenCVSharp实现简单人脸识别

人脸识别是计算机视觉领域中的一个重要研究方向,它可以通过分析和比对人脸图像,实现识别和验证的功能。希望通过这篇文章的学习,你对OpenCVSharp和人脸识别有了初步的了解,并能够运用这些知识进行自己的项目开发。当我们运行程序时,它会加载人脸识别模型并读取待识别的图像,然后进行人脸检测并在图像上标记出检测到的人脸位置。当然,这只是一个入门级的示例,实际的人脸识别系统还需要更加复杂的算法和大量的训练数据来提高准确性和鲁棒性。最后,我们遍历检测到的人脸,并在原始图像上绘制矩形框,标记出检测到的人脸位置。

WELL_CODER的博客 1130

华为昇腾RL训推一致性:大模型强化学习部署性能提升60%

在AI模型工程化实践中,训练与推理环节的计算一致性是影响模型最终上线效果与性能的关键因素。其核心原理在于确保模型从训练到部署的整个生命周期中,计算图、算子实现和数值精度保持统一,从而避免因环境差异导致的性能下降和策略漂移。这一技术对于强化学习和大模型应用尤为重要,能显著提升端到端的工程效率与模型稳定性。华为昇腾通过全栈软硬件协同,实现了RL训推一致性,在特定场景下实测获得了60%的端到端性能收益,为强化学习模型的平滑部署提供了可靠保障。

weixin_33910759的博客 409

LVGL 组件对齐方式说明

本文说明 LVGL(以 v8 为例)中常用的 lv_align_t对齐选项的含义与用法,对应界面设计工具里下拉列表中的以及等命名。

摸鱼专家 134

终极Verl强化学习框架指南:从零搭建高效RLHF训练环境

Verl(Volcano Engine Reinforcement Learning for LLMs)是火山引擎推出的强化学习框架,专为大语言模型(LLM)的RLHF(基于人类反馈的强化学习)训练设计。本指南将带你快速掌握Verl环境搭建的核心步骤,让AI模型训练效率提升20倍不再是难题!🚀 ## 📋 环境准备:一键安装Verl框架 ### 1. 克隆官方仓库 ```bash git c

gitblog_00019的博客 385

基于STM32与FPGA的数据采集系统的设计与实现

数据采集系统在现代工程中起着至关重要的作用,用于实时获取和处理各种传感器或外部设备的数据。在本文中,我们将探讨如何基于STM32微控制器和FPGA(现场可编程门阵列)实现一个高效的数据采集系统。我们可以使用STM32的UART、SPI或I2C接口与各种传感器或外部设备进行通信,并通过GPIO口实现控制功能。在硬件连接完成后,我们可以通过STM32控制FPGA的配置和数据传输。STM32作为主控单元负责与外部设备进行通信和数据处理,而FPGA则用于高速数据采集和实时处理。具体的通信协议取决于连接的设备类型。

UbiSqlserver的博客 1798

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

大模型训推框架研发与优化:收藏这份高薪岗位解析,小白也能入门!

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

大模型研究中心 388

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

VeRL 强化学习框架中的数据流与 PPO 损失计算详解

else:注意:最终训练使用的是多源融合结果,不仅包含 RM 打分,还融合了 KL 惩罚项。VeRL 通过 Hybrid Programming 模式,实现了 PyTorch 与 Ray 的深度融合,构建了一套高效、灵活、可扩展的 LLM-RLHF 训练框架。数据流解耦:将数据生命周期划分为 Rollout、Process、Update 三阶段,支持异步、分布式并行。Batch Size 精细控制:通过的协同设计,实现资源与性能的最优平衡。多模式支持。

weixin_42409374的博客 574

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

终极verl框架RLHF训练指南:从入门到实战的完整路径

verl(Volcano Engine Reinforcement Learning for LLMs)是火山引擎开源的**高效RLHF框架**,基于论文《HybridFlow: A Flexible and Efficient RLHF Framework》实现,为大语言模型提供从人类反馈中学习的完整解决方案。本文将带你从基础概念到实际操作,掌握verl框架的核心功能与应用技巧。 ## 什么是

gitblog_00725的博客 999

vllm-ascend用户案例精选:LLaMA-Factory与TRL强化学习最佳实践

vllm-ascend是昇腾硬件上的vLLM社区维护插件,为大语言模型在昇腾NPU上的部署提供高效支持。本文将通过LLaMA-Factory和TRL两个精选用户案例,展示vllm-ascend如何助力开发者实现模型微调与强化学习的最佳实践,显著提升昇腾平台上的模型推理性能和训练效率。 ## 🌟 LLaMA-Factory:2倍推理加速的实践案例 ### 🔍 业务挑战 [LLaMA-Fac

gitblog_01002的博客 1069

超详细指南:bilingual-gpt-neox-4b-instruction-ppo推理代码示例与NPU加速配置终极教程

想要快速上手双语对话AI模型吗?本文将为您详细介绍bilingual-gpt-neox-4b-instruction-ppo模型的推理代码示例与NPU加速配置方法。这个基于PPO强化学习训练的38亿参数双语GPT-NeoX模型,支持英文和日文对话,在昇腾NPU硬件上能获得显著的推理加速效果。无论您是AI开发者还是普通用户,都能通过本指南快速掌握这个强大模型的部署与使用技巧。🚀 ## 📊 模型

gitblog_01103的博客 955

如何让Qwen2.5更安全?RLHF+DPO联合对齐部署实战教程

本文介绍了基于星图GPU平台自动化部署通义千问2.5-7B-Instruct镜像的实战方法,结合RLHF与DPO联合对齐技术提升模型安全性。该方案可高效构建具备拒答能力的AI服务,适用于智能客服、内容审核等需高安全合规的应用场景,实现从部署到防护的一站式落地。

weixin_33812391的博客 747

华为AI大模型架构师/算法专家招聘全解析,带你入门前沿技术

华为招聘AI大模型架构师和算法专家岗位,聚焦大模型训练/推理优化、国产硬件适配、多模态技术等方向。岗位要求5年以上经验,精通Python/C++,具备机器学习基础和大模型相关技术经验。工作内容包括算法架构创新、行业趋势分析、性能优化等。适合对AI前沿技术感兴趣、具备扎实编程和系统优化能力的人才。同时提供大模型学习资料,帮助从业者掌握提示词工程、RAG系统等核心技术,把握AI发展机遇。

WANGJUNAIJIAO的博客 1678

昇思 AI 框架大模型强化学习对齐优化

昇思 AI 框架通过静态图编译、显存智能调度、训推异步流水线、分布式样本优化,彻底解决大模型强化学习对齐训练的性能瓶颈;结合Kimi K2 超长文本数据创新,实现低成本、高质量、规模化数据供给,形成完整国产化大模型优化方案。

Kenji_Shinji的博客 227

基于昇腾的多模态模型后训练性能优化实践

本文基于VeRL开源框架,针对Qwen3-VL-8B模型在Atlas 800T A2硬件平台上的GRPO后训练流程,系统性地开展性能瓶颈分析与优化,通过推理与训练双路径协同调优,实现端到端性能提升30%。

pae_train_group2的博客 641

大语言模型RLHF训练框架全景解析:OpenRLHF、verl、LLaMA-Factory与SWIFT深度对比

随着大语言模型(LLM)参数规模突破千亿级,基于人类反馈的强化学习(RLHF)成为提升模型对齐能力的关键技术。OpenRLHF、verl、LLaMA-Factory和SWIFT作为开源社区的四大标杆框架,分别通过分布式架构、混合控制器、模块化设计和国产化适配,为70B级模型训练提供创新解决方案。随着RL4LM技术的持续突破,未来将出现更多跨框架融合方案,推动AGI安全对齐研究进入新阶段。开发者应根据硬件条件、算法需求和部署场景进行动态选择,同时关注TRL、TRLX等新兴库的技术演进。

fydw_715的博客 6059
上一篇: RLHF-PPO 昇腾训推共卡方案案例总结(上)
下一篇: 万卡集群训练任务挂了?别慌,这本秘籍帮你解决!
鲲鹏昇腾开发者社区
博客等级 码龄1年 26粉丝 8原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值