


Bringing Fairness to Actor-Critic Reinforcement Learning for Network Utility Optimization 阅读笔记
在网络优化问题中,公平性(fairness)是一个重要的考虑指标。随着越来越多的设备接入网络中,网络中的资源分配、任务调度等需要充分考虑设备之间的公平性,在系统效率与用户公平性之间达到一种平衡。近年来,强化学习被成功应用于网络优化问题的在线决策中,然而大部分算法聚焦于最大化所有agent的长期收益,很少考虑公平性。在这样的背景下,作者提出了一种fairness Actor-Critic algorithm,该算法将公平性融入到AC算法的设计中,旨在优化整体公平效用函数。具体做法为,设计了一种适应性奖励,在原奖励的基础上乘以一个权重,该权重与效用函数和过去的奖励有关。实验部分,作者将算法用于求解网络调度问题(convex)与视频流QoE优化问题(non-convex),说明了算法的有效性。
Problem Formulation
考虑一个网络效用优化问题,网络建模为环境,用户是agents,agent与环境进行交互,学习策略来优化rewards(如数据率等)。假设有K个agents,使用随机策略(stochastic policy)
π
\pi
π(a|s)表示状态s下选择动作a的概率。
x
π
,
k
x_{\pi,k}
xπ,k代表agent k在策略
π
\pi
π下的平均奖励
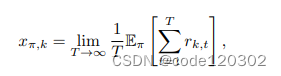
在本文中,使用
α
\alpha
α-fiar 效用函数,该函数广泛应用于网络优化领域。对于任意的
α
\alpha
α >= 0,有
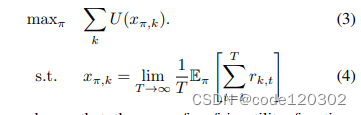
Learning Algorithm
假定在任何策略下的马尔科夫链都是不可还原/非周期性的。
Learning with Multiplicative-Adjusted Rewards
为了优化公平效用,在算法中需要追踪历史reward。为什么能使用过去历史reward来实现公平呢?
假设这样一个场景,两个agent分别有自己的reward,在某个策略下,如果截至到epoch t时agent 1比agent 2获得了更多的累积奖励,那么我们需要偏好使用策略梯度更新agent 2而不是agent 1。因此过去历史reward能够用于优化公平性。
使用
h
π
,
t
h_{\pi, t}
hπ,t表示截止epoch t从采样路径中获得的数据,使用一个一致连续函数( uniformly-continuous function)
ϕ
(
h
π
,
t
)
\phi(h_{\pi, t})
ϕ(hπ,t)计算奖励的乘子。一致连续函数本身是“公平性”的体现。定义适应性奖励(adjust rewards)为
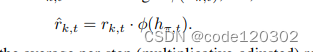
使用
ρ
π
^
\hat{\rho_{\pi}}
ρπ^表示MDP下平均单步适应性奖励,定义状态价值函数和动作价值函数如下:
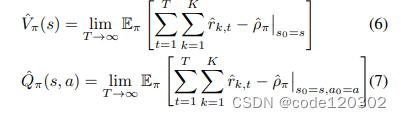
可以看到,V和Q都是有边界的。定义一个增强函数
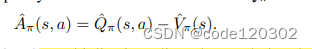
因为适应性奖励依赖于过去的历史h,所以标准RL的策略梯度理论不再适用适应性奖励。重新分析MDP。
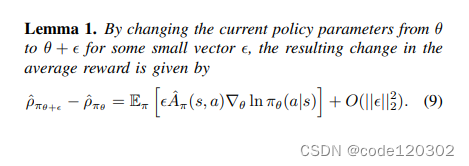
当策略参数发生微小改变,平均奖励的改变如上式。
证明:定义新的状态
z
t
=
[
s
t
,
h
π
,
t
]
z_t = [s_t, h_{\pi, t}]
zt=[st,hπ,t],新的马尔可夫过程为状态
z
t
z_t
zt、动作
a
t
a_t
at和奖励
r
k
,
t
^
\hat{r_{k,t}}
rk,t^的链。使用
p
z
z
′
a
p^a_{zz'}
pzz′a表示状态转移概率,
V
π
(
z
)
V_{\pi}(z)
Vπ(z)和
Q
π
(
z
,
a
)
Q_{\pi}(z,a)
Qπ(z,a)为状态-值函数、动作-值函数。用
P
π
(
z
∣
s
)
P^{\pi}(z|s)
Pπ(z∣s)表示对于给定的状态s发生z的有限概率。Q函数与V函数表示如下
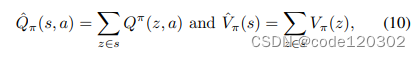
定义一个辅助函数
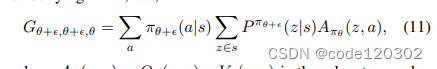
其中
A
π
(
z
,
a
)
=
Q
π
(
z
,
a
)
−
V
π
(
z
,
a
)
A_{\pi}(z,a) = Q_{\pi}(z,a) - V_{\pi}(z,a)
Aπ(z,a)=Qπ(z,a)−Vπ(z,a)。则有
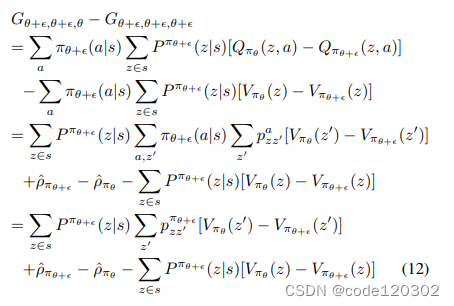
因为
∑
a
π
(
a
∣
s
)
Q
π
(
z
,
a
)
=
V
π
(
z
)
\sum_{a}\pi(a|s)Q_{\pi}(z,a) = V_{\pi}(z)
∑aπ(a∣s)Qπ(z,a)=Vπ(z), 所以根据推导,有
G
θ
+
ϵ
,
θ
+
ϵ
,
θ
+
ϵ
G_{\theta+\epsilon, \theta+\epsilon, \theta+\epsilon}
Gθ+ϵ,θ+ϵ,θ+ϵ = 0 。上述推导的最后一步中,第一项和第三项能够消掉,最后得到
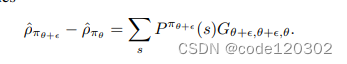
当策略参数发生的改变
ϕ
\phi
ϕ十分微小,策略
π
θ
\pi_{\theta}
πθ的相应改变可以用
ϵ
∇
π
θ
(
a
∣
s
)
+
O
(
∣
∣
ϵ
∣
∣
2
2
)
\epsilon \nabla \pi_{\theta}(a|s) + O(||\epsilon||^2_2)
ϵ∇πθ(a∣s)+O(∣∣ϵ∣∣22)来bound。那么有
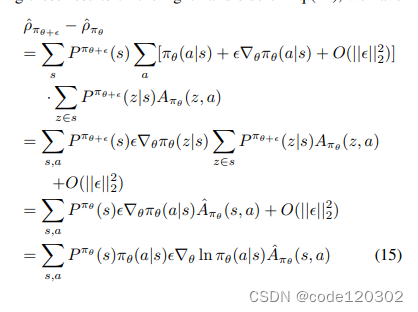
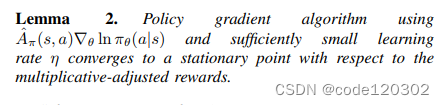
以上的梯度和较小的学习率能够使得算法收敛到一个平稳点。
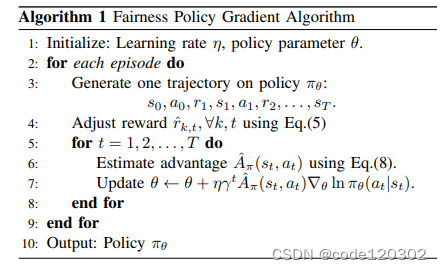
策略梯度算法如下:(类似于REINFORCE算法)
Solving Fairness Utility Optimization
Lemma 2说明了新的策略梯度算法能收敛到适应性MDP的平稳点。定义最优策略的参数为
θ
∗
\theta^*
θ∗,那么初始奖励的单步平均值为
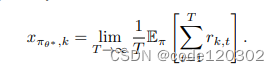
我们需要证明
θ
∗
\theta^*
θ∗也是优化问题
∑
k
U
(
x
π
θ
,
k
)
\sum_{k}U(x_{\pi_{\theta},k})
∑kU(xπθ,k)的平稳点。
对于一致连续函数
ϕ
\phi
ϕ,设定为效用函数U的一阶导数。该函数是符合Lipschitz连续的,有
∣
U
′
(
x
)
−
U
′
(
y
)
∣
<
=
L
∣
x
−
y
∣
|U'(x) - U'(y)| <= L|x - y|
∣U′(x)−U′(y)∣<=L∣x−y∣, 对于L > 0。那么适应性奖励可以表示为
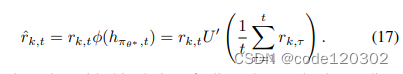
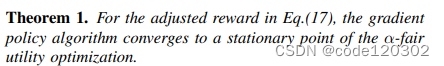
理论1:策略梯度算法能够收敛至公平效用函数的平稳点。
证明:由上已知,
θ
∗
\theta^*
θ∗是适应性MDP的平稳点,即
∇
θ
ρ
π
θ
^
∣
θ
=
θ
∗
=
0
\nabla_{\theta} \hat{\rho_{\pi_{\theta}}} |_{\theta=\theta^* }= 0
∇θρπθ^∣θ=θ∗=0,需要证明
θ
∗
\theta^*
θ∗也是
α
\alpha
α-fair 效用函数
∑
k
U
(
x
π
θ
,
k
)
\sum_{k} U(x_{\pi_{\theta},k})
∑kU(xπθ,k)的平稳点,也即
∇
θ
[
∑
k
U
(
x
π
θ
,
k
)
]
∣
θ
=
θ
∗
=
0
\nabla_{\theta} [\sum_{k} U(x_{\pi_{\theta},k})] |_{\theta=\theta^* }= 0
∇θ[∑kU(xπθ,k)]∣θ=θ∗=0。
所以我们需要分析单步平均适应性奖励
ρ
π
θ
^
\hat{\rho_{\pi_{\theta}}}
ρπθ^和单步平均奖励
x
π
θ
,
k
x_{\pi_{\theta},k}
xπθ,k的关系
根据公式(17),有
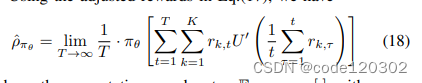
在policy
π
θ
\pi_{\theta}
πθ下,对于任意的
ϵ
\epsilon
ϵ > 0 存在一个足够大的T使得,
∣
1
/
T
∑
t
=
1
T
r
k
,
t
−
x
π
θ
,
k
∣
<
ϵ
|1/T \sum^{T}_{t=1} r_{k,t} - x_{\pi_{\theta},k}| < \epsilon
∣1/T∑t=1Trk,t−xπθ,k∣<ϵ,结合U’的Lipschitz continuity有
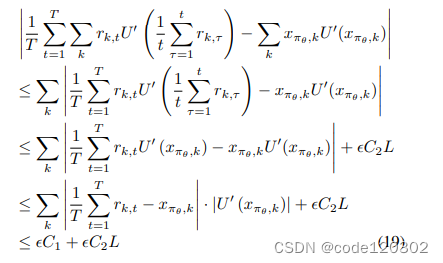
其中C1是
∣
U
′
(
x
π
θ
,
k
)
∣
|U'(x_{\pi_{\theta},k})|
∣U′(xπθ,k)∣的边界,C2是
∣
1
/
T
∑
t
=
1
T
r
k
,
t
∣
|1/T \sum^{T}_{t=1} r_{k,t}|
∣1/T∑t=1Trk,t∣的边界。当T足够大,有
ρ
π
θ
^
=
∑
k
x
π
θ
,
k
U
′
(
x
π
θ
,
k
)
\hat{\rho_{\pi_{\theta}}} = \sum_{k} x_{\pi_{\theta},k}U'(x_{\pi_{\theta},k})
ρπθ^=∑kxπθ,kU′(xπθ,k)
由于
θ
∗
\theta^*
θ∗是适应性MDP的平衡点,有
∇
θ
[
x
π
θ
,
k
U
′
(
x
π
θ
,
k
)
]
∣
θ
=
θ
∗
=
0
\nabla_{\theta} [x_{\pi_{\theta},k}U'(x_{\pi_{\theta},k})] |_{\theta=\theta^* }= 0
∇θ[xπθ,kU′(xπθ,k)]∣θ=θ∗=0,也即
∇
θ
ρ
π
θ
^
∣
θ
=
θ
∗
=
0
\nabla_{\theta} \hat{\rho_{\pi_{\theta}}} |_{\theta=\theta^* }= 0
∇θρπθ^∣θ=θ∗=0。
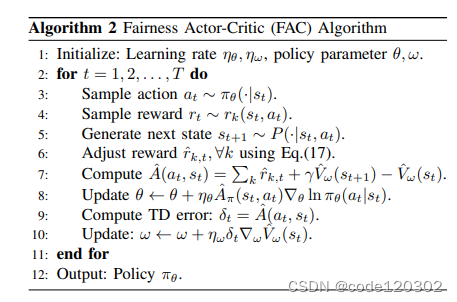
上述证明结果可以形成一个新的actor-critic算法,使用
V
w
^
(
s
t
)
\hat{V_{w}}(s_{t})
Vw^(st)作为神经网络近似state-value function,使用TD误差来训练
V
w
^
(
s
t
)
\hat{V_{w}}(s_{t})
Vw^(st)。
Evaluations
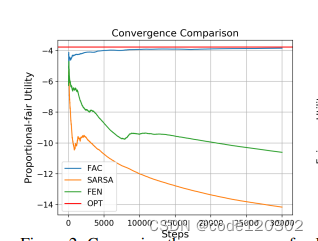
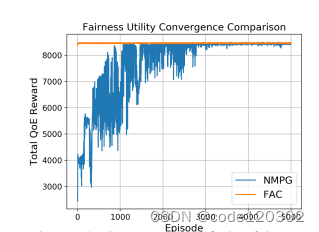
两个场景:无线网络调度和QoE优化
结果都表明FAC算法的优势:能够优化全局的效用、收敛速度快。
Code Implementation
以下是个人尝试复现的代码(文章细节之处仍有存疑)
import torch
from torch import nn
from torch.nn import functional as F
import numpy as np


class Critic(nn.Module):
    def __init__(self, agent_id, state_dim, action_dim, hidden_num=250):
        super(Critic).__init__()
        self.agent_id = agent_id
        self.fc1 = nn.Linear(state_dim + action_dim, hidden_num)
        self.fc2 = nn.Linear(hidden_num, 1)

    def forward(self, s, a):
        cat = torch.cat([s, a], dim=1)
        x = self.f1(cat)
        x = F.relu(x)
        x = self.fc2(x)
        return x


class Actor(nn.Module):
    def __init__(self, agent_id, state_dim, action_dim, hidden_num=250):
        super(Actor).__init__()
        self.agent_id = agent_id
        self.f1 = nn.Linear(state_dim, hidden_num)
        self.f2 = nn.Linear(hidden_num, action_dim)

    def forward(self, s):
        x = self.f1(s)
        x = F.relu(x)
        x = self.f2(x)
        x = F.softmax(x, dim=-1)
        return x


class FairnessActorCritic:
    def __init__(self, state_dim, hidden_num, action_dim, device, n_agents, alpha, actor_lr=0.001, critic_lr=0.01,
                 gamma=0.9):
        self.agents = []
        self.n_agents = n_agents  # k agents
        self.alpha = alpha
        self.gamma = gamma
        self.device = device

        self.actor = Actor(0, state_dim, action_dim, hidden_num).to(self.device)
        self.critic = Critic(0, state_dim, action_dim, hidden_num).to(self.device)
        self.actor_optim = torch.optim.Adam(self.actor.parameters(), actor_lr)
        self.critic_optim = torch.optim.Adam(self.critic.parameters(), critic_lr)

        # self.actors = [Actor(aid, state_dim, action_dim, hidden_num).to(self.device) for aid in range(n_agents)]
        # self.critics = [Critic(aid, state_dim, action_dim, hidden_num).to(self.device) for aid in range(n_agents)]
        # self.actors_optim = [torch.optim.Adam(actor.parameters(), actor_lr) for actor in self.actors]
        # self.critics_optim = [torch.optim.Adam(critic.parameters(), critic_lr) for critic in self.critics]
        self.step = 0
        self.total_past_rewards = self.create_past_reward_list()

    def create_past_reward_list(self):
        list = []
        for i in range(self.n_agents):
            list.append(0)
        return list

    def alpha_fair_utility_function(self, x):
        if self.alpha == 1:
            return np.log(x)
        return x ** (1 - self.alpha) / (1 - self.alpha)

    def utility_first_order_derivative(self, x):
        if self.alpha == 1:
            return 1 / x
        return 1 / (x ** self.alpha)

    def to_tensor(self, inputs):
        if torch.is_tensor(inputs):
            return inputs
        return torch.FloatTensor(inputs).to(self.device)

    def take_action(self, states):
        """
        :param states: [state 1, state 2, ..., state k]
        :return: [action1, action 2, ..., action k]
        """
        # numpy[n_states]-->tensor[1,n_states]
        states = [states]
        actions = []
        for state in states:
            action_prob = self.actor(self.to_tensor(state))
            action_dist = torch.distributions.Categorical(action_prob)
            action = action_dist.sample().item()
            actions.append(action)

        # for actor, state in zip(self.actors, states):
        #     # predict the probabilities of each action under current states
        #     action_prob = actor(self.to_tensor(state))
        #     # construct the probability distribution same as the probability of output actions
        #     action_dist = torch.distributions.Categorical(action_prob)
        #     # sample action from the distribution
        #     action = action_dist.sample().item()
        #     actions.append(action)
        return actions

    def calculate_adjust_rewards(self, current_rewards):
        """
        :param current_rewards: list [r1, r2, ..., rk]
        :param total_past_rewards: list [total_r1, total_r2, ..., total_rk]
        :return: sum of adjust rewards of all agents
        """
        adjust_rewards = 0
        if self.step == 0:
            adjust_rewards = sum(current_rewards)
        else:
            for i in range(self.n_agents):
                adjust_rewards += current_rewards[i] * self.utility_first_order_derivative(
                    self.total_past_rewards[i] / self.step)
        return adjust_rewards

    def learn(self, states, actions, rewards, next_states):
        # shape of tensor is [1, k]
        adjust_rewards = self.calculate_adjust_rewards(rewards)

        '''
        in the article, the author doesn't declare which structure of the algorithm, may the
        framework is centralized training and decentralized execution or centralized ?
        so here we will use the average of the all agents' state-value through network V to
        represent the V(st) and V(st+1) ->only one Actor-Critic
        '''
        next_states_V = sum(self.take_action(next_states)) / len(self.take_action(next_states))
        states_V = sum(self.take_action(states)) / len(self.take_action(states))
        advantage = adjust_rewards + self.gamma * next_states_V - states_V
        advantage = self.to_tensor(advantage)
        states = [self.to_tensor(state) for state in states]
        actions = [self.to_tensor(action) for action in actions]

        critic_loss = 0
        for i in range(self.n_agents):
            critic_loss += torch.log(self.critic(states[i], actions[i]))
        critic_loss = critic_loss * advantage

        actor_loss = 0
        for i in range(self.n_agents):
            actor_loss += self.actor(states[i])
        actor_loss = actor_loss * advantage

        self.critic_optim.zero_grad()
        critic_loss.backward()
        self.critic_optim.step()

        self.actor_optim.zero_grad()
        actor_loss.backward()
        self.actor_optim.step()

        self.step += 1
        for i in range(self.n_agents):
            self.total_past_rewards[i] += rewards[i]

        reward_ave = [pr / self.step for pr in self.total_past_rewards]
        utility_sum = 0
        for i in range(self.n_agents):
            utility_sum += self.alpha_fair_utility_function(reward_ave[i])

        return actor_loss, critic_loss, reward_ave, utility_sum
————————————————————————————
参考文献:
【1】J. Chen, Y. Wang and T. Lan, “Bringing Fairness to Actor-Critic Reinforcement Learning for Network Utility Optimization,” IEEE INFOCOM 2021 - IEEE Conference on Computer Communications, Vancouver, BC, Canada, 2021, pp. 1-10

 349


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


