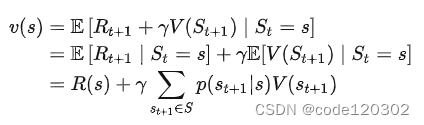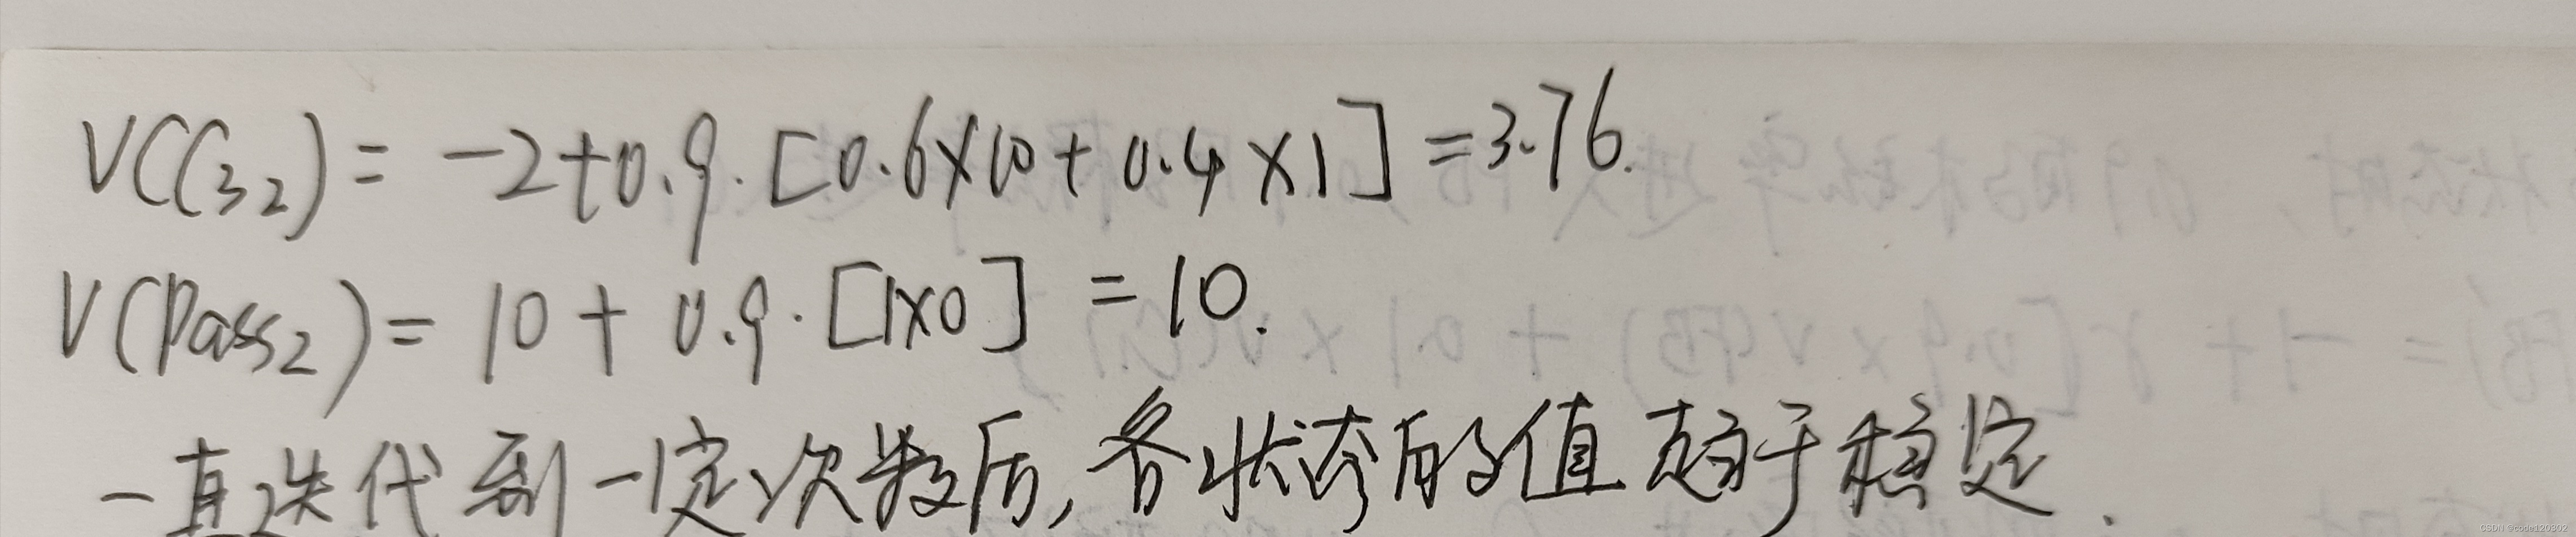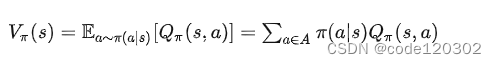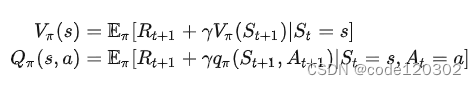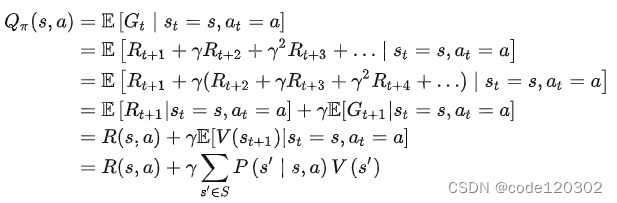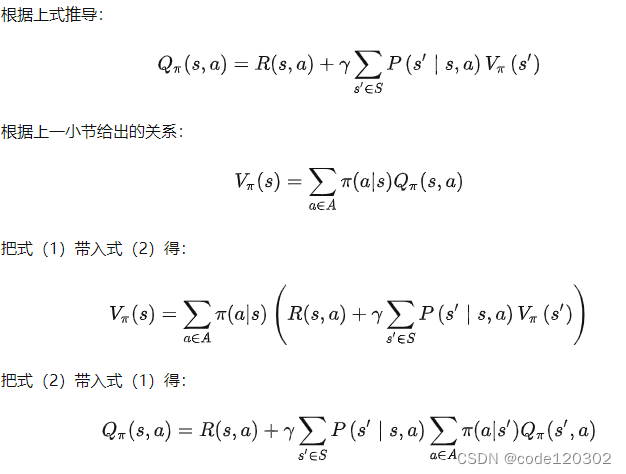马尔可夫决策过程详解

【详解+推导!!】马尔可夫决策过程 马尔可夫决策过程, Markov Decision Process, MDP 文章目录一、为什么需要马尔可夫决策过程?二、马尔可夫决策过程1. 马尔可夫性2. 随机过程3. 马尔可夫过程4. 马尔可夫决策过程三、策略与累计回报1. 策略2. 累计回报四、值函数1. 值函数2. “状态值函数”与“状态-行为值函数”五、什么是强化学习算法? 一、为什么需要马尔可夫决策过程? [外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-YTGUytIs-1616223214043)(2021-0 阅读详情

强化学习

强化学习的发展历史

  RL(Reinforcement Learning)从统计学、控制理论和心理学等多学科发展而来,是一个基于数学框架、由经验驱动的自主学习方法。RL的发展主线有3条:试错学习、最优控制和时间差分(Temporal-Difference,TD)学习。

最优控制方法
  最优控制用来描述通过设计控制器来最小化动态系统的行为随时间变化的测度问题。Bellman等人堆Hamilton、Jacobi理论进行了扩展,使用动态系统的状态和值函数定义了Bellman方程,哦通过求解Bellman方程来解决最优控制问题,即动态规划(Dynamic Programming)。而DP方法存在维数灾难(Curse of Dimensionality),后来Bellman引入最优控制问题的离散随机版本,称之为马尔可夫决策过程(Markov Decision Process,MDP)。

试错学习
  试错学习的本质为:每次采取的动作所产生的结果都会对之后的动作产生影响。若采取某个动作在某个状态下对结果的影响是正向的,那么后续再出现这个状态时,智能体(agent)有重复上次采取动作的倾向;若影响是负向的,那么后续将避免这个动作,称之为“效果定律”。效果定律的两个重要方面:选择性和关联性。智能体能够通过尝试对比选择合适的方案,找到的方案与特定情境相关。

TD学习
  TD学习的方法由同一时间内进行的连续估计之间的差异所驱动。1981年人们在试错学习中使用TD学习,形成了actor-critic架构,actor负责动作选择和执行,critic负责评价actor所选动作的好坏。1989年,Watkins将TD学习和最优控制完全融合在一起,发明了Q-learning。
在这里插入图片描述

强化学习简介

  RL本质是互动学习,让智能体与外界环境进行交互,其目标是使得agent在与环境的交互中得到最大的累计reward,从而学习到自身动作的最优控制。
  RL模型中三个关键部分:
(1) 状态(state):外界环境信息,状态体现环境的特征。
(2) 动作(action):感知环境后采取的行为,动作的表现形式可以是离散的,也可以是连续的。
(3) 奖励(reward):采取行动后获得的收益值,收益根据实际场景可以时正的也可以是负的。

深度强化学习简介

  由于单纯的RL可扩展性较差,且本质上仅限于维度相当低的问题,而深度神经网络强大的函数逼近和表示学习特性,能够解决高维、复杂场景下的RL问题。DL一个重要特征为:深度神经网络能够自动找到高维数据的低维表示(特征)。
DRL是DL领域的一个分支,目的是解决计算机从感知到决策控制的问题,从而实现通用人工智能。

  对于DRL来说,目前算法都包含在actor-critic框架下。
在这里插入图片描述
  actor模块负责选择动作执行,critic模块负责评估执行动作带来后果的好坏,根据r进行调整,指导action模块的动作选择。
  目前,DRL算法的分类如下:

  • 基于值函数(value-based)的DRL
  • 基于策略(policy-based)的DRL
  • 基于模型(model-based)的DRL
  • 基于分层(hierarchical-baased)的DRL

马尔可夫决策过程

马尔可夫过程

马尔可夫属性

未来状态只与当前状态有关,与过去无关。定义为:
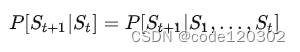
在这里插入图片描述
由于当前状态包含了历史中所有相关信息,只要知道了当前状态,所有历史信息就不再需要了。
对于一个马尔可夫状态s及其后续状态s’,状态转移概率P定义为:
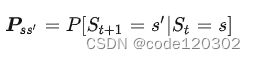
在这里插入图片描述
矩阵P定义为从所有的状态到所有后续状态s’的转移概率。行为当前状态s,列为后续状态s’,每行的和为1。
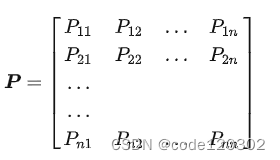
在这里插入图片描述

马尔可夫过程

马尔科夫过程是一个无记忆的随机过程。
马尔科夫过程又称为马尔科夫链(Markov Chain),可以用一个元组<S,P>表示,其中S是有限数量的状态集,P是状态转移概率矩阵。

马尔可夫奖励过程

马尔科夫奖励过程在马尔科夫过程的基础上增加了奖励R和折扣系数 γ \gamma γ,定义为元组<S,P,R, γ \gamma γ>,其中S是有限数量的状态集,P是状态转移概率矩阵,R是奖励函数,R(s) = E[R(t + 1) | St = s](E为期望), γ \gamma γ是折扣因子,[0,1]之间。例子如下图:
在这里插入图片描述

折扣因子

引入折扣因子的原因:

  1. 在带环的马尔可夫过程中避免陷入循环,达到收敛。
  2. 远期收益的不确定性越来越大,人们更关注眼前利益。

收益

Gt为从时间步t开始带折扣的奖励总和。
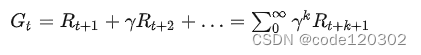
在这里插入图片描述
其中折扣因子体现了未来的奖励在当前时刻的价值比例, γ \gamma γ接近0,则表示注重眼前利益, γ \gamma γ接近1,则表示注重长期利益。

价值函数

价值函数分为两种,一种是状态-价值函数(state-value function),一种是动作-价值函数(action-value function)。
状态价值函数(state-value function)的定义:从该状态s开始的回报的期望,即
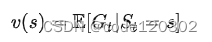
在这里插入图片描述
价值函数V(s)给出了某一状态的长期价值。
价值的计算方法:
通过贝尔曼方程进行迭代计算。
状态价值函数分为两部分:
一是该状态的即时奖励Rt+1
二是带折扣的该状态后续状态的价值函数
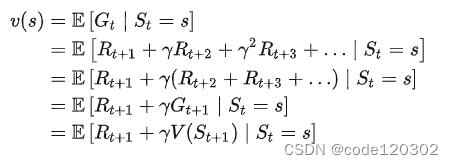
在这里插入图片描述
所以马尔可夫奖励过程的贝尔曼方程为:
在这里插入图片描述
贝尔曼方程定义了当前状态和下一个状态的迭代关系,即当前状态的价值函数可以通过下一个状态的价值函数来计算。

举例说明价值的计算:
在这里插入图片描述
取 γ \gamma γ为0.9,计算每个状态的价值。首先将每个状态的值函数表示出来:
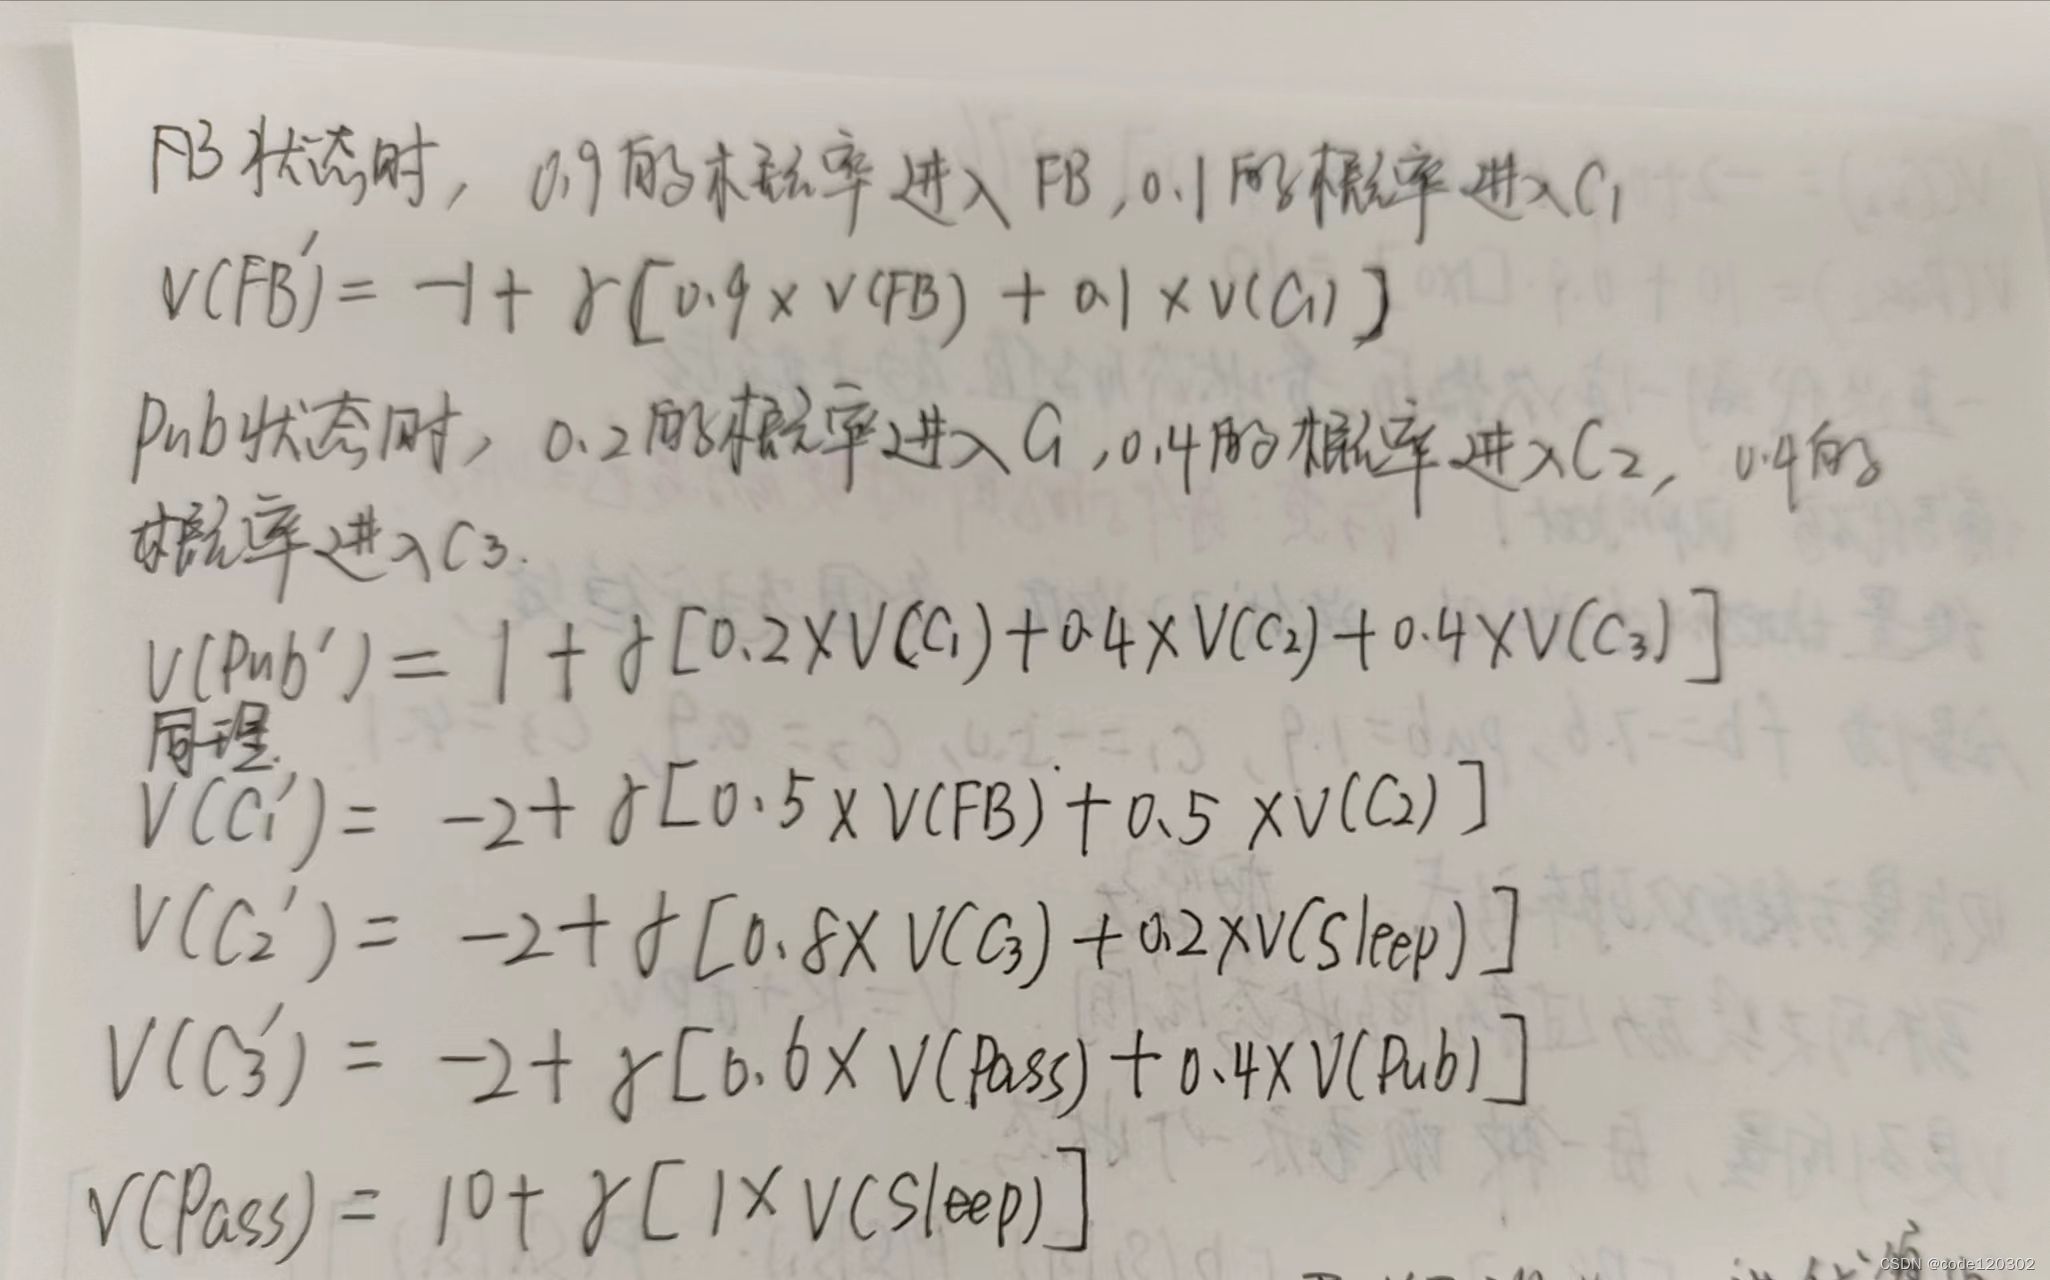
在这里插入图片描述
开始迭代计算V。各状态初始V值都为0,迭代算出各状态的后续状态的V(s),直到V值趋于稳定。
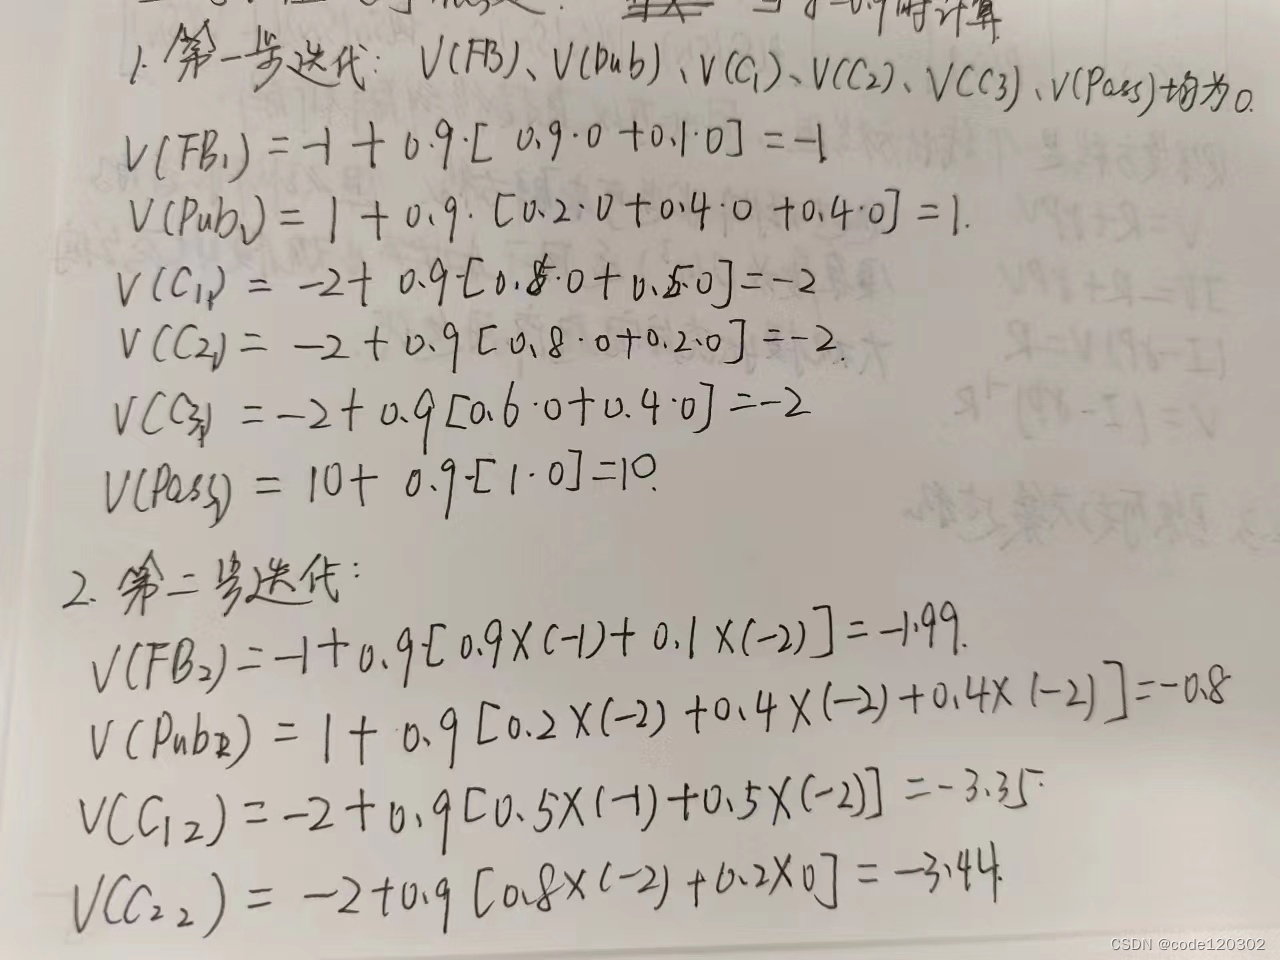
在这里插入图片描述
在这里插入图片描述
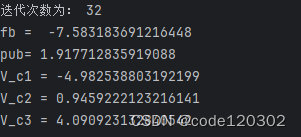
编写代码,设置threshold为0.01,结果如下:
在这里插入图片描述
可知经过32次迭代后V趋于稳定,稳定值如上图。

马尔可夫决策过程

马尔可夫决策过程在马尔可夫奖励过程的基础上加入决策,即定义为元组<S,A,P,R, γ \gamma γ>,S为有限数量的状态集,A为有限数量的动作集,P为状态转移概率矩阵,R为奖励函数。

策略

策略 π \pi π是给定状态时,关于动作a的分布,即
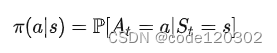
在这里插入图片描述

价值函数

  1. 状态-价值函数(state-value function)
    从状态s开始,执行策略能够获得收益的期望,衡量agent处于状态s时的价值。
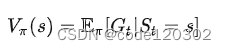
    在这里插入图片描述
  2. 动作-价值函数(action-value function)
    从状态s开始,采取动作a,执行策略能够后的收益的期望,衡量agent处于当前状态s并执行动作a时的价值大小。
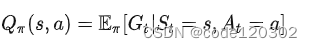
    在这里插入图片描述
    V和Q的关系为:
    在这里插入图片描述

贝尔曼期望方程

V和Q的贝尔曼方程如下:
在这里插入图片描述
对Q函数进行推导,有:
在这里插入图片描述
在这里插入图片描述

最优价值函数

  1. 最优状态价值函数:从策略产生的所有状态-价值函数中,使得状态s价值最大的函数。
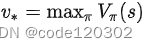
    在这里插入图片描述
  2. 最优动作价值函数:从策略产生的所有动作-价值函数中,选取使得状态动作对<s,a> 价值最大的函数。
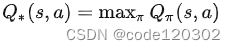
    在这里插入图片描述

贝尔曼最优方程

V的贝尔曼最优方程:一个状态的最优价值等于从该状态出发采取的所有动作产生的动作价值中最大的那个动作价值。
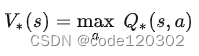
在这里插入图片描述
Q
的贝尔曼最优方程:在某个状态s下,采取某个动作的最优动作价值由两部分组成,一部分是离开状态 s 的即时奖励,另一部分则是所有能到达的后续状态 s’ 的最优状态价值与相应的转移概率的乘积后求和。
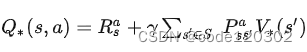
在这里插入图片描述
贝尔曼最优方程的求解Bellman最优方程是非线性的,通常采用迭代方法如Q-learning、Sarsa等求解。

————————————————————————————
参考资料:
【1】刘驰,王占健,戴子彭.深度强化学习学术前沿与实战应用[M].北京:机械工业出版社,2020
【2】https://zhuanlan.zhihu.com/p/494755866

马尔可夫决策过程 马尔可夫决策过程是强化学习中的一个核心概念,它提供了一种数学模型来描述决策者在不确定环境中进行决策的过程。本文详细介绍了马尔可夫决策过程的基本概念、性质、求解方法,并通过Python代码和LaTeX公式进行了深入解析。马尔可夫决策过程在许多实际应用中都有着广泛的应用,例如资源分配、生产调度、金融投资、机器人控制等。需要注意的是,马尔可夫决策过程的求解通常需要完全了解状态转移概率和奖励函数,这在实际应用中可能是困难的。 阅读详情

相关推荐

强化学习基础-马尔可夫决策过程(Markov Decision Process,MDP)

是一种数学框架,用于建模和求解序贯决策问题。它基于马尔可夫性质,通过定义状态、行动、转移概率函数和奖励函数来描述决策过程,并通过最优化方法来求解最优策略。本文将详细介绍马尔可夫决策过程的原理和数学公式。

m0_73916791的博客 6124

马尔可夫决策过程 Markov decision process MDP, 连续时间Markov chain, CMDP(全)

马尔可夫决策过程为决策者在随机环境下做出决策提供了数学架构模型,为动态规划与强化学习的最优化问题提供了有效的数学工具,广泛用于机器人学、自动化控制、经济学、以及工业界等领域。当我们提及马尔可夫决策过程时,我们一般特指其在离散时间中的随机控制过程:即对于每个时间节点,当该过程处于某状态(s)时,决策者可采取在该状态下被允许的任意决策(a),此后下一步系统状态将随机产生,同时回馈给决策者相应的期望值 ,该状态转移具有马尔可夫性质。 https://zhuanlan.zhihu.com/p/35354956

Anne033的博客 1万+

马尔可夫决策过程(MDP)详解

马尔可夫决策过程(MDP)详解 1. 背景介绍 马尔可夫决策过程(Markov Decision Process, MDP)是一种强大的数学框架,广泛应用于机器学习、人工智能、运筹学等诸多领域。MDP为研究基于环境状态和行动后果的最优决策提供了理论基础。在许多实际应用中,代理(agent)需要在

AI天才研究院 562

5、强化学习中的马尔可夫决策过程详解

本文详细介绍了强化学习中的核心概念——马尔可夫决策过程(MDP),包括策略、状态与行动价值函数、贝尔曼方程及其最优性方程。同时,文章还分析了不同类型的强化学习算法,如基于模型的算法和无模型算法,并探讨了它们的特点、适用场景以及选择合适算法的步骤。通过理论与实例相结合的方式,为理解和应用强化学习提供了全面的指导。

v6b7n8m9q0的博客 171

强化学习过程笔记 (二) MDP 马尔可夫决策过程、贝尔曼等式详解

Markov Process & Markov chain 马尔可夫过程及马尔科夫链 如果一个状态是符合马尔可夫的,那就是说一个状态的下一状态只取决于它当前的状态,而跟它之前的状态都没有关系。 Markov Reward Process 马尔可夫过程加上一个奖励函数便构成了马尔可夫奖励过程 这里我们进一步阐述和温习一些概念及定义。 Horizon指一个回合的长度(每个回合的最大时间步数),它由有限个步数决定的 Return指把奖励折扣后所获得的收益,可以定义为奖励的逐步叠加:

qq_37576300的博客 979

9、马尔可夫决策过程详解

本文详细介绍了马尔可夫决策过程(MDP)及其在强化学习中的应用。从马尔可夫链的基础知识入手,逐步讲解了马尔可夫奖励过程(MRP)、状态值和动作值函数的计算,以及贝尔曼方程的推导。随后深入探讨了MDP的定义、策略、状态-动作值函数及其贝尔曼方程的扩展形式。最后,文章介绍了求解MDP的常见方法,包括动态规划、蒙特卡罗方法和时序差分学习方法,并通过示例代码展示了具体实现过程。文章旨在为读者提供对马尔可夫决策过程的全面理解,并为强化学习的实际应用打下理论基础。

xray4的博客 125

12、无限期马尔可夫决策过程:理论与算法详解

本文深入探讨了无限期折扣马尔可夫决策过程(MDP)的理论基础与核心算法。基于马尔可夫链和巴拿赫空间理论,文章推导了策略价值的线性表示与贝尔曼最优性方程,并系统介绍了价值迭代、策略迭代、修改后的策略迭代、时间差分策略迭代及线性规划等求解方法。通过收敛性分析、复杂度比较与适用场景总结,提供了算法选择的实用指导。此外,文章从几何视角引入差异算子与贪婪策略集合,并讨论了实际应用中的参数调整与设计考量,为强化学习与最优决策问题提供了坚实的理论支持与实践路径。

k5l6m的博客 83

29、马尔可夫决策过程详解

本文详细介绍了马尔可夫决策过程(MDP)的核心概念与理论框架,涵盖决策策略、值函数、贝尔曼方程及其最优性原理。文章区分了确定性与随机策略的应用场景,阐述了状态值函数和动作值函数的定义及相互关系,并推导出贝尔曼方程与贝尔曼最优性方程。针对有限与无限时间范围问题,分析了其在动态规划和强化学习中的计算差异,尤其探讨了金融等领域中的实际应用。通过流程图与表格形式直观展示了关键概念之间的逻辑关系,为理解和实现MDP提供了系统性指导。

moss5的博客 113

11、马尔可夫决策过程(MDP)精确求解方法详解

本文详细介绍了马尔可夫决策过程(MDP)的精确求解方法,涵盖策略评估、策略迭代和价值迭代等核心算法。文章解释了MDP的基本组成、贝尔曼方程的数学基础,并对比了不同求解方法的实现方式、收敛性与时间复杂度。同时分析了折扣因子对收敛速度的影响、策略损失的界限,并以飞机避撞问题为例展示了MDP在实际中的应用。内容系统全面,适合研究顺序决策问题的读者参考。

read5的博客 82

19、决策制定与马尔可夫决策过程详解

本文深入探讨了决策制定中的核心方法,重点解析了影响图中的强连接树构建与吸收操作流程,并系统介绍了马尔可夫决策过程(MDP)的基本原理及其求解技术。内容涵盖消息传递最大化期望效用、贝尔曼方程、时间无界MDP的值迭代与策略迭代方法,以及基于变分推理的EM风格算法。通过网格世界和汉诺塔等案例分析,揭示了不同方法在实际应用中的表现与挑战。文章最后总结了各类方法的适用场景与优缺点,并展望了未来在高效算法设计、复杂环境适应及跨领域应用方面的发展方向。

w8x9y0z1的博客 58

21、部分可观测马尔可夫决策过程(POMDP)详解

本文详细介绍了部分可观测马尔可夫决策过程(POMDP),包括其基本概念、状态估计、值迭代算法以及强化学习中的应用。通过一个具体的示例,展示了在部分可观测环境下智能体如何进行状态估计和决策。文章还讨论了POMDP中规划与强化学习的区别与挑战,介绍了基于模型和无模型的强化学习算法类型。最后,针对POMDP的实际应用和面临的计算复杂度问题,提出了应对策略,并展望了未来的研究方向,如高效算法、模型学习与自适应策略以及跨领域应用的拓展。

k8l9m0n的博客 268

部分可观测马尔可夫决策过程(POMDP)形式化中信念状态更新的详解

在部分可观测马尔可夫决策过程(POMDP)形式化中,信念状态(belief state)是处理部分可观测性的核心机制。它将agent对环境真实状态的不确定性表示为一个概率分布,从而将POMDP问题转化为一个完全可观测的马尔可夫决策过程(MDP)——即信念MDP(belief-MDP)

阿正的梦工坊 1936

半马尔可夫决策过程(SMDP)算法详解与Python实现

半马尔可夫决策过程(SMDP)是马尔可夫决策过程(MDP)的扩展,它允许动作的执行时间是可变的。在SMDP中,智能体在状态sss采取动作aaa后,系统会在时间ttt后转移到下一个状态s′s's′,并收到奖励rrr。与MDP不同的是,SMDP中的时间ttt是一个随机变量,而不是固定的。本文详细介绍了半马尔可夫决策过程(SMDP)的核心概念,并使用Python实现了该算法。我们通过三个实际案例展示了SMDP的应用,并为每个案例选择了最适合的设计模式。

闲人编程的博客 1502

强化学习核心概念与马尔可夫决策过程详解

强化学习是机器学习的重要分支,专注于智能体通过与环境交互学习最优策略。其核心数学框架是马尔可夫决策过程(MDP),包含状态空间、动作空间、状态转移概率、奖励函数和折扣因子五个关键要素。与监督学习不同,强化学习依靠延迟且稀疏的奖励信号进行学习,这种特性使其特别适合游戏AI、机器人控制等序列决策问题。在实际应用中,部分可观测环境(POMDP)和奖励函数设计是需要重点解决的工程挑战。通过Bellman方程和动态规划算法,可以实现高效的价值函数计算和策略优化。理解这些基础概念对于掌握深度强化学习等进阶技术至关重要。

weixin_34026276的博客 329

18、影响图求解与马尔可夫决策过程详解

本文深入探讨了影响图的求解方法,重点分析了马尔可夫决策过程(MDP)中的最优决策计算。通过引入消息传递、联合树结构和贝尔曼方程,详细阐述了如何高效地进行期望效用最大化。文章涵盖了有限与无限时间范围下的MDP模型,介绍了值迭代和策略迭代两种核心求解算法,并提供了算法流程、示例代码及收敛性分析,为解决复杂规划问题提供了系统的理论基础与实践工具。

wdx01234567的博客 72

11、马尔可夫决策过程与强化学习详解

本文详细介绍了马尔可夫决策过程(MDP)与强化学习的基础理论,涵盖有限时间范围和无限时间范围问题的建模与求解方法。内容包括MDP的基本构成、策略评估与优化算法(如直接评估、蒙特卡罗方法、反向归纳),以及在最短路径和持续性任务中的应用。通过具体示例解析确定性与随机性环境下的决策策略,帮助读者理解强化学习的核心概念与实际应用方向。

k5l6m的博客 97

机器学习之强化学习(mdp 马尔可夫决策过程详解)

介绍了强化学习的组成与基本过程,区别了机器学习与强化学习的关系,简单介绍了强化学习中马尔可夫决策过程的基本组成与解决方案

m0_74209411的博客 1981

避开CPU瓶颈:手把手教你用RK3588的DMA-BUF实现V4L2到NPU的零拷贝数据流

本文详细介绍了如何在RK3588平台上利用DMA-BUF实现V4L2到NPU的零拷贝数据流,显著提升异构计算性能。通过实战指南展示了如何配置摄像头采集、RGA图像预处理和NPU推理优化,最终实现CPU占用率降低60%、延迟减少60%的效果,特别适合YOLOv5等AI推理应用的高效部署。

weixin_30374009的博客 571
上一篇: GAP问题近似算法
下一篇: 边缘-云在AIGC领域的应用与发展
code120302
博客等级 码龄7年 195粉丝 38原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值