【机器学习算法】——逻辑回归

[机器学习算法]逻辑回归模型、优缺点及spark ml机器学习库实现LR 目录 一、逻辑回归模型-log损失函数 1.1 模型定义 1.2 损失函数 1.3 梯度下降求解参数 二、利用最大似然估计求解逻辑回归模型参数 三、逻辑回归模型优缺点分析 四、spark ml机器学习库实现逻辑回归模型 五、离散特征作为模型输入 一、逻辑回归模型-log损失函数 1.1 模型定义    1.2 损失函数                    ... 阅读详情

逻辑回归原理

  • 逻辑回归是用来二分类的!

  • 是在线性回归模型之后加了一个激活函数(Sigmoid)将预测值归一化到【0~1】之间,变成概率值。

  • 因此:逻辑回归=线性回归模型+sigmoid激活函数
    在这里插入图片描述

  • 对于二分类任务来说,一般计算其中一个类别的概率P,自然会得到另一个类别的概率1-P。

  • 假如一个人是女生的概率是0.7,是男生的概率是多少呢?

    • 自然是0.3。
    • 那你会认为这个人是男生还是女生呢?
    • 当时是女生!
  • 一般认为概率最大的类别为分类结果。

损失函数

  • MSE loss:计算数值之间的差异 (线性回归)
  • BCE Loss:计算分布之间的差异(逻辑回归)
    在这里插入图片描述
    在这里插入图片描述

代码实现

# 导入必要的库
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
import matplotlib.pyplot as plt

# 准备数据
x_data = [1.0], [2.0], [3.0]
y_data = [0], [0], [1]

# 创建并拟合逻辑回归模型
model = LogisticRegression()
model.fit(x_data, y_data )

# 在测试集上进行预测
y_pred = model.predict(x_data)# predict预测的是值,可能是:[0,0,1]

# 计算准确率
accuracy = accuracy_score(y_data, y_pred)
print("Accuracy:", accuracy)


# 绘制决策边界
x = np.linspace(0, 10, 200).reshape(-1,1)#变成200行,1列
y = model.predict_proba(x)[:, 1]#predict_proba预测的是类别为1的概率值,取值范围为:[0,1]概率值[0.2,0.3,0.8]

plt.plot(x, y)
plt.plot([0, 10], [0.5, 0.5], c='r')#在概率=0.5时画一条红色直线;概率<0.5认为类别为0;概率>=0.5认为类别为1.
plt.xlabel('Hours')
plt.ylabel('Probability of Pass')
plt.grid()
plt.show()

在这里插入图片描述

练习

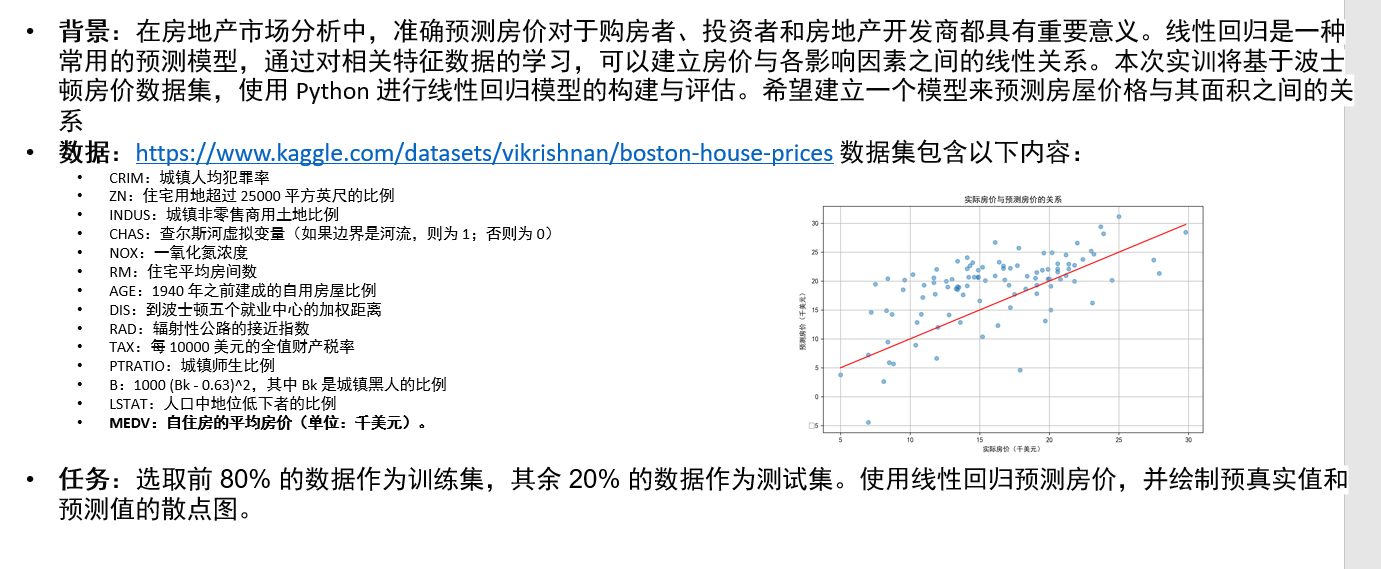
1. 波士顿房价预测

在这里插入图片描述

import pandas as pd
from sklearn.linear_model import LinearRegression
import matplotlib.pyplot as plt
import matplotlib
from sklearn.metrics import mean_squared_error

# 设置图片清晰度
plt.rcParams['figure.dpi'] = 300
matplotlib.rcParams['font.family'] = 'sans-serif'
matplotlib.rcParams['font.sans-serif'] = ['SimHei']  # 使用黑体

# 1.加载数据集
df = pd.read_csv('housing.csv', sep="\s+", header=None)

# 2.划分特征变量X和目标变量y
X = df.iloc[:, :-1].values  # 选择所有特征列
y = df.iloc[:, -1].values    # 选择目标列

# 3.手动划分训练集和测试集
train_size = int(len(df) * 0.8)
X_train = X[:train_size]
y_train = y[:train_size]
X_test = X[train_size:]
y_test = y[train_size:]

# 4.构建线性回归模型并训练
model = LinearRegression()
model.fit(X_train, y_train)

# 5.进行预测(测试集)
y_pred = model.predict(X_test)

# 6.计算mse loss
mse = mean_squared_error(y_test, y_pred)
print(f'Mean Squared Error: {mse:.2f}')

# 7.绘制实际房价和预测房价的散点图
plt.figure(figsize=(10, 6))
plt.scatter(y_test, y_pred, alpha=0.5)
# 绘制对角线
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], color='red')
#对角线表示理想预测:这一条线能帮助直观地判断模型效果。
#点的分布:如果大部分点靠近这条线,说明预测效果较好;如果远离,则可能意味着需要对模型进行调整或改进。
plt.xlabel('实际房价(千美元)')
plt.ylabel('预测房价(千美元)')
plt.title('实际房价与预测房价的关系')
plt.grid()
plt.show()

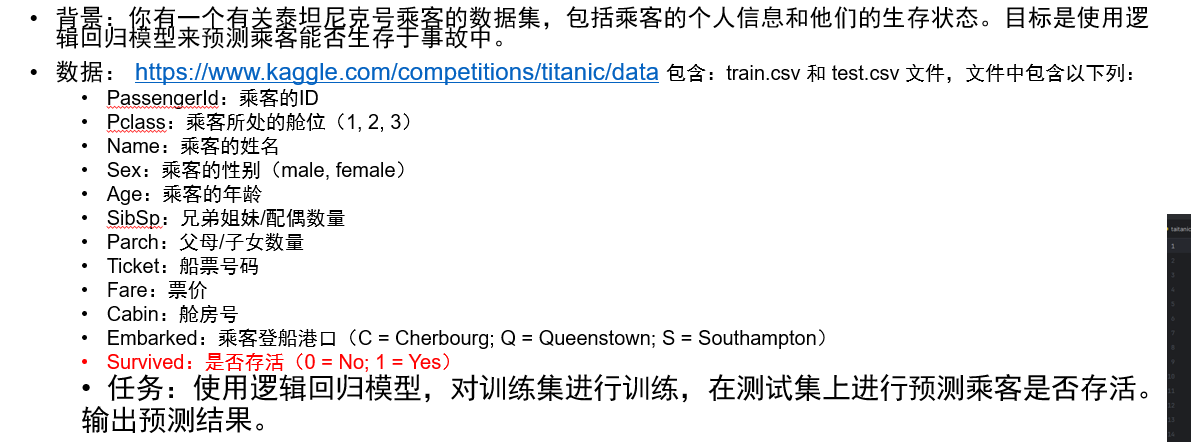
2.基于学生特征的录取概率预测
在这里插入图片描述

import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, log_loss
from sklearn.preprocessing import LabelEncoder

# 1.加载训练集和测试集
train_data = pd.read_csv('data/train.csv')
test_data = pd.read_csv('data/test.csv')

# 2.数据预处理
# 填充训练集和测试集的 Age 列缺失值为均值
train_data['Age'] = train_data['Age'].fillna(train_data['Age'].mean())
test_data['Age'] = test_data['Age'].fillna(test_data['Age'].mean())

# 填充测试集的 Fare 列缺失值为均值
test_data['Fare'] = test_data['Fare'].fillna(test_data['Fare'].mean())

# 填充训练集的 Embarked 列缺失值为众数
train_data['Embarked'] = train_data['Embarked'].fillna(train_data['Embarked'].mode()[0])

# 对 Sex 和 Embarked 列进行编码,进行编码是为了将分类变量转换为数值格式,以便可以被机器学习模型使用
label_encoder = LabelEncoder()
train_data['Sex'] = label_encoder.fit_transform(train_data['Sex'])
test_data['Sex'] = label_encoder.transform(test_data['Sex'])

train_data['Embarked'] = label_encoder.fit_transform(train_data['Embarked'])
test_data['Embarked'] = label_encoder.transform(test_data['Embarked'])

# 3.选择特征X_train、X_test 和目标变量y_train
features = ['Pclass', 'Sex', 'Age', 'SibSp', 'Parch', 'Fare', 'Embarked']
X_train = train_data[features]
y_train = train_data['Survived']

X_test = test_data[features]

# 4.构建逻辑回归模型
model = LogisticRegression(max_iter=1000)#max_iter 的默认值通常是 100,用于指定优化算法的最大迭代次数。如果你发现模型没有收敛或性能较差,可以尝试增加此参数。
model.fit(X_train, y_train)

# 5. 在测试集上进行预测
y_pred = model.predict(X_test)
#y_pred_prob = model.predict_proba(X_test)[:, 1]


# 6.将预测结果和 PassengerId 合并为一个 DataFrame
result_df = pd.DataFrame({
    'PassengerId': test_data['PassengerId'],
    'Survived': y_pred
})

print('预测结果:')
print(result_df.head())
# 7.将预测结果保存为 CSV 文件
result_df.to_csv('data/titanic_prediction.csv', index=False)


线性回归和逻辑回归是机器学习的基础
分类和回归也是机器学习的两个最重要的分支!

Spark ML机器学习算法svm,als,线性回归,逻辑回归简单试验 线性回归 导入训练集数据,将其解析为带label的RDD,然后使用LinearRegressionWithSGD 建立一个简单的线性模型预测label的值,最后计算了均方差来评估预测值与实际值的吻合度 object LinearRegressionModelDemo { def main(args: Array[String]): Unit = { 阅读详情

相关推荐

python机器学习手写算法系列——逻辑回归

从机器学习到逻辑回归 今天,我们只关注机器学习到线性回归这条线上的概念。别的以后再说。为了让大家听懂,我这次也不查维基百科了,直接按照自己的理解用大白话说,可能不是很严谨。 机器学习就是机器可以自己学习,而机器学习的方法就是利用现有的数据和算法,解出算法的参数。从而得到可以用的模型。 监督学习就是利用已有的数据(我们叫X,或者特征),和数据的标注(我们叫Y),找到x和y之间的对应关系,或者说是函...

juwikuang的专栏 1万+

spark 逻辑回归算法案例_黄美灵的Spark ML机器学习实战

原标题:黄美灵的Spark ML机器学习实战本课程主要讲解基于Spark 2.x的ML,ML是相比MLlib更高级的机器学习库,相比MLlib更加高效、快捷;ML实现了常用的机器学习,如:聚类、分类、回归等算法。本课拒绝枯燥的讲述,将循序渐进从Spark2.x的基础知识开始,然后再透彻讲解各个算法的理论、详细展示Spark实现,最后均会通过实例进行解析实战,帮助大家真正从理论到实践全面掌握Spar...

weixin_29174385的博客 478

机器学习算法概述:随机森林&逻辑回归

摘要:机器学习算法入门介绍:随机森林与逻辑回归! 随机森林是用于分类和回归的监督式集成学习模型。为了使整体性能更好,集成学习模型聚合了多个机器学习模型。因为每个模型单独使用时性能表现的不是很好,但如果放在一个整体中则很强大。在随机森林模型下,使用大量“弱”因子的决策树,来聚合它们的输出,结果能代表“强”的集成。 权衡偏差与方差 在任何机器学习模型中,有两个误差来源:偏差和方差。为了更...

阿里云云栖号 7684

ML算法——逻辑回归随笔【机器学习】

计算假阳率的方法是,将预测为正例的样本数量除以所有的负例样本数量。在实际应用中,假阳率高的模型可能会导致过多的误判,因此需要尽可能降低模型的假阳率。假阳率主要出现在分类问题中。在评估分类模型的性能时,假阳率是一个重要的指标,特别是在模型应用于关键决策时。例如,在医疗诊断中,高假阳率可能会导致对病人进行不必要的治疗或手术,因此需要尽可能降低模型的假阳率。Logic Regression (LR),逻辑回归的因变量是二分类的,而不是连续的。参照线性回归中的θ,这里的θ也是个向量,涵盖所有提到过的θ分量,θ=

cold的博客 2309

机器学习算法-逻辑回归(LR)

虽说线性回归无法直接用于分类预测,但可以对其加层映射:将连续无穷输出映射到指定的有限输出。逻辑回归(Logistic Regression, LR)便是基于此思想在线性回归的结果上加上一个逻辑函数,将连续输出映射到$[0,1]$输出。逻辑回归是统计学习中的经典分类方法,通过历史数据的表现对未来结果发生的概率进行预测分类,概率大于一定阈值,输出为1,否则输出为0。

AI_BigData_WH的博客 1375

STDP实战:用PyTorch从零搭建脉冲神经网络(附完整代码)

本文提供了基于PyTorch从零搭建脉冲神经网络的实战教程,重点讲解了STDP学习规则的原理与工程实现。通过构建LIF神经元模型和向量化STDP层,并结合泊松编码,详细演示了如何构建一个能够进行无监督特征学习的混合网络架构,为探索神经形态计算和低功耗实时学习方案提供了完整代码与实践指南。

weixin_29056145的博客 266

[ML]机器学习_逻辑回归算法

输出变量只能取少数可能值中的一个,而不是无线数字范围内的任何数字。也指得到的输出变量的值是的而并非连续的。

iazzz的博客 166

逻辑漏洞:水平越权、垂直越权靶场练习

水平越权和垂直越权是组织中常见的管理问题,指的是员工在组织中所拥有的权力和责任超出其职位所应具备的范围。 水平越权是指员工在同一级别的职位上超越了其同事的权力和责任范围,通常表现为某个员工在团队中承担了过多的任务或权力,导致其他同事感到不公平或不满。 垂直越权则是指员工在组织中超越了其职位等级的权力和责任范围,通常表现为员工在没有得到上级批准的情况下做出决策或行动,可能会导致组织内部的混乱和冲突。

qq_68163788的博客 2470

机器学习——逻辑回归算法实验

一、算法概述逻辑回归,虽然名字中包含“回归”,但实际上是一种分类算法,主要用于处理二分类问题。它的基本原理是通过一个称为“逻辑函数”或“Sigmoid函数”的数学函数,将输入的特征向量映射到一个概率值,该概率值用于描述样本属于正类的可能性。

qq_73559660的博客 1213

Easymesh之拓扑模块(二)

介绍 easymesh 拓扑消息:Topo discovery、Topo notification、Topo query、Topo response

qq_53619687的博客 2153

HFSS - 侧馈矩形微带天线设计与仿真

一、设计指标 中心频率:2.45GHz 介质板厚度:1.6mm 介质板相对介电常数:4.4 二、理论计算 辐射贴片宽度w=c2f(εr+12)−12w=\frac{c}{2 f}\left(\frac{\varepsilon_{r}+1}{2}\right)^{-\frac{1}{2}}w=2fc​(2εr​+1​)−21​ 辐射贴片长度L=cfεe−2ΔLL=\frac{c}{f \sqrt{\varepsilon_{\mathrm{e}}}}-2 \Delta LL=fεe​​c​−2ΔL

MaxWei 1万+

机器学习之逻辑回归算法

文章目录逻辑回归原理推导逻辑回归求解 逻辑回归(Logistic Regression)是机器学习中的一种分类模型,它是一种分类算法,虽然名字中带有回归,但是它与回归之间有一定的联系。 看到回归二字,很多人可能会认为逻辑回归算法是线性回归算法的升级,还是属于回归任务吧?其实并不是这样的,逻辑回归本质上是一个经典的二分类问题,要做的任务性质发生了变化,也就是一个是否或者说0/1问题,有了线性回归的基础,只需稍作改变,就能完成分类任务。 由于逻辑回归算法的简单和高效,在实际中应用非常广泛,比如判断是否为垃圾邮件

自成背后的博客 7592

【WRF-Chem 工具】CAMStoWRF详解:CAMS数据下载及处理

【WRF-Chem 工具】CAMStoWRF详解:CAMS数据下载及处理

WW、forever的博客 195

OpenCV机器学习(5)逻辑回归算法cv::ml::LogisticRegression

cv::ml::LogisticRegression 是 OpenCV 机器学习模块中的一个类,用于实现逻辑回归算法。逻辑回归是一种广泛应用于分类问题的统计方法,特别适合二分类任务。尽管名字中有“回归”二字,但它主要用于预测数据点属于某个类别的概率。

jndingxin的专栏 882

ARM与PC共享文件方式【samba】移植与配置

方式推荐指数适用平台优点缺点⭐⭐⭐⭐⭐全平台 (Win/Mac/Linux)兼容性最强,操作像本地文件配置稍繁琐,协议开销略大NFS⭐⭐⭐⭐Linux/Mac (Win支持一般)速度极快,CPU占用低Windows配置复杂,权限管理较难SFTP (SSH)⭐⭐⭐⭐全平台 (需客户端)安全加密,无需额外配置服务需使用FileZilla/Xftp等专用软件物理U盘⭐⭐⭐全平台无需网络,速度取决于接口需要人工插拔,不适合自动化Syncthing⭐⭐⭐⭐全平台自动同步,支持远程。

浩瀚之水的专栏 263

Android面试必考问题:Android性能优化最全面试题及参考答案(8万字长文)

Android 中的 OOM(Out Of Memory,内存溢出)异常是指应用程序在运行过程中,由于申请的内存空间超过了系统所能提供的最大内存限制而导致的错误。在 Android 中,内存泄漏是指应用中的某些对象在不再被使用后,仍然被其他对象持有引用,导致这些对象无法被垃圾回收器回收,从而占用内存空间,随着时间的推移可能会导致应用内存不足,甚至崩溃。在一次开发 Android 应用的过程中,我发现应用在长时间运行后会出现内存占用过高的情况,导致应用变得卡顿,甚至可能会被系统强制关闭。

大模型大数据攻城狮的专栏 2532

ML机器学习算法(一): 基于逻辑回归的分类预测

机器学习算法(一): 基于逻辑回归的分类预测 1 逻辑回归的介绍和应用 1.1 逻辑回归的介绍 逻辑回归(Logistic regression,简称LR)虽然其中带有"回归"两个字,但逻辑回归其实是一个分类模型,并且广泛应用于各个领域之中。虽然现在深度学习相对于这些传统方法更为火热,但实则这些传统方法由于其独特的优势依然广泛应用于各个领域中。 而对于逻辑回归而且,最为突出的两点就是其模型简单和模型的可解释性强。 逻辑回归模型的优劣势: 优点:实现简单,易于理解和实现;计算代价不高,速度很快,存

我就吃一口的BLOG 1683

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

【机器学习】机器学习的分类算法以及使用逻辑回归算法进行分类

探索分类数据集和绘图,确定线性回归不足以进行逻辑回归。

ya的博客 1236

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

ML算法——逻辑回归(LR)

逻辑回归是一种用于分类任务的线性模型,它是建立在线性回归的基础上,通过将线性回归模型的结果利用一个函数映射到离散值上来实现分类的。线性回归试图学得一个通过样本属性的线性组合来进行预测的函数,即 &lt;div align=center&gt;                        (1) 向量形式写成 fx=wx+b                              (2)...

zhangwenliu的博客 836

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

【机器学习】十大算法之一 “逻辑回归”

逻辑回归算法是一种用于分类问题的机器学习算法,其基本原理是利用线性回归模型对数据进行拟合,并通过逻辑函数对结果进行分类。逻辑回归算法的主要特点是模型简单、计算方便,并且能够处理大规模数据。我们可以将逻辑回归算法应用于二分类问题和多分类问题中,对于二分类问题,逻辑回归算法通常将数据分为两个类别,例如阴性和阳性,假和真等;而对于多分类问题,逻辑回归算法则可以将数据分为多个类别。逻辑回归算法是实现二分类和多分类问题的一种流行算法。这种算法在概率建模方面展现了良好的特性,它能够输出范围在0和1之间的标签概率值。

Code_and516的博客 1598

【机器学习】--- 逻辑回归算法

逻辑回归是机器学习的一种分类算法,主要运用于二分类问题。将线性回归的结果,映射到不同的类别之中。算法简单而高效,实际广泛运用。简单来说:逻辑回归 = 线性回归 +SigmoidSigmoidSigmoid函数(分类函数)

人工智能专业学生 2089

机器学习逻辑回归算法

在医疗领域,逻辑回归可以帮助医生根据患者的症状、检验指标等因素判断是否患有某种疾病,例如预测患者是否患有糖尿病、心脏病等。总体而言,逻辑回归虽有局限,但凭借简单实用的特性,在合适场景中能发挥重要作用。逻辑回归作为常用的机器学习分类算法,应用背景广泛,在医疗、金融、营销等多领域助力分类决策其基本原理围绕逻辑函数构建模型,通过最大似然估计结合梯度下降等方法确定参数。算法分析方面,优点是简单高效、可解释性强、输出易理解,缺点为受线性假设限制、对特征处理要求高、易欠拟合。逻辑回归通过最大似然估计来确定参数和。

池央的博客 1231

ML之分类预测:以六类机器学习算法(kNN、逻辑回归、SVM、决策树、随机森林、提升树、神经网络)对糖尿病数据集(8→1)实现二分类模型评估案例来理解和认知机器学习分类预测的模板流程

ML之分类预测:以六类机器学习算法(kNN、逻辑回归、SVM、决策树、随机森林、提升树、神经网络)对糖尿病数据集(8→1)实现二分类模型评估案例来理解和认知机器学习分类预测的模板流程 目录 六类机器学习算法(kNN、逻辑回归、SVM、决策树、随机森林、提升树、神经网络)对糖尿病数据集(8→1)实现二分类预测 数据集理解 1、kNN 2、逻辑回归 3、SVM 4、决策树 5、随机森林 6、提升树 7、神经网络 相关文章 ML之分类预测:以六类机器学习算法(kNN、逻辑回归

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

机器学习之逻辑回归和k-means算法(六)

无监督学习就是让计算机自己从数据里找规律,不需要我们提前告诉它“正确答案”。它只需要数据的特征(比如年龄、收入、消费频率等),不需要标签(比如“用户是否流失”)。最常见的无监督学习任务就是聚类,也就是把相似的数据自动分到一组。簇:就是一组相似的数据点,算法会把它们归为一类。质心:就是每个簇的“中心点”,是这个簇中所有点的平均值。K-means 就是一个不断“找中心、分数据、再重新找中心”的过程,直到数据分组稳定下来。

Hao_diedie的博客 1297

【机器学习】逻辑回归算法

逻辑回归算法学习目标1. 逻辑回归的介绍1.1 逻辑回归的应用场景1.2 逻辑回归的原理1.2.1 输入1.2.2 激活函数1.3 损失以及优化1.3.1 损失1.3.2 优化1.4 小结2. 逻辑回归api介绍3. 案例:癌症分类预测-良/恶性乳腺癌肿瘤预测3.1 背景介绍3.2 案例分析3.3 代码实现4. 分类评估方法4.1 分类评估方法4.1.1 精确率与召回率4.1.1.1 混淆矩阵4.1.1.2 精确率(Precision)与召回率(Recall)4.1.2 F1-score4.1.3 分类评估

全网粉丝30W+,优快云、稀土掘金人工智能领域签约作者,人工智能、大模型、Python 爬虫,商务合作,请私信沟通。 7146
上一篇: 【机器学习算法】——线性回归
下一篇: CenOS7安装与配置
chairon
博客等级 码龄7年 964粉丝 172原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值