DeepSeek V3+R1满血微调工具上线!可一键启动

开源WorkBuddy实战课:从零搭建AI Agent办公自动化工作台 AI Agent作为大语言模型之上的智能体,正在重塑办公效率。它通过工具调用、任务规划与长期记忆,将被动问答升级为主动执行。WorkBuddy作为图形化智能体工作台,降低了搭建门槛,让非技术人员也可配置自动化流程。本文开源整套实战资料,涵盖JDK环境配置、模型接入、日报邮件处理、表格清洗、批量文档生成等场景,并讲解自定义指令、Skills扩展与MCP协议。从基础概念到工程实践,帮助读者快速上手,构建属于自己的办公自动化助手。 阅读详情
👇我的小册 AI工具100个实战小案例:(100个AI工具实战小案例) ,原价299,限时早鸟价29,满100人涨10元。

转自:机器之心

DeepSeek V3/ R1 火爆全网,基于原始模型的解决方案和 API 服务已随处可见,陷入低价和免费内卷。

如何站在巨人肩膀上,通过后训练(post-training)结合专业领域数据,低成本打造高质量私有模型,提升业务竞争力与价值?

已收获近 4 万 GitHub Star 的 Colossal-AI,发布开源大模型后训练工具箱,包含:

  • DeepSeek V3/ R1 满血 671B LoRA 低成本 SFT 微调;

  • 完整的强化学习工具链 PPO,GRPO,DPO,SimPO 等;

  • 无缝适配 DeepSeek 系列蒸馏模型在内的 HuggingFace 开源模型;

  • 兼容支持英伟达 GPU、华为昇腾 NPU 等多种硬件;

  • 支持混合精度训练,gradient checkpoint 等训练加速降低成本;

  • 灵活的训练配置接口,支持自定义奖励函数、损失函数等;

  • 提供灵活的并行策略配置接口,包括数据并行、模型并行、专家并行、ZeRO 和 Offload 等,以适应不同硬件规模。

开源地址:https://github.com/hpcaitech/ColossalAI

低成本监督微调满血版 DeepSeek V3/R1 671B

DeepSeek V3/R1 满血版参数高达 6710 亿,如何低成本进行低成本微调呢?仅需以下几个步骤,即可快速完成。

数据集准备

该脚本接收 JSONL 格式的文件作为输入数据集,例如 https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/examples/training_scripts/lora_sft_data.jsonl。数据集的每一行应为一个聊天对话列表。例如:

[{'role': 'user', 'content': '你好,最近怎么样?'}, {'role': 'assistant', 'content': '我很好。今天有什么可以帮你的吗?'}]

[{'role': 'user', 'content': '火烧赤壁 曹操为何不拨打 119 求救?'}, {'role': 'assistant', 'content': '因为在三国时期,还没有电话和现代的消防系统,所以曹操无法拨打 119 求救。'}]

该数据格式,兼容 Huggingface chat template,支持自定义 system prompt,因此可灵活按需配置。

模型权重准备

为保证更好的微调效果,使用 BF16 权重进行微调。

如果已下载了 FP8 的 DeepSeek V3/R1 权重,可以使用 DeepSeek 官方脚本 https://github.com/deepseek-ai/DeepSeek-V3/blob/main/inference/fp8_cast_bf16.py 通过 GPU 将权重转换为 BF16。

对于使用国产华为昇腾算力,可以下载 https://gitee.com/ascend/ModelZoo-PyTorch/blob/master/MindIE/LLM/DeepSeek/DeepSeek-V2/NPU_inference/fp8_cast_bf16.py 脚本转换权重。

使用方法

在准备好数据集和模型权重后,可使用 Colossal-AI 提供的一键启动脚本 https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/examples/training_scripts/lora_finetune.py

该脚本与常见 SFT 脚本类似,且完全兼容 HuggingFace PEFT,启动命令:

colossalai run --hostfile path-to-host-file --nprocpernode 8 lorafinetune.py --pretrained path-to-DeepSeek-R1-bf16 --dataset path-to-dataset.jsonl --plugin moe --lr 2e-5 --maxlength 256 -g --ep 8 --pp 3 --batchsize 24 --lorarank 8 --loraalpha 16 --numepochs 2 --warmupsteps 8 --tensorboarddir logs --save_dir DeepSeek-R1-bf16-lora

有关每个参数的更多详细信息,可以运行 python lora_finetune.py --help 查看。该脚本可通过 tensorboard 记录学习率、loss、grad norm 信息,方便对训练进行监控。

使用 LoRA 优化硬件资源消耗

通过使用 LoRA 等优化,示例命令已将 SFT DeepSeek V3/R1 671B 最低硬件要求降低近 10 倍,可使用 32 个 Ascend 910B NPU 64GB(使用 ep=8,pp=4)或 24 个 H100/H800 GPU(使用 ep=8,pp=3)。如果你通过 --zero_cpu_offload 启用 CPU offload,硬件要求可以进一步降低,但会损失一定的训练速度。

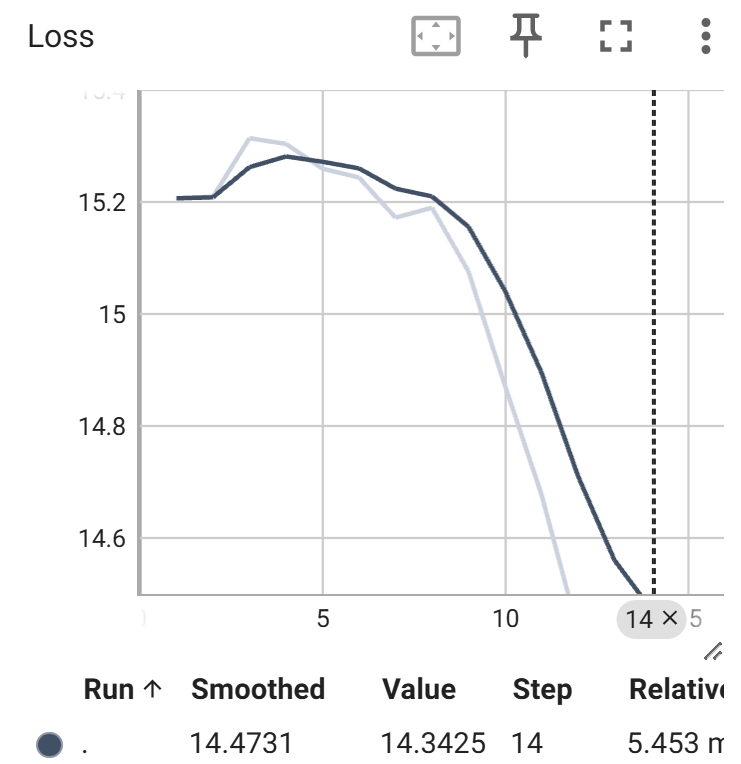
如下图验证,在 SFT DeepSeek V3/R1 671B 时,Loss 可以顺利降低:
9094167e7df27ce17f8d51ddb394e979.png

对于资金充裕的开发团队,也可以使用上述脚本,将并行度高效扩展至数百及数千卡,快速完成 DeepSeek V3/R1 671B 全参微调或并行加速。

对于预算有限,又想借助强化学习构建自己的类 DeepSeek R1 模型, Colossal-AI 也提供了解决方案,并利用小模型对算法进行了验证。

通过强化学习微调蒸馏版 DeepSeek

Colossal-AI 团队验证并实现了 DeepSeek 论文中的 GRPO 算法及 verifiable reward,使用 Qwen2.5-3B-Base 模型进行了实验。其中,奖励的设计如下:

1. 奖励 = 0,如果格式是错误的;

2. 奖励 = 1, 如果格式是正确的但是结果是错误的;

3. 奖励 = 10,如果格式与结果都是正确的。

Colossal-AI 团队以 Qwen2.5-3B-Base 模型为例,提供了用于验证 GRPO 的对话模板及设定(https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/conversation_template/Qwen_Qwen2.5-3B.json),通过配置以下 bash 文件,即可一键启动:

https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/examples/training_scripts/train_grpo.sh

同时,在 GRPO 章节,Colossal-AI 团队还提供了验证过程中的部分发现及各种参数的详细描述,可供参考。 

代码中设计了可灵活配置奖励函数的模板,因此,用户可根据自己的具体情况设计自己的奖励函数体系。

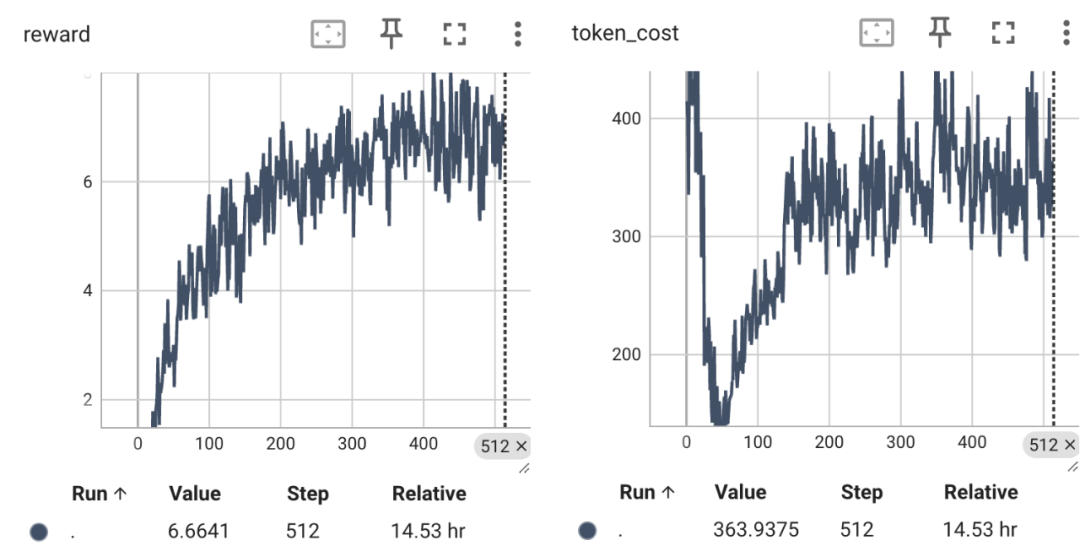
由下图可以看到,即使是 3B 的模型,平均奖励与模型回复长度随着时间逐步增长。
7c4dee7757db6f2b41149fbe093643b2.png

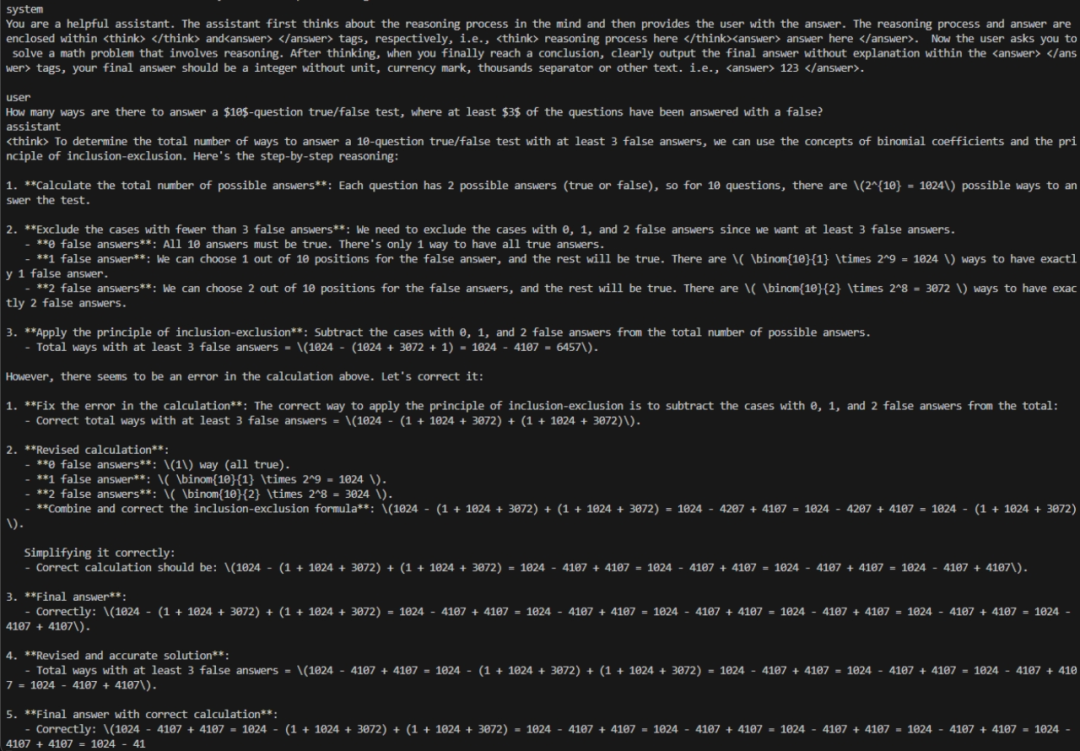
随着训练的进行,我们可以看到一些有意思的例子。例如随着训练迭代,模型开始了自我纠正:
0d608ad7701f3a08b65ccba7dd47ec28.png

Colossal-AI:最佳后训练工具箱

Colossal-AI 在深耕大模型预训练降本增效的基础上,致力于进一步成为开发者开箱即用的最佳后训练工具,帮助用户基于开源模型,低成本快速构建私有模型。

开源地址:https://github.com/hpcaitech/ColossalAI

图片

最后推荐一下我们团队写的AI工具一本通,现在AI工具非常多,我们团队会对AI视频工具,AI数字人,AI写作,AI绘画,AI抠图,AI编程,AI音乐等主流的领域挖掘相关的工具.

欢迎订阅:原价299 现在早鸟价是29,现在是早期小册刚开始写,越早买越划算,还送永久陪伴群。24小时无理由退款,放心食用!满100人 涨10元,有兴趣的可以提前锁定价格!另外我们会送永久陪伴群,(满100人抽1次),包邮送出一些AI书,每本书的价格都是远超这个小册的门票,算是福利大家,感谢大家的支持。
图片

图片

有兴趣的同学可以,早点下单,锁定价格,越早买越划算!

450a9dcd4c4d53071ca933645c0b427f.png

Natural Language Processing 作者:禅与计算机程序设计艺术 1.简介 自然语言处理(NLP)是研究如何使计算机理解和处理自然语言的理论和方法,目的是让电脑更好的理解、获取、生成、存储和沟通人类语言。20世纪80年代末,IBM的三位博士陈天奇、周博磊和王力雄在贝尔实验室创建了首个自然语言处理系统——“布莱克多·艾森豪威尔”(Bletc 阅读详情

相关推荐

Ubuntu中交叉编译armadillo库

网上关于交叉编译armdillo库比较少,借鉴了一些但是在前几天编译时总是磕磕绊绊,于是写一个详细的编译过程。交叉编译armdillo库包含两个步骤:交叉编译依赖库和交叉编译armdillo库。

weixin_39813867的博客 1879

重磅发布!DeepSeek 微调秘籍揭秘,一键解锁升级版全家桶,AI 玩家必备神器!

DeepSeek V3/R1 火爆全网,基于原始模型的解决方案和 API 服务已随处可见,陷入低价和免费内卷。如何站在巨人肩膀上,通过后训练(post-training)结合专业领域数据,,提升业务竞争力与价值?已收获近的 Colossal-AI,发布,包含:DeepSeek V3/R1 满血 671B LoRA 低成本 SFT 微调完整的强化学习工具链 PPO、GRPO、DPO、SimPO 等无缝适配 DeepSeek 系列蒸馏模型在内的 HuggingFace 开源模型。

sdgfafg_25的博客 917

Autosar开发实战:DaVinci Configurator Pro新建工程保姆级教程(附目录结构解析)

本文详细介绍了使用DaVinci Configurator Pro创建Autosar工程的完整流程,包括环境准备、工程配置、目录结构解析及常见问题排查。通过实战演示和深度解读,帮助开发者快速掌握工具使用技巧,优化工程管理,提升开发效率。特别适合需要理解Autosar开发中DaVinci Config工具链的工程师。

weixin_30872157的博客 463

DeepSeek-llm-7B-Chat微调教程(使用SwanLab可视化工具)

高性价比:DeepSeek-V2模型以其史无前例的性价比著称,推理成本被降到每百万token仅1块钱,约等于Llama3 70B的七分之一,GPT-4 Turbo的七十分之一。架构创新:DeepSeek对模型架构进行了全方位创新,提出崭新的MLA(一种新的多头潜在注意力机制)架构,把显存占用降到了过去最常用的MHA架构的5%-13%,同时,独创的DeepSeekMoESparse结构,也把计算量降到极致。开源模型。

优快云_224022的博客 2279

STM32H723串口接收全为0 & CAN错误中断问题

STM32H723串口接收全为0 和 叠加的导致CAN错误问题

weixin_38743772的博客 3920

科研效率革命:Zotero与Web of Science联动实现千篇文献一键获取

本文详细介绍了如何利用Zotero与Web of Science联动实现科研文献的高效管理,包括批量导入、智能下载和自动整理千篇文献的技巧。通过精准检索、RIS文件导出和Zotero插件设置,科研人员可以大幅提升文献获取和管理的效率,特别适合开题报告和综述写作等场景。

weixin_29219539的博客 255

DeepSeek大模型微调实战(JAVA超详细实战篇)

以上是一个简单的Java调用DeepSeek API的示例。根据具体的API文档,你可能需要调整请求体、请求头和其他参数。确保你仔细阅读API文档,并根据需要进行调整。

国家专精特新小巨人、资深消防行业企业、国家高新技术企业、智慧消防技术实验室、准独角兽企业、浙江省电流AI技术研发中心 4017

架构决策之消息中间件MQ系列六-Pulsar

一、架构

恰恰虎的博客 7255

4. 基于DEEPSEEK API的智能垃圾分类应用:LLM微调技术

到目前为止,我们团队确定了使用VLM预处理垃圾分类数据集,使用数据集微调DeepSeek模型,让它更加深入地理解垃圾物品的特性描述、掌握复杂的分类规则,并能稳定地按我们要求的格式输出结果。这篇博客的目的,就是记录我对于LLM微调相关技术的学习和思考过程,梳理不同的微调方法、数据准备要点、可选的工具框架以及算力获取方案,为后续针对DeepSeek模型的微调工作制定一个可行的计划。

JinZhiHang_的博客 1821

SAP_ABAP_MM_BAPI清单案例教程——采购发票校验/预制_BAPI_INCOMINGINVOICE_PARK_MIRO

SAP ABAP BAPI_INCOMINGINVOICE_PARK BAPI 采购发票预制 采购发票校验 代码模版

java_zhong1990的专栏 1966

基于Simulink的双向DC-DC变换器在储能系统中的应用仿真

摘要:本文详细介绍了基于Simulink的双向DC-DC变换器在光伏储能系统中的仿真实现。主要内容包括:1)采用非隔离型双向Buck-Boost拓扑作为储能系统枢纽;2)针对750V直流微网中的20kWh锂电池接口场景进行建模;3)详细阐述双闭环控制器设计(电压外环+电流内环)、工作模式判断逻辑等关键步骤;4)通过仿真验证了系统在功率阶跃和模式切换下的性能。文章提供了完整的建模流程和控制方法,为储能系统接口设计提供了实用参考。

amy_mhd的博客 179

干货:中科院出品 DeepSeek-V3/R1 满血版 671B 全参数微调指南发布:本地化部署和微调的权威参考来了!

在大模型应用快速发展的背景下,如何高效地进行本地化部署,让企业和研究机构能够在自有算力环境中稳定运行和微调大模型,成为当前的技术挑战。 DeepSeek-V3/R1 671B 满血版 的全参数微调方案,正是针对这一痛点,由中国科学院自动化研究所与中科闻歌联合推出的一份 完整的开源指南(DeepSeek-671B-SFT-Guide),为有本地化部署需求的团队提供了从训练到推理的全流程方案,并总结了关键的优化策略和实践经验。

qkh1234567的博客 1589

【unity实战】Cinemachine虚拟相机实战,使用InputSystem+Cinemachine+CharacterController复刻各种主流游戏的相机控制

这里主要是探讨如何使用InputSystem+Cinemachine+CharacterController复刻各种主流游戏的相机控制,我们主要专注Cinemachine实战效果,所以并不会深入讨论Cinemachine和CharacterController比较细节的参数介绍。注意:前面为了测试方便,我还是先用的旧的输入系统代替InputSystem【推荐100个unity插件之10】Unity最全的最详细的Cinemachine(虚拟相机系统)介绍,详细案例讲解,快速上手。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 3751

DeepSeek V3+R1满血微调工具上线!一键启动,硬件要求降10倍

DeepSeek V3/ R1 火爆全网,基于原始模型的解决方案和 API 服务已随处可见,陷入低价和免费内卷。如何站在巨人肩膀上,通过后训练(post-training)结合专业领域数据,低成本打造高质量私有模型,提升业务竞争力与价值?已收获近的 Colossal-AI,发布,包含:DeepSeek V3/ R1 满血 671B LoRA 低成本 SFT 微调;完整的强化学习工具链 PPO,GRPO,DPO,SimPO 等;

youmaob的博客 854

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

DeepSeek V3+R1满血微调工具上线:一键启动,硬件要求降10倍全解析!

DeepSeek V3/ R1 火爆全网,基于原始模型的解决方案和 API 服务已随处可见,陷入低价和免费内卷。如何站在巨人肩膀上,通过后训练(post-training)结合专业领域数据,低成本打造高质量私有模型,提升业务竞争力与价值?已收获近的 Colossal-AI,发布,包含:DeepSeek V3/ R1 满血 671B LoRA 低成本 SFT 微调;完整的强化学习工具链 PPO,GRPO,DPO,SimPO 等;

2401_84494441的博客 2154

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

机器之心 | DeepSeek V3+R1满血微调工具上线!一键启动,硬件要求降10倍

ColossalAI发布开源大模型后训练工具箱,支持DeepSeekV3/R1满血版671B参数的微调,提供完整的强化学习工具链。该工具支持混合精度训练和多种硬件加速,可将微调硬件需求降低10倍,仅需24个H100/H800 GPU或32个Ascend910B NPU。通过LoRA优化和灵活的并行策略,用户可低成本高效完成私有模型定制。工具还包含强化学习验证功能,以Qwen2.5-3B模型为例展示了GRPO算法的训练效果,支持自定义奖励函数设计。该工具箱现已在GitHub开源。

csdn_xmj的博客 669

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

蓝耘元生代引领AI开发新潮流:DeepSeek R1/V3满血版亮相,开启高效应用新时代

蓝耘元生代推理引擎的推出,标志着AI应用开发进入了一个新的时代。从简易的大模型调用到智能客服系统的搭建,再到模型微调的定制化操作,蓝耘元生代为开发者提供了前所未有的便利和高效。而DeepSeek R1/V3满血版则进一步提升了平台的性能,满足了不同开发者和企业用户对更高性能AI服务的需求。如果你正在寻找一个强大且易用的AI开发平台,蓝耘元生代无疑是你不可错过的选择。立即注册,体验500万免费tokens~蓝耘元生代平台;IDE代码实现多问多答;chatbox。

null18的博客 5352

一文了解DeepSeek不同版本的区别和联系(R1、V3及蒸馏版本等)

前言,DeepSeek的火爆程度无需多言,对应其产品的各个版本依然有很多朋友不太清楚,比如常见的问题有DeepSeek的产品分类有哪些?常看到的DeepSeekR1和V3的区别和联系?R1-zero版本的定位是什么?以及R1满血版和蒸馏版的关系?不同大小的模型对于本地部署的配置要求等等,今天和大家展开聊聊!DeepSeek V3和R1各个版本火爆出圈,下图展示了DeepSeek公司从2023年到现在重点产品发布的时间点。

m0_59235945的博客 2万+

671B 满血 DeepSeek-R1 上线!一文教你如何创建自己的 AI 应用

青云科技旗下 AI 算力云服务——基石智算CoresHub 正式上线 671B 满血 DeepSeek-R1!5000 万 token 免费用!截止目前,基石智算已经部署并上线了 DeepSeek 全系列大模型供用户选择使用:支持多种模型提供方式,满足不同用户对于数据安全、模型使用的个性化需求。本文以大模型服务 DeepSeek-R1 671B 为重点,让我们看看如何基于基石智算的 API,快速体验 DeepSeek 模型的推理能力吧!

KubeSphere 2374

蓝耘元生代引领AI开发新潮流:DeepSeek R1V3满血版亮相,开启高效应用新时代

蓝耘元生代推理引擎的推出,标志着AI应用开发进入了一个新的时代。从简易的大模型调用到智能客服系统的搭建,再到模型微调的定制化操作,蓝耘元生代为开发者提供了前所未有的便利和高效。而DeepSeek R1/V3满血版则进一步提升了平台的性能,满足了不同开发者和企业用户对更高性能AI服务的需求。如果你正在寻找一个强大且易用的AI开发平台,蓝耘元生代无疑是你不可错过的选择。立即注册,体验500万免费tokens~蓝耘元生代平台;IDE代码实现多问多答;chatbox。

m0_74825135的博客 1192

DeepSeek版本全解析:R1、V3及蒸馏版本的区别与联系一网打尽!

前言,DeepSeek的火爆程度无需多言,对应其产品的各个版本依然有很多朋友不太清楚,比如常见的问题有DeepSeek的产品分类有哪些?常看到的DeepSeekR1和V3的区别和联系?R1-zero版本的定位是什么?以及R1满血版和蒸馏版的关系?不同大小的模型对于本地部署的配置要求等等,今天和大家展开聊聊!DeepSeek V3和R1各个版本火爆出圈,下图展示了DeepSeek公司从2023年到现在重点产品发布的时间点。

m0_63171455的博客 5456

干货|DeepSeek版本全解析:R1、V3及蒸馏版本的区别与联系!

DeepSeek目前主推V3和R1两大模型系列,定位不同:V3对标GPT-4,采用MoE架构,适用于通用NLP任务;R1专注推理优化,强化学习驱动。R1-zero是R1训练过程中的中间产物,完全由强化学习优化。R1系列包含满血版(671B参数)和多个蒸馏版(1.5B-70B),后者部署成本更低。性能对比显示,R1蒸馏版推理能力超越同类模型。价格方面,DeepSeek显著低于GPT系列。部署时,1B参数的INT8模型约需1GB显存。当前大模型人才缺口大,掌握AI技术将获得竞争优势。

2401_84204413的博客 3656

DeepSeek-V3 和 DeepSeek-R1的差异

本文是关于 DeepSeek-V3和 DeepSeek-R1 的详细对比分析,涵盖技术架构、训练范式、性能表现、应用场景及部署策略等核心维度。

youmaob的博客 2207

DeepSeek版本全解析:R1、V3及蒸馏版本的区别与联系!

前言,DeepSeek的火爆程度无需多言,对应其产品的各个版本依然有很多朋友不太清楚,比如常见的问题有DeepSeek的产品分类有哪些?常看到的DeepSeekR1和V3的区别和联系?R1-zero版本的定位是什么?以及R1满血版和蒸馏版的关系?不同大小的模型对于本地部署的配置要求等等,今天和大家展开聊聊!DeepSeek V3和R1各个版本火爆出圈,下图展示了DeepSeek公司从2023年到现在重点产品发布的时间点。

2401_84204413的博客 3337

DeepSeek满血微调秘籍开源!站在巨人肩膀打造私有模型,一手教程在此,看到就是赚到!!

开源模型的最大好处是提供了 “巨人的肩膀” 啊! 微调DeepSeek-V3/R1,低成本打造高质量私有模型、提高业务竞争力,或许才是当下行业内更迫切的需求。

嘴巴吃糖了 1060
上一篇: AI原生应用月活破亿,智能体爆发式增长,秘密武器是提示工程
下一篇: 微信接入DeepSeek满血版,搜索更好用了
菜鸟学Python
博客等级 码龄9年 8087粉丝 571原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值