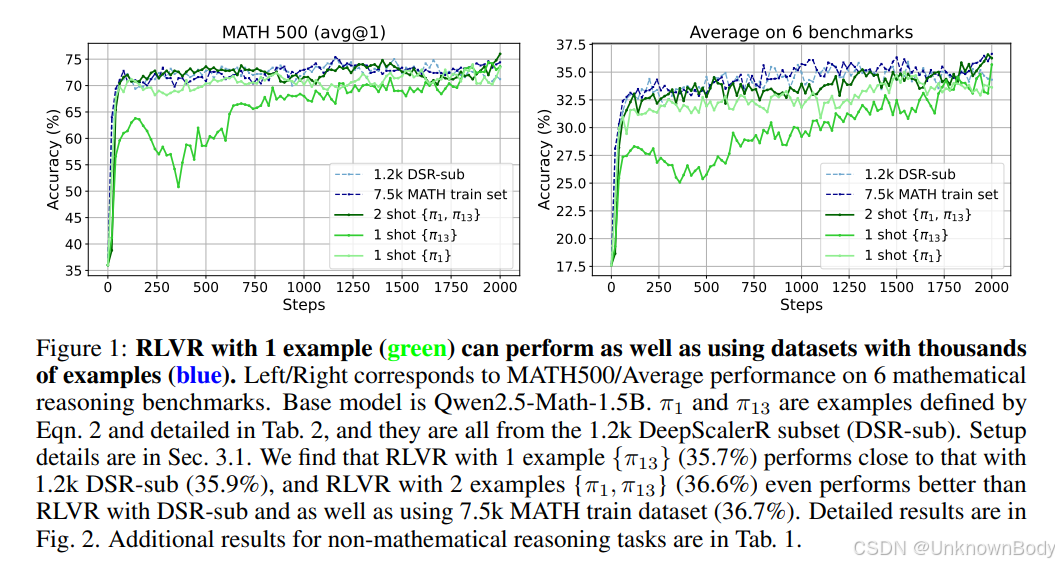
Reinforcement Learning for Reasoning in Large Language Models with One Training Example

在这里插入图片描述

主要内容

  1. 研究背景:强化学习与可验证奖励(RLVR)在提升大语言模型(LLMs)推理能力方面取得显著进展,但RLVR数据方面的研究相对不足,如训练数据的数量、质量和有效性等问题有待探索。
  2. 研究方法
    • 采用GRPO作为强化学习算法,其损失函数包含策略梯度损失、KL散度损失和熵损失。
    • 提出基于历史方差分数的数据选择方法,通过训练模型获取每个示例的历史训练准确率列表,按其方差对数据进行排序。
  3. 实验设置
    • 模型:以Qwen2.5 - Math - 1.5B为主进行实验,并验证了Qwen2.5 - Math - 7B、Llama - 3.2 - 3B - Instruct和DeepSeek - R1 - Distill - Qwen - 1.5B等模型。
    • 数据集:从DeepScaleR - Preview - Dataset中随机选取1209个示例作为数据选择的实例池(DSR - sub),并使用MATH训练集进行对比。
    • 训练与评估:遵循verl管道进行训练,设置多种超参数,使用多个数学推理基准和非数学推理任务进行评估。
  4. 实验结果
【202511】Cosmos-Predict2.5-01-数据篇:用于PhysicalAI的基于视频基础模型的世界模拟【2亿原始视频(3500万小时)➞60亿片段➞4%➞2亿高质量片段(140万H)】 3.5×我们推出 [Cosmos-Predict2.5],这是 Cosmos 物理人工智能世界基础模型的最新一代产品。基于流式架构构建的 [Cosmos-Predict2.5] 将 Text2World、Image2World 和 Video2World 生成功能整合于单一模型之中,并借助物理人工智能视觉语言模型 [Cosmos-Reason1],提供更丰富的文本锚定能力以及对世界模拟的更精细控制。 阅读详情

相关推荐

Training Large Language Models for Reasoning through Reverse Curriculum Reinforcement Learning

在本文中,我们提出了R3R^3R3:通过反向课程强化学习进行学习推理(RL),这是一种仅使用结果监督来实现大型语言模型过程监督的新方法。将RL应用于复杂推理的核心挑战是确定一系列能产生积极回报的行动,并为优化提供适当的监督。结果监督在不识别错误位置的情况下为最终结果提供稀疏的奖励,而过程监督提供逐步奖励,但需要大量的手动注释。R3R^3R3通过从正确的演示中学习克服了这些限制。具体地说,R3R^3R3将推理的开始状态从演示的结束逐渐滑动到开始,有助于在所有阶段更容易地进行模型探索。

c_cpp_csharp的专栏 446

2025_NIPS_Reinforcement Learning for Reasoning in Large Language Models with One Training Example

我们证明,使用单个训练样本的可验证奖励强化学习(1-shot RLVR)能有效激发大语言模型(LLMs)的数学推理能力。将RLVR应用于基础模型Qwen2.5-Math-1.5B,我们发现一个单一样本可将模型在MATH500基准上的性能从36.0%提升至73.6%(较格式修正额外提升8.6%),并将6个常见数学推理基准的平均性能从17.6%提升至35.7%(非格式相关增益7.0%)。

c_cpp_csharp的专栏 42

π0.7:a Steerable Generalist Robotic Foundation Model with Emergent Capabilities

Figure 1: Fig. 1: We introduce π0.7\pi _ { 0 . 7 }π0.7​ , a steerable generalist robot foundation model that can perform dexterous tasks across many tasks, environments, and robots. π0.7\pi _ { 0 . 7 }π0.7​ is trained with diverse prompts that contain not

u013250861的博客 80

深入解析EXI协议在ISO15118-2命令测试中的编解码实践

本文深入探讨了EXI协议在ISO15118-2车桩通信标准中的关键作用与实践方法。EXI编解码测试是确保通信准确性与效率的核心环节,文章详细介绍了从搭建测试环境、选择工具库到编写完整测试代码的全过程,并分析了结果差异的常见原因与调试技巧,为电动汽车充电系统的开发者提供了实用的技术指南。

potato的博客 1050

VSCode+ESP-IDF开发环境搭建:从零开始创建你的第一个物联网项目(2024最新版)

本文详细介绍了如何在2024年使用VSCode和ESP-IDF搭建物联网开发环境,从零开始创建第一个物联网项目。内容包括环境准备、ESP-IDF配置、项目创建与结构解析、构建烧录步骤以及高级技巧和常见问题解决方案,帮助开发者快速上手ESP32开发。

weixin_29165725的博客 332

Cadence IC618版图DRC验证License报错排查:从虚拟机网络配置到HOSTID的实战解析

本文详细解析了Cadence IC618版图设计中DRC验证License报错的排查方法,重点从虚拟机网络配置到HOSTID获取的实战经验。通过对比ifconfig与ip add命令的差异,提供了正确的HOSTID获取方式及License文件修改技巧,帮助工程师快速解决IC618环境下的DRC验证问题。

weixin_30823001的博客 680

为什么PCB设计中的50Ω阻抗如此重要?从USB到以太网的实战解析

本文深入解析了PCB设计中50Ω特征阻抗的核心重要性及其工程权衡起源。文章从传输线理论出发,阐释了阻抗匹配对防止信号反射、确保信号完整性的关键作用,并对比了USB、以太网等不同应用场景的阻抗标准。同时,文章结合实际案例,剖析了在两层板等简单设计中实现精准阻抗控制的难点与实战解决方案。

weixin_29268385的博客 298

用 ABAP RAP + XCO 把 Excel 导入业务对象:从弹窗 Action 到 EML 落库与附件清理的完整实践

摘要:本文介绍了在SAP RAP框架下实现Excel批量导入功能的完整方案。通过XCO库的XLSX模块解析Excel文件,结合RAP的行为定义和Fiori Elements界面集成,构建了一个支持试运行、数据校验和自动合并的业务导入功能。方案采用RAP标准范式,包括Action参数设计、EML事务处理、附件管理以及异常消息反馈,实现了从文件上传到数据落库的端到端流程,既保证了系统稳定性,又提升了业务用户体验。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 278

在 SAP S/4HANA Private Cloud 中把标准 CDS View 发布为 OData:可操作的四条路径与完整示例

在 ADT 中创建。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 726

把 ABAP 开发对象装进 XML 行李箱:SAPlink 安装、插件、升级与协作迁移全指南

SAPlink是一款用于在SAP NetWeaver系统间导入导出ABAP对象的工具,特别适合临时协作、系统孤岛等场景。它通过XML文件(Slinkee和Nugget两种格式)传输开发对象,支持插件扩展多种对象类型。安装时需注意版本兼容性、权限和激活流程,使用时要区分覆盖选项的风险。相比正式运输系统,SAPlink更适用于快速共享、原型交付等非生产场景,但需配合命名规范和协作策略确保可维护性。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 156

TypeError: ‘<=‘not supported between instances of ‘float’and ‘str‘解决方案

本文主要介绍了TypeError: '

weixin_43178406的博客 28万+

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

上一篇: LLM Weekly(2025.04.28-05.04)
下一篇: Phi-4-Mini-Reasoning: Exploring the Limits of Small Reasoning Language Models in Math
UnknownBody
博客等级 码龄16年 5601粉丝 4739原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

UnknownBody

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


