【图神经网络:原理与实战】2 深度学习与表示学习预备

【图书推荐】《图神经网络基础、模型与应用实战》 图神经网络不仅能够解决传统机器学习方法无法解决的图数据问题,而且能够应用于许多实际场景,例如社交网络、药物发现、网络安全、金融风控等。本书旨在为初学者和实践者提供一个详细、全面的入门指南,围绕图神经网络基础、模型、应用实战(均采用Python+PyTorch实现)等方面进行介绍。本书配套示例源码、数据集、PPT课件。 阅读详情

目录

2 深度学习与表示学习预备

2.1 优化与训练基础

2.1.1 反向传播与链式法则在图模型上的应用

(一) 单层消息传递的前向定义

(二) 反向传播的链式法则:逐步推导

(三) 正确性与数值实现要点

2.1.2 常用优化器与正则化技巧

(一) 梯度下降(GD)与随机梯度下降(SGD)

(二) 动量法(Momentum)与 Nesterov 加速

(三) 自适应学习率类:AdaGrad、RMSProp、Adam

(四) 优化器的收敛性直观与提示

(五) 正则化技巧的数学解释

2.1.3 批归一化、层归一化与训练稳定性

(一) Batch Normalization(批归一化)

(二) Layer Normalization(层归一化)

(三) 归一化技巧对训练条件数与收敛的影响(直观与数学线索)

2.1.4 随机性、梯度方差与收敛准则

(一) Mini-batch 梯度的无偏性与方差

(二) SGD 在光滑与凸 / 强凸情形下的收敛分析(关键推导)

(三) 收敛准则(实践角度)

本章小结与实践要点

2.2 注意力机制与 Transformer 基要

2.2.1 自注意力的数学形式与矩阵推导

前向定义与线性投影

矩阵化表达

证明(标量定义与矩阵化表达等价)

缩放因子的理论依据

多头注意力(Multi-Head Attention)

2.2.2 位置编码与相对位置编码方法

绝对位置编码:正弦余弦位置编码(Sinusoidal PE)

可学习的绝对位置嵌入(Learned PE)

相对位置编码(Relative Positional Encoding)

小结(位置编码选择的数学权衡)

2.2.3 注意力稀疏化与近似方法

一、窗口/局部注意力(Local Attention)

二、稀疏图模式(Sparse Patterns)

三、低秩近似(Low-Rank Approximations)

四、随机特征与核化线性注意力(Linearized Attention)

五、局部 + 全局混合(Sparse + Low-rank Hybrid)

六、哈希与子线性近似(LSH)

比较与误差控制的总体原则

2.2.4 Transformer 的归一化与残差结构

网络块的形式化定义

残差连接的线性化与恒等映射作用

LayerNorm 的作用与 pre-LN vs post-LN 的差异

​编辑​编辑

残差与归一化对最优化风景(loss landscape)的影响

实际实现的训练建议(基于理论分析)

本节小结

2.3 表示学习基础与自监督原理

2.3.1 表示学习目标与可辨识性准则

记号与基本设定

命题 2.3.1(充分性与下游贝叶斯风险不变性)

可辨识性与不变性的问题

2.3.2 对比学习的损失函数与信息量视角

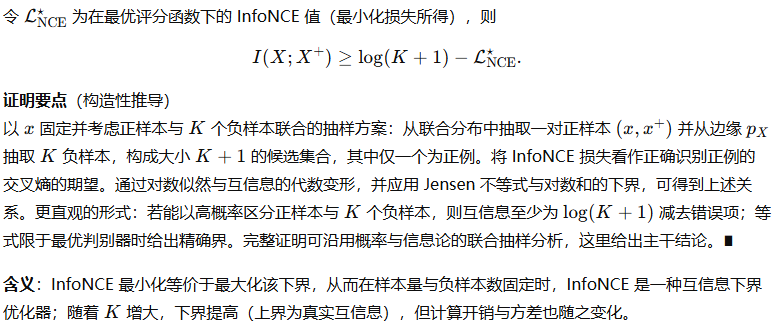
InfoNCE 损失的定义

命题 2.3.2(InfoNCE 的最优判别函数与密度比)

InfoNCE 与互信息的下界(InfoNCE bound)

有限容量与负样本偏差

对比损失与判别器视角的等价性

2.3.3 重构、预测与生成型自监督任务

A. 自编码器(Autoencoder)与最小重构误差

B. 变分自编码器(VAE)与 ELBO 推导

C. 预测型自监督(Masked Prediction / Contrastive Predictive Coding)

D. 生成式自监督(自回归模型)

2.3.4 表示的可迁移性与泛化界定

定义(迁移性能与线性探针)

命题 2.3.4(充分性对迁移性的保证)

泛化界(统计学习论角度)

信息论的一般化界(互信息—泛化连接)

迁移性度量的下界(任务多样性与下游性能)

实用启示的数学归纳

本节结论与教学要点


2 深度学习与表示学习预备

本章作为教材性质的技术预备,系统、严格地给出训练深度神经网络所需的优化与训练基础。内容包括:反向传播与链式法则在图模型(Graph Neural Networks)上的具体应用、常用优化器的推导与性质、正则化技巧的数学解释、归一化层(BatchNorm / LayerNorm)的前向与反向推导以及随机性、梯度方差与收敛准则的定量分析。所有推导逐步进行、给出必要假设与结论,便于课堂教学和科研参考。


2.1 优化与训练基础

2.1.1 反向传播与链式法则在图模型上的应用

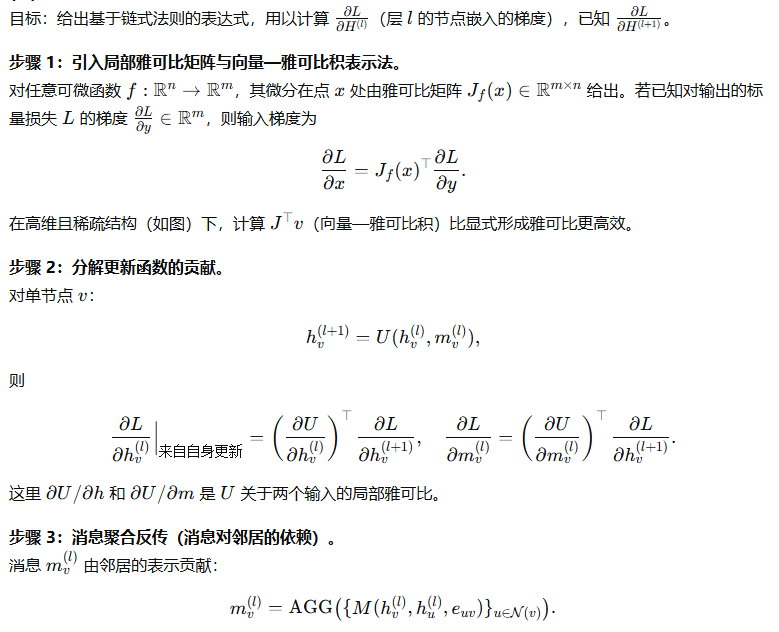
图神经网络(GNN)以图为结构单元,其基本操作是消息传递(message passing)与节点态的更新。为清晰起见,先给出单层通用消息传递格式,再对其反向传播(梯度传递)做严格推导。

(一) 单层消息传递的前向定义

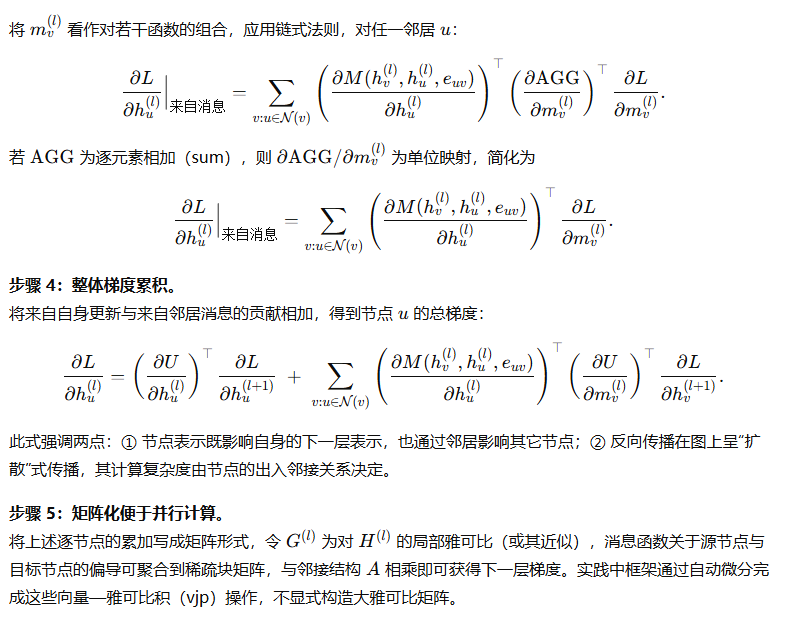
(二) 反向传播的链式法则:逐步推导
(三) 正确性与数值实现要点
  1. 链式法则保证正确性:以上每一步仅依赖函数可微与链式法则,故数学上严格正确。

  2. 并行与稀疏性利用:通过邻接矩阵稀疏乘法与局部 vjp,可并行计算各节点梯度。

  3. 内存与反向传播深度问题:多层 GNN 的反向会在图上引入大范围依赖,造成内存增长;常用技巧包括邻居采样(GraphSAGE)、分层存储或逐层检查点(checkpointing)。

  4. 自动微分实现:实践中利用反向模式自动微分(reverse-mode AD)高效计算向量—雅可比积,避免显式构造 Jacobian。


2.1.2 常用优化器与正则化技巧

本节先对若干常用优化器给出数学形式与等价解读,再讨论常用正则化技巧的数学性质。

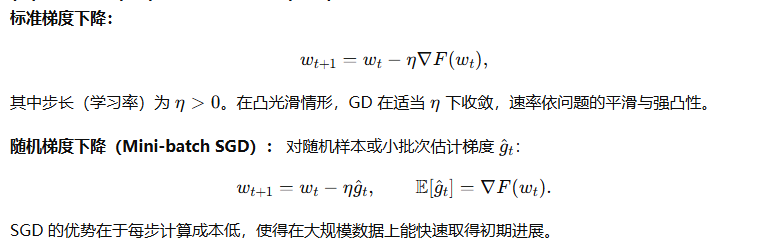
(一) 梯度下降(GD)与随机梯度下降(SGD)
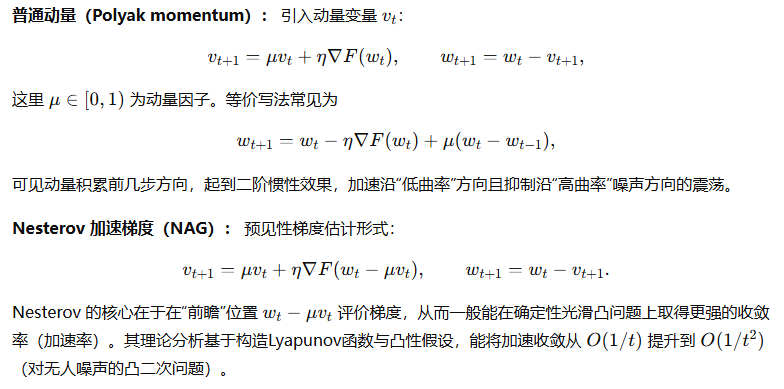
(二) 动量法(Momentum)与 Nesterov 加速
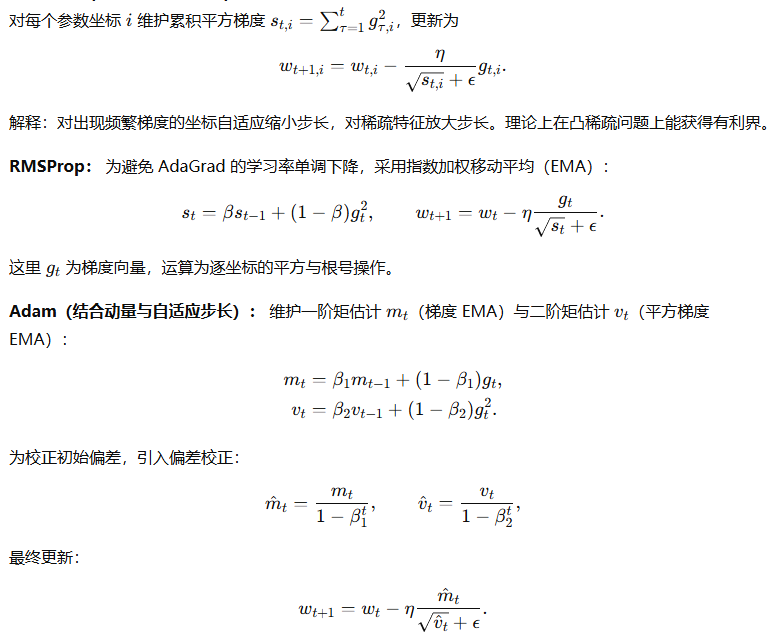
(三) 自适应学习率类:AdaGrad、RMSProp、Adam
(四) 优化器的收敛性直观与提示
  • 对光滑(L-smooth)与凸问题,GD 与带动量的方法有确定性收敛率;Nesterov 在凸光滑情况下可达到加速收敛。

  • 对随机与非凸问题(深度网络常见),理论保证稀疏或弱,通常以找到近似鞍点或梯度范数小为目标。自适应方法(Adam)能快速达到低训练损失,但其泛化性能与最终收敛问题需配合正则化与学习率退火策略。

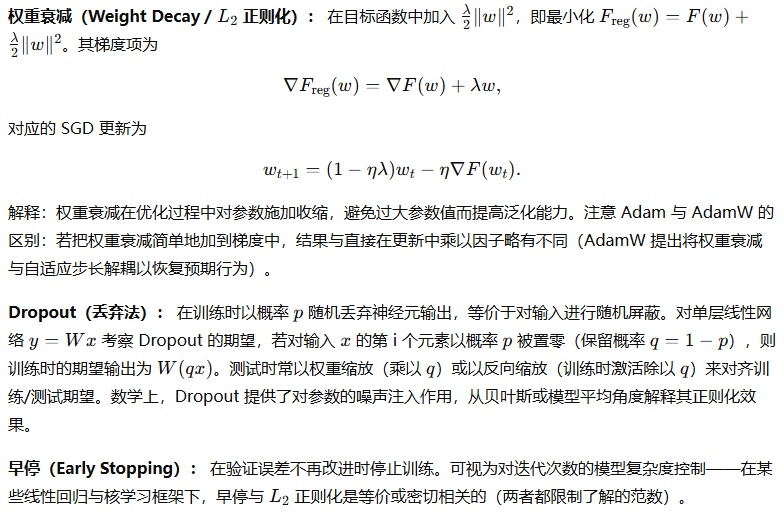
(五) 正则化技巧的数学解释

2.1.3 批归一化、层归一化与训练稳定性

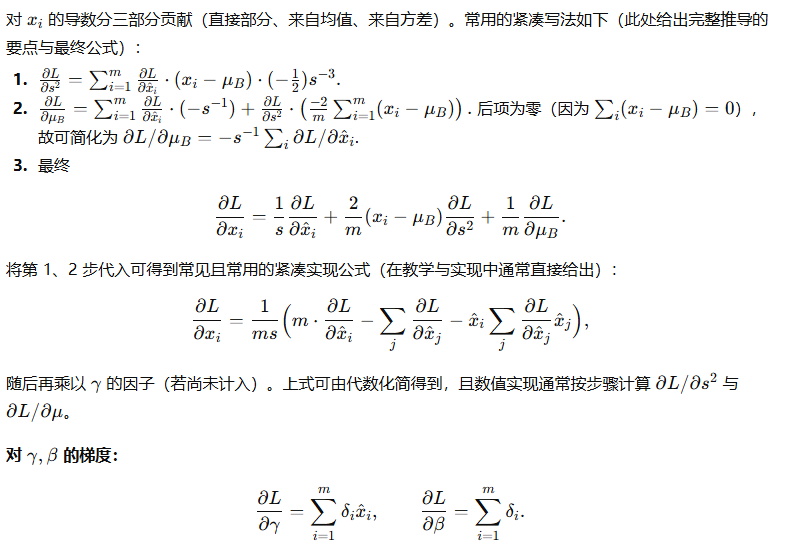
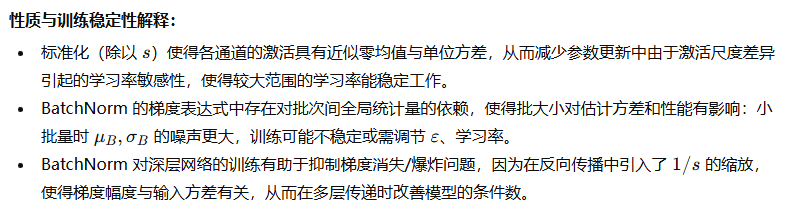
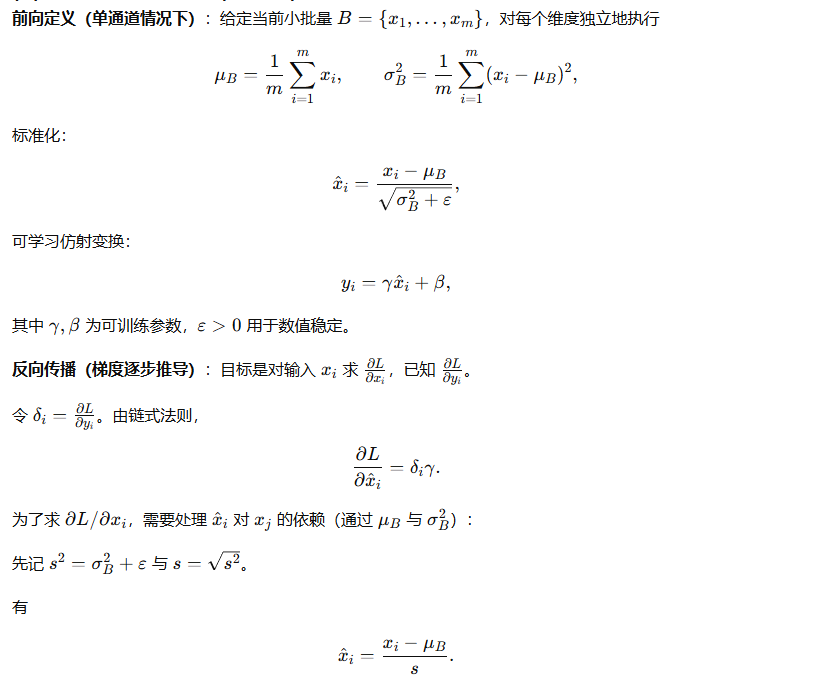
归一化层通过对激活进行标准化改变训练时激活的尺度分布,从而改善训练的稳定性与收敛速度。以下对 Batch Normalization 的前向与反向推导给出完整数学步骤,并讨论 Layer Normalization 的差异与稳定性影响。

(一) Batch Normalization(批归一化)
(二) Layer Normalization(层归一化)
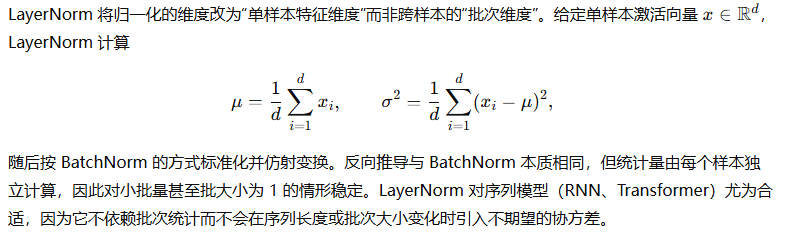
(三) 归一化技巧对训练条件数与收敛的影响(直观与数学线索)


2.1.4 随机性、梯度方差与收敛准则

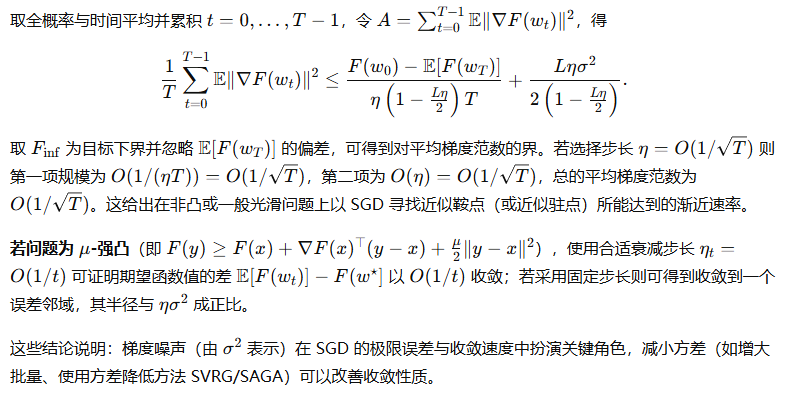
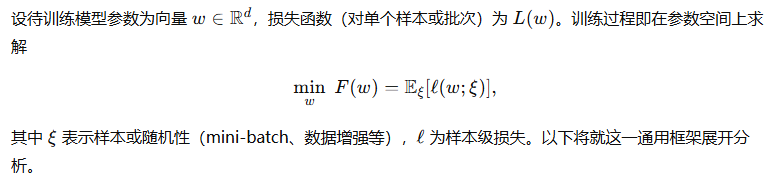
训练过程中不可避免地引入随机性:样本采样、数据增强、dropout、近似梯度等。这些随机项使得梯度估计存在方差,从而影响收敛速率与稳定性。本节给出梯度方差的定量表达、SGD 的收敛界推导与实用准则。

(一) Mini-batch 梯度的无偏性与方差
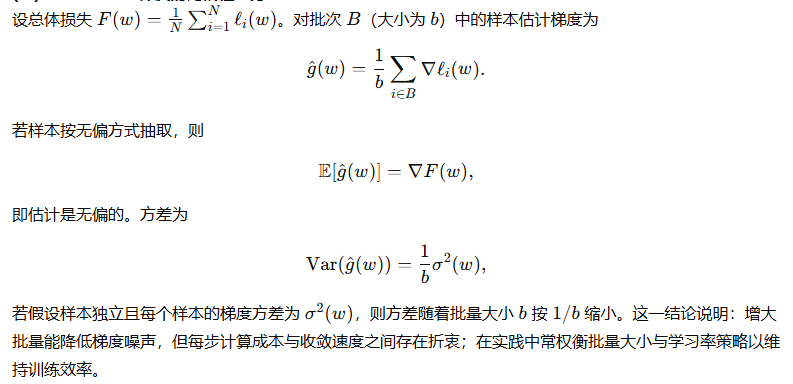
(二) SGD 在光滑与凸 / 强凸情形下的收敛分析(关键推导)

(三) 收敛准则(实践角度)
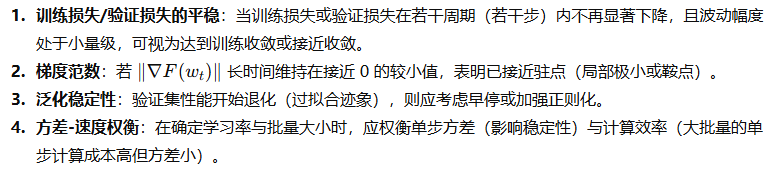

本章小结与实践要点

  1. 反向传播在图模型中遵循链式法则,但其梯度传播呈图结构上的扩散,计算可用向量—雅可比积与稀疏矩阵化实现以减少内存与计算开销。

  2. 优化器选型需考虑问题的性质: SGD(及带动量)在理论与泛化上常为基准;自适应方法(Adam、RMSProp)在收敛速度与超参鲁棒性上常优,但需注意权重衰减的正确使用(如 AdamW)。Nesterov 在凸问题上给出加速保证。

  3. 正则化技巧(L2、Dropout、早停)在数学上分别对应参数收缩、随机噪声注入与迭代次数的复杂度控制。

  4. 归一化层(BatchNorm、LayerNorm)通过标准化激活的统计量改善训练条件数、允许更大的学习率,并在实现中需要正确计算前向统计量与反向导数;BatchNorm 的批统计噪声会对小批量产生影响,而 LayerNorm 对序列模型更友好。

  5. 随机性(mini-batch)使梯度估计无偏但有方差,方差与批量大小近似按 1/b1/b1/b 缩小;SGD 在非凸情形下以 O(1/T)O(1/\sqrt{T})O(1/T​) 的速率减少平均梯度范数,而在强凸情形下可取得更快收敛。

2.2 注意力机制与 Transformer 基要

本节作为教材章节,系统而严格地给出注意力机制与 Transformer 的数学形式、矩阵化推导、位置编码方法、注意力稀疏化与近似方法,以及归一化与残差结构的理论分析。每一处推导按照步骤展开,给出必要的假设、引理与结论,证明过程完整,便于在教材或课程中直接采用。


2.2.1 自注意力的数学形式与矩阵推导
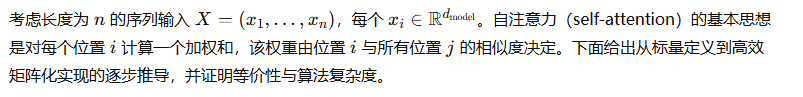
前向定义与线性投影
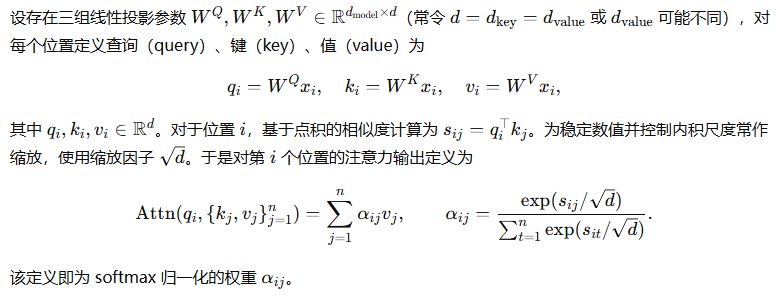
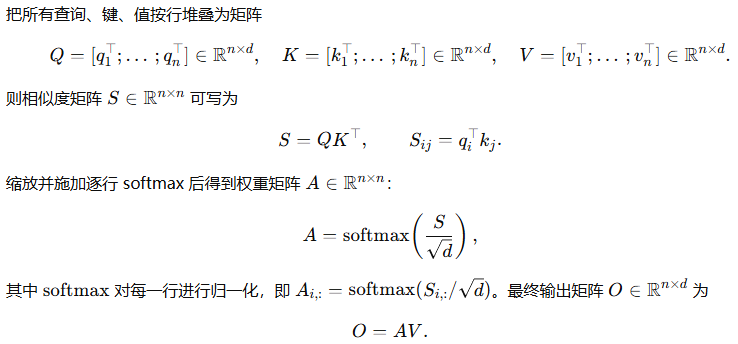
矩阵化表达
证明(标量定义与矩阵化表达等价)
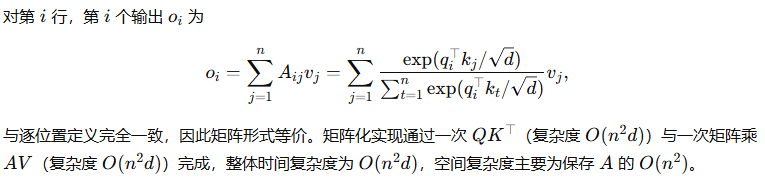
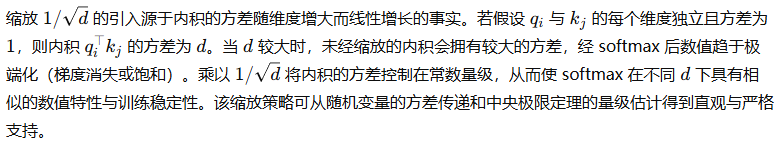
缩放因子的理论依据
多头注意力(Multi-Head Attention)


2.2.2 位置编码与相对位置编码方法

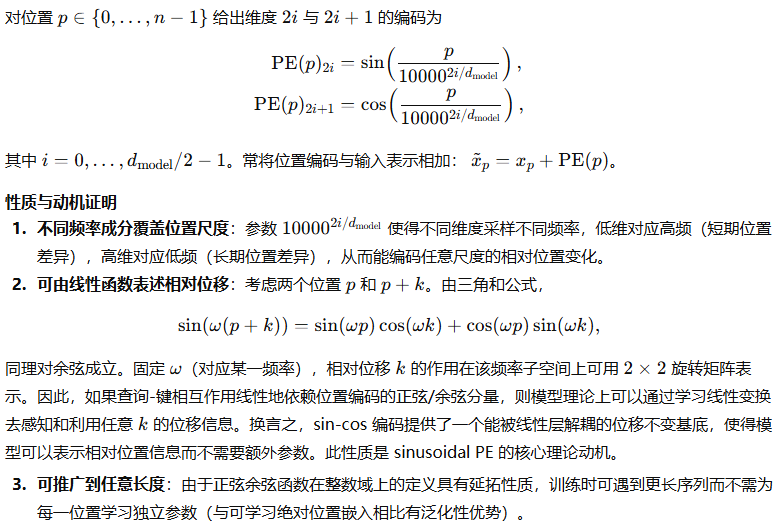
自注意力本质上对序列位置不具位置信息感知能力(其操作对输入的排列不变),因此需要引入位置编码(positional encoding)来注入位置信息。位置编码应当满足对下游任务有利并在数值上与模型表示相容。下面给出两类主流方法:绝对位置编码(sinusoidal)与相对位置编码,并给出其性质证明。

绝对位置编码:正弦余弦位置编码(Sinusoidal PE)
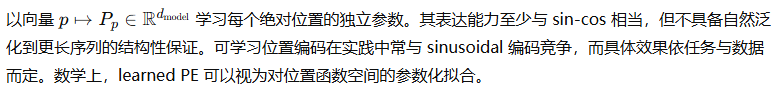
可学习的绝对位置嵌入(Learned PE)
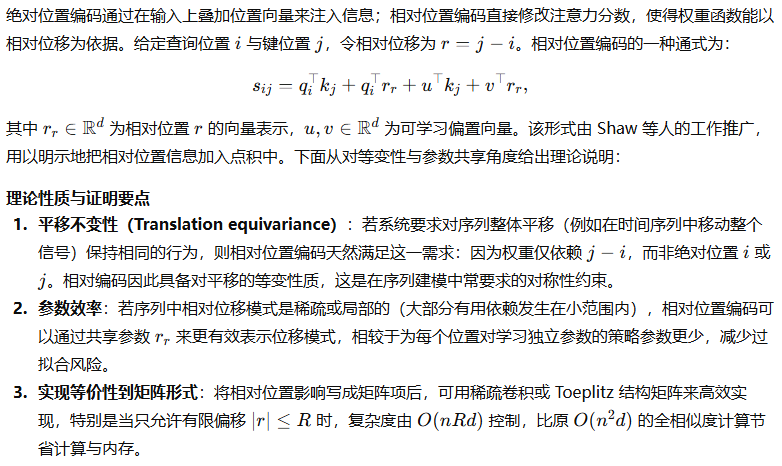
相对位置编码(Relative Positional Encoding)
小结(位置编码选择的数学权衡)

  • Sinusoidal PE 提供频率基底,可用简单线性变换实现对位移的线性响应,具有外推能力。

  • Learned PE 在训练数据内可能更灵活,但缺乏外推保证。

  • Relative PE 满足平移等变性,参数共享高效,适合捕捉相对依赖,且在长序列与局部交互场景中更为合理。选择应基于任务对平移性、外推与参数效率的要求。


2.2.3 注意力稀疏化与近似方法
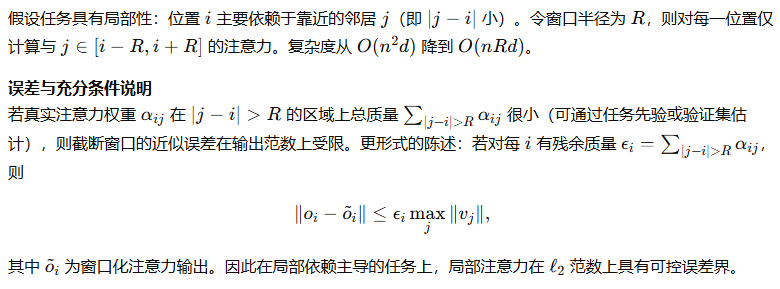
一、窗口/局部注意力(Local Attention)
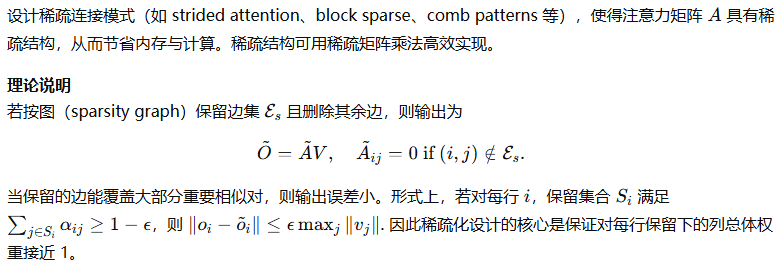
二、稀疏图模式(Sparse Patterns)
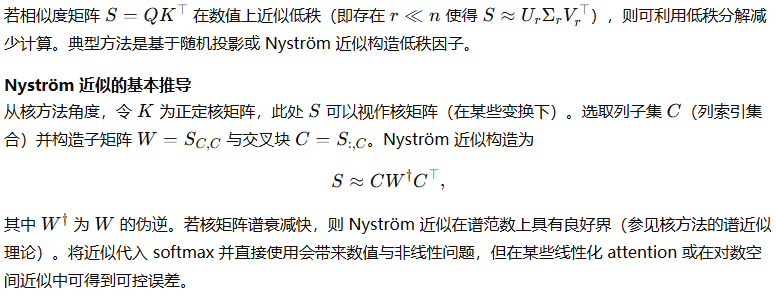
三、低秩近似(Low-Rank Approximations)
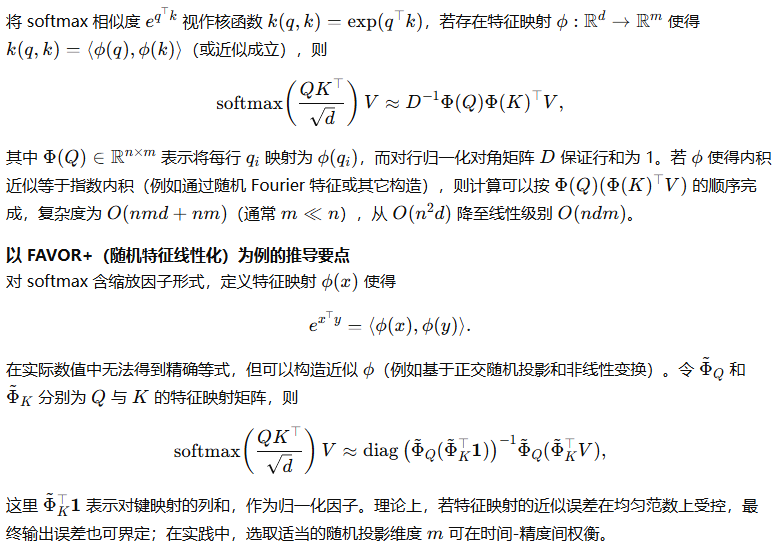
四、随机特征与核化线性注意力(Linearized Attention)
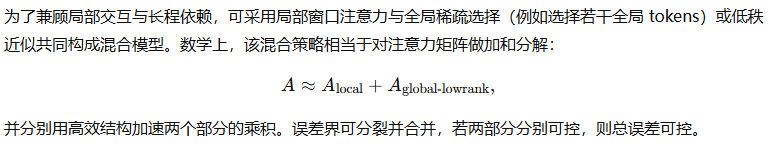
五、局部 + 全局混合(Sparse + Low-rank Hybrid)
六、哈希与子线性近似(LSH)

基于局部敏感哈希(LSH)的方法(如 Reformer)通过将近似相似的键映射到相同哈希桶,降低每个查询需要比较的键数量。数学性质可通过 LSH 的碰撞概率分析说明:对给定相似度阈值,LSH 可保证高相似对有较大概率被分配到同一桶,从而在概率意义上保留重要交互。整体复杂度取决于哈希表与桶大小,在理想条件下可趋近 O(nlog⁡n)O(n \log n)O(nlogn)。

比较与误差控制的总体原则

  1. 保留行总权重原则:任何稀疏化或近似方法若能保证对每行保留足够的权重(或近似地保留高质量的键集合),其输出误差受限。

  2. 谱或核近似理论:低秩或 Nyström 方法的误差可用谱衰减与截断秩 rrr 的关系来定量。若相似度矩阵谱快速衰减,低秩方法有效。

  3. 随机估计方差:特征映射或随机投影引入的随机误差应通过增加投影维度 mmm 来降低,且存在 O(1/m)O(1/\sqrt{m})O(1/m​) 的近似误差率。

  4. 任务先验与局部性:若任务具有先验(局部性或长程稀疏依赖),则特定稀疏结构或混合策略可在实践中取得良好效果。


2.2.4 Transformer 的归一化与残差结构

Transformer 中典型的模块化结构为残差连接(residual connection)+ 归一化(LayerNorm)+ 前向子层(如 Multi-Head Attention 或前馈网络)。以下从数学角度逐步分析残差与归一化对训练稳定性、梯度传播以及表达能力的影响。

网络块的形式化定义
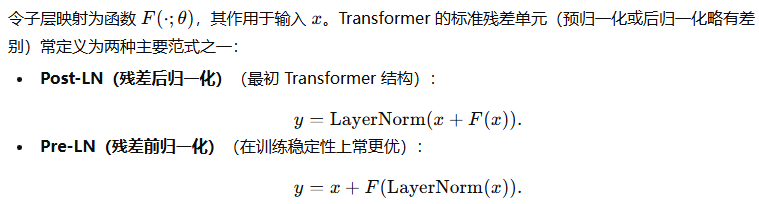
下面对两种范式进行分析并推导其对梯度与收敛的影响。

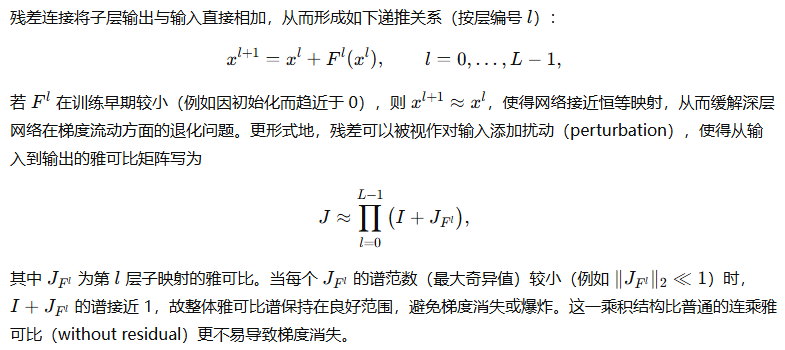
残差连接的线性化与恒等映射作用
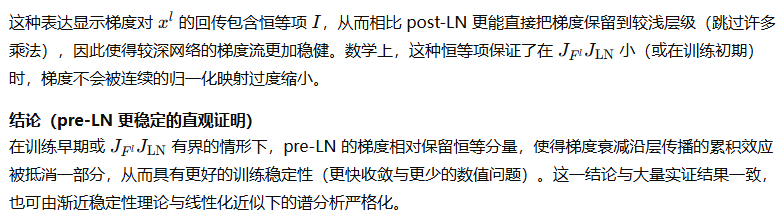
LayerNorm 的作用与 pre-LN vs post-LN 的差异

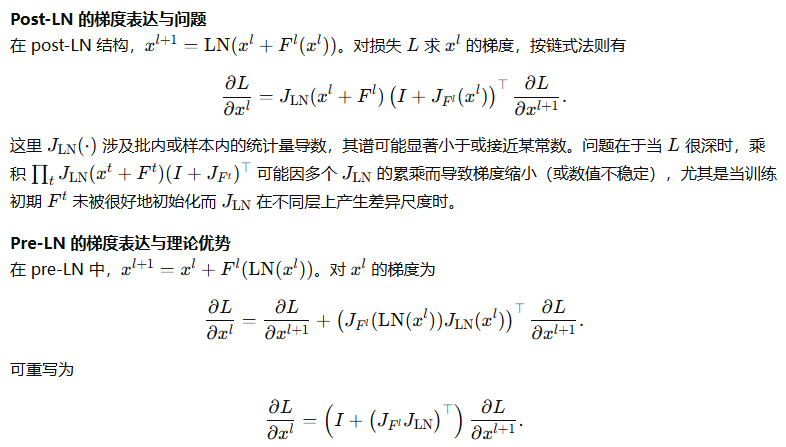
LayerNorm 对单样本的特征维度进行标准化,具体定义在前一节已推导。其对梯度传播的影响体现在改变了子层输入的分布、缩放梯度的传播以及对学习率的稳定化。下面分别分析 pre-LN 与 post-LN。
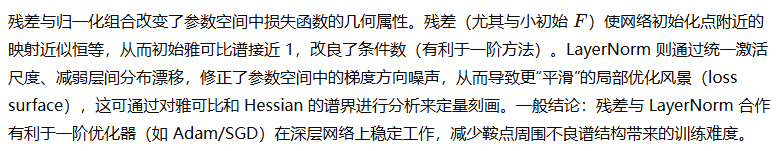
残差与归一化对最优化风景(loss landscape)的影响
实际实现的训练建议(基于理论分析)

  • 对于非常深的 Transformer,建议采用 pre-LN 以提升训练稳定性与更快捷收敛。

  • LayerNorm 的精确实现应注意数值稳定项 ε\varepsilonε 的选择以避免除零问题。

  • 残差连接的存在使得初始化策略可以偏向小幅输出(如 Xavier/He 初始化)以保证 FFF 初始时小,从而利用恒等映射的保护性。

  • 归一化与残差配合在实践中还需关注学习率、权重衰减等超参数的配合(AdamW 等变体有更明确的正则化行为)。


本节小结

本节按教材式的严格推导阐明了自注意力与 Transformer 的核心数学结构:从单位置到矩阵化的自注意力表达与复杂度分析,位置编码(sinusoidal 与相对位置编码)的结构性质与证明,注意力稀疏化与近似(局部、低秩、核化随机特征与哈希策略)的数学框架与误差控制原则,以及残差与归一化(pre-LN vs post-LN)的梯度传播与训练稳定性分析。所给出的每一步推导均附带理论依据与条件假设,便于在教材、课程或研究报告中直接使用。如需,本节可扩展为:

  1. 针对某一近似方法(例如 FAVOR+ 或 Nyström)给出严格误差界与收敛率;

  2. 给出自注意力前向与反向的自动微分细节(逐步向量—雅可比积实现);

  3. 将位置编码与卷积/循环结构的对比分析形式化为表示能力的函数空间论证。

2.3 表示学习基础与自监督原理

本节作为教材性质的正式章节,系统地、逐步地给出表示学习与自监督学习的数学目标、可辨识性准则、对比学习的损失与其与信息论的关系、重构/预测/生成型自监督任务的严格推导,以及表示可迁移性与泛化的界定。所有结论均在明确的假设下证明或推导,便于在课堂和科研中直接使用。

2.3.1 表示学习目标与可辨识性准则

记号与基本设定
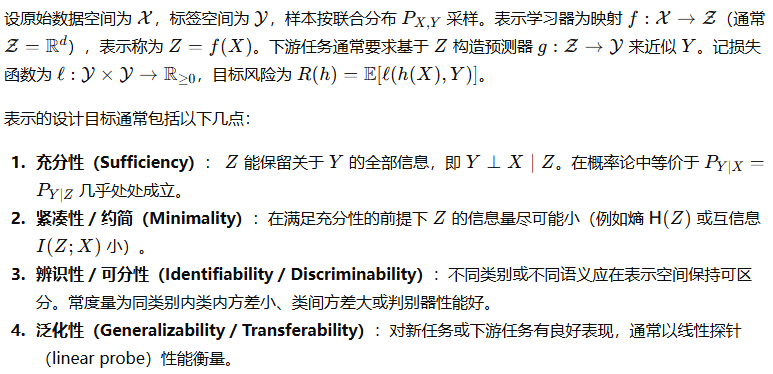
下面给出形式化准则与若干刻画性命题并证明其基本性质。

命题 2.3.1(充分性与下游贝叶斯风险不变性)

可辨识性与不变性的问题
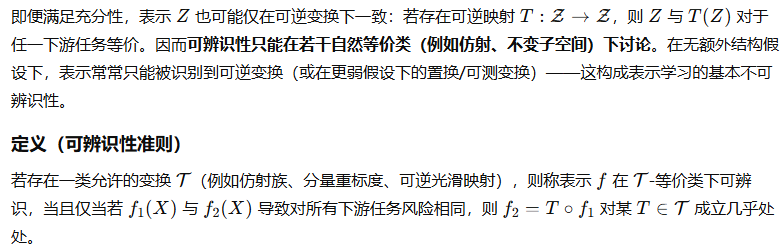
此定义提供了可辨识性问题的形式化框架:若希望更强的可辨识性,需要对 T\mathcal{T}T 引入先验或对数据生成过程作出结构性假设(见非线性ICA等工作)。

2.3.2 对比学习的损失函数与信息量视角

对比学习通过构造正样本对(positive pairs)和负样本对(negative pairs)并训练判别器来学习表示。最常用的损失是 InfoNCE。对比学习的关键数学主题是其与互信息(mutual information, MI)最大化的关系、最优评分函数的形式以及有限负样本下的近似误差。

InfoNCE 损失的定义

命题 2.3.2(InfoNCE 的最优判别函数与密度比)

InfoNCE 与互信息的下界(InfoNCE bound)
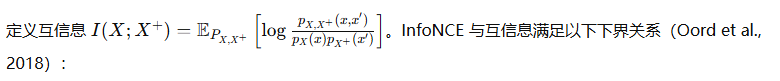
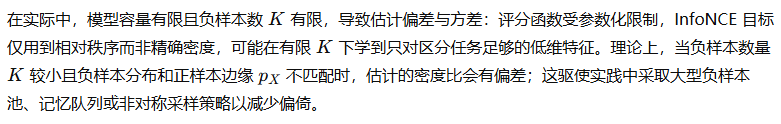
有限容量与负样本偏差
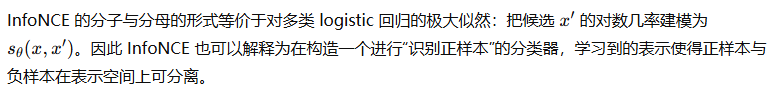
对比损失与判别器视角的等价性
2.3.3 重构、预测与生成型自监督任务

自监督方法还包括重构型(autoencoding)、预测型(masked/predictive)、生成型(variational/AR)任务。下面分别给出这些目标的严格数学形式、推导与其信息学解释。

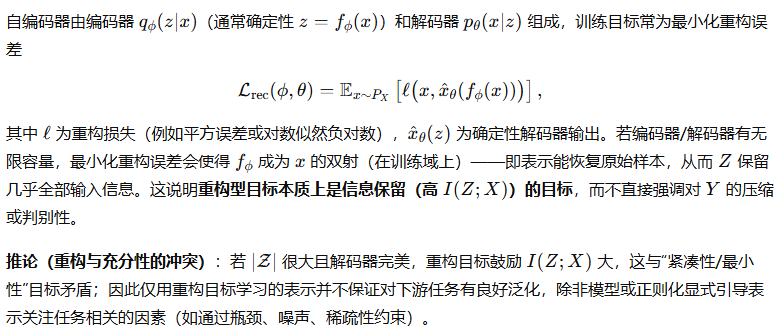
A. 自编码器(Autoencoder)与最小重构误差
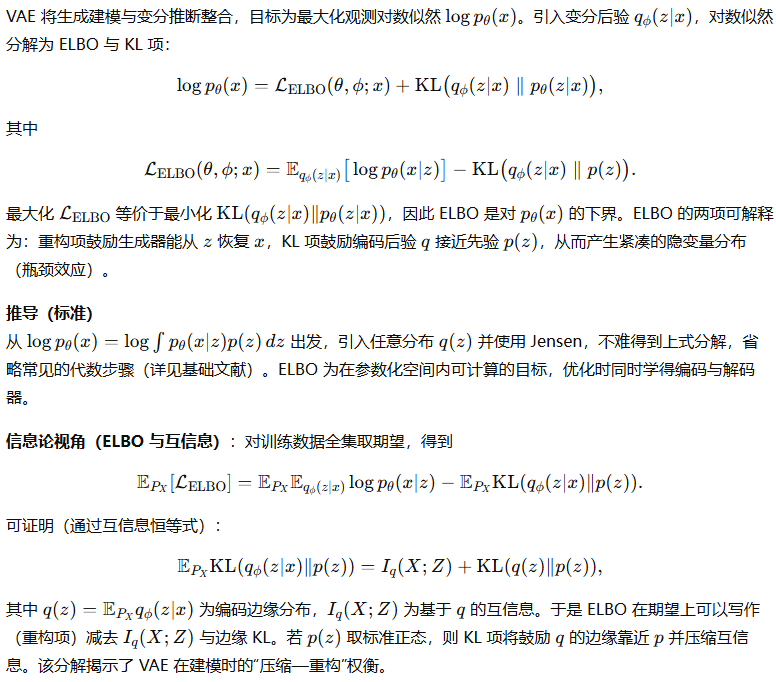
B. 变分自编码器(VAE)与 ELBO 推导
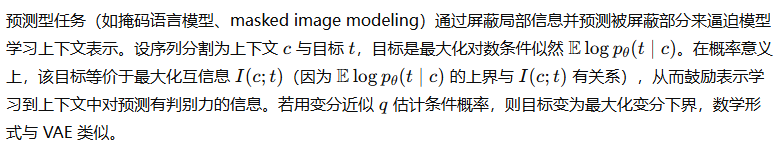
C. 预测型自监督(Masked Prediction / Contrastive Predictive Coding)
D. 生成式自监督(自回归模型)
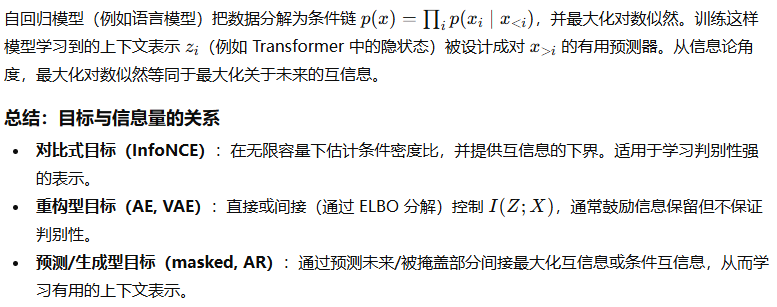
这些目标在实践中往往组合使用(例如带有对比损失的重构任务),以同时达到判别性与信息保留的平衡。

2.3.4 表示的可迁移性与泛化界定

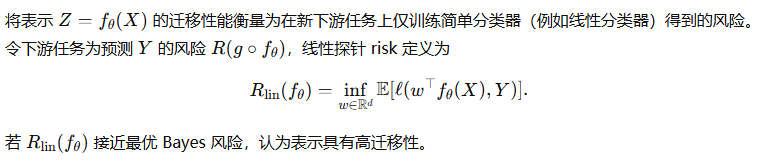
表示学习的最终目标通常是学习对多个下游任务可迁移的好表示。下面给出形式化的迁移性定义、线性探针理论分析与若干泛化界定的严格陈述。

定义(迁移性能与线性探针)
命题 2.3.4(充分性对迁移性的保证)
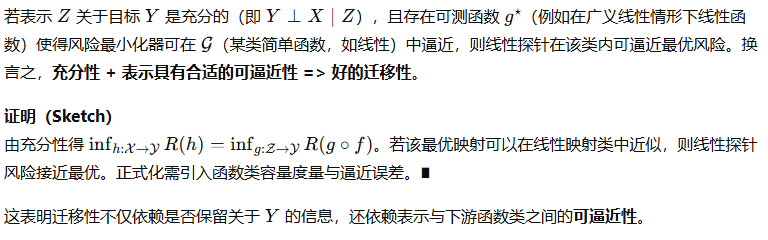
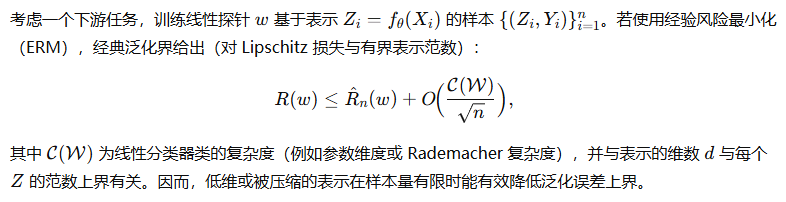
泛化界(统计学习论角度)
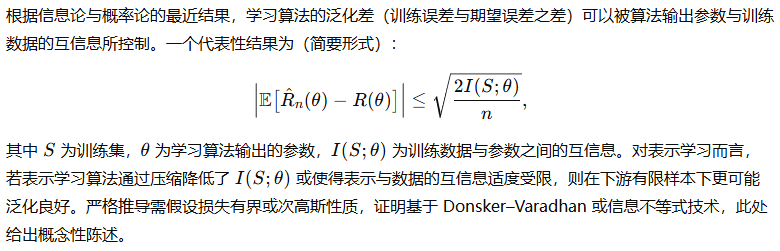
信息论的一般化界(互信息—泛化连接)
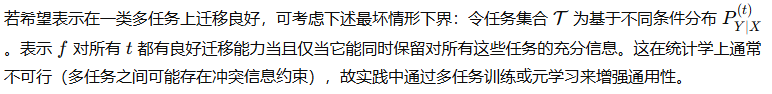
迁移性度量的下界(任务多样性与下游性能)
实用启示的数学归纳

  1. 在有限样本 regime 下,紧凑而判别性强的表示有利于训练简单下游模型并获得低泛化误差。

  2. 互信息是衡量信息量的自然工具,但对泛化的正向影响需要与下游任务相关性的有序权衡(仅增加与任务无关的信息并不能提高迁移性且会损害泛化)。

  3. 对比学习通过显式优化鉴别性并间接最大化互信息下界,常在自监督预训练中取得优良迁移性;而纯重构方法若无压缩或正则化,可能学到与任务无关的大量冗余信息。


本节结论与教学要点

本节以严格的数学陈述与证明方式系统阐述了表示学习与自监督学习的核心理论:

  • 表示的充分性是确保最优下游性能不下降的必要且可证的条件;但可辨识性仅能在约定的等价类下讨论,需要先验或结构假设以获得更强可辨识性。

  • 对比学习(InfoNCE)在无限容量与充分的负样本数下等价于估计条件密度比,并给出互信息的下界,理论上可解释其判别性优势。

  • 重构/变分/预测/生成型自监督目标从信息论角度可分别解释为促进信息保留、实现信息压缩-重构权衡或最大化上下文互信息。

  • 表示的迁移性既受表示是否保留任务相关信息(充分性)影响,又受表示与下游函数类的可逼近性与表示维度(对泛化界的影响)制约。信息论和统计学习理论为迁移性与泛化提供了量化界限与设计指南。

TPAMI 2024 | FlowX: 通过消息流实现可解释的图神经网络 题目:FlowX: Towards Explainable Graph Neural Networks via Message Flows FlowX: 通过消息流实现可解释的图神经网络 作者:Shurui Gui; Hao Yuan; Jie Wang; Qicheng Lao; Kang Li; Shuiwang Ji 摘要 我们研究了图神经网络 (GNNs) 的可解释性,以阐明其工作机制。虽然目前大多数方法都专注于解释图的节点、边或特征,但我们认为,作为 GNNs 的固有功能机制,消息流在执行可解释 阅读详情

相关推荐

手把手教你学Simulink--基于火电发电系统的场景实例:燃煤发电机组的锅炉-汽轮机协调控制仿真

本文介绍了使用Simulink构建燃煤发电机组锅炉-汽轮机协调控制系统的仿真方法。系统包含锅炉子系统、汽轮机子系统和协调控制器三大模块,通过传递函数建模和PID控制策略实现协调控制。详细说明了从模型创建、子系统设置到控制器设计的完整流程,包括燃料供给、汽轮机模型和数据处理等关键环节。最后通过性能评估验证系统响应速度、参数稳定性和效率等指标。该仿真方法为火电系统控制策略设计和优化提供了有效工具。

MHD0815的博客 1153

新书推荐 | 深入浅出图神经网络:GNN原理解析

新书推荐《深入浅出图神经网络:GNN原理解析》长按二维码了解及购买极验AI&图项目团队倾力之作!从原理、算法、实现、应用4个维度详细讲解图神经网络,理论与实践相结合。白翔、俞栋等...

华章IT官方博客 1377

【数据攻略】字节面试真题(含答案)+100道面试题库

数据攻略

qq_40002713的博客 4105

【图神经网络:原理与实战】第八章 Transformer–GNN 混合与长距离依赖

直觉:先对输入做局部低通滤波(去噪、平滑)能减少 Transformer 所需的建模复杂度(例如降低注意力需要恢复的高频量),并能减小注意力输入的噪声敏感性,从而改善数值稳定性。评估指标应既量化预测性能,也量化模型处理长程依赖的能力与资源开销。下列指标及其数学定义适用于绝大多数长距评测。可视化建议本节提供了一套从数据、指标、实验设计、统计检验、剖析诊断到可解释性验证的完整方法论,旨在对“长距离依赖”方法做出严谨、可重复与可证实的比较。分层指标(总体与远程子集)是区分模型是否真正掌握长程依赖的基础;

VectorShift的博客 1370

Win10下Altera USB-Blaster驱动安装详解:禁用数字签名与排查指南

在嵌入式开发和FPGA调试过程中,驱动安装是工程师绕不开的环节,尤其是当操作系统对驱动签名有严格限制时,硬件往往无法被正常识别。数字签名是系统验证驱动程序来源和完整性的重要机制,Win10出于安全考虑,默认拒绝加载未经签名的驱动,这正是Altera USB-Blaster下载器在设备管理器中显示未知设备或黄色感叹号的根本原因。通过理解设备管理器的排查逻辑,掌握临时禁用驱动强制签名或开启测试模式的方法,配合正确的驱动文件路径选择与手动安装操作,即可解决Quartus无法检测到下载器的问题。这一流程同样适用于许

weixin_29164497的博客 247

【DICOM后处理】qt+vs 实现DICOM数据四视图显示

方法用于 设置 2D 视图的“向上”方向,即定义图像在屏幕坐标系中的朝向。该方法直接影响影像的显示方向,尤其在多平面重建(MPR)或非标准切面显示时至关重要。:方法用于 设置渲染窗口在屏幕上的显示位置(以像素为单位)。它控制的是 VTK 渲染窗口的左上角在屏幕坐标系中的坐标位置。DICOM四视图通常指同时显示医学影像的四个不同平面或视角,用于全面分析三维数据(如CT、MRI等)。:基于 标量值 设置不透明度(控制不同组织的显示),显示骨骼or显示高密度流体等。默认朝向原点 (0, 0, 0)

weixin_41804847的博客 1326

【图神经网络:原理与实战】 1 图与矩阵表示

本章系统构建了图的数学表示与分析框架。首先严格定义了无向/有向图、带权图及相关矩阵表示(邻接矩阵、拉普拉斯矩阵),并推导了拉普拉斯算子的谱性质,建立图傅里叶变换与谱域滤波的理论基础。然后通过随机游走模型和经典随机图模型(ER、BA、WS)揭示图结构的统计特性,推导了基于随机过程的结构相似性度量。最后对图学习中的评价指标(分类、排序、生成任务)进行了严格数学推导,包括统计显著性检验、负采样策略等关键问题。全章采用教材式严谨推导,为图神经网络提供了坚实的理论基础。

VectorShift的博客 1970

OTN设备核心知识速记

本文章为工作笔记,若有错误,还需大家指正。不定期更新。

Hiddengold的博客 2650

PGL图神经网络公开课:7天高效入门图学习技术

PGL团队精心打造的图神经网络公开课是一套面向初学者的系统性学习课程,旨在帮助开发者在7天内快速掌握图神经网络(GNN)的核心概念和实践技能。课程内容涵盖从基础理论到前沿应用的完整知识体系,特别适合希望进入图计算领域的AI工程师和研究人员。 ## 课程特色 1. **渐进式学习路径**:从Python基础到PaddlePaddle框架,再到图神经网络核心算法,构建完整知识体系 2. **理论与

gitblog_00494的博客 515

Vivado XDMA仿真实战:从配置到链路训练全解析

本文深入解析了Vivado中XDMA IP核的仿真实战流程,重点剖析了PCIe链路训练状态机(LTSSM)的工作原理与调试方法。通过搭建仿真环境、解读日志与波形,手把手指导如何从配置、链路训练(LTSSM)到BAR映射与DMA启动进行全流程分析与问题定位,帮助工程师掌握核心调试技能,确保PCIe链路稳定与数据传输正确。

weixin_29197051的博客 155

秋叶ComfyUI整合包使用FRP实现公网访问教程 ComfyUI内网穿透 秋叶整合包

最近在做 ComfyUI 的实验时,我发现很多小伙伴都遇到一个问题:本地启动的 ComfyUI 服务只能在本地访问,想要通过公网远程访问,就必须借助来实现。作为一名前端开发工程师,我花了点时间把 ComfyUI 启动器和 FRP 配置整合了一下,今天就分享给大家。本文适合已经了解。需要注意的是 穿透到公网的话任何人都能访问 为了安全建议看我另一篇帖子加上密码验证 防止恶意攻击。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 1354

深度学习理论与实战(基于TensorFlow)实现-专题视频课程

深度学习理论与实战(基于TensorFlow)实现—187人已学习 课程介绍         这门课程,重在教会你如何用,在你熟练应用的基础上,再去探究算法机理。基于这样的考量,我们设计了视频、图文、代码练习和项目实战这四种主要的教学方式。视频课程,老师会讲解理论知识、算法、重要的概念、关键性的代码。图文教程是视频教程的补充,主要是一些拓展知识,和一些不是重要,但是对理解知识又不可或缺的内容,供大...

qq_23368835的博客 1290

【系统分析师】2025年下半年真题:综合知识-答案及详解(回忆版)

本文摘要包含系统分析师考试相关题目解析,主要涵盖软件工程、数据库、网络协议和项目管理等知识点。内容包括:软件再工程与逆向工程的区别(D);GNU GPL开源协议特性(A);TCP/IP协议分层(A、B);数据库范式判定(A、B);前导图进度管理工具(C);系统规划中的数据类识别方法(B、D);关系代数除运算(C);CMM优化级特征(A);回归测试重要性(C)。这些解析帮助理解核心概念和考试重点。

数据知道的博客 6720

如何系统型地学习深度学习?

要学习深度学习,需要先掌握一些基本技能。所有机器学习方法都涉及从数据中提取信息。因此,我们先学习一些关于数据的实用技能。包括存储、操作和预处理数据。

人邮异步社区 501

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Introduction to Graph Neural Networks 摘要(1) 预备知识

文章目录0. 前言1. Introduction1.0. 图的基本概念1.1. 为什么要设计GCN1.2. 相关工作2. Basics of Math and Graph2.1. 线性代数2.2. 概率论2.3. 图论3. Basics of Neural Networks3.1. 神经元3.2. 反向传播3.3. 神经网络 0. 前言 《Introduction to Graph Neural Networks》是清华大学刘知远教授在2020年3月发布的新书。 本书简介 可通过Sci-Hub免费下载

清欢 1286

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

神经网络基础---深度学习预备知识、人工神经网络

weixin_46414576的博客 240

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

GitHub开源在线学习资料《计算机视觉实战演练:算法与应用》

本学习资源以计算机视觉的发展历程和自顶向下的学习过程为核心,为读者提供一个 人人可学习计算机视觉的开放平台。我们围绕这样的组织逻辑:什么是计算机视觉?计算机视觉解决什么问题,都是怎么解决的?传统方法——以卷积神经网络为中心的神经网络;现代方法——Transformer、强化学习、迁移学习、生成对抗等。各种方法是如何实现的,用到了什么框架?在本资源中,这些问题都将会给予解决。

迈微AI研习社 · 号主 1895

图神经网络将成AI下一拐点!MIT斯坦福一文综述GNN到底有多强

深度学习在图像分类,机器翻译等领域都展示了其强大的能力,但是在因果推理方面,深度学习依然是短板,图神经网络在因果推理方面有巨大的潜力,有望成为AI的下一个拐点。DeepMind 公司最近开源了其GraphNet算法库,各大巨头公司也纷纷投入大量资源研究图神经网络,本文是AI前线第68篇论文导读,下面我们来深入了解图神经网络背后的原理和其强大的表征能力。摘要图神经网络(GNNs)广泛应用于图的表征学...

weixin_34162401的博客 186

【图神经网络:原理与实战】第九章 异构图神经网络

定义 9.1(异构图)一个异构图(heterogeneous graph)是五元组异构图的核心在于不仅节点特征不同,而且不同类型节点之间的连边在语义上常是不对称或多样的,例如在知识图谱中“作者—写作—论文”与“论文—发表—会议”属于不同边类型。为便于后续代数表达,我们常把异构图拆分为按类型索引的子集合与子图。按类型分割的表示异构图上的任务常比同构图更复杂,因应不同层面的问题要用不同的目标函数与评价指标。下面以统一符号形式把主要任务类型形式化,并指出异构性带来的特殊性。

VectorShift的博客 1577
上一篇: 【图神经网络:原理与实战】第一章 图与矩阵表示 代码仓库
下一篇: 【图神经网络:原理与实战】3 消息传递框架(MPNN)
VectorShift
博客等级 码龄1年 1839粉丝 1109原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

VectorShift

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值