告别“补点”时代:PaCo 用参数化补全重写多边形重建规则

深度学习之LoRA(低秩适配)原理与实战 【代码】深度学习之LoRA(低秩适配)原理与实战。 阅读详情

论文题目:Parametric Point Cloud Completion for Polygonal Surface Reconstruction
作者:Zhaiyu Chen, Yuqing Wang, Liangliang Nan, Xiao Xiang Zhu
单位:Technical University of Munich, Delft University of Technology, Munich Center for Machine Learning
发表会议:ECCV(European Conference on Computer Vision)
关键词:点云补全,参数化补全,多边形表面重建,平面基元,二分图匹配

1. 引言:为什么“补点”不再是好办法?

在三维重建中,从残缺的点云恢复出完整、规整的多边形表面一直是个棘手问题。主流思路是先“补点”再“表面重建”,但补全算法只关心点的位置,忽略了高层几何结构,导致重建结果崩塌。慕尼黑工业大学和代尔夫特理工大学提出的 PaCo 直接换了一种思维:不补点,而是补“参数化平面基元”。

这种参数化补全新范式让多边形表面重建在高缺失率下依然稳健,论文已开源。本文将按照漏斗式叙事,从问题根源讲起,拆解核心设计,并给出实验验证。
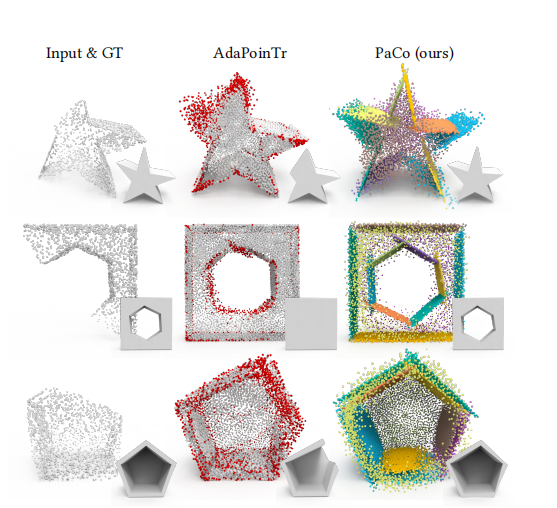
参数化补全 vs 传统点云补全

点云补全(PCN、PoinTr、AdaPoinTr 等)在填坑方面取得了长足进步,但一旦把它和多边形表面重建(如 PolyFit、KSR)串联起来,效果就急转直下——要么重建残缺,要么面片杂乱,甚至直接失败。根本矛盾在于:

  • 点云补全:追求点集的 Chamfer Distance 最小,输出一堆无结构的 3D 点;
  • 多边形表面重建:需要分段平面结构(每个面是一个参数化平面 + 一组共面内点)。

这种“点”与“结构”的错位,使得传统流水线在遮挡严重时必然崩溃。另一条路——直接在不完整输入上做重建(PolyFit、BSP-Net 等)——又因为看不到完整的平面证据而大量失败。

PaCo 提出了一种新范式:参数化补全(Parametric Completion)。它不再输出点坐标,而是直接输出一组 参数化平面基元(plane primitives),每个基元携带:平面参数、内部点分布和置信度。有了这些基元,只需简单组装就能得到高保真多边形网格。

2. 相关工作:三条路线,各自跛脚

2.1 点云补全

PCN、PoinTr、AdaPoinTr、ODGNet 等方法能恢复缺失区域的点,但它们输出的是无结构点集,缺乏对平面性等高层几何的编码。即使把补全后的点送入 PolyFit 等求解器,提取出的平面对依然脆弱,重建易失败。

2.2 多边形表面重建

传统方法 PolyFit、KSR、COMPOD 依赖从输入点云中提取平面基元(如 RANSAC、GoCoPP),然后通过组合优化得到多边形网格。输入残缺时,基元提取不完整,重建必然失败。神经方法如 BSP-Net、SECAD-Net 虽然端到端,但对不完整数据泛化极差,常产生过度简化的结果。

2.3 几何简化

“先密后简”路线先用泊松重建生成密集网格,再用 QEM、RoLoPM 等简化,但难以保留 CAD 模型那种规则的平面性,面数多且不规整。

三条路共同痛点:没有一种表示能直接从残缺数据中捕获完整的平面结构。PaCo 正是要填补这一空白。
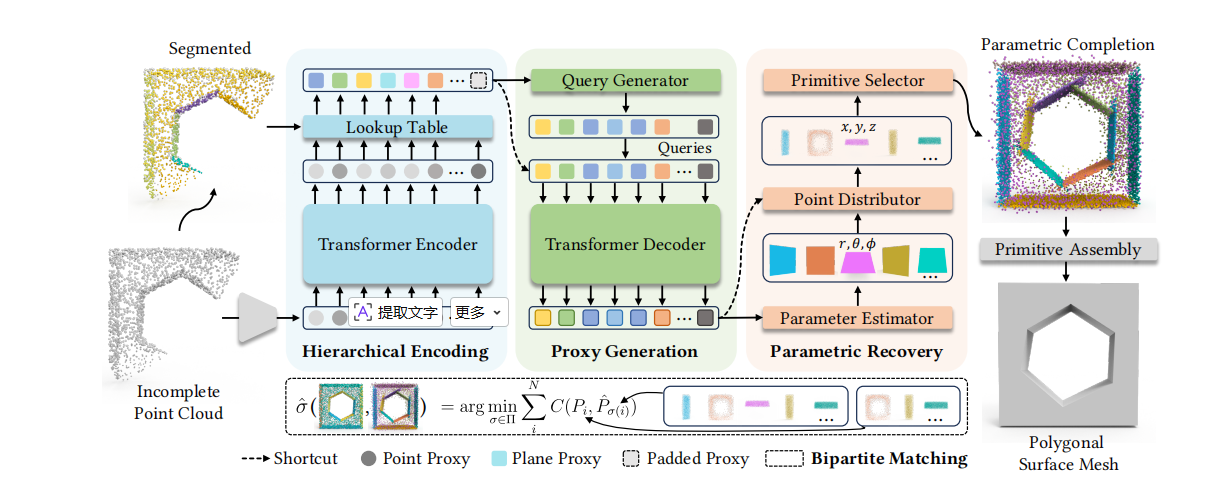
PaCo 整体架构

3. 方法:从残缺点云直接“长”出平面基元

PaCo 的整体流程为:分层编码 → 代理生成 → 参数恢复 → 集合匹配优化。

3.1 分层编码:从点到面,逐级上卷

给定残缺点云 X={xi}i=1NxX = \{x_i\}_{i=1}^{N_x}X={xi​}i=1Nx​​,先用 GoCoPP 将其分割为若干平面片段 S={si}S = \{s_i\}S={si​},得到“点→面”的映射表 f:X→Sf: X \to Sf:X→S。编码器逐级构建三个层次的特征:

  • 点代理 (Point Proxies):将局部点集聚合成一个特征向量 X′X'X′,代表一个“点块”。
  • 平面代理 (Plane Proxies):利用映射表 f′:X′→Sf' : X' \to Sf′:X′→S,通过 sum pooling 聚合同一平面的所有点代理,再注入平面法向量的 MLP 嵌入,得到第 iii 个平面代理:

vi=sum(Xi′)+Φ(ni)(1) v_i = \text{sum}(X_i') + \Phi(n_i) \tag{1} vi​=sum(Xi′​)+Φ(ni​)(1)

其中 nin_ini​ 是该平面的法向量。最终得到一组平面代理 V={vi}i=1KV = \{v_i\}_{i=1}^KV={vi​}i=1K​。聚合时保留 sum 而非 mean 是为了保留平面尺度信息,这对恢复内点数量至关重要。

3.2 代理生成:猜出那些完全缺失的面

仅靠可见平面的代理无法应对严重遮挡,模型必须“想象”出完全缺失的平面。

  • 先将 VVV 补零到固定大小,经 MLP 得到输入查询 QIQ_IQI​;
  • 另一可学习的查询生成器输出缺失部分查询 QGQ_GQG​;
  • 用查询排序策略选择前 MMM 个查询 Q={qi}i=1MQ = \{q_i\}_{i=1}^MQ={qi​}i=1M​;
  • Transformer 解码器让 QQQ 关注 VVV,输出补全后的平面代理提议。

这个阶段的关键是:用 Transformer 的注意力机制融合全局上下文,推演出应该出现但不可见的平面。

3.3 参数恢复:一个平面需要三样东西

每个平面基元必须同时具备参数、内点集和存在概率。PaCo 用三个头进行预测:

参数估计器:输入平面代理,输出极坐标下的平面参数 (ri,θi,ϕi)(r_i, \theta_i, \phi_i)(ri​,θi​,ϕi​),避免 Cartesian 表示在轴对齐平面附近的退化问题。

点分配器:平面形状由附着在其上的点集决定。对第 iii 个平面的第 jjj 个点,预测其在平面上的极角 (θij,ϕij)(\theta_{ij}, \phi_{ij})(θij​,ϕij​),然后通过平面参数反推半径:

rij=ricos⁡(Δϕ)sin⁡(θij)sin⁡(θi)+cos⁡(θij)cos⁡(θi)(2) r_{ij} = \frac{r_i}{\cos(\Delta \phi)\sin(\theta_{ij})\sin(\theta_i) + \cos(\theta_{ij})\cos(\theta_i)} \tag{2} rij​=cos(Δϕ)sin(θij​)sin(θi​)+cos(θij​)cos(θi​)ri​​(2)

其中 Δϕ=ϕij−ϕi\Delta \phi = \phi_{ij} - \phi_iΔϕ=ϕij​−ϕi​。

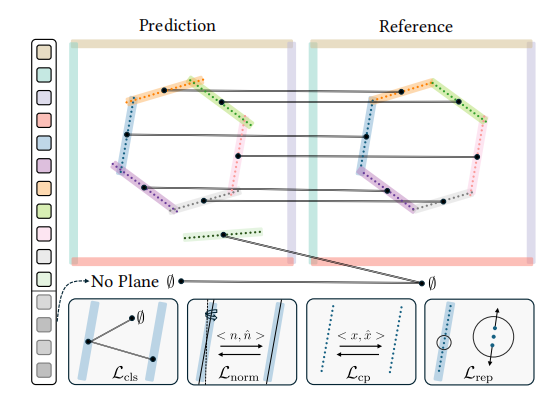
基元选择器:为每个基元预测置信度 κi∈[0,1]\kappa_i \in [0,1]κi​∈[0,1],表示该面是否真正属于物体表面。训练时通过二分匹配决定监督信号,推理时按阈值筛选。

3.4 集合匹配与损失

真值是一组不定数量的平面基元 PPP,预测集 P^\hat{P}P^ 固定为 MMM 个。通过 匈牙利算法 寻找最优排列 σ^\hat{\sigma}σ^,最小化总匹配成本:

σ^=arg⁡min⁡σ∈Π∑i=1MC(pi,p^σ(i))(4) \hat{\sigma} = \arg\min_{\sigma \in \Pi} \sum_{i=1}^{M} C(p_i, \hat{p}_{\sigma(i)}) \tag{4} σ^=argσ∈Πmin​i=1∑M​C(pi​,p^​σ(i)​)(4)

其中单项匹配代价定义为:

C(pi,p^σ(i))=Lcls+β1Lnorm+β2Lcp+β3Lrep(3) C(p_i, \hat{p}_{\sigma(i)}) = \mathcal{L}_{\text{cls}} + \beta_1 \mathcal{L}_{\text{norm}} + \beta_2 \mathcal{L}_{\text{cp}} + \beta_3 \mathcal{L}_{\text{rep}} \tag{3} C(pi​,p^​σ(i)​)=Lcls​+β1​Lnorm​+β2​Lcp​+β3​Lrep​(3)

各损失项具体含义:

  • 分类损失 Lcls\mathcal{L}_{\text{cls}}Lcls​:鼓励选择器对匹配上的基元输出高置信度,对填充的 ∅\emptyset∅ 输出低置信度:

Lcls=−1{c^i=1}log⁡κσ^(i)−1{c^i=0}log⁡(1−κσ^(i))(5) \mathcal{L}_{\text{cls}} = -\mathbb{1}_{\{\hat{c}_i=1\}} \log \kappa_{\hat{\sigma}(i)} - \mathbb{1}_{\{\hat{c}_i=0\}} \log (1-\kappa_{\hat{\sigma}(i)}) \tag{5} Lcls​=−1{c^i​=1}​logκσ^(i)​−1{c^i​=0}​log(1−κσ^(i)​)(5)

  • 法线损失 Lnorm\mathcal{L}_{\text{norm}}Lnorm​:同时使用余弦相似度和 L2 距离约束平面法向:

Lnorm=1{c^i=1}⋅λ(1−cos⁡(∠(ni,n^σ^(i))))+1{c^i=1}⋅∥ni−n^σ^(i)∥2(6) \mathcal{L}_{\text{norm}} = \mathbb{1}_{\{\hat{c}_i=1\}} \cdot \lambda(1 - \cos(\angle(n_i, \hat{n}_{\hat{\sigma}(i)}))) + \mathbb{1}_{\{\hat{c}_i=1\}} \cdot \|n_i - \hat{n}_{\hat{\sigma}(i)}\|^2 \tag{6} Lnorm​=1{c^i​=1}​⋅λ(1−cos(∠(ni​,n^σ^(i)​)))+1{c^i​=1}​⋅∥ni​−n^σ^(i)​∥2(6)

  • 平面 Chamber 损失 Lcp\mathcal{L}_{\text{cp}}Lcp​:衡量匹配对内部点集的相似度:

Lcp=1{c^i=1}⋅CD(pi,p^σ(i))(7) \mathcal{L}_{\text{cp}} = \mathbb{1}_{\{\hat{c}_i=1\}} \cdot CD(p_i, \hat{p}_{\sigma(i)}) \tag{7} Lcp​=1{c^i​=1}​⋅CD(pi​,p^​σ(i)​)(7)

  • 全局 Chamber 损失 Lco\mathcal{L}_{\text{co}}Lco​:对所有被选中的基元点云整体求 CD:

Lco=CD({pi∣ci=1},{p^i∣c^i=1})(8) \mathcal{L}_{\text{co}} = CD(\{p_i \mid c_i=1\}, \{\hat{p}_i \mid \hat{c}_i=1\}) \tag{8} Lco​=CD({pi​∣ci​=1},{p^​i​∣c^i​=1})(8)

  • 排斥损失 Lrep\mathcal{L}_{\text{rep}}Lrep​:防止内点聚集在平面中心,促进均匀分布:

Lrep=∑i=1T∑i′∈K(i)−∥x^i′−x^i∥⋅exp⁡(−ω∥x^i′−x^i∥2)(9) \mathcal{L}_{\text{rep}} = \sum_{i=1}^{T} \sum_{i' \in K(i)} -\| \hat{x}_{i'} - \hat{x}_i \| \cdot \exp(-\omega \| \hat{x}_{i'} - \hat{x}_i \|^2) \tag{9} Lrep​=i=1∑T​i′∈K(i)∑​−∥x^i′​−x^i​∥⋅exp(−ω∥x^i′​−x^i​∥2)(9)

最终总损失为上述各项加权和:

Ltotal=∑i=1M(Lcls(i)+β1Lnorm(i)+β2Lcp(i)+β3Lrep(i))+β4Lco(10) \mathcal{L}_{\text{total}} = \sum_{i=1}^{M} \left( \mathcal{L}_{\text{cls}}^{(i)} + \beta_1 \mathcal{L}_{\text{norm}}^{(i)} + \beta_2 \mathcal{L}_{\text{cp}}^{(i)} + \beta_3 \mathcal{L}_{\text{rep}}^{(i)} \right) + \beta_4 \mathcal{L}_{\text{co}} \tag{10} Ltotal​=i=1∑M​(Lcls(i)​+β1​Lnorm(i)​+β2​Lcp(i)​+β3​Lrep(i)​)+β4​Lco​(10)

这种设计让网络从一开始就按结构进行思考,而不是盲目追逐点的位置。

优化目标示意图

4. 实验:让数据说话

4.1 实验设置

使用 ABC 数据集中 15,339 个纯平面 CAD 模型,每个模型生成 25%、50%、75% 缺失三种难度,共约 36 万帧点云。评价指标基于重建网格:Chamfer Distance (CD)、Hausdorff (HD)、法向一致性 (NC) 和失败率 (FR)。

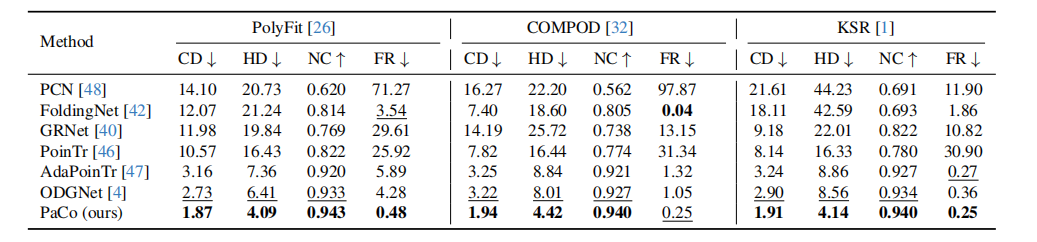
4.2 对比点云补全 + 重建流水线

将 PCN、FoldingNet、GRNet、PoinTr、AdaPoinTr、ODGNet 与 PolyFit、KSR、COMPOD 组合,与 PaCo 直接对比(PaCo 输出的平面可直接组装)。结果如论文中所示,PaCo 在不同求解器下均全面领先,尤其在 75% 硬缺失下,CD 仅 2.43,而最强对手 ODGNet 为 4.72,失败率仅 0.48%。
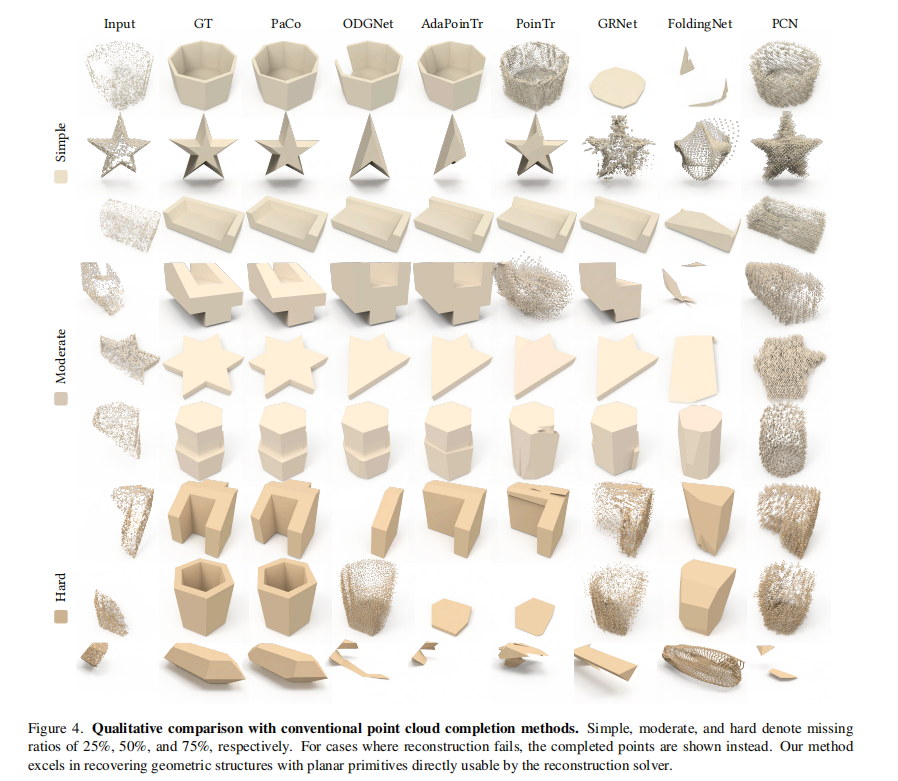
定性对比:不同缺失率下的重建结果

4.3 对比直接重建方法

在不完整输入上直接运行 PolyFit、KSR、COMPOD 等,失败率高达 33%~64%,BSP-Net 和 SECAD-Net 也难逃结构丢失。PaCo 的完成-重建策略将失败率压至 0.48%,证明了参数化补全对结构恢复的决定性作用。
与神经重建方法的定性对比

4.4 对比几何简化

与 QEM、RoLoPM 简化泊松网格相比,PaCo 用最少的三角面片(平均 39 个三角形)实现了最高的几何精度和最强的规则性。
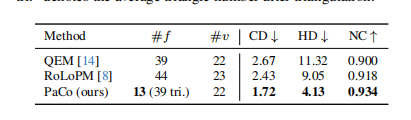
与简化方法的对比

4.5 鲁棒性分析

  • 噪声:加入 1.5%~4.5% 高斯噪声重新训练,PaCo 直到 3% 噪声级别性能几乎不降,失败率稳定在低水平(图7)。
  • 高缺失:随缺失率增加(25%→75%),其他方法性能陡降,PaCo 则下降平缓,优势持续扩大。
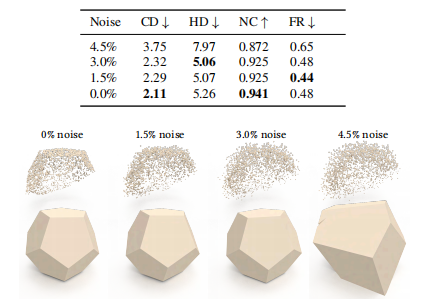
噪声鲁棒性示例

5. 结论:范式转换的力量

PaCo 开创了参数化补全新范式,将点云补全的目标从“恢复点”扭转为“恢复参数化平面基元”。通过分层编码、代理生成和参数恢复,它能在极短时间(29.8ms)内从残缺数据中恢复出完整、规整的多边形表面,即使在极高缺失和噪声下也极其稳健。

目前 PaCo 主要面向纯平面物体,未来将扩展到球面、圆柱面等更多参数化基元,有望统一形状补全与表面重建。项目页面和代码已开源,欢迎尝鲜和二次开发。

项目主页:https://parametric-completion.github.io


AI对战五子棋——深度学习策略网络 在本篇博文中,我们完成了:✔ 构建一个 CNN 五子棋策略网络✔ 让神经网络输出落子概率✔ 使用 Policy Gradient 强化学习训练 AI✔ 让 AI 实现人与 AI、AI 自对弈博弈。 阅读详情

相关推荐

Altair HyperWorks 2022.3.0 Suite下载

Altair HyperWorks开发团队提供了新的一流技术,以设计和优化高性能、高效和创新的产品,并发布了HyperWorks 2021.2套件。与所有新版本一样,这个版本包含了新特性、增强功能,并修复了前一个版本中用户报告的各种问题,提供了总体上更稳定的体验。链接: https://pan.baidu.com/s/1rYietmQLQUboHiJzYoE9WQ?pwd=m9yh 提取码: m9yh 复制这段内容后打开百度网盘手机App,操作更方便哦。

weixin_48469365的博客 2132

Transformer 为什么能取代 RNN?从自注意力讲起

2017 年谷歌在《Attention Is All You Need》中提出 Transformer,核心是。它如今是 GPT、BERT、ChatGPT 的共同底座。

anew___的博客 802

高效爬取懂车帝车型数据:从静态解析到动态反爬实战

本文详细解析了如何高效爬取懂车帝车型数据,从静态HTML解析到动态接口反爬的完整实战路径。文章重点介绍了使用浏览器开发者工具定位数据、应对CSS混淆与参数加密等反爬策略,并提供了整合静态与动态抓取逻辑的Python代码示例,帮助开发者稳健地获取结构化车型信息。

wind6的博客 937

基于深度学习的商品评论情感分析系统-毕业设计

面向商品评论的中文情感分析系统,支持单条预测、批量分析、情感分布与关键词、报告导出。TextCNN、BiLSTM、Transformer 在同一词表、同一数据切分、同一种子与超参下公平对比,测试集 F1 分别为 0.9101、0.9089、0.9075。结论是这一规模下模型复杂度未带来收益,但误差结构不同。附技术栈、截图、文档预览与演示视频。

csbysj2020 141

无人驾驶-2024-09-智能驾驶与机器视觉09:视觉与多传感器融合

从本章开始,我们将详细介绍视觉与多传感器融合技术。自动驾驶中常用的传感器都有其优势和局限性,单一传感器无法应对复杂的驾驶场景。多传感器融合技术旨在综合利用不同的传感器优势,提升感知的精度和鲁棒性。本章首先介绍多传感器融合的相关概念,之后详细介绍典型的融合方法。

u013250861的博客 593

如何在Ubuntu 22.04上为AlphaFold3配置NVIDIA A100 GPU(含驱动安装避坑指南)

本文提供了在Ubuntu 22.04系统上为AlphaFold3部署NVIDIA A100 GPU的完整安装教程。内容涵盖从系统环境准备、NVIDIA驱动安装与避坑指南,到Docker容器化部署、数据库获取以及最终构建运行AlphaFold3的详细步骤,旨在帮助研究者和开发者高效配置高性能计算环境,充分发挥A100的硬件潜力。

nft7creator的博客 468

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 228

samba源码编译安装(版本4.13.0)

这里写目录标题前言编译安装samba下载三个包安装依赖共需要安装samba、gnutls、nettle1、进入解压后的samba目录执行:2、进入解压后的gnutls目录执行3、进入解压后的nettle目录执行3.1 卸载已存在nettle3.2 编译3.3 make3.4 安装4、进入gnutls继续编译4.1 编译4.2 make4.3 安装5、再次进入解压后的samba目录5.1 执行./configure5.2 make5.3 samba安装启动samba 前言 一般来说,安装samba最快的方式应

灵葱的博客 1万+

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 398

银河麒麟V10SP1实战:5步搞定AD域登录(附Samba+Winbind配置详解)

本文提供银河麒麟V10 SP1操作系统无缝集成Windows AD域的实战指南。文章深入解析了Samba、Winbind与Kerberos三大核心组件的协作原理,并详细阐述了从环境准备、软件包安装、配置文件定制到执行加域及排错的全流程。特别针对2403等新版本提供了关键配置差异与避坑要点,旨在帮助企业运维人员实现高效、稳定的域环境登录与管理。

weixin_29269441的博客 297

QT应用编程: 编写低功耗BLE蓝牙调试助手(Android系统APP)

一、环境介绍 QT版本: 5.12.6 编译环境: win10 64位 目标系统: Android 完整工程源码下载地址(包含APK文件):https://download.youkuaiyun.com/download/xiaolong1126626497/19051696 二、功能介绍 本软件是一款BLE蓝牙串口调试助手,支持常规的发送和接收调试,BLE是低功耗类型蓝牙,在智能家居、物联网领域使用较多。BLE低功耗蓝牙一般不能直接使用手机进行连接,手机蓝牙默认都是工作在传统蓝牙模式,无法直接连接BL..

7663

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 380

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

CNN 卷积神经网络深度解析:卷积、池化与特征提取的底层原理

卷积核(Kernel),也叫滤波器(Filter),本质上是一个可以训练的权重矩阵。1 0 -11 0 -11 0 -1这个卷积核可以对图像中的局部像素进行加权计算。不同的卷积核能够提取不同类型的特征:水平边缘特征垂直边缘特征纹理特征角点特征局部形状特征在传统图像处理中,滤波器通常由人工设计。而在 CNN 中,卷积核的权重通过训练数据和反向传播自动学习得到。这也是 CNN 能够自动提取图像特征的关键。# 第一层卷积padding=1# 第二层卷积padding=1。

2503_90237586的博客 259

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

图解常用深度学习优化器

来隐式构造 Hessian 逆的近似,从而直接估计出“谷底在哪”,而非仅仅判断“哪边最陡”。即SGD/Adam 主要看“当前坡度”,LBFGS 还会看“最近几步坡度怎么变”,像用局部地形图来规划路线。训练 Transformer 时,有些层梯度大,有些层梯度小。如果用 Adam + L2,梯度大的参数反而可能被“少衰减”,正则效果不稳定;:你要下山,但每次迈步前都要派侦察兵把整座山的每一个坡面都测量一遍,算出“绝对最陡”的方向才走一步。:还是下山,但这次你只问身边一个路人“哪边最陡”,然后就走。

技术管理两手抓,两手都要硬. 218

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

【无标题】无人机视角道路坑洞坑洼目标检测数据集深度学习 目标检测 无人机航拍 道路坑洞 路面病害 YOLO格式 数据集发布9032期

(一)类别构成该数据集聚焦单一类别——坑洞(类别 ID 为 0),任务指向明确,围绕无人机俯视视角下的道路坑洞目标开展检测标注。类别体系精简,与公路路面病害巡检的实际需求高度契合,图像中的坑洞样本可直接作为路面破损识别的核心正样本,便于对接道路养护排查流程。(二)数据数量数据集规模为 3285 张无人机俯视航拍图像,采用标准 YOLO txt 标注格式,标注框总计 4457 个,其中带有效标注的图片 2007 张,全部图片均带有有效标注。

qq_2529413168的博客 179

基于深度学习的猫图像目标检测方法研究:YOLOv8s模型海选、多种子对比训练与Django+ONNX部署实现详解

本课题基于深度学习研究猫图像目标检测问题。数据集含1000张猫图像、1188个标注框,按固定比例划分并冻结清单;训练前在多个候选族中短训海选,确定YOLOv8s为主模型,经学习率搜索与显存标定后完成150轮训练,验证集mAP50达到0.92,并以7个随机种子的对比实验验证稳定性。最优权重导出为ONNX接入Django系统,提供图片、视频、摄像头三种识别方式,配套识别记录管理与统计大屏,形成从训练到应用的完整闭环。

WEIXIN_JSJBSZDS的博客 207

第 05/24 期:计算图与自动微分:深度学习如何计算梯度

本文系统阐述了神经网络训练中梯度计算的本质:损失对参数的敏感性。通过构建计算图,将复杂函数分解为基本运算,利用链式法则实现反向传播。核心在于反向模式自动微分——以一次前向计算为基础,通过传播输出对中间变量的敏感性,高效求得所有参数梯度。相比前向模式,反向模式在参数多、目标为标量的场景下更高效。计算图不仅适用于神经网络,也广泛适用于任意可微程序。关键思想是:梯度是局部导数与上游敏感性的乘积,分支路径的贡献需累加,从而保证导数计算的正确性与效率。

weixin_47502228的博客 305

【深度学习项目实战·30】PM2.5短期预测:用LSTM构造没有未来信息的滑动窗口

本文基于北京PM2.5数据,使用LSTM实现从最近24小时历史观测预测下一小时PM2.5。重点解决时间切分、因果填补、滑动窗口构建与标准化等关键问题,确保模型仅依赖过去信息,避免未来泄漏。通过滚动单步预测与持续性基线对比,评估在原始单位下的MAE/RMSE,验证模型有效性。强调时间顺序与数据完整性,为时序预测提供可复现的实践框架。

银尘博客 493

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

qq_2529413168的博客 204

AI 学习第 14 课:CNN 训 6 轮卡在 0.5352,数据没打乱

第 13 课把 Conv2d 的参数量和池化后的尺寸算清了,这课把卷积块拼成一个能训练的完整网络,跑满 6 个 epoch。第一版直接卡死:loss 从 2.6104 掉到 0.6989 就再也不动,

aifannihao的博客 247

深度学习基本原理:从数学基础到神经网络训练

深度学习训练的核心,是先确定模型结构,再通过前向计算得到损失,利用链式法则和反向传播计算梯度,最后借助优化器与学习率不断更新参数。真正理解这条链路,后续学习更复杂的网络结构才有可靠的基础。

chh563的博客 142

【深度学习实验】—— YOLOv12 添加 SE 注意力机制:实现、训练与水果检测对比

本次实验在 YOLOv12n 中接入 SE(Squeeze-and-Excitation)通道注意力,使用已有四类水果数据集,完成模块编写、模型解析器注册、前向与梯度检查、模型训练和最佳权重评估。项目本次设置与结果模型YOLOv12n 基线 / YOLOv12n SE 替换版任务四类水果目标检测数据集200 张图片,594 个标注框划分训练 160 张 / 验证 20 张 / 测试 20 张训练两组各 2 轮,batch=2,imgsz=640,seed=0,随机初始化。

weixin_65899656的博客 220

计算机毕业设计选题推荐:【基于深度学习的车辆损坏严重程度评估方法研究】ResNet50 图像分类

系统用 ResNet50 完成轻微、中度、严重三档分类,输出类别、置信度和单次耗时;视频按每秒一帧抽帧识别,历史区同步出图,没识别出来的帧也保留原图;识别记录可检索、看详情和删除,大屏按类别、时段和任务类型做统计。训练采用迁移学习,部署走 ONNX,推理前加纯色和域外两道拒识,尽量避免把非车损画面硬判成某一类。

BYSJLG的博客 233

深度学习0:数学知识:正态分布4(坐标变换的缩放比例(面积微元变换))

x2y2r2x2y2r2(距离公式,把直角坐标变成极坐标)dxdyrdrdθdxdyrdrdθ(面积微元变换,多出来的rrr是关键)rrr从000到∞+\infty∞(半径覆盖整个平面)θ\thetaθ从000到2π2\pi2π(角度转一整圈)为什么要这么做?因为原来的高斯积分里是e−x2y2dxdye−x2y2dxdy。换成极坐标后,x2y2x^2 + y^2x2y。

tellmewhoisi的博客 259

基于深度学习的猫狗目标检测(Python+YOLO26m+Django)实现详解

详解基于深度学习的猫狗目标检测系统:YOLO26m迁移学习训练、数据划分与错标检测、ONNX导出、Energy阈值拒识、Django+Vue网站部署,附后端核心代码。

WEIXIN_JSJBSZDS的博客 366
上一篇: (KDD-2025)STH-SepNet:轻量化大模型与自适应超图融合方法
下一篇: (NeurIPS-2025)MAGE 以简驭繁:线性自适应图学习赋能时空预测
山科智能信息处理实验室
博客等级 码龄6年 809粉丝 74原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值