(NeurIPS-2025)MAGE 以简驭繁:线性自适应图学习赋能时空预测

2022年电赛F题23年电赛D题-信号调制度测量装置说明中提到带通采样定律。 另外,当对于一个频率很高的射频信号采样时,如果采样频率设的太低,对提高采样量化的信噪比是不利的。低通采样定理在《信号与系统》教材中进行了详细的讨论,但未对带通信号的采样定理进行描述,国内樊昌信和曹丽娜老师编写的《通信原理》第10章第2小节有所描述,但没有详细的公式推导,容易给初学者产生超过该最低采样频率即不会产生频谱混叠的假象。故采样频率没选好,就会使周期性频谱搬移过程中造成频谱混叠,既然频谱和原信号的频谱对不上了,故就无法无失真恢复原信号了,总之,频域波形不出现重叠是无失真传输的重要保障。 阅读详情

主要内容:本文聚焦时空预测领域痛点,介绍了中科大团队提出的 MAGE 模型。传统时空图模型存在图拓扑噪声大、计算复杂度高(O (N²))、难以适配大规模场景的问题。MAGE 以 “少而精” 为理念,核心创新包括移除 ReLU 激活净化图拓扑、采用线性自适应图将复杂度降至 O (N),并设计稀疏平衡多专家结构突破线性低秩瓶颈。实验覆盖交通、能源、气象等 17 个真实数据集,MAGE 在 94% 指标上达最优,训练速度与内存占用均大幅优于主流模型,兼顾高精度与高效率,为大规模时空建模提供了新范式。

论文链接:https://openreview.net/pdf?id=jCGwSLwOt9

代码链接:https://github.com/USTC-MAGE/MAGE

一、引言

1.1 时空预测:智慧城市与交通调度的核心挑战

       在智慧城市、交通管理、能源调度、气象预测等关键场景中,时空预测(Spatiotemporal Forecasting) 始终是支撑智能决策的核心技术。它的目标是基于历史的多节点时间序列数据,预测未来一段时间内各节点的状态变化 —— 比如城市路网中未来 1 小时的交通流量、电力网络中不同节点的负载波动、或者城市各区域的气象数据变化。

       这类任务的核心难点在于,数据同时包含时间维度的动态依赖(比如早晚高峰的周期性变化、突发拥堵的短期波动)和空间维度的关联依赖(比如主干道拥堵会影响周边支路、相邻区域的气象变化存在联动)。时空图神经网络(STGNN)凭借 “用图结构建模空间关联、用时序模块建模时间依赖” 的思路,成为这类任务的主流方案,也在多个场景中取得了不错的效果。但随着应用场景从小规模路网拓展到城市级、甚至跨城市的大规模场景,传统 STGNN 的短板也逐渐暴露出来。

1.2 传统时空图模型的两大痛点:拓扑不准与计算低效

      在实际应用中,传统时空图模型面临着两个难以兼顾的核心问题:

  1. 图拓扑质量差,噪声放大问题突出:早期 STGNN 依赖地理距离、道路连通性等先验知识构建静态图拓扑,但真实场景中节点间的关联往往是隐式、动态变化的 —— 比如两条不直接连通的道路,也可能因为车流绕行形成强关联,静态图完全无法捕捉这类依赖。后续的自适应图学习方法,通过节点嵌入的内积动态学习图拓扑,试图解决这个问题。但这类方法普遍使用 ReLU 激活函数来过滤负相关边,却意外放大了噪声:原本微弱的噪声信号经过 ReLU 后会被强化,反而生成了大量无效的假边,破坏了图拓扑的可靠性,最终导致模型预测精度下降。

  2. 计算复杂度高,难以适配大规模场景:传统自适应图学习的核心瓶颈是节点数平方级的复杂度(O (N²))。对于城市级路网这类包含上万节点的大规模场景,O (N²) 的复杂度会导致模型训练时内存占用爆炸、推理速度极慢,甚至无法正常运行。虽然部分工作通过稀疏化、采样等方式降低复杂度,但又会损失模型的表达能力,无法兼顾效率与性能。 

1.3 MAGE 的破局思路:线性自适应图 + 多专家结构,实现高效与性能双赢

       为了同时解决 “拓扑不准” 和 “计算低效” 这两大痛点,论文提出了 MAGE(Mixture of Adaptive Graph Experts) 模型,以 “Less but More(少而精)” 为核心设计理念,用线性复杂度的自适应图学习,实现了比传统方法更优的预测性能。

     MAGE 的核心破局思路可以概括为两点:

  • 线性自适应图:解决拓扑噪声与复杂度问题:放弃传统自适应图中的 ReLU 激活函数,用纯线性的方式生成图拓扑,避免噪声放大问题;同时将复杂度从 O (N²) 降到 O (N),让模型能轻松适配大规模场景。
  • 多专家自适应图模块:突破线性模型的低秩瓶颈:纯线性模型存在低秩瓶颈,表达能力不足。为此,MAGE 引入多专家自适应图结构,通过多个线性专家的组合,在保持线性复杂度的同时,大幅提升模型的表达能力;再搭配稀疏平衡机制,避免专家偏科,让每个专家都能学到有效的关联模式。

       这套 “线性 + 多专家” 的设计,让 MAGE 在保持 O (N) 线性复杂度的同时,在 17 个真实数据集上实现了 94% 的最优性能,真正做到了 “高效不打折,性能再升级”。接下来我们将从模型架构的核心模块,一步步拆解 MAGE 的设计细节。

二、模型架构:线性自适应图的高效设计

2.1 整体框架:从联合建模到线性解耦的设计思路

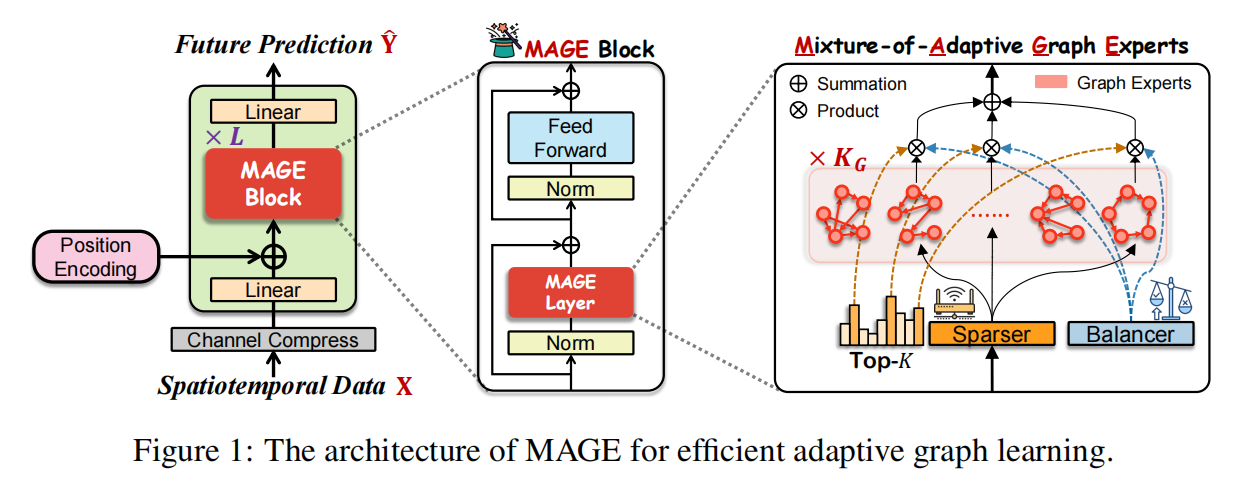
        MAGE 的整体设计,是对传统时空图神经网络(STGNN)的一次 “解耦重构”。传统 STGNN 往往将图拓扑学习与时空特征耦合在一起,导致复杂度居高不下且难以优化;而 MAGE 的核心设计理念,是将自适应图学习模块从时空建模中解耦出来,用线性结构保证效率,再通过多专家结构补足表达力。

      模型的整体流程可以分为三步:

  1. 输入层:接收多节点的历史时间序列数据(如交通流量、气象数据);
  2. 线性自适应图学习:通过无 ReLU 的线性投影生成初始邻接矩阵,再由多专家模块增强表达力;
  3. 时空建模与融合:将线性图拓扑与时序特征结合,通过门控融合模块整合时空信息,输出预测结果。
2.2 去 ReLU 的线性自适应图:净化拓扑、消除噪声放大

       传统自适应图学习普遍依赖 ReLU 激活函数过滤无效边,但论文发现 ReLU 会放大微小噪声,生成大量虚假关联,严重降低图拓扑质量。

        MAGE 的核心改进之一,就是直接移除 ReLU,用纯线性方式学习图结构。这样做能从根源避免噪声放大,生成更干净、更可靠的空间依赖关系,同时把计算复杂度从节点平方级降到线性级,显著提升效率。

2.3 多专家自适应图模块:突破线性模型的低秩瓶颈

     纯线性自适应图虽然高效,但表达能力有限,存在低秩瓶颈,难以捕捉复杂动态依赖。

     为解决这个问题,MAGE 引入多专家自适应图模块。它同时训练多个独立的线性图专家,每个专家专注学习一种空间关联模式,最后把所有专家的结果动态融合。多个专家组合后,模型表达能力大幅增强,有效突破单一低秩限制。

2.4 稀疏平衡机制:避免专家偏科,提升表达能力

      多专家结构容易出现 “专家偏科” 问题:少数专家频繁被激活,多数专家闲置,导致资源浪费、表达单一。

     为此,MAGE 设计稀疏平衡机制:

  • 稀疏激活:每个节点只选择最相关的少量专家参与计算,减少冗余;
  • 平衡约束:通过正则化让所有专家被均匀激活,避免冷热分化,确保每个专家都学到独特关联模式,整体表达更多样、鲁棒。

2.5 时空建模模块:线性图与时序特征的融合

    得到高质量线性图结构后,模型进行时空特征融合:

  • 空间建模:基于线性图拓扑聚合邻居节点信息,捕捉空间依赖;
  • 时序建模:通过轻量级时序模块,捕捉时间维度的趋势与周期。

    两者无缝融合,兼顾空间关联与时间动态,形成完整时空特征表示。

2.6 门控融合模块:动态整合时空特征,实现精准预测

        把稀疏平衡的多专家图卷积与时序特征整合,形成完整 MAGE 层。模型通过动态权重融合不同专家输出,自适应选择最优空间依赖模式,同时保留线性高效优势,最终输出高质量时空特征,支撑精准预测。

三、实验结果与分析

3.1 实验数据集与实验结果

        为全面验证 MAGE 的有效性,实验覆盖交通、能源、气象、移动通信四大领域、共 17 个真实数据集,包括大规模路网、电力负荷、空气质量、手机流量等不同场景。

        对比模型涵盖多种主流时空模型:传统图模型、自适应图模型、线性基线、Transformer 类方法等,共 14 个先进模型。

        评价指标采用时空预测通用标准:MAE(平均绝对误差)、RM(均方根误差)、MAPE(平均绝对百分比误差),数值越低表示预测精度越高。
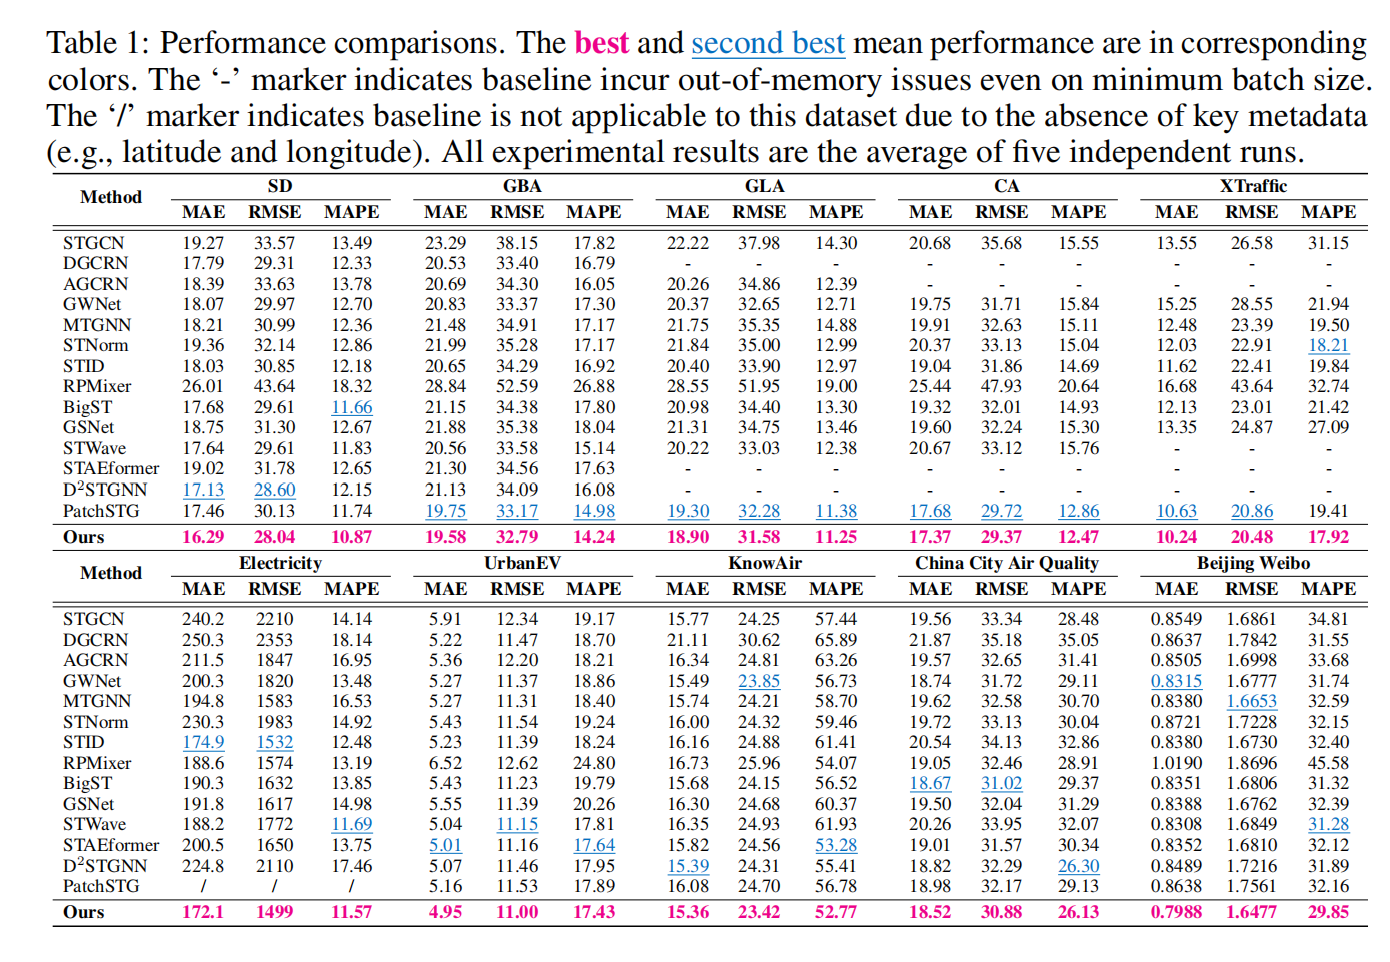
       实验结果显示,MAGE 在 94%(51/53)指标上取得最优,在交通、能源、气象、移动通信等所有领域均大幅领先对比模型。

       尤其在大规模数据集(如 GBA、GLA、CA、XTraffic)上,传统模型因内存限制无法运行,而 MAGE 依然保持高精度,充分证明其线性复杂度带来的大规模适配能力。

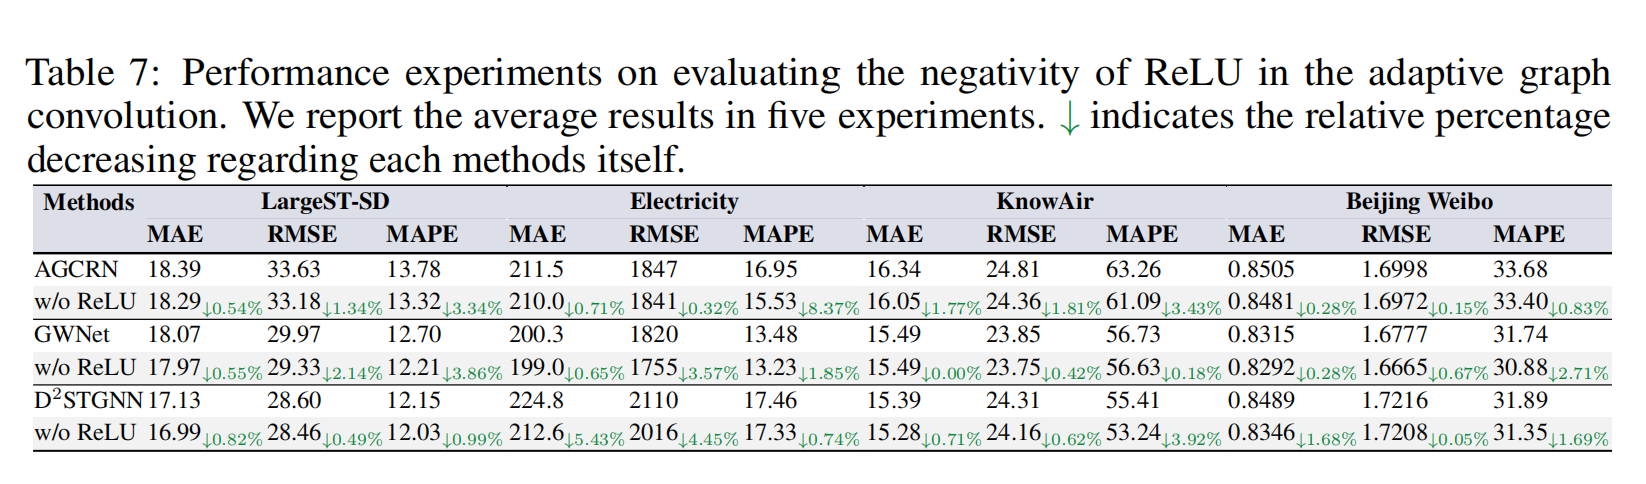
3.2 自适应线性图的有效性分析

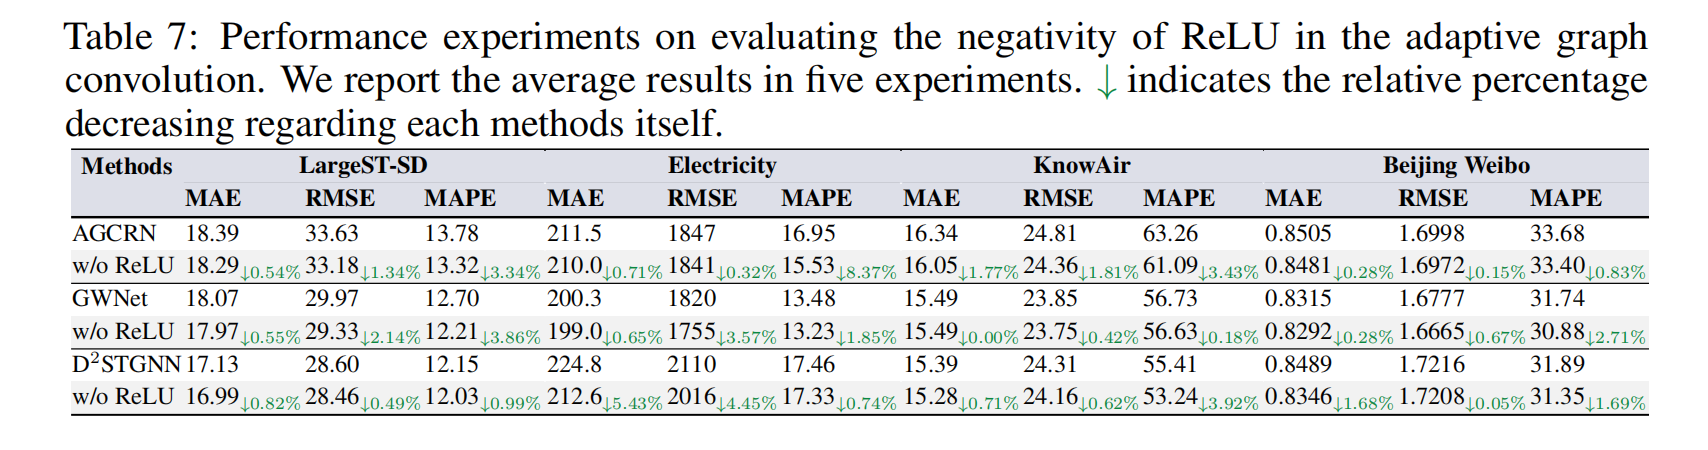
       论文通过对比有无 ReLU 的自适应图,验证线性图的优势:去掉 ReLU 后,所有模型精度均显著提升,证明 ReLU 确实放大噪声、破坏拓扑,而 MAGE 的线性图能生成更干净、可靠的空间依赖。
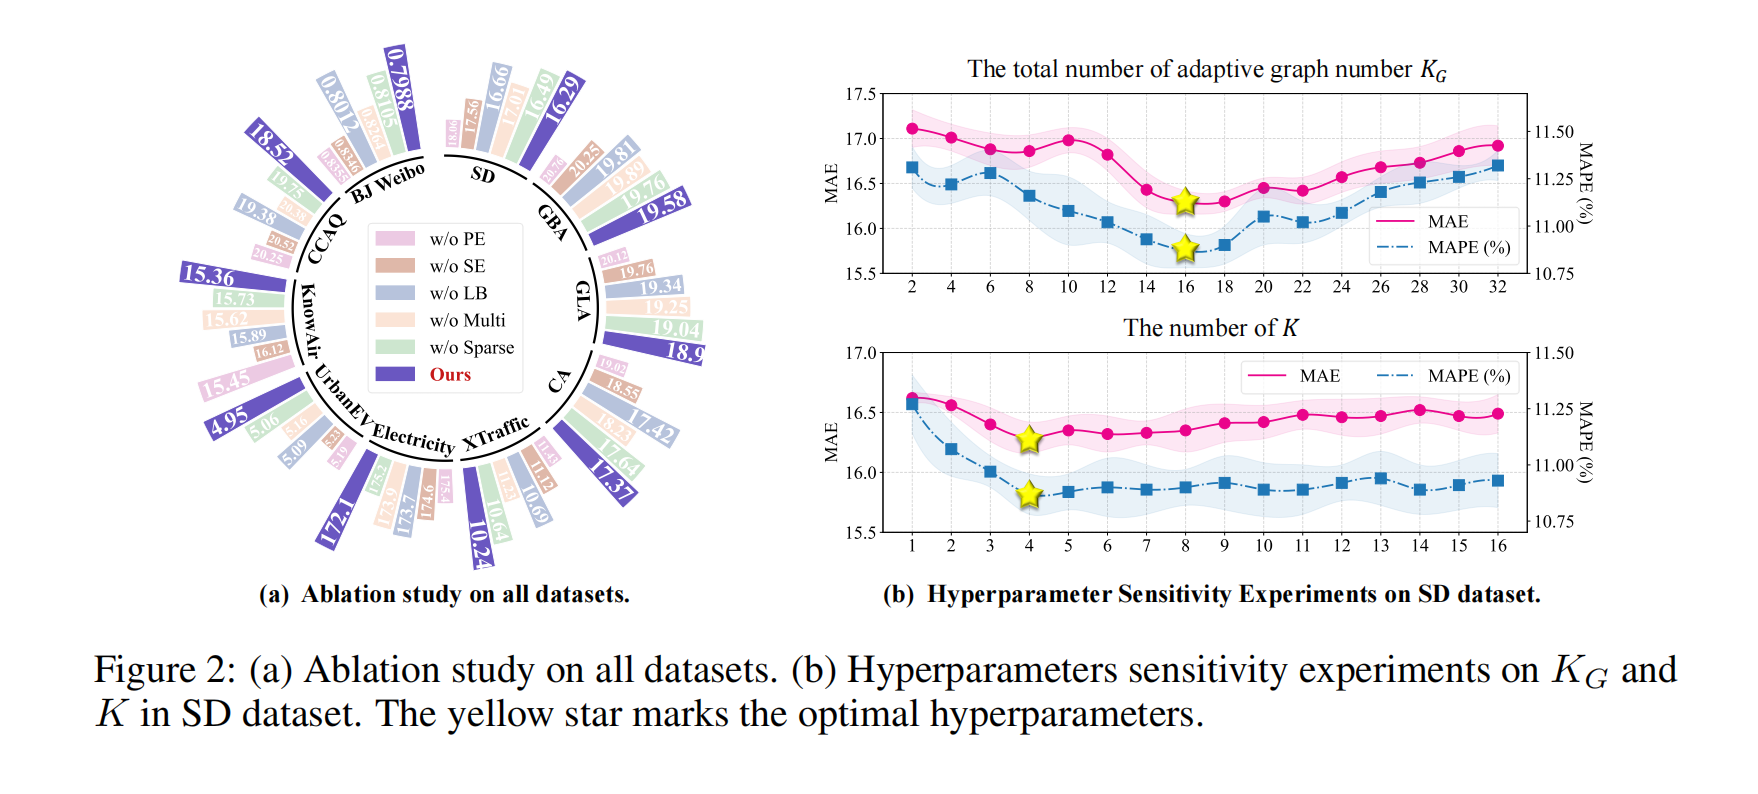
3.3 多专家模块的消融实验验证

    消融实验显示:

  • 去掉多专家(单专家):精度明显下降,证明多专家能显著提升表达力;
  • 去掉稀疏激活:精度下降,说明稀疏能减少冗余;
  • 去掉平衡机制:精度下降,证明平衡能避免专家偏科。
  • 候选专家数 KG​=16、激活专家数 K=4 时最优;
  • 过大 / 过小均会导致精度下降,证明参数选择的合理性。

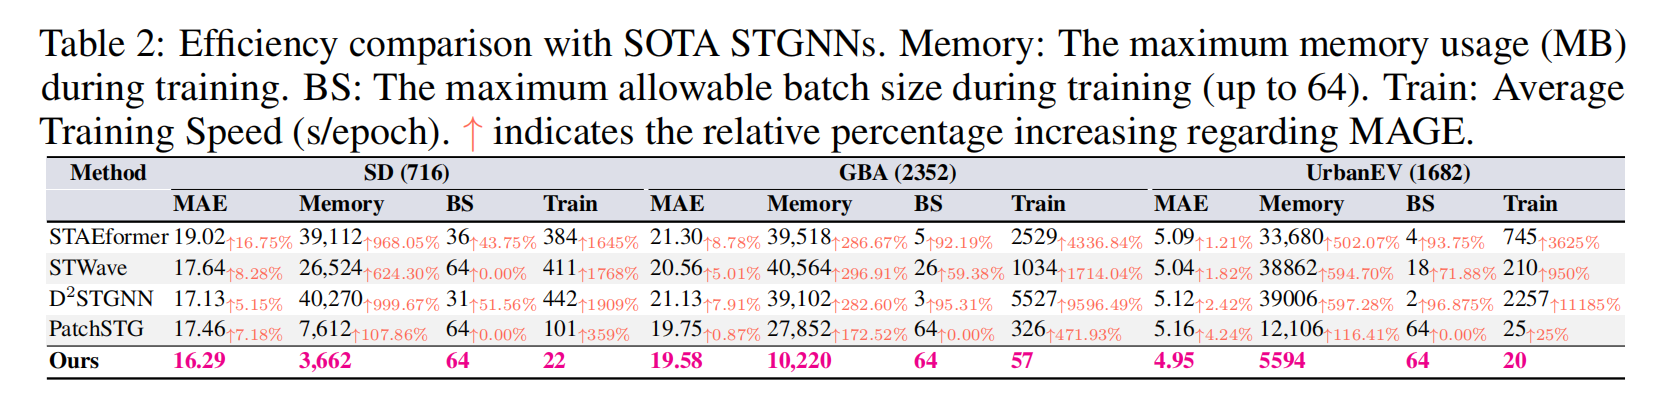
3.4 复杂度与效率分析:线性模型的性能优势

    效率对比显示:

  • MAGE 训练速度比 Transformer 类模型最高快 960 倍;
  • 内存占用比基线模型低 1.72–10 倍;
  • 上万节点数据集下,传统模型无法运行,MAGE 仍高效训练。

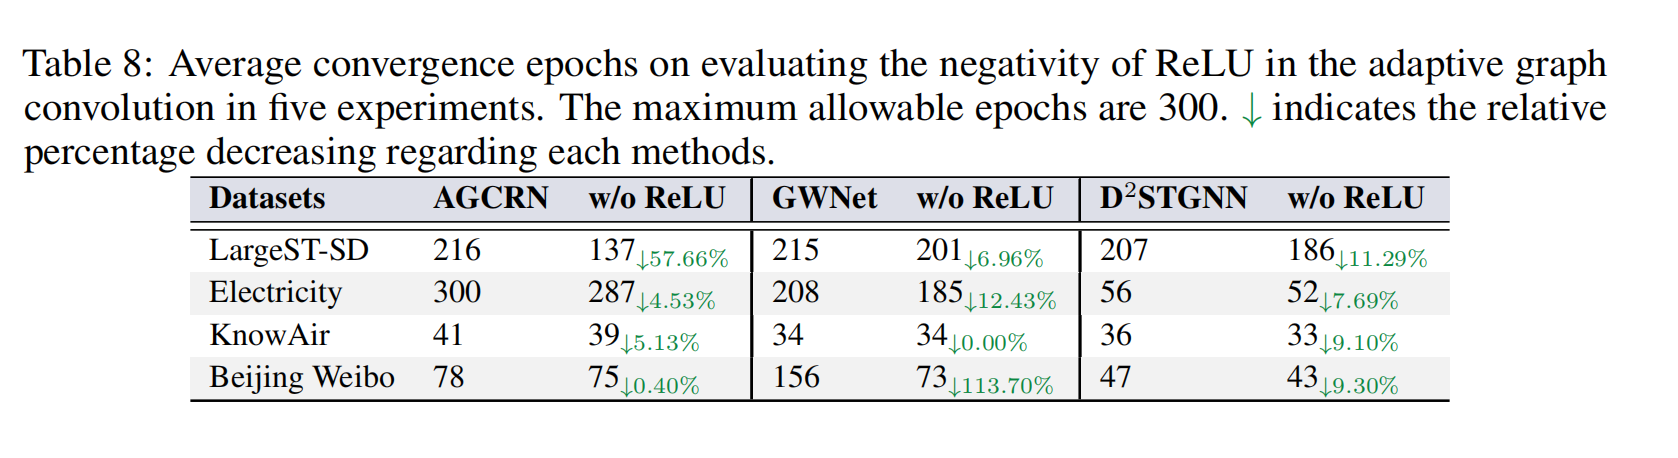
3.5 ReLU 影响验证:去噪带来的性能提升

     进一步实验验证:

  • ReLU 会放大边噪声,降低预测精度;
  • 去掉 ReLU 后,模型收敛更快、精度更高。

四、总结与展望

4.1 工作总结

       本文介绍了 MAGE(Mixture of Adaptive Graph Experts),一种面向时空预测的线性自适应图学习框架。

     MAGE 的核心创新可以概括为三点:

  1. 去噪线性自适应图:移除传统 ReLU 激活,避免噪声放大,生成更可靠的空间依赖关系;
  2. 稀疏平衡多专家结构:用多个线性专家突破低秩瓶颈,兼顾高效与强表达力;
  3. 线性复杂度设计:把复杂度降到节点线性级别,支持上万节点的大规模时空场景。

        在 17 个真实数据集、四大领域的实验中,MAGE 在 94% 的指标上达到最优,同时在速度、内存上全面优于现有模型,兼顾高精度、高效率和强通用性。

4.2 未来展望

     虽然 MAGE 取得了很好的效果,但仍有进一步探索空间:

  1. 时序模块升级:当前时序建模较简单,后续可引入更强的时序模块,捕捉长期复杂依赖;
  2. 动态专家机制:让专家数量自适应变化,进一步降低冗余、提升效率;
  3. 轻量化部署:面向端侧设备,设计更小、更快的模型变体;
  4. 通用图任务拓展:把线性自适应图思路推广到节点分类、图预测等通用图任务。

       总体来看,少即是多的设计思路在时空预测领域非常有效,线性化 + 多专家的组合为大规模时空建模提供了新的研究方向。

Python爬虫实战:链家/贝壳租房数据抓取与可视化分析平台 本文详细介绍了如何使用Python爬虫技术抓取链家/贝壳网站的租房信息,并构建一个完整的数据可视化分析平台。文章涵盖了从数据抓取、数据清洗、数据存储到数据可视化的全流程,使用最新的Python技术栈,包括AsyncIOPandasMongoDB和Pyecharts等库。本系统可作为毕业设计项目,提供了完整的代码实现和架构设计。关键词:Python爬虫、数据抓取、数据可视化、链家、贝壳、租房信息、毕业设计。 阅读详情

相关推荐

STM32输入捕获功能,同时捕获8路波形。

STM32输入捕获功能,使用TIM2和TIM3同时捕获8路波形。 工作上的一个需求,要采集两组控制步进电机的信号。就是采集8个通道的方波,测量频率和计脉冲个数。看起来简简单单的东西,磕磕碰碰搞了两天,走了一些弯路,这里写出来记录一下。顺便理解一下输入捕获个多种用法。 1. 硬件设计 首先看一下用到那些IO口。在STM32手册里找这样TIMx_CHx的就是输入捕获的口了。 这里用了TIM2的4个口和TIM3的4个口。 定义 端口 TIM2_CH1 PA0 TIM2_CH2 PA1 TI

qq_36353009的博客 5126

RNNoise-SpeexDSP-WebRTC使用说明

本文介绍RNNoise、SpeexDSP与WebRTC音频处理库的下载、调用及参数配置方法,适用于Android语音工程集成。RNNoise基于深度学习,适合非稳态噪声降噪,需48kHz输入;SpeexDSP支持多采样率与回声消除,适用于全双工场景;WebRTC提供轻量级窄带处理。三者可串联使用:麦克风信号先经前级降噪(RNNoise或SpeexDSP),再进入WebRTC媒体引擎进行编码。重点说明各库的典型应用场景、接口调用方式、关键参数调节策略及采样率转换注意事项,帮助开发者高效集成与优化语音处理链路。

知识共享,你我皆是知识的搬运工 245

腾讯2020 unreal虚幻面试题

解析一下,腾讯的unreal客户端面试题: 1.lua性能优化的方向 申请的内存,是造成卡顿的原因之一,在C++与lua交互中,如果参数或者返回值有类变量,那么这个变量不会再交互的栈中存放数据,而会通过申请内存,再指定在交互,这样就造成卡顿,因此可以通过把C++的对象的每个参数分开单独传递,可以解决问题,当时我们游戏改完这个问题后,整体提升了2帧。 其实,主要是Tick循环中,减少与C++的交互,需要的数据不要每帧都去拿,其次,经常拿的一些数据(比方说主角信息),可以做一个lua缓存,...

qq_17347313的博客 1万+

Transformer 为什么能取代 RNN?从自注意力讲起

2017 年谷歌在《Attention Is All You Need》中提出 Transformer,核心是。它如今是 GPT、BERT、ChatGPT 的共同底座。

anew___的博客 982

海康视觉平台VisionMaster使用学习笔记(1)

双击图像源设置图像源的属性,像素格式分为Mono8和RDB24分别对应导入的图像是彩色还是黑白。打开相机驱动软件MVS,对连接的相机进行属性上的配置,先对相机的IP进行对应的设置。将自动触发的使能打开,保存配置好的相机属性,默认保存到用户集1中。点击MVS软件中的触发按钮,查看相机是否进行正常的触发拍照。打开VM软件添加一个图像源,选择图像源选项拖出图像源。回到VM软件中将选择相机选项选择到配置好参数的相机。取图方式也可以调整为相机取图,将图像源改为相机。双击相机进行连接后对相机的属性进行配置。

A567852的博客 1万+

手把手教你解决Kernel panic报错:init找不到的5种排查方法(附NFS挂载实战)

本文深入解析了Linux系统启动时出现“Kernel panic - not syncing: No working init found”报错的根本原因,并提供了五种系统性的排查方法。文章结合NFS挂载根文件系统的实战场景,详细阐述了从动态链接库依赖、内核引导参数、NFS权限配置、文件系统完整性到内核配置干扰的完整排查路径,帮助开发者快速定位并解决这一常见的系统启动故障。

weixin_29159995的博客 199

基于深度学习的商品评论情感分析系统-毕业设计

面向商品评论的中文情感分析系统,支持单条预测、批量分析、情感分布与关键词、报告导出。TextCNN、BiLSTM、Transformer 在同一词表、同一数据切分、同一种子与超参下公平对比,测试集 F1 分别为 0.9101、0.9089、0.9075。结论是这一规模下模型复杂度未带来收益,但误差结构不同。附技术栈、截图、文档预览与演示视频。

csbysj2020 162

驱动兼容_FANUC 驱动器兼容问题探讨

近10年来,FANUC伺服驱动器随着系统的升级而升级,不同的系统,可以兼容很多种类的驱动器,作者做了一些常见经验总结如下表:电源模块伺服放大器主轴放大器bi一体18i/OIB/OIC6110-Hxxx6114-Hxxx6111-Hxxx6134-Hxxx31iA/OID6140-Hxxx6117-Hxxx6141-Hxxx6164-Hxxx31IB/35IB/OIF/OI MATE D(5包)62...

weixin_34420941的博客 1753

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 399

SIPVicious实战指南:从零开始掌握VoIP渗透测试(Kali Linux环境)

本文为SIPVicious实战指南,详细介绍了在Kali Linux环境下进行VoIP渗透测试的完整流程。从环境准备与工具安装开始,逐步讲解如何使用svmap扫描SIP服务器、svwar枚举PBX分机号,以及svcrack进行密码安全测试,并整合svreport生成报告。旨在帮助安全从业者从零开始,系统掌握这套经典开源工具,在授权范围内有效评估VoIP系统的安全性。

weixin_29327977的博客 541

Qt —— 在Win11下“Qt for Android“开发环境,通过USB在真机(华为Meta60 PRO)上调试运行,并打包APK并在真实手机运行

Qt —— 在Win11下“Qt for Android“开发环境,打包APK并在真实手机运行

315

AI 学习第 15 课:变长序列不 pack 直接喂 RNN,隐状态全被 0 污染

NLP 的 batch 里句子长短不一,短句垫 0 补齐后直接喂 RNN,看似能跑,实际上每个 0 垫步都在更新隐状态——短序列的最后一步输出根本不是它真实句子的结果。这一课用 torch 2.15(

aifannihao的博客 167

YOLOv8【第十章:多任务扩展深度篇·第16节】车道线检测——基于 YOLOv8-Seg 的车道线分割与拟合!

🏆 本文收录于 《YOLOv8实战:从入门到深度优化》 专栏。该专栏系统复现并梳理全网各类 YOLOv8 改进与实战案例(当前已覆盖分类 / 检测 / 分割 / 追踪 / 关键点 / OBB 检测等方向),坚持持续更新 + 深度解析,质量分长期稳定在 97 分以上,可视为当前市面上 覆盖较全、更新较快、实战导向极强 的 YOLO 改进系列内容之一。

**My Coding Family** 1万+

CNN 卷积神经网络深度解析:卷积、池化与特征提取的底层原理

卷积核(Kernel),也叫滤波器(Filter),本质上是一个可以训练的权重矩阵。1 0 -11 0 -11 0 -1这个卷积核可以对图像中的局部像素进行加权计算。不同的卷积核能够提取不同类型的特征:水平边缘特征垂直边缘特征纹理特征角点特征局部形状特征在传统图像处理中,滤波器通常由人工设计。而在 CNN 中,卷积核的权重通过训练数据和反向传播自动学习得到。这也是 CNN 能够自动提取图像特征的关键。# 第一层卷积padding=1# 第二层卷积padding=1。

2503_90237586的博客 299

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

基于 YOLOv8 与 CRNN 的车牌识别 Web 系统

两个模型通过裁剪区域衔接:检测侧只判断"是不是车牌、在哪里",识别侧只负责"框里的字符是什么",任何一段换模型都不影响另一段。这种拆分让定位精度与字符识别能力可以分别迭代,也让训练数据各取所需——检测用标注框,识别用文件名编码出的号牌真值。

Michael_Jay的博客 326

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

【无标题】无人机视角道路坑洞坑洼目标检测数据集深度学习 目标检测 无人机航拍 道路坑洞 路面病害 YOLO格式 数据集发布9032期

(一)类别构成该数据集聚焦单一类别——坑洞(类别 ID 为 0),任务指向明确,围绕无人机俯视视角下的道路坑洞目标开展检测标注。类别体系精简,与公路路面病害巡检的实际需求高度契合,图像中的坑洞样本可直接作为路面破损识别的核心正样本,便于对接道路养护排查流程。(二)数据数量数据集规模为 3285 张无人机俯视航拍图像,采用标准 YOLO txt 标注格式,标注框总计 4457 个,其中带有效标注的图片 2007 张,全部图片均带有有效标注。

qq_2529413168的博客 190

基于深度学习的猫图像目标检测方法研究:YOLOv8s模型海选、多种子对比训练与Django+ONNX部署实现详解

本课题基于深度学习研究猫图像目标检测问题。数据集含1000张猫图像、1188个标注框,按固定比例划分并冻结清单;训练前在多个候选族中短训海选,确定YOLOv8s为主模型,经学习率搜索与显存标定后完成150轮训练,验证集mAP50达到0.92,并以7个随机种子的对比实验验证稳定性。最优权重导出为ONNX接入Django系统,提供图片、视频、摄像头三种识别方式,配套识别记录管理与统计大屏,形成从训练到应用的完整闭环。

WEIXIN_JSJBSZDS的博客 227

第 05/24 期:计算图与自动微分:深度学习如何计算梯度

本文系统阐述了神经网络训练中梯度计算的本质:损失对参数的敏感性。通过构建计算图,将复杂函数分解为基本运算,利用链式法则实现反向传播。核心在于反向模式自动微分——以一次前向计算为基础,通过传播输出对中间变量的敏感性,高效求得所有参数梯度。相比前向模式,反向模式在参数多、目标为标量的场景下更高效。计算图不仅适用于神经网络,也广泛适用于任意可微程序。关键思想是:梯度是局部导数与上游敏感性的乘积,分支路径的贡献需累加,从而保证导数计算的正确性与效率。

weixin_47502228的博客 344

【深度学习项目实战·30】PM2.5短期预测:用LSTM构造没有未来信息的滑动窗口

本文基于北京PM2.5数据,使用LSTM实现从最近24小时历史观测预测下一小时PM2.5。重点解决时间切分、因果填补、滑动窗口构建与标准化等关键问题,确保模型仅依赖过去信息,避免未来泄漏。通过滚动单步预测与持续性基线对比,评估在原始单位下的MAE/RMSE,验证模型有效性。强调时间顺序与数据完整性,为时序预测提供可复现的实践框架。

银尘博客 526

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

qq_2529413168的博客 213

深度学习 目标检测 无人机巡检 防震锤 电力设备 YOLO格式 数据集发布

深度学习 目标检测 无人机巡检 防震锤 电力设备 YOLO格式 数据集发布 9038期

qq_2529413168的博客 342

AI 学习第 14 课:CNN 训 6 轮卡在 0.5352,数据没打乱

第 13 课把 Conv2d 的参数量和池化后的尺寸算清了,这课把卷积块拼成一个能训练的完整网络,跑满 6 个 epoch。第一版直接卡死:loss 从 2.6104 掉到 0.6989 就再也不动,

aifannihao的博客 253

深度学习基本原理:从数学基础到神经网络训练

深度学习训练的核心,是先确定模型结构,再通过前向计算得到损失,利用链式法则和反向传播计算梯度,最后借助优化器与学习率不断更新参数。真正理解这条链路,后续学习更复杂的网络结构才有可靠的基础。

chh563的博客 193

计算机毕业设计选题推荐:【基于深度学习的车辆损坏严重程度评估方法研究】ResNet50 图像分类

系统用 ResNet50 完成轻微、中度、严重三档分类,输出类别、置信度和单次耗时;视频按每秒一帧抽帧识别,历史区同步出图,没识别出来的帧也保留原图;识别记录可检索、看详情和删除,大屏按类别、时段和任务类型做统计。训练采用迁移学习,部署走 ONNX,推理前加纯色和域外两道拒识,尽量避免把非车损画面硬判成某一类。

BYSJLG的博客 241

RNN 循环神经网络深度解析:从基本原理、网络架构到 PyTorch 实战

在深度学习领域,神经网络主要用于处理各种类型的数据,例如图像、文本、语音和时间序列数据。对于图像任务,CNN(卷积神经网络)能够通过卷积操作提取空间特征;而对于文本、语音、股票价格、传感器数据等具有时间顺序的数据,传统神经网络往往难以充分利用数据之间的时序关系。例如:自然语言处理:理解一句话中前后词语之间的关系。语音识别:根据连续的声音信号识别语音内容。时间序列预测:根据历史数据预测未来趋势。股票预测:根据过去一段时间的价格变化预测未来价格。当前时刻的数据通常与之前时刻的数据存在关联。

2503_90237586的博客 137

MIT 6.S191:深度学习导论 CNN记录

RGB图像的“三维”指通道、高、宽,非空间厚度。Conv2d中权重为四维(输出通道×输入通道×核高×核宽),每张输出特征图融合所有输入通道信息,通过加权求和后加偏置生成。初始权重从均匀分布随机初始化,取值范围基于输入维度归一化(如√27)。全连接层参数由设计者设定,如Linear(64×6×6, 1024)中的6×6由卷积与池化层数决定,具体尺寸依赖输入图像大小及网络结构。

TonyHsuM的博客 346

基于深度学习的猫狗目标检测(Python+YOLO26m+Django)实现详解

详解基于深度学习的猫狗目标检测系统:YOLO26m迁移学习训练、数据划分与错标检测、ONNX导出、Energy阈值拒识、Django+Vue网站部署,附后端核心代码。

WEIXIN_JSJBSZDS的博客 389
上一篇: 告别“补点”时代:PaCo 用参数化补全重写多边形重建规则
下一篇: 视觉自回归建模:通过“下一尺度预测”实现可扩展的图像生成
山科智能信息处理实验室
博客等级 码龄6年 809粉丝 74原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值