真得收藏!深度学习模型一网打尽!

深度学习之Encoder-Only原理与实战 【代码】深度学习之Encoder-Only原理与实战。 阅读详情

前出了一期机器学习模型的文章受到不少同学的好评(没看过的可以点击图片查看)
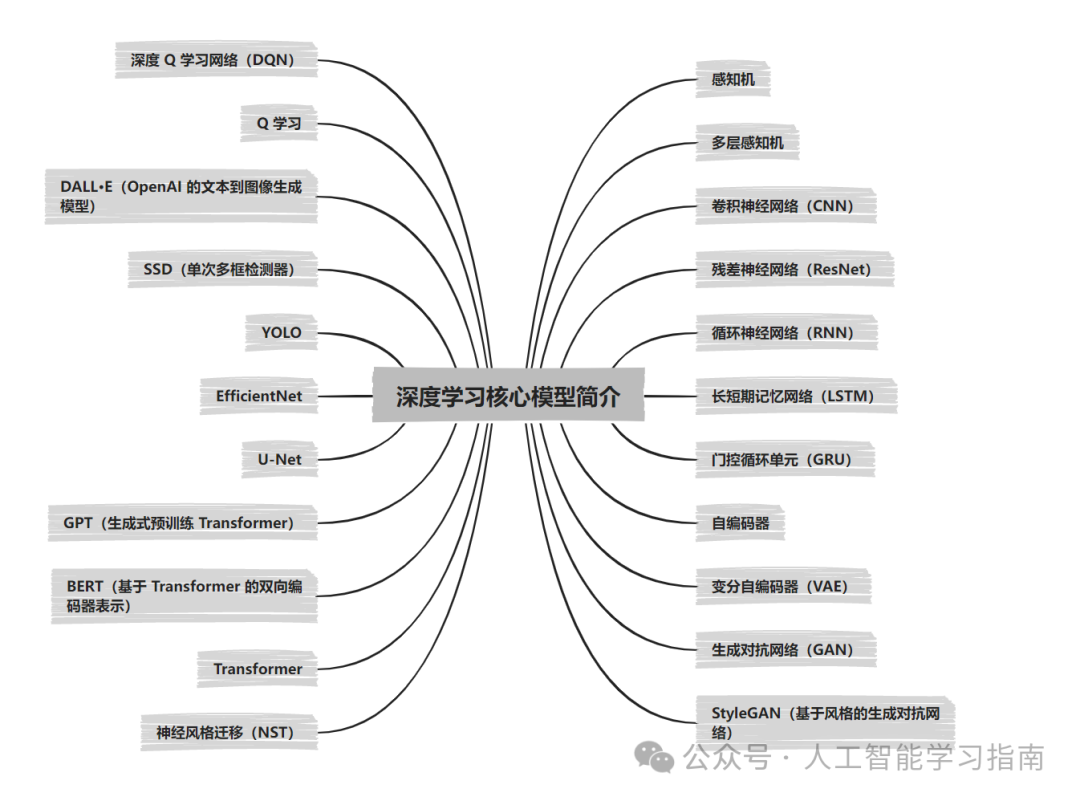
所以今天给大家带来——深度学习模型篇,本文将为大家简洁而全面地解析关键深度学习模型,大家可以当成模型备忘录。
图片.png

感知机

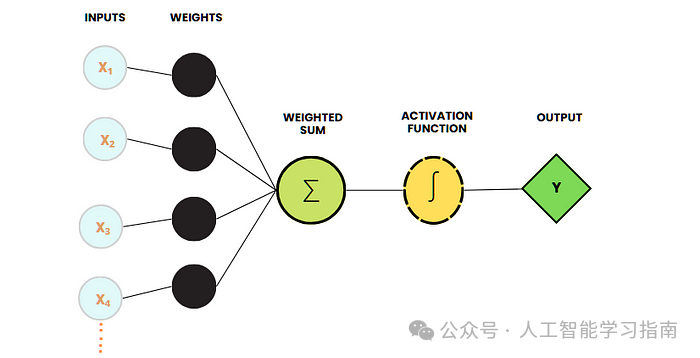
感知机是神经网络最基本的构建模块,常被称作人工神经元。

它由多个输入节点、一个加权求和函数以及一个决定输出的激活函数组成。

感知机旨在通过学习决策边界来解决二分类问题(例如区分猫和狗),该模型利用感知机学习算法更新权重,直至能够正确分类数据点。
None

多层感知机

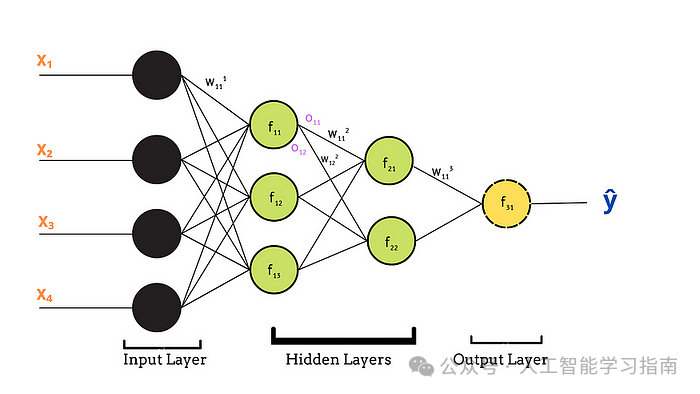
多层感知机(MLP)由三层或更多层构成,包括接收数据的输入层、学习复杂数据表示的一个或多个隐藏层,以及产生最终预测结果的输出层。

它使用 ReLU、Sigmoid 或 Tanh 之类的激活函数来引入非线性,从而能够捕捉复杂的数据模式。

多层感知机通过反向传播算法进行学习,在这个过程中,模型不断调整内部权重以最小化预测误差。
没有任何

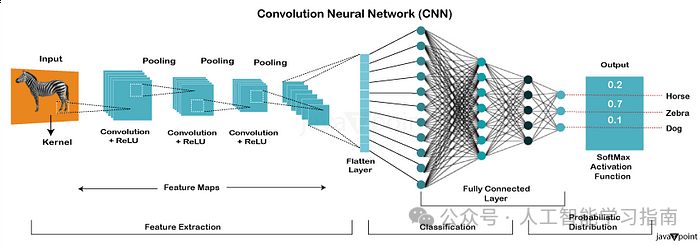
卷积神经网络(CNN)

卷积神经网络(CNN)是一种专门为处理网格状数据(如图像和视频)而设计的特殊神经网络。

受人类大脑视觉皮层的启发,CNN 能够自动从原始图像数据中提取边缘、形状和纹理等重要特征,无需人工进行特征工程。

CNN 的核心组件包括卷积层,它应用滤波器来检测模式。

池化层,它在保留重要信息的同时降低空间维度。

以及全连接层,它做出最终预测。
没有任何

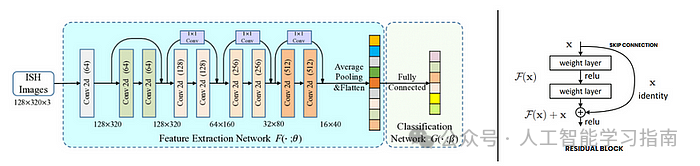
残差神经网络(ResNet)

残差神经网络(ResNet)是一种深度学习模型,旨在通过引入残差连接(或跳跃连接)来解决极深神经网络中的梯度消失问题。

在传统的深度网络中,梯度在经过多层传递后往往会逐渐减小,导致训练困难。

ResNet 通过允许梯度直接通过跳跃连接流动来解决这一问题,使模型能够在不降低性能的情况下训练极深的网络,核心思想是学习残差映射(输入与输出之间的差异),而非直接学习输出,从而使优化过程更加容易。
没有任何

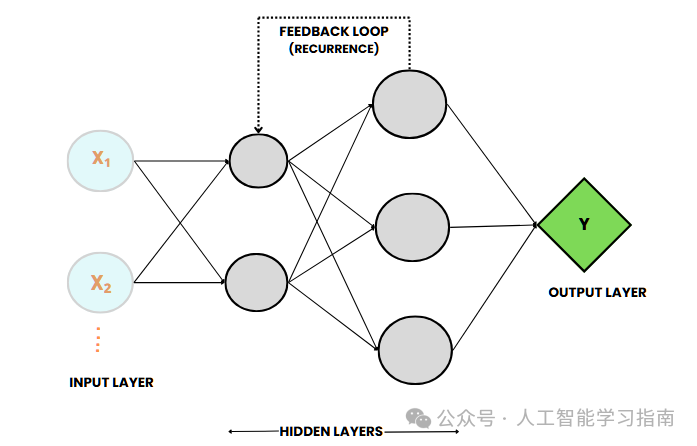
循环神经网络(RNN)

循环神经网络(RNN)是一种专门为处理序列数据(如时间序列、文本和音频)而设计的深度学习模型。

RNN  具有反馈回路,使其能够保留之前输入的信息,从而能够有效处理具有时间依赖性的任务。

这种类似记忆的行为使 RNN  能够理解数据的上下文,非常适合语言建模、语音识别和时间序列预测等应用。

标准的 RNN 往往难以处理长期依赖问题,这是由于梯度消失问题限制了其在长序列中捕捉信息的能力,为此引入了长短期记忆网络(LSTM)和门控循环单元(GRU)等变体,使 RNN 在序列任务中更加有效。
没有任何

另外我们精心打磨了一套基于数据与模型方法的 AI科研入门学习方案(已经迭代过5次,即将迭代第6次),对于人工智能来说,任何专业,要处理的都只是实验数据,所以我们根据实验数据将课程分为了三种方向的针对性课程,包含时序、影像、AI+实验室,我们会根据你的数据类型来帮助你选择合适的实验室,根据规划好的路线学习 只需5个月左右(很多同学通过学习已经发表了 sci 一区及以下、和同等级别的会议论文)学习形式为直播+录播,多位老师为你的论文保驾护航。

文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
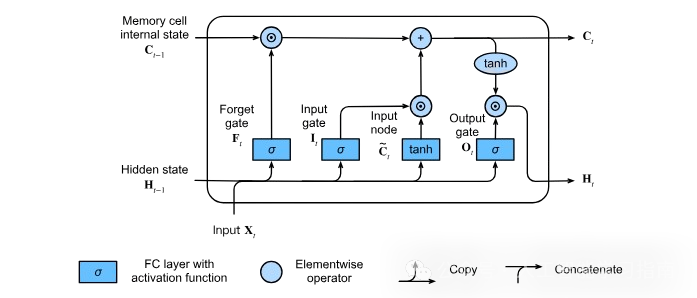
长短期记忆网络(LSTM)

长短期记忆网络(LSTM)是一种先进的循环神经网络(RNN),旨在克服标准 RNN 在捕捉长期依赖方面的局限性(梯度消失问题)。LSTM 采用了一种独特的架构,包含输入门、遗忘门和输出门,以及一个记忆细胞来控制信息的流动。

遗忘门决定丢弃哪些信息,输入门用新数据更新细胞状态,输出门确定下一个隐藏状态。

这种机制使 LSTM 能够捕捉序列数据中的长期依赖关系,对于需要长时间保留上下文的任务非常有效。
没有任何

门控循环单元(GRU)

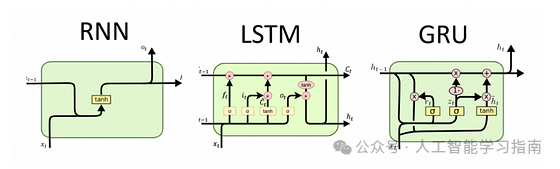
门控循环单元(GRU)是循环神经网络(RNN)的另一种先进变体,旨在解决梯度消失问题并提高训练效率。

与使用三个门的 LSTM  不同,GRU  只有两个门——更新门和重置门,更新门控制需要保留多少之前的信息,重置门决定应该遗忘多少过去的信息。

在训练速度至关重要且不影响性能的任务中,GRU  通常比 LSTM 更受青睐。
没有任何

自编码器

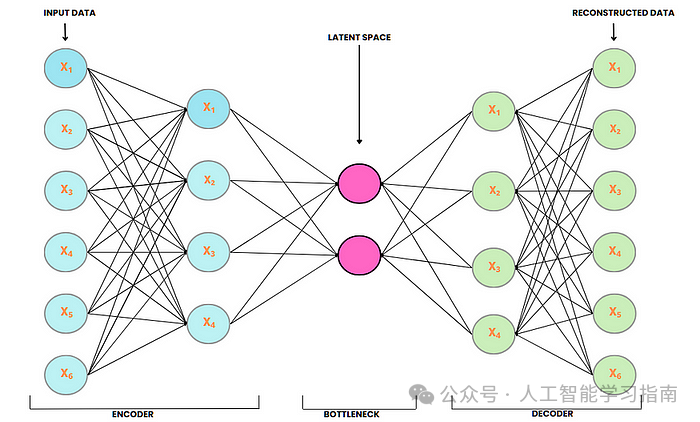
自编码器是一种无监督的深度学习模型,旨在将输入数据压缩到低维潜在空间,然后再将其重构回原始形式。

它由两个主要部分组成——编码器,将输入压缩为紧凑的表示。

解码器,从该表示中重构原始输入。

自编码器常用于降维、异常检测、图像去噪以及生成新的数据样本。
没有任何

变分自编码器(VAE)

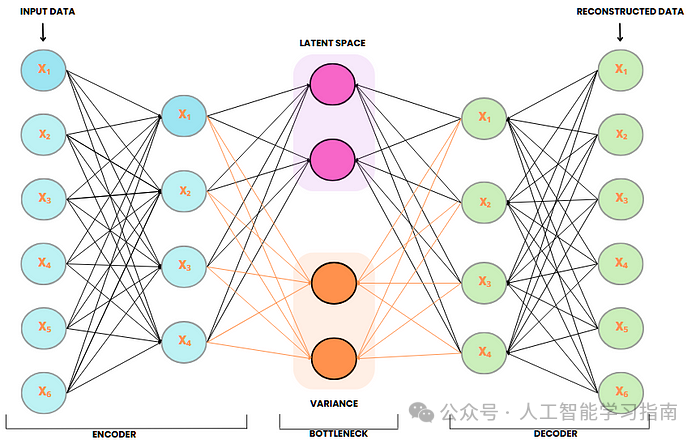
变分自编码器(VAE)是一种生成式深度学习模型,旨在学习输入数据的潜在表示,并生成与训练数据相似的新数据样本。

与标准自编码器不同,VAE 通过学习一个概率潜在空间引入随机性,编码器输出的是均值(μ)和方差(σ),而非固定的表示。

在训练过程中,从这些分布中随机采样潜在向量,通过解码器生成多样化的输出。

这使得 VAE 在图像生成、数据增强、异常检测和潜在空间探索等任务中非常有效。
没有任何

生成对抗网络(GAN)

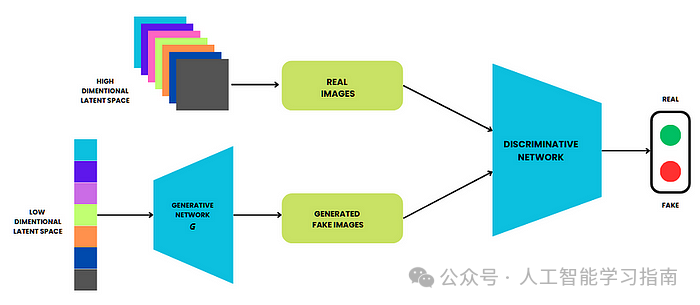
生成对抗网络(GAN)由两个神经网络组成——生成器和判别器,它们在零和博弈中相互竞争。

生成器从随机噪声中创建逼真的合成数据,而判别器则试图区分真实数据和生成的数据,随着训练的进行,生成器不断改进,直到能够生成判别器无法与真实数据区分的高度逼真的数据。

GAN 广泛应用于图像生成、深度伪造创建、数据增强和风格迁移等领域,是生成式深度学习中最强大的模型之一。
没有任何

StyleGAN(基于风格的生成对抗网络)

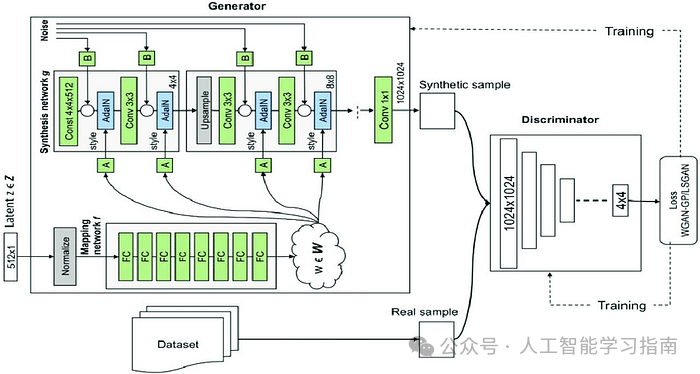
StyleGAN 是一种先进的生成对抗网络(GAN),专门用于高质量图像生成,尤其是在人脸合成方面。

与传统 GAN  不同,StyleGAN  引入了一种基于风格的生成器架构,其中潜在向量(输入噪声)首先被转换为风格表示,使模型能够控制不同的视觉属性,如年龄、发型、面部表情和背景。

该架构还使用了一种称为自适应实例归一化(AdaIN)的技术来控制这些风格变化,从而生成超逼真且可定制的图像。
没有任何

神经风格迁移(NST)

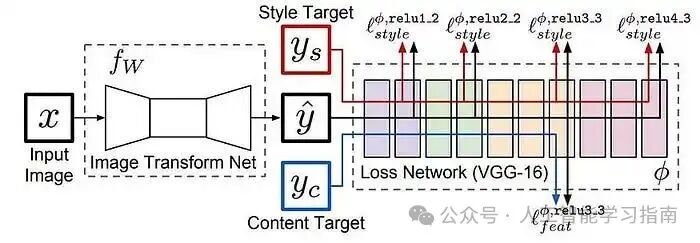
神经风格迁移(NST)是一种深度学习技术,它将一幅图像(风格图像)的艺术风格应用到另一幅图像(内容图像)的内容上,从而创建出视觉上吸引人的混合图像。

它使用通常在大规模图像数据集上预训练的卷积神经网络(CNN)来提取和操作图像的内容和风格表示。

该过程涉及最小化一个结合了内容损失(保留图像结构)和风格损失(捕捉艺术纹理)的损失函数,NST  广泛应用于艺术生成、照片风格化和创意图像处理等领域。
没有任何

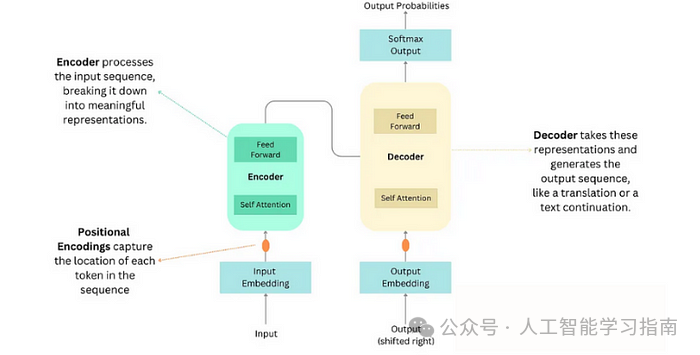
Transformer

Transformer  是一种用于处理序列数据(如文本或音频)的深度学习模型,无需使用循环或卷积。

相反,它采用了一种自注意力机制,使模型能够同时查看所有输入单词,并理解它们之间的相互关系,无论它们在序列中出现的位置如何。

该模型有两个主要部分——编码器,用于理解输入数据。

解码器,根据编码器的理解生成输出。

Transformer  广泛应用于 BERT、GPT 和 T5 等先进的自然语言处理模型中,因为它们速度快且效果显著。
没有任何

BERT(基于 Transformer 的双向编码器表示)

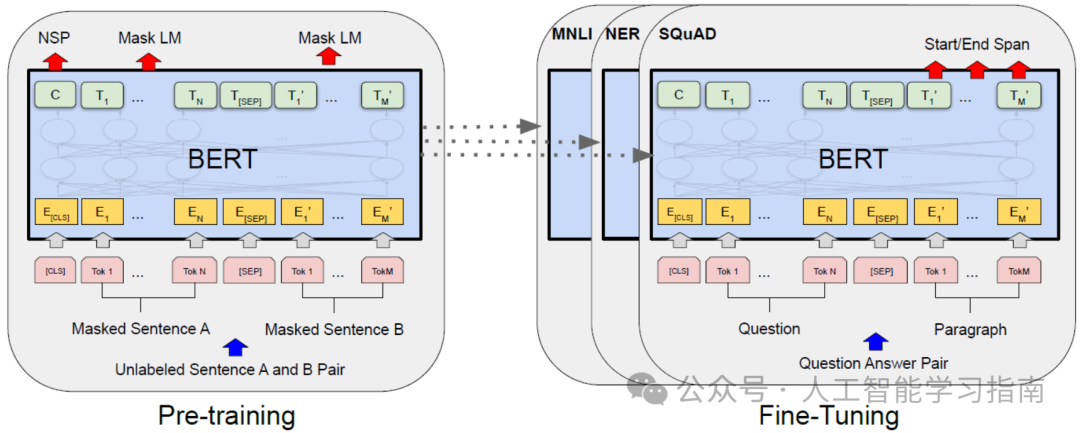
BERT 是一种基于 Transformer 架构的预训练深度学习模型,旨在从左右两个方向理解句子中单词的上下文(双向)。

与传统的顺序处理文本的模型不同,BERT 使用自注意力机制,通过一次性考虑整个输入序列来捕捉上下文含义。

它在大规模文本语料库上进行预训练,任务包括掩码语言建模(MLM)和下一句预测(NSP),从而能够生成深度的上下文嵌入。
GPT(生成式预训练 Transformer)

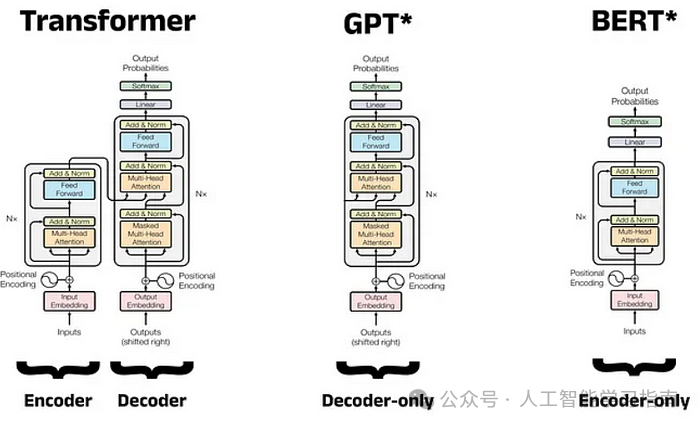
GPT 是一种基于 Transformer 架构的深度学习模型,主要用于生成文本、完成内容以及理解语言。

与从两个方向查看文本的  BERT 不同,GPT  从左到右逐个单词处理文本,能够根据前面的单词生成清晰且有意义的文本。

它在大规模文本数据上进行训练,以预测句子中的下一个单词,使其在聊天机器人、文本摘要和代码生成等任务中非常有效,GPT  的一个著名示例是 OpenAI 的 ChatGPT。
没有任何

U-Net

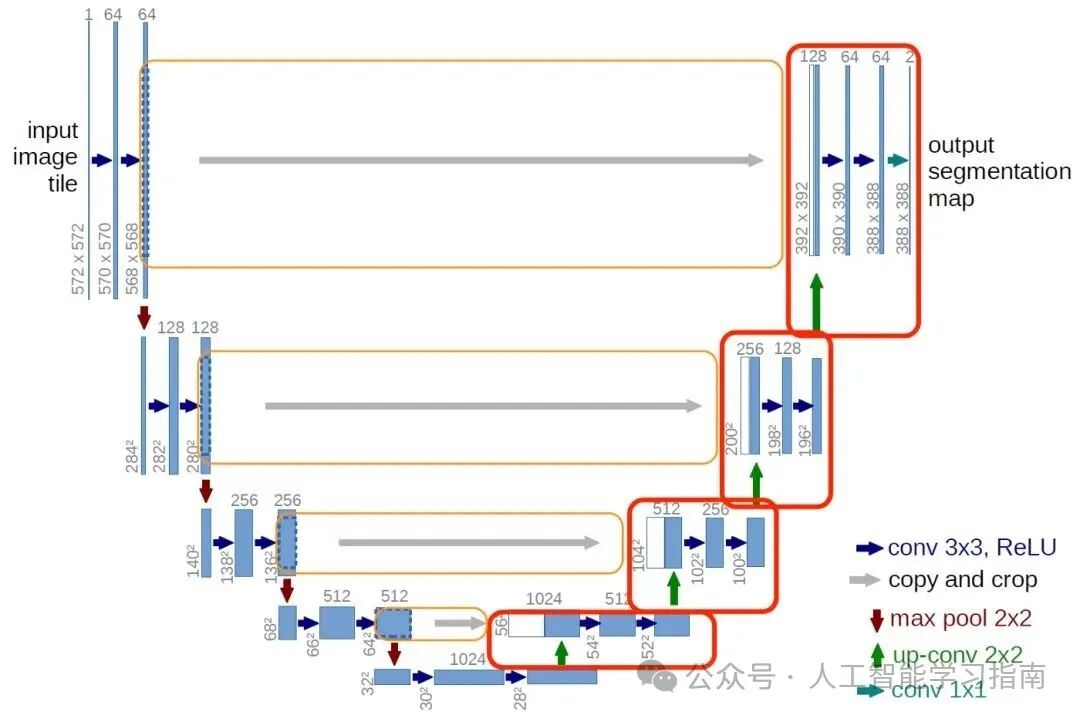
U-Net 是一种主要用于图像分割的深度学习模型,在医学图像分析中尤为常用。

其 U  形架构由两部分组成——编码器,用于捕捉重要特征并减小图像尺寸;解码器,用于重建具有清晰分割细节的图像。

U-Net  还使用跳跃连接将编码器的低层特征传输到解码器,从而保留图像细节,这使得它在医学图像分割、目标检测和卫星图像分析等任务中非常有效。
EfficientNet

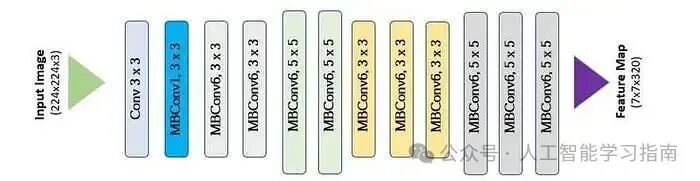
EfficientNet  是一种用于图像分类的深度学习模型,在计算量较小的情况下也能实现高准确率。

与传统模型仅通过增加网络规模不同,EfficientNet  采用复合缩放方法——均匀缩放网络的深度、宽度和分辨率,以获得更好的性能。这使得它比 ResNet 或 VGG  等更大的模型更快、更高效,因此在图像分类、目标检测和医学图像分析等任务中备受欢迎。
没有任何

YOLO

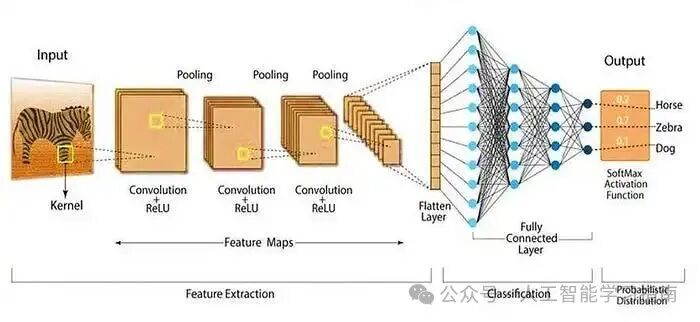
YOLO是一种用于图像和视频中实时目标检测的深度学习模型,与传统模型需要多步检测物体不同,YOLO  能够一次性完成检测,速度极快且效率极高。

它通过将图像划分为网格,并一次性预测物体及其位置,从而能够同时检测多个物体,这种速度使 YOLO  非常适合视频监控、自动驾驶和目标跟踪等实时应用。
没有任何

SSD(单次多框检测器)

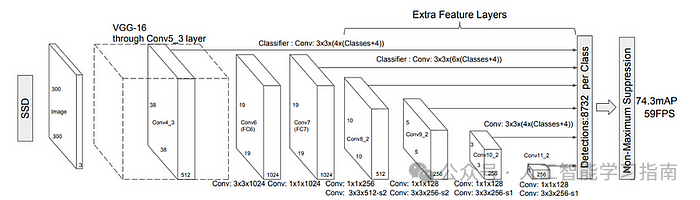
SSD(单次多框检测器)是一种用于图像和视频中实时目标检测的深度学习模型。

与传统模型需要两步检测物体不同,SSD  能够一次性完成检测,速度快且效率高,它使用多个特征图来检测不同大小的物体,从而能够准确处理小物体和大物体。

SSD  广泛应用于自动驾驶汽车、视频监控和需要速度和准确性的实时目标跟踪等领域。
没有任何

DALL·E(OpenAI 的文本到图像生成模型)

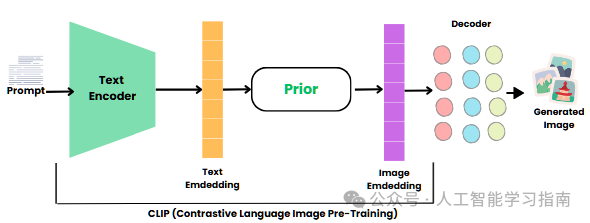
DALL·E 是 OpenAI 开发的一种生成式深度学习模型,能够根据文本描述生成逼真的图像(文本到图像生成)。

基于  GPT(生成式预训练 Transformer)架构构建,DALL·E 使用 Transformer  来理解文本提示并生成相应的视觉输出。

DALL·E 以仅根据文本输入就能生成高质量、多样化和创造性的视觉内容而广受认可。
没有任何

Q 学习

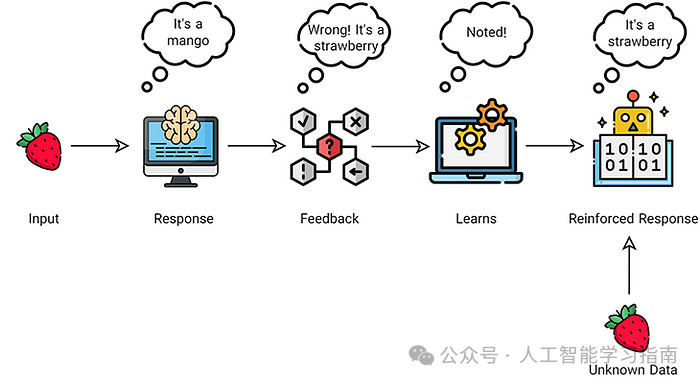
Q  学习是一种强化学习技术,机器通过试错来学习。一个“智能体”(如机器人或游戏角色)与环境交互,尝试不同的动作,并根据其选择获得奖励或惩罚。

随着时间的推移,它通过将经验存储在  Q 表中来学习最佳动作,这种方法常用于游戏人工智能、自动驾驶汽车和交易机器人等领域,帮助它们自主做出明智的决策。
没有任何

深度 Q 学习网络(DQN)

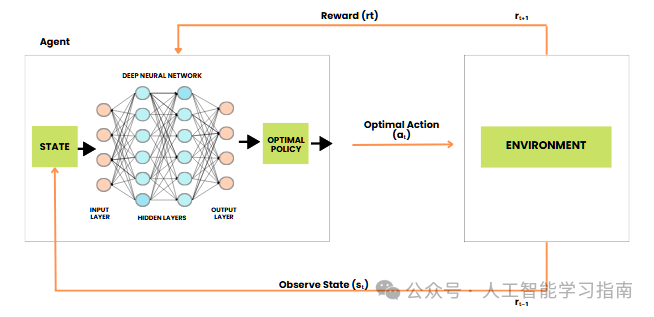
深度 Q 学习网络(DQN)是一种深度强化学习模型,它将 Q  学习(一种流行的强化学习算法)与深度神经网络(DNN)相结合,使智能体能够在复杂环境中学习最优动作。

与使用 Q 表存储状态 - 动作值的 Q  学习不同,DQN 使用神经网络来近似这些值,从而能够处理高维状态空间(如游戏中的图像),DQN 还结合了经验回放和目标网络等技术来稳定训练。
没有任何

另外我们精心打磨了一套基于数据与模型方法的 AI科研入门学习方案(已经迭代过5次,即将迭代第6次),对于人工智能来说,任何专业,要处理的都只是实验数据,所以我们根据实验数据将课程分为了三种方向的针对性课程,包含时序、影像、AI+实验室,我们会根据你的数据类型来帮助你选择合适的实验室,根据规划好的路线学习 只需5个月左右(很多同学通过学习已经发表了 sci 一区及以下、和同等级别的会议论文)学习形式为直播+录播,多位老师为你的论文保驾护航。

文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

深度学习之Seq2Seq原理与实战 【代码】深度学习之Seq2Seq原理与实战。 阅读详情

相关推荐

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 187

深度学习模块汇总(一)

深度学习模块汇总

weixin_63087177的博客 2746

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 258

深度学习四大核心模型全解析:从CNN到Transformer的技术演进与实战

深度学习是机器学习的进阶分支,其核心突破在于构建"多层神经网络",实现从数据中自动提取特征的能力——无需人工设计特征工程,模型就能从像素、音频等原始数据中,逐层挖掘出边缘、纹理、语义等高级信息。层次化特征提取:通过卷积、激活函数等非线性变换,将底层原始数据转化为高层抽象特征。例如识别猫时,先捕捉线条边缘,再组合成耳朵、眼睛等部件,最终形成完整的猫的特征表示。端到端学习:直接建立输入(如图片)到输出(如"猫"的标签)的映射关系。

优快云_224022的博客 1831

基于Ardupilot/PX4固件,APM/PIXhawk硬件的VTOL垂直起降固定翼软硬件参数调试(第一篇)安装调试

基于Ardupilot/PX4固件,APM/PIXhawk硬件的VTOL垂直起降固定翼调试 本文内容大部分来自Kris,我们的K大,在VTOL领域的大牛,在此,非常感谢K大。能引用K大的成果也是自己的荣幸,不便之处还请K大多多包涵,在此引用只是为方便自己日常学习,部分参数表里根据自身情况,增加了相应参数。 1.安装及下载Ardupilot官方固件: VTOL固件的来源可分为Ardupilot官方固...

u011322358的博客 3万+

DOTween回调函数的隐藏技巧:优化你的Unity动画流程

本文深入探讨了DOTween回调函数在Unity动画开发中的高级应用技巧,帮助开发者优化动画流程。通过分析回调机制、链式应用模式和大规模动画系统管理,提升性能与可维护性,特别适合需要高效处理复杂动画场景的Unity开发者。

weixin_27945229的博客 319

深度学习三大核心模型解析:CNN、RNN、GAN的奥秘与实践

(注:此处可插入相关技术概念图)

不止顾望 不怠所学 1374

LabVIEW与MySQL的连接:软件下载与安装至UDL文件创建全过程

依据个人经验编辑的十分完备的使用教程

tiaowudexiaoyu的博客 5574

深度学习在生成式模型领域的应用

1.背景介绍 深度学习是人工智能领域的一个重要分支,它通过模拟人类大脑中的神经网络来解决复杂的问题。生成式模型是深度学习中的一个重要类别,它们的目标是生成新的数据样本,而不是直接对现有数据进行分类或预测。在这篇文章中,我们将探讨深度学习在生成式模型领域的应用,包括背景、核心概念、算法原理、代码实例等。 2.核心概念与联系 生成式模型可以分为两类:确定性模型和概率性模型。确定性模型生成的数据是...

AI天才研究院 949

树莓派与无人机协同实战:基于OpenCV的地标识别优化策略

本文深入探讨了基于树莓派与无人机的协同系统,重点分享了利用OpenCV优化地标识别以实现精准降落的实战策略。内容涵盖从应对复杂光照的图像预处理、鲁棒的轮廓几何过滤,到通过ROS进行稳定通信,以及实现分层控制与状态机设计,旨在提升系统在真实环境中的可靠性与性能。

y2z3a4b5c的博客 1086

Debian下Rust环境极速安装指南:国内镜像+避坑配置(附清华/中科大源对比)

本文详细介绍了在Debian系统上快速安装和配置Rust开发环境的完整指南。针对国内网络环境,重点对比评测了清华大学、中国科学技术大学等主流镜像源,提供了详细的安装配置步骤、Cargo优化技巧以及常见问题排查方案,帮助开发者显著提升依赖下载和编译效率。

s8t9u0v1w的博客 1162

盘点人工智能深度学习的五大模型

BERT通过在大量文本数据上进行预训练,学习到了丰富的语言知识,然后在特定任务上进行微调,如文本分类、情感分析等。GPT(Generative Pre-trained Transformer)也是一种基于Transformer的预训练语言模型,它的最大创新之处在于使用了单向Transformer编码器,这使得模型可以更好地捕捉输入序列的上下文信息。未来深度学习在自动驾驶、视觉识别、智能机器人助手等方向会有更大的发展,有可能改变如今的生活,是前景非常好的一个方向,值得学习入门。学习人工智能技术——滴滴我。

cd_farsight的博客 853

auto.js梦幻西游游戏脚本,梦幻西游脚本开发思路

本篇文章给大家谈谈梦幻西游脚本用什么语言写,以及auto.js梦幻西游游戏脚本,希望对各位有所帮助,不要忘了收藏本站喔。

npy199331的博客 1939

深度学习核心网络模型梳理

网络基石:单个神经元的能力有限(仅能拟合简单非线性关系),但当大量神经元按层堆叠(形成多层网络)后,可组合低阶特征形成高阶抽象特征(如“图像类别”“文本语义”),为神经网络处理复杂任务提供基础。权重 w = [ w 1 ​ , w 2 ​ , . . . , w n ​ ] w=[w_1​,w_2​,...,w_n​] w=[w。自编码器(Autoencoder):编码器-解码器结构,用于无监督特征学习(降维、去噪)。数据处理:归一化、增强、填充、截断、分词(NLP)、tokenize(多模态)

2401_89306935的博客 554

ZYNQ Petalinux编译系统启动文件实战指南

本文提出的混合编译加速方案实测可将编译时间从45分钟缩短至18分钟,QSPI双启动方案已在工业控制领域成功应用。Xilinx官方UG1144文档(最新v2023.1版)正点原子《ZYNQ嵌入式开发实战》开源项目Meta-Petalinux(GitHub趋势项目)未来展望:随着Versal平台的普及,Petalinux将支持更多AI加速器原生驱动,值得持续关注。

QQ_778132974的博客 812

工业质检封神!YOLOv8实战金属表面缺陷检测,自建数据集mAP突破95%

本文详细介绍了基于YOLOv8的金属表面缺陷检测实战方案。针对工业质检中的光照不均、纹理复杂、小样本等挑战,作者构建了12000张图像的数据集,提出针对性数据增强策略和两阶段训练方法。通过优化损失函数、调整超参数等技术手段,最终在测试集上达到95.1%的mAP@0.5,检测速度32FPS。相比传统方法,该方案在精度和鲁棒性上均有显著提升,为工业视觉质检提供了可复现的落地解决方案。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 428

一文了解深度学习模型:CNN、RNN、GAN、transformer

深度学习是一种模仿人脑神经网络结构和功能的机器学习方法,通过构建多层神经网络模型,自动从大规模数据中学习复杂的特征表示。其核心原理包括和层次化特征提取:通过多层非线性变换,逐步提取数据的高级语义特征端到端学习:直接学习输入与输出间的映射关系,无需人工干预这种机制使深度学习能有效处理高维、非线性数据,在图像识别、语音识别和自然语言处理等领域展现出卓越性能。

Java_rich的博客 2万+

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

深度学习中模块设计汇总(一)

2.1离散小波逆变换 Inverse discrete wavelet transform (IDWT)全局上下文 res-dense 模块包含一个残差密集块 (RDB) 和一个全局上下文块 (GCB)DWT 的本质是将输入特征图分解为高频和低频分量,离散小波变换(DWT)上采样和下采样。1.全局上下文 res-dense 模块。1.2 全局上下文块 (GCB)1.1 残差密集块 (RDB)2.离散小波变换(DWT)............

learning5201的博客 3258

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

【深度学习】深度学习模型

ResNet在2015年被提出,在ImageNet比赛classification任务上获得第一名,深度残差网络,ResNet可以解决“随着网络加深,训练误差不下降”的问题,这是因为Resnet提供了两种选择方式,也就是identitymapping和residualmapping,如果网络已经到达最优,继续加深网络,residualmapping将被push为0,只剩下identitymapping,这样理论上网络一直处于最优状态了,网络的性能也就不会随着深度增加而降低了。...

小张同学的博客 3482

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Python 中 argparse 模块简介

argparse 的作用 argparse是python标准库里面用来处理命令行参数的库,其目的就是为py文件封装好可以选择的参数。举个例子:在Linux系统中,我们常用到 ls 这个命令,默认情况下 ls 会显示当前目录的所有文件或文件夹名称,但是当我们想要获得更多信息,如文件的权限、建立时间等,就需要在 ls 命令后加上 -all 或其他被允许的指令。因此对 ls 这个命令而言,假设我们想改...

Sweety_Lin的博客 641

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 196

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 358

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 215

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 353

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 385
上一篇: 深度学习入门教程(附详细解释笔记)
下一篇: AI医学必看!使用SHAP解释医疗机器学习模型中的预测结果
深度学习机器学习
博客等级 码龄2年 495粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值