AI医学必看!使用SHAP解释医疗机器学习模型中的预测结果

SHAP实战:用kernelshap和shapviz搞定医疗数据预测的可解释性分析(附完整代码) 本文详细介绍了如何利用SHAP工具(特别是kernelshap和shapviz组合)进行医疗数据预测的可解释性分析。通过完整代码示例,展示了从数据预处理到SHAP值计算、可视化及临床解释的全流程,帮助医疗AI开发者创建透明且可信的预测模型,满足临床决策中对模型解释性的需求。 阅读详情

假设你是一名医生,正在使用一款AI工具,该工具显示某位患者有78%的概率患上糖尿病,但当你问它原因时,工具却无法说出个所以然来,我们肯定不会相信这个AI工具给出的结果。

在医疗领域,仅靠准确性是不够的,无论你是医生、研究人员还是患者,都需要了解预测背后的原因,尤其是当它影响治疗、诊断或医疗服务的获取时。

这时,SHAP就派上用场了,SHAP(SHapley Additive exPlanations)帮助我们洞察机器学习模型的“黑箱”,看清其内部运作。

它展示了哪些特征(如BMI、年龄或血压)在驱动模型的决策,以及每个特征的贡献程度。

本文将通过一个真实的医疗案例,展示如何使用SHAP来解释预测糖尿病风险的模型。

包含:

  • 全局特征重要性——模型用于预测的主要因素

  • 特征效应——每个特征如何影响风险,以及特征之间的相互作用

  • 个体预测——模型如何解释为何给特定的人打高(或低)风险分

本文的目标是展示SHAP如何增进理解、信任和透明度——在AI与医疗相遇的今天,这比以往任何时候都更为重要。

什么是SHAP,为何要关注它?
大多数机器学习模型就像黑箱,你输入数据(如患者的年龄、体重和血压),它输出结果(如风险评分),但它很少解释得出结论的过程。

SHAP值(SHapley Additive exPlanations的缩写)解决了这一问题,它们精确展示了每个特征对每个个体预测的贡献程度。

可以把这想象成分配小组作业的功劳,想象五个人合作完成了一个项目,得了A。

SHAP可以算出每个人做了多少工作——谁提高了成绩,谁没帮忙,谁甚至拖了后腿。

现在把这个思路应用到AI模型上:SHAP展示了哪些特征(如BMI、年龄或高胆固醇)将预测推向了“是的,这个人有患糖尿病的风险”。

例如:

  • 如果患者的BMI非常高,这可能会将预测推向“糖尿病”。

  • 如果他们年轻且经常运动,这些因素可能会拉低预测值。

SHAP不仅对一个人这样做——它对每个预测都这样做,还能展示模型总体上学到了什么。

这就是SHAP的强大之处:即使模型很复杂,它也能帮助你理解模型的“思考”过程。

另外我们精心打磨了一套基于数据与模型方法的AI科研入门学习方案(已经迭代第6次),对于人工智能来说,任何专业,要处理的都只是实验数据,所以我们根据实验数据将课程分为了三种方向的针对性课程,包含时序、影像、AI+实验室,我们会根据你的数据类型来帮助你选择合适的实验室,根据规划好的路线学习 只需3-5个月左右(很多同学通过学习已经发表了 sci 一区及以下、和同等级别的会议论文)学习形式为直播+录播,多位老师为你的论文保驾护航。

适合人群:

  • 导师放养,自学无头绪

  • 时间紧任务重有延毕风险

  • 想提前完成大小论文为之后读博或工作做准备的

  • 想通过发表sci论文、提升科研能力bao研、考研的本科同学

文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
数据与模型

在这个项目中,使用了名为“糖尿病健康指标数据集”

(https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset/data)的公开数据集。

它包含了数千人的健康调查信息,如年龄、BMI、身体活动、总体健康状况以及是否患有糖尿病。

为了构建模型,使用了XGBoost,这是一种在结构化数据上表现优异的流行机器学习算法。

选择XGBoost的原因之一是它与SHAP无缝协作,使我们能够清晰高效地解释预测。

model = xgb.XGBClassifier(
    n_estimators=100,100,
    max_depth=4,
    learning_rate=0.1,
    use_label_encoder=False,
    eval_metric='logloss',
    random_state=42
)

model.fit(X_train, y_train)

在医疗领域,可解释性至关重要,医生和患者不仅需要预测结果——他们还需要理解模型为何做出这样的预测,这就是没有在这里使用复杂的深度学习模型的原因,相反专注于强大且可解释的模型。

接下来,我们将使用SHAP来探索模型学到了什么——以及它是如何做出决策的。

模型最依赖哪些特征?

训练完模型后,下一个重要问题是:

“模型在做出预测时关注哪些因素?”

SHAP通过展示全局特征重要性轻松回答了这个问题——换句话说,模型在所有患者中使用的最多的特征。

让我们看两个简单的可视化图表。

SHAP汇总图(蜂群图)
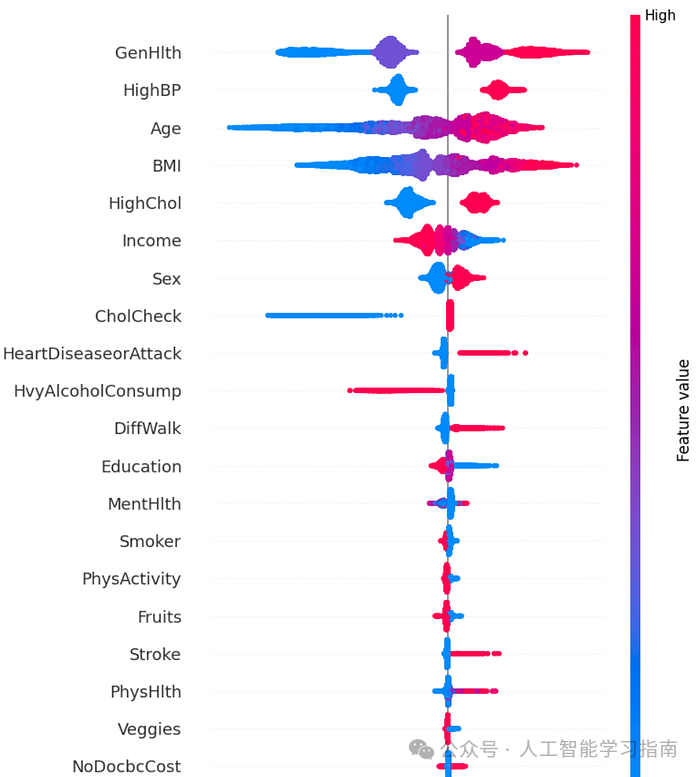
这个图表初看可能很复杂,但一旦知道如何解读,其实非常直观。

解读方法:

  • 每一行代表一个特征(如BMI、年龄等)。

  • 每个点代表一个患者。

  • 颜色表示该特征的实际值(红色=高,蓝色=低)。

  • x轴上的位置表示该特征将模型的预测值提高了还是降低了。

关键发现:

  • GenHlth(自我报告的总体健康状况)是最重要的特征。健康状况较差(红色)会强烈推动预测结果趋向糖尿病。图上的点分布广泛,表明排列重要性较高。

  • HighBP(高血压):高血压(红色)持续增加预测的糖尿病风险,而低血压(蓝色)则降低风险。

  • Age(年龄):年龄较大的人(红色)更有可能被预测为糖尿病患者。中间区域的聚集表明可能与其他特征存在相互作用。

  • BMI(体重指数):BMI越高,预测风险越大,尤其是在BMI为25-40之间。中间范围的重叠表明与其他特征存在相互作用。

  • Heart Disease or Attack(心脏病或发作):大多数患者的SHAP值较低,但少数心脏病患者(粉色点)的风险明显更高。这与临床现实相符:心脏病虽然罕见,但影响重大。

  • Stroke(中风):与心脏病类似:受影响的患者较少,但受影响的患者糖尿病风险急剧增加,反映在较高的SHAP值上。

SHAP条形图
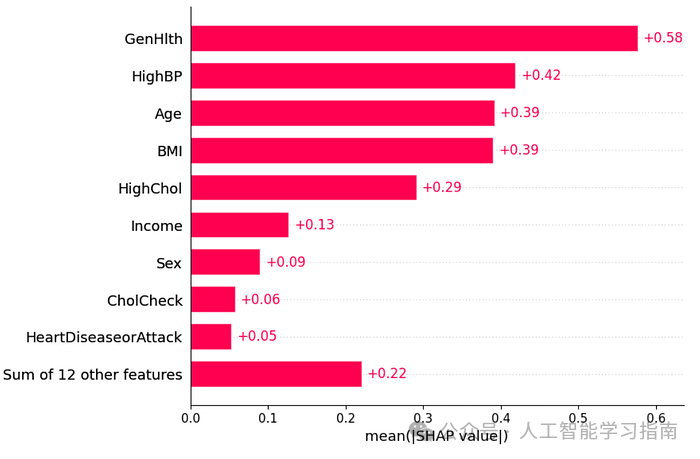
这个条形图更简洁地总结了同样的观点:它根据特征对模型的平均贡献程度对特征进行排名。

从两个图表中,我们了解到最重要的特征是:

  • 总体健康状况——患者如何评价自己的健康

  • 高血压

  • 年龄

  • BMI

  • 高胆固醇

这些都是众所周知的糖尿病风险因素,模型优先考虑这些因素使其更值得信赖,尤其是在医疗领域,我们希望模型能像临床医生一样“思考”。

为什么这很重要

这些图表让我们从宏观上了解模型在做什么,它们有助于回答:

  • “模型是否使用了正确的特征?”

  • “它是否与医生对糖尿病的了解相符?”

  • “我们能信任它的决策方式吗?”

到目前为止,答案似乎是肯定的。

特征如何影响风险?

现在我们知道模型依赖哪些特征了,让我们深入探讨每个特征如何影响预测。

这正是SHAP的用武之地,它不仅告诉你哪些特征重要——还告诉你它们如何重要。

这些散点图(称为依赖图)展示了随着特征值的上升或下降会发生什么。

让我们看几个重要的例子。

BMI:风险上升最显著的因素
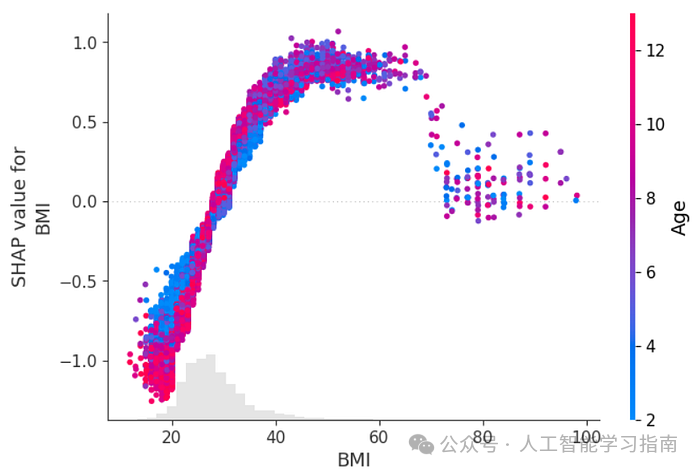
随着BMI的增加,模型预测的糖尿病风险上升——但并非呈直线上升。

BMI在25到40之间时,风险急剧上升,然后对于极高的BMI,风险趋于平稳。

这反映了我们在临床环境中经常看到的情况:超重会增加糖尿病风险,但这种影响在极高的BMI时趋于平缓。

我们还用年龄对点进行了颜色编码,你可以看到,即使BMI相同,年龄较大的人(粉色点)的SHAP值往往更高,这表明BMI和年龄之间存在相互作用。

对于年龄较大的人来说,高BMI可能比年轻人更危险。

年龄:风险增加,与体重无关
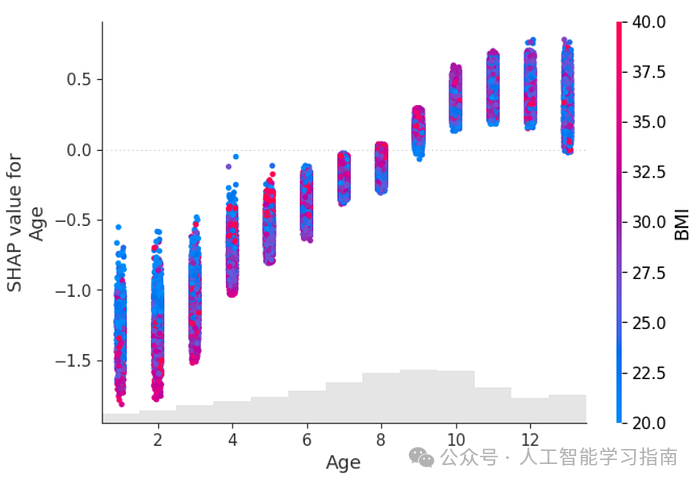
随着年龄的增长,预测的糖尿病风险单调增加——即持续上升,没有下降。

这是意料之中的:年龄是已知的风险因素。

有趣的是,这种模式在各种BMI水平上都存在,即使BMI较低的人(蓝色点),随着年龄的增长,风险也会上升。

换句话说,年龄是一个强大的独立预测因素——无论体重如何,模型都将其视为重要因素。

心脏病:危险信号
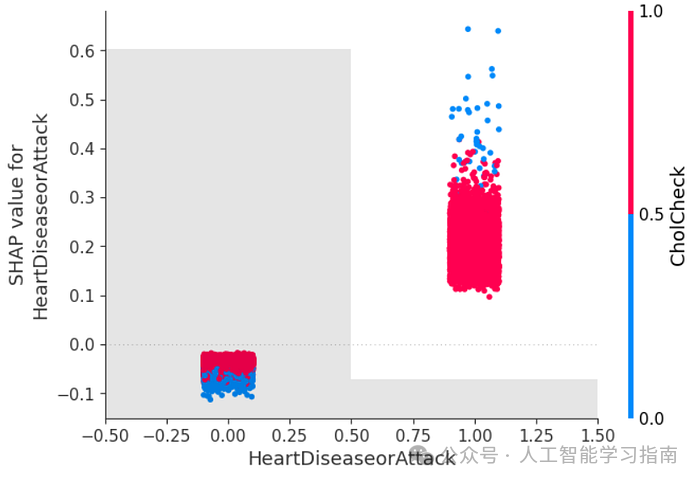
这个特征更简单——它是一个是/否(二元)特征,很明显:曾心脏病发作或患有心脏病的人预测的糖尿病风险要高得多。

虽然这些事件在数据集中相对罕见(这就是为什么大多数点的SHAP值较低),但少数心脏病患者脱颖而出——模型给他们的SHAP值很高。

这与我们对长期健康的看法一致:如果一个人有心血管问题,他们患糖尿病等代谢疾病的风险也更高。

为什么这很重要

这些图表帮助我们理解模型如何使用特征,而不仅仅是哪些特征重要。我们可以发现与医学知识相符的模式、阈值和相互作用(有时甚至能学到新东西)。

例如:

  • BMI和年龄不仅各自重要——它们还以有趣的方式相互作用。

  • 一个反映现实世界风险因素的模型更容易让医生和患者信任和理解其预测。

为什么模型会做出这样的预测?

用SHAP解释个体预测
到目前为止,我们已经了解了SHAP如何解释模型的整体行为——它学到了什么,使用了哪些特征,以及这些特征如何影响预测。

接下来让我们问模型:

“你为什么预测这个人有患糖尿病的风险?”

这时,SHAP力图和瀑布图就派上用场了。

什么是SHAP力图?

力图就像特征之间的拔河比赛。
它展示了:

  • 基础值:模型在看到任何特征之前的平均输出。

  • 最终预测:模型根据这个人的数据改变了多少想法。

  • 红色箭头:增加风险的特征。

  • 蓝色箭头:降低风险的特征。

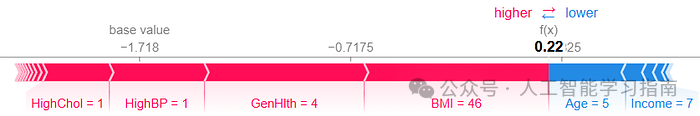
示例1:中度糖尿病风险预测

让我们看一个被预测患有糖尿病的人。
如何解读他的力图:

基础值 = -1.718,模型在看到任何特征之前的平均输出(对数几率),这代表了一个基本的低风险。

模型输出(f(x))= 0.22。这个患者的最终预测对数几率,高于基础值,这意味着与普通人相比他们的风险增加,概率为55%。

🔴 增加风险的特征(红色箭头):

  • HighChol = 1 → 胆固醇高

  • HighBP = 1 → 血压高

  • GenHlth = 4 → 自我评价总体健康状况较差

  • BMI = 46 → 极高的BMI

🔵 降低风险的特征(蓝色箭头):

  • Age = 5 → 年龄较小(可能是40多岁)

  • Income = 7 → 收入较高,通常与更好的医疗服务获取相关

要点:
尽管这个人相对年轻且富裕,但模型预测他们患糖尿病的风险为中到高,主要是由于总体健康状况极差和BMI极高。

示例2:相似但风险更高的患者
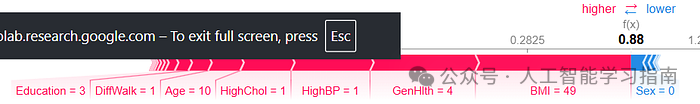
接下来,选择了一个与上一个人有一些相同“不良”特征(高BMI、健康状况差)但情况更糟的患者,这次模型的预测值更高。

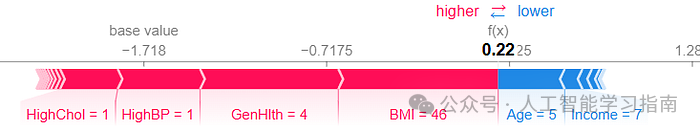
模型输出(f(x))= 0.88,这个患者的最终预测对数几率,高于基础值和上一个患者,概率为70%。

在他们的力图中:

  • 红色箭头更长——尤其是BMI和GenHlth

  • 蓝色箭头更少或更小

这个对比展示了SHAP如何帮助我们理解两个相似患者之间的差异,以及是什么将一个预测推得比另一个更高。

瀑布图呢?

SHAP水fall图以逐步叠加的格式展示了与力图相同的观点。
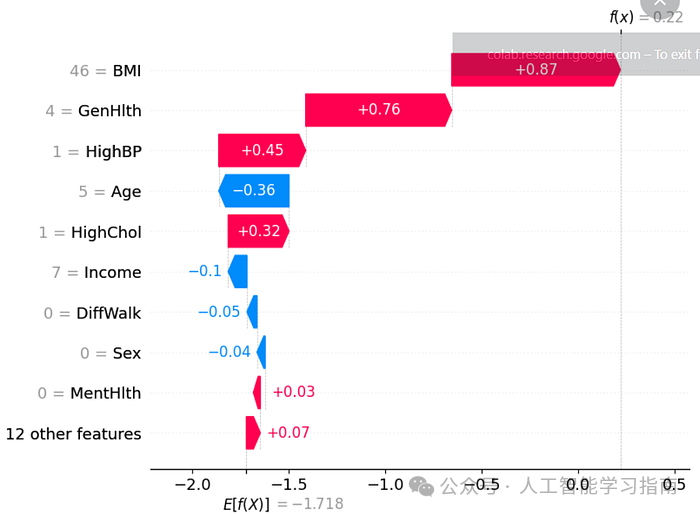
如何解读:

  • 图表从基础值开始。

  • 每个条形展示一个特征如何将预测值提高或降低。

  • 最后一个条形给出模型的输出(预测)。

为什么这很重要

有了SHAP,我们得到的不仅仅是一个数字——我们得到了数字背后的故事。

医生可以看到哪些症状或风险因素促使AI做出了决定,患者可以得到更透明、更易理解的结果,数据科学家可以在最重要的时刻调试或辩护预测。

这种透明度建立了信任、问责制和洞察力,这在医疗AI中至关重要。

为什么SHAP很重要(尤其是在医疗领域)

在医疗领域,决策可能关乎生死,这就是为什么理解AI模型如何做出预测如此重要,SHAP帮助所有相关人员:

  • 数据科学家可以调试模型,尽早发现错误或偏差。

  • 医生对AI工具更有信心,因为他们可以看到模型为何做出特定预测。

  • 患者从透明度中受益,使AI驱动的医疗服务不再那么神秘。

黑箱AI模型——那些给出答案却不解释的模型——是有风险的。

如果没有可解释性,我们可能会忽略隐藏的偏差或错误的推理,从而对患者造成伤害。

SHAP就像一座桥梁,将AI的复杂计算与医生和患者能够理解的现实决策连接起来。

另外我们精心打磨了一套基于数据与模型方法的AI科研入门学习方案(已经迭代第6次),对于人工智能来说,任何专业,要处理的都只是实验数据,所以我们根据实验数据将课程分为了三种方向的针对性课程,包含时序、影像、AI+实验室,我们会根据你的数据类型来帮助你选择合适的实验室,根据规划好的路线学习 只需3-5个月左右(很多同学通过学习已经发表了 sci 一区及以下、和同等级别的会议论文)学习形式为直播+录播,多位老师为你的论文保驾护航。

适合人群:

  • 导师放养,自学无头绪

  • 时间紧任务重有延毕风险

  • 想提前完成大小论文为之后读博或工作做准备的

  • 想通过发表sci论文、提升科研能力bao研、考研的本科同学

文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

第二十讲:SHAP 值与模型可解释性详解(附案例) [特殊字符] SHAP 让复杂机器学习模型“开口说话”,告诉你每一个预测值是怎么来的。 阅读详情

相关推荐

打开AI黑箱:SHAP让医疗AI决策更清晰的编程路径

医疗AI可解释性:SHAP技术助力破除“黑箱”困境 本文探讨了人工智能在医疗领域应用中的核心挑战——模型可解释性问题。尽管AI在疾病预测等方面表现优异,但其“黑箱”特性阻碍了临床信任的建立。文章重点介绍了可解释性人工智能(XAI)技术SHAP(SHapley Additive exPlanations),该技术源自博弈论,能有效解析复杂医疗模型的决策逻辑。通过糖尿病预测的实战案例,展示了SHAP如何生成全局特征重要性分析和个体化决策解释,帮助医生理解AI的判断依据。文章强调,医疗AI必须满足临床可理解性、决

AllenLV的博客 1404

第十三天打卡

在SHAP可视化中,带有base value(基准值)的图通常是指force plot(力图),它展示了模型预测是如何由各个特征贡献组成的。在SHAP可视化中,带有mean(均值)的图通常是指 特征重要性图 (summary plot),它展示了各特征对模型预测的平均影响程度。在SHAP可视化中,带有"SHAP value"的图(通常是详细特征影响图)展示了各个特征值如何影响模型预测的具体细节。- E(f(x))=0.501 :基准值(模型在所有样本上的平均预测概率)

nbbsn的博客 3767

从Kaggle心脏病预测到模型可解释性:用SHAP与PDP照亮随机森林黑箱

本文探讨了如何利用SHAP和PDP技术提升随机森林模型在Kaggle心脏病预测中的可解释性。通过详细的数据预处理、模型构建与解释性分析,展示了SHAP值在揭示特征贡献和决策路径中的关键作用,以及PDP在理解特征非线性关系中的应用,为医疗AI的透明决策提供了实用方案。

weixin_29159441的博客 456

模型理解与可解释性图表案例解读之SHAP 瀑布图(Waterfall Plot)

SHAP Waterfall Plot 是一种“逐步累积”的可视化方法模型预测值如何从“全局平均值”开始,一步步被每个特征推动,最终到达这个样本的预测结果。→ 全体用户的平均风险得分→ 这个用户的风险得分每一步:一个特征“跳下去”,把水位(预测值)往上或往下推这个用户虽然曾有自杀念头(高危),但由于压力极低、生活方式健康,模型综合判断其为“低风险”。这说明:单一高危因素不能决定一切,整体生活状态才是关键。

小小默:进无止境 3060

医疗AI模型可解释性编程研究:基于SHAP、LIME与Anchor

医疗领域的人工智能应用正迅速从理论研究转向临床实践,在这一过程中,**模型可解释性**已成为确保AI系统被医疗专业人员接受和信任的关键因素。基于树模型的集成算法(如RandomForest、XGBoost、LightGBM)因其卓越的预测性能和相对良好的解释性,在医疗诊断、风险预测和疗效评估等场景中获得了广泛应用。这些模型能够有效处理医疗数据的**高维度**、**非线性和缺失值**等特性,同时保持较高的准确度。然而,即使是这些相对透明的模型,在面对复杂医疗决策时仍需要更高级的解释技术来满足临床需求。

AllenLV的博客 1490

可解释AI在医疗诊断辅助中的应用研究

随着人工智能技术的飞速发展,其在医疗领域的应用越来越广泛。然而,大多数传统的人工智能模型如深度学习模型是黑盒模型,缺乏可解释性,这在一定程度上限制了其在医疗诊断辅助中的应用。本研究的目的在于探讨可解释AI在医疗诊断辅助中的应用,分析其原理、算法、实际应用场景等,为医疗行业提供更可靠、可信赖的诊断辅助工具。范围涵盖了可解释AI的主要方法、在不同医疗诊断场景(如影像诊断、疾病预测等)中的应用,以及相关技术的发展趋势。

AI架构师小马 1091

SHAP 可视化解释机器学习模型简介

个人理解SHAP模型是对机器学习模型进行解释的一个模型上面这个图就是一个比较直观的解释机器学习模型一般都是一个黑盒。比如某个模型要进行一些预测任务,首先对模型输入一些已知条件(Age=65,Sex=F,BP=180,BMI=40),然后模型根据输入进行训练,最终训练完的模型可以对该条件输出预测结果(Output=0.4)

chaishen10000的专栏 10万+

破解医疗AI黑箱:SHAP和LIME技术详解

医疗AI的普及推动了临床效率提升,但深度学习模型的“黑箱性”严重阻碍了医患信任与 regulatory 合规(如FDA的AI审批要求)。SHAP(基于博弈论的Shapley值)与LIME(局部线性近似)是当前破解医疗AI黑箱的两大核心技术,分别从全局公平分配与局部线性近似视角提供可解释性。本文以“第一性原理”为起点,系统推导两者的理论框架,解析架构设计与实现机制,并结合医疗场景(如影像诊断、用药推荐)阐述实践策略。

AI 原生应用开发的博客 824

Day37 深入理解SHAP图

年龄+0.02影响很小,把模型的决策分解到每个特征上。基准值 = 没有任何特征信息时的"默认"预测(相当于"0”的起点),这个值一般就是平均值,把训练集的所有样本都输入模型,得到所有预测值取平均值,在没有关于这个特定样本的区分性信息时,最合理的猜测就是平均值。到这里你可能心想,这样是不是很类似于线性回归的特征前的系数 y=ax1+bx2+cx3,那既然如此,我直接选择用线性回归的系数作解释,那岂不是更好?三人合伙前,收入是 0,三人合伙后,收入是 100万,要分配的"蛋糕"就是 100万-0=100 万。

weixin_47193046的博客 928

可解释AI在医疗诊断中的临床应用研究

随着人工智能(AI)技术的飞速发展,其在医疗领域的应用日益广泛。然而,传统的AI模型往往被视为“黑盒”,难以解释其决策过程和依据,这在医疗诊断这种对可靠性和可解释性要求极高的领域中是一个严重的问题。本研究的目的在于深入探讨可解释AI在医疗诊断中的临床应用,分析其优势、挑战和应用场景,为医疗行业提供更可靠、可解释的AI解决方案。研究范围涵盖了可解释AI的核心概念、算法原理、数学模型、实际应用案例以及相关的工具和资源。本文共分为十个部分。第一部分为背景介绍,阐述研究的目的、范围、预期读者和文档结构;

AI架构师小马 1016

12、可解释人工智能在心力衰竭患者医疗事件预测中的应用

本文提出了一种结合可解释人工智能(XAI)与医学专业知识的模型解释管道,用于心力衰竭患者医疗事件的预测。通过DeepSHAP算法进行全局和局部解释,识别出自我评估健康状态、体液状态和血压等关键预测特征,并利用MoRF曲线评估解释的保真度。研究结果与临床知识对比显示高度一致性,增强了医生对AI模型的信任。该方法为临床决策提供了透明、可理解的支持,有助于提升心血管疾病管理的精准性与效率。

vv45678的博客 104

SHAP可解释AI在医疗影像分析中的实践:从原理到全脑放疗预测

机器学习模型的可解释性是AI在医疗领域应用的关键挑战。基于博弈论的SHAP(SHapley Additive exPlanations)框架通过为每个特征分配贡献值,将黑箱模型转化为透明决策系统。这一技术价值在于提升临床可信度,使医生能够验证模型逻辑与医学知识的一致性。在医疗影像分析场景中,放射组学从CT、MRI等影像提取定量特征,而SHAP解释器能够揭示这些特征对预测结果的具体影响。特别是在全脑放疗生存期预测等关键应用中,SHAP的可视化结果帮助医生理解模型基于肿瘤体积、水肿比例等影像特征的决策过程,自然

weixin_34121282的博客 333

Python爬虫实战:从巨潮网批量抓取上市公司年报JSON数据

网络爬虫作为自动化数据采集的核心技术,其原理是通过模拟浏览器行为向服务器发送HTTP请求并解析响应,从而高效获取结构化信息。在金融数据分析领域,这项技术价值尤为突出,能够将研究人员从繁琐的手工数据收集中解放出来,聚焦于更高阶的模型构建与价值挖掘。典型的应用场景包括上市公司财务研究、市场趋势分析和风险预警系统开发。本文以Python的requests库为核心工具,详细解析如何通过分析巨潮资讯网的JSON数据接口,构建一个稳定、高效的上市公司年报数据采集管道,并重点探讨了接口逆向、分页爬取、PDF文件下载等关键

weixin_42529366的博客 1236

RF随机森林分类预测+特征贡献SHAP分析,通过特征贡献分析增强模型透明度,Matlab代码实现,引入SHAP方法打破黑箱限制,提供全局及局部双重解释视角

在机器学习分类任务中,随机森林(Random Forest,RF)凭借其抗过拟合能力强、对噪声数据鲁棒、无需复杂参数调优等优势,被广泛应用于医疗诊断、金融风险评估、工业故障检测等领域。然而,RF 作为集成学习模型,其 “多棵决策树投票” 的工作机制导致模型存在 “黑箱” 特性 —— 难以解释每个特征对分类结果的具体影响,这在对模型可解释性要求较高的场景(如医疗诊断中判断疾病风险因素)中成为明显短板。

m0_57702748的博客 1050

瑞数6.5逆向实战:手把手教你用RPC搞定cookie sign加密(附环境补全技巧)

本文深入解析瑞数6.5逆向实战,重点探讨如何结合环境补全与RPC调用技术来应对其动态加密机制。文章详细介绍了环境指纹采集、双重验证等核心防护原理,并提供了基于Puppeteer的RPC实现方案,手把手教你搞定cookie sign加密,附有实用的环境补全技巧与完整代码示例。

weixin_29315091的博客 1273

STM32CubeIDE串口打印浮点数踩坑实录:5分钟搞定printf输出小数(附完整配置截图)

本文针对STM32CubeIDE中串口无法打印浮点数的常见问题,提供了详细的解决方案。核心在于通过添加“-u _printf_float”链接器参数,启用标准库的浮点数格式化支持。文章附有完整的配置截图和步骤,并提供了系统性的排查清单,帮助开发者快速解决printf输出小数的问题。

weixin_29163797的博客 343

医疗AI诊断模型可信吗?用SHAP可视化特征贡献的5种方法

本文探讨了医疗AI诊断模型的可信度问题,并重点介绍了使用SHAP(SHapley Additive exPlanations)可视化特征贡献的五种核心方法。通过糖尿病预测案例,详细演示了如何利用SHAP的摘要图、力图、依赖图等工具,从全局和局部层面解释模型决策,识别潜在偏见,从而增强模型在医疗高风险领域的透明度与临床信任。

weixin_29191669的博客 424

WRF移动嵌套结合伏羲模型与CFD(PALM)高精度多尺度降尺度分析研究

WRF移动嵌套(Moving Nesting):动态调整高分辨率嵌套网格位置,追踪天气系统(如台风、强对流系统)以提高局地预报精度。伏羲(Fuxi)模型:国产数值模式,提供对WRF模拟的初始及边界条件优化。CFD(Computational Fluid Dynamics)PALM模型:精细化局地流场、湍流、温度分布。

m0_57411304的博客 1716

MedGemma模型解释:使用SHAP分析医疗AI决策过程

本文介绍了如何在星图GPU平台上自动化部署MedGemma Medical Vision Lab AI 影像解读助手镜像,实现医疗影像AI分析功能。通过该平台可快速搭建医学影像解读环境,应用于胸部X光片等医学图像的自动化诊断分析,提升医疗影像解读效率与可解释性。

weixin_34885746的博客 109

Quartus (Quartus Prime 18.1)的安装及仿真步骤

前两天做计组的课设需要用到Quartus 这个软件,但安装有点麻烦,在网上搜了很多教程,发现都是旧版本的,最后弄了好半天才把环境搭建好。所以,分享一下它的搭建过程。 因为我不经常用它,所以安装的版本是精简版的其他版本的也应该差不多以下是需要下载的安装包: 准备: Quartus Prime 精简版,最新发布: v18.1 1. QuartusLiteSetup-18.1.0.625-wi...

weixin_41082948的博客 8万+

F280049C Crossbar X-BAR

X-BAR不是一个功能模块,只起内部外设与外设之间,或内部外设与GPIO的连接作用。配置X-BAR的就是在配置信号之间的连接。确实如这一节的开头所言,X-BAR提供了以各种配置连接设备输入、输出和内部资源的灵活性。学完这一节也知道为什么crossbar(X-BAR)的中文翻译是交叉开关。

xht2403267701的博客 3048

基于SHAP与GBDT的2型糖尿病全因死亡率可解释预测模型构建

在机器学习与医疗健康交叉领域,模型可解释性是实现AI临床落地的关键瓶颈。传统黑箱模型虽预测性能优异,但其决策逻辑不透明,限制了在临床决策中的可信度与应用。可解释人工智能通过提供模型决策依据,架起了高精度预测与临床信任之间的桥梁。其中,基于博弈论Shapley值的SHAP框架,因其模型无关、全局局部解释统一的特性,成为解读复杂模型的主流技术。结合梯度提升决策树在结构化医疗数据上的卓越性能,可构建出预测准确且解释清晰的临床风险预测系统。该技术方案能有效应用于慢性病管理、疾病风险分层等场景,例如为2型糖尿病患者的

weixin_30615767的博客 686

2024年数字IC秋招-海康威视-数字逻辑设计工程师-笔试题

笔试题型:单选 + 多选笔试平台:百一测试(电脑监控)笔试时间:1h30minA. AW通道B. D通道C. B通道D. AR通道return x++;x = 5;y = Foo(x);

qq_42135020的博客 3199

ResNet18模型可解释性:用SHAP值理解分类决策

SHAP值像AI的"决策地图":直观显示图像哪些区域影响分类结果GPU加速是刚需:单张医疗图像SHAP计算需1-3分钟(CPU可能需要小时级)参数调优有技巧:背景样本数、批量大小显著影响计算效率医疗验证不可少:最终解释需与临床知识交叉验证现在你可以尝试用公司真实数据(需脱敏)生成第一份可解释性报告了。实测在V100 GPU上,完成100张图像分析仅需约2小时。💡获取更多AI镜像想探索更多AI镜像和应用场景?访问优快云星图镜像广场。

BlackStone33的博客 901

大疆A型板使用经验分享(二)——A型板原理图和引脚图

一.原理图 二.引脚图

weixin_43361652的博客 7682

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

PythonDataScienceHandbook模型解释:SHAP与LIME方法完全指南

在当今**机器学习模型**日益复杂的背景下,**模型可解释性**已成为数据科学领域的关键挑战。PythonDataScienceHandbook项目为数据科学家提供了宝贵的资源,帮助他们理解和使用**SHAP**和**LIME**这两种强大的模型解释方法。本指南将带你深入了解这些工具如何让黑盒模型变得透明可信。💡 ## 为什么模型解释如此重要? **模型解释**不仅仅是技术需求,更是业务决策

gitblog_00328的博客 980

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

上一篇: 真得收藏!深度学习模型一网打尽!
下一篇: 看完还不懂什么是机器学习的概率基本为0!
深度学习机器学习
博客等级 码龄2年 495粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值