ViT-YOLO:基于Transformer的用于目标检测的YOLO算法

目标检测算法-transformer系列-ViT(Vision Transformer)(附论文和源码) 阅读详情

PART/1

     概述   

最近,使用自注意力机制设计视觉主干架构成为了一个令人兴奋的研究课题。在这项工作中,我们设计了一种改进的主干网络MHSA-Darknet,通过多头自注意力机制保留足够的全局上下文信息,并提取更具区分性的特征用于目标检测。关于路径聚合颈部网络,我们提出了一种简单但非常有效的加权双向特征金字塔网络(BiFPN),用于实现有效的跨尺度特征融合。此外,诸如测试时增强(TTA)和加权框融合(WBF)等其他技术有助于实现更高的检测精度和更强的鲁棒性。我们的实验表明,ViT-YOLO显著优于当前最先进的检测器,并在2021年VisDrone-DET挑战赛中取得了顶尖成绩之一(测试挑战数据集的平均精度均值(mAP)为39.41,测试开发数据集的mAP为41)。

PART/2

     背景   

目标检测的目的是为每个感兴趣的物体预测一组边界框和类别标签。近年来,随着无人机(UAV)的出现,配备摄像头的无人机迅速应用于农业、航拍、快递、监控等广泛领域。因此,自动且有效的目标检测在无人机平台的场景解析中起着重要作用。
图片

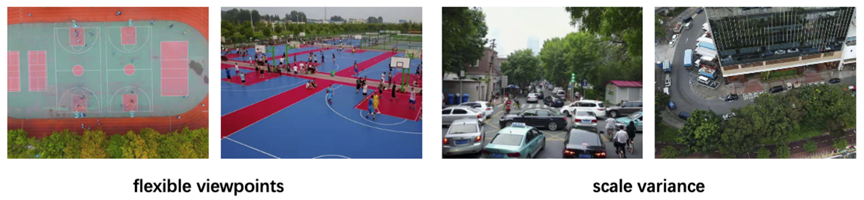
然而,如上图所示,无人机拍摄的图像具有显著特点,包括物体尺度变化极大、背景复杂且充斥着干扰物,以及拍摄视角灵活多变。这些特点给基于普通卷积网络的通用目标检测器带来了巨大挑战。卷积神经网络(CNN)在计算机视觉的各个领域都取得了重大突破。一般来说,现代检测器采用纯卷积网络来提取特征。经典的图像分类网络(如VGG、ResNet被用作最先进的检测器FasterRCNN和RetinaNet等的主干网络)。至于YOLO系列检测器,它们应用了一种新颖的残差网络Darknet,在进行特征提取时效率更高。如今,Transformer由于能够通过自注意力机制学习输入序列之间的复杂依赖关系,已成为自然语言处理中的主导模型。我们也注意到,最近引入的视觉Transformer通过将图像视为一系列图像块,在基准分类任务中取得了具有竞争力的结果。对于具有大规模和复杂场景的无人机拍摄图像,为了提高语义辨别能力并减轻类别混淆,从较大的邻域中收集和关联场景信息有助于学习物体之间的关系。但对于卷积网络来说,卷积操作的局部性限制了其捕捉全局上下文信息的能力。

相比之下,Transformer能够全局地关注图像特征块之间的依赖关系,并通过多头自注意力机制为目标检测保留足够的空间信息。此外,为了解决航拍图像中视角变化的问题,目标检测器应具备更强的领域自适应能力和动态感受野。文献的研究表明,与CNN相比,视觉Transformer对严重的遮挡、扰动和领域偏移具有更高的鲁棒性。因此,提高检测性能的一种直观方法是将Transformer层嵌入到纯卷积主干网络中,以引入更多的上下文信息并学习更具区分性的特征表示。另一方面,无人机拍摄图像中的物体尺寸差异很大,而卷积神经网络单层的特征图表示能力有限,因此有效地表示和处理多尺度特征至关重要。一种经典方法是通过求和或拼接操作来组合低层和高层特征,但不加区分地简单求和或拼接可能会导致特征不匹配和性能下降。我们的关键思路是引入可学习的权重来学习不同输入特征的重要性,同时反复应用自上而下和自下而上的多尺度特征融合。

章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
PART/3

     新框架解析   

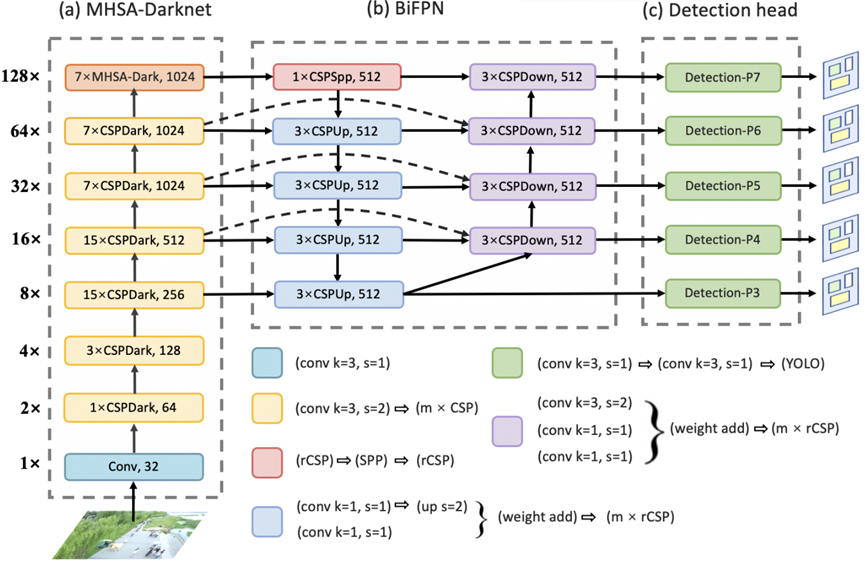
我们提出的网络架构是一个同时使用卷积和自注意力机制的混合模型ViT-YOLO,它主要基于YOLOv4-P7。
图片

ViT-YOLO的结构如上图所示,可分为三个部分。第一部分,我们使用MHSA-Darknet作为主干网络,将多头自注意力机制集成到原始的CSP-Darknet中,以提取更具区分性的特征。MHSA-Darknet的详细信息将在下面中介绍。

MHSA-Darknet

对于具有大规模和复杂场景的无人机拍摄图像,为了提高语义辨别能力并减轻类别混淆,从较大的邻域中收集和关联场景信息有助于学习物体之间的关系。但对于卷积网络来说,卷积操作的局部性限制了其捕捉全局上下文信息的能力。相比之下,Transformer能够全局地关注图像特征块之间的依赖关系,并通过多头自注意力机制为目标检测保留足够的空间信息。另一方面,视角变化是无人机拍摄图像中最大的挑战之一,这要求检测器应具备更强的领域自适应能力和动态感受野。文献的研究表明,与CNN相比,视觉Transformer对严重的遮挡、扰动和领域偏移具有更高的鲁棒性。为了提高所学习特征的可迁移性,同时捕捉长距离上下文信息,我们提出了MHSA-Darknet主干网络来为检测器提取特征。MHSA-Darknet的设计很简单:将多头自注意力(MHSA)层嵌入到顶部的CSPDark模块中,以便在二维特征图上实现全局(全连接)自注意力。
图片

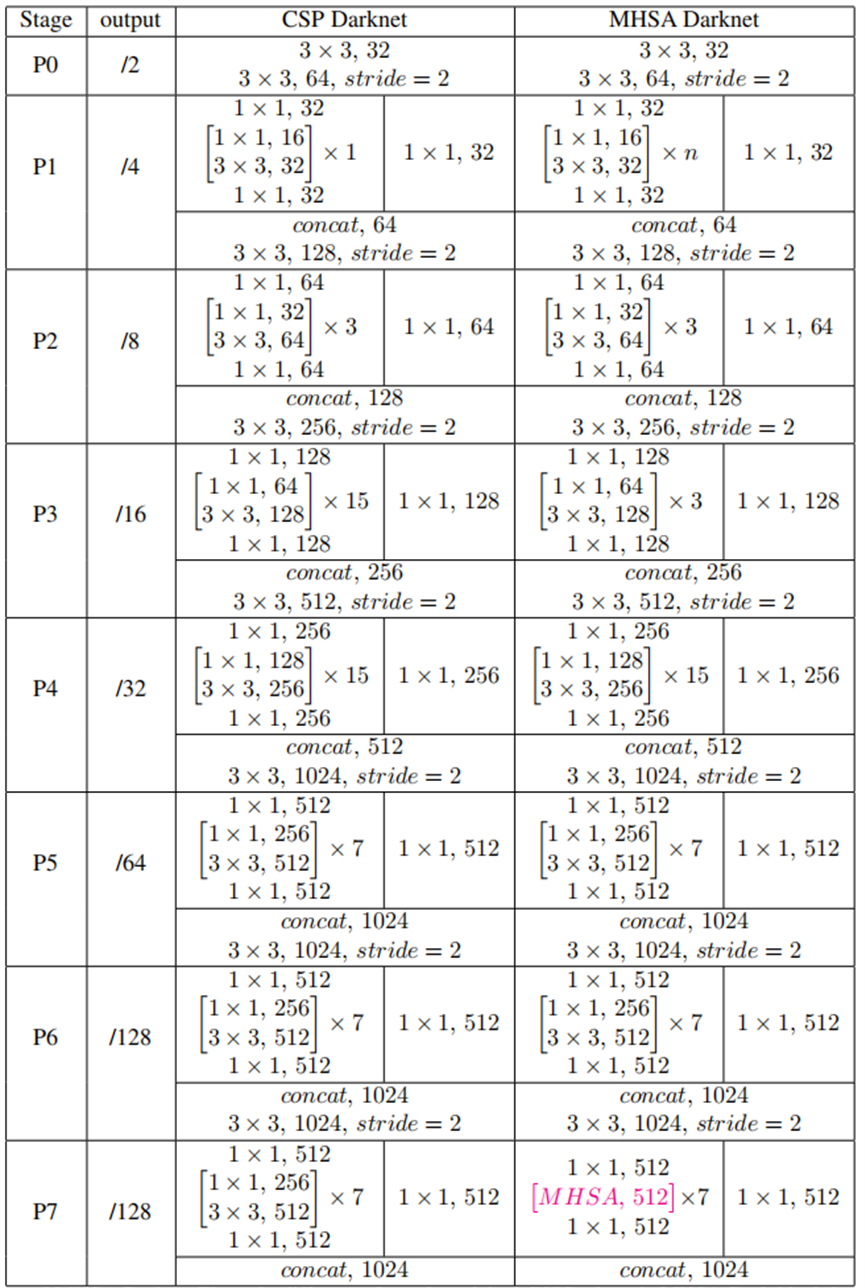
MHSA-Darknet架构见上表。

图片

章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

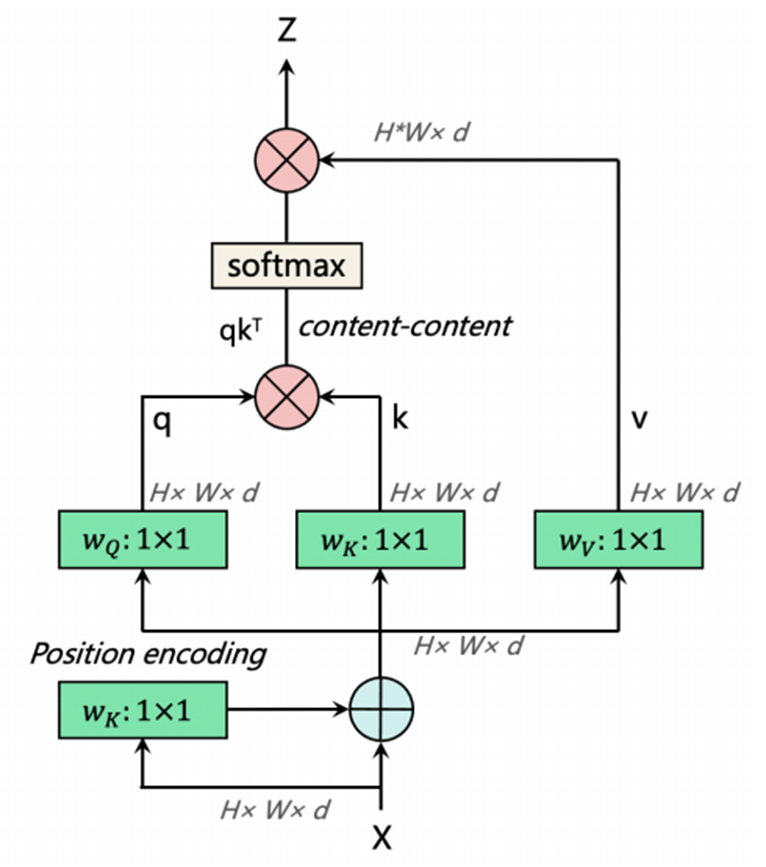
MHSA层如上图所示。YOLOv4-P7中的CSP-Darknet通常有7个阶段(或模块组),通常称为[P1,P2,P3,P4,P5,P6,P7],相对于输入图像的步长分别为[2,4,8,16,32,64,128]。[P1,P2,P3,P4,P5,P6,P7]模块组由多个具有跨阶段部分(CSP)连接的CSPDark模块组成。(即YOLOv4-P7中的CSP-Darknet有[1,3,15,15,7,7,7]个CSPDark模块)。值得注意的是,当网络相对较浅且特征图相对较大时,过早使用Transformer层来强制确定回归边界可能会丢失一些有意义的上下文信息。因此,在MHSA-Darknet中,Transformer层仅应用于P7阶段,而不是P3、P4、P5和P6阶段。

此外,考虑到在全局范围内对n个实体执行自注意力操作需要O(n²d)的内存和计算量,我们认为,遵循上述因素的最简单设置是在主干网络中分辨率最低的特征图上融入自注意力机制,即P7模块组中的CSPDark模块。Darknet主干网络中的P7模块组通常使用7个CSP瓶颈模块,每个模块包含一个1×1空间卷积和一个3×3空间卷积。用MHSA层替换它们构成了MHSA-Darknet架构的基础。

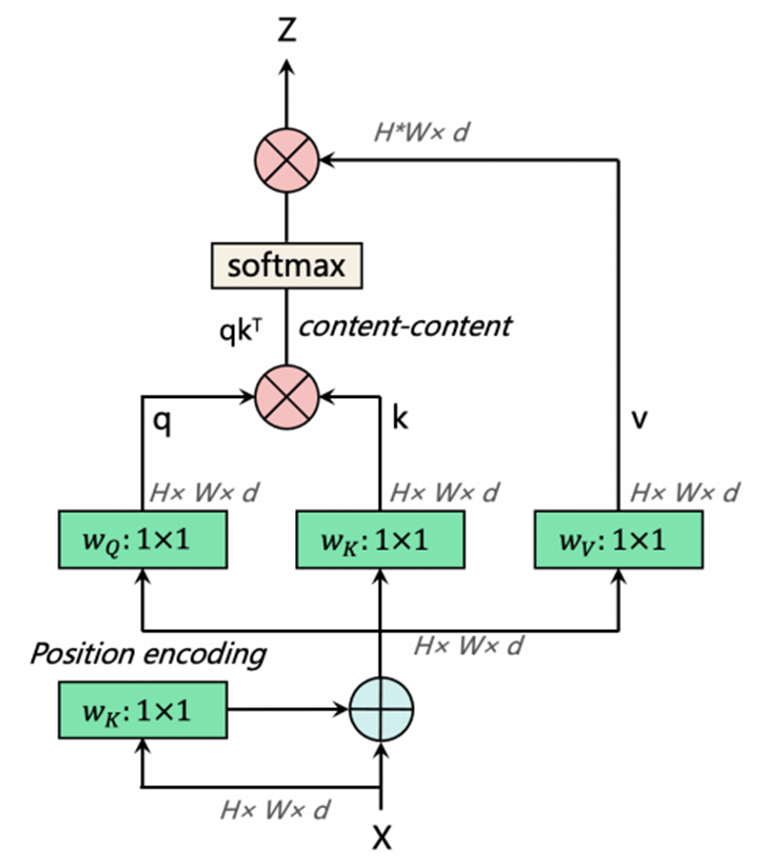
为了处理二维图像,我们将二维特征图\(x\in\mathbb{R}^{H\timesW\timesd}\)的空间维度展平为一个序列\(x_p\in\mathbb{R}^{(H\timesW)\timesd}\),其中\((H,W)\)是原始特征图的分辨率,\(d\)是通道数,\(H\timesW\)作为Transformer层的有效输入序列长度。为了使注意力操作具有位置感知能力,基于Transformer的架构通常会使用位置编码。我们使用带有线性层的标准可学习一维位置嵌入来保留位置信息。
图片

MHSA层如上图所示。

双向特征金字塔网络(BiFPN)

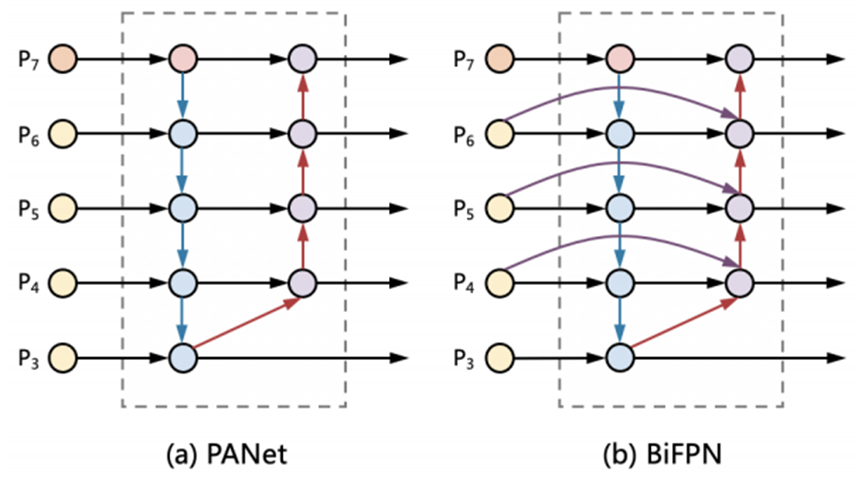
无人机拍摄图像中的物体尺寸差异很大,而卷积神经网络单层的特征图表示能力有限,因此有效地表示和处理多尺度特征至关重要。传统的自上而下的特征金字塔网络(FPN)在本质上受到单向信息流的限制。为了解决这个问题,路径聚合网络(PANet)添加了一个额外的自下而上的路径聚合网络。
图片

如上图(a)所示。跨尺度连接在文献中得到了进一步研究。在这项工作中,如上图(b)所示,简单但非常有效的加权双向特征金字塔网络(BiFPN)对跨尺度连接进行了两项优化。首先,BiFPN在原始输入和输出节点处于同一层级时,会添加一条额外的边,以便在不增加太多计算成本的情况下融合更多的特征。其次,在组合低层和高层特征时,BiFPN引入了可学习的权重来学习不同输入特征的重要性,而不是简单地求和或拼接,因为简单的求和或拼接可能会导致特征不匹配和性能下降。正式地说,给定一个多尺度特征列表\(\widetilde{P}_{in}=(P_{l_1}^{in},P_{l_2}^{in},\ldots)\),其中\(P_{l_i}^{in}\)表示层级\(l_i\)的特征。路径上的中间特征列表表示为\(\widetilde{P}_{td}=(P_{l_1}^{td},P_{l_2}^{td},\ldots)\)。我们的目标是找到一个变换\(f\),它可以有效地聚合不同的特征并输出一个新的特征列表:\(\widetilde{P}_{out}=f(\widetilde{P}_{in})\)。

上图(a)展示了传统的自上而下和自下而上的路径聚合网络(PANet)。它采用层级\(3-7\)的输入特征\(\widetilde{P}_{in}=(P_{3}^{in},\ldots,P_{7}^{in})\),其中\(P_{i}^{in}\)表示分辨率为输入图像\(1/2^i\)的特征层级。例如,如果输入分辨率是\(1024\times1024\),那么\(P_{3}^{in}\)表示层级\(3\)(\(1024/2^3=128\))的特征,分辨率为\(128\times128\),而\(P_{7}^{in}\)表示层级\(7\)的特征,分辨率为\(8\times8\)。

PART/4

     实验及可视化   

实现细节在2021年VisDrone目标检测挑战赛中,我们选择了MHSA-Darknet主干网络、BiFPN路径聚合颈部网络,以及基于锚框的YOLOv3检测头作为ViT-YOLO的架构。我们的模型使用随机梯度下降(SGD)作为优化器,默认权重衰减为0.0005,动量为0.937。在模型的初始训练阶段,我们首先进行3个epoch的热身训练。在热身过程中,优化器SGD的动量设置为0.8,并使用一维线性插值来更新每次迭代的学习率。热身训练之后,使用余弦退火函数来衰减学习率,其中初始学习率为0.02,最小学习率为0.2*0.01。最后,我们对模型进行300个epoch的训练。
图片

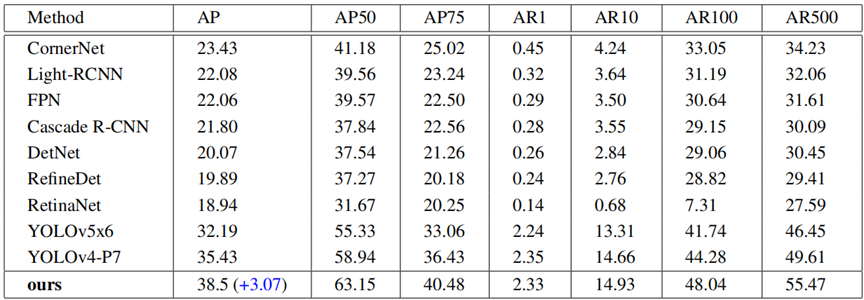
上表展示了我们在VisDrone2019测试开发数据集上的评估结果。在那些最先进的方法中,所有的YOLO系列算法都表现出明显的出色性能。作为优秀模型YOLOv4-P7的改进版本,我们提出的如图2所示的架构在没有使用测试时增强(TTA)和多模型融合的情况下,取得了具有竞争力的性能,平均精度均值(mAP)达到38.5,甚至比基线模型YOLOv4-P7高出3.07。
图片

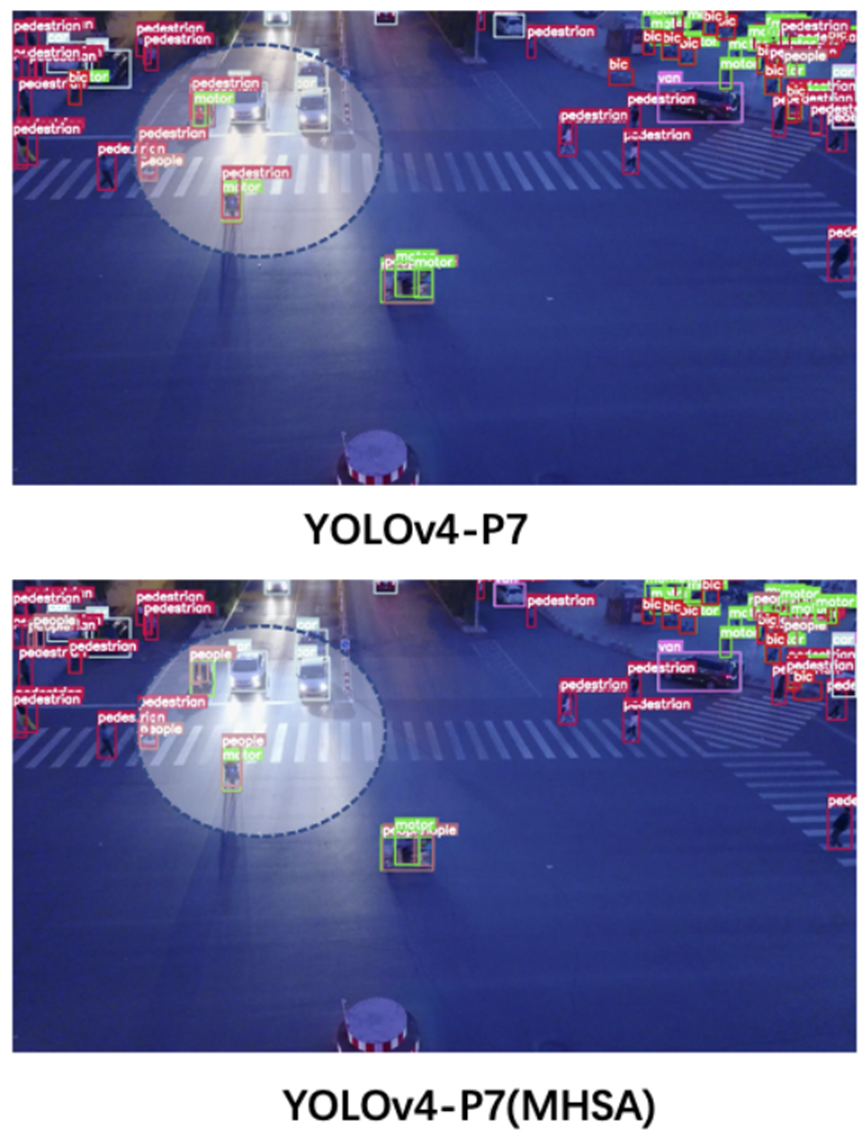
另一方面,从上图中原始基线模型和我们基于Transformer的模型的预测结果对比来看,我们观察到我们基于Transformer的模型成功识别出了骑摩托车的人,而基线模型则错误地将他们归类为行人。这表明,改进后的主干网络MHSA-Darknet能够通过多头自注意力机制为目标检测提取更具区分性的特征,并且展现出了更强的语义辨别能力,从而减轻了类别混淆问题。

章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

目标检测-Transformer-ViT和DETR 随着Transformer爆火以来,NLP领域迎来了大模型时代,成为AI目前最先进和火爆的领域,介于Transformer的先进性,基于Transformer架构的CV模型也开始涌现。本文介绍一下最先得到可靠应用的简单模型:ViT(Vision Transformer)、DETR(Detection Transformer)。在COCO数据集上的性能,DETR和一个训练好的Faster R-CNN baseline是差不多的,无论从内存、速度还是精度来说。 阅读详情

相关推荐

YOLO12在RDK X5上的部署,体验纯视觉Transformer的YOLO目标检测!

YOLOv12构建以注意力为核心的YOLO框架,通过创新方法和架构改进,打破CNN模型在YOLO系列中的主导地位,实现具有快速推理速度和更高检测精度的实时目标检测。

吴超的博客 3378

ViT-YOLO论文解读

ViT-YOLO论文解读

易大飞 6283

Transformer融入YOLO的3种策略对比:ViT-YOLO、YOLO-Former与DETR性能与速度分析

本文深度评测了Transformer与YOLO融合的三大技术路径:ViT-YOLO、YOLO-Former与DETR,对比了它们在目标检测任务中的性能与速度表现。通过详细的架构解析和实测数据,为开发者提供了工业部署的实用建议,帮助在不同场景下选择最优方案。

weixin_33853794的博客 329

计算机视觉算法——基于Transformer的目标检测(DETR / Deformable DETR / Dynamic DETR / DETR 3D)

DETR是DEtection TRansformer的缩写,该方法发表于2020年ECCV,原论文名为《End-to-End Object Detection with Transformers》。传统的目标检测是基于Proposal、Anchor或者None Anchor的方法,并且至少需要非极大值抑制来对网络输出的结果进行后处理,涉及到复杂的调参过程。而DETR使用了Transformer Encoder-Decoder的结构,并且通过集合预测损失实现了真正意义上的端到端的目标检测方法。...

weixin_44580210的博客 1万+

Transformer目标检测:从ViT到DETR的端到端实践与原理详解

目标检测是计算机视觉的核心任务之一,旨在识别图像中物体的位置与类别。传统方法如Faster R-CNN和YOLO依赖卷积神经网络(CNN)的局部感受野和手工设计的锚框(Anchor),并通过非极大值抑制(NMS)进行后处理,流程复杂且存在冗余。Transformer架构通过自注意力机制实现了全局建模能力,突破了CNN的局部性限制,为视觉任务带来了统一的端到端(End-to-End)解决方案。其技术价值在于摒弃了手工先验,简化了检测流程,提升了模型在复杂场景下的泛化能力。在应用场景上,Vision Trans

weixin_30908103的博客 681

Vision Transformer (ViT) 在目标检测中的实战应用与源码解析

本文深入探讨了Vision Transformer (ViT) 在目标检测领域的实战应用与源码实现。文章分析了ViT从图像分类跨界到目标检测的核心挑战,并详细解读了DETR、ViTDet等主流改造思路。通过一个基于PyTorch和timm库的简易ViT检测器源码示例,手把手演示了特征提取、序列到特征图转换及检测头构建的关键步骤,为开发者提供了实用的技术参考。

tensorflowjs6的博客 305

ICCVW|ViT-YOLO:融合Transformer与YOLO的无人机图像目标检测新框架,突破尺度与背景复杂度瓶颈

本文提出了一种名为ViT-YOLO的混合目标检测框架,用于解决无人机图像中目标尺寸差异大、背景复杂等问题。该模型将多头自注意力机制嵌入CSP-Darknet主干网络以增强全局上下文信息提取,并引入加权双向特征金字塔网络进行多尺度特征融合。

2501_93716422的博客 1481

YOLOv8与Transformer:探索目标检测的新架构

本文旨在深入探讨YOLOv8与Transformer架构在目标检测领域的应用。我们将从YOLO系列算法的发展历程出发,逐步介绍Transformer的基本原理,并重点分析YOLOv8如何将Transformer融入其架构中以提升性能。介绍目标检测任务、YOLO系列算法和Transformer架构。深入探讨YOLOv8和Transformer的核心概念,并使用Mermaid流程图展示其架构。使用伪代码详细阐述YOLOv8结合Transformer的目标检测算法。

AI架构师小马 2639

【计算机视觉 | 目标检测】术语理解6:ViT 变种( ViT-H、ViT-L & ViT-B)、bbox(边界框)、边界框的绘制(含源代码)

【计算机视觉 | 目标检测】术语理解6:ViT 变种( ViT-H、ViT-L & ViT-B)、bbox(边界框)、边界框的绘制(含源代码)

wzk4869的博客 2万+

自监督预训练与视觉 Transformer 在目标检测中的崛起:从 ViT、MAE 到 DETR 的落地演进

视觉 Transformer(ViT)与自监督预训练技术的融合,正在加速目标检测从 CNN 主导走向统一建模的新时代。本文将系统解析自监督(如 MAE、DINOv2)如何成为 ViT 系列模型的预训练主力,剖析 DETR 及其家族架构如何通过 Transformer 完成端到端检测,并结合多个真实工业应用,分享 ViT 检测模型在不同任务中的落地路径、性能表现与部署挑战。文章内容聚焦可实操方案与最新开源实践,面向视觉系统开发者与工程落地团队提供系统参考。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1627

AT91SAM9260搭建LINUX操作系统

一、 编写目的 2 二、 系统搭建 2 1. 下载相关软件包 2 2. Bootstrap编译 3 3. U-BOOT编译 5 4. LINUX编译 7 5. 通过U-BOOT的TFTP命令从TFTP服务器下载系统镜像 9 6. 文件系统制作 10 7. 挂载NFS作为根文件系统 10 三、 总结 14 一、编写目的 本文档用于记录AT91SAM9260 LINUX学

lshiceman的专栏 7412

ViT+YOLO革命:10倍提升目标检测效率的混合架构实战

当你的自动驾驶系统因检测延迟错过突发障碍,当你的工业质检设备因精度不足放过关键缺陷,当你的安防摄像头在人群中丢失目标——是时候重构目标检测的技术范式了。传统YOLO虽快但小目标漏检率高达35%,纯Transformer模型虽准却慢如蜗牛(FPS...

gitblog_00160的博客 1620

Python数据分析案例——宏观经济指标与沪深指数实证研究分析

沪深300指数与宏观经济指标关联性研究:2015-2024实证分析 摘要:本文基于2015-2024年月度数据,采用多元回归方法分析宏观经济指标对沪深300指数的影响。研究发现,市场情绪(SEN)、美国利率(STY)、美元指数(DXY)、狭义货币供应量(M1)和CPI对指数具有显著解释力(P<0.05),而GDP、LPR等传统指标影响不显著。模型解释力达62%(R²=0.62),表明A股短期走势更受资金流动、投资者心理和国际金融条件驱动。研究为投资者提供了除基本面外的市场预判指标,建议关注M1增速、美

weixin_50902344的博客 1404

ViT、DETR 和 Swin Transformer :基于 Transformer 的计算机视觉(CV)模型

图像输入 → 线性 Patch Embedding → Swin Transformer Block(窗口注意力) → 多尺度特征提取 → 适用于分类、检测、分割。

lqq 1816

Win10+pycharm+conda 配置Siammask 过程记录(新手向)

我们跑动demo 需要配置两个相关的文件这两个文件需要用 git 进行下载,对于不熟悉git的小伙伴 我这里给出连接,大家可以直接下载即可,并将其配置在 experiments文件夹下然后大家再需要在设置参数参数这里给出了。

C1137577723的博客 551

微带线贴片天线尺寸的计算,利用Matlab计算+常见的RF计算在线公式

微带线贴片天线尺寸的计算,利用Malatb计算 这几天在使用hfss对矩形天线仿真,每次改变频率和实验的材料,都要重新计算一遍,太麻烦了,所以用matlab进行计算。 知道天线的工作频率:f_r 介质板的介电常数:epsilon_r 介质板厚度:h 就可以计算出矩形天线的长:L 矩形天线的宽:W 对于下面公式的单位要注意,公式以及化简了,要注意单位 由于matlab中的变量不能用希腊字母代替,所以用了该字母的读音 代码如下: f_r=2.45; %工作频率,单位GHz epsilon_r=3.5;

weixin_43404609的博客 2万+

Transformer杀回目标检测!与YOLO组成王炸组合,高分论文创新点一览

YOLOS 用“最简”序列接口揭示 ViT 的检测迁移极限,适合作为 Transformer 表征学习的硬核基准;HR-YOLO 用“去雾+增强”插件式改造,证明 Transformer 模块可无缝嵌入 YOLO 家族,在恶劣天气下实现精度-效率双杀。换任务——把 [DET] 令牌改成 [SEG]、[POSE] 即可秒变新赛道;换模块——将 DND-Net 换成雨/雪/夜间复原网络,即可冲击不同天气赛道;

916

映泰TB250-BTC主板魔改BIOS支持8/9代CPU实战与开机故障排查

BIOS(基本输入输出系统)是计算机硬件与操作系统之间的桥梁,负责初始化硬件和提供运行时服务。其工作原理是通过存储在主板芯片中的固件程序,在上电自检(POST)阶段完成对CPU、内存等关键组件的检测与配置。魔改BIOS的技术价值在于突破硬件限制,通过修改微码和电源管理模块,让旧平台支持新处理器,从而以极低成本实现性能跃升,在预算有限或追求极致性价比的DIY、办公和软路由等应用场景中极具吸引力。本文以映泰TB250-BTC矿板为例,详细解析了通过软刷方式刷入魔改BIOS,并重点解决了刷写后常见的“开机风扇转一

weixin_29164185的博客 406

YOLO系列目标检测算法——YOLOS

YOLOS不是一个高性能的目标检测器,而是为了揭示Transformer从图像识别到目标检测的多功能性和可转移性;本文中探讨了在中型ImageNet-1k数据集上预训练的vanilla ViT在更具挑战性的COCO目标检测基准中的可转移性。证明了二维目标检测可以以纯粹的seq-to-seq的方式完成,并且具有最小的额外归纳偏置。在COCO上的表现还是可以的,这些初步的结果证实其是有意义的,表明Transformer对各种下游任务的可转移性和通用性。

AI-Mei的博客 3243

调试GMS应用,报错“此设备未获得play保护机制认证”问题解决

不少同学在调试GMS相关应用时,需登录Google账号,有时会弹出如下通知。Google登录界面也会出现如下提示这个报错的原因是设备未通过Google认证,google服务器未配置荣耀设备的型号白名单导致国内网页有一些指导方法在鸿蒙\荣耀的设备上消除这个提示,但本质的问题没有解决,无法登录Google账号。

胡同老道的博客 2万+

自动化Ai Agent全流程实现【设计+代码】

本文探讨了人工智能代理(AI代理)如何通过自动化复杂的业务流程来帮助企业提高效率和降低成本。AI代理具有适应性、智力、自主性和可扩展性等特点,能够处理非结构化信息、在定义参数范围内做出判断、协调多个系统或利益相关者,以及处理变量输入和异常。文章详细介绍了AI代理在文件处理、客户服务、人才招聘和财务运作等领域的应用,并提供了一个逐步实现发票处理自动化的案例。此外,文章还强调了实施AI代理自动化的优势,包括效率提升、成本降低、准确性和可扩展性的改进,并提出了实施最佳实践,如从高影响力流程开始、设计人机交互、优先

FeelTouch Labs 896

为什么有的YOLO里面和transformer结合了呢?比如放入VIT注意力机制,这合理吗?既卷积又要进行transformer计算吗?

CNN 提供局部强特征,Transformer 提供全局上下文,两者互补。在 YOLO 中插入 Transformer 是合理的,前提是平衡好精度提升 vs 速度消耗。这类结合方法已经有很多成熟研究,比如:YOLOv5-Trans、YOLOv7-E6E+Transformer、YOLOv8 + ViT backbone。✅ 一句话:YOLO 加 Transformer 是“局部特征 + 全局关系”的结合,非常合理,但要考虑计算成本。要不要我给你画一张的结构对比图(示意全局/局部信息流)?

weixin_43501408的博客 772

光学测量仿真软件:Zygo_(5).Zygo的数据处理与分析方法

通过上述综合案例,我们可以看到Zygo中的数据处理与分析方法是如何一步一步应用于实际数据的。从数据导入到预处理,再到滤波、表面分析、缺陷检测和数据可视化,每一步都至关重要,最终确保了数据的准确性和可靠性。处理后的数据还可以导出为多种格式,便于在其他软件中进行进一步的处理或报告。希望这个案例能够帮助您更好地理解和应用Zygo中的数据处理与分析方法。

kkchenjj的博客 946

LW-DETR:用于实时检测的可替代YOLO的Transformer模型(提供源代码)

的实现方式(参考文献)中,特征图是按行组织的(行优先组织方式),为了在窗口注意力机制中从行优先组织方式转换为窗口优先组织方式,需要进行代价高昂的排列操作来转换特征图。我们认为,我们的方法有可能从其他设计中获益,比如高效的多尺度特征融合、标记稀疏化、知识蒸馏,以及其他的训练技术,例如在。编码器进行改进,从而形成更丰富的特征图,并引入以窗口为主的特征图组织方式,提高交错注意力计算的效率。的做法,采用交错窗口注意力和全局注意力机制,此外还使用了以窗口为主序的特征图组织方式,以降低内存重排的成本。

gzq0723的博客 1542

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

无人机目标检测新突破:ViT-YOLO如何用Transformer解决复杂场景难题?

本文深入探讨了ViT-YOLO如何将Transformer的全局建模能力与YOLO的高效检测框架相结合,以解决无人机视觉中目标尺度变化大、背景复杂等核心挑战。通过引入MHSA-Darknet骨干网络和加权BiFPN颈部网络,该模型显著提升了在VisDrone等复杂场景下的检测精度,为实时无人机目标检测提供了新的技术范式。

weixin_29047919的博客 181

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

上一篇: 深度学习研1、2,三个月水论文一般流程
下一篇: YOLO-S:小目标检测的轻量级、精确的类YOLO网络
深度学习机器学习
博客等级 码龄2年 495粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值