手搓机器学习代码进步太快了!(附学习资料)

ML system 入坑指南 阅读详情

如果你正在学习机器学习入门,纯粹学习机器学习理论,容易陷入迷茫,不清楚算法怎么使用,以及怎么实现这个算法

学习机器学习算法的过程中,建议边学习理论,边尝试将理论中的公式建模推导实现出来,就是大家常说的手搓代码,手搓对于提升代码能力真的很有帮助

下面给大家推荐一个手搓机器学习教程(结合之前的机器学习教程一起看更有感觉):
 

文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
1. KNN算法

首先要基于KNN的原理实现KNN模型,KNN模型挺简单的,总共就三十行左右代码,但是这个模型的思想是挺重要的,算法的具体代码如下,当然还有相应的训练文件
import numpy as np

from collections import Counter
def euclidean_distance(x1, x2):    distance = np.sqrt(np.sum((x1-x2)**2))    return distance
class KNN:    def __init__(self, k=3):        self.k = k
    def fit(self, X, y):        self.X_train = X        self.y_train = y
    def predict(self, X):        predictions = [self._predict(x) for x in X]        return predictions
    def _predict(self, x):        # compute the distance        distances = [euclidean_distance(x, x_train) for x_train in self.X_train]
        # get the closest k        k_indices = np.argsort(distances)[:self.k]        k_nearest_labels = [self.y_train[i] for i in k_indices]
        # majority voye        most_common = Counter(k_nearest_labels).most_common()        return most_common[0][0]

2. 线性回归算法

线性回归模型是最简单的机器学习模型,通过拟合自变量和因变量之间的关系,模型也不复杂,适合小白练手,练习的时候不要直接看答案,争取自己先去写一下代码

import numpy as np
class LinearRegression:
    def __init__(self, lr = 0.001, n_iters=1000):        self.lr = lr        self.n_iters = n_iters        self.weights = None        self.bias = None
    def fit(self, X, y):        n_samples, n_features = X.shape        self.weights = np.zeros(n_features)        self.bias = 0
        for _ in range(self.n_iters):            y_pred = np.dot(X, self.weights) + self.bias
            dw = (1/n_samples) * np.dot(X.T, (y_pred-y))            db = (1/n_samples) * np.sum(y_pred-y)
            self.weights = self.weights - self.lr * dw            self.bias = self.bias - self.lr * db
    def predict(self, X):        y_pred = np.dot(X, self.weights) + self.bias        return y_pred


3. 逻辑回归算法

逻辑回归是最简单的二分类模型,基于sigmoid函数来计算正负类的概述,注意逻辑回归的损失函数是交叉熵损失,部分代码如下:

import numpy as np
def sigmoid(x):    return 1/(1+np.exp(-x))
class LogisticRegression():
    def __init__(self, lr=0.001, n_iters=1000):        self.lr = lr        self.n_iters = n_iters        self.weights = None        self.bias = None
    def fit(self, X, y):        n_samples, n_features = X.shape        self.weights = np.zeros(n_features)        self.bias = 0
        for _ in range(self.n_iters):            linear_pred = np.dot(X, self.weights) + self.bias            predictions = sigmoid(linear_pred)
            dw = (1/n_samples) * np.dot(X.T, (predictions - y))            db = (1/n_samples) * np.sum(predictions-y)
            self.weights = self.weights - self.lr*dw            self.bias = self.bias - self.lr*db

    def predict(self, X):        linear_pred = np.dot(X, self.weights) + self.bias        y_pred = sigmoid(linear_pred)        class_pred = [0 if y<=0.5 else 1 for y in y_pred]        return class_pred

4. 决策树算法

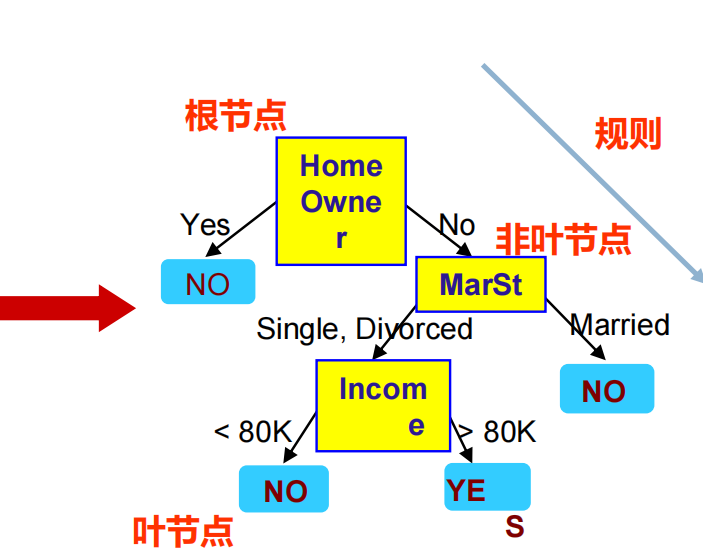
决策树算法是基于二叉树的一种算法,通过在每个节点进行特征划分来实现分类和回归任务,主要有ID3, C4.5和CART分类/回归树几种类型,算法实现过程会比前面的几个更复杂一些,代码比较长就不直接放代码了
5. 随机森林算法

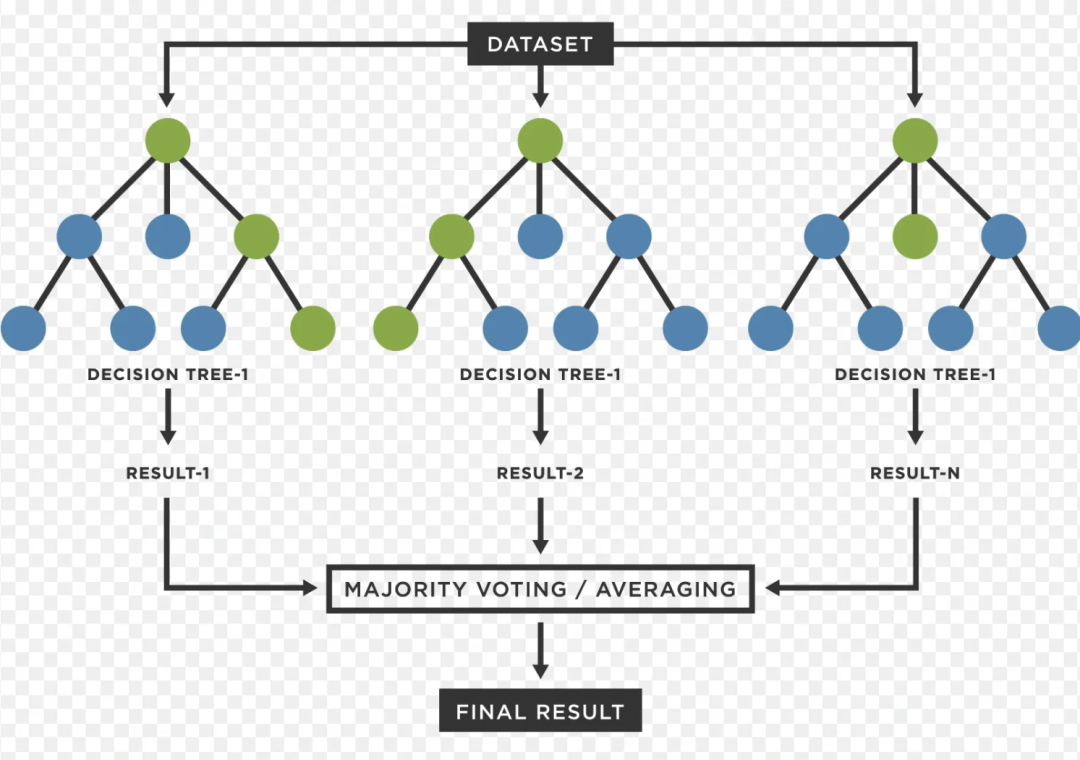
随机森林算法是基于决策树的一种算法,通过并行训练多棵决策树来提升模型的融合效果,随机森林算法比较容易过拟合,注意设置最大树深度和树的数量等
文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

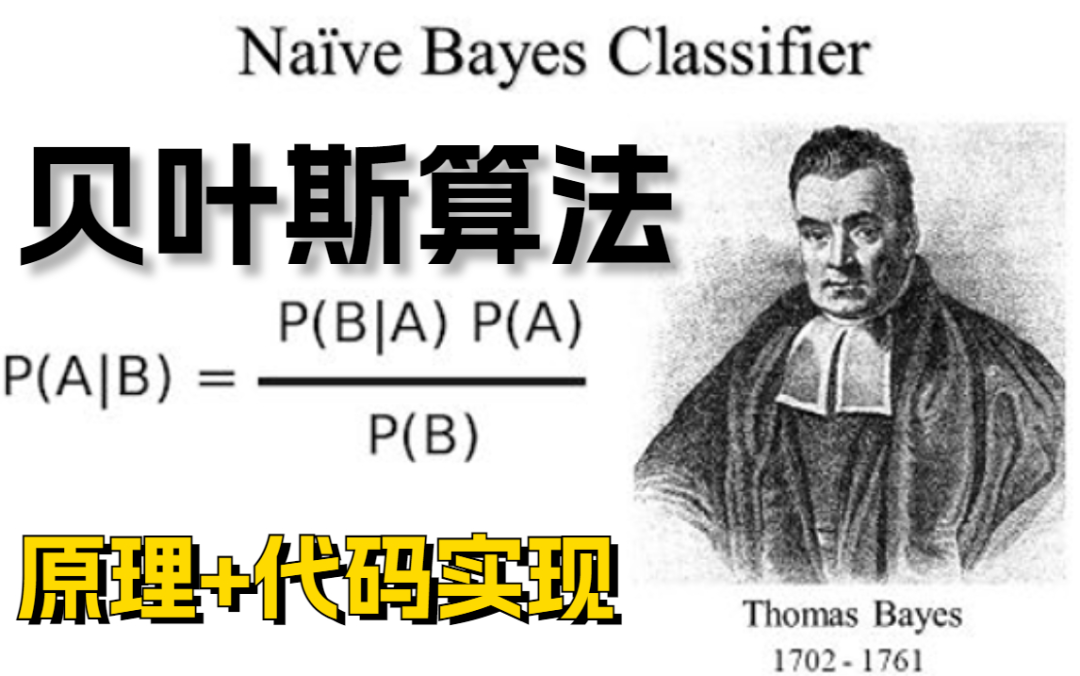
6. 朴素贝叶斯算法

朴素贝叶斯算法是基于贝叶斯定理的一种算法,可以用于解决垃圾邮件分类等问题,贝叶斯定理真的太伟大了这个思想,朴素指的是特征条件独立,这个在面试中经常会问到
7. PCA算法

主成分分析是用于降维的一种算法,对于数据特征维度比较多,以及存在一些多重共线性问题的时候,可以采用PCA进行降维,防止过拟合。代码总体上不算特别复杂,对于稍微有点python基础的同学,完成可以实现

mport numpy as np
class PCA:
    def __init__(self, n_components):        self.n_components = n_components        self.components = None        self.mean = None
    def fit(self, X):        # mean centering        self.mean = np.mean(X, axis=0)        X = X -  self.mean
        # covariance, functions needs samples as columns        cov = np.cov(X.T)
        # eigenvectors, eigenvalues        eigenvectors, eigenvalues = np.linalg.eig(cov)
        # eigenvectors v = [:, i] column vector, transpose this for easier calculations        eigenvectors = eigenvectors.T
        # sort eigenvectors        idxs = np.argsort(eigenvalues)[::-1]        eigenvalues = eigenvalues[idxs]        eigenvectors = eigenvectors[idxs]
        self.components = eigenvectors[:self.n_components]
    def transform(self, X):        # projects data        X = X - self.mean        return np.dot(X, self.components.T)

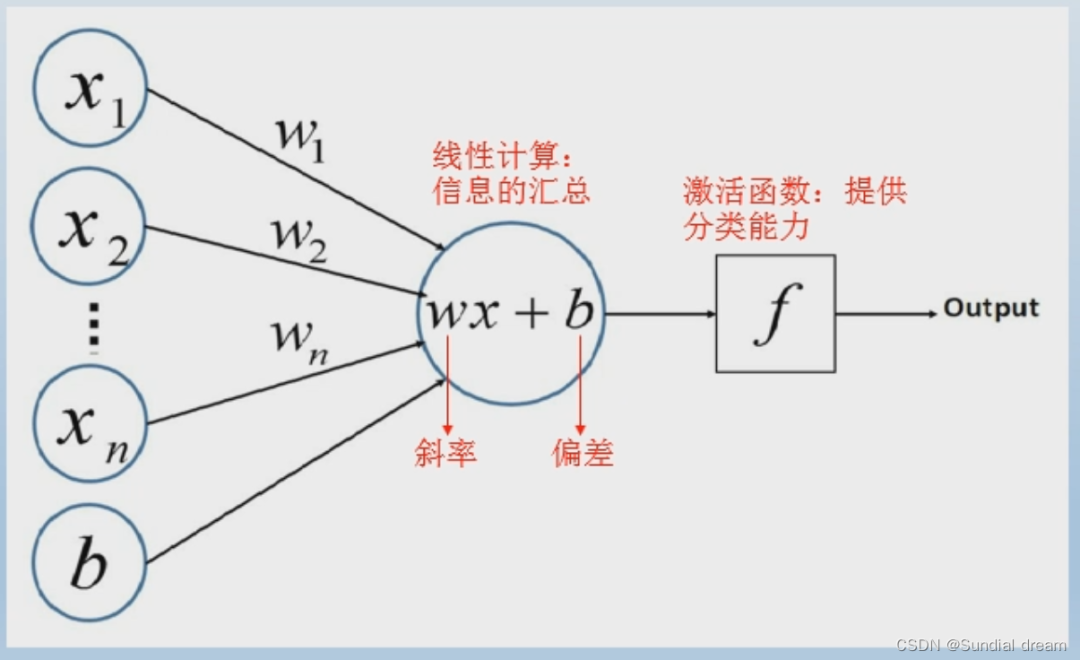
8. 感知机算法

感知机是机器学习历史上第一个真正意义的神经网络的模型,其他深度学习模型都是在这个基础上发展改进的,算法实现简单,易于理解,后续启发了MLP和反向传播等发展,这个可以看一看,手撕感觉意义不大,还不如手撕MLP
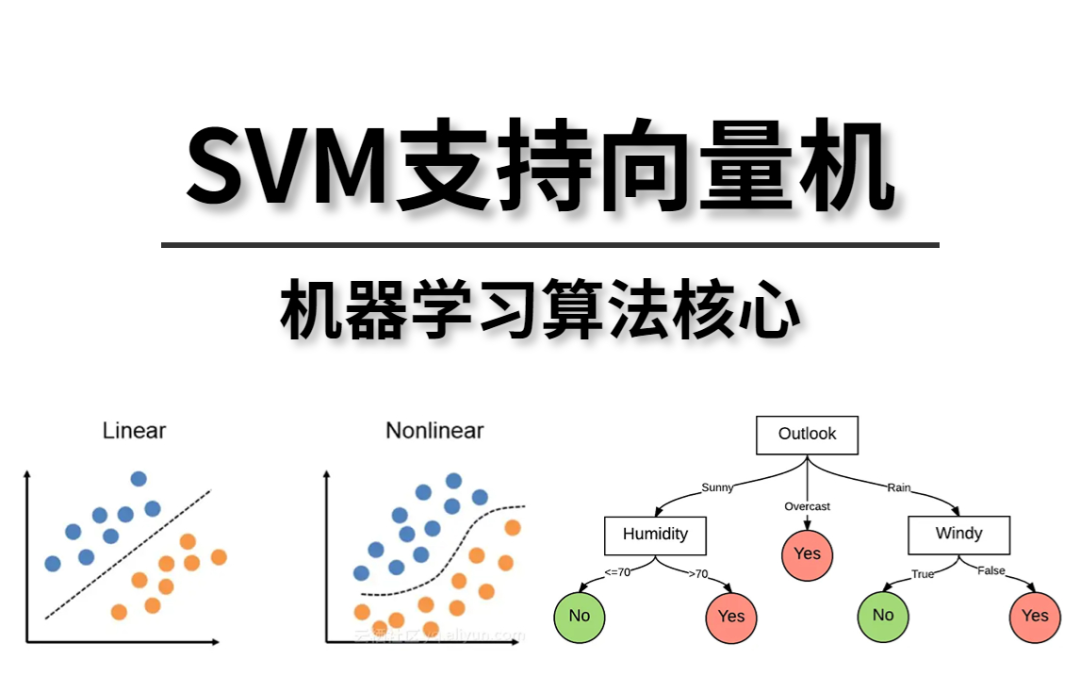
9. SVM算法

SVM 的目标不是随便找一个能分开两类的超平面,而是找间隔,间隔越大,分类器越“自信”,对噪声和新样本的鲁棒性越强,泛化能力更好
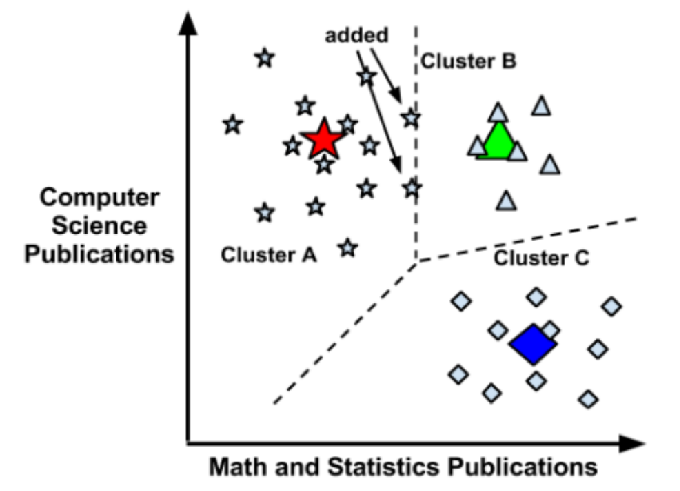
10. K-means算法

k-means算法是一类聚类算法,属于无监督学习,通过设置K参数,期望最终聚类成K个簇,注意和分类算法进行区分,算法相对来说比其他的复杂,可以看一下代码就行,多看代码一定会有进步的
文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

介绍几个我学习机器学习经常逛的社区,论坛 前言: 学习技术我没有完整的看完一本技术书,因为效果不好,自己照着代码敲一遍,执行完以后,合上书基本就是:什么冬梅?马什么梅?而且技术迭代太快,有些书已经跟不上技术的潮流,所以自己很少看书,一般是用到的时候才去翻书。这是一个开源的时代,网络资源是自己学习的主要工具,对于机器学习,网上的社区氛围特别好,分享的很多很全面,而且MLer都非常乐于助人。今天给大家分享几个自己经常逛的社区和论坛。 ... 阅读详情

相关推荐

机器学习入门基础

一,什么是人工智能 人工智能(Artificial Intelligence),英文缩写为 AI。它是研究使计算机来模拟人的某些思维过程和智能 行为(如学习、推理、思考、规划等)的学科,主要包括计算机实现智能的原理、制造类似于人脑智能的计算机,使计算机能实现更高层次的应用。人工智能将涉及到计算机科学、心理学、哲学和语言学等学科。 二,人工智能应用领域 三,什么是机器学习 ...

qq_42379006的博客 546

机器学习-手搓KNN算法

K最近邻(K-Nearest Neighbors, KNN)​ 是一种简单且直观的监督学习算法,适用于分类和回归任务。其核心思想是:​相似的数据点在特征空间中彼此接近。KNN通过计算新样本与训练数据中各个样本的距离,找到最近的K个邻居,并根据这些邻居的标签进行预测。对于分类任务:新样本的类别由K个最近邻居中多数决定对于回归任务:新样本的输出值由K个最近邻居的平均值决定。

m0_73426548的博客 427

ExcelVBA批量添加PDF文件

如图1所示,"BOM-01.xlsx"工作簿中的Sheet1工作表根据B列图号单元格中的内容,在图2所示的文件夹中找到对应的PDF文件,然后嵌入到相应的N列,双击N列中所示的图标,会打开PDF文件,是源文件的副本,即删除源文件,也可以打开N列的文件。 图1 根据B列的图号在N列嵌入对应的PDF文件 图2 PDF文件 图3 文件格式 Sub 导入文件() Ap...

qq389445046的博客 5577

从0到1——手搓【Transformer】底层代码_手搓transformer

同时课程详细介绍了。

HUANGXIN9898的博客 1365

【智能教育实践】MOOPer数据集在个性化学习路径规划中的应用

本文探讨了如何利用MOOPer数据集实现从“千人一面”到“千人千面”的个性化学习路径规划。通过分析学习者与平台的交互数据(如练习、反馈、讨论)并结合知识图谱,系统能够动态诊断学生知识状态,并为其推荐最优学习序列。文章详细介绍了基于数据驱动的推荐系统核心技术,包括知识追踪、图谱关联挖掘及排序策略,旨在解决传统在线教育的僵化问题,提升学习效率与动力。

read5的博客 230

嵌入式开发也玩“全家桶”?手把手教你用CLion+PyOCD调试APM32,比OpenOCD更简单

本文详细介绍了如何使用CLion和PyOCD组合进行APM32嵌入式开发,提供从环境配置到实战调试的完整指南。相比传统工具如Keil和OpenOCD,这套方案更轻量、易用,特别适合现代开发者需求,涵盖CMake配置、PyOCD调试技巧及常见问题解决。

weixin_42543046的博客 464

DeepSeek做PPT,太快了

今天同事问我 AI 能不能做 PPT,有个述职报告要做,问我能不能帮忙,这时我脑海中的第一画面就是 DeepSeek + KimiDeepSeek 擅长逻辑构建与内容生成,其深度思考能力当前测试下来,不愧为国内No.1,而且还会把中间的思考过程展示出来,大多时候会给出很多我们意想不到的思路。Kimi智能助手的功能又很丰富,其中的PPT助手,就很适合将 DeepSeek 深度思考整理出来内容一键生成PPT优秀的工具 + 优秀的工具 + 我 这相当于 1 + 1 + 1 > 3。

m0_59164520的博客 5767

达梦DM8整合Seata AT模式实战:手把手教你搞定分布式事务(含源码修改避坑)

本文详细介绍了达梦DM8数据库与Seata AT模式的深度整合实战,包括环境准备、架构设计、源码适配及分布式事务落地。通过独创性源码改造,解决了Seata官方对达梦数据库AT模式支持的限制,为国产数据库在微服务架构中的应用提供了可靠的事务保障。

weixin_30764771的博客 333

人工智能vs机器学习vs深度学习:概念辨析

深度学习本质上还是机器学习,就是用“多层深度神经网络”这个模型结构来做机器学习,相当于机器学习这个大分支里,又出来一个效果特别好、发展特别快的小分支,结果这个小分支发展得太猛了,从AlexNet到VGG到ResNet,再到Transformer,再到BERT,再到GPT大模型,10年时间就席卷了几乎所有AI领域,现在大家提到AI,第一反应就是深度学习,就是大模型,很多新人甚至根本不知道传统机器学习和符号AI了

优快云博客专家,领域包括但不限于:AI、大数据、Python、架构师,有合作、课程、问题、疑惑请私信博主 1万+

一起玩儿物联网人工智能小车(ESP32)——48. 利用循迹模块实现循迹小车(三)

摘要:本文介绍循迹小车的接线方法及类的基础知识

一起玩儿科技 1135

使用AutoDL云服务器训练YOLO计算机视觉网络模型(AutoDL+Xftp+VS Code),附详细操作步骤

AutoDL AI算力云是一个提供人工智能算力服务的云平台。丰富的GPU资源:提供多种GPU型号,包括NVIDIA的A100A800L40V100RTX 4090RTX 3090等,能满足我们在不同场景下的需求,无论是进行大规模的AI训练还是复杂的科学计算等任务,都可以找到合适的GPU资源。灵活的付费方式:支持按量付费包日包周包月等多种付费模式。对于短期的实验或不确定时长的项目,可以选择按量付费;如果有长期稳定的算力需求,预付费或包周包月则可能更划算,可以根据自己的需求和预算进行选择。集成主流框架:集成了。

Limiiiing的博客 958

ML-Agents:训练配置文件(二)

本文是Unity ML-Agents Toolkit训练配置文件的第二部分,主要介绍了特定训练器的配置选项。对于PPO训练器,文章讨论了熵正则化强度、策略演化速度、GAE正则化参数、梯度下降遍历次数和是否共享价值函数网络等配置。对于SAC训练器,涉及了缓冲区初始化步数、初始熵系数、是否保存回放缓冲区、目标网络更新速度和每步更新次数等设置。MA-POCA训练器与PPO共享配置,没有额外参数。文章强调了这些配置对训练稳定性和效率的影响,并鼓励读者提出建议以促进共同进步。

m0_58988991的博客 1236

视图库对接系列(GA-T 1400)四、视图库对接系列(本级)注册

在之前的步骤中,我们已经把项目大体的架构已经写出来了。那我们就来实现注册接口。GA-T 1400中的步骤如下:这里的话,我们实现的简单点, 我们不进去鉴权,也就是设备或平台找我们注册的话,我们直接返回成功,不进行验证。如果需要鉴权的话可看我的另外一篇文档。

qq_37716298的博客 1044

零代码!完成数据分析、机器学习

零代码!完成数据分析、机器学习最近参加了一个数据建模比赛,举办方介绍了了一款软件叫看了他演示的功能可以说就办了三件事方便!方便!还是***方便!一拖一拽一点简直不要太快而且分析步骤,输出结果,图表说明应有尽有以官网自带的青少年样本中的身高-体重的正态检验为例只需将需要的特征列按指示拖拽就可以得到丰富的分析结果:其中对显著性水平进行了解释同时针对数据给出结论红色方框中的等也均有体现生成的为doc文件和pdf文件不止如此spsspro功能极其丰富。...

qq_36396757的博客 718

使用LabVIEW创建和分析柱状图:从基础绘制到高级数据分析的完整指南

LabVIEW,全称为Laboratory Virtual Instrument Engineering Workbench,是由美国国家仪器公司(National Instruments, NI)开发的一款图形化编程语言。自1986年首次推出以来,LabVIEW凭借其强大的数据采集、分析和控制能力,在工程、科研、教育等领域得到了广泛应用。与传统的文本编程语言不同,LabVIEW采用了图形化编程方式,用户通过连接不同的函数节点来实现复杂的逻辑和算法。

qq_38334677的博客 775

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

机器学习三要素深度解析:一个完整的故事带你彻底掌握 ML 核心框架

本文系统阐述了机器学习的三大核心要素:模型、策略与算法。模型(如线性回归、神经网络)是对数据规律的数学抽象;策略通过损失函数(如均方误差、交叉熵)定义优化目标;算法(如梯度下降)则负责高效求解最优参数。三者协同工作,构成了机器学习的基础框架。文中通过线性回归的完整代码示例,生动展示了梯度下降如何优化模型参数。理解这一框架,有助于把握各类机器学习方法的本质,为后续学习奠定坚实基础。

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 304

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Swift AI 工具链实战:从 Core ML 到 MLX 与本地 Agent 编排

端侧推理是指在设备本地完成模型计算,不依赖云端,其原理基于量化压缩与硬件加速,能显著提升隐私、延迟与离线可用性。在 Apple 生态中,Core ML 与 MLX 分别面向生产部署与研究实验,结合 Swift 并发模型可构建本地 Agent。典型场景包括 iOS/macOS 智能助手、隐私敏感行业应用。本文围绕 Swift、AI、MLX、Agent、Core ML 等关键词,梳理从模型转换、量化到 Agent 编排的完整工程路径,并给出可操作代码与避坑经验。

weixin_33139275的博客 265

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Ml307Udp: Failed to send data chunk

摘要:ML307模块UDP发送失败通常由音频播放期间串口通信中断或状态机错乱导致,而非单纯的AT命令问题。主要原因包括:1)音频任务占用资源导致UART接收丢失关键响应;2)网络短暂掉线或socket回收;3)发送过快导致模块缓存溢出。建议验证方法包括检查串口原始数据、网络状态和系统资源。修复方案应优化任务调度、启用硬件流控、增加心跳机制并控制发送速率。快速定位可在失败时打印原始AT交互、网络状态和系统资源信息。

qq_41126242的博客 489

机器学习如何重塑最优定价

点击上方“AI公园”,关注公众号,选择加“星标“或“置顶”作者:Javier编译:ronghuaiyang正文共:4727 字 6 图预计阅读时间:14 分钟导读智能定价是机器学习的非常...

AI公园 5329

我开的慕课《机器学习》突破了1万人,回答几个问题

中国大学慕课《机器学习》,黄海广主讲,第一次开课快结束了,目前突破了10000人,成为热门课程,课程即将结束(1月3日结束),现在修改了课程设置,只要报名了课程,就能继续看回放了!课程链接...

fengdu78的博客 867

机器学习内卷了吗?

机器学习内卷了吗?一本优秀的机器学习入门书籍《零基础学机器学习》的创作手记。

JackyHuang79的博客 928

[ML]机器学习_激活函数

激活函数(Activation Function)是神经网络中的一种数学函数,用于将输入转换为输出,并增加神经元之间的非线性特性。激活函数通常被应用于神经网络中的隐藏层和输出层,以实现非线性映射和复杂的分类和回归任务。常见的激活函数包括Sigmoid函数、ReLU函数、Tanh函数等。选择合适的激活函数可以对神经网络的性能和准确度产生重要影响。

iazzz的博客 334

【职业发展】ML工程师相关资料整理

Aron 数据科学小菜/励志当大厨 2 人赞同在实际的工作中,从事机器学习相关工作的有四种角色(不一定对,算抛砖引玉吧) 1. 初级工具侠,在了解一定基础甚至没有基础的情况下,按照模型训练需要的格式处理好数据,输入, 然后调优,最后离线跑全量数据或者在线实时调用模型 2. 高级工具侠,了解模型,知道多模型融合,模型调优和特征工程功底炉火纯青 3. 工具创造者,跟进最新的研究进展,结合公司具体

Fusrodah 940

AdaGrad从直觉到推导、从手算到工程

AdaGrad优化器通过累计平方梯度实现自适应学习率,解决了不均匀曲率、高维稀疏特征学习等问题。其核心思想是为每个参数维度维护独立的学习率,梯度变化大的方向缩小步长,稀疏特征保持较大步长。文章详细推导了AdaGrad的数学公式与矩阵视角,通过密集二次函数和稀疏逻辑回归两个手算示例展示其工作机制,并分析了实现中的关键细节:ε取值、稀疏更新、权重衰减处理、混合精度等。最后指出AdaGrad存在后期学习率衰减问题,建议采用窗口化、重置策略或切换其他优化器。代码实现时需注意稀疏特征的高效更新和统计量存储优化。

hello.reader 837
上一篇: 这是一份机器学习算法的Python实现教程!(附学习资料)
下一篇: 看机器学习笔记真的会上瘾!(附学习文档)
深度学习机器学习
博客等级 码龄2年 495粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值