关于大模型和知识图谱、本体的一场讨论,零基础入门到精通,收藏这一篇就够了

知识图谱中的 Ontology(本体论) 本文的部分图片和内容来自中国科学院自动化研究所刘康老师的课件 Ontology(本体论) Ontology 是(特定领域)信息组织的一种形式,是领域知识规范的抽象和描述,是表达、共享、重用知识的方法。 Ontology 是知识体系构建的关键技术,知识图谱是一种人工智能技术,它的关键在于让计算机能够处理人类的知识。然而,人类脑海中的知识通常是直觉性的,我们无法将这种直觉性的知识直接输入给计算机,On... 阅读详情

前段时间,在OpenKG分享了我们在知识图谱结合大模型的技术及医药行业落地应用,“大模型+知识图谱”双轮驱动的医药数智化转型新范式-OpenKG TOC专家谈,关注度很高。本篇编译分享关于大模型和知识图谱、本体的一场讨论。

本体是知识的形式化表示。它们由特定领域内的概念、类别及其之间的关系组成。本体旨在以结构化的形式建模领域知识。它们使机器和人类能够理解、共享和重用这些知识。在生物医学领域,一个著名的本体示例是基因本体,它提供了一套全面的术语和关系来描述任何生物体中基因和蛋白质的功能。
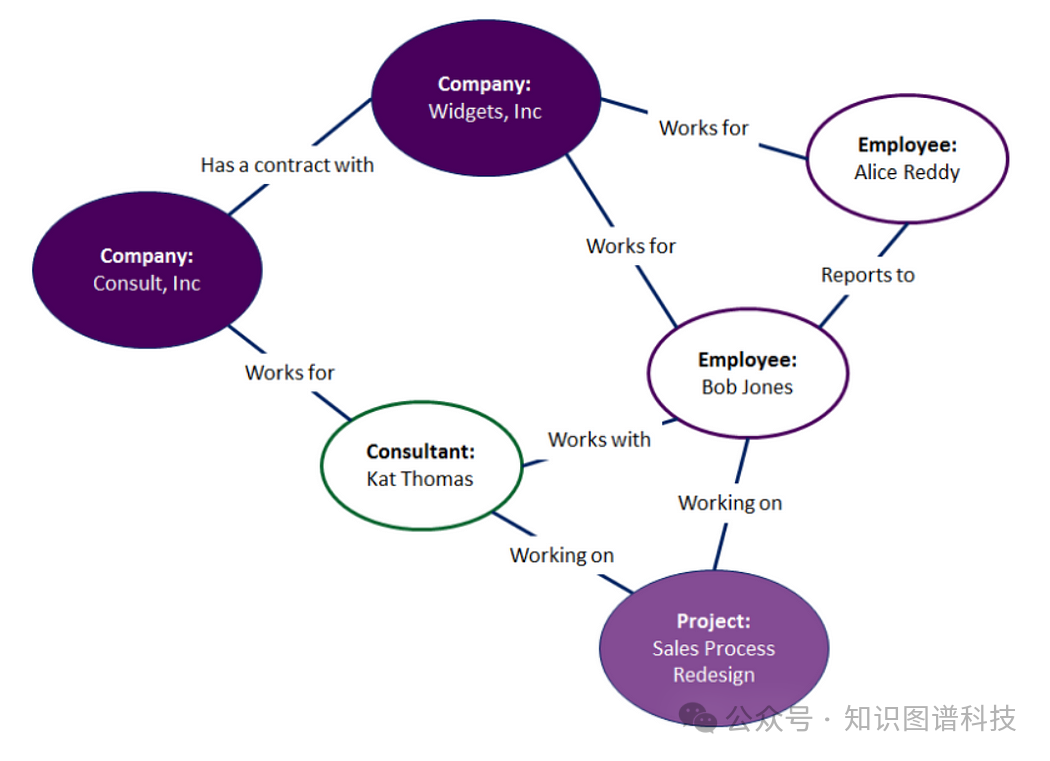
LLMS基于大模型的本体与知识表示

本体在知识表示领域中发挥着至关重要的作用。它们通过定义特定领域内概念之间的关系,提供了知识的结构化和形式化表示。这种结构化的方法使计算机能够以逻辑、一致和可理解的方式理解、推理和处理信息。然而,本体的设计和维护需要大量的精力。

在大语言模型(LLM)出现之前,本体被认为是语义理解的巅峰。它们是机器理解各种领域语义的主要方法。尽管本体具有实用性,但它们也显示出局限性,相对缺乏灵活性、不完整,并且适应新信息的速度较慢。

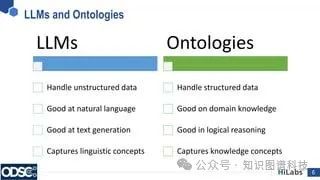
大语言模型的出现为知识表示和处理领域引入了一个新的维度。大语言模型凭借其在大量数据集上训练的庞大神经网络,展示了前所未有的理解、生成和操作语言的能力。这种能力为以往无法想象的方式增强和扩展本体打开了可能性。

大语言模型与本体的融合创造了一种强大的协同效应,充分利用了两者的优势,以实现更卓越的语义理解和知识处理。
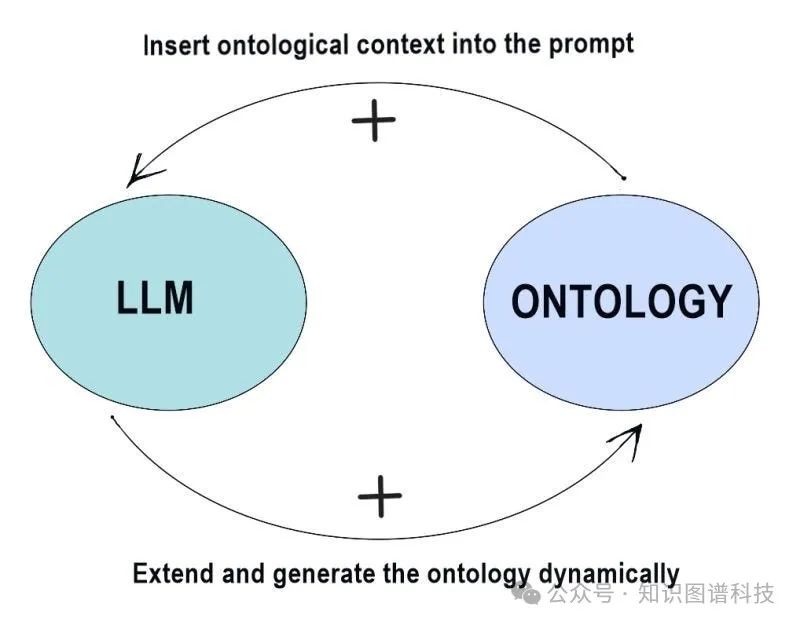
LLM可以帮助生成和扩展本体,使这一过程变得更加快速和灵活。这一能力是一个游戏改变者,因为它减少了更新和维护本体所需的人工工作量。

然而,涉及“人类环节”的参与仍然至关重要,以监督和引导这一过程,确保生成内容的准确性和相关性。顶尖的LLM在这一角色中展现出了惊人的有效性,证明了它们有潜力彻底改变本体的开发和维护方式。

本体反过来为提供给LLM的提示提供了重要的上下文。这一上下文丰富了LLM回应的准确性和相关性,使其更符合特定领域的语义。此外,本体可以用于验证LLM生成的回应的一致性,确保所产生的信息是连贯的且逻辑结构合理。

大型语言模型与本体论之间的协作建立了一种连续改进的加强反馈循环。随着大型语言模型帮助更快速和动态地生成更好的本体论,改进后的本体论反过来又提升了大型语言模型的性能。

这种协同效应为LLMs分析的数据和文本提供了更全面的背景,增强了它们的理解和处理能力。这种正反馈循环有潜力催化组织内AI应用能力的指数跃升。它可以以空前的方式简化流程、增加智能,并提升客户体验。

LLMs与本体的集成代表了人工智能和知识管理领域的重大进步。它将LLMs动态灵活的语言理解能力与本体的结构化和形式化知识表示相结合。这种伙伴关系不仅加速了本体的开发和维护,还增强了AI系统的语义理解和推理能力。随着这种协作方法的不断发展,它有望为AI应用解锁新的可能性,使其在满足组织及其客户需求方面更加智能、高效和响应迅速。

AI中的本体

本体在人工智能中发挥着至关重要的作用。它们提供了一个组织信息的结构化框架。这使得人工智能系统能够理解和解释不同概念之间复杂的关系。本体本质上是一种定义特定领域中实体类型及其之间关系的方法。
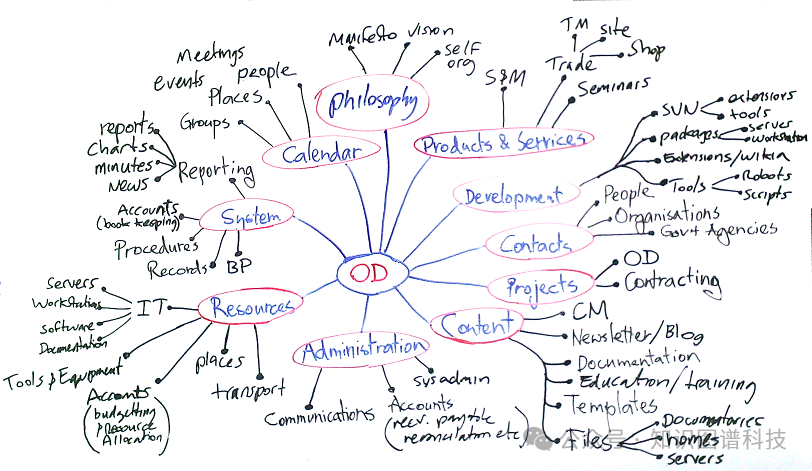
一个人工智能中的本体包括一组概念、类别和属性。这些元素有助于知识的表示。例如,在医学本体中,概念可能包括疾病、症状和治疗。类别可以区分感染性疾病和遗传性疾病。属性可能描述疾病与其症状之间的关系。

本体在人工智能中的主要用途之一是实现语义互操作性。这是不同系统以相同方式理解和解释数据的能力。例如,如果两个医疗系统使用相同的本体,它们可以无歧义地共享和理解彼此的数据。在医疗等领域,这一点尤其重要,因为信息的准确交换可能至关重要。

本体在自然语言处理(NLP)中也发挥着关键作用。它们有助于理解句子中单词的上下文和含义。例如,“银行”一词可以指代金融机构或河岸。本体可以帮助人工智能系统根据对话的上下文确定正确的含义。

在机器学习领域,本体可以增强学习过程。它们提供了一个结构化的知识库,机器学习模型可以利用该知识库更好地理解数据。这可以导致更准确和高效的学习结果。例如,基于具有基础本体的数据集训练的人工智能模型可以更轻松地对新的、未见过的数据进行分类。

本体的开发需要对领域有深入的理解。这涉及识别关键概念及其关系。这个过程通常是协作的,涉及领域专家和知识工程师。最终的结果是可以被人工智能系统使用的知识的正式表示。

用大模型创建本体

**定义领域和范围:**构建本体的第一步是清晰地定义领域和范围。这涉及识别主题内容,设定边界,并确定本体的目的。明确本体的预期用途和希望回答的问题至关重要。这一阶段还包括概述要建模的概念、关系和知识类型,并决定是一般化还是专业化的程度。

**收集信息来源:**下一步是识别和汇编相关的信息来源。这些信息来源可以包括文档、数据文件、数据库、网站和领域专家的见解。将与该领域相关的全面文本内容编纂成语料库。与利益相关者进行沟通是收集示例、术语和需求的重要环节。现有的标准、分类法和竞争性本体可以提供灵感和见解。

**提取概念和关系:**在信息来源汇编完成后,LLM被提示分析内容。这一分析旨在提取重要的术语、实体类型、关系、属性、层级和关联。LLM可能会建议可能缺少的额外相关概念。基于这些见解,创建了一个初步粗略的分类法。

**组织分类层级:**利用模型的输出,将概念分类为一个连贯的层次结构。这涉及根据它们的相似性将概念从一般到具体进行结构化,并定义更广泛和更狭义术语之间的父子关系。根据需要对模型的分类进行修正,以确保准确性。

**定义附加属性:**本体通过识别实体类型的属性、特征和特性来扩展。这包括指定数据属性、元属性和限制。定义表示实体类型之间关系的对象属性,包括关联属性、对称属性、传递属性或逆属性。模型可能会建议添加其他属性

**编码本体:**选择标准本体语言如OWL、RDF或OBO进行本体编码。概念本体在模型的帮助下被翻译为正式编码。这涉及在代码中指定类、个体、属性、关系和限制,以及定义逻辑公理和推理规则

**迭代优化:**本体根据能力问题和要求进行评估。识别出差距、不一致和冗余,并提示模型建议改进和补充。这一迭代优化过程持续进行,直到本体提供满意的覆盖范围

**填充本体:**为每个类实例化代表性个体。该模型可以协助生成样本个体。个体通过定义的属性链接,确保逻辑一致性。

正式评估和专家评审**:**使用如Pellet、HermiT或FaCT++的推理器评估逻辑一致性。本体与领域专家一同审核以确保准确性和完整性。根据专家反馈进行修订,评估重复进行直到达到满意的结果。

**全面文档记录:**生成全面的文档,解释本体的各个组成部分、设计依据和来源。每个类别、属性和关系都有详细说明,并附有可读的人类描述。对本体的能力、局限性和使用指南进行了记录。

与大型语言模型(LLM)一起创建本体是一个将手动和自动步骤结合起来的详细过程。最终产品是一个决策工具,利用本体和LLM的能力,创建出能够适应和有效的人工智能系统。

本体和知识图谱
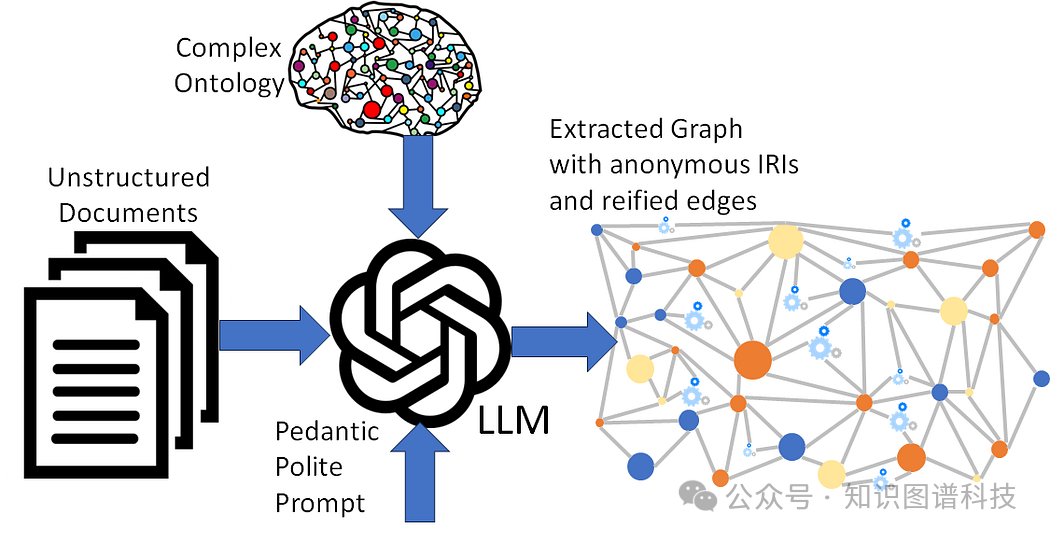
知识图谱是在知识表示方面更进一步的步骤。它们不仅包括本体中找到的结构化概念和关系,还包含这些概念的实例。

知识图谱是由实体、它们的属性和它们之间的关系组成的大型网络。它们是动态的,允许不断添加新信息。谷歌的知识图谱就是一个典型例子,通过来自各种来源的信息增强其搜索引擎的结果,这些信息以突出实体之间关系的方式进行结构化。
本体论和知识图谱之间的区别在于它们的范围和应用。

  • 本体论更多关注于某一领域内知识的正式、通常是抽象的表示,专注于概念之间的关系。

  • 知识图谱则更加广泛,不仅包含这些关系,还包括概念的现实实例,使其在增强搜索引擎或支持推荐系统等实际应用中更加有效。

本体论和知识图谱的应用广泛且多样。

  • 在医疗保健领域,本体论有助于组织医疗知识,促进不同健康系统之间的语义互操作性。

  • 知识图谱则用于提升用户在网络上的体验,通过搜索引擎、社交网络和电子商务网站等服务,为用户提供相关、关联的信息,从而改善搜索结果和推荐的质量。

本体论和知识图谱的重要性不容低估。

  • 它们对于语义网至关重要,语义网是万维网的扩展,允许数据在应用、企业和社区之间共享和重用。

  • 它们在人工智能中发挥着关键作用,尤其是在自然语言处理领域,理解词语之间的上下文和关系至关重要。

参考文献:

  1. For further reading on the development and application of ontologies in AI, see “Ontologies: A Silver Bullet for Knowledge Management and Electronic Commerce” by Dieter Fensel (https://link.springer.com/book/10.1007/978-3-662-04723-3).

  2. Research in the field of ontologies is ongoing. A notable paper is “Building Ontologies with Basic Formal Ontology” by Robert Arp, Barry Smith, and Andrew D. Spear, which provides a comprehensive guide to developing ontologies (https://mitpress.mit.edu/books/building-ontologies-basic-formal-ontology).

  3. For further reading on the development and application of ontologies and knowledge graphs, refer to “Building Knowledge Graphs” by Hogan et al., 2020 (https://arxiv.org/abs/2002.00388), which provides a comprehensive overview of the principles, methodologies, and tools involved in constructing knowledge graphs.

  4. For further reading on the challenges and methodologies of fine-tuning LLMs with knowledge graphs, refer to the research paper “Fine-Tuning Language Models from Human Preferences” (https://arxiv.org/abs/1909.08593). This paper provides insights into the complexities of aligning LLMs with human-like understanding and preferences, offering a relevant perspective on the topic discussed.

  5. 在Palantir生成式人工智能平台AIP中用本体Ontoloty减少幻觉

  6. 知识图谱增强大模型GraphRAG全面综述解读 - 蚂蚁集团、北大、浙大、人大等

  7. “大模型+知识图谱”双轮驱动的医药数智化转型新范式-OpenKG TOC专家谈

AI大模型学习福利

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

四、AI大模型商业化落地方案

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

知识图谱初步学习(一)——本体+Protege新手学习 文章目录前言(本体详解)1.本体概念2.本体分类3.本体组成4.本体构建方法一、protege简介二、软件使用步骤1.安装2.使用三、问题解决方案汇总 前言(本体详解) 在开始学习知识图谱的过程中,首先就是要了解什么是本体(ontology)。 1.本体概念 本体的概念最初源自于哲学领域,在哲学中的定义为“对世界上客观事物的系统描述,即存在论”。哲学中的本体关心的是客观现实的抽象本质。而在计算机领域,本体是可以在语义的层次上来对知识进行描述,可以看做是某一个领域知识的通用模型。 本体是从客观世界中抽象出来 阅读详情

相关推荐

大模型与知识图谱之间的关系

大模型和知识图谱是两个不同的概念,但它们可以相互补充和增强。大模型是指采用深度学习技术训练出来的参数数量庞大、参数复杂度高的模型,例如 OpenAI 的 GPT-3 模型。大模型通过对海量数据的学习,可以从中提取出复杂的特征和规律,从而实现各种任务,例如自然语言处理、计算机视觉等。大模型的优势在于可以从数据中自动学习知识,避免了手动构建知识库的繁琐过程。知识图谱则是一种以图为基础的知识表示和推理框架,可以用来描述实体之间的关系和属性,并支持自然语言问答、推荐系统等多种应用。

源代码杀手的博客 4062

从“被优化”到“AI训练师”:35岁转行实操手册,把经验变成喂给AI的“黄金饲料”

2025年的职场,“35岁+”仿佛一道无形的分水岭。

m0_59163425的博客 4513

为什么你的Nginx配置SM2国密SSL证书失败?这些坑我都帮你踩过了

本文针对Nginx配置SM2国密SSL证书的常见失败原因,提供了详细的排查与解决方案。核心在于使用支持国密算法的Nginx版本(如集成Tongsuo库),正确处理从阿里云等平台获取的证书格式,并正确配置ssl_ciphers等关键参数。文章还解释了浏览器兼容性差异及双证书部署等进阶场景,帮助运维和开发人员高效完成国密合规改造。

weixin_29228203的博客 387

0代码,5分钟,搭建出企业级文档处理MCP Agent

文档质量决定了大模型理解的上限。当你正在构建知识库或者搭建文档审核相关的Agent,可以考虑将TextIn MCP Server嵌入到你的搭建工作流中,成为你的文档处理引擎。

z551646的博客 1387

探索Vortex开源GPGPU:RISC-V SIMT架构(4-1),Execute SFU(1)

本文详细分析了Vortex RISC-V内核6级流水线中Execute阶段的SFU(特殊功能单元)模块。重点介绍了SFU的数据流结构,包含dispatch_unit、pe_switch、csr_unit、wctl_unit和gather_unit五个子模块。文章深入解析了warp控制指令wspawn和tmc的实现机制:wspawn用于激活指定数量的warp并设置新PC值,tmc则用于控制线程掩码和warp状态。通过C代码和汇编指令的对照分析,阐明了这些指令在并行计算中的关键作用,包括线程激活、状态切换和执行

weixin_55313207的博客 1363

Vue3项目实战:集成h265webjs打造高性能Web端H.265播放器

本文详细介绍了如何在Vue3项目中集成h265webjs库,构建高性能的Web端H.265播放器。通过封装播放器管理模块、利用Vue3组合式API优雅管理生命周期,并提供了从环境准备、核心集成到进阶优化的完整实战指南,有效解决了浏览器原生不支持H.265解码的难题,显著降低视频流带宽占用。

weixin_29016833的博客 364

通俗易懂理解知识图谱+大模型

▼中秋专场直播,预约保你有收获—1—知识图谱与大模型的特点和互补性知识图谱的独特性:知识组织:它由实体及其相互间的联系构成的三元组网络,有效地描绘了知识的框架。数据可信度:知识图谱所包含的信息普遍具有高度的准确性和信赖度。解释性:知识图谱的架构更贴合人类的认知方式,它为知识的解释和逻辑推理提供了途径。大模型的优势:语言理解力:这些模型能够深入理解庞大的文本资料,具备强大的上下文学习及跨领域...

musicml的博客 2649

如何使用事务码SMICM分析ABAP代码发起的HTTP请求的错误

当我用CL_HTTP_CLIENT往一个外网的url发请求时,遇到错误:ICM_HTTP_SSL_PEER_CERT_UNTRUSTED 错误是从这段ABAP代码里抛出来的: CALL METHOD lo_http_client->get_last_error IMPORTING code = lv_sysubrc message = ev_error_message. "BREAK-...

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 3209

本体模型

本体是概念化的明确的规范说明(Gruber提出的)。目前本体广泛应用于人工智能领域。 本体模型就是按照现实生活中的概念、概念间的关系、概念所具有的特征(即属性)以及概念的实例抽象出现实的模型。 ...

zhf的博客 3557

【五分钟论文笔记】Vision Banana:图像生成器成为通用视觉学习器

图像生成训练可以像 LLM 预训练一样,让模型学习强大且通用的视觉表示感知即生成——将视觉任务输出参数化为 RGB 图像,是一种优雅且强大的统一框架视觉理解能力可以在不牺牲生成能力的情况下获得——两者可以共存于同一个模型。

专注:太空算力、AI infra、异构调度、大模型成本工程 232

网工运维掌握OpenClaw这7大必备技能,自动化运维效率直接起飞

OpenClaw的核心就是它的技能系统。通过官方技能市场(clawhub.ai),你只需一条命令就能安装扩展,让AI代理变成你的“运维副手”。今天我就结合网工运维的真实痛点,精选7项最热门、最实用的OpenClaw技能(基于ClawHub下载量和实际测试),手把手教你安装、使用和进阶玩法。这些技能不是玩具,而是能直接提升运维效率10倍以上的生产力工具!安装后,你的OpenClaw代理就能自动处理Zabbix告警、总结syslog日志、更新Obsidian网络拓扑笔记、甚至通过n8n触发自动修复脚本。

网络技术联盟站 574

【大模型应用】收藏这篇就够了:工业标准文档知识图谱构建与本体感知KG-RAG框架

:工业标准文档知识图谱构建与本体感知KG-RAG框架 本文提出工业标准文档知识图谱构建与KG-RAG应用方案。通过层级与原子命题本体建模将文档结构化,构建实体与关系嵌入形成同义词词典精炼图谱,设计统一图结构,并开发本体感知KG-RAG框架,结合文档层级与全局图谱实现精准知识检索与推理,提升大模型问答效果。

2401_84494441的博客 766

SAP Fiori Elements 扩展实战:UI 层扩展、OData 服务扩展、CDS 视图增强及全流程案例

UI 层扩展主要关注在不修改标准生成界面的基础上,自定义用户界面元素和交互逻辑。典型需求包括:在现有 Fiori Elements 界面上添加新的字段(如表格列或表单项)、增加自定义按钮并绑定操作、以及通过控制器扩展加入事件处理等。无论在 RAP 还是传统 BOPF 架构下,前端 UI 扩展通常采用 SAPUI5 提供的**扩展点(Extension Points)和控制器扩展(Controller Extension)**机制来安全地插入自定义代码。下面分别说明两种后端架构下 UI 扩展的实现方式。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 902

什么是知识图谱和AI多模态推理,零基础入门到精通,收藏这篇就够了

大模型与知识图谱结合,构建企业智能知识管理平台,为解决上述难题提供了新的思路:大模型技术能够从海量数据中提取复杂信息,具备学习和推理能力,而知识图谱则通过图形结构,将知识进行有机整合,展示出实体之间的关系和语义信息。两个技术的结合,将实现更加便捷的知识管理、更加精准的智能问答、以及更加可靠的智能决策与分析。一、知识图谱推理知识图谱是一种结构化的知识库,它以图的形式表示和存储现实世界中的实体、概念及其相互关系。这些实体可以是具体的人、地点、事物,也可以是抽象的概念或思想。

2401_85375298的博客 3893

【人脸识别/轻量级模型】MobileFaceNet:适用于人脸识别的轻量级网络模型(文末附pytorch代码)

MobileFaceNet:用于人脸识别的轻量级网络模型

Roaddd的博客 6988

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

一张图看懂本体与知识图谱的关系(超详细)从零基础到实战精通,收藏这一篇就够了!

知识建模分为数据层和模式层。数据层以图数据库存储事实,通过知识提取生成实体关系,经知识融合去除冗余;模式层借助本体规范概念关系,通过知识推理发现新关联,本体建模明确定义概念联系。数据层实现知识图谱,模式层实现本体建模,共同构建完整知识体系。知识建模在逻辑架构上分为两个层次:数据层和模式层。数据层是以事实为存储单位的图数据库,其事实的基础表达方式是「实体-关系-实体」或者「实体-属性-属性值」。数据层进行知识提取和知识融合。知识提取是基于已有数据生成「实体-关系-实体」;

m0_70486148的博客 2240

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

【2025版】知识图谱增强的RAG(KG-RAG)详细解析,从零基础到精通,精通收藏这篇就够了!

KG-RAG 表示基于知识图谱的RAG(Retrieval Augmented Generation)检索增强.

Python_0011的博客 1745

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

什么是知识图谱(超详细),从入门到精通,收藏这一篇就够了!

2012年5月,Google正式提出了知识图谱(Knowledge Graph)的概念。目的是为了优化搜索引擎返回的结果,增强用户的搜索质量及体验。

xx_nm98的博客 1527

基于大模型的知识图谱构建,非常详细收藏我这一篇就够了!

EDC框架通过三阶段协同工作实现知识图谱的高效构建。开放信息抽取阶段,利用LLM的语义理解能力,从自由文本中提取初步的三元组。这一过程不依赖预定义模式,允许模型自由识别多样化的关系表达(如“出生日期”可能被表述为“BornOn”“出生时间”),并通过示例引导模型捕捉显式或隐含的关联,例如从“1959年被NASA选中”中抽取出“selectedByNASA”关系。输出结果保留了原始语义的丰富性,但也引入了冗余性,例如同一概念可能对应多个近义词。模式定义。

2401_85375151的博客 6704

收藏级干货!ACL2025清华Tree-KG:AI知识图谱构建的终极指南,一篇就够了!

在人工智能的研究与应用中,**知识图谱(Knowledge Graph, KG)**已成为不可或缺的基石。无论是搜索引擎、智能问答,还是学术研究、教育应用,知识图谱都能帮助我们把碎片化的信息组织成结构化的知识网络。

m0_59164520的博客 1918

清华团队创新发布Tree-KG:30分钟快速构建教科书知识图谱,非常详细收藏我这一篇就够了!

清华大学团队在ACL会议上提出的Tree-KG框架创新性地结合教材层次化结构与大语言模型能力,显著提升了知识图谱构建效率。该方案采用"显式KG+隐式KG"的双层架构,通过五大核心操作符实现知识迭代扩展。实验数据显示,Tree-KG在F1分数上比第二名高出12-16%,同时token使用量降低40%,在知识密集型领域展现出显著优势。该框架为科研、医疗等专业领域的知识图谱构建提供了高效解决方案。

2401_84204207的博客 2011

告别传统 RAG,迎接 GraphRAG:知识图谱+本体=更强 AI大模型入门到精通,收藏这篇就足够了!

现代 AI 聊天机器人常常依赖 Retrieval-Augmented Generation (RAG),也就是检索增强生成技术。

瓦罗兰特顶级C位的博客 1160

知识图谱教程:从零基础入门到精通,收藏这篇就够了!

知识图谱是基于图结构的语义网络,通过"实体-关系-实体"三元组构建知识体系。核心要素包括实体、关系和属性,技术流程涵盖知识抽取、融合、推理和可视化。相比传统数据库,知识图谱支持深度语义网络和多跳推理,在搜索引擎、医疗健康、金融风控等领域应用广泛,信息检索效率显著提升,是机器理解现实世界的重要技术。知识图谱是一种基于图结构的语义网络,通过“实体-关系-实体”三元组构建现实世界的关联知识体系,实现机器对复杂信息的理解、推理与智能应用。

h1453586413的博客 1267

一文搞懂大模型 Agent,零基础入门到精通,收藏这篇就够了

大模型 Agent 是基于 LLM 构建的智能体自主性:无需人工干预即可完成复杂任务(如自动生成财报分析报告)目标导向:通过任务分解和动态规划实现预设目标(如制定旅行计划)工具协同:可调用 API、数据库等外部资源扩展能力边界(如查询实时天气)初代阶段(2023 前):基于规则的简单问答系统过渡阶段(2023-2024):LLM + 单一场景工具集成(如 ChatGPT 插件)智能阶段(2024 后):多工具协同 + 自主决策(如 Auto-GPT)

Javachichi的博客 1419

RAG技术的三种范式之图谱RAG(KG-RAG):如何用、何时用?(非常详细)从零基础到精通,收藏这篇就够了!

在特定领域任务中,KG-RAG能够显著增强开源LLM(如Llama2-7B)的表现,使其在某些场景下甚至可以与商业LLM相媲美。在开放域问答中,KG-RAG的提升效果相对有限。这可能是因为开放域任务需要更广泛的知识覆盖,而当前的KG-RAG方法在知识广度上仍有不足。

Libra1313的博客 1549
上一篇: 程序员编程如何入门、进阶?零基础入门到精通,收藏这一篇就够了
下一篇: 你应该知道的 10 大常见黑客技术,零基础入门到精通,收藏这一篇就够了
网络安全大白
博客等级 码龄5年 7305粉丝 698原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

