【2025版】知识图谱增强的RAG(KG-RAG)详细解析,从零基础到精通,精通收藏这篇就够了!

【RAG系列】KG-RAG 用最简单的方式将知识图谱引入RAG 介绍如何用最简单的方法将知识图谱加入到RAG的原因、挑战和具体方法,详细实现可见源码。 阅读详情

KG-RAG 表示基于知识图谱的RAG(Retrieval Augmented Generation)检索增强.


先看一下KG-RAG的视频

这是一个与任务无关的框架,它将知识图谱(KG)的显性知识与大型语言模型(LLM)的隐含知识结合起来。这是该工作的arXiv预印本 https://arxiv.org/abs/2311.17330 。

我们在这里利用一个名为SPOKE(https://spoke.ucsf.edu/)的大规模生物医学知识图谱作为生物医学背景的提供者。SPOKE已经整合了来自不同领域的40多个生物医学知识库,每个知识库都专注于生物医学概念,如基因、蛋白质、药物、化合物、疾病及其相关连接。

SPOKE由21种不同类型的超过2700万个节点和55种类型的5300万条边组成(https://doi.org/10.1093/bioinformatics/btad080)。

KG-RAG的主要特点是从SPOKE KG中提取“提示感知上下文”,其定义为:足以回答用户提示的最小上下文。
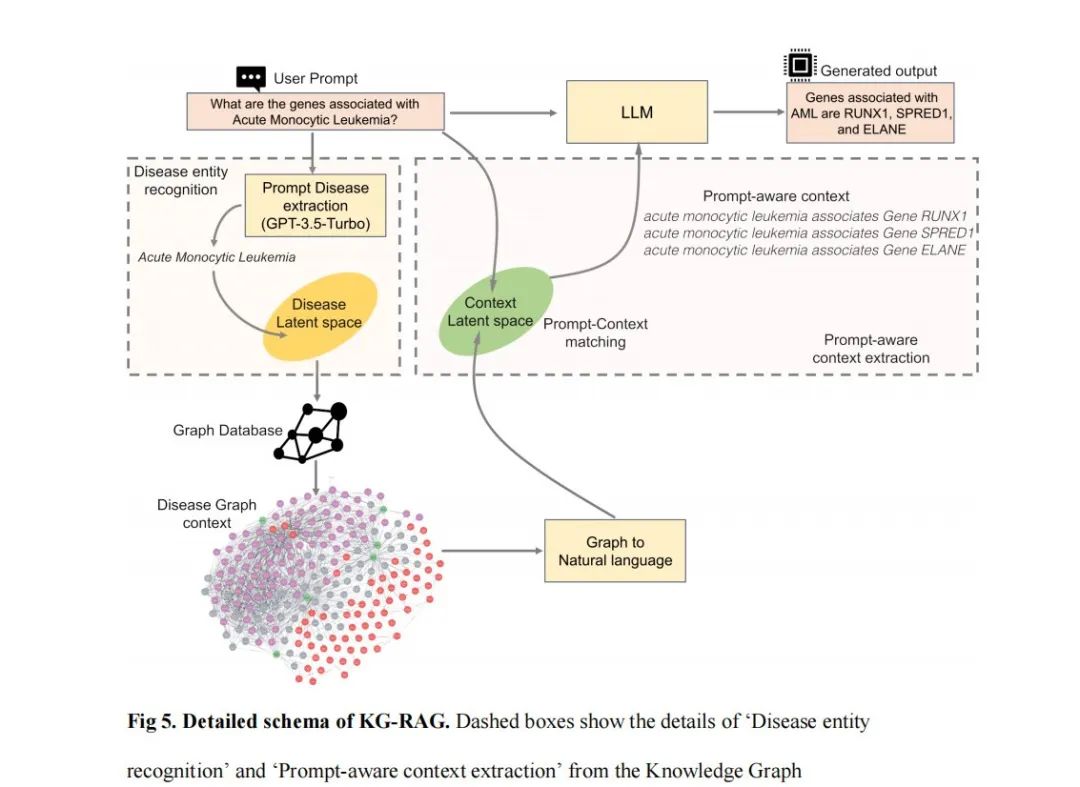
因此,这个框架通过从生物医学KG中获得的优化领域特定的“提示感知上下文”,赋予了一个通用型的LLM更强大的功能。

KG-RAG用户案例

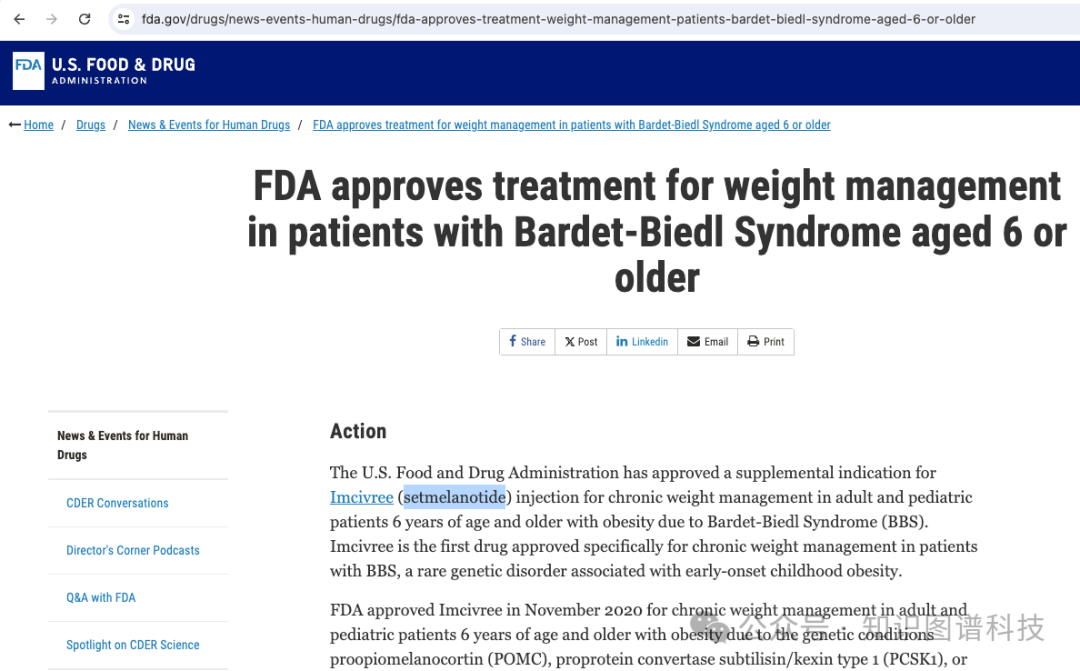
下面的片段显示了FDA网站上关于由

FDA(https://www.fda.gov/drugs/news-events-human-drugs/fda-approves-treatment-weight-management-patients-bardet-biedl-syndrome-aged-6-or-older)批准用于巴代特-畢迪二氏综合征患者的减重药物“setmelanotide”的信息。
询问 GPT-4 关于上述药物:

没有KG-RAG

注意:此示例是使用KG-RAG v0.3.0运行的。我们是通过终端来启动GPT,而不是通过chatGPT浏览器。分析中的温度参数设置为0。参考此yaml文件进行参数设置,包括KG-RAG。

有KG-RAG

注意:此示例是使用KG-RAG v0.3.0运行的。分析过程中,温度参数设置为0。有关参数设置,请参阅此yaml文件。

你可以看到,KG-RAG能够提供关于FDA批准药物的正确信息。

如何运行KG-RAG

注意:目前,KG-RAG专门为与疾病相关的提示运行而设计。我们正在积极努力改进其多功能性。

Step 1: 克隆repo

克隆此存储库。所有论文中使用的生物医学数据已上传到此存储库,因此您无需单独下载。

Step 2: 创建一个虚拟环境

注意:本存储库中的脚本是在Python 3.10.9版本下运行的。

conda create -n kg_rag python=3.10.9  
conda activate kg_rag  
cd KG_RAG

Step 3: 安装依赖项

pip install -r requirements.txt

Step 4: 更新config.yaml

config.yaml保存了运行您机器上的脚本所需的所有必要信息。请确保相应地填充此yaml文件。

注意:还有另一个名为system_prompts.yaml的yaml文件。它已经填充好,并保存了KG-RAG框架中使用的所有系统提示。

Step 5: 运行设置脚本

注意:确保您位于KG_RAG文件夹中

设置脚本以交互方式运行。

运行设置脚本将:

1.为KG-RAG创建疾病向量数据库

2.在您的机器上下载Llama模型(可选,您可以跳过此步骤,完全没有问题)

python -m kg_rag.run_setup

Step 6: 从重点运行KG-RAG

注意:确保你处于KG_RAG文件夹中

你可以使用GPT和Llama模型来运行KG-RAG。

用GPT
python -m kg_rag.rag_based_generation.GPT.text_generation -g <your favorite gpt model - "gpt-4" or "gpt-35-turbo">

示例:注意:以下示例在AWS p3.8xlarge EC2实例上运行,并使用KG-RAG v0.3.0。

用GPT的交互模式

这使用户可以以交互式方式逐步完成整个过程。
python -m kg\_rag.rag\_based\_generation.GP`T.text_generation -i True -g <your favorite gpt model - "gpt-4" or "gpt-35-turbo">`
用Llama
注意:如果您在安装设置步骤时没有下载Llama,那么当您运行下面的命令时,可能需要一些时间,因为它首先会下载模型。
python -m kg_rag.rag_based_generation.Llama.text_generation -m <method-1 or method2, if nothing is mentioned it will take 'method-1'>

示例

注意:以下示例是在AWS p3.8xlarge EC2实例上运行,并使用KG-RAG v0.3.0。

用Llama交互模式

这样做可以让用户以互动方式逐步完成整个过程。
python -m kg_rag.rag_based_generation.Llama.text_generation -i True -m <method-1 or method2, if nothing is mentioned it will take 'method-1'>  

引用

@article{soman2023biomedical,  
  title={Biomedical knowledge graph-enhanced prompt generation for large language models},  
  author={Soman, Karthik and Rose, Peter W and Morris, John H and Akbas, Rabia E and Smith, Brett and Peetoom, Braian and Villouta-Reyes, Catalina and Cerono, Gabriel and Shi, Yongmei and Rizk-Jackson, Angela and others},  
  journal={arXiv preprint arXiv:2311.17330},  
  year={2023}  
}

SPOKE KG可以通过以下链接访问:

https://spoke.rbvi.ucsf.edu/neighborhood.html。也可以使用REST-API访问

(https://spoke.rbvi.ucsf.edu/swagger/)。

KG-RAG代码可在

https://github.com/BaranziniLab/KG_RAG 下载。本研究中使用的生物医学数据集(一跳问题、两跳问题、真假问题、多选题问题、药物重新定位问题、SPOKE KG中的疾病上下文)可供研究界使用,位于同一GitHub存储库中。

原文 - [2311.17330] Biomedical knowledge graph-enhanced prompt generation for large language models (arxiv.org)

欢迎点赞关注

----------------------------
## AI大模型学习福利

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

四、AI大模型商业化落地方案

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

KG-RAG: 知识图谱增强的检索增强生成技术 在一个具体的测试中,研究人员比较了使用和不使用KG-RAG的GPT-4在回答关于FDA批准药物的问题时的表现。结果显示,使用KG-RAG的GPT-4能够提供更加准确和详细的信息,而没有使用KG-RAG的GPT-4则可能给出不完整或过时的答案。通过将结构化知识与先进的语言理解能力相结合,KG-RAG正在推动AI系统向更智能、更可靠的方向发展,为未来的人工智能应用开辟了新的可能性。: 通过结合知识图谱的结构化信息,KG-RAG能够显著减少LLM的幻觉问题,提供更加准确和可靠的回答。 阅读详情

相关推荐

【论文精读(KG²RAG)】南京大学&阿里巴巴:Knowledge Graph-Guided Retrieval Augmented Generation (KG²RAG)

大语言模型(LLM)在生成任务中常因知识缺失或过时产生幻觉,传统检索增强生成(RAG)虽能补充知识,但仅依赖语义相似性导致检索结果冗余且缺乏关联。本文提出 KG²RAG(Knowledge Graph-Guided Retrieval Augmented Generation)框架,通过知识图谱(KG)显式建模文本块间的事实级关系,提升检索结果的多样性与连贯性。实验表明,KG²RAG 在 HotpotQA 等数据集上显著优于传统 RAG 方法,为可信 AI 推理提供了新路径。

2301_79985417的博客 3730

LLMs之KG-RAG:KG-RAG/GraphRAG(基于知识图谱的RAG系统)的简介(可以解决多跳问题/同时支持结构化和非结构化数据查询)、经验技巧、案例应用之详细攻略

​ LLMs之KG-RAG:KG-RAG/GraphRAG(基于知识图谱的RAG系统)的简介(可以解决多跳问题/同时支持结构化和非结构化数据查询)、经验技巧、案例应用之详细攻略 目录 KG-RAG的简介 KG-RAG的相关工具或框架 KG-RAG的案例应用 KG-RAG的简介 检索增强生成(RAG)应用在集成来自外部来源的数据到LLMs中,回答简单问题方面表现出色。但是,它们在回答涉及将相关信息连接起来的多部分问题时往

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 4760

探索检索增强生成(RAG)技术的无限可能:Vector+KG RAG、Self-RAG、多向量检索器多模态RAG集成

探索检索增强生成(RAG)技术的无限可能:Vector+KG RAG、Self-RAG、多向量检索器多模态RAG集成

丨汀、的博客 5391

本地部署大模型?看这篇就够了,Ollama 部署和实战

如果要使用的模型不在 Ollama 模型库怎么办?至此,我们一起走完了 Ollama 的部署和实战流程。在我看来,Ollama 也许是目前最便捷的大模型部署和使用工具,对小白非常友好。简单的命令行操作,用户即可快速启动和管理模型,极大降低了技术门槛,用户可以专注于模型的应用,而无需关注底层技术细节。此外,Ollama 的离线运行也为数据安全提供了保障。期待大家在使用 Ollama 的过程中,发现更多有趣的 AI 应用场景。让我们一起推动大模型技术的应用落地,探索更广阔的可能性!

2401_85373898的博客 2717

KG-RAG 文献精读:面向问答的知识图谱增强型检索增强生成

论文对当前知识图谱问答领域的三个代表性 SOTA 方法进行了系统的梳理与对比。KAPING(Knowledge-Augmented Language Model PromptING)是由 Baek 等人于 2023 年提出的零样本 KGQA 方法。其核心思想是:从 KG 中检索与问题实体相关的候选三元组,将三元组语言化为文本,然后通过语义相似度筛选出与问题最相关的前KKK个三元组,与问题一起输入 LLM 生成答案。KAPING 的最大优势在于无需任何训练,因此具有极高的跨 KG 泛化能力。

nmdbbzcl的博客 469

经典点云配准算法:迭代最近点算法ICP(Iterative Closest Point)

迭代最近点算法,又名为 ICP(Iterative Closest Point)算法。 (1)ICP算法对初始值的依赖比较大,具体的配准过程中,如何选择初始值是一个问题,可以使用轮式里程计、imu预积分或其它先验的配准结果。 (2)ICP迭代次数过多,实际工程中需要考虑到其实时性的优化问题。 (3)迭代终止的阀值的设置也是需要考虑的点,可以考虑自适应阀值的方法。 (4)关于寻找最近点可以使用kdtree进行临近搜索。

qq_35102059的博客 1万+

先RAG后KG,还是先KG后RAG?我们试了三种策略

摘要:本文探讨了RAG(检索增强生成)与知识图谱(KG)在企业智能问答系统中的融合应用。针对当前系统存在的信息检索不准确和模型幻觉问题,提出了三种协同策略:先RAG后KG验证、先KG查询后RAG扩展,以及并行融合结果评判。文章详细解析了融合工作流、示例代码和防错机制(包括双向验证、时效性过滤、LLM仲裁和用户反馈闭环),并提供了企业股权问答系统的实战案例。最后强调RAG与KG应实现推理协同而非简单叠加,指出自动化图谱构建和智能联合推理是未来发展方向。(149字)

javatiange的博客 1026

大模型推理常见采样策略:Top-k, Top-p, Temperature, Beam Search

大模型推理采样策略,举例通俗易懂汇总介绍

qq_43243579的博客 2万+

一文讲清楚KG、RAG、KAG、GraphRAG...这些有什么区别?

一文讲清楚KG、RAG、KAG、GraphRAG...这些有什么区别?

weixin_59191169的博客 1673

VLM,VLA,VLN的区别与联系

VLM 提供了理解世界的“眼睛和大脑”,VLN 赋予了这个智能体在空间中“移动的双腿”,而 VLA 则进一步赋予了它“灵巧的双手”来改变世界。三者共同构成了一个完整具身智能体的核心能力模块。

l0409044222的博客 1309

国赛数学建模高教社杯历届优秀论文全集

包含了2004到2023年高教社的赛题及优秀论文。

BanDeng001的博客 3284

下一代知识图谱增强的检索增强生成(KG-RAG):掌握2025年图增强检索技术

检索增强生成(RAG)通过弥合预训练知识与实时、特定领域信息之间的差距,彻底改变了大型语言模型(LLM)领域。然而,早期依赖纯向量检索的RAG在处理复杂关系映射和多跳推理任务时存在固有局限性。传统向量检索将文本转换为稠密向量嵌入,并基于相似度指标检索相关信息,但难以捕捉实体间的显式语义关系——例如,区分“A是B的父母”和“A是B的同事”——且无法有效执行多步骤推理,如“锂离子电池发明者创办的公司名称是什么?在此背景下,知识图谱增强的检索增强生成(KG-RAG)应运而生,成为一种变革性解决方案。

wddxwdwl的博客 830

【同等学力】2025-数学✨

本文主要涵盖了谓词逻辑、集合论、图论和排列组合等多个数学领域的题目。在谓词逻辑部分,要求用全称量词和存在量词表达“没有两个人的指纹完全相同”。集合论部分涉及集合运算的证明,如证明(A-B)-C=(A-C)-(B-C)。图论部分包括计算给定10个点的联通图的边与面数。排列组合部分则要求计算从8个人中选6个并分为三组的不同方法。此外,还涉及偏序、长链、反链、二项式定理等相关内容,参考了多个优快云博客中的解题思路。

super_mochi1 676

【KG²RAG】结合知识图谱解决RAG 文本块孤立问题

知识图谱引导的检索增强生成

2301_76896984的博客 922

机器人动力学仿真软件:PyBullet_(10).案例分析:双足机器人行走仿真

在本节中,我们将详细探讨如何使用PyBullet进行双足机器人的行走仿真。双足机器人行走仿真是一个复杂的动力学问题,涉及多个关节的协调运动和环境交互。通过本节的学习,您将了解如何创建和控制双足机器人模型,设置仿真环境,以及实现基本的行走算法。首先,我们需要创建一个双足机器人模型。PyBullet支持多种模型格式,包括URDF(Unified Robot Description Format)和MJCF(MuJoCo XML Format)。URDF是一种广泛使用的机器人模型描述格式,我们将使用URDF来创建

kkchenjj的博客 908

Modbus协议介绍及解析

Modbus协议介绍及解析 1.Modbus简介 Modbus是一种广泛应用于工业控制领域串行通信协议,以其开放性、高可靠性、高效简单性、免费等优点,成为了工业领域通信协议的业界标准,是工业现场电子设备之间常用的连接方式。Modbus按其格式可分为Modbus-RTU,Modbus-ASCII,Modbus-TCP,其中前两者适用于串行通信控制网络中,例如RS485,RS232等,而Modbus-TCP主要应用于基于以太网TCP/IP通信的控制网络中。通过此协议,控制器相互之间、或控制器和其它设备之间进行通

逍遥子的博客 1万+

【2025版】当大模型遇见知识图谱 ,从零基础到精通,精通收藏这篇就够了!

我们知道,大型语言模型(LLMs)在固定的数据集上运行,其知识停止在最后一次训练更新时。ChatGPT的常规用户可能会认识到这个众所周知的限制:“训练数据截至2021年9月”。这种限制可能导致不准确或过时的回复,因为这些模型会“产生幻觉”信息。在不重新训练或微调的情况下更新它们以获得新信息或增强上下文理解可能是具有挑战性的,涉及资源和人力。

Python_0011的博客 1951

SPME/IP PPT详解

什么是中间件?它是操作系统与应用程序之间的一块代码,它对于应用程序提供了一些标准接口,屏蔽了应用程序与底层的一些交互,上层应用程序只要和中间件进行交互就可以了,这样就可以达到一个解耦的目的。SOMEIP其实是一个中间件,它是操作系统与应用程序之间的一段代码,它是可以运行在TCP/IP之上的,可以在很多平台上使用,可以适配较多的操作系统,可以提供很多接口。经过序列化之后,在网络上传输的是一些101010这样的二进制流。SOME/IP可以承接应用层的一些数据,进行打包放到传输层。

usstmiracle的博客 618

【万字长文】LLM+KG:大模型与知识图谱融合的黄金时代,技术前景与实现路径全解析!

文章深入探讨LLM与知识图谱融合技术,分析LLM在复杂推理中的幻觉与知识过时痛点,提出从"单向增强"到"双向协同"的技术演进路径。详细介绍了KG作为背景知识、推理指导、优化验证器等角色,以及在医疗、法律等垂直领域的应用价值,并展望了神经符号深度融合、效率优化与知识动态对齐等未来发展方向。

2401_85373396的博客 1661

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

M3KG-RAG:让多模态 RAG 真正“会推理”的关键一步

原创 MindChain.AI2026年1月5日 12:01新加坡📌 一句话总结:本工作提出 M3KG-RAG,一个基于多跳多模态知识图谱的检索增强生成框架,通过模态感知检索与精细化剪枝机制,显著提升多模态大模型在音频、视频与视听联合任务中的推理深度与答案可信度。🔍 背景问题:当前多模态 RAG 在音视频场景中仍面临两类核心瓶颈:1️⃣ 现有多模态知识图谱(MMKG)多为单跳、概念级结构,难以支撑时序性与因果性的深层推理;

Python_0011的博客 1789

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

【2025版】带你了解7种检索增强生成 (RAG) 技术,从零基础到精通,精通收藏这篇就够了!

回顾2024年RAG技术的发展,检索增强生成(Retrieval-Augmented Generation,RAG)技术彻底改变了人工智能模型的工作方式,它将生成式人工智能的优势与检索现实世界文档的精确性相结合。通过从外部来源提取相关数据,RAG使得人工智能能够生成更准确且上下文更合适的答案。

Javachichi的博客 2024

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

【2025版】RAG效果不好怎么办?试试以下RAG优化策略大幅提升问答效果(非常详细)从零基础入门到精通,收藏这篇就够了

自从2022年12月 ChatGPT 横空面世以来,AI 领域获得了十足的关注和资本,其实AI的概念在早些年也火过一波,本轮 AI 热潮相比于之前的 AI,最大的区别在于:生成式。通过海量文本训练的、能识别人类语言、执行语言类任务、拥有大量参数的模型,称之为大语言模型。GPT、LLaMA、Mistral、BERT等都是LLM,LLM是对训练文本信息的压缩,同时拥有了泛化能力,不同于数据库和搜索引擎,LLM能创造性地生成历史上没有出现过的文本内容。

leah126的博客 1039

AAAI 2025 论文精读:KG-LLaVA——用知识图谱增强医学影像解释生成

论文摘要: AAAI 2025论文《KG-LLaVA》提出了一种基于知识图谱检索增强生成(KG-RAG)的医学影像解释方法,旨在解决通用视觉语言模型(如LLaVA)在胸部X-ray病理解释任务中因缺乏专业医学知识导致的生成不严谨问题。该方法通过检索结构化医学知识图谱三元组(如“不透明影—提示—肺炎”),而非原始报告文本,增强模型生成解释的准确性与隐私安全性。实验表明,KG-LLaVA在MIMIC-NLE数据集上显著优于基线模型(AUC达83.0,CIDEr提升至62.2),验证了KG-RAG模块的普适性和有

GodGump的博客 415

【2025版】一文讲清RAG与本地知识库、向量数据库、知识图谱的联系与区别(非常详细)从零基础入门到精通,收藏这篇就够了

RAG是一种从外部检索数据的方式;本地知识库相当于一个资料库;而知识图谱是组织数据的一种更加科学的方式;向量数据库是用来存储向量化数据的一个载体。所以,本地知识库,向量数据库和知识图谱和RAG没什么直接关系,如果说有关系就是它们三者可以作为RAG技术的一种具体实现;但RAG也可以使用其它的实现方式。RAG,本地知识库,向量数据库,知识图谱是四个完全独立的技术,它们之间没有任何直接关系,但又可以互相合作以达到某种效果。

Libra1313的博客 1910

100 个 AI 领域常见概念解析 | KG、RAG、KAG、GraphRAG… 它们的差异究竟在哪?

这个系列的灵感来源于我偶然间看到的“歪门邪道”——大意是如何伪装成一个陌生领域的专家?可以先了解这个领域常见的100个概念,并厘清其中的关系、上下位概念、区别和联系,然后在合适的场合灵活运用,就能骗到和你一样不懂的人了()虽然是一句玩笑,不过后来又想到,传统的人文社科考试似乎真的是考名词解释和名词解释Plus…

kaka0722ww的博客 716

2025年度RAG清单,从零基础到精通,精通收藏这篇就够了!

作者遴选了2025年度典型的RAG系统和论文(含AI注解、来源、摘要信息),并于文末附上RAG综述和测试基准材料,希望阅读完本文可以帮助大家速通RAG。▍作者:范志东,蚂蚁图计算开源负责人、图计算布道师回顾2025,大模型日新月异,智能体百家争鸣。作为AI应用的重要组成部分,RAG也是“群雄逐鹿,诸侯并起”。年初ModularRAG持续升温、GraphRAG大放异彩,年中开源工具如火如荼、知识图谱再创新机,年末图表理解、多模态RAG又启新征程,简直“你方唱罢我登场”,奇技叠出,不胜枚举!

leah126的博客 1575
上一篇: 【2025版】最新全网最全网络基础思维导图,从零基础到精通,收藏这篇就够了!
下一篇: 【2025版】当大模型遇见知识图谱 ,从零基础到精通,精通收藏这篇就够了!
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

