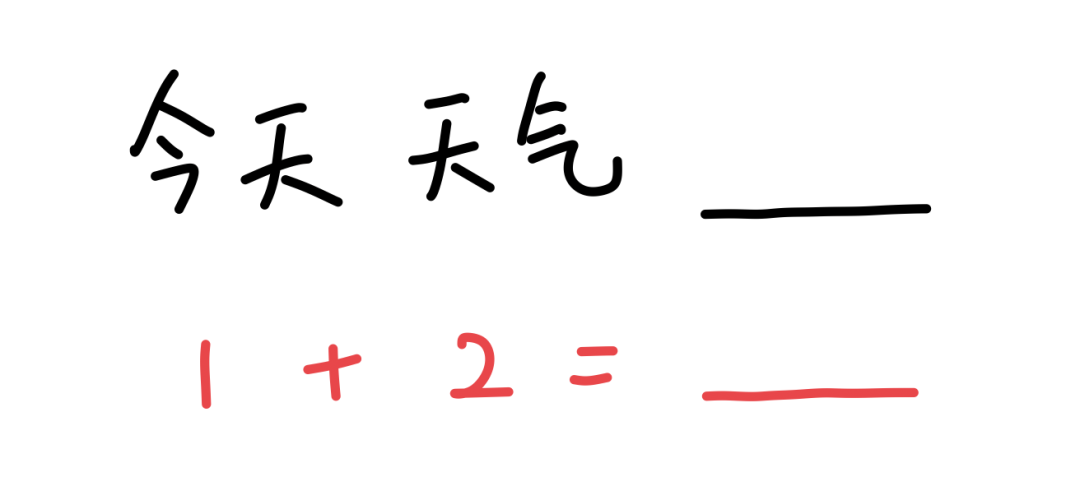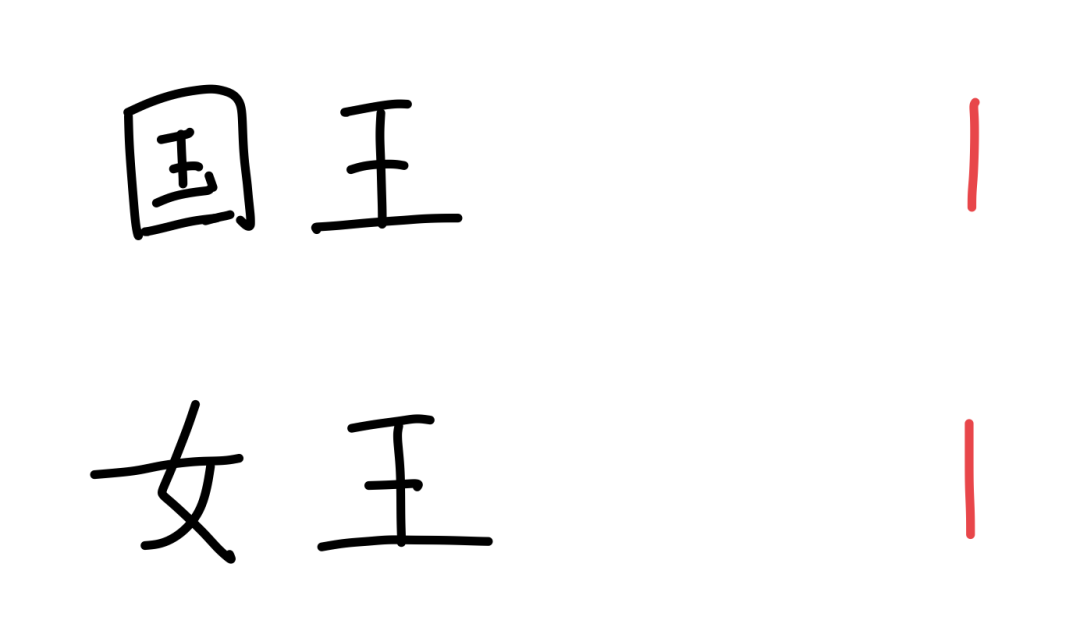通俗解释:大模型是怎么理解文字的?

Token验证绕过 靶场实战 实验介绍 1.漏洞简介 在Web领域基于Token的身份验证随处可见。在大多数使用Web API的互联网公司中,tokens 是多用户下处理认证的最佳方式。 具有以下几点特性: 1)无状态、可扩展 2)支持移动设备 3)跨程序调用 4)安全 2.原理基于Token的验证原理 基于Token的身份验证是无状态的,我们不将用户信息存在服务器或Session中。 NoSession意味着你的程序可以根据需要去增减机器,而不用去担心用户是... 阅读详情

真奇怪,你说这大模型到底是用什么办法理解人类文字的啊?

前几天我老婆这么问我。
img

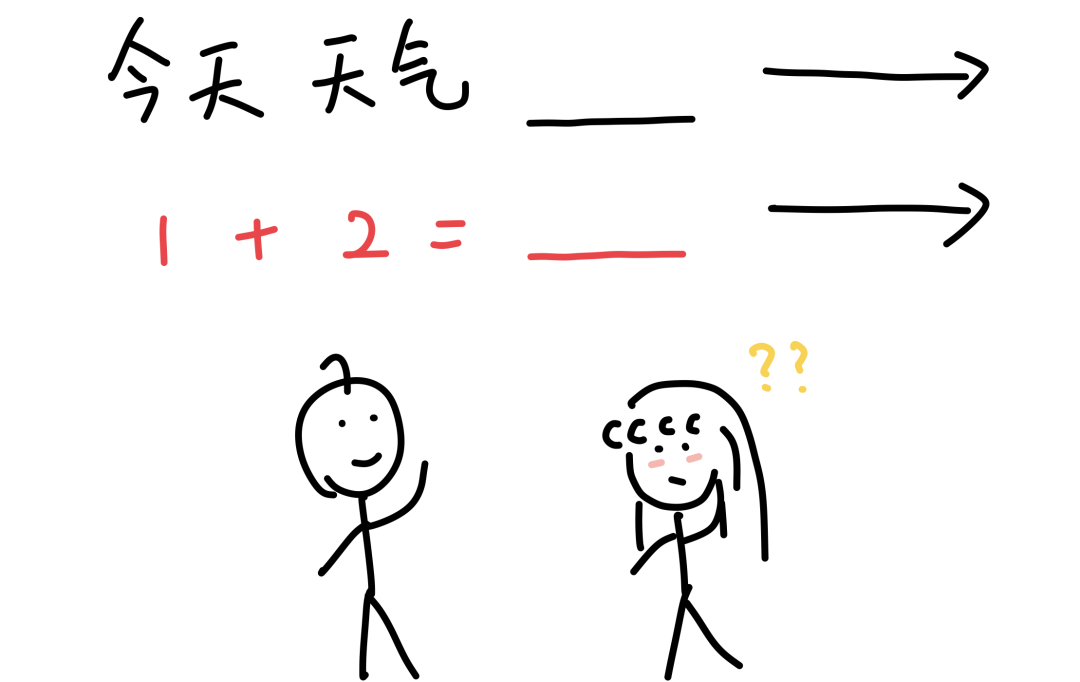
我告诉她,大模型会把每个词都用数字来表示。

img

这样预测下一个词,就变成了在做一道计算题。

img

只要不停地往后做计算题,它就可以不停地输出文字。

img

她听完好像更疑惑了的样子:可是一个词语的含义那么丰富,用数字是怎么能把这些丰富含义都表达出来的呢?
img

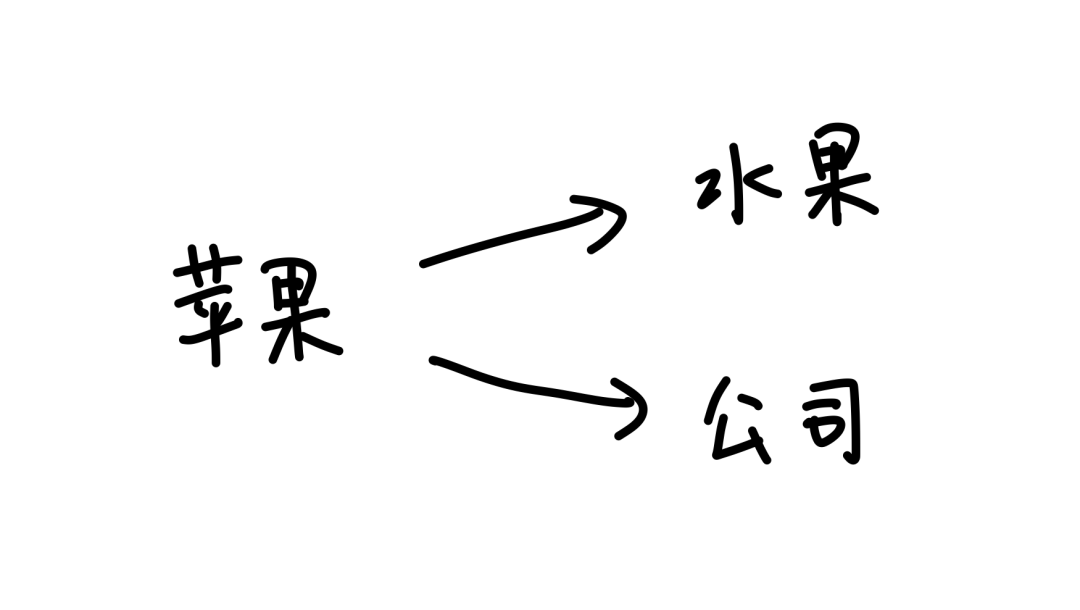
比如像「苹果」既可以是一种水果,又可以是一家公司,数字到底要怎么表达出复杂含义呢?
img

于是我决定换个方式给她通俗解释一下。

img

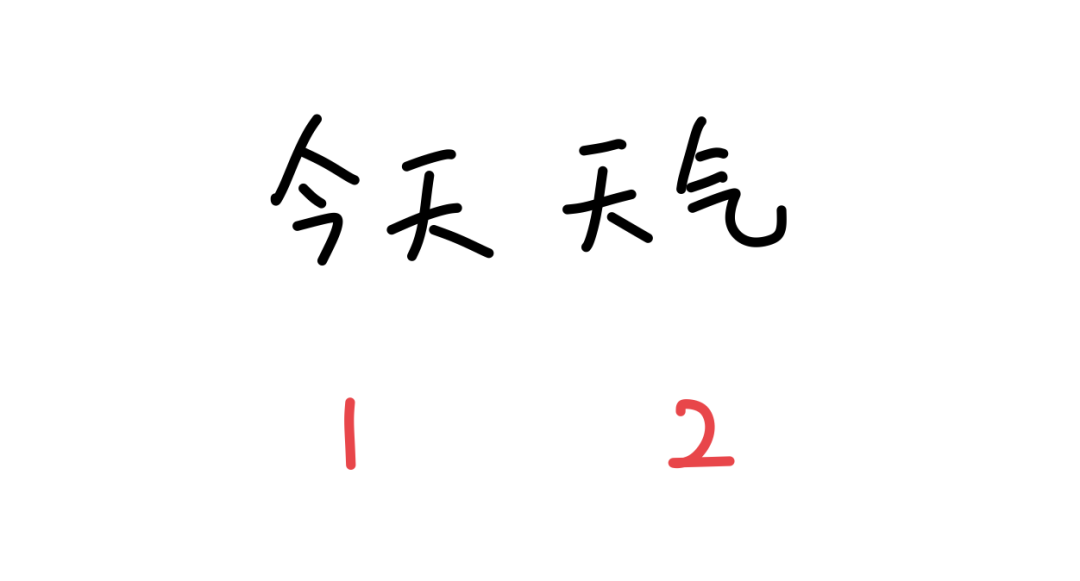
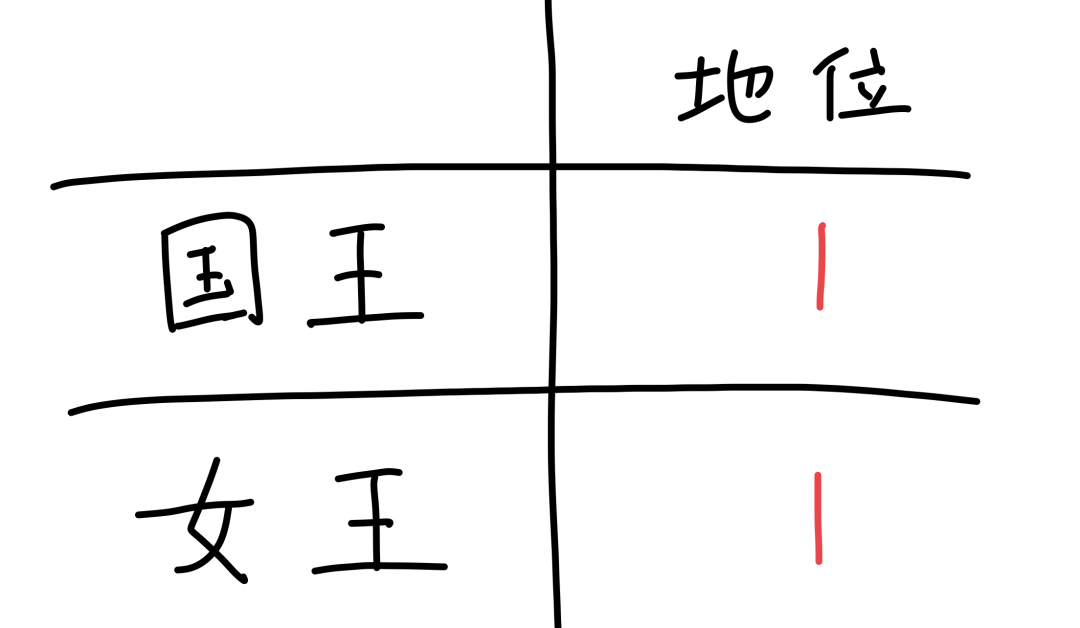
我们先假设**「国王」这个词用1表示,「女王」这个词也用1**表示。

img

是不是可以看作,这两个词在某一个维度上是相同的,比如「地位」当然也可能是别的维度。
img

而如果**「女王」这个词用2表示,就说明这两个词在某一个维度上是不同**的,这个维度可能是「性别」,也可以是别的。
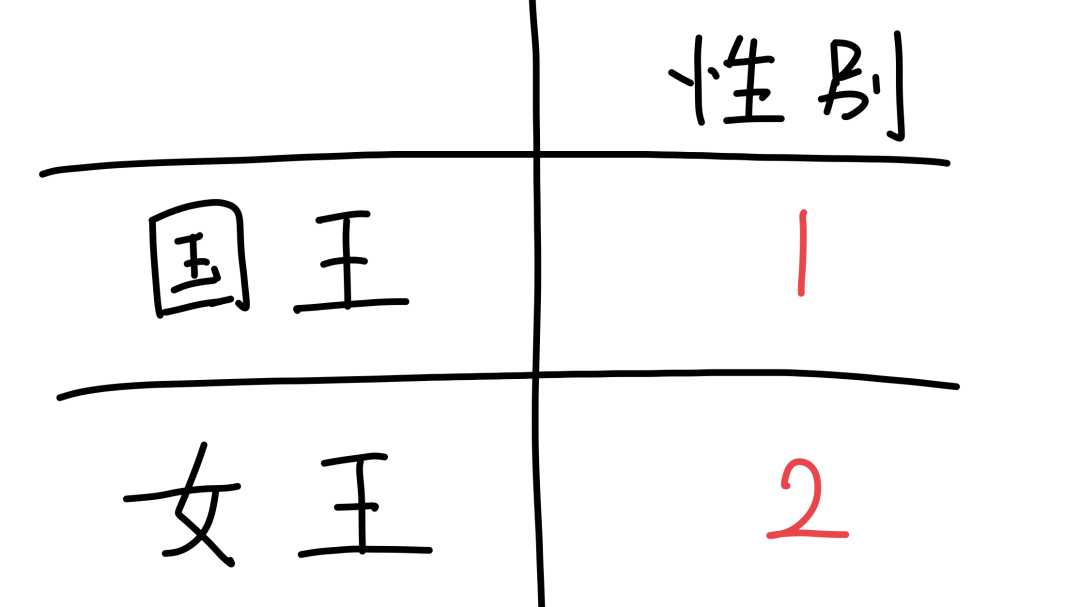
img

你看,用一个数字,就可以从一个维度上来描述两个词的区别。

现在我们开始用两个数字来表示每一个词。

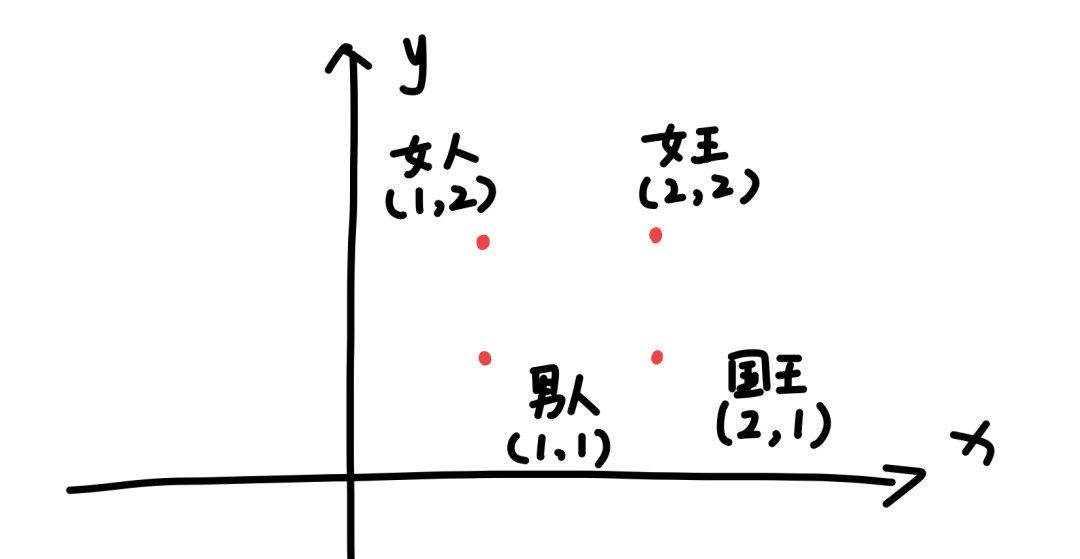
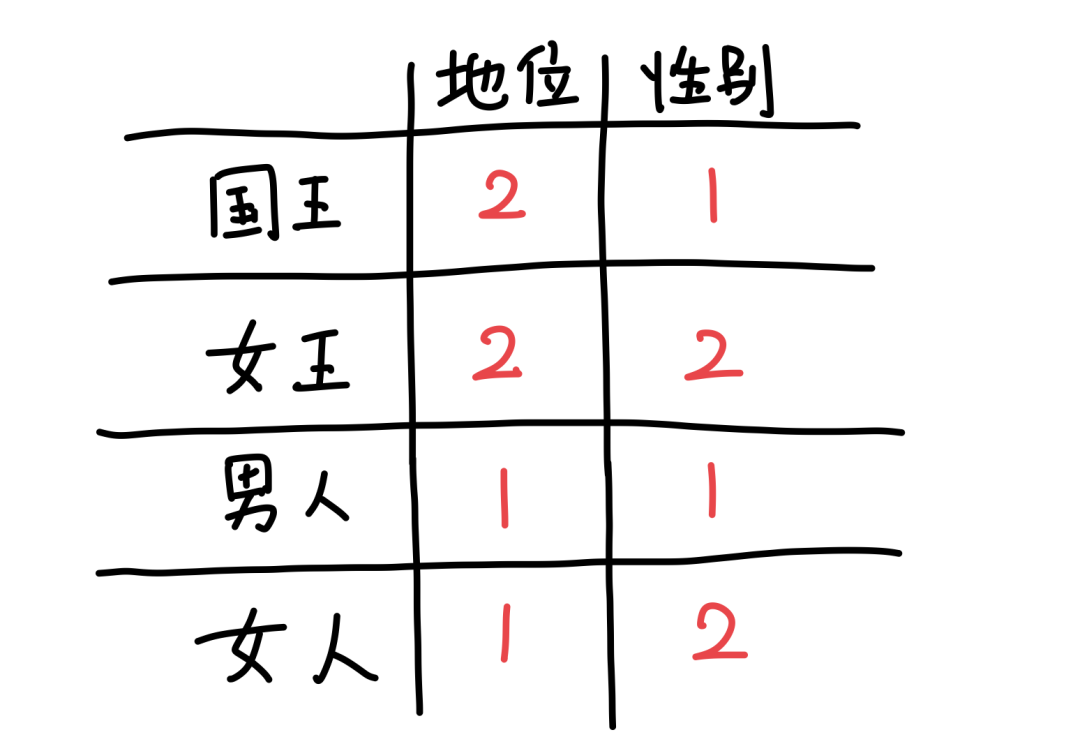
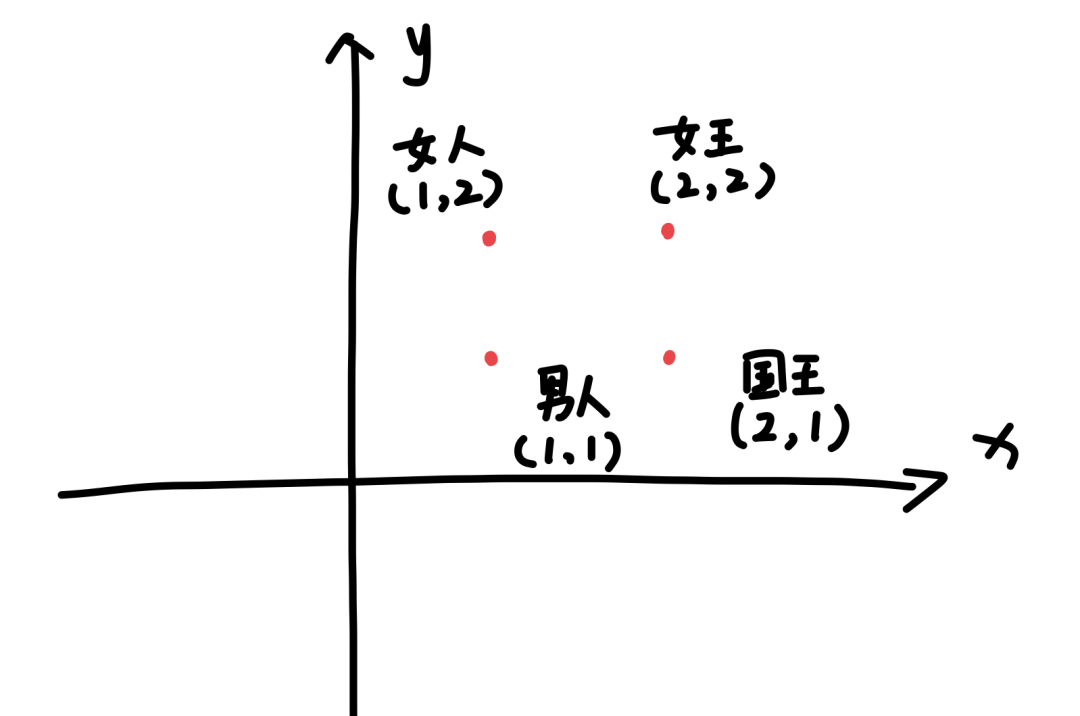
假设**「国王」是(2,1),「女王」是****(2,2)**。
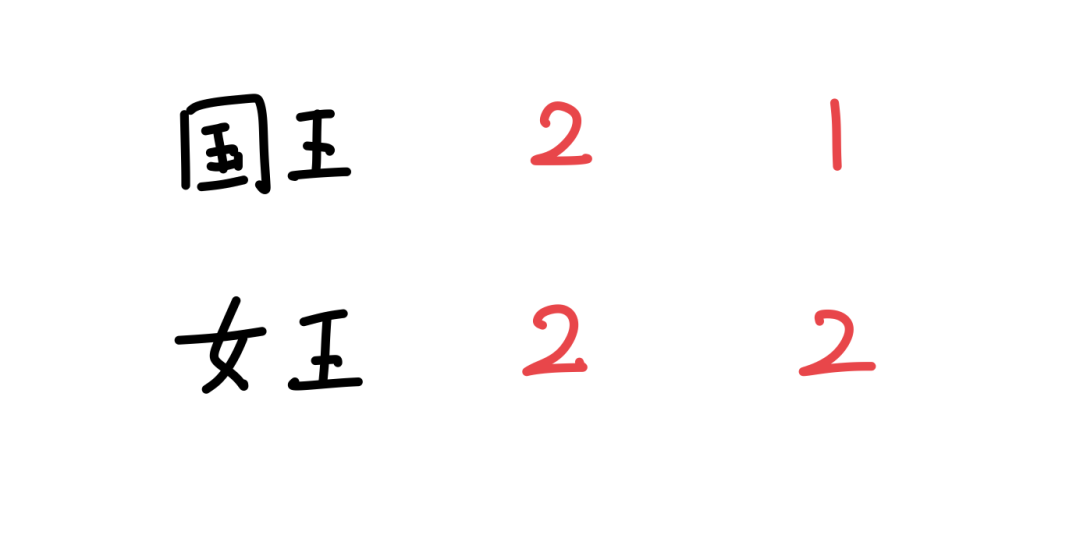
img

是不是可以看作,它们在某一个维度上(地位)是一样的,而在另一个维度上(性别)是不一样的。
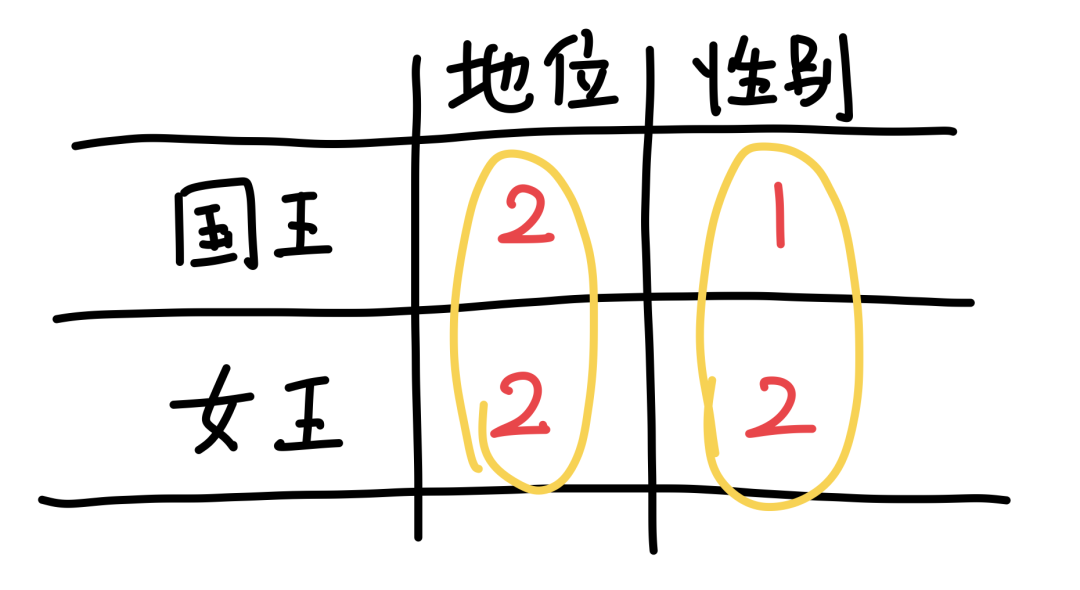
img

你看,我们用更多的数字来表示每一个词,就可以更细致地来描述它。

现在我们再加两个词。

**「男人」**这个词,在性别上和国王相同,都是1,但是地位和国王不同,记为1,所以男人是(1,1)。
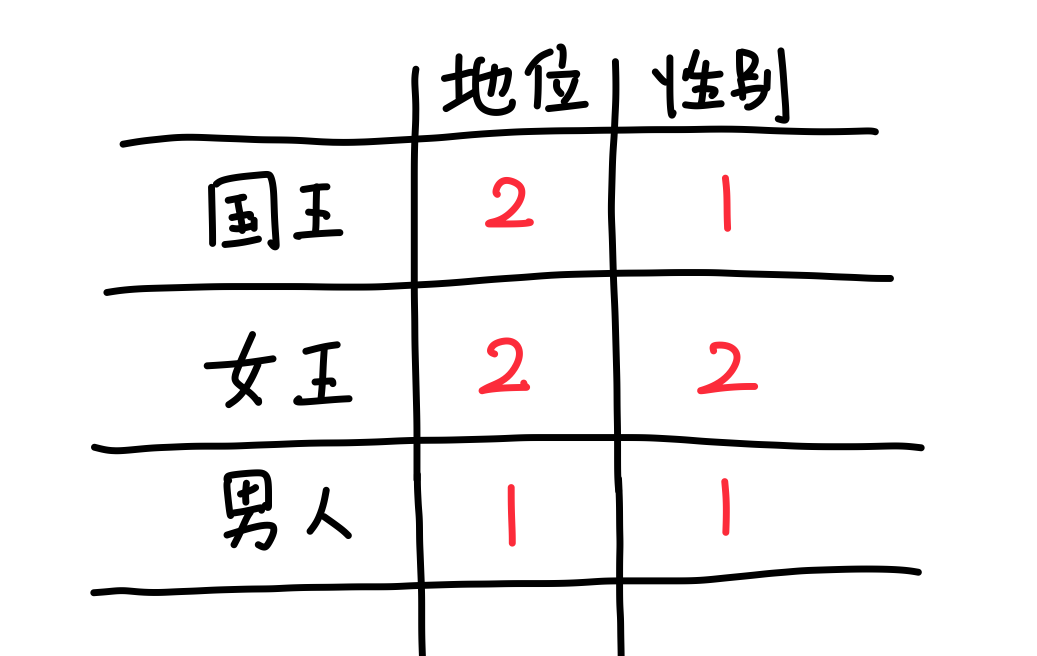
img

**「女人」**这个词和在性别上和女王相同(都是2),地位上和男人相同所以记为(1,2)。
img

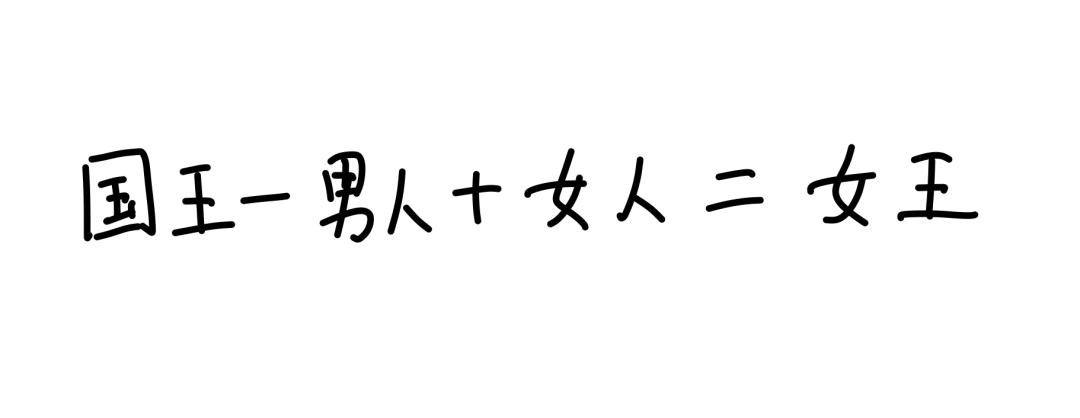
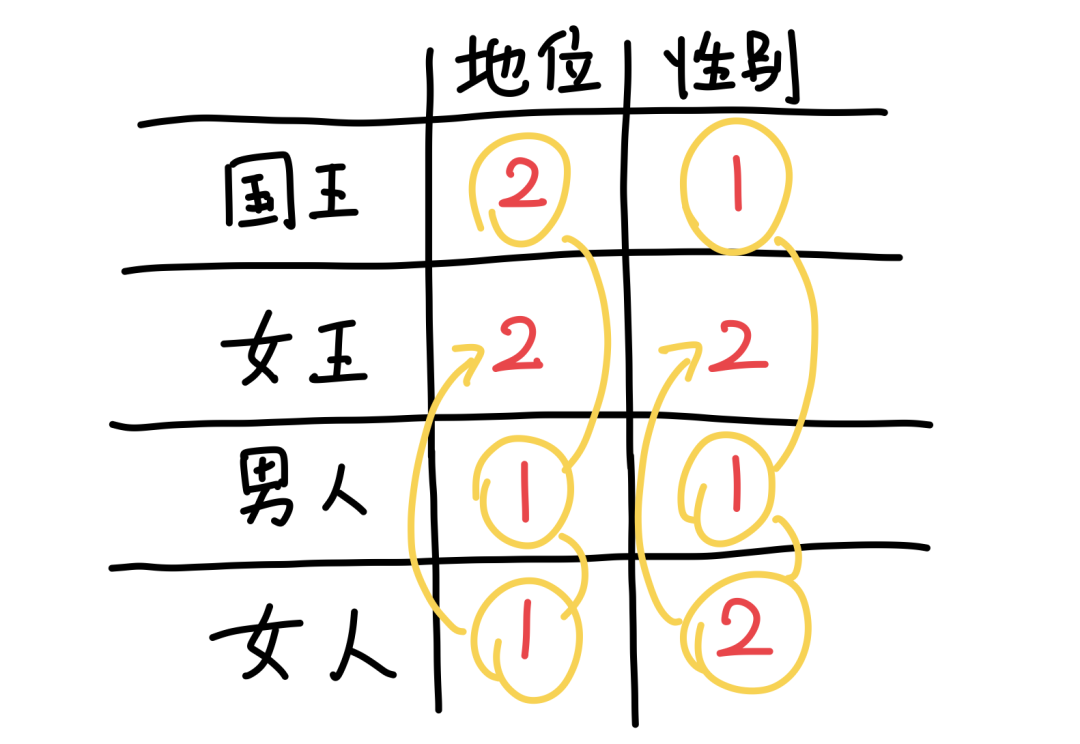
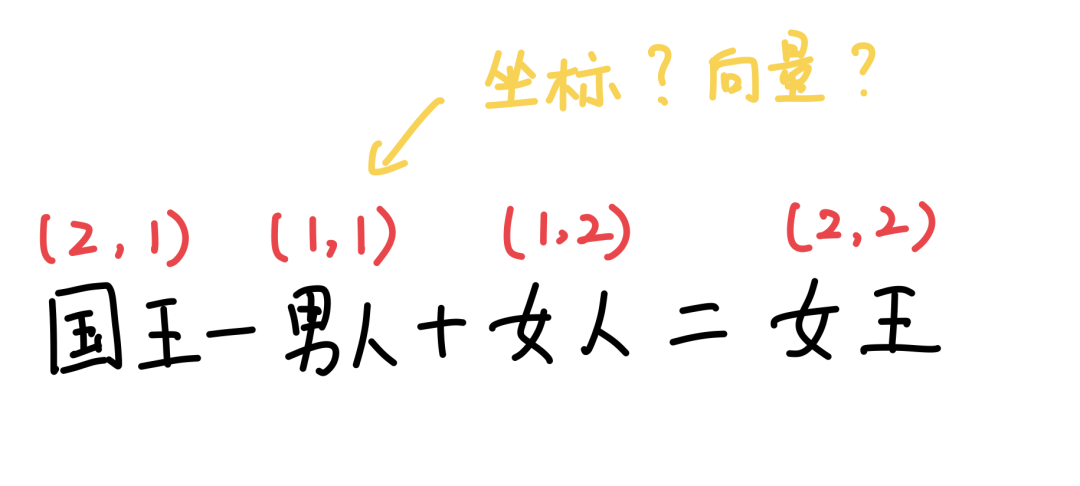
有趣的事情就发生了,你会发现:国王减去男人再加上女人,等于女王。

img

你看,在地位上,二减一再加一等于二。在性别上,一减一加二等于二,而二、二刚好就是女王。
img

我们仅仅用了两个数来表示每一个词,再配合简单的加减法,就模拟出了这四个词在两个维度上的区别和相互关系。

那如果更多的数来表示每一个词,比如三个、十个数、一百个数、一千个数,并且用更复杂的计算方法,不就可以从更多维度更细致地描述每一个词之间的关系?

实际上大模型就是这么干的。

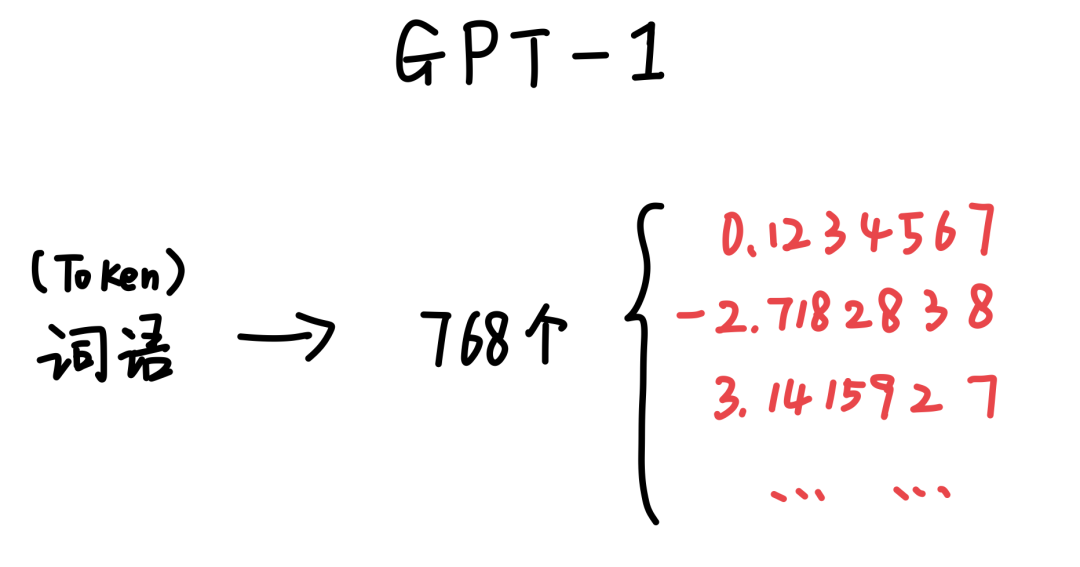
在GPT-1里,每一个词用768个精确到小数点后七位数的数字来表示。
img

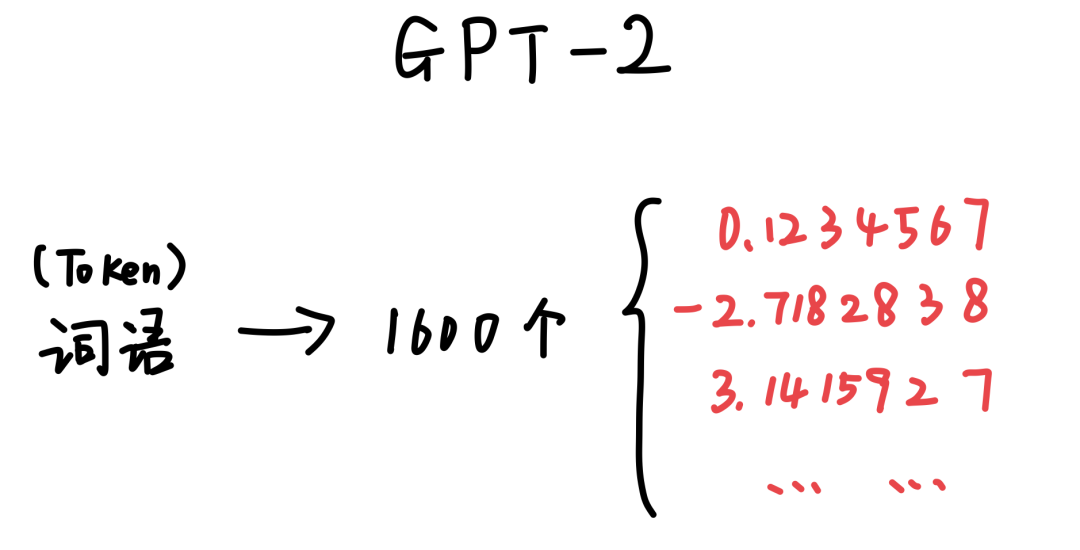
在GPT-2里,每一个词是用1600个数来表示。

img

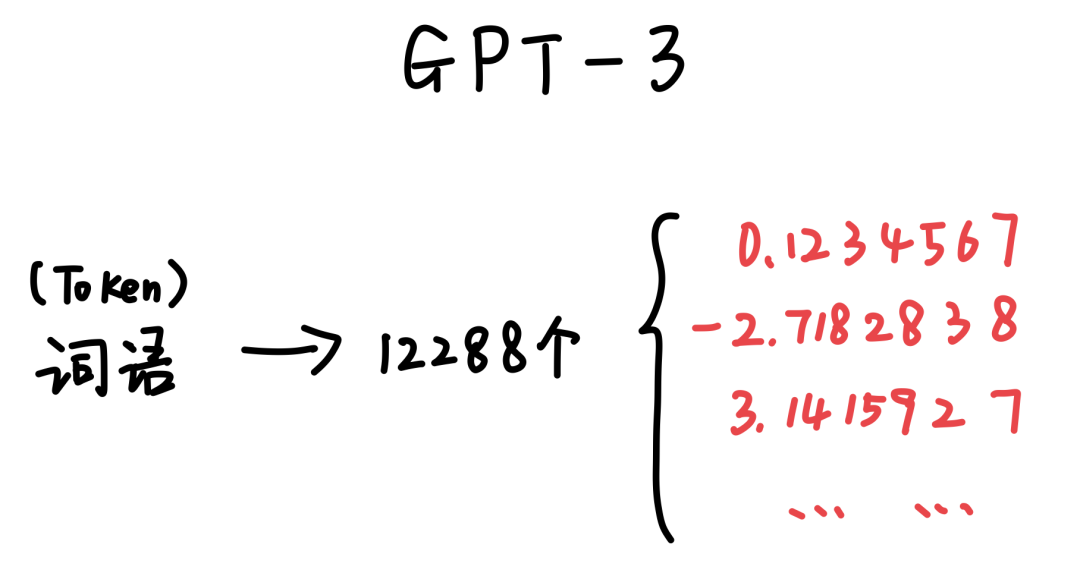
GPT-3,是用12288个数。

img

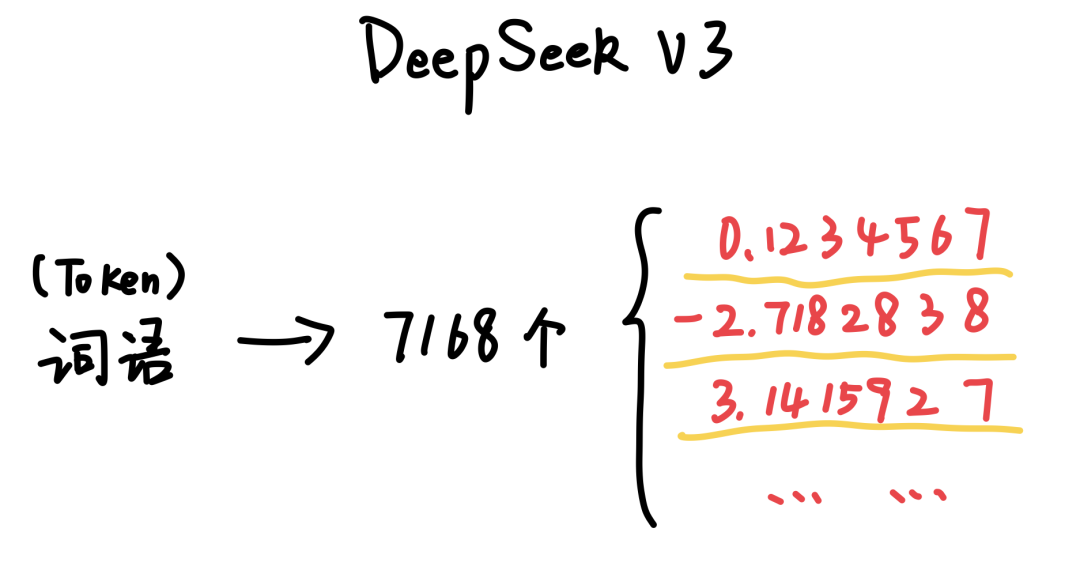
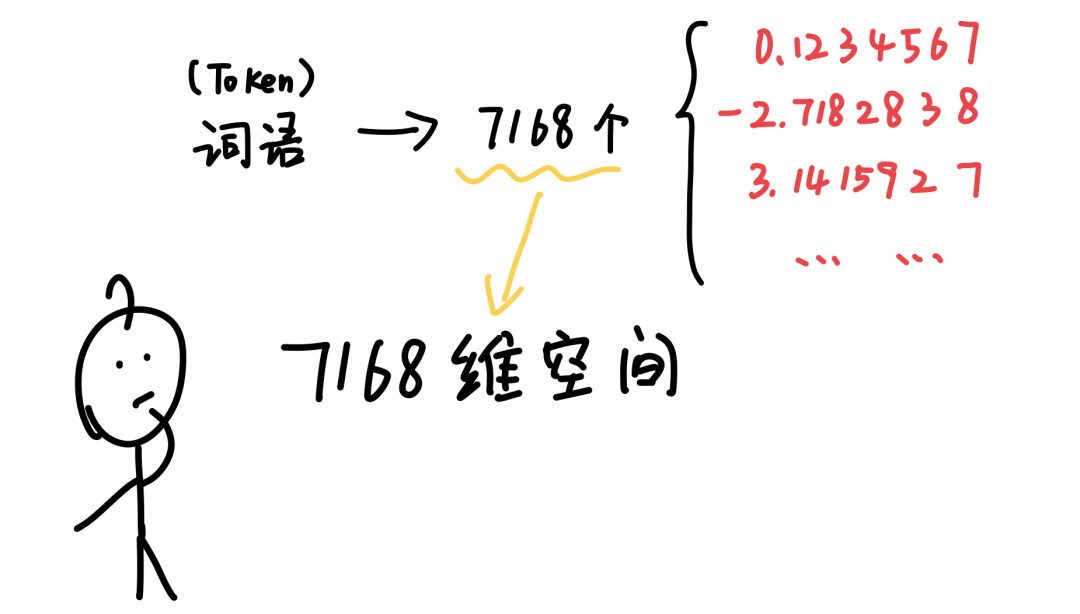
在DeepSeek 第二代模型里,用了21000个数来表示每一个词。DeepSeek-V3用7168个数来表示每一个词。
img

不过大模型不会告诉你,每一个数究竟代表什么意思,虽然肯定代表着某种含义或者属性。

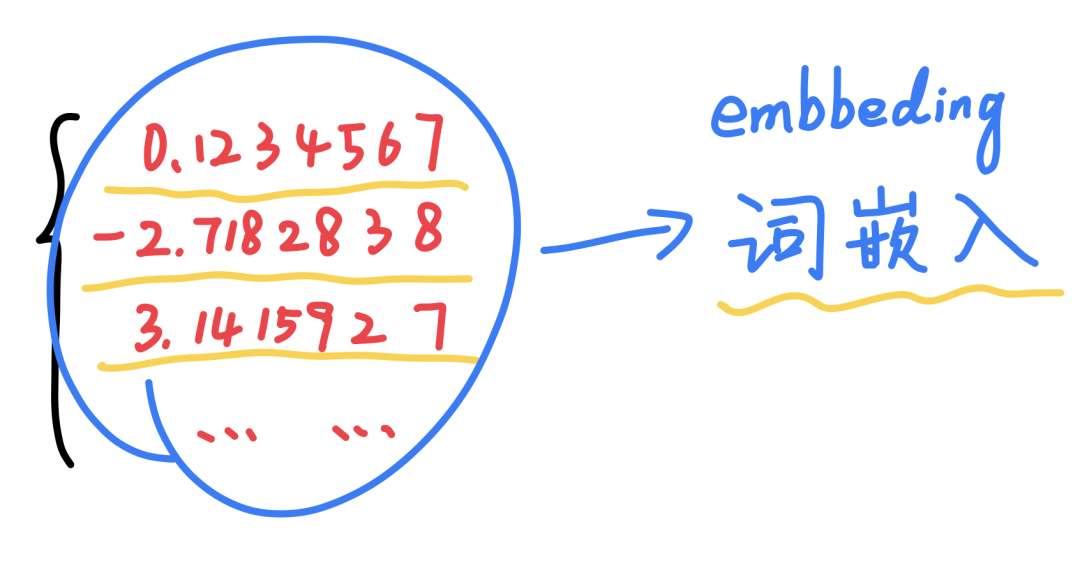
用来表示每一个词的这一堆数字,专业术语叫**「词嵌入」**,英文叫 embedding。
img

词嵌入,为什么要叫这么奇怪的名字呢?

其实词嵌入这个名字还挺形象。你看啊,刚才我们用两个数字来表示一个词,两个数字是不是可以看作是一个二维坐标?或者是二维向量。
img

那么用两个数字来表示一个词,是不是就相当于把这个词,嵌入到一个空间里。

img

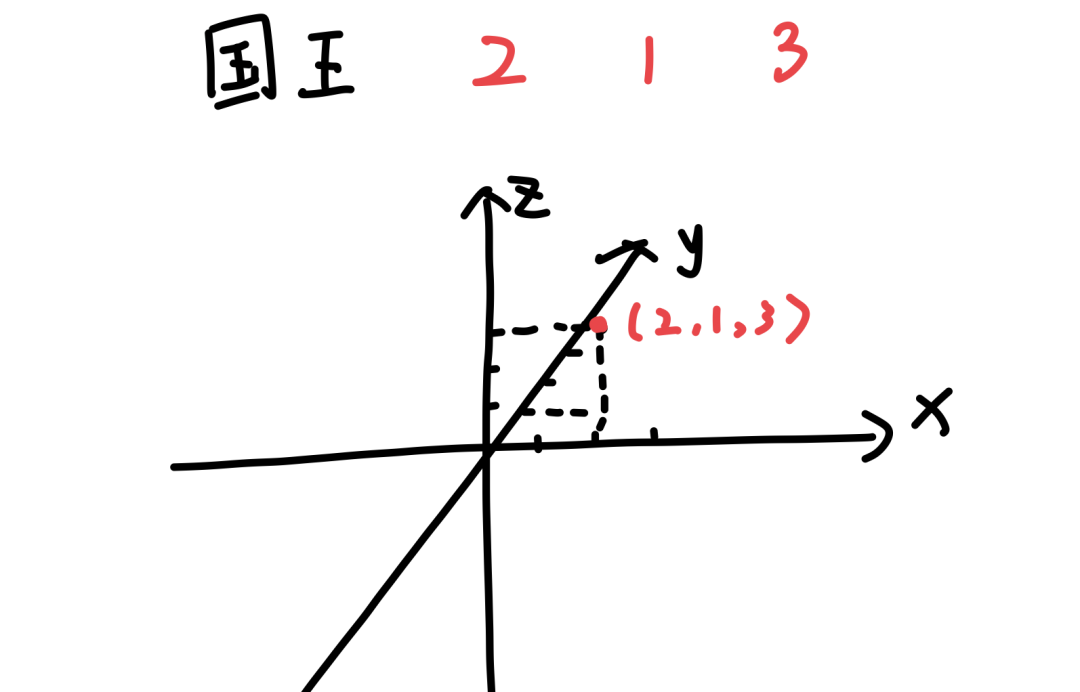
用三个数字来表示一个词,就相当于把词嵌入到一个三维空间里。

img

用7168个数来表示每个词,就相当于把这些词嵌入到一个7168维的空间里,虽然我画不出来,也想象不出来,但7168维的空间在数学上确实存在。
img

这就是为什么它叫词嵌入,因为真的是把词嵌入到数学空间里。

顺便说一下,词嵌入和Token ID是两个完全不同的东西。

Token ID是一个词在词库里的编号,而词嵌入是直接用一堆数来模拟这个数。

TokenID相当于图书馆里某本书的编号,而词嵌入相当于这本书的摘要。

那每一个词的词嵌入的值是怎么定出来的呢?

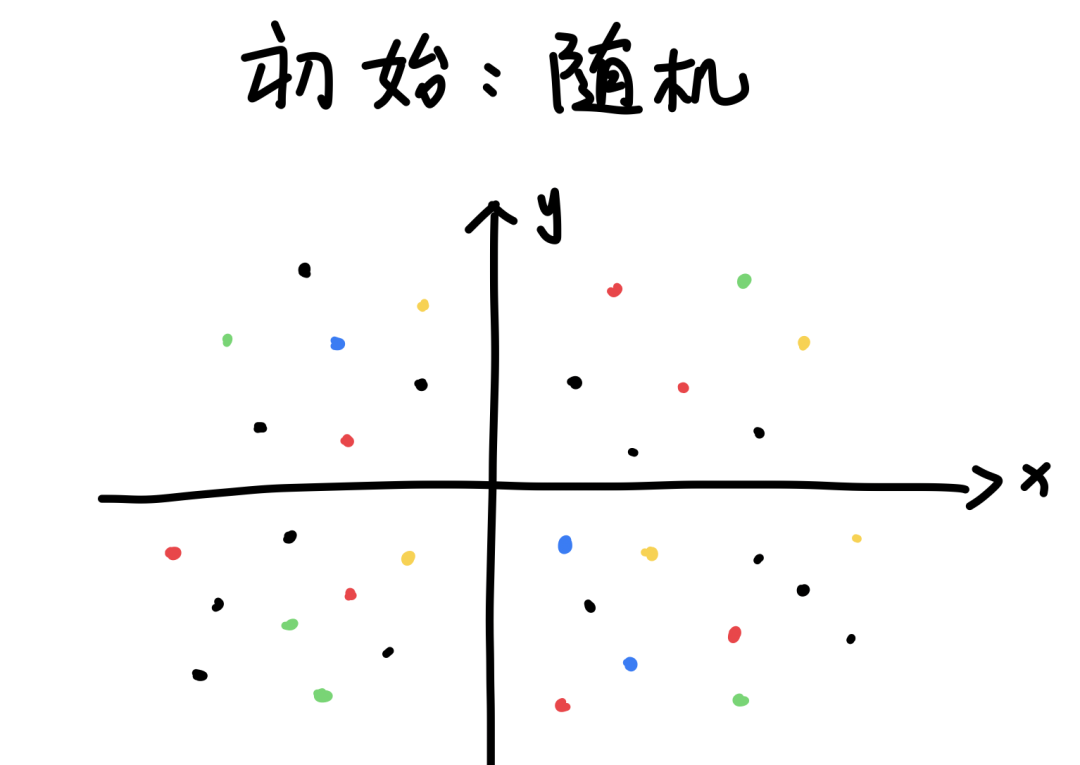
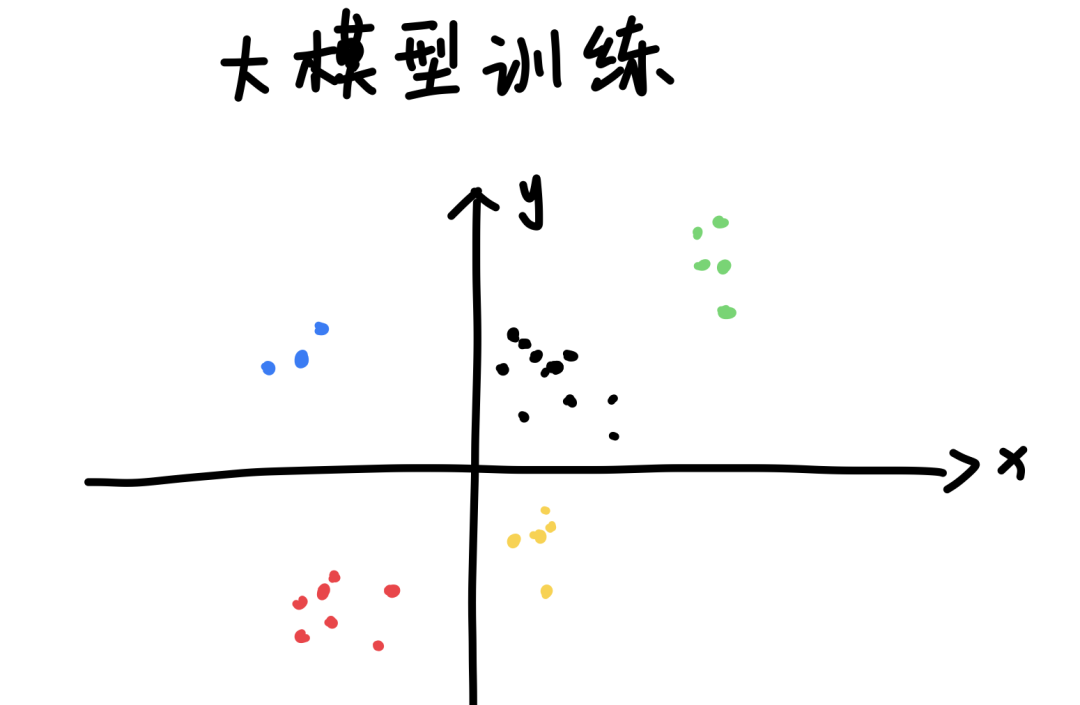
刚开始都是随机的,相当于所有词随机散乱地分布在一个房间里。
img

在大模型训练阶段,就开始「打扫」房间,会根据人类现有大量文字的分布规律,把每个词收拾到最合适的位置上,意思相近的词通常会离得更近一些。
img

训练完以后,每个词的位置关系就可以体现出它和其他词的关系,就像前面这个例子。
img

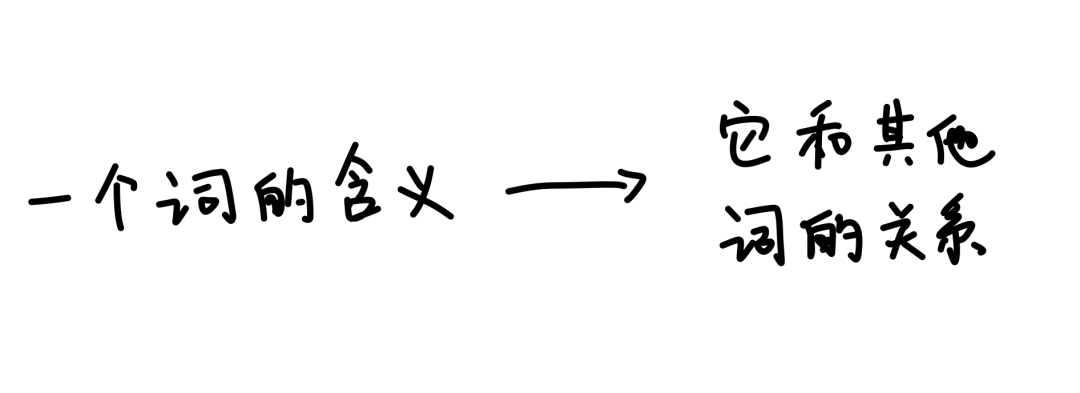
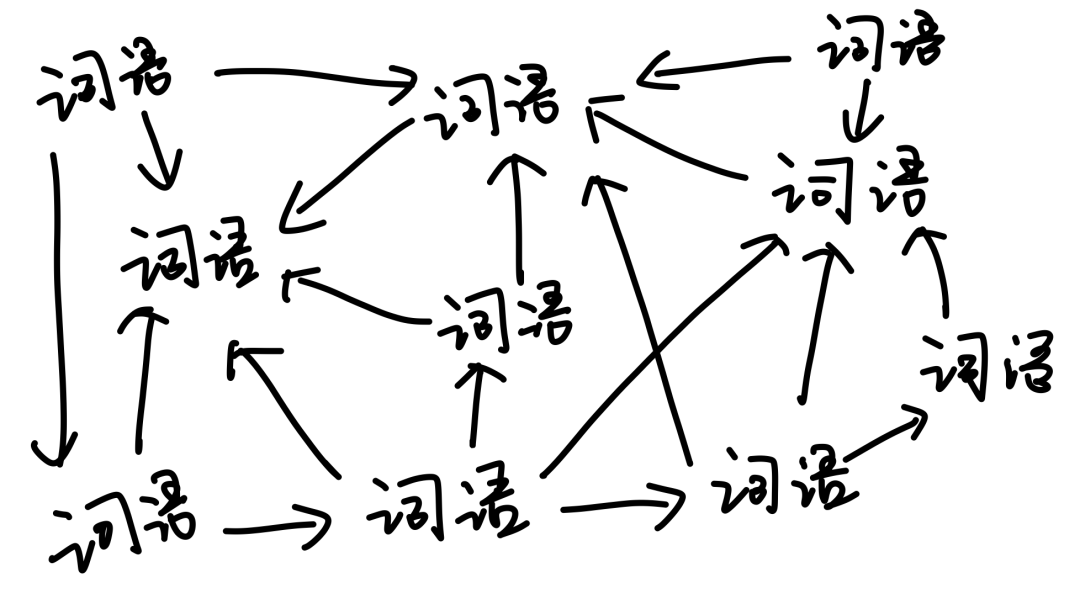
而一个词的含义,本质上就是由它和其他词的关系决定。

img

比方说,我们在解释一个词的时候,会用很多其他词来解释它,而用来解释的这些词,又需要用另一些词来解释,如此往复,最后发现,词和词相互交织在一起才形成了每一个词的含义。
img

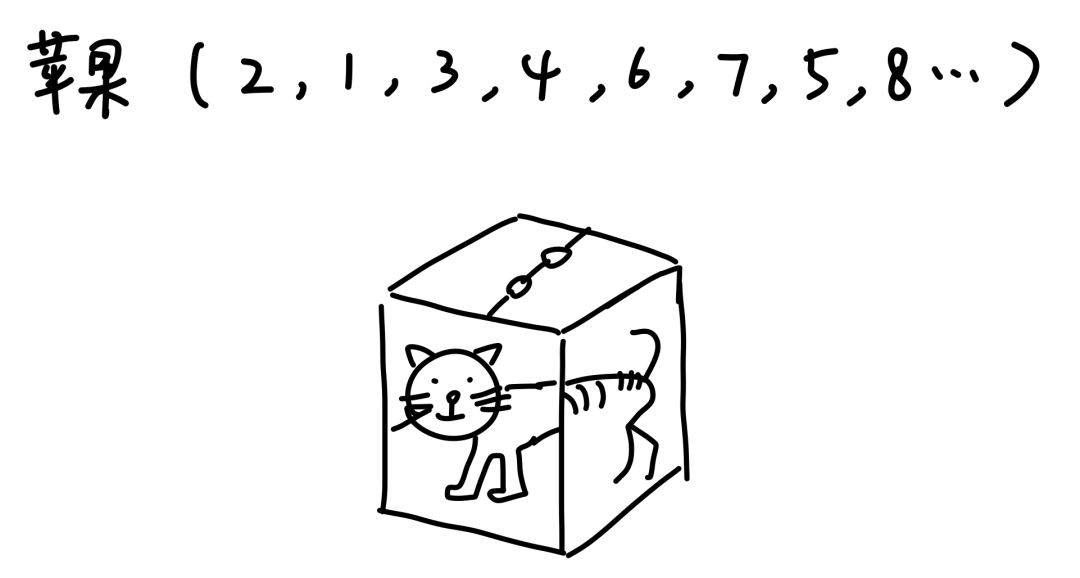
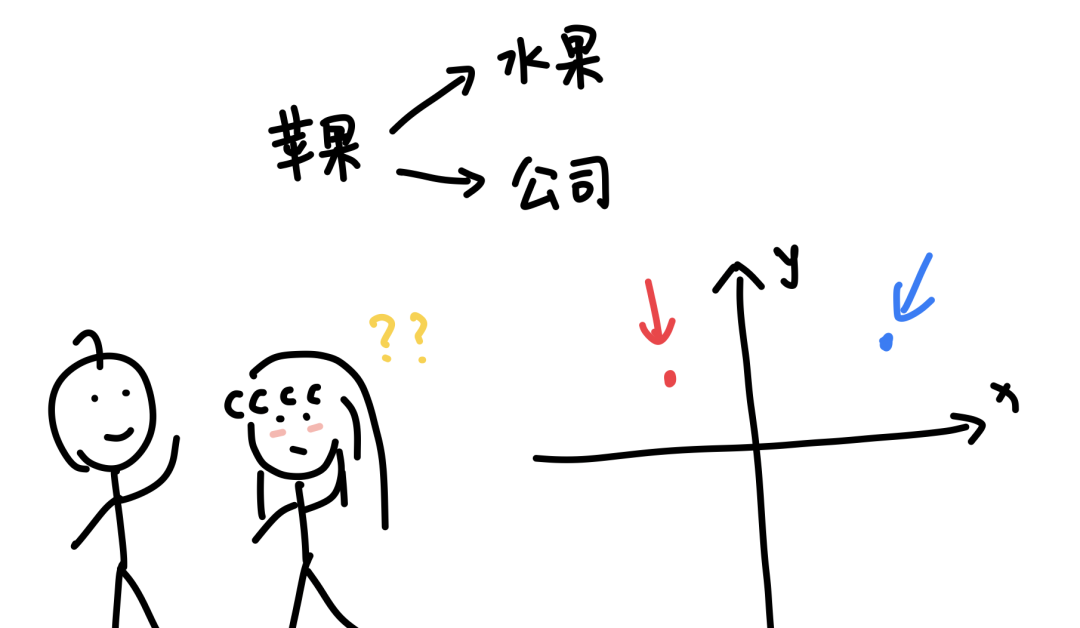
那像「苹果」这个词,又可以表示一种水果,又可以表示一家公司品牌。

那它的词嵌入的位置,究竟是在水果这边,还是在公司这边呢?
img

答案:都不是。

一开始,处在一个中间状态,就像薛定谔的猫。

img

当它和其他词出现在一起,会相互发生计算,改变它原来的值,坍塌为某一种更具体的含义。
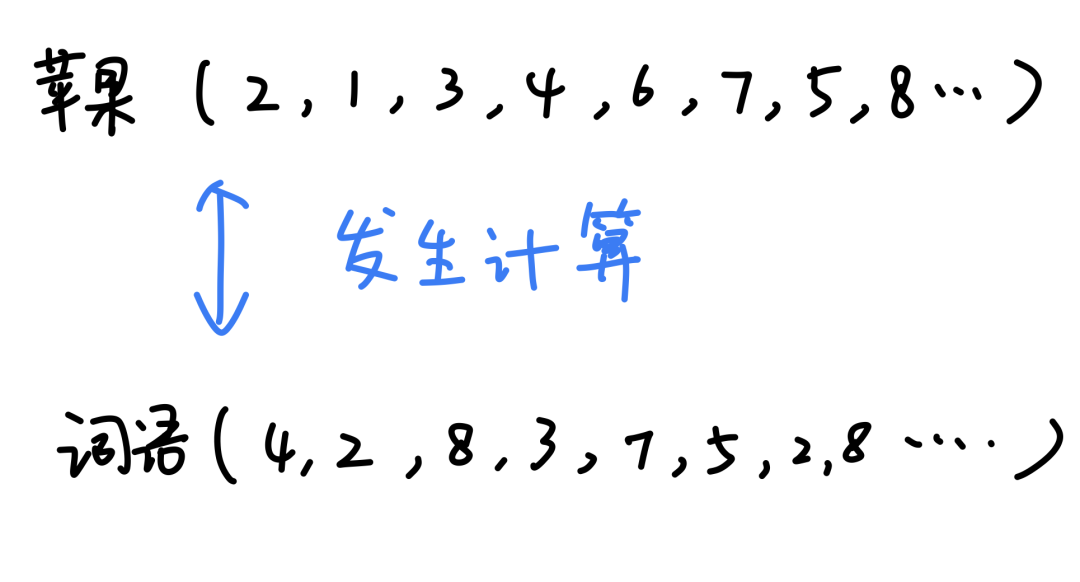
img

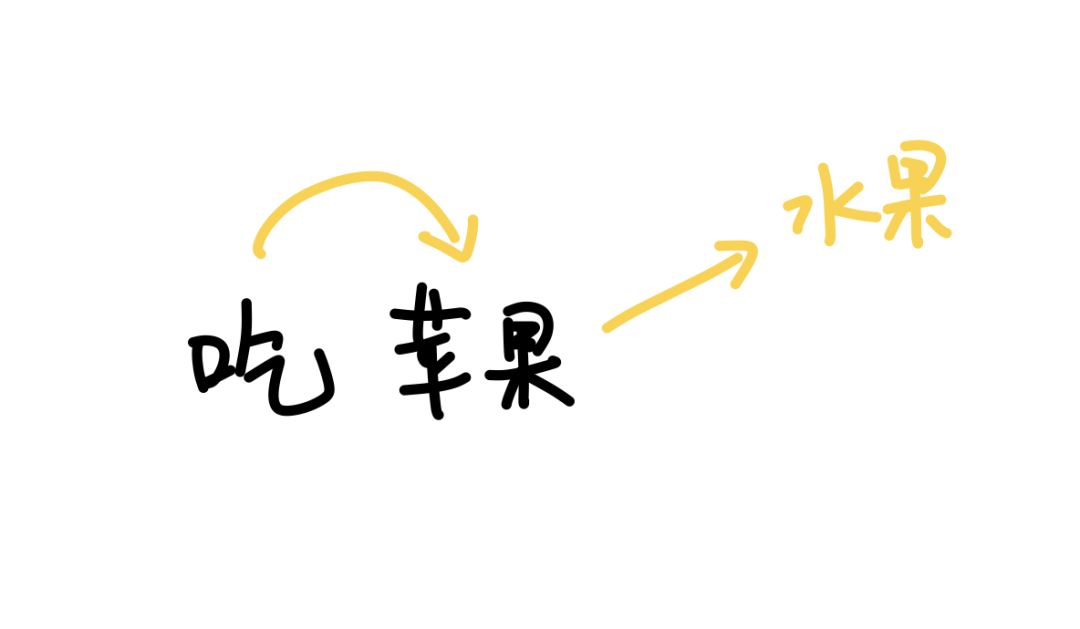
比如当苹果前面出现了一个吃字,那这个吃字就会和苹果发生计算,把苹果的词嵌入更新为水果那个苹果。
img

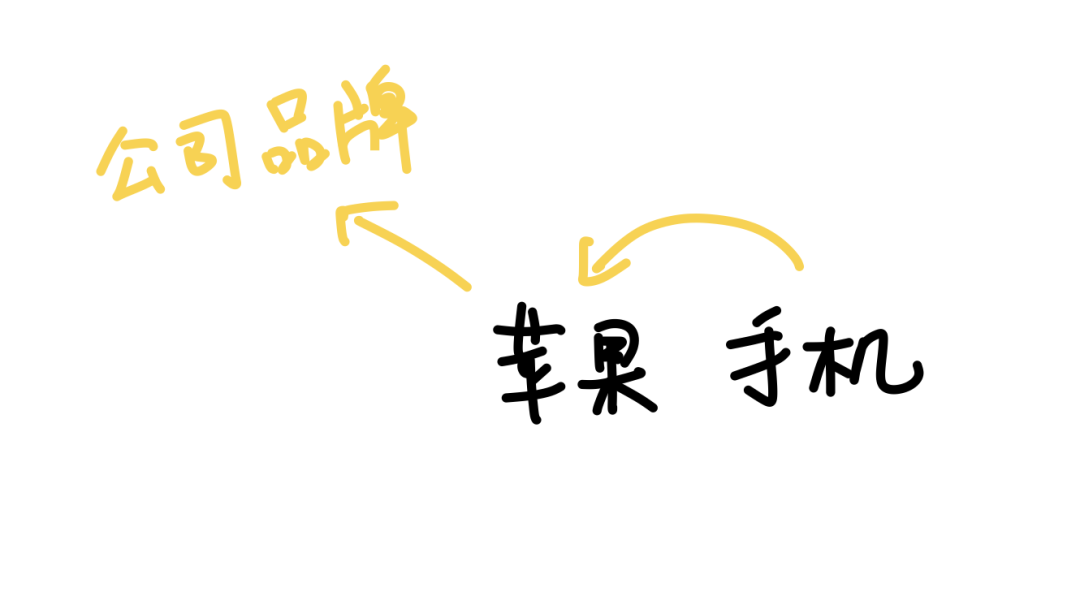
而如果「苹果」的后面跟了一个「手机」或者「公司」,那这些词同样会和苹果发生计算,把苹果的词嵌入更新为专门指代公司品牌的值。
img

这就像人一样,也得通过上下文来判断一个词的含义。

所以回过头来,大模型是怎么理解文字的?

每一个词都是大量的数学计算。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

霜冰优化算法(RIME)详解:从自然现象到智能优化 霜冰优化算法(RIME)是一种新型元启发式优化算法,灵感源于自然界中霜冰的形成过程。该算法通过模拟软霜和硬霜的不同生长特性,实现了高效的全局探索和局部开发平衡。RIME算法包含三个核心机制:软霜搜索策略模拟随机覆盖特性实现全局探索;硬霜穿刺机制模拟定向生长特性进行局部开发;正向贪婪选择机制确保解的持续优化。与遗传算法、粒子群算法相比,RIME具有参数少、收敛快、自适应平衡等优势,特别适合处理高维复杂优化问题。算法已在工程优化、机器学习等领域获得广泛应用,发表一年内即成为高被引论文。 阅读详情

相关推荐

BEVFusion实战:从零搭建LiDAR-Camera融合的3D目标检测环境(附避坑指南)

本文提供了BEVFusion实战指南,详细讲解如何从零搭建LiDAR-Camera融合的3D目标检测环境。内容涵盖环境配置、数据预处理、模型训练与性能优化等关键步骤,并附有实用的避坑技巧,帮助开发者高效部署这一先进的BEV感知算法。

p4q5r6s7t的博客 513

大模型入门实战:通过 HuggingFace 调用 Llama3

至此,我们成功演示了如何通过 Hugging Face 的 Transformers 调用 Llama 模型,并获取了模型的回答。但是如果你的需求只是简单地调用模型,而无需进行微调或复杂的部署,可以尝试使用 Ollama。它不仅操作更加便捷,还提供了开箱即用的 RESTful 接口,适合快速集成到生产环境中。下一篇,我将会讲解如何通过 Ollama 下载部署 Llama 模型并调用。

python12345_的博客 2602

51单片机定时器的原理、应用与编程实现

本文系统介绍了51单片机定时器的基本原理与应用。首先阐述了定时器的工作原理,包括定时模式和计数模式的区别。然后详细讲解了定时器的四种工作模式(方式0-方式3)及其适用场景,并分析了相关寄存器(TMOD、TCON、THx/TLx)的功能设置。文章还给出了定时器编程的具体步骤,包括初始化、计数初值计算和示例代码。最后通过LED闪烁、PWM波形产生、脉冲计数等实际应用案例,展示了定时器的多样化应用。掌握这些知识对嵌入式系统开发具有重要意义。

2501_91227323的博客 1521

大模型部署指南:从个人玩转到企业级应用,这4款工具必看!,大模型入门到精通,收藏这篇就足够了!

Ollama是当前最受欢迎的本地大模型管理框架,专为个人用户设计。只需几条命令,就能在本地快速部署和运行各类开源大模型。

DEVELOPERAA的博客 1342

ABB机器人ModbusTCP通信实战:如何高效传输Float数据到PLC(附完整代码)

本文详细介绍了ABB机器人通过ModbusTCP协议高效传输Float数据到PLC的实战方法,包括底层逻辑解析、RAPID程序架构设计、PLC服务器配置及现场调试技巧。特别针对浮点数据传输中的字节顺序问题提供了解决方案,并附有完整代码示例,助力工程师快速实现工业自动化设备间的高精度数据交互。

weixin_30836759的博客 482

基于PI双闭环解耦控制的三相SVPWM电压型逆变器(3)--调制方法

阐述SPWM和SVPWM的原理以及实现方法

weixin_58670090的博客 6258

(一文读懂)大模型到底是怎么生成文字的?

在人工智能的领域,大模型在去年已经成为了一个热门的话题。各大厂商如谷歌、微软、OpenAI等,都在积极研发和应用大模型技术。这些模型在语言理解、图像识别、推荐系统等方面都表现出了惊人的能力,甚至在某些任务上,已经超越了人类的表现。或许你用过,惊叹于它的神奇,或许你没有用过,听着它的传奇。无论如何,都懂那么一点点,但很难讲的清,它到底是怎么生成的?我们接下来就讲透它生成的原理,并了解四种构建AI应用的大模型技术架构。01大模型的生成原理。

2401_85373898的博客 4312

对比学习(contrastive learning)

什么是自监督学习? 举个通俗的例子:即使不记得物体究竟是什么样子,我们也可以在野外识别物体。 我们通过记住高阶特征并忽略微观层面的细节来做到这一点。那么,现在的问题是,我们能否构建不关注像素级细节,只编码足以区分不同对象的高阶特征的表示学习算法?通过对比学习,研究人员正试图解决这个问题。 什么是对比学习? 对比学习是一种自监督学习方法,用于在没有标签的情况下,通过让模型学习哪些数据点相似或不同来学习数据集的一般特征。 让我们从一个简单的例子开始。想象一下,你是一个试图理解世界的新生婴儿。在家里,假设你有两只

cziun的博客 11万+

【干货收藏】大模型不神秘:10分钟看懂AI如何一个字一个字地“思考“

看到这里,你是不是觉得AI没那么神秘了?它不是什么"黑科技",更不是"有灵魂的生命"——它就是一个通过海量数据训练出来的"超级概率计算器",擅长根据上下文预测下一个词。它能写诗、写代码、做翻译它能分析数据、回答问题、提供建议它甚至能在某些领域超越人类专家接龙游戏 + 概率预测 + 向量分类 + 注意力机制。理解这些原理,不是为了让你变成AI工程师,而是让你在使用这些工具时,心里有底——知道它的能力边界在哪里,知道它为什么会犯错,知道如何更好地"驾驭"它。毕竟,在这个AI狂飙的时代,

weixin_59191169的博客 1714

RTX 50系显卡(5080/5090D)CUDA 12.8环境下的vLLM部署避坑与实战指南

本文为RTX 5080/5090D显卡用户提供了在CUDA 12.8环境下部署vLLM的完整实战指南。文章详细介绍了从驱动安装、CUDA 12.8环境配置、PyTorch Nightly版本精准匹配,到vLLM源码编译及常见报错排查的全过程,帮助开发者高效利用新一代硬件进行大模型推理。

gray5的博客 663

手把手教你学Simulink——基于Simulink的重复控制抑制周期性负载转矩扰动

传统的PI调节器在面对这类特定频率的周期性扰动时,会因积分器的相位滞后而导致转速出现明显的纹波(如6次、12次谐波),严重影响系统的控制精度和静音性能。:要在频率 fd​处获得较高的开环增益以抑制扰动,必须大幅增加PI的比例系数 Kp​,但这会牺牲系统的相位裕度,导致高频共振甚至系统失稳;:电机转速变化时,基频 fbase​会变,导致 6次谐波频率 6×fbase​也在变。设系统的采样周期为 Ts​,目标抑制的周期性扰动频率为 fd​(rad/s),则对应的周期采样点数 N=fd​Ts​2π​。

MHD0815的博客 255

大模型相关概念科普,非常详细收藏我这一篇就够了,一文让你搞懂大模型!

大模型也叫大语言模型,所谓大语言,可以理解为能和人进行对话,可以理解文本内容的模型,而模型可以理解为一个系统,这个系统会接收一个值或者说一个任务,经过一系列的运算,最后得到一个值或者一个结果。模型除了大模型外,对于可以接收图片视频音频的这种模型叫做多模态模型。对于现在很多模型都可以上传附件或图片等内容,确切说都属于多模态模型,但我们通常更习惯称为大模型。

2401_85390073的博客 1703

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

【小白教程】通俗解释:大模型是怎么理解文字的?

我们仅仅用了两个数来表示每一个词,再配合简单的加减法,就模拟出了这四个词在两个维度上的区别和相互关系。 那如果更多的数来表示每一个词,比如三个、十个数、一百个数、一千个数,并且用更复杂的计算方法,不就可以从更多维度更细致地描述每一个词之间的关系? 实际上大模型就是这么干的。 在GPT-1里,每一个词用768个精确到小数点后七位数的数字来表示。

datian1234的博客 964

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

大模型靠啥理解文字?通俗解释:词嵌入embedding

本视频通俗解释了大模型理解文字的核心机制——词嵌入(embedding)。大模型将每个词用一组数字(向量)来表示,数字越多描述越精细。通过简单的向量加减法就能捕捉词语之间的语义关系(如"国王-男人+女人=女王")。词嵌入的值通过大量文本训练从随机状态调整到合适位置,语义相近的词会自动靠近。对于一词多义问题(如"苹果"),通过上下文中其他词的计算来动态确定具体含义。本质上,大模型对文字的理解就是大量的数学计算。

m0_74382565的博客 831

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

推荐:大模型靠啥理解文字?通俗解释:词嵌入embedding

4分钟简单的介绍基本词嵌入的科普,很简单,很形象:

jackyrongvip的专栏 302

通俗解释:大模型的参数究竟是啥?

大模型的参数究竟是什么东西啊?前几天我老婆这么问我。我说参数参数,就是参天大树……(哔——)参数参数,它就是个数嘛!比如其中一个参数可能是3.1415926,另一个参数可能是-0.0009527。像DeepSeek R1 最大的版本是671B,这个B是十亿的意思,也就是它有6710亿个,类似这样的数。你可以想象一张巨大的表格,每一个格子里都有一个类似这样的数,一共有几千亿个数,这些参数通常占了一大模型90%以上的体积。

m0_59235245的博客 1003

什么是大模型?通俗易懂地解释给你听

ChatGPT是人工智能技术驱动的自然语言处理工具,它能够通过理解和学习人类的语言来进行对话,还能根据聊天的上下文进行互动,真正像人类一样来聊天交流,甚至能完成撰写邮件、视频脚本、文案、翻译、代码,写论文等任务。这是实体的模型,映射到虚拟上,就包括我们听到过很多次的数学建模,建立一个模型,就变成一个虚拟的“模具”,我就可以使用这个“模具”来计算其他的数据,来增加我们的工作效率。什么是AIGC应用?“当下,我们正处在全新起点,这是一个以大模型为核心的人工智能新时代,大模型改变了人工智能,大模型即将改变世界。

2401_85325557的博客 1606

普通人学AI:如何最简单、通俗地理解大模型?

我是一个不懂技术的普通人,所以这个系列就叫做「普通人学AI」,以下是该系列的第一篇文章。

2301_81888214的博客 1259

什么是大模型?最通俗易懂的解释来了!

我们在生活中常常使用过很多模型,比如自制雪糕的雪糕模具,塑料加工工业中的注塑模具等等,这些都是模具,我们可以使用这些模具来更加简单地完成最终的成品。这是实体的模型,映射到虚拟上,就包括我们听到过很多次的数学建模,建立一个模型,就变成一个虚拟的“模具”,我就可以使用这个“模具”来计算其他的数据,来增加我们的工作效率。结合模型的书面定义:通过主观意识借助实体或者虚拟表现,构成客观阐述形态结构的一种表达目的的物件。(物件并不等于物体,不局限于实体与虚拟、不限于平面与立体)。你能更好地理解到模型的意思。

程序员鑫港的博客 925

用最通俗易懂的语言解释什么是大模型 - 大模型介绍 - 大模型是什么

大模型,简单来说,就像是一个超级聪明的大脑,它通过学习大量的信息来理解世界,并能够解决各种复杂的问题。这种“大脑”实际上是由计算机程序构成的,特别是通过一种叫做深度学习的技术训练出来的神经网络。大模型本身的能力横评主要通过基准测试和人类评估两种方式进行。1)基准测试,也称为“考试模式”其核心思路是通过一系列预设的问题来考察模型在特定任务上的表现,这些问题覆盖了数学、逻辑推理、常识等多个领域。

whisperzzza的博客 2523

如何最简单、通俗地理解大模型?

理解大模型(Large Model)本质上就是理解两个关键词:大、模型。首先我们理解什么是模型(Model)。模型是事物的抽象,可用于描述、解释和预测事物。例如数学公式、物理装置、计算机程序、人体模型都可以称为模型。在人工智能领域,模型特指学习算法从数据中提取的模式或规则,进一步用于数据的预测。这样理解可能会比较抽象,举个简单的例子:我们想让人工智能来识别图像里有没有猫,该怎么做呢?第一步,我们要准备数据。我们将大量有猫的图片和没有猫的图片做好标记,例如有猫标记为1,没有猫标记为0。

2401_84206094的博客 1621

大模型“幻觉“通俗一些的理解

它源自模型的本质:一个"文字接龙大师",而不是"事实数据库"。它就像一个记忆力超强、但从来不会说"我不懂"的超级学霸,当你问到一个它不确定的问题时,它会用听起来非常流利、非常自信的语言,现场给你编一个答案。这就像一个擅长接龙的孩子,你说"苹果",他接"手机",你说"华为",他接"5G"……"(实际上没人这么干,但听起来挺有道理)它被训练的方式是:看了海量的互联网文字后,学会了"给定前面的文字,下一个字最可能是什么"。

bisal的专栏 608
上一篇: 9000字。一文看懂Embedding模型
下一篇: GR00T N1:通用人形VLA模型——从“数据孤岛”到“数据金字塔”的破局之路
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值