【Attention优化重大突破!显存减半效率倍增,大模型长文本处理迎来新时代】

大模型训练之加速篇 -attention优化【线性化performer/VQ->分块计算MQA/GQA->计算(flash atten/slim/dec)->缓存MLA/pagedAtt】 加速 阅读详情

一,前言

从Transformer 17年被提出来, Attention 层的相关的工作从未间断,参考邱锡鹏教授21年关于Transformer的综述里的整理如下:

更耳熟能详一些的如:MQA,GQA ,DeepSeek的MLA,阶跃星辰的MFA,以及最近DeepSeek提出的NSA和Kimi提出的MoBA。

到底这么多的Attention为什么被提出,它们都意图解决什么问题。 我们用接下来的两个章节来解释一下。

二,Attention 是什么

为了更容易理解我们接下来的内容,我们先来看一下Attention的计算公式:
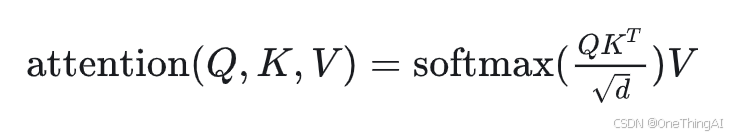
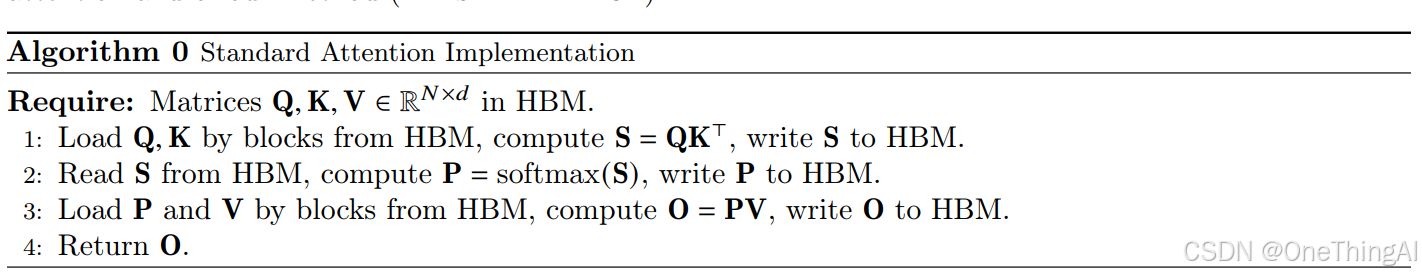
这个公式到底在做什么,flashattention的论文里说的比较清楚:

结合下图更有利于我们深入的理解attention(11. Self Attention - by Tom Yeh - AI by Hand ✍️)
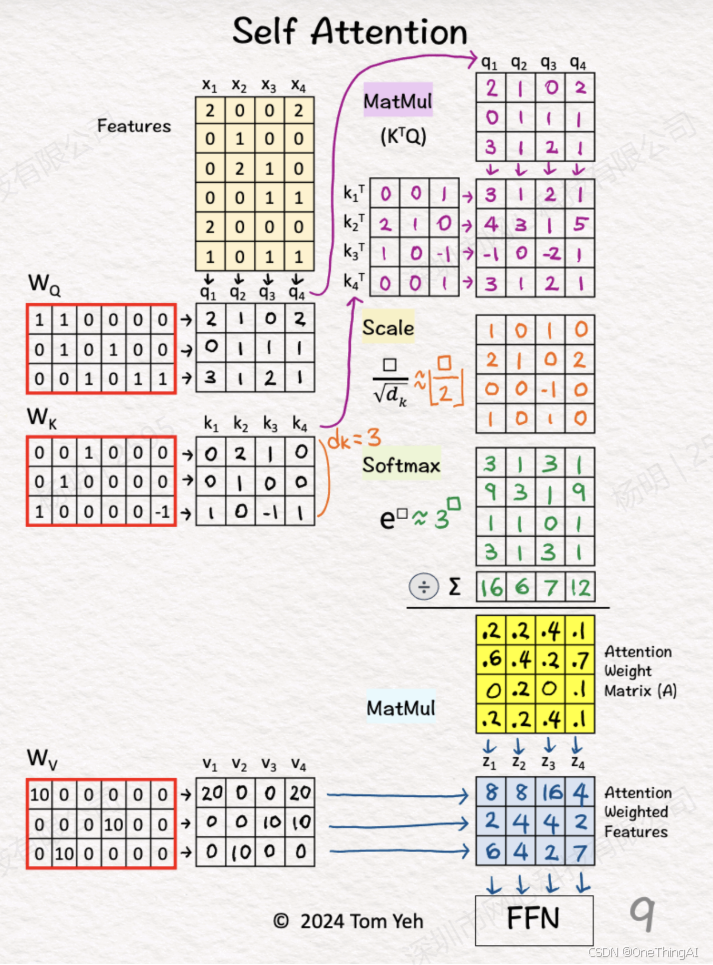
下面会对以上的这张图做分块的解释:

语言模型简单来说就是针对输入的序列计算概率,推测下一个token是什么,新生成的token以及历史上所有的token又做为下一轮生成的输入。 上面这个图是模型多层transformer中的一层的计算过程的具象化展示,主要含有Attention和FFN(MLP)这2个子层。下面几个小节主要解释attention的计算部分。

1, 我们假设该图是transformer第一层,每个token是一个词,这样可以简化讨论。假设有4个词做为输入,被转化为4个向量,也就是图里的Features:x1,x2,x3,x4。 通过和模型的权重矩阵Wq,Wk 相乘,得到一个Q矩阵,也就是图里的q1,q2,q3,q4 这4个销向量。得到一个K矩阵也就是k1,k2,k3,k4 这4个销向量;
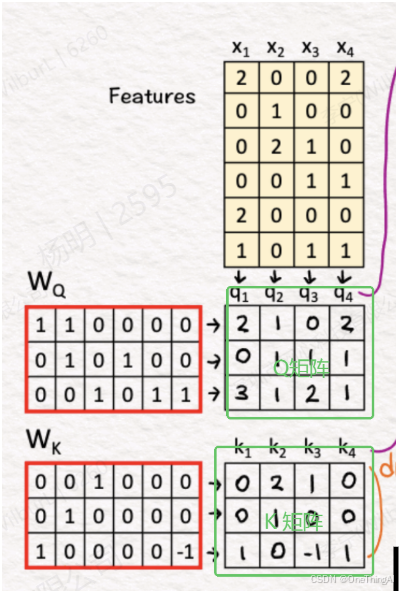
2, Q,K 通过矩阵乘法计算得到一个矩阵S
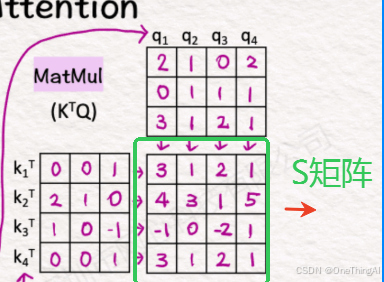
3,然后通过softmax 等计算得到矩阵P
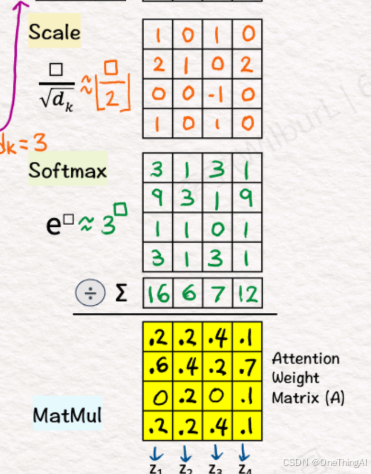
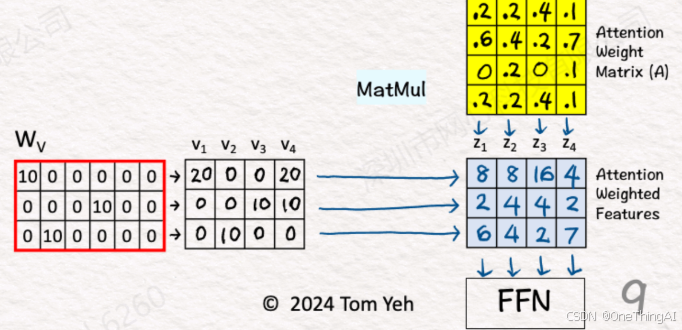
4,输入x1,x2,x3,x4通过和模型的权重矩阵Wv相乘得到v1,v2,v3,v4 也就是矩阵V。 最后矩阵P和V相乘得到最终的输出向量z1,z2,z3,z4,也就是矩阵O
三,为什么能做和要做前言里提到的优化工作

从第二章节不难看出(Decoder-only的attention计算和上面略有不同,不影响计算复杂度讨论),如果不做任何优化,生成每一个token的计算复杂度是O(n^2),最终生成的序列全局计算复杂度是O(n^3)。对于上下文这个计算复杂度肯定是无法接受的。

1,所以,直觉上提升Attention的性能的做法是降低它的计算复杂度.

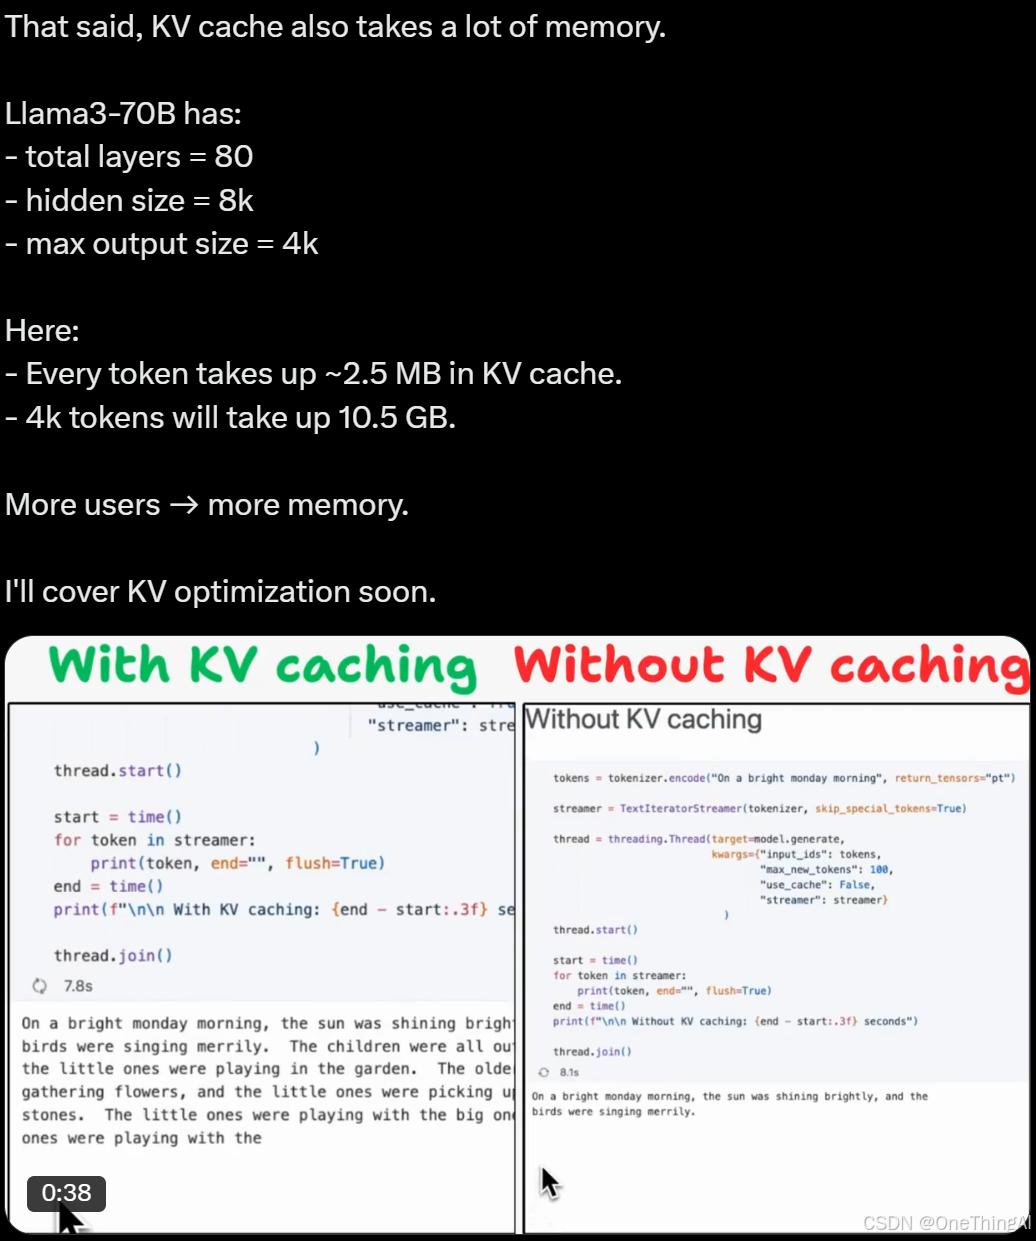
kv caching就是为了解决这个问题将单个token的计算复杂度降低到O(n) (n为当前序列长度),全局的复杂度就下降到O(n^2)极大的提升了性能。比如下图开不开起kv caching 作者观察到的。 kv caching 是一个空间换时间的做法,那么我们需要付出的就是更多的显存空间用来做k,v 的缓存。
kv caching 为什么可行参考下面2个图(https://x.com/_avichawla/status/1890288542322221206):
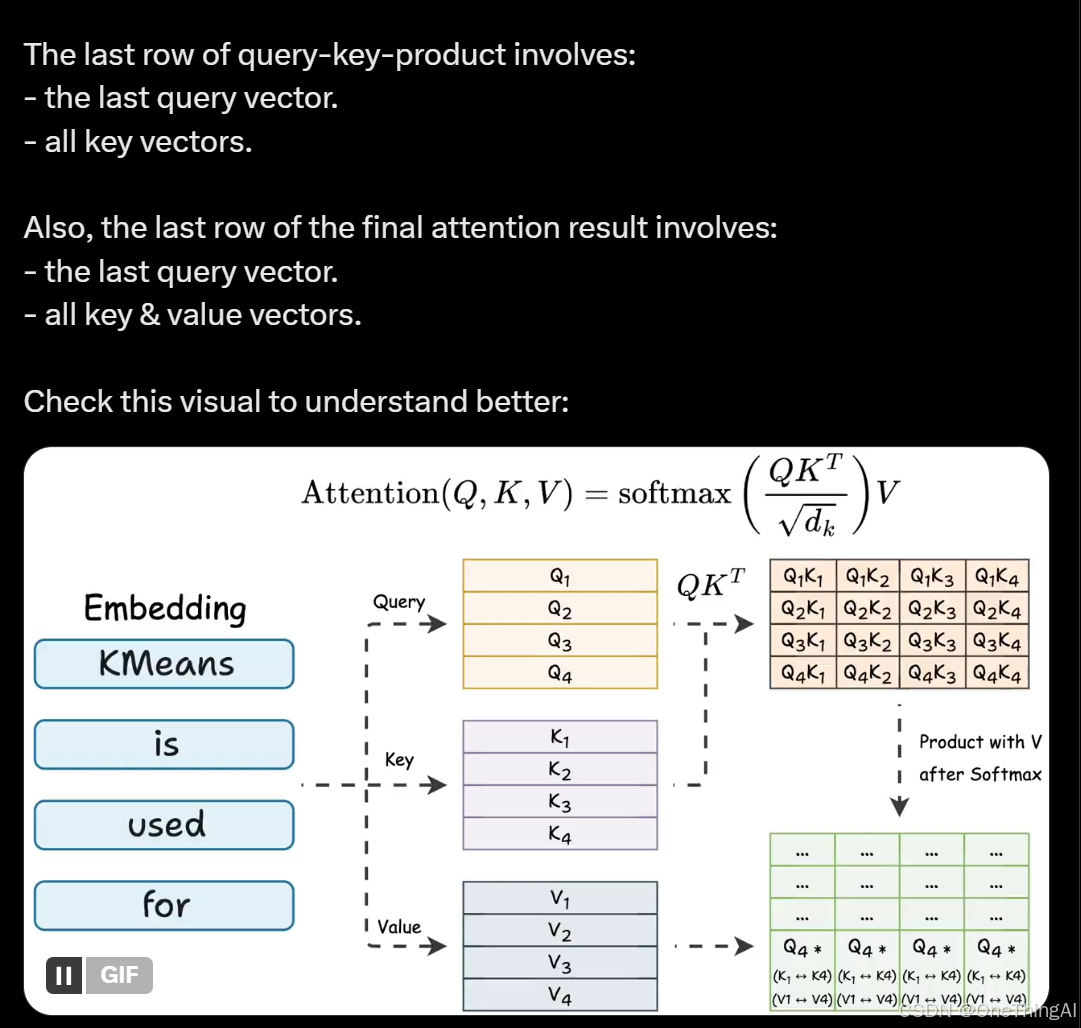
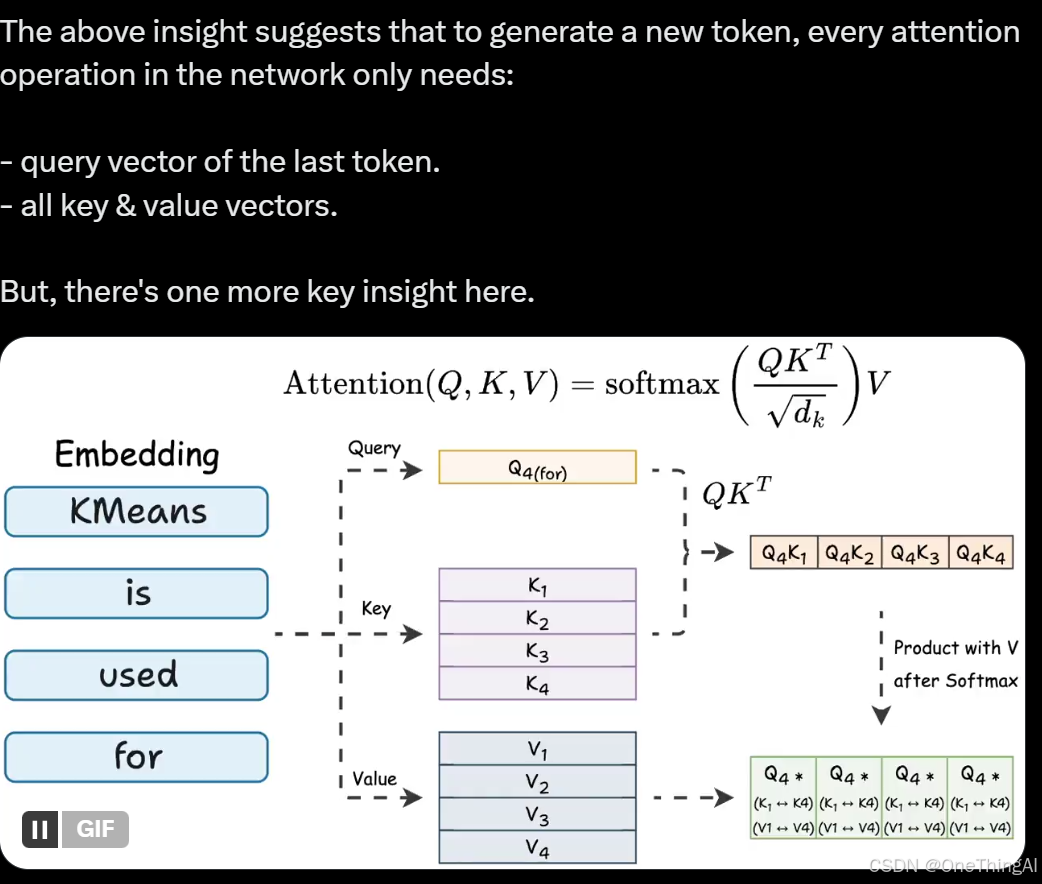
大体来说就是Decoder 里的attention计算由于当前token只参考之前的token而不向后参考,所以如第二章节的历史上的z向量可以在新token生成时不更新,Zk = (Qk * K) * V。

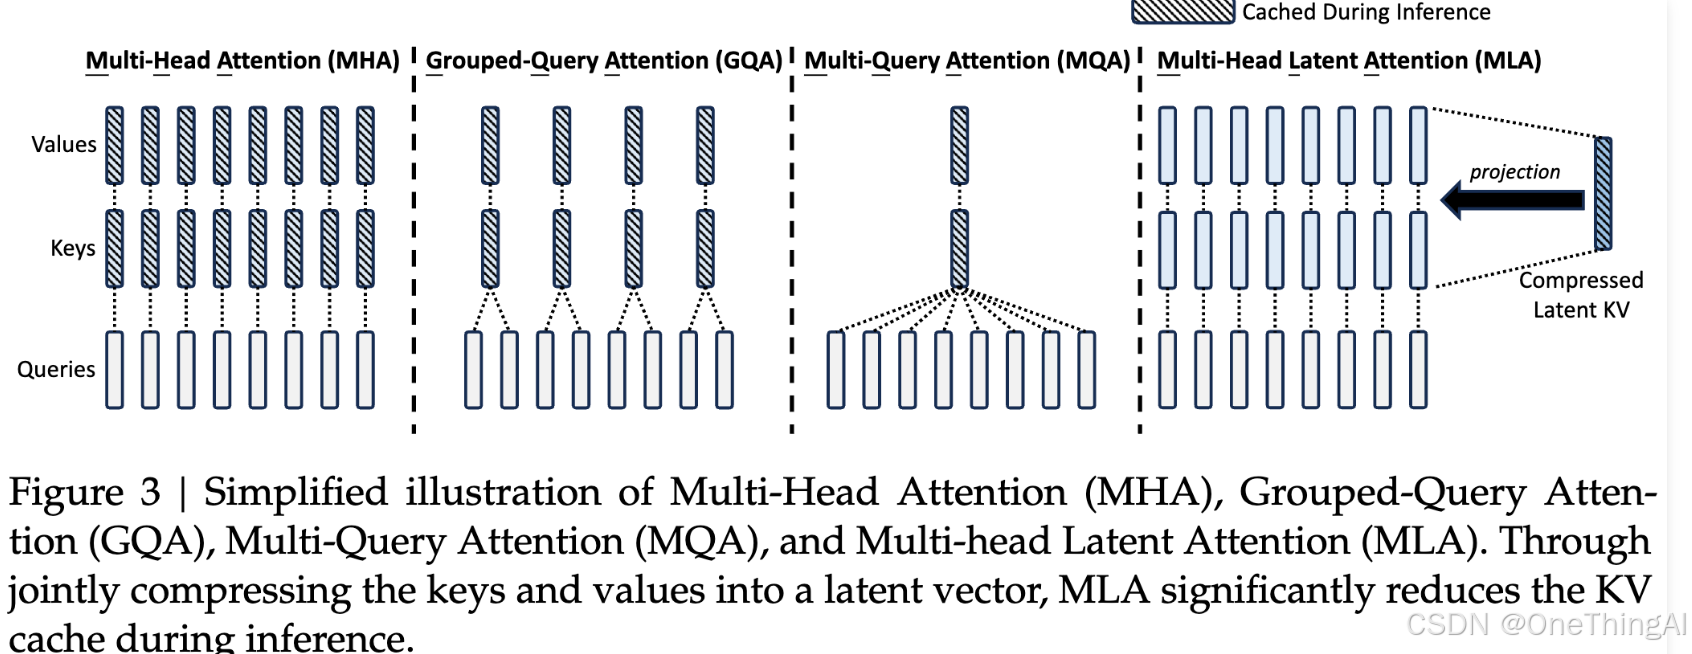
2,kv caching 极大的提升了性能,但是需要大量的cache 空间。比如上图所示看Llama3 70B,4k token需要10.5 GB 的cache空间,这个是极大的开销。为了降低cache的压力,开头提到的MQA,GQA等被提出,通过降低k v 的数量来降低对显存的消耗。同时模型能力没有出现明显的下降,所以得到了广泛的使用。DeepSeek 的MLA 则是通过压缩k v 大小的方式,进一步降低了cache 的压力,这里的风险是信息的损失会导致模型性能的下降,但从实际的结果来看,这个风险目前被处理得很好。
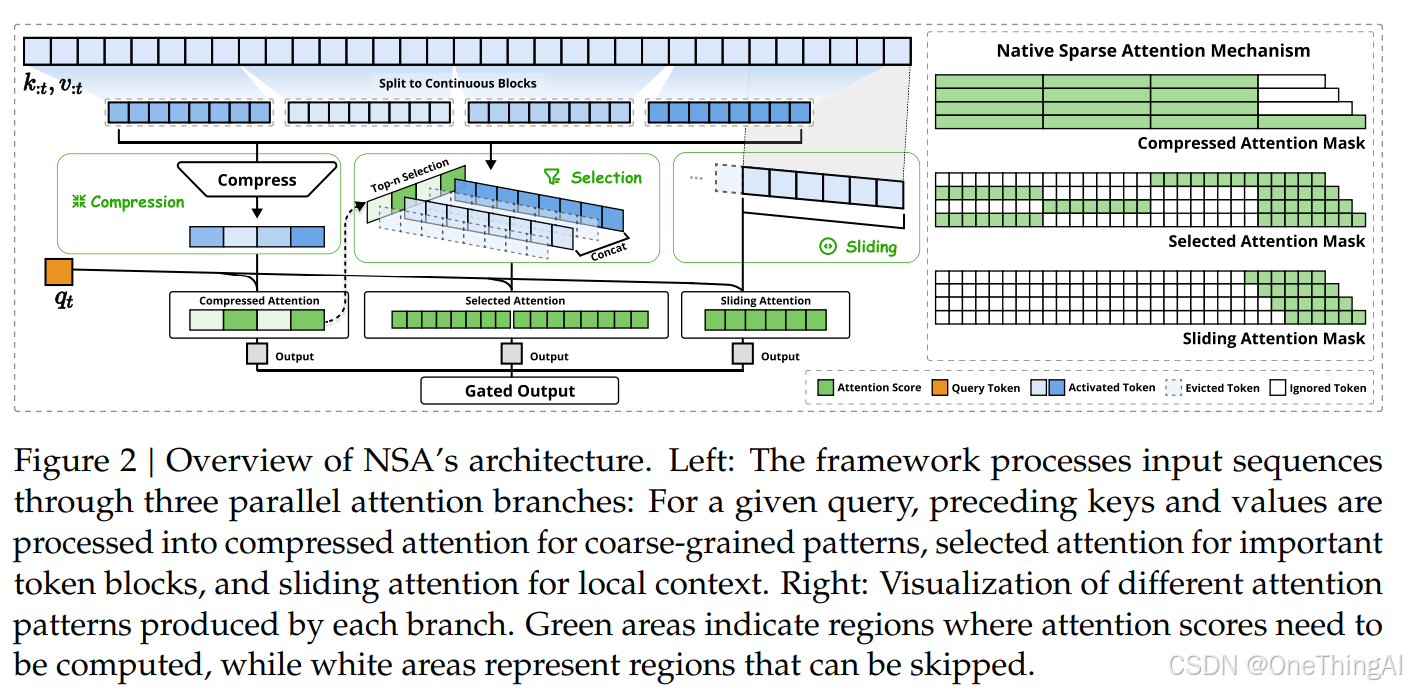
3,即使做了1,2的优化,问题就不存在了吗?当然不是,对于更长的上下文cache的压力还是很大,计算压力还是O(n^2) (n 为序列长度),这样模型实际是很难继续朝着长上下文scaling的。2和其他的一些研究表attention是稀疏的,序列越长attention越稀疏,像DeepSeek 的NSV,Kimi的MoBA以及别的一些研究就诞生了,通过这些研究我们可以进一步降低计算量和cache大小同时不降低模型性能。
参考资料:

https://arxiv.org/pdf/1706.03762

https://arxiv.org/pdf/2106.04554

https://arxiv.org/pdf/2205.14135

https://arxiv.org/pdf/2502.11089

11. Self Attention - by Tom Yeh - AI by Hand ✍️

The Annotated Transformer

https://x.com/_avichawla/status/1890288542322221206

Attention优化|2w字原理&图解: 从Online-Softmax到FlashAttention V1/V2/V3 本文通过原理分析和图解的方式,通俗易懂地FlashAttention系列算法。FlashAttention V1/V2在LLM领域的应用已经非常广泛,相关的论文也反复读了几遍。FA1和FA2论文非常经典,都推荐读一下(不过FA2论文中公式错误不少本文大约1.8w字,包括以下内容:0x07 分布式训推使用FlashAttention0x09 FlashAttention中MQA/GQA以及Causal Mask处理。 阅读详情

相关推荐

从零到一:Bioconductor新手入门与R包安装实战

本文详细介绍了Bioconductor在生物信息学中的重要性及其R包安装实战指南。从环境准备到BiocManager的使用,再到常见问题排查,帮助新手快速掌握这一强大工具。特别推荐org.Hs.eg.db等核心工具包,助力基因注释和功能分析,提升研究效率。

weixin_29061041的博客 418

各式各样的attention改进

多头注意力机制,各式各样的attention改进,Transformer模型架构.刷到一个『awesome-fast-attention』大列表,整理了一系列关于attention的高效改进文章,包括论文、引用量、源码实现、算法复杂度以及关键亮点。其中一部分论文,我们在之前的『Transformer Assemble』系列文章中也都有作过解. Transformer 由两个独立的模块组成,即Encoder和Decoder

计算机毕业论文源码,学生个人网页制作html源码。贴近用户做网络推广和互联网优化。 1546

哈工大OS实验四——进程运行轨迹的跟踪与统计

进程运行轨迹的跟踪与统计 进程从创建(Linux 下调用 fork())到结束的整个过程就是进程的生命期,进程在其生命期中的运行轨迹实际上就表现为进程状态的多次切换,如进程创建以后会成为就绪态;当该进程被调度以后会切换到运行态;在运行的过程中如果启动了一个文件读写操作,操作系统会将该进程切换到阻塞态(等待态)从而让出 CPU;当文件读写完毕以后,操作系统会在将其切换成就绪态,等待进程调度算法来调度该进程执行…… process.c解读 void cpuio_bound(int last, int cpu_

优快云-ych 1002

LLM中的Attention实现及优化

作者:phynlp原文:https://zhuanlan.zhihu.com/p/15348185464。

AIBigModel的博客 1241

TNS-12516及ORA-12516错误解决

在客户端进行sqlplus连接报错如下: ORA-12516: TNS: 监听程序找不到符合协议堆栈要求的可用处理程序 在/home/oracle/product/10.2.0/db_1/network/log/listener.log中查看到错误如下: TNS-12516: TNS:listener could not find available handler with matchin

KEL 2万+

基于BS21的星闪模块设计电路SLE/BLE

基于BS21的星闪模块设计电路SLE/BLE HI2821

2503_91889531的博客 2739

self-attention 的 CUDA 实现及优化 (上)

self-attention 是 Transformer 中最关键、最复杂的部分,也是 Transformer 优化的核心环节。理解 self-attention ,对于深入理解 Transformer 具有关键作用,本篇主要就围绕 self-attention 展开,由于该部分比较复杂,故分为上下两篇,本篇为上篇。self-attention 的原理非常常见,在之前的文章中也分析很多,因此不在此介绍介绍其原理,仅解读代码。

小舟的博客 1768

用C++从零复刻Wordle:手把手教你实现命令行猜词游戏(含完整源码解析)

本文详细介绍了如何使用C++从零开始实现一个命令行版本的Wordle猜词游戏,包含完整的源码解析和核心模块设计。通过游戏逻辑控制器、单词库管理器等模块的构建,开发者可以学习C++实战技巧和性能优化方法,适合提升编程能力和游戏开发兴趣。

weixin_26763955的博客 334

降低显存,优化性能方案 MHA MQA GQA MLA MFA

GQA是一种在现代大模型中广泛采用的注意力机制变体,它通过创新的组策略优化了资源利用,是模型效率和性能之间精妙平衡的体现。通过在不同应用场景中调整组的数量,GQA能够灵活适应不同的计算和性能要求,成为深度学习领域中处理大规模数据流的一个重要工具。

FeelTouch Labs 1411

高频面试题-项目介绍篇

聊聊如何介绍项目经历。

m0_73359763的博客 1908

**Coffin-Manson 模型**在半导体功率循环测试中的理论背景、数学形式、应用场景,以及如何使用 **C#** 编程语言进行具体实现

Coffin-Manson 模型最初用于描述金属材料在低周疲劳(Low-Cycle Fatigue, LCF)下的寿命,后来被广泛应用于半导体功率器件(如 IGBT、MOSFET)的可靠性分析,特别是在功率循环测试中。如果你有具体数据(如 CSV 文件)、更复杂的模型要求(如 Bayerer 模型)或特定可视化需求,请提供,我可以进一步优化代码或添加功能!以下代码实现基本模型 ( N_f = A \cdot (\Delta T_j)^{-n} ) 的拟合,生成拟合曲线并预测寿命。我会结合你之前提到的。

专注于前沿技术的探索与实践,热衷于从代码逻辑、架构设计到行业应用等多维度深挖技术本质。期待在技术之路上与你共同成长~ 481

Attention优化问题&Sparse Attention&Efficiency Linear Attention&Infini Attention

摘要:本文探讨了多种Attention优化方法。SparseAttention通过稀疏化注意力矩阵降低计算复杂度(O(n√n)或更低),以精度换空间;EfficientAttention通过数学优化将复杂度降为线性(O(n));InfiniAttention实现无限上下文窗口,结合压缩记忆和线性访问;PagedAttention借鉴操作系统分页管理优化KVcache显存利用率至96%。这些方法通过数学或机制优化,在精度、空间、时间之间取得平衡,提升大模型效率。

m0_65648831的博客 1202

MIKE21 教程 3.2 随空间变化的网格文件制作(.dfsu文件制作) 曼宁值网格文件制作

上一节讲解了如何制作时间序列文件。本节讲解如何制作仅随空间变化的文件。 目录 1 数据准备 1.1 基于地形设置 1.2 基于地形水深设置: 2 数据导入 3 数据导出

Hello Word 3941

Attention机制深度解析:问题、优化方向与经典变体

从传统Attention到MQA、GQA、FlashAttention的演进,核心逻辑始终是“在保证模型效果不显著下降的前提下,最大化提升效率、降低资源开销”:MQA主打“极致效率”,通过全共享KV实现显存和速度的突破,适合部署场景;GQA主打“平衡取舍”,通过分组共享兼顾效果与效率,适合对效果要求较高的大模型;FlashAttention主打“硬件适配”,通过分块计算和Kernel融合挖掘硬件潜力,是通用加速方案;

ppbk_的博客 770

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【注意力机制】一系列关于attention的高效改进大集合

编辑:NewBeeNLP前几天逛github刷到一个『awesome-fast-attention』大列表,整理了一系列关于attention的高效改进文章,包括论文、引用量、源码实现、...

zenRRan的博客 1万+

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

【亲测免费】 SageAttention 使用教程

SageAttention 是一个开源项目,旨在通过量化注意力机制来加速深度学习模型的推理过程,而不牺牲模型的端到端性能。该项目提供了优化的内核,支持不同GPU架构,包括Ampere、Ada和Hopper,通过INT8和FP8量化技术,实现了对QK^T和PV的加速处理。 ## 2. 项目快速启动 ### 环境准备 确保你的环境中安装了以下依赖: - Python >= 3.9 - PyTor...

gitblog_00216的博客 3317

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

深度解析SageAttention:量化注意力机制的技术革新与应用实践

SageAttention作为新一代量化注意力机制框架,通过创新的8位量化技术在不损失端到端指标的前提下,相比FlashAttention2和xformers分别实现了2.1-3.1倍和2.7-5.1倍的性能提升。本文将深入分析其技术原理、实际应用效果和部署优化策略。 ## 技术架构与核心优势 ### 量化注意力机制设计 SageAttention采用分层量化策略,在QK^T计算中使用INT

gitblog_00563的博客 1166

Transformer升级之路:从计算瓶颈出发,MLA如何实现理论上的“双优”?

当然,MLA 是 DeepSeek 首先提出的,第三方使用 MLA 总会给人一种复制 DeepSeek 的感觉,但在更好的变体出现之前,或者在发现严重的缺陷之前,MLA 始终是一个相当有竞争力的选择,如果单纯是为了显示自己不“追随” DeepSeek 而不用 MLA,那是一个相当不明智的选择。然而,将 head_dims 升到 512,Decoding 是没问题,但训练和 Prefill 都很难接受,因为它们俩的瓶颈是计算,而影响计算速度的主要因素是 num_heads 和 head_dims。

Paper weekly 1031

双注意力机制网络,attention在图像分割领域的进一步优化?

前言 在之前的博客中我们将了self-attention,在图像领域中应用大多数基于[H,W]这个维度,也就是图像的空间维度,本篇Dual Attention Network for Scene Segmentation,不仅在空间维度上的attention,也在channel的维度上进行attention。 目前的主流attention机制: 基于空间域的:self-attention,soft/hard attention 基于channel域的:SEnet SKnet 以及ResNest 本篇pape

qq_43534932的博客 2866

[深度概念]·Attention机制实践解读

[深度概念]·Attention机制实践解读 此文源自一个博客,笔者用黑体做了注释与解读,方便自己和大家深入理解Attention model,写的不对地方欢迎批评指正。。 1、Attention Model 概述 深度学习里的Attention model其实模拟的是人脑的注意力模型,举个例子来说,当我们观赏一幅画时,虽然我们可以看到整幅画的全貌,但是在我们深入仔细地观察时,其实眼睛聚...

简明AI工作室 9692

自然语言处理中的Attention机制总结

       在面试的过程中被问到了attention,原来虽然其实已经实际用过attention了,也知道个大概原理是加权求和,但是对于加权的具体方法以及权值得分的计算并不是很清晰,面试答的一般,正好最近实习的地方

CODE and POEM 10万+

attention注意力机制

顾名思义:之一李机制的意思就是将注意力集中在重要的点上,忽略那些不重要的因素。 注意力机制其实就是分配权重的过程。 现在的重点就是注意力权重的获取过程。 Soft Attention Model------软注意力模型,任何数据都会给一个权值,没有筛选条件。 ...

XZ_AN 1684

自然语言处理中的Attention Model:是什么及为什么

转自 张俊林        http://blog.youkuaiyun.com/malefactor/article/details/50550211 要是关注深度学习在自然语言处理方面的研究进展,我相信你一定听说过Attention Model(后文有时会简称AM模型)这个词。AM模型应该说是过去一年来NLP领域中的重要进展之一,在很多场景被证明有效。听起来AM很高大上,其实它的基本思

zdy0_2004的专栏 1082

Self-Attention 加速方法一览:ISSA、CCNet、CGNL、Linformer

作者:林天威链接:https://zhuanlan.zhihu.com/p/270898373本文转载自知乎,作者已授权,未经许可请勿二次转载Attention 机制最早在NLP 领域中...

深度学习与计算机视觉 1171

attention 机制入门

在下面这两篇文章中都有提到 attention 机制:使聊天机器人的对话更有营养如何自动生成文本摘要今天来看看 attention 是什么。下面这篇论文算是在NLP中第一个使用attention机制的工作。他们把attention机制用到了神经网络机器翻译(NMT)上,NMT其实就是一个典型的sequence to sequence模型,也就是一个encoder to decoder模型htt

极客X养成计划 830

Attention和增强循环神经网络

本文重点讲述的是一种被称为attention的方法,有的人将其译为“聚焦”,但觉得这种翻译将原文对神经网络拟人化的手法给扔掉了,因此保留了原来的称谓。Attention,顾名思义,就是让神经网络对部分内容引起注意,而忽略其他不重要的内容。目前我看到过这篇文章的两种译文版本,但都有不少缺陷,或是残缺,或是表述不清难以理解,因此汲取两个版本的优点对原文重新进行翻译。 Attention方法的通用的技巧是将原本不可微的离散数据结合一个attention分布变得可微,从而使得离散数据也可以作为神经网络的输入向量,

Krse Lee的技术博客 8752
上一篇: 【大模型私有化部署要花多少钱?】一张图看懂你的钱用在哪
下一篇: 云端H20实战:基于LlamaFactory实现LLM高效微调
OneThingAI
博客等级 码龄2年 135粉丝 44原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值