字节深夜开源 Seed-OSS:512K 超长上下文实力亮相,长度较主流模型劲增 4 倍!

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品) 阅读详情

字节 Seed 团队开源首个 LLM:Seed-OSS-36B。该模型具备长上下文、推理、智能体和通用能力,开发者友好,而且还主要针对国际化场景进行了优化。尽管仅用 12T 数据训练,依然在多项主流基准上表现优异,并以 Apache-2.0 许可证开放商用。
核心特性

  1. 灵活的思维预算控制:允许用户根据需求灵活调整推理长度,这一动态控制推理长度的能力提升了实际应用场景中的推理效率。例如,对于简单任务,可设置较短预算;复杂任务则可延长预算。
  2. 增强的推理能力:在推理任务上进行了专门优化,同时保持了均衡且出色的通用能力,在 BBH、AGIEval-en 等推理相关基准测试中成绩较好。
  3. 智能代理能力:在工具使用和问题解决等代理任务中表现卓越,如在 TAU1-Retail 等代理相关测试里有突出表现。
  4. 研究友好性:考虑到预训练中合成指令数据的加入可能影响训练后研究,团队发布了包含和不包含指令数据的两种预训练模型,为研究社区提供了更多样化的选择。
  5. 原生长上下文:原生支持高达 512K 的长上下文,在 RULER(128K)等长上下文测试中表现出色。

模型架构方面,Seed-OSS采用了成熟稳定的设计:

360亿参数的稠密模型(不是MoE),使用了RoPE位置编码、GQA注意力机制、RMSNorm归一化和SwiGLU激活函数。整个模型有64层,隐藏层维度5120,词汇表大小155K。

参数详情
参数规模36B
注意力机制GQA
激活函数SwiGLU
层数64
QKV 头数80 / 8 / 8
头大小128
隐藏层大小5120
词汇表大小155K
上下文长度512K
RoPE 基础频率1e7

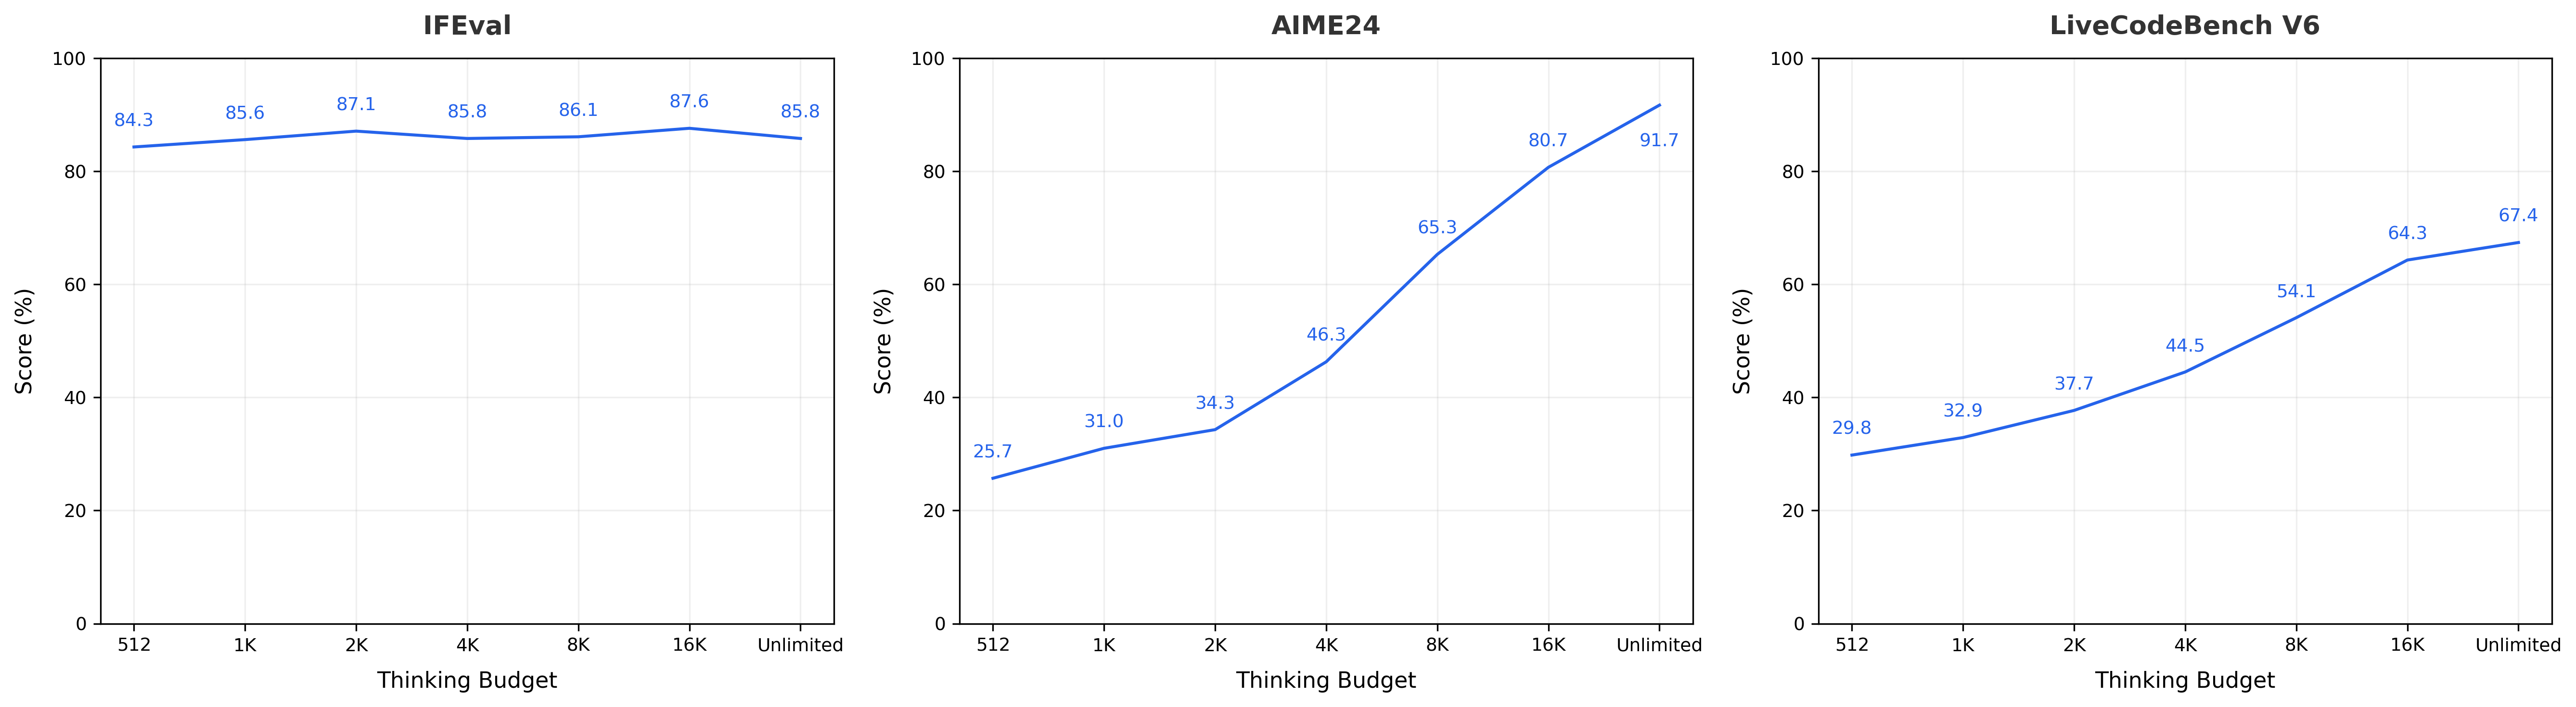
Seed-OSS-36B一大特色是支持用户设置thinking budget参数来灵活指定模型的思考预算,和谷歌的Gemini 2.5 Flash一样。下图展示了在不同任务下,随着思考预算变化的性能曲线。对于较简单的任务(如 IFEval),模型的链式思维(CoT)较短,分数在思考预算增加时会出现波动;而在更具挑战性的任务(如 AIME 和 LiveCodeBench)中,模型的 CoT 更长,分数会随着思考预算的增加而提升。
eed-OSS-36B-Base

在多数基准测试中,预训练加入合成指令数据能提升性能,以下是部分关键基准测试结果:

  • 知识类:MMLU-Pro 得 65.1 分,MMLU 得 84.9 分,TriviaQA 得 82.1 分。
  • 推理类:BBH 得 87.7 分,AGIEval-en 得 70.7 分。
  • 数学类:GSM8K 得 90.8 分,MATH 得 81.7 分。
  • 编程类:MBPP 得 80.6 分,HumanEval 得 76.8 分 。
BenchmarkSeed1.6-BaseQwen3-30B-A3B-Base-2507*Qwen2.5-32B-Base*Seed-OSS-36B-Base
(w/ syn.)
Seed-OSS-36B-Base-woSyn
(w/o syn.)
Knowledge
MMLU-Pro7059.858.5 (55.1)65.160.4
MMLU88.882.784 (83.3)84.984.8
TriviaQA9176.27682.181.9
GPQA-D43.43729.331.735.2
SimpleQA17.17.26.15.87.4
Reasoning
BBH92.181.479.1 (84.5)87.787.2
AGIEval-en7866.465.670.770.1
Math
GSM8K93.18787.5 (92.9)90.890.3
MATH72.961.163.5 (57.7)81.761.3
Coding
MBPP83.678.877.8 (84.5)80.674.6
HumanEval7870.747.6 (58.5)76.875.6

同时也发布了不含合成指令数据的 Seed-OSS-36B-Base-woSyn 模型,其在部分测试中成绩与含合成数据模型接近,如 MMLU 得 84.8 分。

Seed-OSS-36B-Instruct

在与其他模型的对比中表现亮眼,部分关键结果如下:

  • 知识类:MMLU-Pro 得 82.7 分,MMLU 得 87.4 分。
  • 数学类:AIME24 得 91.7 分,AIME25 得 84.7 分,BeyondAIME 得 65 分。
  • 推理类:ArcAGI V2 得 40.6 分,KORBench 得 70.6 分。
  • 编程类:LiveCodeBench v6 得 67.4 分。
  • 指令遵循类:IFEval 得 85.8 分。
  • 代理类:TAU1-Retail 得 70.4 分,SWE-Bench Verified (OpenHands) 得 56 分 。
  • 多语言类:MMMLU 得 78.4 分。
  • 长上下文类:RULER (128K) 得 94.6 分。
  • 安全类:AIR-Bench 得 75.6 分。
BenchmarkSeed1.6-Thinking-0715OAI-OSS-20B*Qwen3-30B-A3B-Thinking-2507*Qwen3-32B*Gemma3-27BSeed-OSS-36B-Instruct
Knowledge
MMLU-Pro86.676.281.9 (80.9)81.867.582.7
MMLU90.681.7 (85.3)86.986.276.987.4
GPQA-D80.772.2 (71.5)71.4 (73.4)66.7 (68.4)42.471.4
SuperGPQA63.450.157.3 (56.8)49.3-55.7
SimpleQA23.76.723.68.6109.7
Math
AIME2490.392.7 (92.1)87.782.7 (81.4)-91.7
AIME258690.3 (91.7)81.3 (85)73.3 (72.9)-84.7
BeyondAIME60695629-65
Reasoning
ArcAGI V250.341.737.814.4-40.6
KORBench74.872.370.265.4-70.6
Coding
LiveCodeBench v6
(02/2025-05/2025)
66.863.860.3 (66)53.4-67.4
HLE13.912.7 (10.9)8.76.9-10.1
Instruction Following
IFEval86.392.888 (88.9)88.4 (85)90.485.8
Agent
TAU1-Retail63(54.8)58.7 (67.8)40.9-70.4
TAU1-Airline49(38)47 (48)38-46
SWE-Bench Verified
(OpenHands)
41.8(60.7)3123.4-56
SWE-Bench Verified
(AgentLess 4*10)
48.4-33.539.7-47
Multi-SWE-Bench17.7-9.57.7-17
Multilingualism
MMMLU84.377.4 (75.7)7979 (80.6)-78.4
Long Context
RULER
(128K)
94.578.794.577.5-94.6
Safety
AIR-Bench-----75.6

快速上手

1 、安装依赖

pip3 install -r requirements.txt
pip install git+ssh://git@github.com/Fazziekey/transformers.git@seed-oss

2、基础使用代码示例

from transformers import AutoModelForCausalLM, AutoTokenizer
import os
import re

model_name_or_path = "ByteDance-Seed/Seed-OSS-36B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(model_name_or_path)
model = AutoModelForCausalLM.from_pretrained(model_name_or_path, device_map="auto")  # 可根据需求使用 bfloat16 和/或移至 GPU
messages = [
    {"role": "user", "content": "How to make pasta?"},
]
tokenized_chat = tokenizer.apply_chat_template(
  messages, 
  tokenize=True, 
  add_generation_prompt=True, 
  return_tensors="pt", 
  thinking_budget=512  # 控制思维预算
)

outputs = model.generate(tokenized_chat.to(model.device), max_new_tokens=2048)
output_text = tokenizer.decode(outputs[0])

Seed-OSS-36B 仅仅是字节跳动进军开源大模型领域的起点,后续其大概率还会推出更多开源模型

QT里获取UUID当做唯一文件名称 阅读详情

相关推荐

链路监控pinpoint3.0.3安装部署(2)

本文详细介绍了Pinpoint 3.0.3分布式链路监控系统的安装部署过程。主要内容包括:1)数据库安装(HBase、MySQL、Redis、Pinot)的详细配置步骤;2)中间件Zookeeper和Kafka的安装;3)Pinpoint三大组件的部署:Collector、Web和Batch的配置文件修改和启动脚本。文章特别强调了使用-starter-exec.jar包的重要性,并提供了各组件所需的详细参数配置,包括数据库连接、Zookeeper地址、Kafka配置等关键信息。

zouzou_888的博客 1376

字节跳动Seed-OSS-36B-Instruct:开源大模型新标杆,512K长上下文与智能推理的完美融合

Seed-OSS-36B-Instruct是字节跳动Seed团队开发的开源大语言模型,采用Apache-2.0许可协议向全球开发者开放。特性参数参数规模36B注意力机制GQA激活函数SwiGLU层数64词汇量155K上下文长度512K训练数据量12T tokens最引人注目的是其原生支持512,000 tokens的超长上下文窗口,这一数字是Llama3-70B(8K)的64倍,是Qwen3-32B(32K)的16倍,为处理长文档、代码库和复杂对话提供了前所未有的能力。

AI浩 2004

【一文搞懂几种常用推荐算法】

协同过滤:适合用户-物品交互数据丰富的场景。矩阵分解:能处理稀疏数据,适合显式评分预测。基于内容:依赖物品特征,解决冷启动问题。NMF:适用于非负数据(如点击率、购买记录)。根据实际需求选择算法,或结合多种方法构建混合推荐系统。

专注技术的博主 2637

【干货收藏】字节跳动Seed-OSS-36B大模型部署全攻略:512K上下文与H200性能实测!

本文详细介绍了字节跳动Seed-OSS-36B大模型的部署与性能测试。该模型拥有原生512K上下文窗口,支持灵活的"思考预算"机制。作者通过vLLM 0.10.2版本在H200显卡上成功部署,测试显示并发处理下可达1500+Tokens/s的速度。模型在长文本处理、数学推理、代码生成等方面表现优异,尤其在RULER测试中达到94.6分,创下开源模型最高分,相比Qwen3-32B有明显优势。

WANGJUNAIJIAO的博客 1809

贝塞尔曲线原理--曲线生成--路径规划--matlab代码

贝塞尔曲线有着很多特殊的性质, 在图形设计和路径规划中应用都非常广泛, 在路径规划中贝塞尔曲线完全由其控制点决定其形状, n个控制点对应着n-1阶的贝塞尔曲线,并且可以通过递归的方式来绘制.

bob595078694的博客 1万+

数字IC设计随笔之二(VCS、DVE|Verdi单步调试)

VCS+Verdi单步调试

ic疾风传 1万+

今天,字节开源Seed-OSS-36B模型,512k上下文

字节跳动Seed团队开源Seed-OSS系列大模型,包含36B参数的Base和Instruct版本,采用Apache-2.0许可。

计算机科研圈的博客 815

从315MHz到125kHz:手把手教你用Arduino模拟汽车钥匙的RKE/PKE信号(附代码)

本文详细介绍了如何使用Arduino开发板和射频模块模拟汽车钥匙的RKE/PKE信号,包括硬件准备、代码实现和安全机制。通过实践教程,读者可以深入理解315MHz和125kHz信号在汽车电子领域的应用,掌握无钥匙进入系统的核心技术。

weixin_30945039的博客 223

字节跳动开源Seed-OSS:36B参数模型以512K上下文与可控思考预算重新定义AI实用主义

在过去几年中,AI大模型的“军备竞赛”为我们呈现了一场又一场数字奇观。模型的参数量从百亿迅速攀升至万亿,上下文窗口也从几千扩展到几十万。AI的“蛮力”越来越大,但它的“巧劲”在哪里?我们常常觉得自己面对的是一个能力强大却难以捉摸的“黑箱”。它时而表现出惊人的创造力,时而却输出毫无逻辑的内容;我们无法得知为了回答一个简单问题,它在背后消耗了多少计算资源;更无法控制它在处理复杂任务时应当投入多少“思考深度”。现在,字节跳动Seed团队带着其首次开源的大语言模型Seed-OSS,给出了一个明确的答案。这款。

2302_81153890的博客 804

分布式定时任务(XXL-JOB)整合达梦数据库 带源码

背景 1. 因公司需要可视化管理配置调度任务,查询项目选择XXL-JOB,它是开源项目,入手很简单,详情可以参考官方文档; 2. 因项目的机密性,选择数据库为国内知名的达梦数据库7,与Java项目的整合详情可以参考SpringBoot 集成 达梦数据库 maven依赖本地jar包; 3. 因XXL-JOB暂时没有找到集成达梦数据库的案例,博主自己整合DM7踩过很多的坑,特此整合一个简单可直接...

艾斯-李的博客 3814

集成库仑计移动电源设计:从原理到实战,实现精准电量管理

在电池供电设备中,精准的电量计量是提升用户体验和产品可靠性的核心技术。传统基于电压估算的方法因受温度、负载和老化影响误差较大,而库仑计技术通过直接测量充放电电流并对时间积分,实现了电荷量的直接计量,从根本上提升了精度。这项技术的核心价值在于为设备提供了真实、可靠的电量状态数据,是智能电池管理系统的基础。其应用场景广泛,从消费电子如移动电源、智能穿戴,到工业与汽车领域如储能系统、新能源汽车的电池管理都不可或缺。本文以移动电源为例,深入解析了集成库仑计方案的硬件设计要点,特别是围绕高精度采样电阻与差分放大器的电

weixin_33453726的博客 551

51c深度学习~合集8

方法的完整数学描述略显复杂,如果只是想了解主要思想,可以只看上面 PatchMix的流程图即可(其实只是公式多,每个公式也不复杂,后续有机会做个演示动画,帮助大家理解。这个方法也可以用简单的 Mask 方法实现,但是本方法在大规模图像处理上效率是最高的),对该工作感兴趣的同行可以看一下,我尽量写得清楚一些。结合 PatMix 的流程图,主要过程如下:由于混合图像和混合图像之间,重叠比例的不同,mix-to-mix label 中每一项的权重分数是不同的,根据上图,可以得到权重系数可以表示为。

whaosoft~aiotの开发板商城 2962

C#上位机+YOLO实时目标检测:摄像头采集+多线程推理+精度调优全流程

标注数据集:使用LabelImg工具标注目标对象,按YOLO格式整理数据集;模型训练:使用Ultralytics库训练自定义模型,提升特定目标的检测精度;训练参数优化:增加训练轮数(epochs=100200)、调整批次大小(batch=1632)、使用数据增强(flip、mosaic等)。摄像头采集:封装通用采集类,支持USB摄像头/网口相机,实现稳定帧读取与异常处理;多线程推理:采用“采集线程+推理线程+UI线程”解耦架构,使用线程安全队列传递帧数据,彻底解决界面卡顿;核心封装。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 673

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 224

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 398

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 246

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 501

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 201

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 199

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 558

AI前沿日报 · 2026-11-04 | 祛魅时刻:Astra“纯读权重“神话的崩塌

①Astra"裸权重通吃"被spaCy创始人Honnibal精准祛魅——仅1/3实验真裸读,数学能力提升依赖Python+50次迭代;②Simon Willison用Qwen 3.8-27B端侧复现权重空间编程;③Nvidia开源Auto-Ontology自动知识图谱;④$800开源全域抓取机器人Stringman;⑤OpenAI悄然重开Codex训练开关引信任危机;⑥DeepMind发布Gemini 4 Argon机器人基础模型;⑦美国科技巨头隐性AI债务达3.2万亿美元,6个月增90%。

johnsong2009的博客 574

大模型 Embedding 与向量相似度详解

Embedding 解决的问题:计算机不懂文字,但懂数字│▼文本 → 向量(1024维浮点数数组)│▼相似度解决的问题:怎么判断两个向量(文本)有多接近│▼余弦相似度:看向量方向的夹角,越接近0°越相似│▼最终效果:语义搜索——理解意思,而非字面匹配一句话总结:Embedding 把文字变成数字,余弦相似度比较数字的方向,两者结合实现了"理解语义"的搜索。

T3165919332的博客 90

GPT-1 架构和计算细节

下面配合框图,对 GPT-1 的每个组件做公式展开 + 数值实例(配置:12 层 × 768,12 头,FFN 3072,词表 40478,共 117M 参数)。GPT-1 把翻译模型的编码器-解码器砍掉一半,只留解码器,然后以"预测下一个词"为目标在 BooksCorpus 上预训练。与 2017 原版的四个架构差异(框图中标 ★):h0=E[token]+Epos[position],E∈R40478×768, Epos∈R512×768h^0 = E[\text{token}] + E_{pos}[\

eloudy的专栏 278

终端 AI 审计与 “龙虾” 类智能体风险治理:从可见性到闭环溯源

生成式 AI 办公普及之后,数据泄露风险逐步下沉到终端。员工将合同、源代码、客户资料粘贴至公有大模型,以及龙虾(OpenClaw)这类本地开源 AI 智能体的滥用,成为企业安全新挑战。传统网络边界防护存在审计盲区,本文从风险链路拆解、核心能力模型、分级治理策略、落地踩坑点以及技术局限性多角度,分享终端侧 AI 安全治理的实践思路。

2401_86491085的博客 640

2.53 基于极稀疏指纹的室内定位注意力图元学习

该论文发表于IEEE Transactions on Mobile Computing(TMC)2026年6月,面向极稀疏指纹条件下的WiFi室内定位,针对指纹采集人力成本高、标记指纹稀缺时定位精度大幅下降的痛点,提出注意力图元学习模型AGML(Attentional Graph Meta‑Learning),结合图神经网络、元学习、两种指纹数据增强与分布对齐技术,在标记指纹极少的场景实现高精度室内定位,同时公开了多套真实+仿真定位数据集用于基准测试。场景:二维室内空间,障碍物造成信号遮挡,

weixin_42963026的博客 338
上一篇: DeepSeek V3.1 深度技术解读:从架构到应用的核心突破与系统评估对比
下一篇: OneThingAI「Wan2.2」镜像上架
OneThingAI
博客等级 码龄2年 135粉丝 44原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值