论文阅读:Attention is All you Need

常学常新:《Attention Is All You Need》万字解读! 阅读详情

Abstract


贡献:

提出了Transformer,完全基于注意力机制,摒弃了循环和卷积网络。

结果:

本模型在质量上优于现有模型,同时具有更高的并行性,并且显著减少了训练时间。

1. Introduction


  • long short-term memory(LSTM)——长短期记忆网络
  • gated recurrent neural networks——门控循环神经网络

循环模型通常沿着输入和输出序列的符号位置来分解计算。通过将位置与计算时间步骤对齐,它们生成一系列隐藏状态 ht,作为前一个隐藏状态 ht−1 和位置 t 的输入的函数。

Transformer完全摒弃循环网络、完全依赖注意力机制来捕捉输入和输出之间全局依赖关系的模型架构。
显著允许增加并行化。

2. Background


减少序列计算。

  • Extended Neural GPU
  • ByteNet
  • ConvS2S
    在这些模型中,关联任意两个输入或输出位置信号所需的操作次数随着位置之间的距离而增加。

Self-attention,是一种通过关联同一序列中不同位置来计算该序列表示的注意力机制。

End-to-end memory networks,基于一种循环注意力机制,而不是与序列对齐的循环网络。

Transformer是第一个完全依赖自注意力来计算输入和输出表示的转换模型,没有使用与序列对齐的RNN或卷积网络。

3. Model Architecture


编码器输入x,输出z;解码器输入z,输出y。
在每一步,模型都是自回归的,在生成下一步时,使用先前生成的符号作为附加输入。
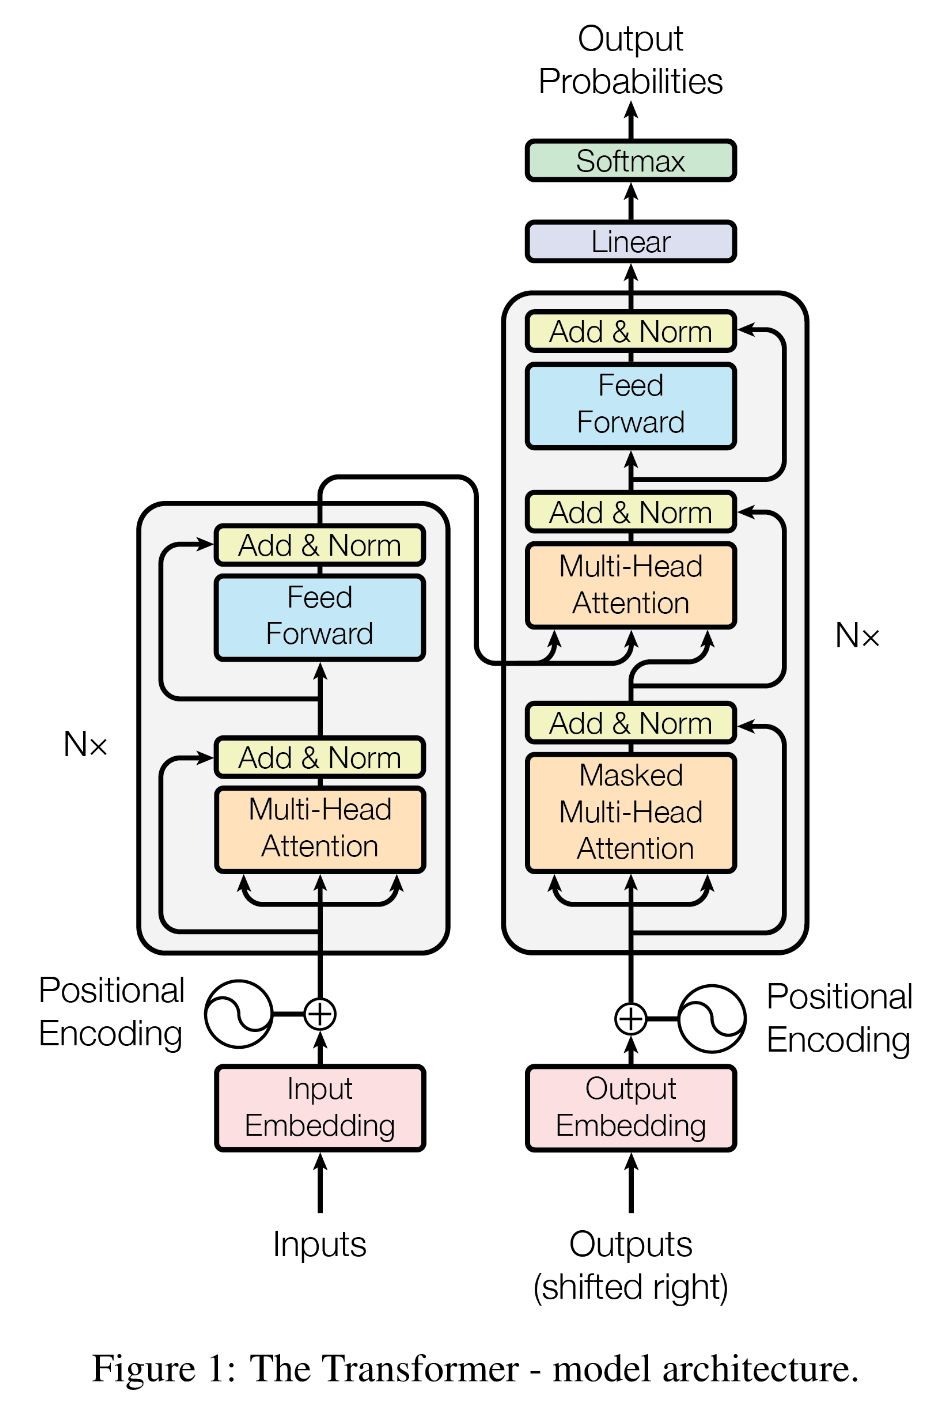
image.png

3.1 Encoder and Decoder Stacks


编码器:

N=6,每个两层。
第一层,多头自注意力机制;
第二层,逐位置全连接前馈网络。
残差连接,层归一化,即:LayerNorm(x + Sublayer(x))。
维度dmodel=512d_{model} = 512dmodel​=512。

解码器:

N=6,每个三层。
二三层同上。
第一层,掩码多头自注意力机制。
这种掩码机制结合输出嵌入偏移一个位置,确保位置 i 的预测只能依赖于位置 i 之前已知的输出。

3.2 Attention


注意力函数可以描述为将查询(query)和一组键-值对(key-value pairs)映射到一个输出,其中查询、键、值和输出都是向量。
输出是根据值(value)的 加权和 计算得到的,权重是通过查询(query)与相应键(key)之间的兼容性函数计算得出的。

3.2.1 Scaled Dot-Product Attention——缩放点积注意力
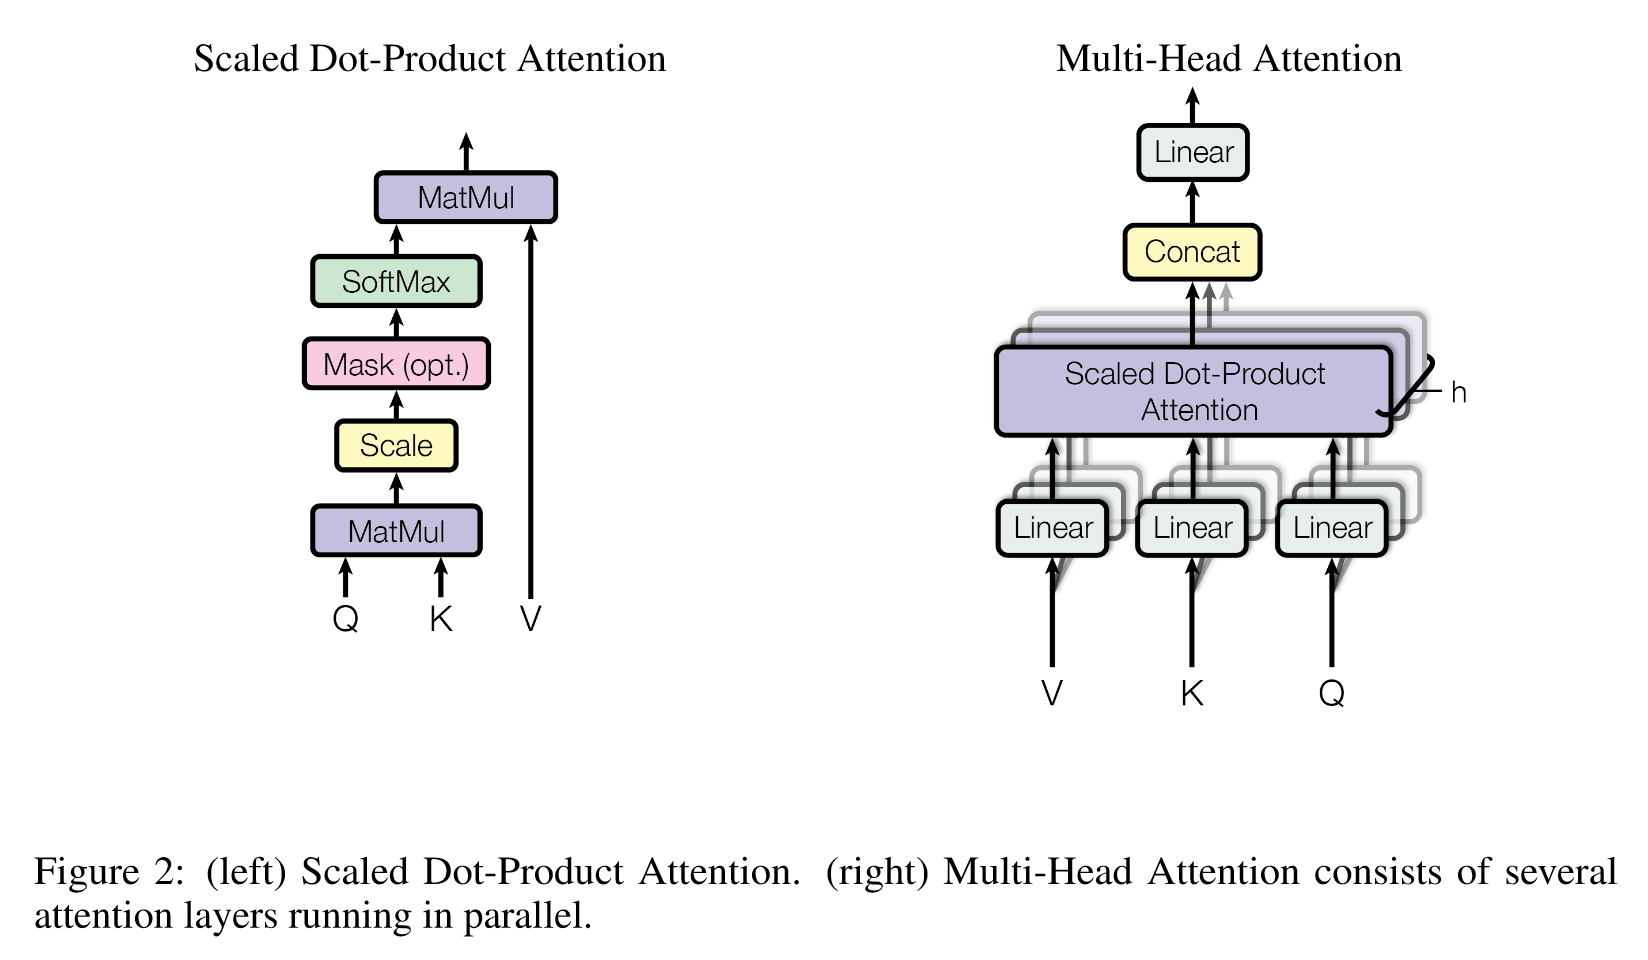

image.png
输入由维度为 dk 的查询和键以及维度为 dv 的值组成,计算查询与所有键的点积,将每个点积除以 dk\sqrt{d_k}dk​​,并应用 softmax 函数以获得值的权重。
在实际应用中,会同时对一组查询计算注意力函数,使用矩阵计算。

输出矩阵:
Attention(Q,K,V)=softmax(QKTdk)VAttention(Q, K, V) = softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)VAttention(Q,K,V)=softmax(dk​​QKT​)V

  • 加性注意力
  • 点积注意力

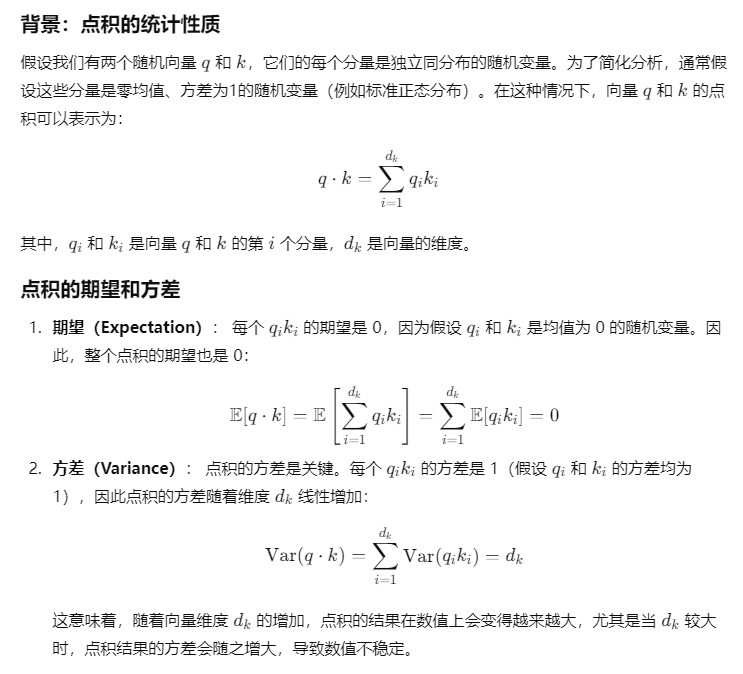
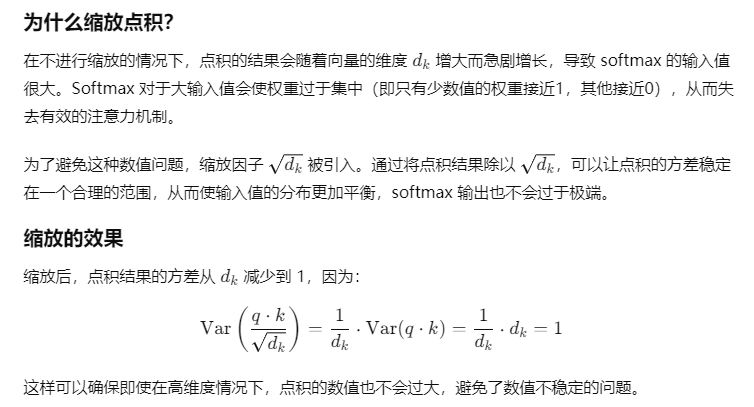
对于较大的 dk 值,如果没有缩放,点积的数值可能会变得很大,从而将 softmax 函数推入梯度极小的区域,所以缩放dk\sqrt{d_k}dk​​ 。

为什么选择 dk\sqrt{d_k}dk​​​​ 而不是其他数,这与点积结果的统计性质有关。
image.png
image.png

3.2.2 Multi-Head Attention


h=8,dk=dv=dmodel/h=64

将查询、键和值分别线性投影为 dk、dk 和 dv 维度的 h 次不同的线性投影。
在这些投影后的查询、键和值上并行执行注意力函数,得到 dv​ 维度的输出值。
输出拼接起来,并再次投影,得到最终的输出值。

多头注意力允许模型在不同的位置上同时关注来自不同表示子空间的信息。

多头注意力公式:
MultiHead(Q,K,V)=Concat(head1,…,headh)WOMultiHead(Q, K, V) = Concat(head_1, \dots, head_h) W^OMultiHead(Q,K,V)=Concat(head1​,…,headh​)WO
第 i 个头的注意力为:
headi=Attention(QWiQ,KWiK,VWiV)head_i = Attention(Q W^Q_i, K W^K_i, V W^V_i)headi​=Attention(QWiQ​,KWiK​,VWiV​)
投影矩阵分别为:
WiQ∈Rdmodel×dk,WiK∈Rdmodel×dk,WiV∈Rdmodel×dv,WO∈Rhdv×dmodel.W^Q_i \in \mathbb{R}^{d_{model} \times d_k}, \quad W^K_i \in \mathbb{R}^{d_{model} \times d_k}, \quad W^V_i \in \mathbb{R}^{d_{model} \times d_v}, \quad W^O \in \mathbb{R}^{h d_v \times d_{model}}.WiQ​∈Rdmodel​×dk​,WiK​∈Rdmodel​×dk​,WiV​∈Rdmodel​×dv​,WO∈Rhdv​×dmodel​.

3.2.3 Applications of Attention in our Model


编码器-解码器注意力层:

查询来自前一层的解码器,键和值来自编码器的输出。

编码器自注意力层:

键、值和查询全部来自同一个地方,它们都来自编码器中前一层的输出。

解码器自注意力层:

允许解码器中的每个位置关注解码器中该位置及之前的所有位置。
需要阻止解码器中的左向信息流动。

3.3 Position-wise Feed-Forward Networks——按位置的前馈网络


编码器和解码器中的每一层还包含一个全连接的前馈网络。
该网络由两次线性变换构成,中间使用 ReLU 激活函数:
FFN(x)=max⁡(0,xW1+b1)W2+b2FFN(x) = \max(0, xW_1 + b_1)W_2 + b_2FFN(x)=max(0,xW1​+b1​)W2​+b2​
线性变换在不同位置之间是相同的,但它们在不同层次之间使用不同的参数。

另一种描述方式是将其看作两个卷积,卷积核大小为1。输入和输出的维度为 dmodel=512,而内部层的维度为 dff=2048。

3.4 Embeddings and Softmax——嵌入和Softmax


使用学习到的嵌入(embeddings)来将输入标记(tokens)和输出标记转换为dmodel维的向量。
使用常规的线性变换和 Softmax 函数将解码器的输出转换为预测的下一个标记的概率。
在两个嵌入层和 Softmax 之前的线性变换中共享相同的权重矩阵。
在嵌入层中,将这些权重乘以 dmodel\sqrt{d_{model}}dmodel​​ ​​。

3.5 Positional Encoding——位置编码


在编码器和解码器堆栈的底部将“位置编码”添加到输入嵌入中。
位置编码的维度与嵌入相同,均为 dmodel​,这样两者可以相加。
位置编码使用不同频率的正弦和余弦函数:
PE(pos,2i)=sin⁡(pos100002idmodel)PE(pos, 2i) = \sin\left(\frac{pos}{10000^{\frac{2i}{d_{model}}}}\right)PE(pos,2i)=sin(10000dmodel​2i​pos​)
PE(pos,2i+1)=cos⁡(pos100002idmodel)PE(pos, 2i+1) = \cos\left(\frac{pos}{10000^{\frac{2i}{d_{model}}}}\right)PE(pos,2i+1)=cos(10000dmodel​2i​pos​)
pos 是位置,i 是维度。
位置编码的每个维度都对应于一个正弦波。
对于任何固定的偏移量 k,位置 PEpos+kPE_{pos+k}PEpos+k​​ 可以表示为位置 PEposPE_{pos}PEpos​​ 的线性函数。

4. Why Self-Attention


自注意力层与
将一个可变长度的符号表示序列(x1, …, xn)映射到另一个等长度的序列(z1, …, zn)的循环层和卷积层
进行比较。

  • 总计算复杂度
  • 并行化的计算量
  • 长距离依赖的路径长度

学习长距离依赖,一个关键因素是前向和后向信号在网络中必须穿过的路径长度。输入和输出序列中任意位置组合之间的这些路径越短,学习长距离依赖就越容易。
比较了由不同类型层组成的网络中任意两个输入和输出位置之间的最大路径长度。
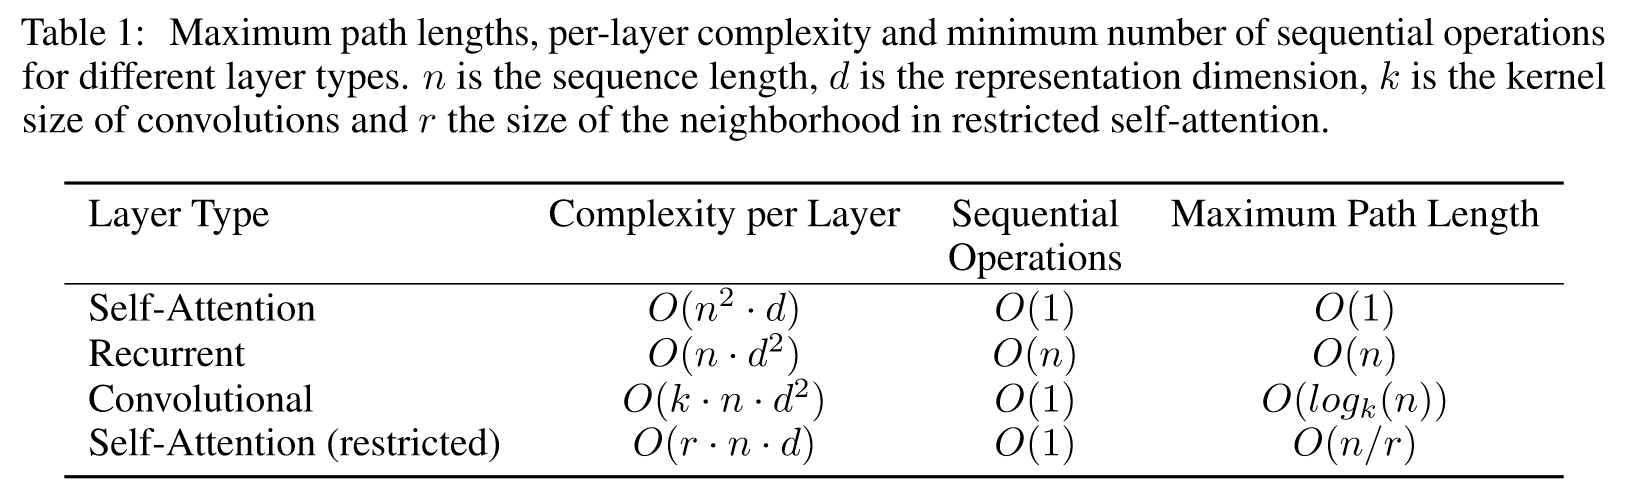
image.png

在计算复杂度方面,当序列长度n小于表示维度d时,自注意力层比循环层更快。

为了提高涉及非常长序列的任务的计算性能,自注意力可以限制为仅考虑输入序列中以相应输出位置为中心的、大小为r的邻域。这将使最大路径长度增加到O(n/r)。

具有核宽度k < n的单个卷积层不会连接所有输入和输出位置对。在连续核的情况下,这需要堆叠O(n/k)个卷积层;在膨胀卷积的情况下,则需要O(logk(n))个卷积层。

不仅单个注意力头明显学会了执行不同的任务,而且许多注意力头似乎表现出与句子句法和语义结构相关的行为。

可分离卷积大大降低了复杂度,降至O(k · n · d + n · d^2)。

5. Training


5.1 Training Data and Batching


  • WMT 2014英德数据集
  • 每个训练批次包含一组句子对,其中包含大约25,000个源标记和25,000个目标标记。

5.2 Hardware and Schedule


  • 8个NVIDIA P100 GPU
  • 基础模型训练了100,000个步骤,12小时
  • 大型模型训练了300,000个步骤,3.5天

5.3 Optimizer


  • Adam优化器
  • β1=0.9\beta_1 = 0.9β1​=0.9、β2=0.98\beta_2 = 0.98β2​=0.98 和 ϵ=10−9\epsilon = 10^{-9}ϵ=10−9

学习率公式:
lrate=dmodel−0.5⋅min⁡(step_num−0.5,step_num⋅warmup_steps−1.5)lrate = d_{\text{model}}^{-0.5} \cdot \min(\text{step\_num}^{-0.5}, \text{step\_num} \cdot \text{warmup\_steps}^{-1.5})lrate=dmodel−0.5​⋅min(step_num−0.5,step_num⋅warmup_steps−1.5)
对应于在前 warmup_stepswarmup\_stepswarmup_steps 个训练步骤中线性增加学习率,此后按步数的平方根倒数比例减少学习率。
设置 warmup_steps=4000warmup\_steps = 4000warmup_steps=4000 。

5.4 Regularization


三种正则化方法:

残差 Dropout:

每个子层的输出加入残差并进行归一化之前应用 dropout。
编码器和解码器堆栈中的嵌入和位置编码的和上应用 dropout。
dropout 率为 Pdrop=0.1P_{drop} = 0.1Pdrop​=0.1

标签平滑:

值为 ϵls=0.1\epsilon_{ls} = 0.1ϵls​=0.1。
影响困惑度,因为模型会学得不那么确定,但能提高准确度和 BLEU 分数。

6. Results


6.1 Machine Translation
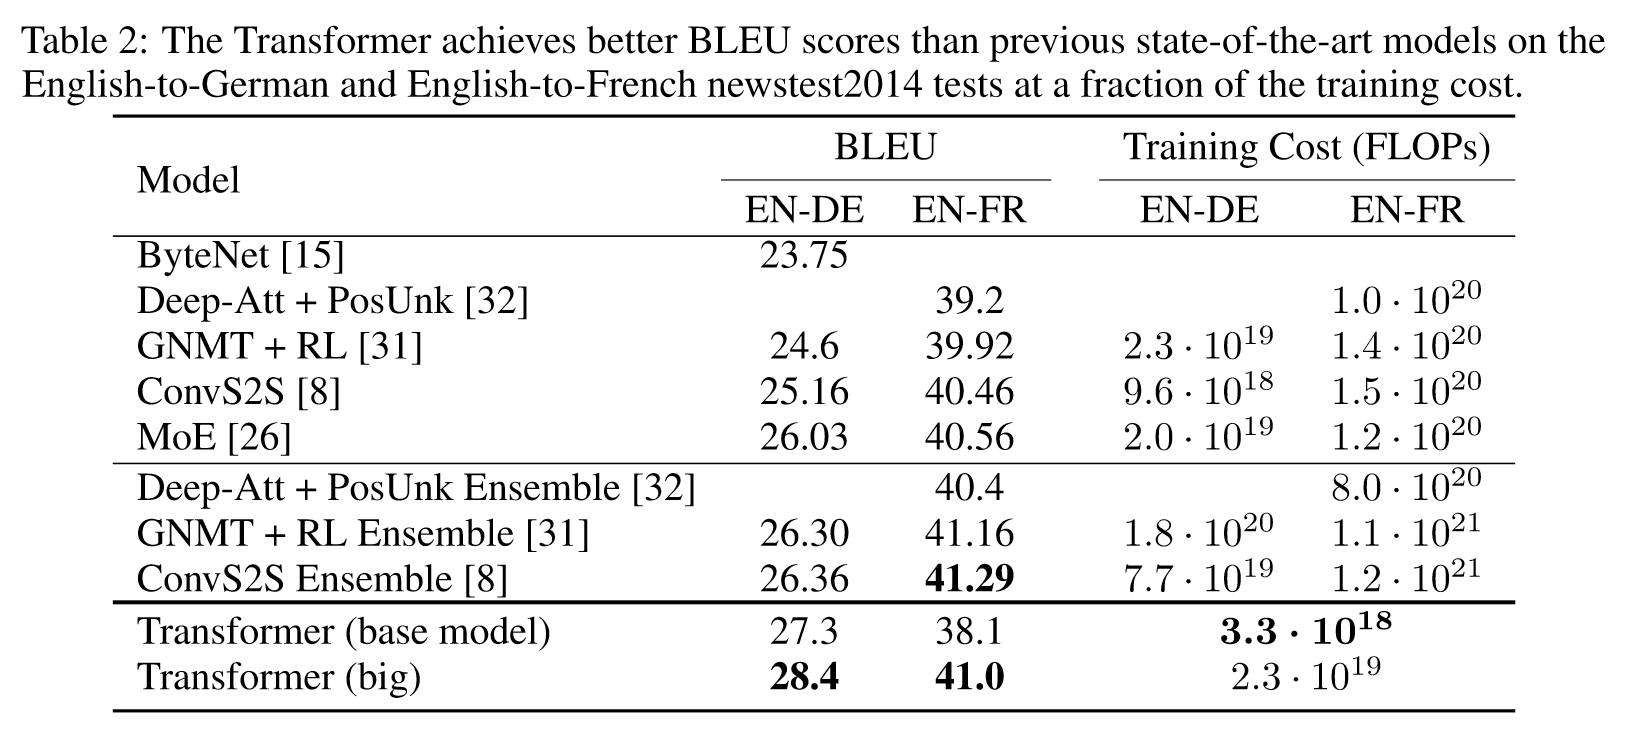

image.png

6.2 Model Variations


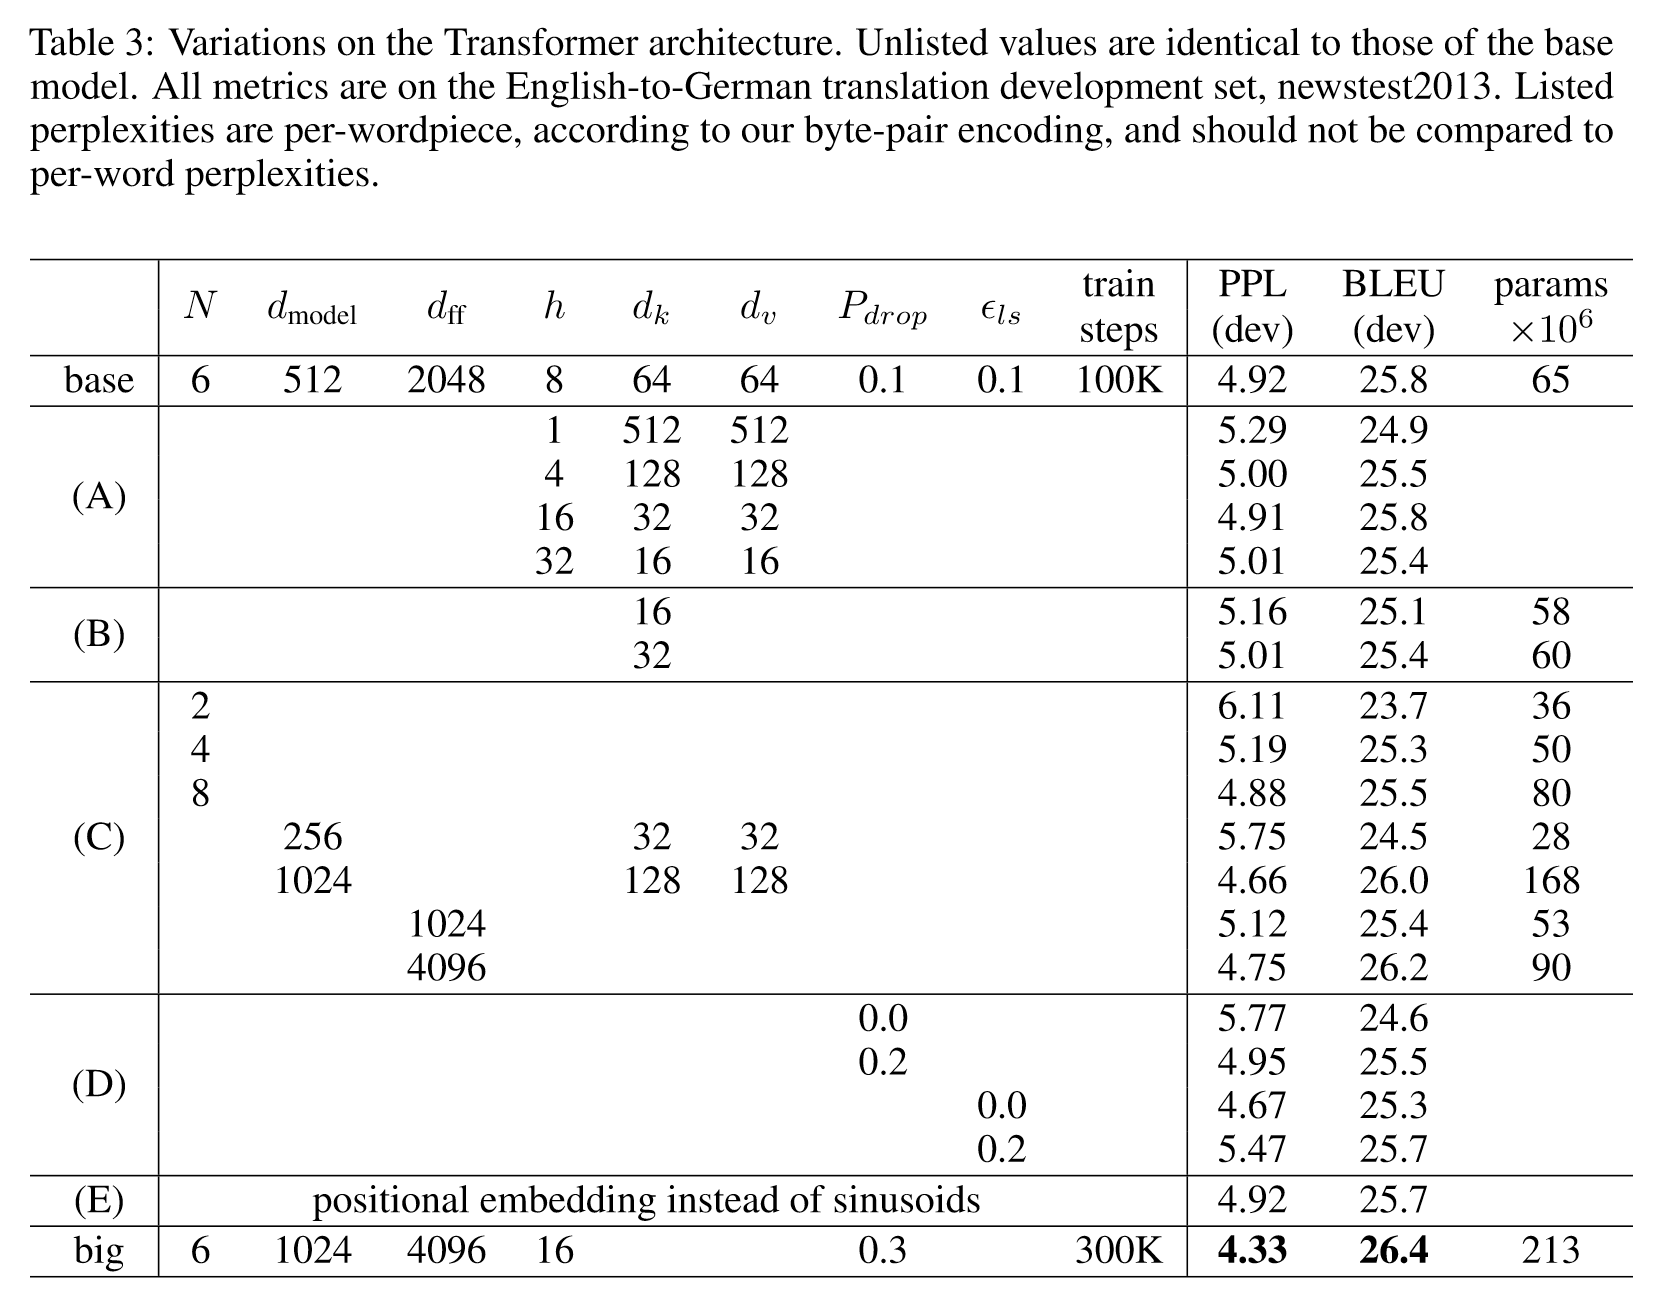
image.png

7. Conclusion


Transformer,这是第一个完全基于注意力机制的序列转换模型,它用多头自注意力替代了在编码器-解码器架构中最常用的循环层。

计划将 Transformer 扩展到涉及文本以外的输入和输出模式的问题中,并研究局部、受限的注意力机制,以便高效处理如图像、音频和视频等大型输入和输出。减少生成过程的顺序性也是研究目标之一。

【论文阅读】Attention is all you need(Transformer) 文章目录前言1.Abstract2.Introduction3.Background4.Model Architecture4.1. Encoder and Decoder Stacks4.2. Attention4.2.1. Scaled Dot-Product Attention4.2.2.Multi-Head Attention4.2.3. Applications of Attention in our Model4.3. Position-wise Feed-Forward Networks4.4 阅读详情

相关推荐

【大模型系列篇】论文解读:Transformer - Attention Is All You Need

当今大模型初学者必读的一篇论文,已经有不少业内大佬都翻译解读过这篇论文,此处仅作为自己学习的记录。该论文是由谷歌机器翻译团队于2017年发表在NIPS ,提出了一个只基于attention的结构来处理序列模型相关的问题,比如机器翻译。相比传统的CNN与RNN来作为Encoder-Decoder的模型,谷歌这个模型摒弃了固有的方式,并没有使用任何的CNN或者RNN的结构,该模型可以高度并行的工作,相比以前串行并且无法叠加多层、效率低的问题。

木亦汐丫 4647

Attention Is All You Need

Attention Is All You Need 注意力机制是你需要的全部 Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, Illia Polosukhin attention [ə'tenʃ(ə)n]:n. 注意,关注,注意力,关心 int. 注意,立正 attention mechanism:注意力机制 Computer Science,CS:

程永强 4万+

PSCAD学习笔记(1)Project Settings(重点snapshot设置)

若不勾选,则横坐标为实际时间2-7s,故障显示在第3s发生。图片中时间坐标轴显示为0-5s,故障时刻显示为第1s,即0-1s展示系统稳态,1-5s展示系统发生故障后的暂态响应,如何通过快照文件实现?勾选该项后,使用快照文件启动仿真会将仿真起始时间强制设置为0s,反之不勾选则依据快照文件保存的时间轴继续(即坐标为实际时间)。如果已有的快照文件保存的是0s至5s的仿真内容,则仿真运行时间从5s开始,到10s结束。如果已有的快照文件保存的是0s至2s的仿真内容,则仿真运行时间从2s开始,到7s结束;

gwenh的博客 7345

【翻译】Attention Is All You Need

论文地址:https://proceedings.neurips.cc/paper/2017/file/3f5ee243547dee91fbd053c1c4a845aa-Paper.pdf 项目地址:https://github.com/ tensorflow/tensor2tensor

jokerwu192的博客 3万+

倍福TwinCAT3 OPC UA配置全流程:从安装到无密码访问(附常见问题解决)

本文提供了倍福TwinCAT3 OPC UA配置的完整实战指南,重点讲解如何实现无密码游客访问。从软件安装、授权配置、服务器初始化到深度排错,详细解析了配置流程中的关键步骤与常见陷阱,帮助工程师高效打通PLC与上位系统的数据通讯通道。

vulkan6gpu的博客 473

YOLOv10改进 | 代码逐行解析(三) | YOLO中的Mosaic增强详解(新手入门必读系列)

本文给大家带来的是YOLOv10中的Mosaic增强代码的详解,可能有部分人对于这一部分比较陌生,有的读者可能知道Mosaic增强但是不知道其工作原理,具体来说Mosaic增强就是指我们的数据集中的图片在输入给模型之前的一个处理过程(我们的图片并不是直接就输入给模型了,大家的训练结果中的结果检测图片大家可以看到数据集中多个图片会组合在一起这就是简单的Mosaic增强),下面我就来讲解一下其在YOLOv10中工作原理和代码定义,下面图片为一个Mosaic增强后的图片。​。

Snu77的博客 2077

论文阅读:Attention Is All You Need【注意力机制】

论文阅读:Attention Is All You Need 原文链接:Attention Is All You Need 作者: Ashish Vaswani;Noam Shazeer;Niki Parmar;Jakob Uszkoreit;Llion Jones;Aidan N. Gomez; Łukasz Kaiser;Illia Polosukhin 目录论文阅读:Attention Is All You Need摘要1 介绍2 背景3 模型架构3.1 编码器和解码器堆栈3.2 注意力机制3.2

南有芙蕖 8035

什么是 SAP S/4HANA 的 Brown Field 迁移和 Green Field 迁移

Brown Field实施涉及升级现有的 SAP 环境并继续使用一些遗留组件。它类似于传统升级,因为它涉及软件更新、一些数据转换和一些业务流程的调整。它仍然具有破坏性,但比Green Field实施要少得多。如果你是风险厌恶者,倾向于逐步使用 S/4HANA 的功能,或担心 S/4HANA Green Field方法的成本,那么你可能更喜欢这种方法。混合方法结合了Brown Field和Green Field迁移的一些元素。它从公司的 SAP 系统的副本开始,包括配置设置和定制。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1324

我读我自己——如何使用 GPT 阅读论文:以《Attention Is All You Need》为例

使用 GPT(如 ChatGPT)阅读和理解论文,您可以采用以下步骤,以经典论文《Attention Is All You Need》为例。这篇论文由 Vaswani 等人于 2017 年提出,开创了 Transformer 模型,是现代自然语言处理的基础。通过使用 GPT 分段阅读和解释论文,您可以快速掌握论文的核心内容,特别是像《Attention Is All You Need》这种经典论文。GPT 可以帮助您快速理解复杂概念,并在有疑问时进行快速解释。

Never Give Up 960

【OpenClaw企业级智能体实战】第27篇:Skill生态运营——企业私有Skill商店的搭建与审核机制

2026年ClawHavoc供应链攻击事件曝光超1200个恶意Skill渗透公共技能市场,工信部明确要求企业审慎使用第三方技能包并严格审查代码。本文基于真实安全事件与行业实践,完整讲解企业私有Skill商店从0到1搭建方案,覆盖小团队极简GitLab私有仓库、中大型企业Nacos 3.2私有Registry两种主流架构,配套企业级安全审核四步法、静态代码扫描规则、CI/CD自动化审计、数字签名校验与版本生命周期管理。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 501

EPLAN中2D安装板的绘制方法示例

EPLAN中2D安装板的绘制方法示例

Robot_PLC_HMI_Automation 3222

论文阅读:Attention is all you need

低维度的波长短变化快,高维度的波长长变化慢(导致整体出来的d_model维度的位置编码类似二进制数字),这种组合能为每个位置生成一个独一无二的编码纹理。此外,对于pos+k,其编码向量可以看作是位置pos的编码向量*一个与pos无关、只与k有关的线性变换矩阵,这意味着模型在计算 Attention时,能够很容易地学到相对位置信息(不是绝对位置100和105的关系,而是“相距5个单位之间的关系”),这使得模型具有更好的外推性,即在训练时只见过短句子,测试时遇到比训练集更长的句子,这种相对位置的规律依然成立。

yibulaxinwuhu的博客 1313

SAP Fiori 会话超时全解析:从 Launchpad 到 Identity Authentication 的统一策略

SAP Fiori会话超时机制解析与配置策略 本文深入探讨SAP Fiori项目中的会话超时机制,分析其对系统安全和用户体验的双重影响。文章系统拆解了SAP Fiori Launchpad与SAP Cloud Identity Services之间的会话超时工作原理,重点介绍了两种超时机制:服务器驱动的超时(通过SESSION_TIMEOUT_STOP_DATA_REFRESH参数控制)和UI驱动的超时(通过SESSION_TIMEOUT_INTERVAL_IN_MINUTES参数控制)。文中结合制造业产线

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 213

论文阅读笔记:Attention Is All You Need

论文阅读笔记:Attention Is All You Need

HollowKnightz的博客 3492

Ultralytics 框架中 model.predict() 返回的 results 对象的详细解析

通过掌握 results 对象的使用方法,您可以快速实现模型部署、数据分析与可视化。

浩瀚之水的专栏 749

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

论文阅读:Attention is all you need、Attention原理

[TOC] 这篇文章可以说是把Attention机制发扬光大的文章。提出了一个交Transformer的模型,对,就是变形金刚的那个transformer。Transformer模型只使用注意力机制(Attention mechanisms)来实现Encoder和Decoder,没有使用其他的RNN或者CNN。 Transformer模型是一个Seq2Seq的模型,即输入是一个序列,输出也为一个序列。 模型架构: 从模型架构上来看,主要有以下几个部分: 左侧是Encoder,右侧是Decoder,他们主

铁锹的填坑记录 1345

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

论文阅读(一):Attention Is All You Need

论文阅读:Attention Is All You Need 写在最前面:假期在家学习动力不足,为了更好的督促自己,准备每周至少分享一次论文阅读! 有些地方可能理解的不是很透彻,提前感谢各位大佬指正~ 论文主要内容(包含创新点以及不足) 提出了只用注意力机制的议长网络结构-transformer,这种网络结构避免了重复和卷积,有更好的并行能力,需要的训练时间也更少!!! 这也太厉害了吧,造轮子的人实锤。 首先介绍了RNN等递归神经网络在应用过程中的缺点,即其计算基本上都是固定顺序的,因为在隐

zoe的博客 673

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

论文阅读:Transformer Attention Is All You Need

在主流的序列转录模型中,主要是依赖复杂的循环网络或者卷积神经网络,这类模型都包含一个 Encoder 和 Decoder。在性能最好的模型里,通常会在编码器与解码器之间使用一个注意力机制进行连接。这篇文章提出了一个简单的架构,称为 Transformer,仅仅只依靠注意力机制,不再需要循环或者卷积。文章提出的模型,在两个机器翻译任务上取得了更好的效果,同时具备更好的并行化以及更少的训练耗时。同时模型泛化到其它任务上也有不错的表现。

Matrix-11 1549

论文阅读笔记:Attention is All You Need

Transformer

myblog 1138

Transformer论文阅读:Attention Is All You Need

Transformer论文阅读:Attention Is All You Need

m0_55034547的博客 934

论文阅读笔记:Attention: Self-Expression Is All You Need

论文阅读笔记:Attention: Self-Expression Is All You Need摘要简介 正在双盲审中的ICLR 2022论文 摘要 Transformer模型令人惊喜地同时在NLP和CV领域的各种学习任务中出色表现。Transformer的成功很大程度上归功于attention层的使用,该层通过注意力系数捕获数据token(如单词和图像块)之间的远程联系,注意力系数是全局的,并在测试时适应输入数据。在本文中,我们研究了注意力背后的原理及其与现有技术的联系。具体地说,我们证明了att

weixin_44876302的博客 1849

论文阅读:attention is all you need

1. 引言 RNN、LSTM和Gated RNN被认为是序列建模和翻译任务的SOTA。 循环神经网络通过一步一步地将输入和上一步的输出结果输入到模型中来得到下一步的输入。这个特点天生地让它只能用于串行计算,不能很好地利用并行化技术。虽然进来有一些用于改进的技术,但效果仍不理想。 注意力机制已经在序列化预测与转化任务中取得了广泛的应用,允许模型将不同位置的输入或输出建立联系。在少数情况下,注意力机制还被用于RNN中。 在这份工作中我们提出了Transformer,一种新的模型结构,抛弃了卷积和循环,仅仅使用注

baiwan_的博客 410
上一篇: 论文阅读:PET/CT Cross-modal medical image fusion of lung tumors based on DCIF-GAN
下一篇: 论文阅读:基于深度学习的肺肿瘤PET-CT图像融合
BulingQAQ
博客等级 码龄7年 335粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值