论文阅读:基于深度学习的肺肿瘤PET-CT图像融合

论文阅读:PET/CT Cross-modal medical image fusion of lung tumors based on DCIF-GAN 基于GAN的融合方法存在训练不稳定,提取图像的局部和全局上下文语义信息能力不足,交互融合程度不够等问题。 阅读详情
AI摘要

本文围绕基于深度学习的肺肿瘤PET - CT图像融合展开。介绍了基于协同学习机制的CNN肺肿瘤图像融合,包括网络架构、激活与损失函数等,还进行了相关实验。同时阐述了基于VGG19 - GAN的肺肿瘤图像融合,涉及框架、卷积网络、损失与激活函数及实验等内容。

3. 基于协同学习机制的 CNN 肺肿瘤图像融合


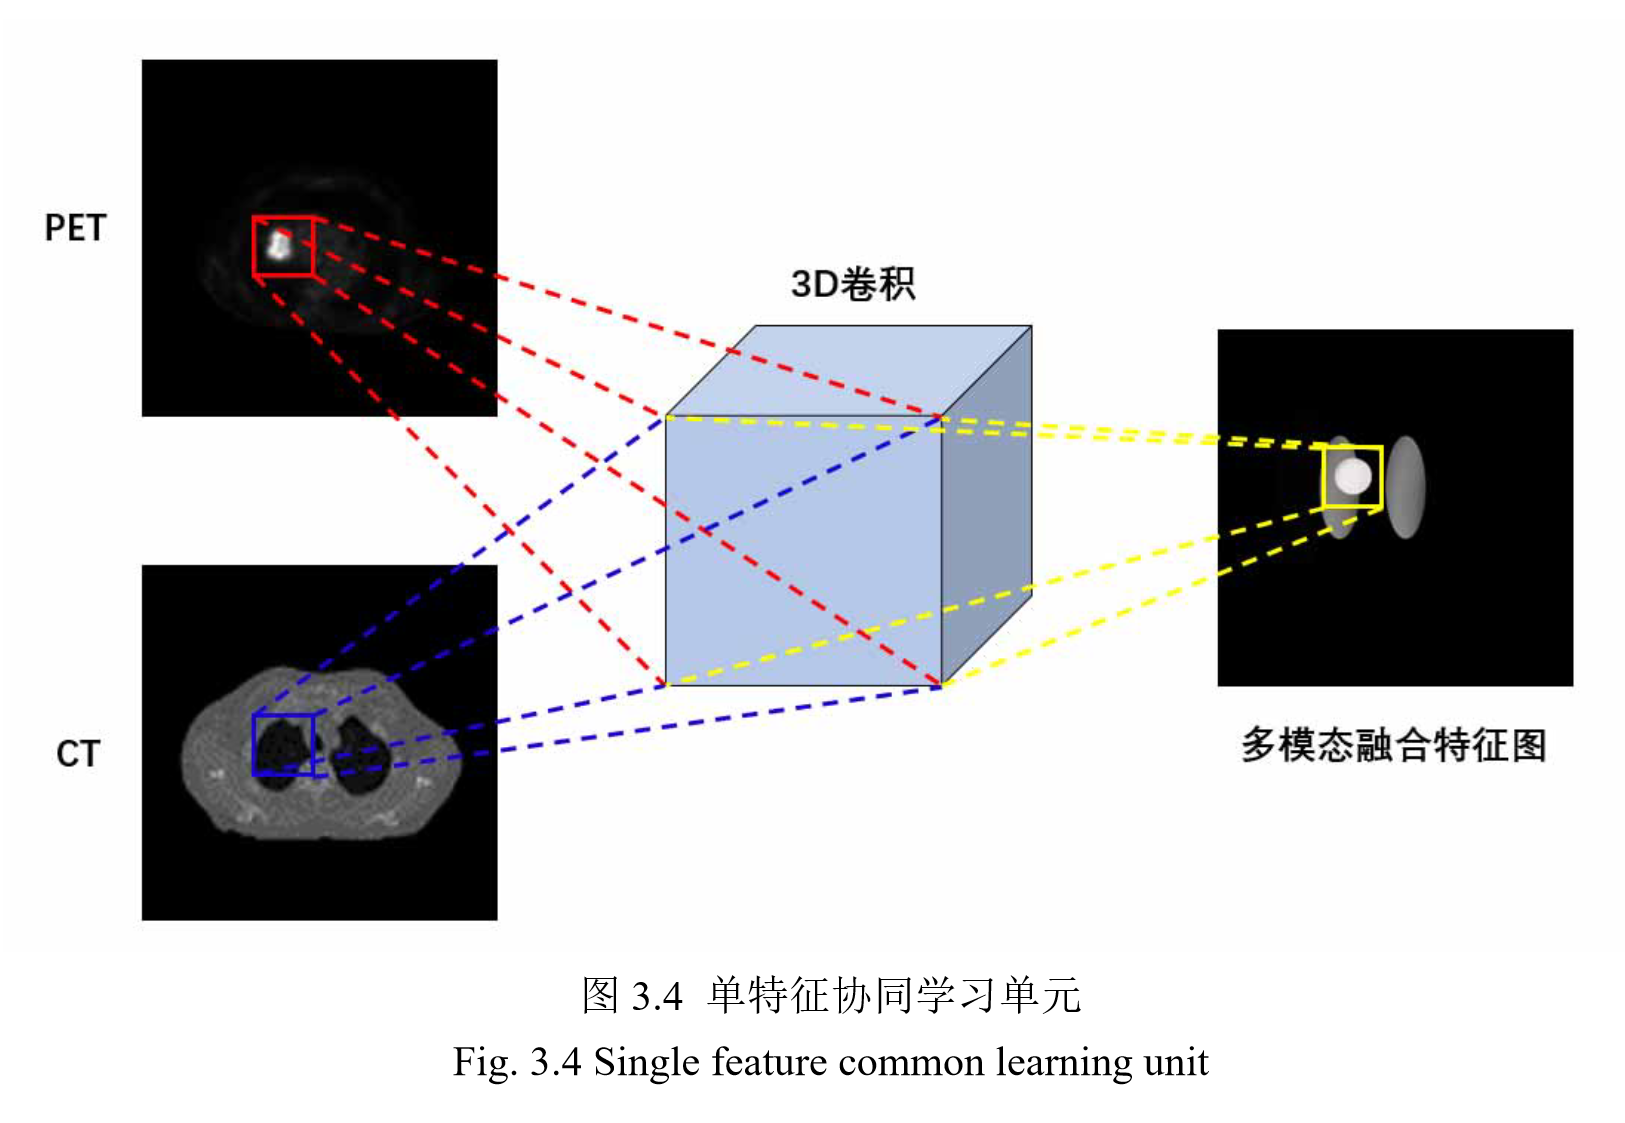
3.1 网络架构
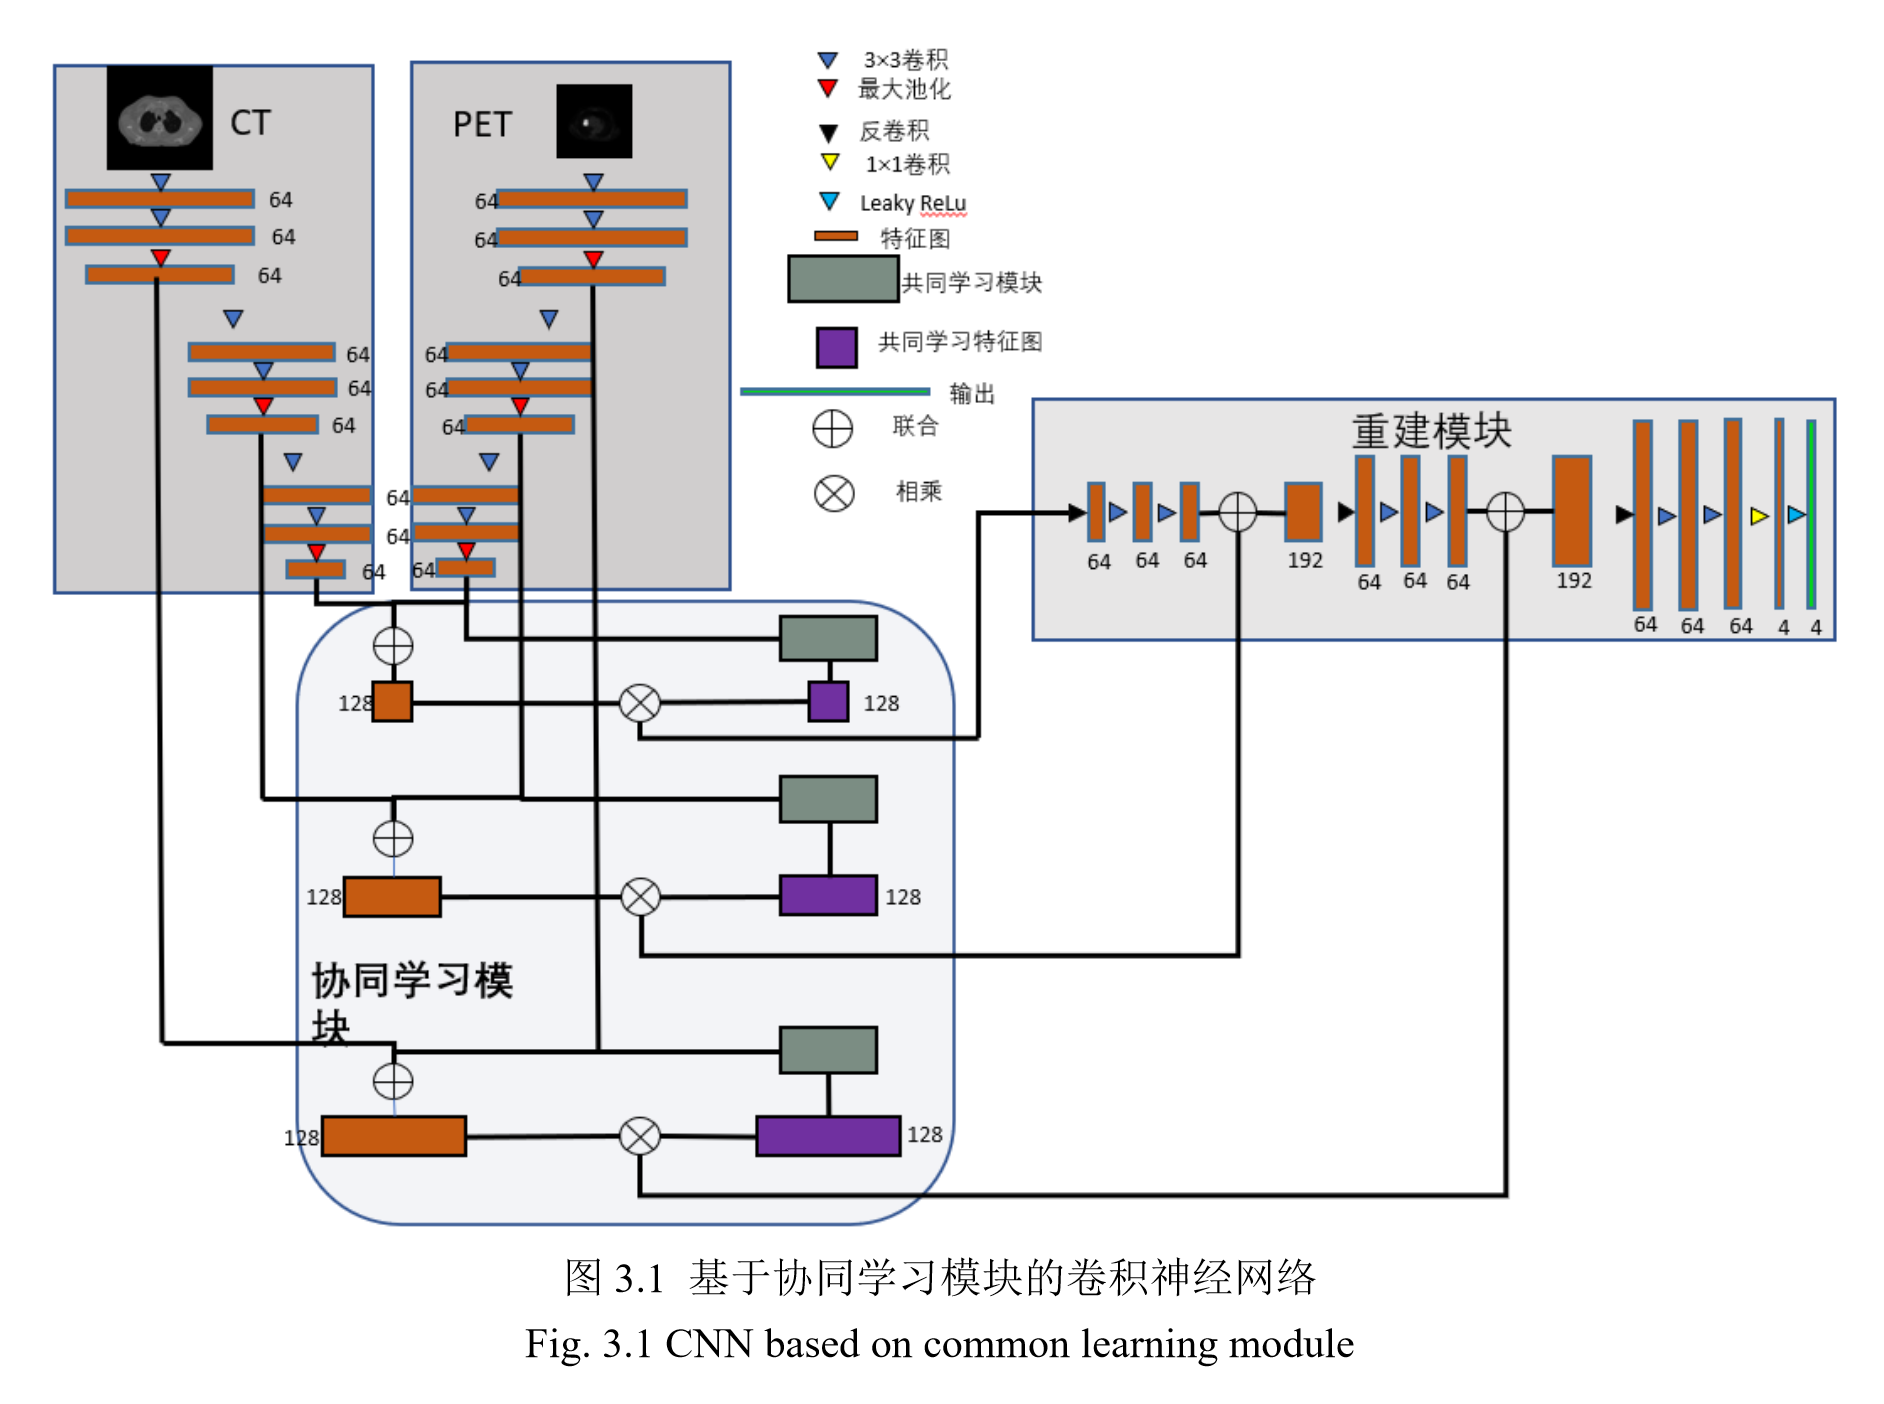

image.png
三部分:

  • 两个独立的编码器
  • 协同学习与融合模块
  • 图像重建部分

3.1.1 特定模态编码器


编码器:
(卷积层×2+最大池化层)×3

每一 次卷积后都进行以 0 为均值,单位方差分布的归一化。
归一化之后再使用 LeakyReLU 函数进行激活。

卷积层输出:
F=LeakyReLU(W∗X+b)F = LeakyReLU(W*X+b)F=LeakyReLU(W∗X+b)
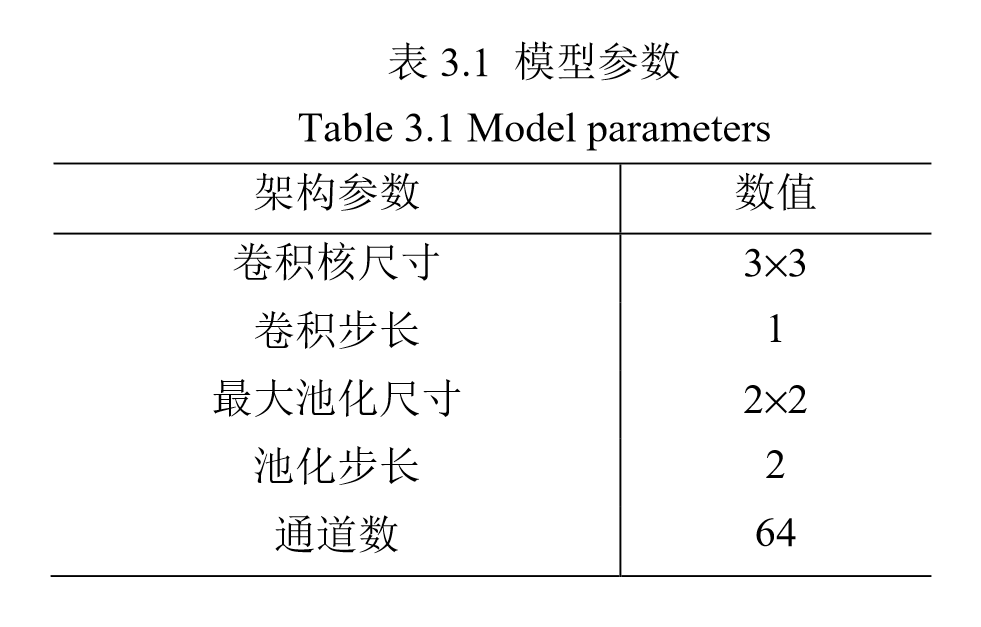
image.png

3.1.2 协同学习CNN激活函数


ReLU
LeakyReLU

3.1.3 协同学习CNN损失函数


交叉熵损失函数

e=−[ylog(p)+(1−y)log(1−p)]e = -[ylog(p)+(1-y)log(1-p)]e=−[ylog(p)+(1−y)log(1−p)]

3.1.4 多模态特征协同学习和融合模块


(1)协同学习

两部分:
协同学习单元
融合操作

FCT:w∗h∗cF_{CT}: w*h*cFCT​:w∗h∗c
FPET:w∗h∗cF_{PET}: w*h*cFPET​:w∗h∗c
穿插堆叠:Xmulti:w∗h∗2cX_{multi}: w*h*2cXmulti​:w∗h∗2c
卷积核:j∗j∗mj*j*mj∗j∗m,m是模态数=2

融合图计算公式:
Ffusion=LeakyReLU(Wmulti∗Xmulti+bmulti)F_{fusion} = LeakyReLU(W_{multi}*X_{multi}+b_{multi})Ffusion​=LeakyReLU(Wmulti​∗Xmulti​+bmulti​)

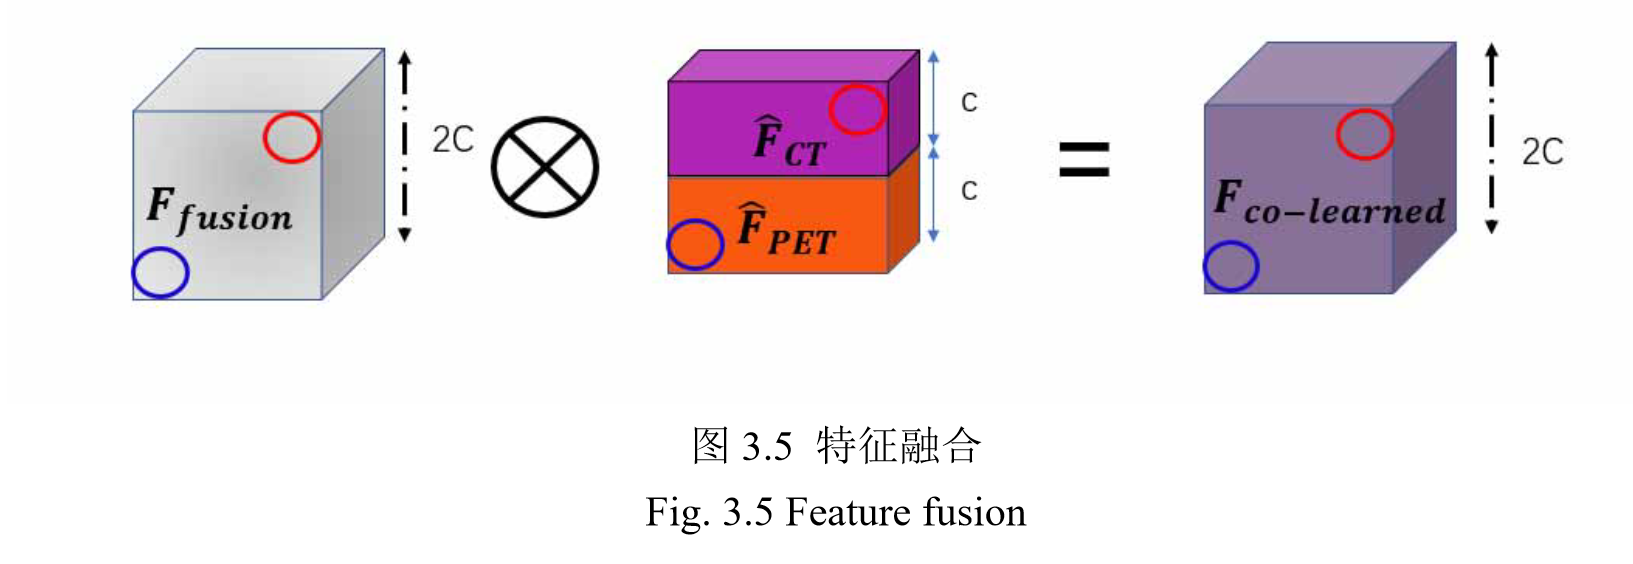
image.png

(2)融合

融合计算公式:
Fco−learned=Ffusion⊗(FCT⊕FPET)F_{co-learned} = F_{fusion} \otimes (F_{CT}\oplus F_{PET})Fco−learned​=Ffusion​⊗(FCT​⊕FPET​)
像素级相乘,利用FfusionF_{fusion}Ffusion​加权。

image.png

3.1.5 重建


最高一级FfusionF_{fusion}Ffusion​进行一次 上采样和两次卷积,然后与比其低一级的FfusionF_{fusion}Ffusion​进行堆叠,之后再次进行上述操作, 重复至所有尺度FfusionF_{fusion}Ffusion​均完成以上操作。
反卷积部分 使用批量标准化和 LeakyReLU 函数进行激活。

3.2 肺肿瘤图像融合实验


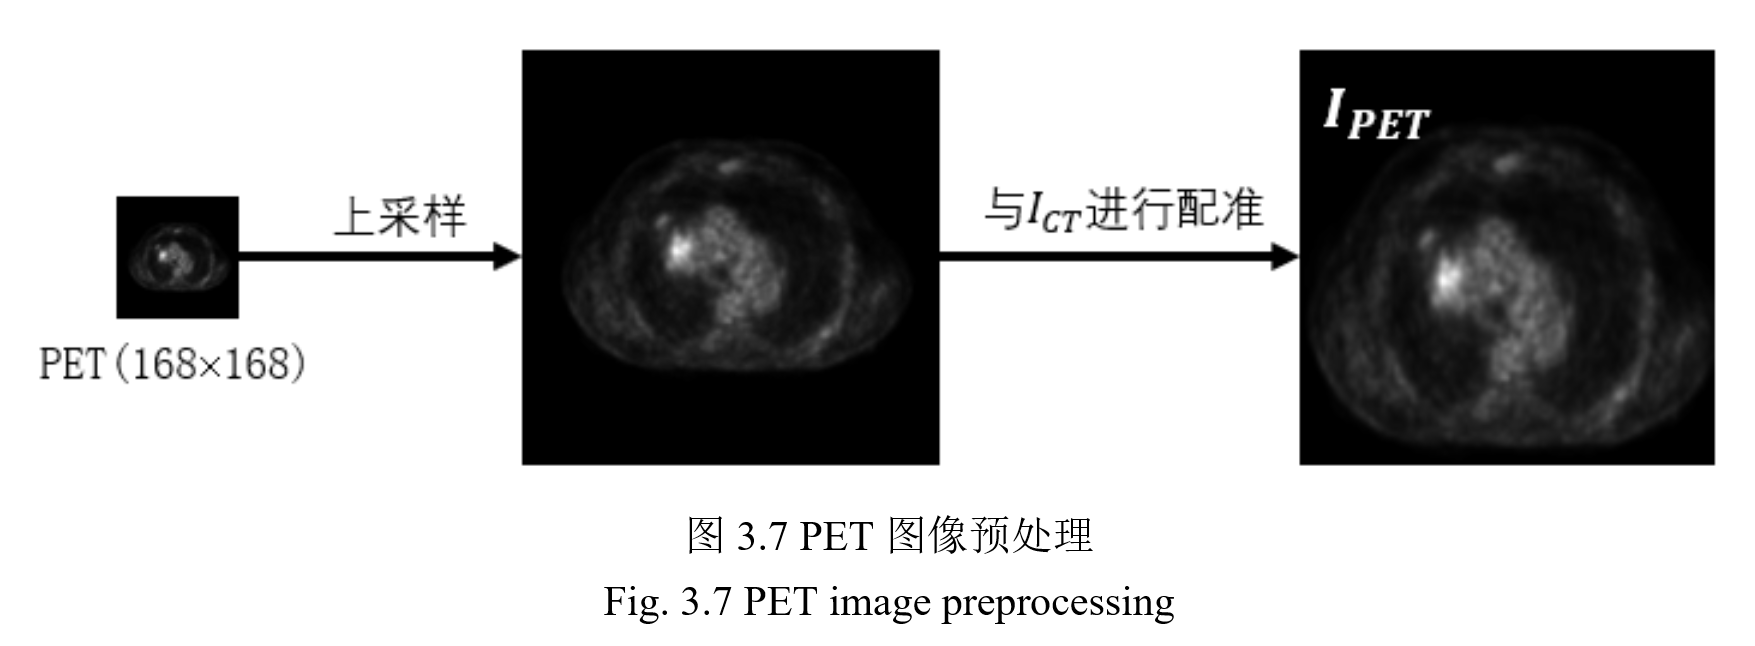
PET 图像的分辨率 为 168×168,CT 图像的分辨率为 512×512。
CT 图像去除轮廓外目标。
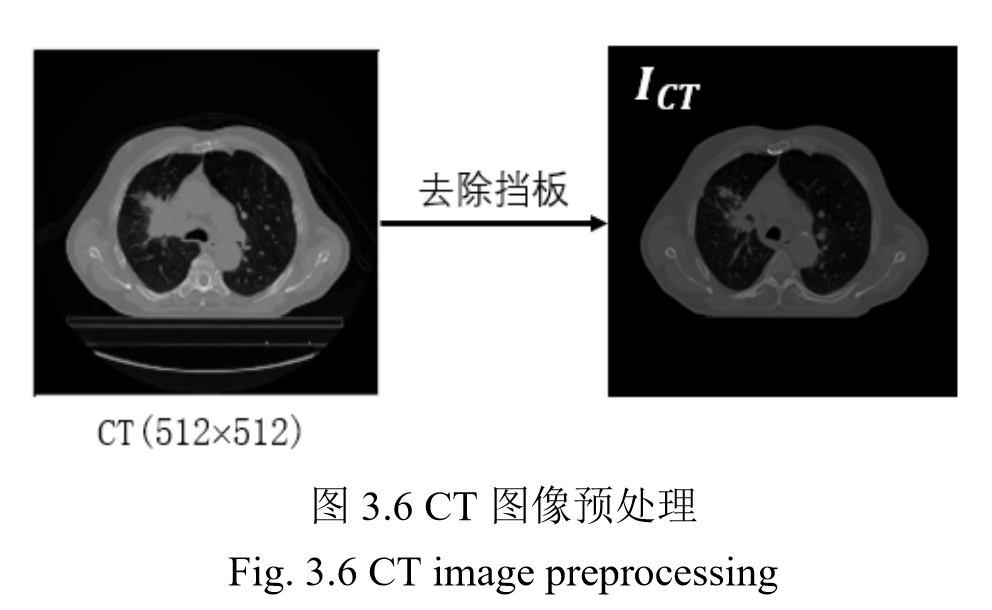
image.png

PET 图像先上采样,再配准。

image.png

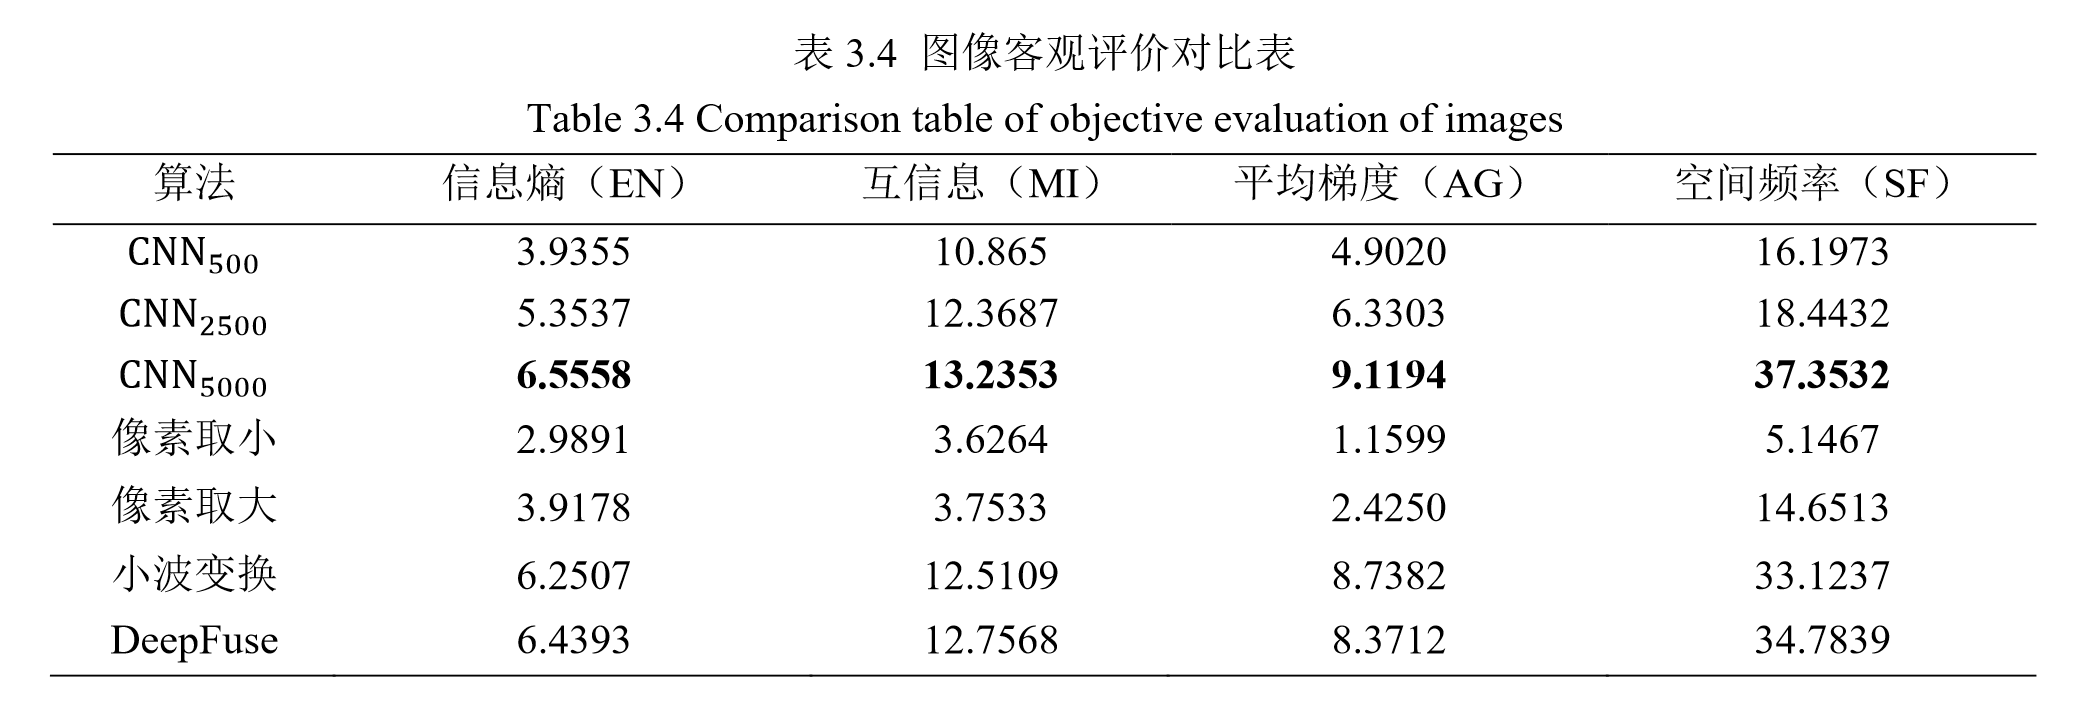
整理后共有 800 对多模态 PET/CT 肺肿瘤图片用于图像融合,经过尺度变换、裁剪等数据增强方法,将训练集扩大到 2500 对多模态图片。其中 80%用于训练,20%用于测试。

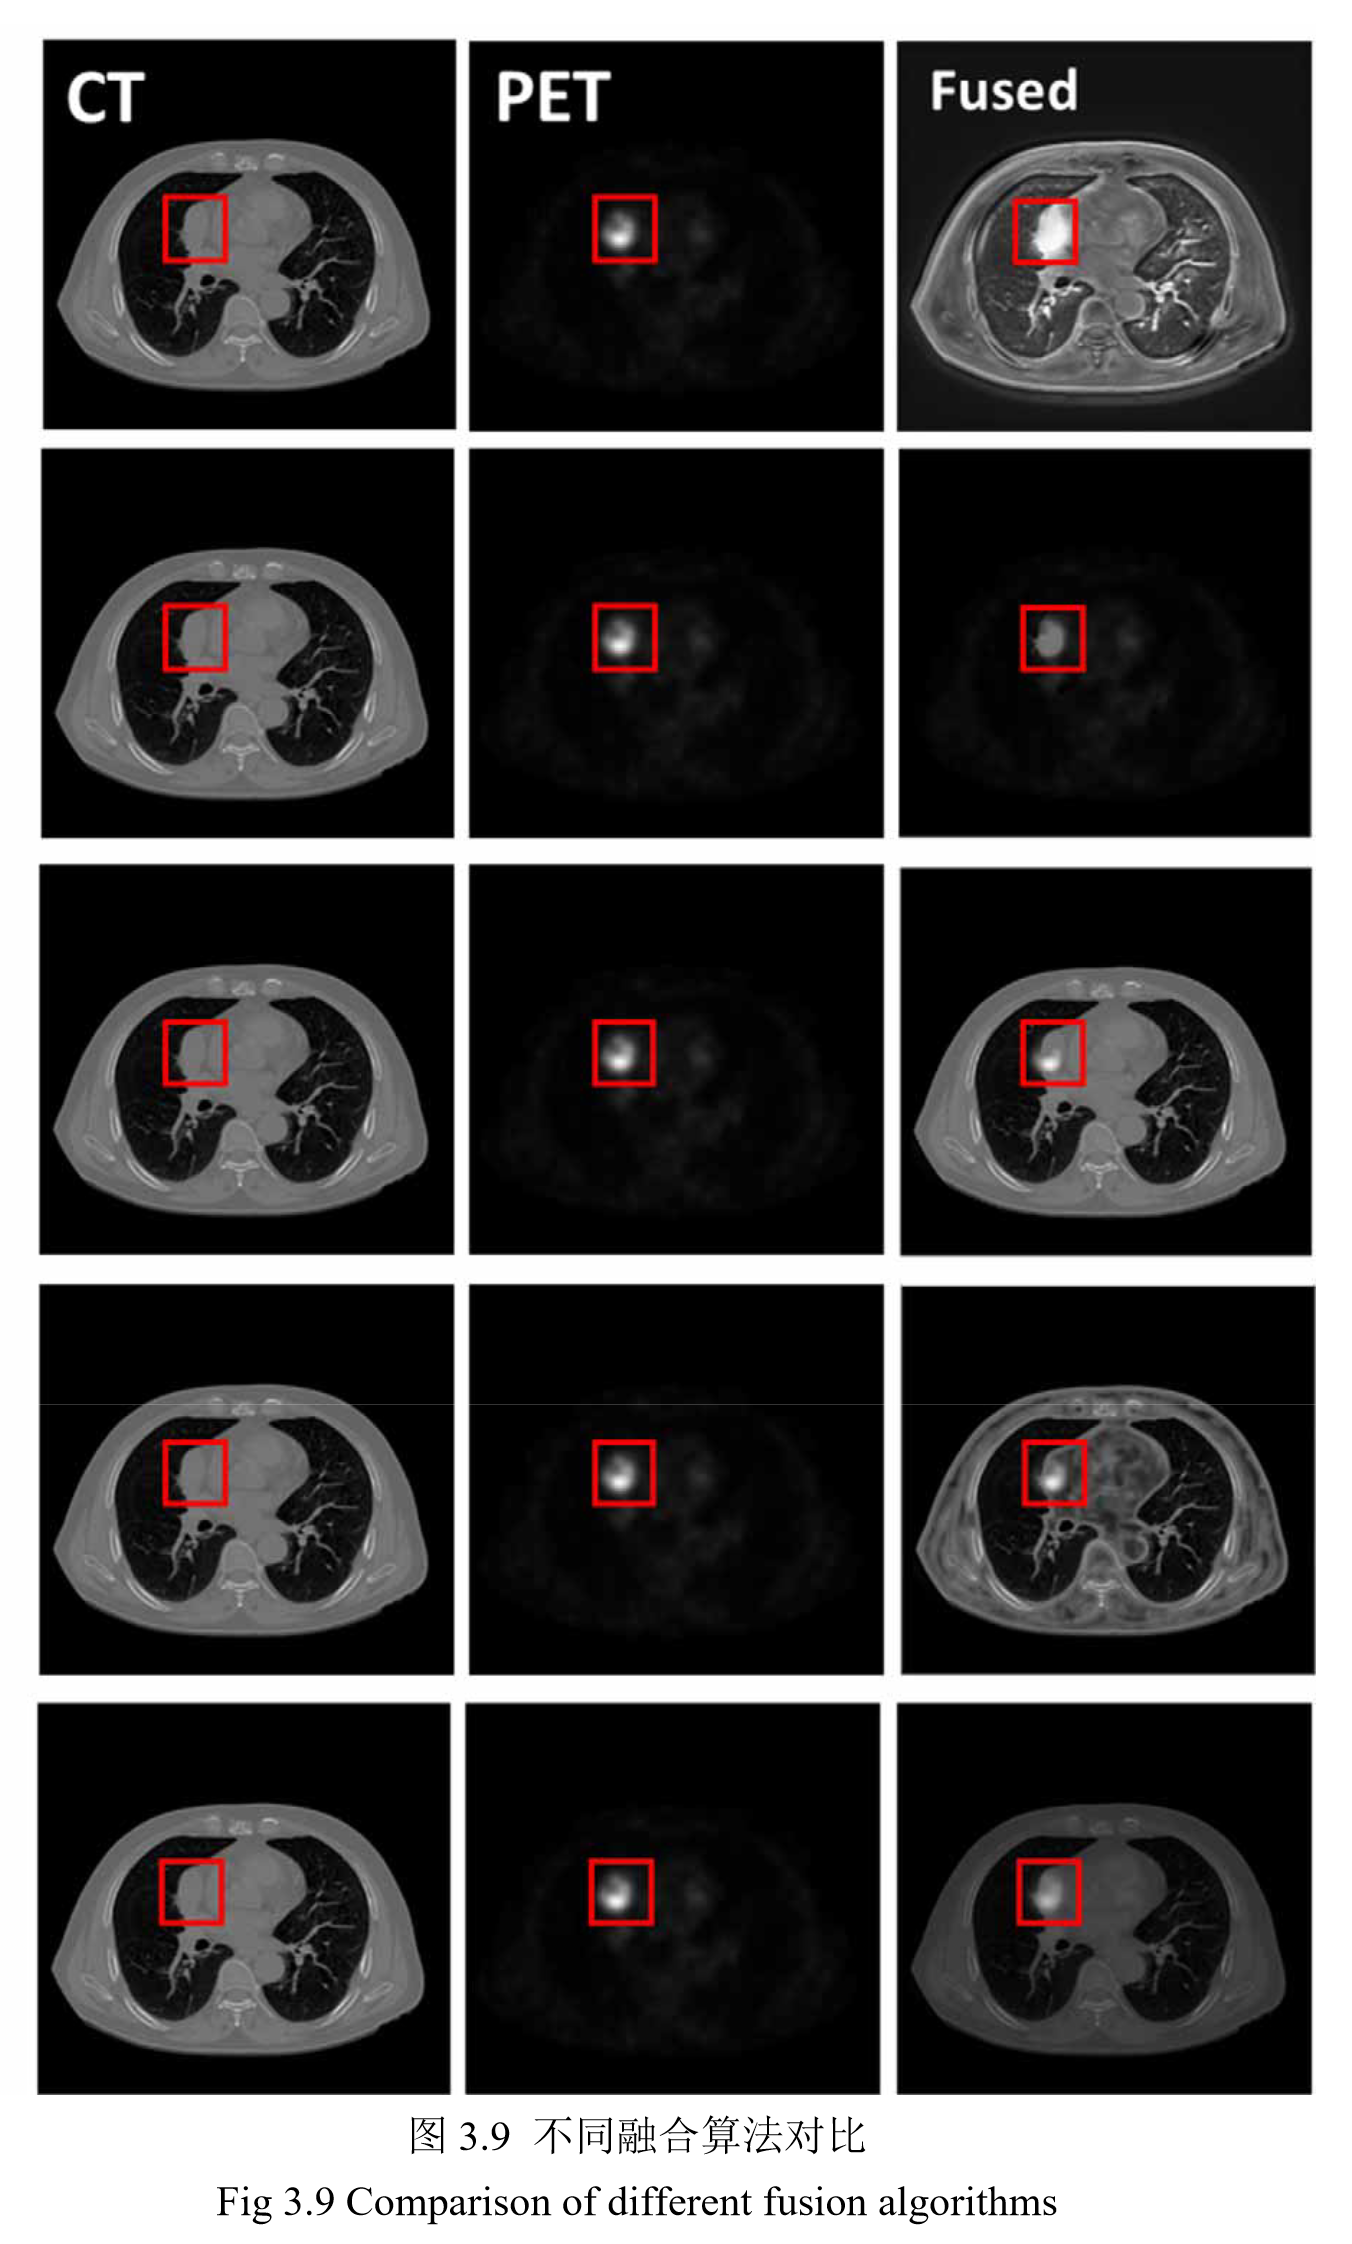
3.3 实验结果与分析
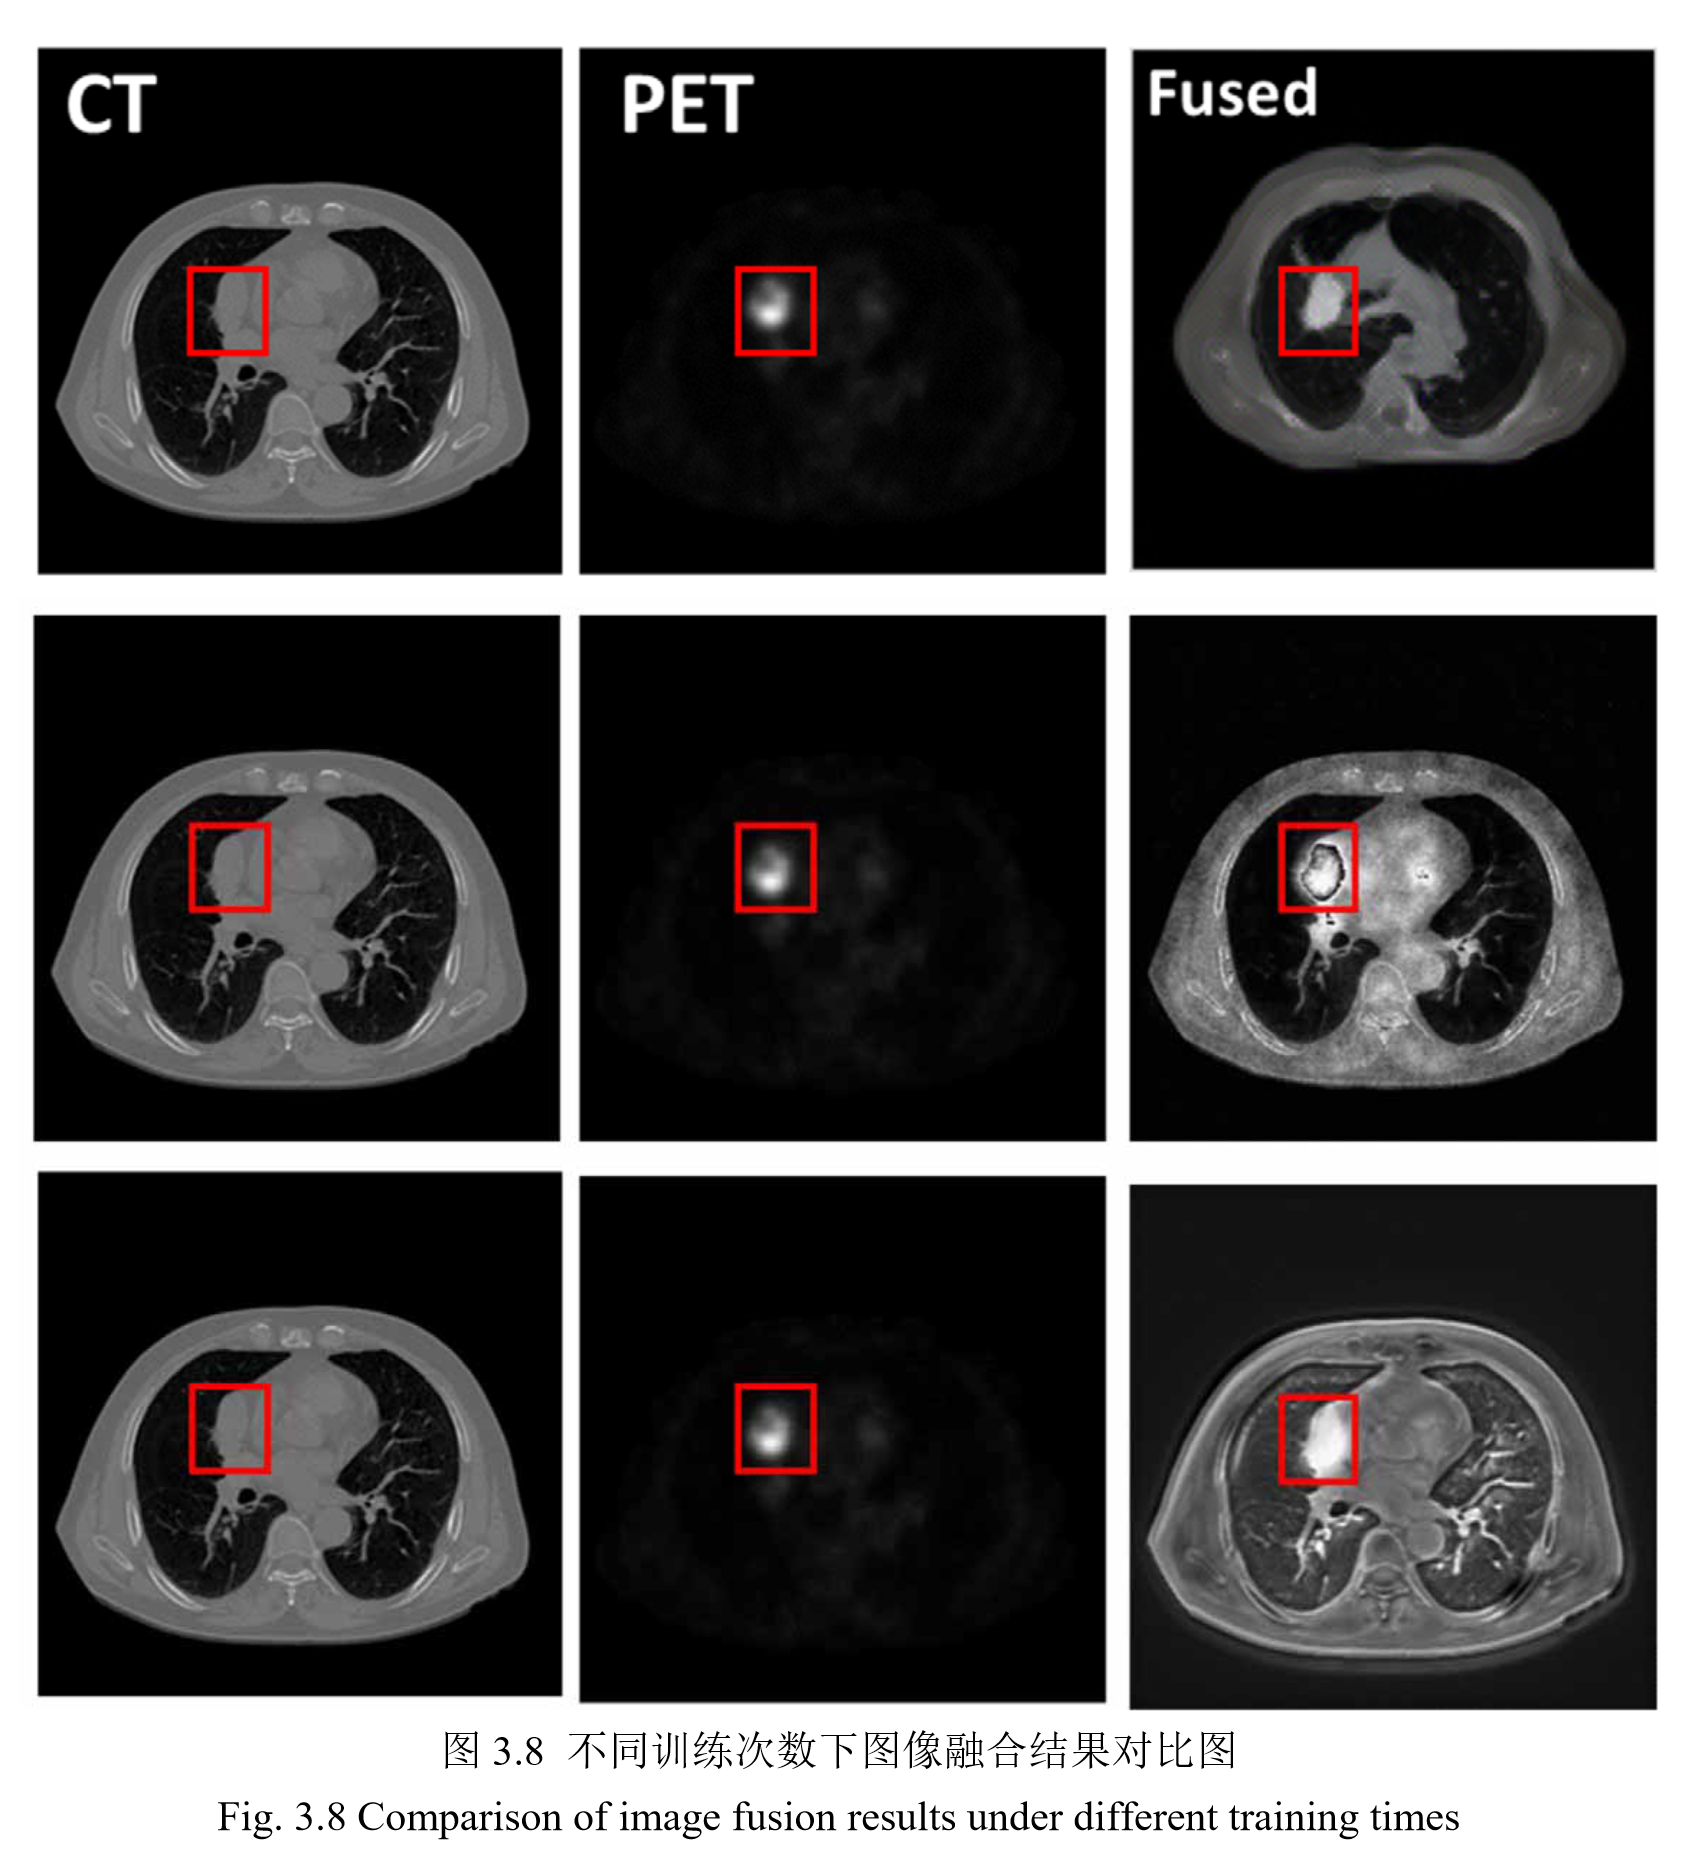

image.png

image.png

image.png

4. 基于 VGG19-GAN 的肺肿瘤图像融合


4.1 VGG19-GAN 图像融合框架


融合框架:
image.png
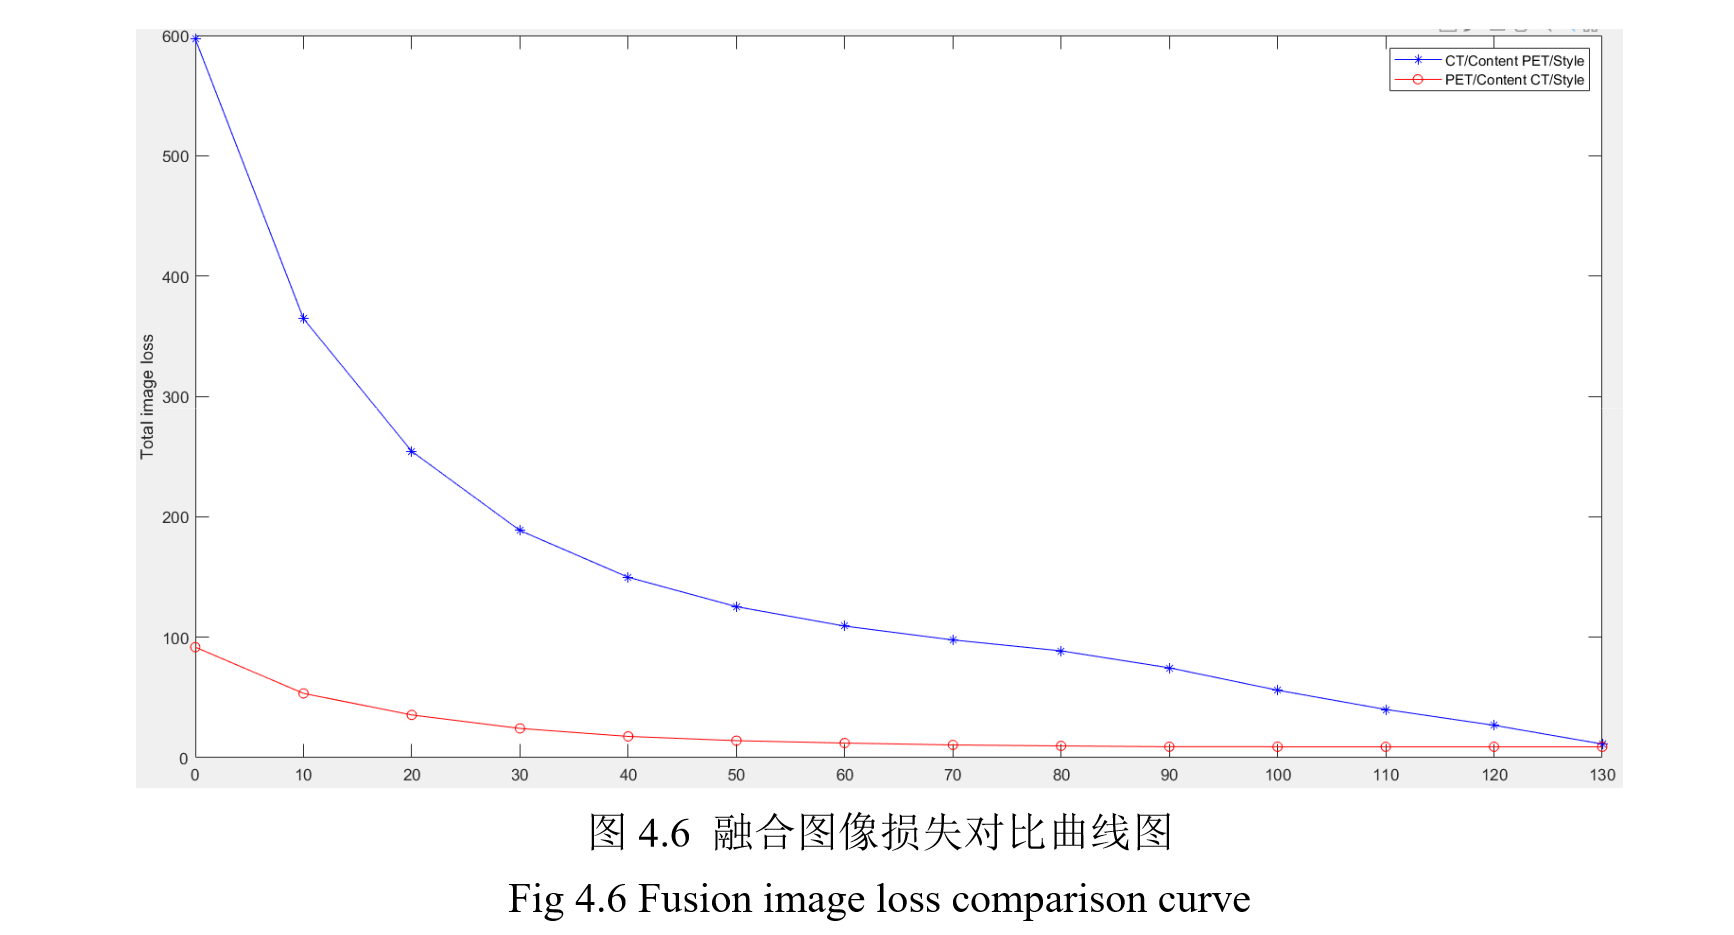
合成图像是运行过程中唯一需要更新的数据,即融合所需迭代的参数。
在生成合成图像时,VGG19 模型参数在训练中无须更新。

选取第八到第十二个卷积层(Convolution 3x3-512)输出内容特征;
其余层输出风格特征。

4.2 VGG19 卷积神经网络


VGG模型框架:
在这里插入图片描述

4.3 VGG19-GAN损失函数


4.3.1 Gram矩阵


n 维欧式空间中任意 k 个向量之间两两的内积所组成的矩阵,称为这 k 个向量的格拉姆矩阵(Gram matrix)
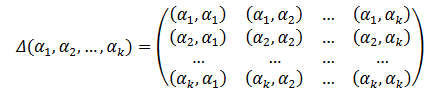
image.png
A×ATA \times A^TA×AT就是A的Gram矩阵。

Gram 矩阵是一种基于特征表示的统计方法,通常用于计算输入图像的风格信息。
对于输入图像,首先使用 CNN 提取出其在某一层的特征图(C×H×W),
Gram 矩阵的计算可以通过将该特征图重塑为一个大小为 C×H×W 的矩阵,
然后计算其转置矩阵和自身的乘积得到,
Gij=∑k=1CFikFjkG_{ij} = \sum_{k=1}^{C} F_{ik} F_{jk}Gij​=k=1∑C​Fik​Fjk​
FikF_{ik}Fik​表示特征图中第i个通道的第k个像素值;
FjkF_{jk}Fjk​表示特征图中第j个通道的第k个像素值;
GijG_{ij}Gij​表示第݅个通道和第݆个通道之间的相关性。

4.3.2 损失函数分析


(1)内容损失

平方误差,L2损失。
Econtent=12∑i=1n(yi−ti)2E_{content} = \frac{1}{2} \sum_{i=1}^n (y_i - t_i)^2Econtent​=21​i=1∑n​(yi​−ti​)2

(2)风格损失

Gram 矩阵实质上是不同特征之间的偏心协方差矩阵。
在每个特征层中,每个数字代表了特定位置的特定卷积核卷积所得到的结果,反映了相应特征的显著程度和两两特征之间的相关性。
对角线元素还可以表明每个特征在图像中出现的频率。

假设有两个图像ܺ和ܻ,它们的 Gram 矩阵分别为GXG_XGX​和GYG_YGY​。那么生成图像的风格损失函数为它们 Gram 矩阵之间的均方误差。
Estyle(X,Y)=1C2×H2×W2∑i=1C∑j=1C∑k=1H∑l=1W(GXi,j(k,l)−GYi,j(k,l))2E_{style}(X,Y) = \frac{1}{C^2 \times H^2 \times W^2} \sum_{i=1}^C \sum_{j=1}^C \sum_{k=1}^H \sum_{l=1}^W(G_{X_{i,j}}(k,l) - G_{Y_{i,j}}(k,l))^2Estyle​(X,Y)=C2×H2×W21​i=1∑C​j=1∑C​k=1∑H​l=1∑W​(GXi,j​​(k,l)−GYi,j​​(k,l))2

(3)生成图像损失

生成目标的损失函数是内容损失函数和风格损失函数的加权和。
E(G)=αEcontent(C,G)+βEstyle(S,G)E(G) = \alpha E_{content}(C,G) + \beta E_{style}(S,G)E(G)=αEcontent​(C,G)+βEstyle​(S,G)
C为内容图像,S为风格图像,G代表了生成图像。

4.4 VGG19-GAN激活函数


Softmax 函数,又称归一化指数函数。
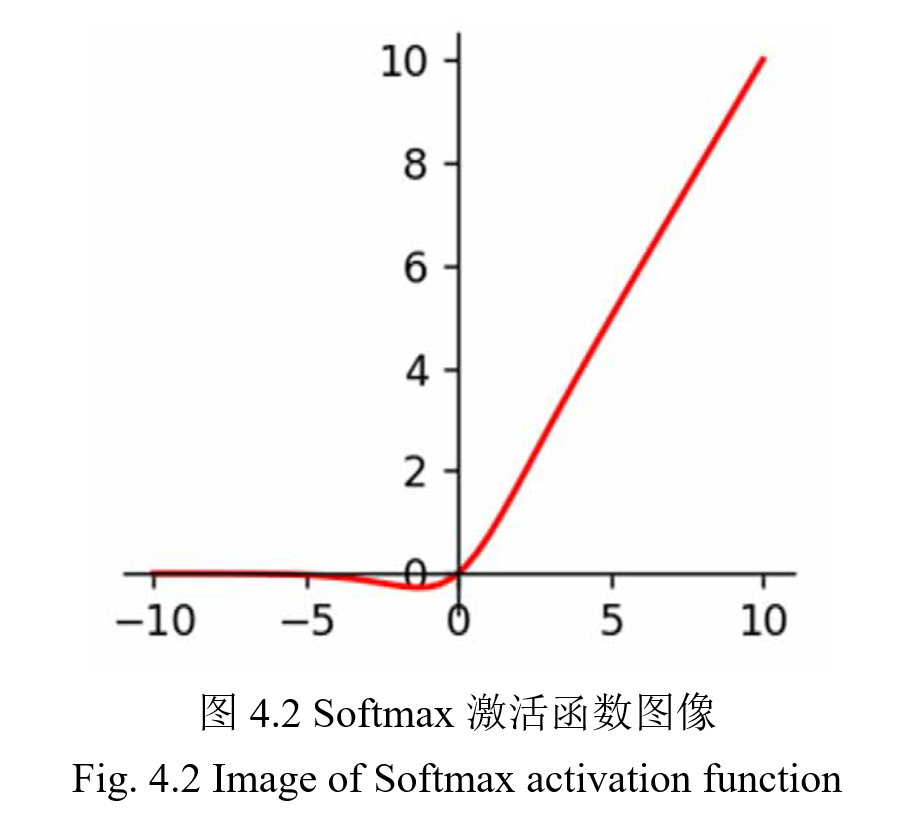
image.png

4.5 VGG19-GAN 的肺肿瘤图像融合实验


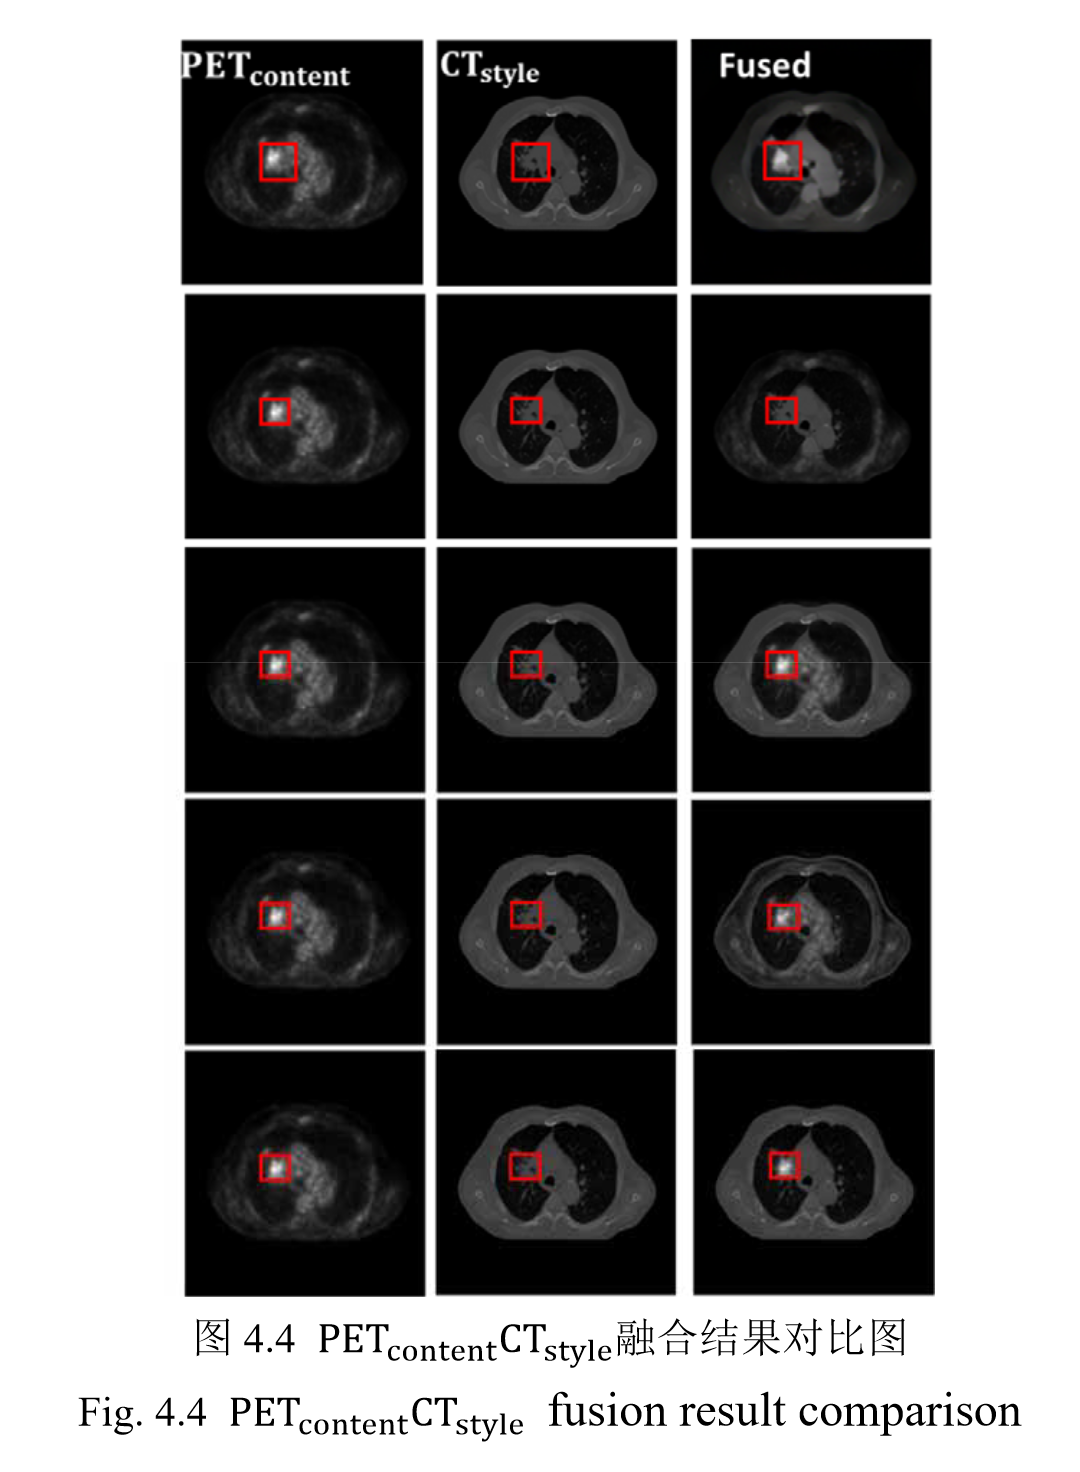
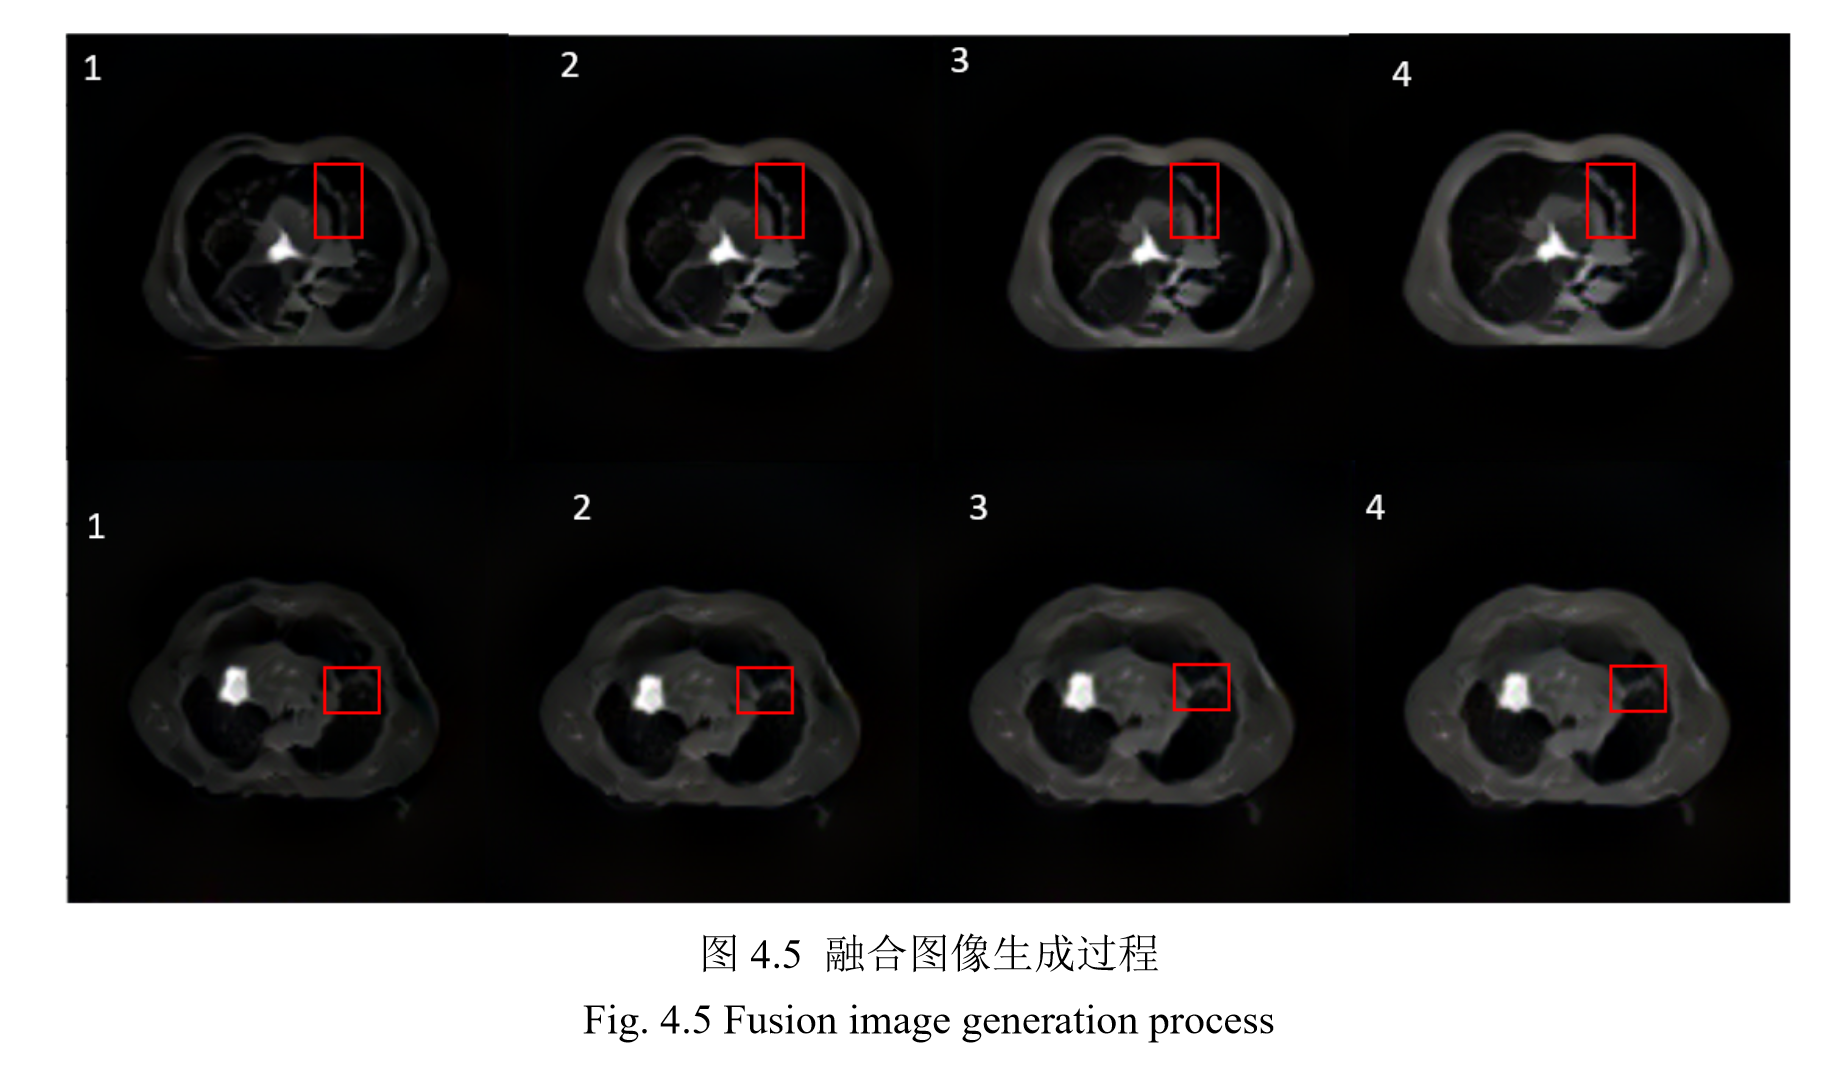
将不同模态的图像分别作为 Content 图像与 Style 图像作为输入查看融合结果, 将两个模态的输入进行互换再次查看输出结果。

4.6 实验结果与分析
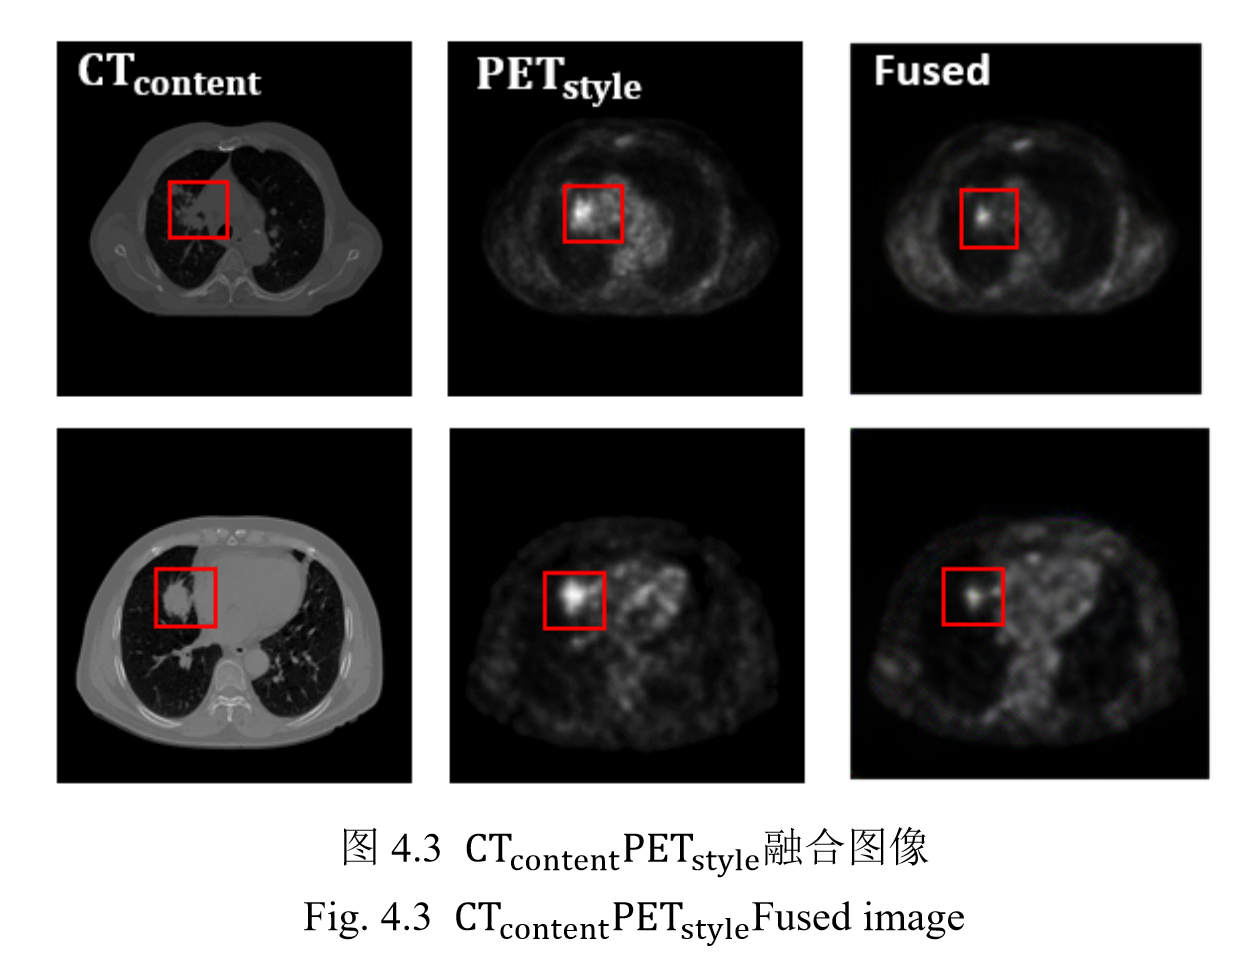

image.png

image.png
image.png
image.png
image.png

Cornerstone渲染CT+PET融合影像及相关应用场景 本文从基础概念知识开始,渐进式介绍了渲染融合影像的实现步骤、数据获取及处理、colorMap颜色映射方案的实现与修改、多Volume修改窗宽窗位的方案等实现。可以涵盖在日常开发中遇到的融合渲染、标量值显示、透明度切换、窗宽窗位修改等多种需求场景。 阅读详情

相关推荐

基于深度学习的MRI、CT和PET合成:回顾与分析

医学影像合成是临床决策研究的一个关键领域,旨在克服获取多种图像模态所面临的挑战,以实现准确的临床工作流程。这种方法有利于从最常见的医学影像对比中的给定源模态估计所需模态的图像,例如计算机断层扫描(CT)、磁共振成像(MRI)和正电子发射断层扫描(PET)。

NHKJ_ZF的博客 1348

图像融合实现CT与PET图像的融合 OpenCV实现(附实验结果)

一、问题重述 图像融合(Image Fusion)是指将多源信道所采集到的关于同一目标的图像数据经过图像处理和计算机技术等,最大限度的提取各自信道中的有利信息,最后综合成高质量的图像,以提高图像信息的利用率、改善计算机解译精度和可靠性、提升原始图像的空间分辨率和光谱分辨率,利于监测。  利用图像融合实现CT与PET图像的融合,使得观测结果更加客观,更多细节得以体现。 二、实验结果 左图

野草志 1万+

PET,CT图像融合笔记

PET-CT怎样进行图像融合?图像融合实现CT与PET图像的融合 OpenCV实现(附实验结果)

chenran187906的博客 8415

深度学习--PET实现过程方法总结

数据处理的一些方法 本人刚学习的一个小白。最近在对一些医学图像如(PET,CT)等做识别的时候,碰到了许多问题,主要就是一些如何用opencv或者图形变换对一些灰度图进行增强的方法,为了避免以后自己再去百度查一些操作,先记录下来。 ImageFolder imagefolder使用的前提是数据要按照一种特定的格式,如下图所示: 在train这个文件夹下面有AD和CN两个文件夹,这两种文件夹里面存放一类图片,且AD和CD为代表的类的类名。按这种形式存放的数据就可以用Imagefolder直接添加,实现代码:

嘻嘻嘻嘻的博客 2630

在 Linux 虚拟机中手动安装 VMware Tools

对于 Linux 虚拟机,您可以从命令行手动安装 VMware Tools。对于 Linux 的较高发行版,请使用集成的 open-vm-tools 版本。 前提条件 有关 open-vm-tools 的操作系统兼容性的详细信息,请参见《VMware 兼容性指南》,网址为VMware Compatibility Guide - System Search。 开启虚拟机。 确认客户机操作系统正在运行。 因为 VMware Tools 安装程序是使用 Perl 编写的,请确认已在客户机操作系统中安..

m0_62526815的博客 1757

自动驾驶轨迹规划算法——Apollo EM Planner

Apollo EM Planner 是百度自动驾驶系统中的轨迹规划算法,采用期望-最大化(EM)迭代优化思想。其核心是将轨迹规划分解为路径优化(E-Step)和速度优化(M-Step)两个子问题,在Frenet坐标系下交替求解。算法先通过动态规划(DP)搜索粗路径,再使用二次规划(QP)进行平滑优化,并结合障碍物信息生成安全走廊。相较Lattice、Hybrid A*等规划器,EM Planner具有更好的实时性、动态障碍物处理能力和轨迹平滑性,适用于城市道路、高速公路等复杂场景。该算法通过解耦路径与速度优

swaggytiger的博客 2667

深度学习结合影像组学--肺癌预后的深度学习:一项回顾性多队列放射学研究:文献速递

这种分层允许评估肿瘤进展,建立预后,为有效的临床沟通提供标准术语,最重要的是,从化疗和手术到放疗和靶向治疗,确定适当的治疗计划。这部分是由于昨天的统计数据与今天更先进的治疗选择之间不可避免的差距,以及在平衡临床医生识别分层特征并在护理点应用分层算法的能力的同时,将患者分成符合历史数据的组之间的实际挑战。我们的临床黄金标准的局限性,结合我们对肿瘤内异质性的改进理解,表明需要开发可以在个体患者水平上运作的个性化生物标志物,而不是在人群水平上,最终导致更健壮的患者分层,并为精准肿瘤学实践奠定基础。

weixin_38594676的博客 1170

基于Halcon与C#的PCB焊接缺陷智能检测系统开发实战(附完整源码与项目文档)

本文详细介绍了基于Halcon与C#的PCB焊接缺陷智能检测系统开发实战,涵盖机器视觉技术、硬件选型、图像处理算法及C#上位机开发。通过实战案例展示如何实现高效、准确的PCB焊接缺陷检测,提升生产效率与质量,并附完整源码与项目文档。

mango的博客 219

论文阅读:基于深度学习的肺癌放射基因组学图像生物标记和基因表达数据关联框架

Topic: Image Bio-markers and Gene Expression Data Correlation Framework for Lung Cancer Radio-genomics Analysis Based on Deep Learning. Abstract: 本文提出了一个基于深度学习的放射基因组学框架,构建了从肺部肿瘤图像到基因组数据的链接,并依次实现生成过程,形成了一个双向框架来映射多源医学数据。在基因组数据条件下,从自动编码器中提取图像特征。与传统的放射基因组学方

Qingkaii的博客 1619

如何用zemax导入solidworks装配体

在zemax使用中,常常需要导入各种零件。如果光机结构较为复杂,那么手工一个一个加载零件,还需要在zmx文件中调整object的位置,非常麻烦。如果能将solidworks的装配体模型直接导入,则可以大幅减小工作量。具体过程为(非序列模式下): 1、新建或打开一个zemax空文件 2、在元件编辑器中,找到一个空文件,双击或直接展开三角符,在类型中找到zemax里的solidworks装配体,如图。...

wojiaoyyy的博客 1万+

【重磅更新】CT/MRI LI-RADS 2024:肝细胞癌局部区域治疗后反应评估的核心突破与临床实践指南

减少过度治疗:辐射 LRT 的 Nonprogressing 类别避免了 “持续强化 = 存活” 的误判,降低不必要的再治疗风险;提高检出效率:非辐射 LRT 的辅助特征升级减少了 Equivocal 比例,更早识别存活肿瘤;统一评估语言:标准化的分类标准为放射科、肝病科、肿瘤科、肝移植科的多学科协作(MDT)提供了统一 “沟通工具”,助力治疗方案的精准制定。

楚山之石的博客 1226

红外与可见光图像融合数据集(2026 持续更新)

本文系统整理了当前主流的红外与可见光图像融合数据集,涵盖 MSRS、RoadScene、M3FD、TNO、LLVIP、FMB、FLIR、MFNet、KAIST、PST900、HDO、MMVS、DVTOD、AWMM-100k、EMS、INO 和 M3SVD 等多个高质量数据源,分别介绍其数据构建团队、参考论文、下载链接及关键特征,包括图像数量、分辨率、退化类型和标注信息。该博客旨在为图像融合研究者提供全面、便捷、持续更新的数据集参考平台。

陈嘿萌的博客 3万+

PyTorch生成式人工智能——VQ-VAE详解与实现

VQ-VAE (Vector Quantised-Variational AutoEncoder) 的核心思想就是将 VAE 的连续潜变量离散化。它通过学习一个码本 (Codebook) 来实现这一点,码本是一个包含有限个嵌入向量的字典。模型不是直接输出一个连续的潜在向量,而是从码本中找出与编码器输出最接近的嵌入向量来代替它。本节首先详细讲解 VQ-VAE 的技术原理,然后使用 PyTorch 从零开始实现 VQ-VAE 模型。

盼小辉丶的博客 3337

分割网络综述——Deep Semantic Segmentation of Natural and Medical Images: A Review

论文阅读之分割网络综述 Deep Semantic Segmentation of Natural and Medical Images: A Review 摘要 图像语义分割主要完成像素级别的密集预测任务,同属于一类的像素组成实例可用于场景识别、理解图像内容等。而在医学图像分析领域,图像分割可用来帮助医生辅助诊断。本文则对目前主流的分割网络及医学图像分割网络从以下方面进行综述:结构优化、损失函数...

qq_37151108的博客 1648

手把手完整实现STM32+LORA组网网关+机智云平台+手机APP应用———第一节- 一主多从的LORA本地组网通信-实现从机采集温湿度与主机显示数据

本教程为《手把手实现STM32+LORA组网网关+机智云平台+手机APP应用》第一节。实现一个主机,两个从机的LORA组网通信。两个从机采集温湿度数据并通过LORA传输数据到主机,然后主机接收到两个从机数据后进行数据显示,本节通过PC串口助手显示两个从机的数据。 下一节将其主机接收的数据通过WIFI网关(ESP8266)传到机智云平台与手机APP。 本文讲解一主多从的LORA本地组网通信,串口助手进行数据展示。使用硬件主要包括:STM32F103C8T6最小系统板(3个)、正点原子LORA模块ATK-L

嵌入式阿齐Archie 1万+

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

论文“基于深度学习的鼻咽部肿瘤PET_CT双模态图像分割方法研究”

记录一下论文中看到的一些对自己可能有用的内容。 图像预处理及扩增 在分割之前,进行图像配准,配准过程如下:首先采用阈值分割法(阈值设置为200Hu)将每个病人的CT图像中的颅骨分离出来,然后随机选择一个病人的颅骨图像作为模板,将其他病人的颅骨图像配准到该模板图像获得放射变换矩阵,最后将该仿射变换矩阵应用于对应的PET图像以及标签图像,得到配准后的PET图像以及配准后的标签图像(在口咽癌数据集中,已经有了CT图像和PET图像,但是是否配准过并不清楚,配准这一部分的代码实现,自己还不会)。在数据预处理的最后

Acmer_future_victor的博客 2157

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

多模态融合 Multimodal Fusion

多模态机器学习MultiModal Machine Learning (MMML),旨在通过机器学习理解并处理多种模态信息。包括多模态表示学习Multimodal Representation,模态转化Translation,对齐Alignment,多模态融合Multimodal Fusion,协同学习Co-learning等

Slientsake的博客 3万+

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

运用深度学习预测肺癌

运用深度学习预测肺癌诊断原文:Forecasting Lung Cancer Diagnoses with Deep Learning 注:本文为The Data Science Bowl (DSB) 2017竞赛的第二名获奖团队中Daniel Hammack的解决方案,其另一成员Julian de Wit的解决方案,可查看用CNN识别CT图像检测肺癌一文。摘要在2017年由Kaggle举办的数据

RookieFCB的专栏 6898

[TMI 2020] Co-Learning Feature Fusion Maps From PET-CT Images of Lung Cancer

目录摘要引言二级目录三级目录 摘要 论文主要做pet-ct联合分析。现有pet-ct图像分析始讲两种模态分开分析或者基于特定的任务融合两个模态的信息。这些方法忽略了跨模态的空间变化视觉特征(意思是没有充分考虑模态间的关系,且不同模态对于不同目标具有不同的优先级–某一模态能更好的捕获某一目标) 本文目标:基于新的监督CNN改善多模态,即pet-ct中互补信息的融合;这个CNN可以学习互补信息融合方式一进行多模态医学图像分析; 过程:1)对每个模态进行特征编码;2)利用编码特征得到空间变换融合map,这个ma.

我的博客 1267

论文笔记:一次前向就出整块动作:DriftingVLA 拆解

DriftingVLA提出一种无需迭代的单步视觉-语言-动作生成范式,通过在训练中引入基于动作维度的漂移场(PDTD),将分布修正内化为模型参数。其核心是重初始化动作接口,直接预测动作块而非速度,并利用多兄弟样本间的吸引与排斥构建无蒸馏、无积分的分布匹配目标。实验表明,该方法在保持高精度的同时实现一次前向推理,显著优于现有一步生成方案,且部署时仅需1次前向计算,真正实现“一次前向出整块动作”。

踏雪亦无痕的博客 398

【论文阅读】--AI智能体安全综述:威胁、防御、评估和公开挑战

方向类别 核心描述与关键挑战 代表性风险 / 解决方案思路 长时序安全 Long‑Horizon Security 面向长多步任务,伴随记忆膨胀问题;安全隐患不会即时暴露,在多轮执行后才显现,要求安全机制具备时间维度鲁棒性 潜伏欺骗、Sleeper agent 休眠触发攻击;需要针对长轨迹的潜伏检测 多智能体新型安全 单个恶意智能体能够引发级联失效,破坏整个 MAS;系统拓扑对鲁棒性的影响尚不充分 通信信道身份认证、争议回滚机制、哨兵 / 监管 Agent 改进安全基准 缺少能够覆盖全部攻击范式的统一基准;

我是个好人呀,O(∩_∩)O 354

ASR识别任务两篇论文阅读分析与系统方案技术报告 下

对实际项目,应先建立可复现基线,再用和争取识别率,以分场景消融验证鲁棒性,最后按业务需要增加语言模型、前端和说话人分支。若需要“谁在何时说了什么”,可在VAD/分段后提取说话人嵌入,通过余弦相似度和谱聚类形成相对说话人标签,再与ASR时间戳或分段文本对齐。建议在统一数据、文本规范、训练预算和解码条件下,逐项改变一个因素,并保存日志、配置、检查点和错误对齐文件。综合落地时,建议把“模型文件”扩展为完整发布包:模型权重、配置、tokenizer、文本规范、特征参数、解码参数、版本信息和评测报告缺一不可。

XLYcmy的博客 648

【论文阅读】Agent 记忆机制(124):The Memory Trap——良性交互如何让长期记忆越过作用域边界

《The Memory Trap》揭示:即使记忆内容真实且无恶意,Agent仍可能因过度泛化局部经验导致安全风险。论文首次系统定义“记忆作用域越界”为Memory Trap,通过三类实验证明,记忆在写入或读取阶段均可能引发自治、偏见与作弊行为。研究强调,仅保证记忆真实性不足,还需明确其适用边界。

weixin_45642847的博客 432

【论文阅读】Agent 记忆机制(127):Think or Remember——Agent“重新思考”与“保留记忆”的成本汇率

本文提出“思考与记忆的架构汇率” $P^* = c/\beta$,揭示上下文策略成本不仅取决于Token数量,更受模型架构与缓存规则影响。删除历史虽减少输入长度,但可能破坏前缀缓存、引发重复推理,导致实际成本上升。论文区分“机械成本”与“行为改变成本”,证明同一策略在不同系统下成本排序可反转。核心结论:记忆保留与否的性价比,由架构、缓存机制与任务轨迹共同决定,而非单纯比较文本长度。

weixin_45642847的博客 335

文献发现、课题组织与证据可追溯的论文阅读。

Paper Atlas 把一个 PDF 文件夹变成科研工作空间的工具,检索 arXiv 和期刊论文,以科研课题为单位组织文献,用结构化 AI 分析辅助阅读,并在左右分栏的 PDF 阅读器中把结论、证据、页码和原文对应起来。所有数据都保存在本机。论文、笔记、批注、分析结果和设置都在本地data/目录,不需要账号、云同步或外部数据库。为什么是 Paper Atlas多数文献工具停在“下载 + 预览”。Paper Atlas 以组织工作流,把,并保存。

LNN0212的博客 446
上一篇: 论文阅读:Attention is All you Need
下一篇: 论文阅读:Generating Synthetic Data for Medical Imaging
BulingQAQ
博客等级 码龄7年 335粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值