LLM大型语言模型脑图-基础技术篇

大型语言模型(LLM)理论简介 大语言模型(LLM,Large Language Model),也称大型语言模型,是一种旨在理解和生成人类语言的人工智能模型。LLM 通常指包含数百亿(或更多)参数的语言模型,它们在海量的文本数据上进行训练,从而获得对语言深层次的理解。目前,国外的知名 LLM 有 GPT-3.5、GPT-4、PaLM、Claude 和 LLaMA 等,国内的有文心一言、讯飞星火、通义千问、ChatGLM、百川等。为了探索性能的极限,许多研究人员开始训练越来越庞大的语言模型,例如拥有1750 亿参数的GPT-3和。 阅读详情

图片


1. LLM基础概念

1.1 定义与背景

什么是LLM:

基于深度学习的自然语言处理模型,具备生成、理解和处理文本能力。

发展历史

  • 早期NLP:规则系统、统计模型(HMM、CRF)。
  • Transformer时代:2017年《Attention is All You Need》。
  • 规模化模型:GPT系列、BERT、T5等。

核心特点

  • 大规模参数(亿级到万亿级)。
  • 自监督学习(Pre-training + Fine-tuning)。
  • 多任务适应性。

1.2 工作原理

Transformer架构

  • Encoder-Decoder结构(BERT vs GPT)。
  • Attention机制:Self-Attention、Multi-Head Attention。
  • Positional Encoding:处理序列顺序。

图片

训练过程

  • 预训练:大规模无标注文本(Common Crawl、Wikipedia)。
  • 微调:针对特定任务(分类、生成)。
  • 指令微调(Instruction Tuning):提升指令理解。

关键技术

  • Tokenization:WordPiece、BPE。
  • Embedding:Word、Position、Segment。
  • Layer Normalization与残差连接。

2. LLM核心技术与算法

2.1 模型架构

图片

主流模型

  • GPT:生成式,自回归。
  • BERT:双向,掩码语言模型。
  • T5:文本到文本框架。
  • LLaMA:高效研究模型。

架构优化

  • Sparse Attention:降低计算复杂度。
  • Mixture of Experts(MoE):动态路由提升效率。
  • FlashAttention:优化GPU内存使用。

2.2 训练与优化

数据处理

  • 数据清洗与去重。
  • 多语言与多模态数据。

优化算法

  • Adam/AdamW:主流优化器。
  • Learning Rate Schedule:Warm-up与衰减。

分布式训练

  • 数据并行 vs 模型并行。
  • Pipeline Parallelism与Tensor Parallelism。
  • ZeRO(DeepSpeed):内存优化。

2.3 评估与指标

通用指标

  • Perplexity:生成质量。
  • BLEU/ROUGE:文本生成评估。
  • F1/Accuracy:分类任务。

任务特定指标

  • GLUE/SuperGLUE:NLP综合基准。
  • MMLU:多任务语言理解。
  • 人类评估
  • 流畅性、相关性、一致性。

3. LLM应用场景

3.1 文本生成

图片

应用案例

  • 文章创作、故事生成。
  • 代码生成(Copilot、CodeLLaMA、Cursor)。
  • 对话系统(ChatGPT、Grok、 DeepSeek)。

挑战

  • 事实性(Hallucination)。
  • 上下文一致性。

3.2 文本理解

任务类型

  • 情感分析、文本分类。
  • 命名实体识别(NER)。
  • 问答系统(QA)。

技术要点

  • 上下文建模。
  • 知识增强(Knowledge-Augmented Models)。

3.3 多模态与跨领域

多模态LLM

  • 文本+图像:CLIP、DALL·E、Flamingo。
  • 文本+音频:Whisper。

跨领域应用

  • 医疗:临床记录分析。
  • 法律:合同审查。
  • 教育:自动批改、智能辅导。

4. LLM开发与部署

4.1 开发工具与框架

图片

主流框架

  • PyTorch/TensorFlow:模型开发。
  • Hugging Face Transformers:预训练模型库。
  • DeepSpeed/Megatron:分布式训练。

开发流程

  • 数据准备与预处理。
  • 模型选择与微调。
  • 超参数调优。

4.2 部署与优化

部署方式

  • 云端API(OpenAI、DeepSeek)。
  • 本地部署(ONNX、Triton、Ollama)。

优化技术

  • 量化(Quantization):INT8、FP16。
  • 剪枝(Pruning):减少冗余参数。
  • 蒸馏(Distillation):小模型继承大模型能力。

硬件加速

  • GPU/TPU:主流训练硬件。
  • Inference优化:NVIDIA TensorRT。

4.3 开源与生态

开源模型

  • LLaMA、Mistral、Grok(部分开源)。
  • Hugging Face社区模型。

数据集

  • The Pile、C4、RedPajama。

社区与工具

  • GitHub、Kaggle。
  • Weights & Biases:实验跟踪。

5. LLM挑战与未来

5.1 技术挑战

计算成本

  • 训练与推理的高昂算力需求。
  • 能耗与环境影响。

模型局限

  • 偏见与公平性。
  • 鲁棒性与对抗攻击。

伦理问题

  • 隐私保护。
  • 虚假信息生成。

5.2 未来方向

高效模型

  • 更小、更快、更节能的模型。
  • 模块化与可组合模型。

多模态融合

  • 统一文本、图像、音频、视频。

自主学习

  • 在线学习与自适应。
  • 强化学习与人类反馈(RLHF)。

6. 学习资源与路径

6.1学习书籍文档

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)
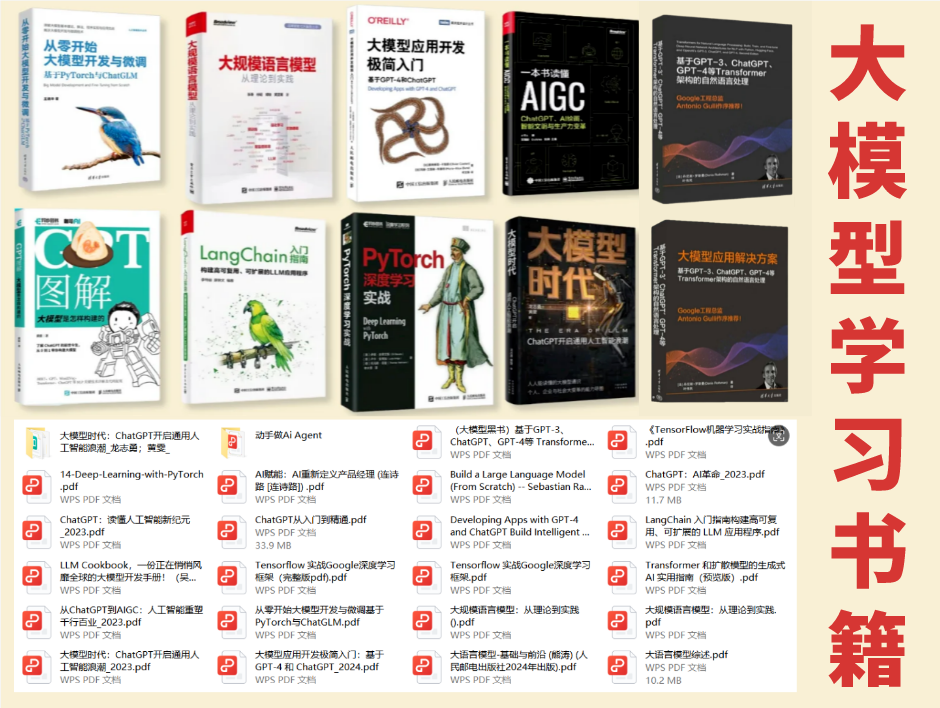
在这里插入图片描述

6.2学习视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。
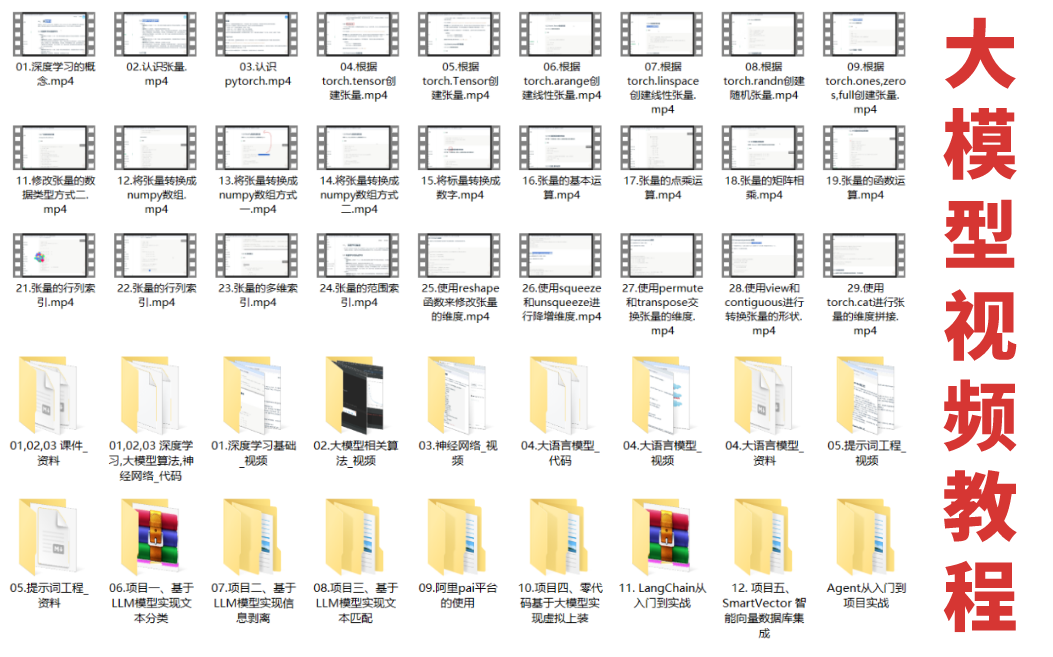
在这里插入图片描述

6.3项目实战源码

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。
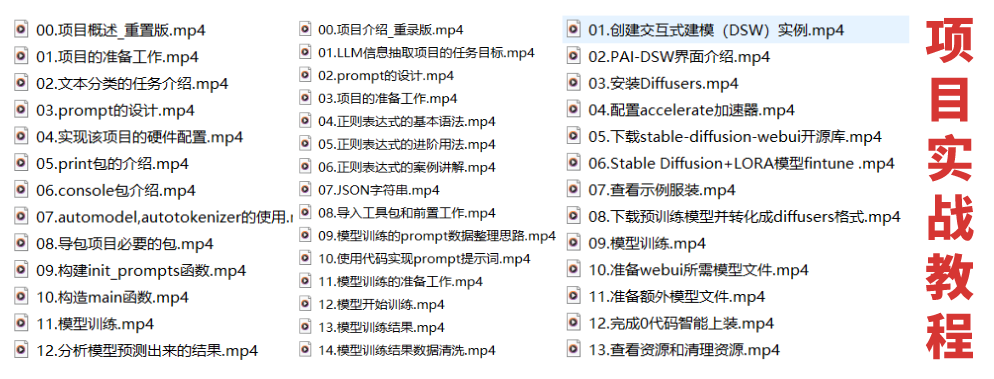
在这里插入图片描述

6.4大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
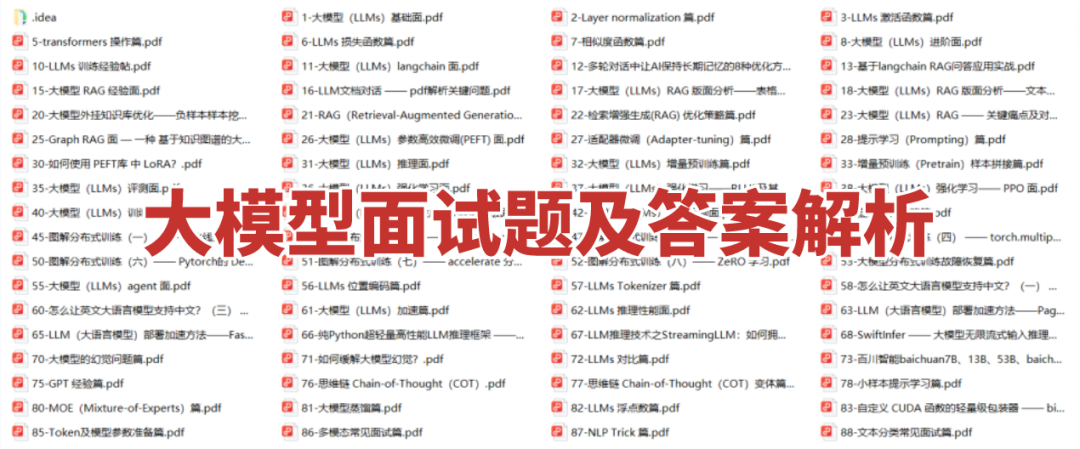
图片

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取 

大型语言模型(LLM)简介:基础知识、工作原理和示例_llm大型语言模型 对于大型语言模型,用于训练的数据通常是大型文本语料库。该模型学习文本数据中的模式,并使用它们来生成新文本。训练过程包括优化模型参数,以最小化语料库中生成的文本与实际文本之间的差异。训练模型后,可以使用它来生成新文本。为此,模型被赋予一个单词的起始序列,并根据训练语料库中单词的概率生成序列中的下一个单词。重复此过程,直到生成所需的文本长度。为了了解大型语言模型的工作原理,了解可用的不同类型的语言模型非常重要。 阅读详情

相关推荐

LLM大型语言模型代理的安全与隐私综述

受大型语言模型(LLM)快速发展的启发,LLM代理已发展到能够执行复杂任务的阶段。LLM代理现在广泛应用于各个领域,处理大量数据以与人类互动并执行任务。LLM代理的广泛应用展示了其显著的商业价值;然而,这也暴露了其安全和隐私漏洞。

2301_81887304的博客 1346

LLM大型语言模型脑图(一)基础技术篇

目前大模型处于爆火状态,大家对LLM基础技术还是比较感兴趣,故根据我现在已有的知识,给大家整理一个脑图;主要梳理了基础技术篇的脑图,后续文章会继续给出开发、应用偏的脑图;辅助小伙伴们对LLM认知。

瓦罗兰特顶级C位的博客 1117

深入浅出:大型语言模型(LLM)的全面解读

在当今的数字化时代,人工智能技术已经成为各行各业的核心驱动力之一。而在人工智能的领域中,大型语言模型(LLM)作为一种引人瞩目的技术,正在以其强大的语言理解和生成能力引领着一场革命。本文旨在深入浅出地解读大型语言模型,探讨其背后的原理、技术突破、应用场景以及未来发展趋势。

fudaihb的博客 10万+

【值得收藏】LLM大型语言模型脑图-基础技术篇

基于深度学习的自然语言处理模型,具备生成、理解和处理文本能力。发展历史早期NLP:规则系统、统计模型(HMM、CRF)。Transformer时代:2017年《Attention is All You Need》。规模化模型:GPT系列、BERT、T5等。核心特点大规模参数(亿级到万亿级)。自监督学习(Pre-training + Fine-tuning)。多任务适应性。

youmaob的博客 772

【人工智能】LLM 大型语言模型和 Transformer 架构简介

然而,传统的机器学习模型,例如神经网络,并不能天生理解输入的顺序。通过将位置编码纳入 Transformer 架构,GPT 可以更有效地理解句子中单词的顺序,并生成语法正确且语义有意义的输出。但是,模型只能理解数字,不能理解文本,因此需要将这些输入转换为称为“输入嵌入”的数字格式。作为初创公司的首席技术官,我每天都在讨论这项革命性的技术,因为围绕它的持续不断的嗡嗡声和炒作。这篇博文将探讨 LLM(大型语言模型)和转换器架构的基本概念,转换器架构是所有带有转换器的语言模型的构建块,包括 GPT。

AI天才研究院 2万+

在matlab中运行自带的模块(以CCSDS LDPC Decoder模块为例)

最新版的获取需要注册 MathWorks 账户 访问账户注册页面:www.mathworks.cn/mwaccount/register。下载新版本或历史版本的MATLAB,请登陆:https://www.mathworks.cn/downloads 并下载。点击此处可以拷贝调用例程的命令,在matlab命令行输入即可自动获取代码。可以看到页面中写了该模块需要在R2022b以上版本使用。运行.m文件可以生成simulink运行所需要的数据。可以看到左侧下载到了官方历程的文件。之后双击slx文件即可打开。

qq_28455081的博客 885

LLM大型语言模型脑图-基础技术篇,大模型入门到精通,收藏这篇就足够了!

笔者发现大家对LLM基础技术还是比较感兴趣,故根据我现在已有的知识,给大家整理一个脑图;主要梳理了基础技术篇的脑图,后续文章会继续给出开发、应用偏的脑图;辅助小伙伴们对LLM认知。

DEVELOPERAA的博客 683

车规级非易失存储选型指南:从AEC-Q100到ISO 26262的可靠性设计

非易失存储器是电子系统中负责长期保存关键数据与代码的核心组件,其可靠性直接决定了系统的长期稳定运行能力。在汽车电子领域,这一要求被提升到了极致,必须满足严苛的车规级标准。从原理上看,存储器的数据保持能力、擦写寿命等关键参数在高温、振动等恶劣环境下会急剧衰减,因此需要专门的设计与验证。其技术价值在于保障车辆全生命周期的功能安全与数据完整性,避免因存储失效导致的安全隐患或频繁维护。应用场景涵盖从发动机控制单元、自动驾驶域控制器到智能座舱的各类电子控制单元。本文聚焦于车规级非易失存储的选型,深入解析AEC-Q10

weixin_30938149的博客 458

大型语言模型 (LLM)全解读

大型语言模型 是一种深度学习算法,可以执行各种自然语言处理 (NLP) 任务。大型语言模型底层使用多个转换器模型底层转换器是一组神经网络。大型语言模型是使用海量数据集进行训练的超大型深度学习模型。这也是它们能够识别、翻译、预测或生成文本或其他内容的强大基础所在。因此大型语言模型也称为神经网络 (NN),是受人类大脑启发而开发出的计算系统。这些神经网络利用分层的节点网络工作,就像神经元一样。这些神经网络由具有自注意力功能的编码器和解码器组成。

FeelTouch Labs 1万+

实战分享:如何用本地替换和插桩调试搞定Kasada最新版x-kpsdk-cd环境检测

本文深入解析Kasada最新版x-kpsdk-cd环境检测机制,提供动态请求拦截、本地替换和函数插桩等实战调试策略。通过Proxy保护破解、关键函数断点调试和环境检测对抗方案,帮助逆向工程师有效应对从280位扩展到294位的加密数组挑战,实现高效补环境调试。

weixin_29251567的博客 569

点云体素化算法研究-3.Voxelization 三维模型体素化

体素(voxel)即体积元素的简称,是数字数据在三维空间分割上的最小的单位。体素化就是通过创建三维体素网格来表示三维物体,是一种将无序点云变为有序点云的降采样的空间数据结构方法,便于实现点云的空间卷积。激光雷达(LiDAR)| Open3D:第五节 表面重建-体素化。

周陽讀書 2067

LLM大型语言模型脑图(一) - 开发篇

收到很多同学的私信,发现大家对LLM基础技术还是比较感兴趣,故根据我现在已有的知识,给大家整理一个脑图;主要梳理了基础技术篇的脑图,后续文章会继续给出开发、应用偏的脑图;辅助小伙伴们对LLM认知。

DEVELOPERAA的博客 984

PostgreSQL14 离线安装全攻略:从下载到配置详解

本文详细介绍了PostgreSQL14在无网络环境下的离线安装全流程,涵盖RPM包与源码编译两种主流方法。文章重点解析了安装前的系统环境检查、依赖包准备、数据库初始化、远程访问配置以及安装后的关键检查与性能调优,旨在帮助运维和开发人员在离线服务器上高效、稳定地部署PostgreSQL14数据库。

p5l2m9n4o6q的博客 718

LLM大型语言模型脑图 - 开发篇

基于大模型的开发是一个快速发展的领域,涵盖从需求分析到部署优化的完整流程。开发框架如Hugging Face、LangChain等提供了强大的工具支持,而开发方向则覆盖了对话系统、代码辅助、多模态应用等多个领域。

DEVELOPERAA的博客 960

告别配置烦恼!保姆级教程:在Windows 10/11上为QT5.14.2配置MSVC2017编译器(附VS2022组件避坑指南)

本文提供了一份详细的保姆级教程,指导如何在Windows 10/11上为QT5.14.2配置MSVC2017编译器,包括VS2022组件避坑指南。从环境准备到关键配置,再到调试工具验证和Qt Creator中的编译器设置,一步步解决常见问题,帮助开发者快速搭建稳定可靠的开发环境。

weixin_30615767的博客 502

基于FPGA低频方波测量-频率与占空比

基于FPGA低频方波测量-频率与占空比

DRAXY的博客 6733

LLM——大型语言模型简介

在coursera上看到的视频,把笔记写一下。原视频更加生动,推荐有能力者可以去观看原视频。

2301_80917679的博客 1756

Python爬虫实战:高效爬取CNKI知网文献数据的技术解析

本文将详细介绍如何使用Python最新技术构建一个高效的CNKI知网文献爬虫系统。我们将从爬虫基础知识讲起,逐步深入到高级反反爬技术、分布式爬取、智能解析等前沿内容。文章包含完整的代码实现,涵盖请求模拟、数据解析、持久化存储等关键环节,并特别针对CNKI的反爬机制提供解决方案。通过本文,读者将掌握构建专业级学术文献爬虫的全套技术栈。关键词:Python爬虫、CNKI爬取、反反爬技术、文献数据挖掘、Scrapy框架本文详细介绍了如何使用Python最新技术构建CNKI知网文献爬虫。

2201_76125261的博客 2075

通向 AGI 之路:大型语言模型(LLM)技术精要

来源:AI科技评论作者:张俊林本文经授权转载自知乎:https://zhuanlan.zhihu.com/p/597586623?utm_campaign=shareopn&utm_medium=social&utm_oi=37478916423680&utm_psn=1595705313004679168&utm_source=wechat_timeline&am...

人工智能学家 2万+

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

大型语言模型(LLM)基础学习-什么是大型语言模型(LLM)

1.1 大型语言模型(LLM)的概念大语言模型(LLM,Large Language Model),也称大型语言模型,是一种旨在理解和生成人类语言的人工智能模型。LLM 通常指包含数百亿(或更多)参数的语言模型,它们在海量的文本数据上进行训练,从而获得对语言深层次的理解。目前,国外的知名 LLM 有 GPT-3.5、GPT-4、PaLM、Claude 和 LLaMA 等,国内的有文心一言、讯飞星火、通义千问、ChatGLM、百川等。

2301_76161259的博客 1356

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

大型语言模型 (LLM)类型和示例

大型语言模型(LLM)是一类深度学习模型,旨在处理和理解海量自然语言数据。简单地说,大型语言模型可以定义为人工智能/机器学习模型,它们试图解决与文本生成、摘要、翻译、问答(Q&A)等相关的 NLP 任务,从而实现更有效的人机交流。这就是为什么 LLM 需要处理和理解海量文本数据,并学习句子中单词之间的模式和关系。大型语言模型(LLM)之所以被称为 “大型”,是因为它们在大型文本语料库中预先训练了大量参数(1 亿多个),用于处理/理解和生成自然语言文本,以完成各种 NLP 任务。

2401_85325726的博客 2973

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

什么是LLM?了解AI大型语言模型

随着大型语言模型(LLM)的兴起,我们正步入一个由AI驱动的沟通新时代。这些模型的进步不仅预示着技术创新的新浪潮,也为社会发展开辟了前所未有的道路。然而,随着LLM的能力日益增强,如何确保它们在负责任和伦理的框架内被运用,亦成为了我们必须面对的挑战。

z551646的博客 2413

史上最全大型语言模型LLM介绍

摘要 大型语言模型(LLM)是能理解和生成人类语言的AI模型,参数量通常达数百亿以上。GPT、LLaMA等国外模型和文心一言等国内模型是典型代表。LLM发展经历了统计学习、深度学习到Transformer架构的演进,模型规模扩大带来了"涌现能力"。常见LLM包括OpenAI的GPT系列(最新GPT-5实现多模态融合)、Anthropic的Claude系列(最新Claude 4.1强化推理能力)等。LLM应用广泛,ChatGPT就是杰出代表,展现出流畅的人机对话能力。模型训练通常分为预训练

2401_85592132的博客 2714

《大型语言模型基础》:东北大学NLP实验室出品,全面解析LLM技术(附pdf)

「Foundations of Large Language Models」 📚,无论你是一名想继续深入学习大模型的 LLM Engineer,还是刚入门的大模型小白,这本书都可以作为你日常学习的基础书籍。

2301_81940605的博客 1617
上一篇: AI大模型入门指南3:提示工程
下一篇: AI大模型入门指南4:检索增强生成(RAG)
AI小模型
博客等级 码龄6年 6863粉丝 487原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

AI小模型

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值