AI大模型入门指南4:检索增强生成(RAG)

大模型的检索增强生成综述研究 大模型(LLMs)在处理特定领域或知识密集型任务时,它们仍面临挑战,例如产生“幻觉”、知识过时以及推理过程不透明、难以追溯等问题。为了解决这些问题,检索增强生成(Retrieval-Augmented Generation, RAG)作为一种有前景的解决方案应运而生,它通过整合外部数据库的知识来增强模型的准确性和可信度。本综述论文由来自同济大学上海智能自主系统研究所、复旦大学上海数据科学重点实验室以及同济大学设计创意学院的研究人员共同撰写。 阅读详情

图片

“仅凭Prompt工程根本无法满足人们日益增长的大模型需要,鉴于大模型本身诸多缺陷,比如不能及时更新知识、上下文有限等,人们开始给大模型加入插件,引入向量数据库,把数据索引进向量数据库,再召回数据,再做Prompt工程,这样就可以使用最新的知识和更准确的知识,这种方法叫做检索增强生成(RAG)。”

前文中提到,增加了Prompt工程的大模型,还是不能把问题回答的与时俱进,在专业领域不够专业。其实使用提示工程优化后的大模型还仅是一个通用大模型,并没有给它提供额外的专业知识,如果想要构建专用或者私有大模型,还需要使用检索增强生成(RAG)技术为它增加专业知识库。

检索增强生成

当下领先的大语言模型(LLMs)是基于大量数据训练的,目的是让它们掌握广泛的普遍知识,这些知识被储存在它们神经网络的权重(也就是参数记忆)里。但是,如果我们要求LLM生成的回答涉及到它训练数据之外的知识——比如最新的、专有的或某个特定领域的信息——这时就可能出现事实上的错误(我们称之为“幻觉”)。以下截图就是一个典型案例:

图片

这是ChatGPT回答“总统对布雷耶法官有何看法?”这个问题的情况。

因此,弥合LLM的常识与任何额外语境之间的差距非常重要,这样才能帮助 LLM生成更准确、更符合语境的补全,同时减少幻觉。

RAG是解决其中一些挑战的一种方法。它会重定向LLM,从权威的、预先确定的知识来源中检索相关信息。组织可以更好地控制生成的文本输出,并且用户可以深入了解LLM如何生成响应。

一、什么是检索增强生成

检索增强生成(Retrieval-Augmented Generation,RAG)是指对大型语言模型输出进行优化,使其能够在生成响应之前引用训练数据来源之外的权威知识库。大型语言模型(LLM)用海量数据进行训练,使用数十亿个参数为回答问题、翻译语言和完成句子等任务生成原始输出。在LLM本就强大的功能基础上,RAG将其扩展为能访问特定领域或组织的内部知识库,所有这些都无需重新训练模型。这是一种经济高效地改进LLM输出的方法,让它在各种情境下都能保持相关性、准确性和实用性。

LLM是一项关键的人工智能(AI)技术,为智能聊天机器人和其他自然语言处理(NLP)应用程序提供支持。目标是通过交叉引用权威知识来源,创建能够在各种环境中回答用户问题的机器人。但是,LLM技术的本质在LLM响应中引入了不可预测性。此外,LLM训练数据是静态的,并引入了其所掌握知识的截止日期。

二、重要意义

RAG技术为专用或私有大模型建立带来了诸多益处:

1.降低成本、增强安全性

聊天机器人开发通常从基础模型开始。基础模型(FM)是在广泛的广义和未标记数据上训练的API可访问LLM,不包含私有数据,因此对于一些私有领域知识是欠缺的。针对组织或领域特定信息重新训练LLM的成本很高。此外,有研究和实践表明,通过一些特定的攻击手法,可以让LLM泄漏训练数据,如果训练数据中包含一些私有信息,就很可能会发生隐私信息泄露。如果把私有数据作为一个外部数据库,让LLM在回答基于私有数据的问题时,直接从外部数据库中检索出相关信息,再结合检索出的相关信息进行回答。这样就不用通过预训练或者微调的方法让LLM在参数中记住私有知识,既节省了训练或者微调成本,也一定程度上避免了私有数据的泄露风险。因此,RAG是一种将新数据引入LLM的更加经济高效的方法。它使生成式人工智能技术更广泛地获得和使用。

2.保证数据实时性

即使LLM的原始训练数据来源适合您的需求,但保持相关性也具有挑战性。RAG允许开发人员为生成模型提供最新的研究、统计数据或新闻。他们可以使用RAG将LLM直接连接到实时社交媒体提要、新闻网站或其他经常更新的信息来源。然后,LLM可以向用户提供最新信息。

3.增强用户信任度

RAG允许LLM通过来源归属来呈现准确的信息。输出可以包括对来源的引文或引用。如果需要进一步说明或更详细的信息,用户也可以自己查找源文档。这可以增加对您的生成式人工智能解决方案的信任和信心。

4.更多开发人员控制权

借助RAG,开发人员可以更高效地测试和改进他们的聊天应用程序。他们可以控制和更改LLM的信息来源,以适应不断变化的需求或跨职能使用。开发人员还可以将敏感信息的检索限制在不同的授权级别内,并确保LLM生成适当的响应。此外,如果LLM针对特定问题引用了错误的信息来源,他们还可以进行故障排除并进行修复。

三、大体工作过程

如果没有RAG,LLM会接受用户输入,并根据它所接受训练的信息或它已经知道的信息创建响应。RAG引入了一个信息检索组件,该组件利用用户输入首先从新数据源提取信息。用户查询和相关信息都提供给LLM。LLM使用新知识及其训练数据来创建更好的响应。以下各部分概述了该过程。

1.创建外部数据

LLM原始训练数据集之外的新数据称为外部数据。它可以来自多个数据来源,例如API、数据库或文档存储库。数据可能以各种格式存在,例如文件、数据库记录或长篇文本。另一种称为嵌入语言模型的AI技术将数据转换为数字表示形式并将其存储在向量数据库中。这个过程会创建一个生成式人工智能模型可以理解的知识库。

2.检索相关信息

下一步是执行相关性搜索。用户查询将转换为向量表示形式,并与向量数据库匹配。例如,考虑一个可以回答组织的人力资源问题的智能聊天机器人。如果员工搜索:“我有多少年假?”,系统将检索年假政策文件以及员工个人过去的休假记录。这些特定文件将被退回,因为它们与员工输入的内容高度相关。相关性是使用数学向量计算和表示法计算和建立的。

3.增强LLM提示

接下来,RAG模型通过在上下文中添加检索到的相关数据来增强用户输入(或提示)。此步骤使用提示工程技术与LLM进行有效沟通。增强提示允许大型语言模型为用户查询生成准确的答案。

4.更新外部数据

下一个问题可能是——如果外部数据过时了怎么办?要维护当前信息以供检索,请异步更新文档并更新文档的嵌入表示形式。您可以通过自动化实时流程或定期批处理来执行此操作。这是数据分析中常见的挑战——可以使用不同的数据科学方法进行变更管理。

四、具体工作原理

下图显示了将RAG与LLM配合使用的概念流程图,主要分为2个阶段:数据准备阶段(紫色动线)、应用阶段(绿色动线)。下面我们详细介绍一下各阶段的:

图片

数据准备阶段工作流程(紫色动线):
私有数据经过数据提取和文本分割,再经过嵌入向量化(Embeding),生成语义向量(Semantic Vector),并把数据存入向量数据库(Vector Database),这个向量数据库也就是所谓的本地知识库。

应用阶段工作流程(绿色动线):

用户准备提示词和问题,生成查询向量(Query Vector),进入本地向量数据库进行数据检索(召回),返回的信息注入Prompt,再把Prompt输入大模型生成最终响应。

特别解释一下【注入Prompt】:

Prompt作为大模型的直接输入,是影响模型输出准确率的关键因素之一。在RAG场景中,Prompt一般包括任务描述、背景知识(检索得到)、任务指令(一般是用户提问)等,根据任务场景和大模型性能,也可以在Prompt中适当加入其他指令优化大模型的输出。一个简单知识问答场景的Prompt如下所示:

【任务描述】假如你是一个专业的客服机器人,请参考【背景知识】,回【背景知识】{content} // 数据检索得到的相关文本【问题】石头扫地机器人P10的续航时间是多久?

Prompt的设计只有方法、没有语法,比较依赖于个人经验,在实际应用过程中,往往需要根据大模型的实际输出进行针对性的Prompt调优。这就是我们前文提到的知识了。

名词解释:

数据检索:常见的数据检索方法包括:相似性检索、全文检索等,根据检索效果,一般可以选择多种检索方式融合,提升召回率。

嵌入向量化(Embeding):Embedding(嵌入)是自然语言处理(NLP)和机器学习领域中的一个核心概念,指的是将高维的离散数据(如单词、句子或文档)转换成低维的连续数值向量的过程。这种转换使得原本计算机难以直接处理的文本数据能够以数值形式被机器学习模型所理解和处理。

语义向量(Semantic Vector):Semantic Vector(语义向量)是一种将自然语言文本转换成数值向量的技术,它试图捕捉文本中的语义信息。在大模型领域,Semantic Vector通常指的是通过大型预训练语言模型(如BERT、GPT等)生成的向量,这些向量能够表示词汇、句子或段落的语义内容。这些向量可以用于各种下游任务,如文本相似性比较、语义搜索、机器翻译等。

查询向量(Query Vector):Query Vector(查询向量)是自然语言处理(NLP)和信息检索领域中的一个概念,它指的是将用户的查询(即问题或搜索请求)转换成数值向量的形式。这种转换使得计算机能够通过向量空间模型来处理和理解用户的查询意图,并利用这些向量来执行搜索、匹配或推荐等任务。

五、几种调用模式

图片

模式一:非结构化数据通过Embedding Model把非结构化数据进行embedding存到向量数据库中,然后形成Construct Prompts给到LLM。LLM返回结果给到用户。

模式二:用户提出问题,下一步把问题通过Embedding Model向量化,然后保存到长时记忆数据库(向量数据库)中,然后调用LLM完成问题的回答,接下来将大模型的回答存到长时记忆数据库中,最后返回给用户。

模式三:用户问问题,下一步把问题通过Embedding Model向量化,然后从Cache中(向量数据库)查询类似的问题和答案,返回给用户。如果没有命中,则去和LLM交互。然后把LLM的回答存到Cache中,最后把回答返回给用户。

这三种形式就是典型的RAG的调用模式。它可以解决不同类型的数据如何让大模型知道的问题,同时在性能和效率上得到了提高,解决了长时记忆的问题,幻觉问题也有很大改善。

检索增强生成 vs. 微调

与对基座大语言模型预训练或有监督微调(Supervised Fine-Tuning,SFT)等传统方法相比,RAG提供了一种经济高效的替代方法。RAG从根本上增强了大语言模型在响应特定提示时直接访问特定数据的能力。为了说明 RAG与其他方法的区别,请看下图。雷达图具体比较了三种不同的方法:预训练大语言模型、预训练+微调LLM、预训练+RAG LLM。

图片

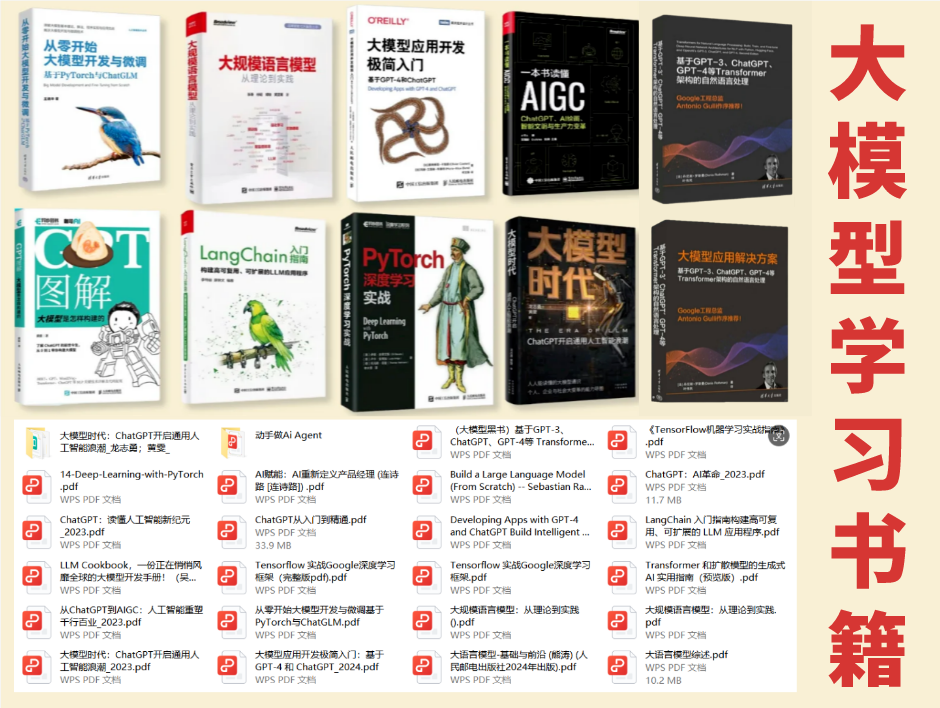
学习书籍文档

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)
在这里插入图片描述

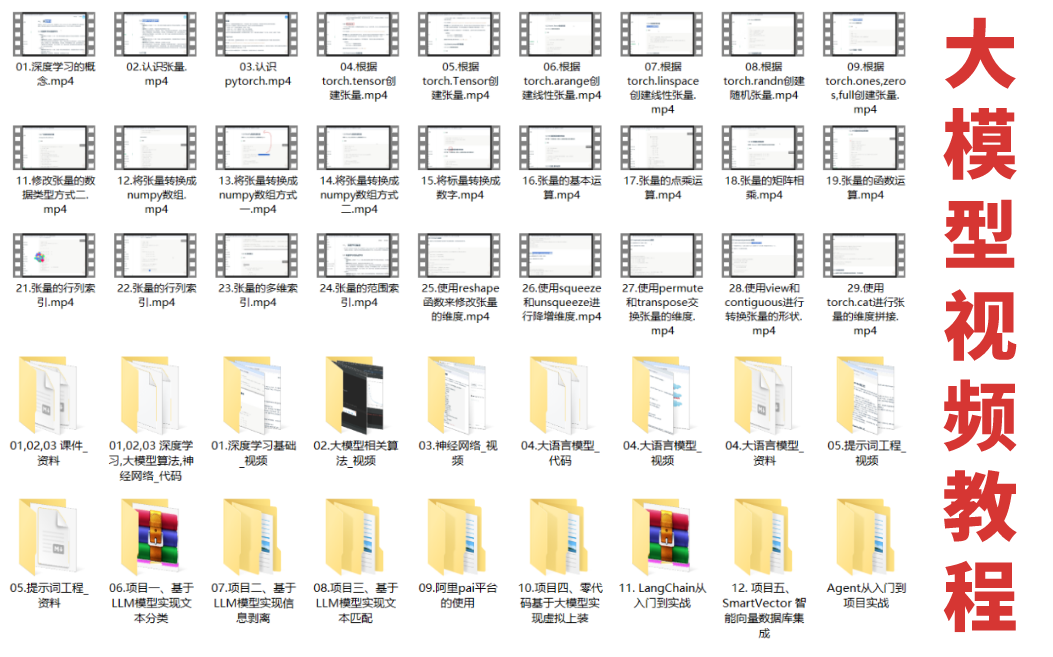
学习视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。
在这里插入图片描述

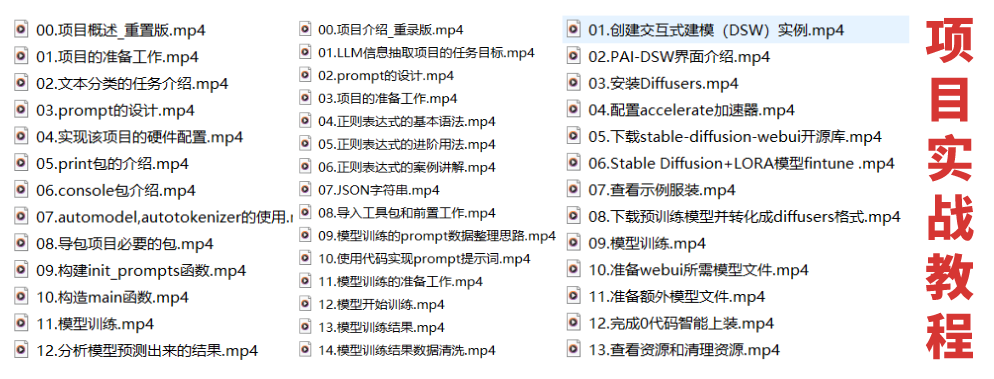
项目实战源码

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。
在这里插入图片描述

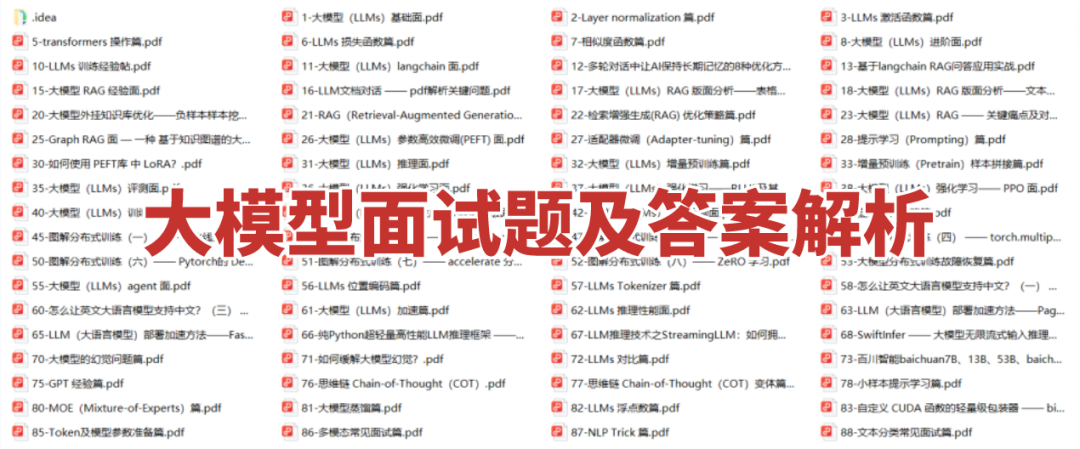
大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
图片

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取 

参考文献:

1. https://aws.amazon.com/cn/what-is/retrieval-augmented-generation/

2. https://baoyu.io/translations/rag/retrieval-augmented-generation-rag-from-theory-to-langchain-implementation

3. https://github.com/wdndev/llm_interview_note/tree/main

4. https://www.youtube.com/watch?app=desktop&v=4PdQ_7sCFYY

RTKLIB模糊度固定实战:三种模式对比与部分模糊度固定代码解析 本文深入解析RTKLIB中模糊度固定的三种核心模式(continuous、instantaneous、fix and hold),对比其性能与适用场景,并详细拆解了部分模糊度固定技术的源码实现。通过实战案例与代码级解析,为GNSS高精度定位开发者提供了在不同数据特性下提升固定成功率的优化思路与配置建议。 阅读详情

相关推荐

霍尔式流量计背后的技术和算法

例如,在一项实验中,当流量低于最小操作范围(0.250 L/min)时,误差比其他流量大,但仍然在95%的精度范围内可接受。例如,在Honeywell电子学的测试中,使用30英寸水柱的压力计和热电偶测量气体特性,记录并计算实际和理论质量流量,以确定修正系数。霍尔式流量计的校准系数是通过一系列精确的测量和计算步骤确定的,以确保其测量结果的准确性和可靠性。霍尔式流量计的校准系数是通过严格的环境条件、精确的测量步骤和实验数据确定的。其中,Qs是标尺介质的流量,K是修正系数,Qm是用户介质的流量。

百态·数智思维 | 聚焦大数据、量化与未来AI 1234

大模型+检索增强(RAG、Atlas 和 REPLUG)

大模型+检索增强/图谱增强(RAG、Atlas 和 REPLUG)

ZhengrongYue的博客 1万+

STM32实战:5分钟搞定CanFestival协议栈下的CANopen心跳报文配置(附避坑指南)

本文详细介绍了如何在STM32平台上使用CanFestival协议栈快速配置CANopen心跳报文,包括硬件准备、协议栈移植、心跳报文配置及常见问题解决方案。通过实战步骤和避坑指南,帮助开发者高效实现节点状态监控,提升工业控制系统的可靠性。

win55的博客 747

一文彻底搞懂大模型 - RAG(检索、增强、生成)

RAG(Retrieval-Augmented Generation,检索增强生成) 是一种结合了信息检索技术与语言生成模型的人工智能技术。该技术通过从外部知识库中检索相关信息,并将其作为提示(Prompt)输入给大型语言模型(LLMs),以增强模型处理知识密集型任务的能力,如问答、文本摘要、内容生成等。RAG模型由Facebook AI Research(FAIR)团队于2020年首次提出,并迅速成为大模型应用中的热门方案。前排提示,文末有大模型AGI-优快云独家资料包哦!一、检索增强生成(RAG)什么

lvaolan168的博客 4321

NVIDIA Jetson AGX Xavier设置风扇转速、工作模式及性能监控

Xavier的风扇在开机之后是默认关闭的,每次重启都需要手动打开风扇,后续可能考虑修改bashrc文件进行自动开启 这个是显示当前风扇的转速,默认应该是0,表示关闭,最大是250 cat /sys/devices/pwm-fan/target_pwm 可以通过修改该文件的值来修改风扇转速 vim /sys/devices/pwm-fan/target_pwm 我一般使用的是100这个值 作者:ryan_ren 链接:https://www.jianshu.com/p/d3c2041f7f7d 来源:简书 著

weixin_43877080的博客 1万+

告别FreeRTOS?手把手带你用NuttX在STM32F4-Discovery上跑起第一个Shell

本文详细介绍了如何在STM32F4-Discovery开发板上从FreeRTOS迁移到NuttX,并运行第一个Shell。NuttX以其完整的POSIX兼容性和模块化架构优势,特别适合复杂网络应用的开发。通过环境搭建、移植配置、调试技巧及POSIX开发实践,帮助开发者高效构建嵌入式系统。

weixin_42526417的博客 299

什么是检索增强生成?

检索增强生成(Retrieval Augmented Generation,RAG)是指对大型语言模型(Large Language Model,LLM)输出进行优化,使其能够在生成响应之前引用训练数据来源之外的权威知识库。LLM 用海量数据进行训练,使用数十亿个参数为回答问题、翻译语言和完成句子等任务生成原始输出。在 LLM 本就强大的功能基础上,RAG 将其扩展为能访问特定领域或组织的内部知识库,所有这些都无需重新训练模型。

加百力 的技术博客 2893

LightRAG实战:从零构建中药知识图谱,解锁六种检索模式效能对比

本文详细介绍了如何使用轻量级RAG框架LightRAG从零构建中药知识图谱的实战过程。通过本地部署环境搭建、开源模型配置与《本草纲目》数据导入,文章重点对比了Naive、Local、Global、Hybrid、Mix和Bypass六种检索模式在中药问答中的效能差异,并提供了可视化图谱与优化心得,为开发者构建专业领域智能问答系统提供了实用指南。

weixin_29096377的博客 176

检索增强生成

20分钟讲明白检索增强(内附基于LangChain搭建简单RAG系统简单教程)

qzhqbb的博客 1620

YOLOv8集成EMA注意力机制YOLOv8完整教程 将EMA注意力机制集成到YOLOv8框架中

YOLOv8教程这篇文章介绍了如何将EMA(高效多尺度注意力)机制集成到YOLOv8目标检测框架中。YOLOv8 EMA注意力机制通过多尺度特征融合和高效计算,能够提升模型对关键特征的关注能力。文章详细解析了EMA的原理和结构设计,包括其核心组件和前向传播过程。此外,提供了完整的实现指南,包括环境准备、项目结构设置、EMA模块代码实现(包含分组处理、空间注意力计算和特征融合等关键步骤)。YOLOv8 YOLOv8 YOLOv8 YOLOv8 YOLOv8

FJN110的博客 928

【FPGA教程案例89】编译码2——使用vivado核实现RS信道编译码

RS编码,又称里所码,即Reed-solomon codes,是一种前向纠错的信道编码,对由校正过采样数据所产生的多项式有效。当接收器正确的收到足够的点后,它就可以恢复原来的多项式,即使接收到的多项式上有很多点被噪声干扰失真。

FPGA/MATLAB学习教程/源码/项目合作开发 3542

Elasticsearch:什么是检索增强生成 (RAG)?

​检索增强生成 (RAG) 是一种利用来自私有或专有数据源的信息来补充文本生成的技术。 它将旨在搜索大型数据集或知识库的检索模型与大型语言模型 (LLM) 等生成模型相结合,后者获取该信息并生成可读的文本响应。 检索增强生成可以通过添加来自其他数据源的上下文并通过培训补充 LLMs 的原始知识库来提高搜索体验的相关性。 这增强了大型语言模型的输出,而无需重新训练模型。 其他信息来源的范围包括 LLM 未受过培训的互联网上的新信息、专有业务背景或属于企业的机密内部文件。 RAG 对于问答和内容生成等任务

Elastic 中国社区官方博客 5123

PCL点云DBSCAN聚类算法:基于密度的点云聚类

核心点是在给定半径内拥有足够多邻居点的点,边界点是在给定半径内没有足够多邻居点但是位于核心点的邻域内的点,噪声点是既不是核心点也不是边界点的点。本文将介绍PCL中的DBSCAN(基于密度的空间聚类应用噪声)算法,用于点云数据的聚类。上述示例代码首先从PCD文件中读取点云数据,并设置了DBSCAN聚类的参数,包括邻域搜索半径(epsilon)和邻域内最小点数(min_points)。需要注意的是,示例代码中的点云数据格式为pcl::PointXYZ,如果使用其他类型的点云数据,需要相应地修改代码。

LpmShell的博客 1239

一文读懂:大模型RAG(检索增强生成)

本文概述 RAG 的核心算法,并举例说明其中的一些方法。RAG融合是一个强大的功能,能够提高RAG应用的语义搜索效率。通过使用语言模型生成多个查询并对搜索结果进行重新排序,RAG融合可以呈现更丰富多样的内容,并提供了一个额外的层次,用于调整应用。此外,RAG融合还可以实现自动纠正、节省成本以及增加内容多样性。但是,需要注意一些权衡,比如潜在的延迟问题、自动纠正的挑战以及成本影响。对于依赖常见概念但可能出现内部行话或重叠词汇的应用来说,RAG融合尤其有用。

m0_59164304的博客 4万+

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

AI外挂RAG:大模型时代的检索增强生成技术

在人工智能领域,大型语言模型(LLM)如ChatGPT、DeepSeek等已经展现出惊人的能力,但它们也面临着一些固有局限:知识过时、产生幻觉、缺乏专业领域知识等。RAG技术代表了大模型时代的一个重要发展方向,它通过引入外部知识库,有效解决了大模型的固有局限。用通俗的话来说,RAG就像让大模型进行"开卷考试":当遇到不熟悉的问题时,先去"翻书"查找相关资料,然后再基于查找到的信息生成答案。例如,在医疗、法律等专业领域,大模型可能缺乏足够的专业知识,导致回答不够准确或专业。

攻城狮7号的博客 2676

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

RAG(检索增强生成)学习路径全解析:从入门到精通

RAG(检索增强生成)技术作为结合了信息检索和生成式模型的方法,正在人工智能领域发挥越来越重要的作用。通过提供的高质量中文文章资源,学习者可以系统地掌握RAG技术的原理、实现和应用,从初学者到高级开发者都能找到适合自己的学习路径。从基础概念到高级技术,从入门教程到实际应用,从框架工具到最新研究,这些资源涵盖了RAG技术的各个方面,为学习者提供了全面的学习指南。希望这些资源能够帮助学习者在RAG技术领域取得长足进步,为人工智能的发展做出贡献。图片来源网络,侵权删。

沛哥儿的专栏 4028

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

一文彻底搞懂rag大模型(检索、增强、生成)

一文彻底搞懂rag大模型(检索、增强、生成)

Python单行客的博客 7258

2024检索增强生成RAG最新综述

人工智能生成内容(AIGC)的发展得益于模型算法的进步、基础模型规模的增加以及大量高质量数据集的可用性。虽然AIGC取得了显著的性能,但仍面临一些挑战,如难以保持最新和长尾知识、数据泄露的风险以及与训练和推理相关的高成本。检索增强生成(RAG)最近出现作为一种范式来解决这些挑战。具体而言,RAG引入信息检索过程,通过从可用数据存储中检索相关对象来增强生成过程,从而提高准确性和鲁棒性。本文全面审查了将RAG技术整合到AIGC场景中的现有努力。

m0_59163425的博客 4769

AI大模型教程:RAG检索增强生成

RAG目前是基于LLM系统中最受欢迎的架构,有许多产品基于RAG构建,使RAG成为推动聊天机器人发展和增强LLM在现实世界应用适用性的关键技术。

Y525698136的博客 2282

AI|大模型入门(四):检索增强生成(RAG)

检索增强生成(Retrieval-Augmented Generation,RAG)是指对大型语言模型输出进行优化,使其能够在生成响应之前引用训练数据来源之外的权威知识库。大型语言模型(LLM)用海量数据进行训练,使用数十亿个参数为回答问题、翻译语言和完成句子等任务生成原始输出。在LLM本就强大的功能基础上,RAG将其扩展为能访问特定领域或组织的内部知识库,所有这些都无需重新训练模型。这是一种经济高效地改进LLM输出的方法,让它在各种情境下都能保持相关性、准确性和实用性。

z551646的博客 1274

检索增强生成 (RAG) 入门指南

RAG 生成器负责将检索和排序后的的信息以及用户的原始查询作为输入,并生成最终的答案或输出。它使用生成模型,例如基于 transformer 的模型 (例如 GPT、BERT),来生成文本,这些文本与上下文相关、连贯且信息丰富。生成器确保答案与用户的查询一致,并纳入从外部来源检索到的事实性知识。

2301_76161259的博客 1416

检索增强生成(RAG)入门

RAG是一个利用特定任务的外部知识来提高由生成模型驱动的应用性能的框架。RAG流水线的有不同组成部分,包括外部知识源、提示模板和生成模型,如何在检索、增强和生成。包括市场上流行的RAG使用案例和实现框架,例如LangChain、LlamaIndex和DSPy。最后本文涉及了一些专业的RAG技术,包括高级RAG方法、智能体RAG和图形RAG,以及用于评估RAG流水线的方法。目录1概要1.1生成模型的限制1.2检索增强生成 (RAG)是什么?2RAG架构3提示模板4RAG是如何工作的?

lyy2017175913的博客 1656

【LLM大模型】人工智能|RAG 检索增强生成

RAG(Retrieval-Augmented Generation),通过将检索模型和生成模型(LLM)结合在一起,即可提高了生成内容的相关性和质量。

DEVELOPERAA的博客 1061

一文彻底搞懂:大模型RAG(检索增强生成)

本文概述 RAG 的核心算法,并举例说明其中的一些方法。RAG融合是一个强大的功能,能够提高RAG应用的语义搜索效率。通过使用语言模型生成多个查询并对搜索结果进行重新排序,RAG融合可以呈现更丰富多样的内容,并提供了一个额外的层次,用于调整应用。此外,RAG融合还可以实现自动纠正、节省成本以及增加内容多样性。但是,需要注意一些权衡,比如潜在的延迟问题、自动纠正的挑战以及成本影响。对于依赖常见概念但可能出现内部行话或重叠词汇的应用来说,RAG融合尤其有用。

qkh1234567的博客 3599
上一篇: LLM大型语言模型脑图-基础技术篇
下一篇: AI大模型入门指南5:智能体(Agent)
AI小模型
博客等级 码龄6年 6863粉丝 487原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

AI小模型

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值