一文搞懂李飞飞的空间智能(世界模型)

空间智能-李飞飞团队工作总结(至2025.07) 李飞飞团队在空间智能领域取得突破性进展总结:2024年系统化定义空间智能为机器理解3D世界的基础能力;2024-2025年实现单图生成3D场景、开发评估工具VSI-Bench和长视频数据集HourVideo;2025年应用于具身智能机器人,结合认知地图提升空间推理能力。团队成立World Labs公司推动商业化,开源3D渲染器Forge,并验证低成本模型训练可行性。未来将聚焦多模态融合与伦理问题,推动AI从感知到交互的全面进化。 阅读详情

如果当前如火如荼的大语言模型(LLM)只是一个“能言善辩的瞎子”,你还会认为AI真的理解世界吗?AI教母李飞飞一针见血地指出,LLM的知识缺乏“现实根基”。而她提出的下一个前沿——空间智能,目标正是为AI装上“眼睛”和“双手”,让它真正看懂、并走入我们的世界。

【李飞飞老师学习资料已整理好】
李飞飞倡导的“空间智能”,其技术内核是从基于符号的LLM范式,转向基于物理模拟的“世界模型”范式。这是AI想要从“数字世界”走进“物理世界”所必须跨越的技术鸿沟。让我们一起从“是什么”、“为什么”、“怎么做”三个维度,来彻底搞懂她提出的“空间智能”技术内涵。
一、是什么?

什么是空间智能(Spatial Intelligence)?—— 超越语言的“世界模型”

李飞飞认为当前以大语言模型为代表的AI存在根本性局限——它们是基于符号(文字)的系统,缺乏对物理世界的“根基”理解。

(1)LLM是“黑暗中的文字匠”

LLM通过学习海量文本数据中的统计规律,变得“能言善辩”。但它并不真正“理解”它所说的内容。例如,它知道“苹果从树上掉下来”这句话很常见,但它并不理解“掉下来”背后的重力、速度、质量等物理概念。

(2)空间智能是人类认知的“脚手架”

人类智能的进化始于与物理世界的互动。我们需要感知环境(看、听、触),理解物体在空间中的关系(远近、上下、内外),预测其物理动态(碰撞、支撑、坠落),并据此行动。这种对三维空间的、物理的、动态的世界的内在理解能力,就是空间智能。它是我们进行推理、想象和创造的基础。

(3)空间智能的终极载体是“世界模型”

要让AI拥有空间智能,不能只靠更大的文本训练数据,而是要构建一个全新的模型——世界模型。这个模型的内在对世界的表示,不再是文字序列,而是一个符合几何、物理和语义规律的、可推理和可交互的模拟世界。
通过李飞飞的专业解释,我们脑补下空间智能的画面。它让AI不仅能读懂“苹果落地”这句话,更能像我们一样,在脑海里想象出苹果掉落的轨迹、理解背后的重力,甚至预判它会弹几下。同时也初步了解实现它的核心,就是为AI构建一个名为“世界模型”的内心模拟器,使其能真正“感受”并“互动”于这个三维世界,而不仅仅是阅读和生成关于这个世界的文本。
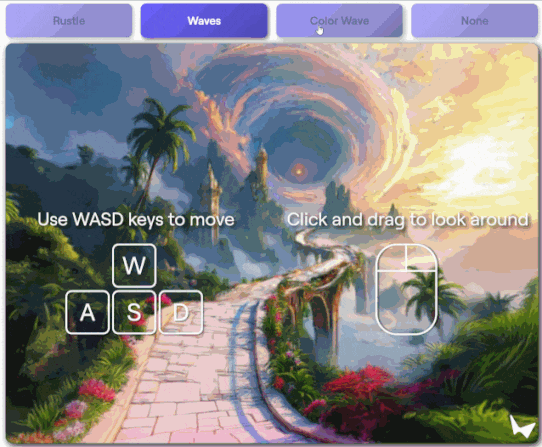
二、为什么?

为什么需要空间智能?—— 突破AI的能力天花板

李飞飞指出了当前AI在需要空间理解的任务上表现不佳,这限制了其应用边界。主要存在如下问题:

  1. (1)低级空间任务失败

  2. 让最先进的多模态模型估算距离、从新视角想象一个物体、数清视频中不重复的物体数量,它的表现往往很差。

  3. (2)缺乏物理常识

  4. AI无法预测一个堆叠的积木塔是否会倒下,也无法规划穿过房间的最短路径,因为它没有内置的物理规则。

  5. (3)生成内容缺乏连贯性

  6. AI生成的视频几秒后就会“崩坏”,因为它无法保持场景在时间和空间上的长期一致性。

  7. (4)无法与真实世界互动

  8. 这是最关键的局限。要让机器人拿杯子,AI不仅要知道“杯子”这个词,还要理解杯子的3D形状、材质(是易碎的瓷杯还是柔软的纸杯)、它与其他物体的位置关系,以及抓取它需要施加多大的力。
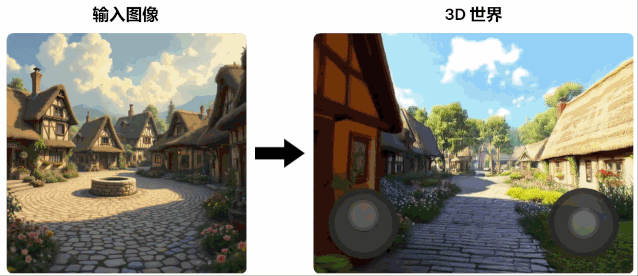
通过李飞飞的论文,我们了解了当前AI的瓶颈局限。目前的AI(如自动驾驶)在处理熟悉场景时已非常可靠,但其能力严重依赖事先见过的海量数据。它的核心瓶颈是缺乏“物理常识”,无法真正理解世界,因此难以安全处理未知的复杂情况。

发展空间智能,就是为AI装上理解物理规则的“大脑”,让它能从机械的“识别”进化到真正的“理解”,从而突破瓶颈,实现真正的自主。
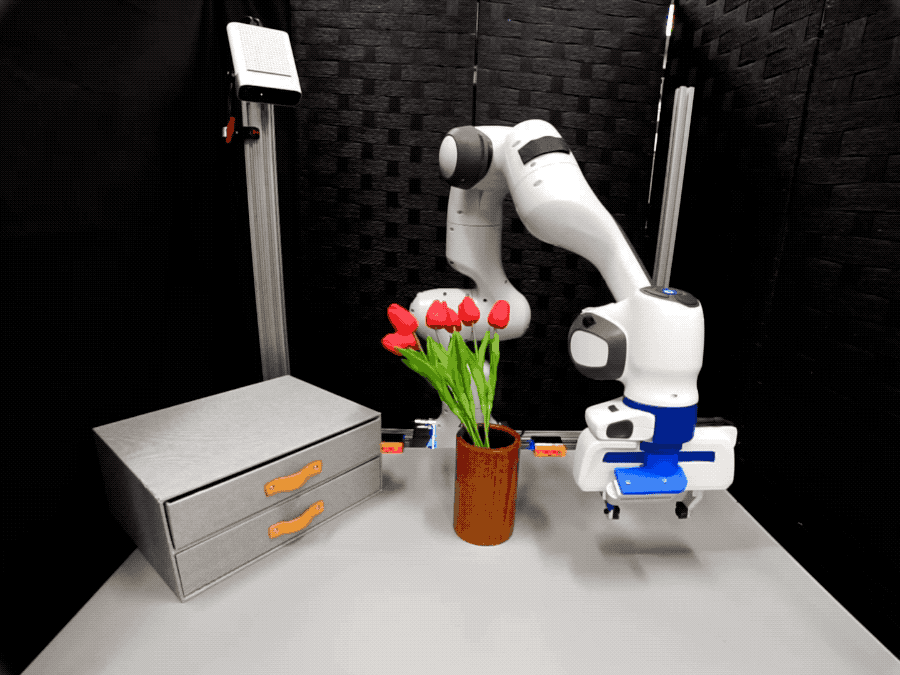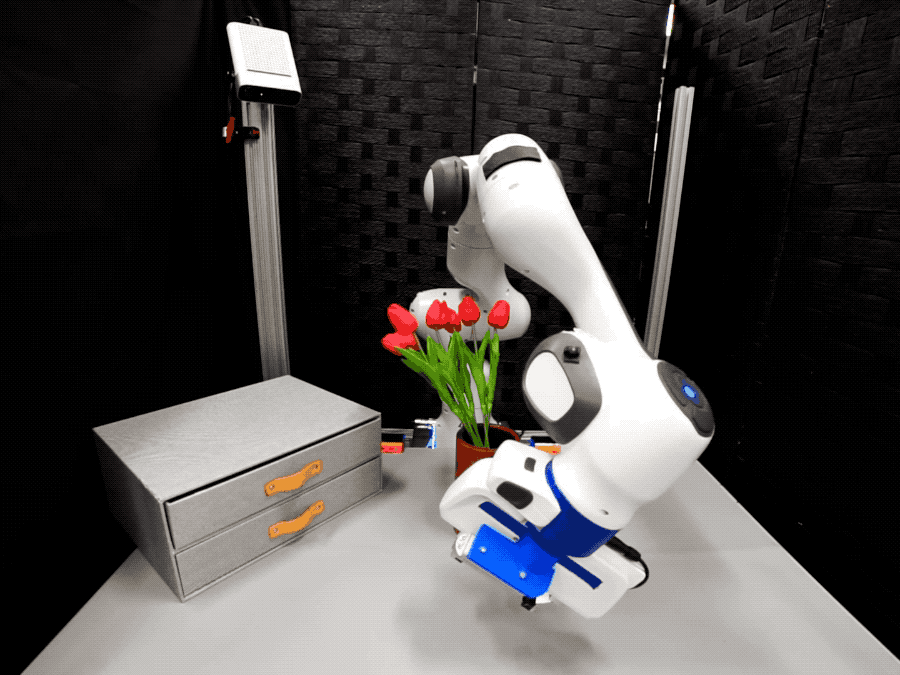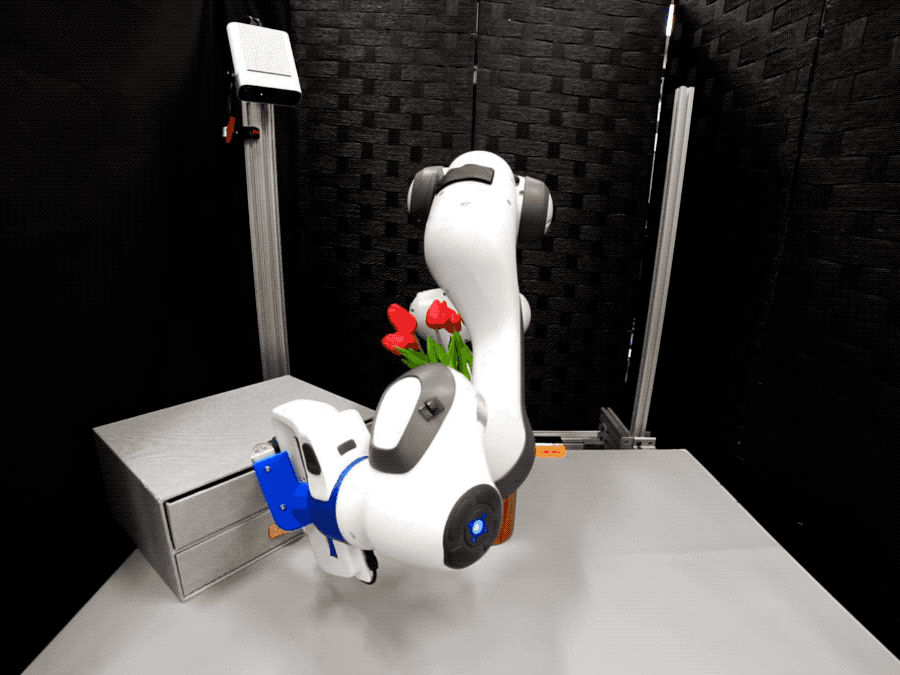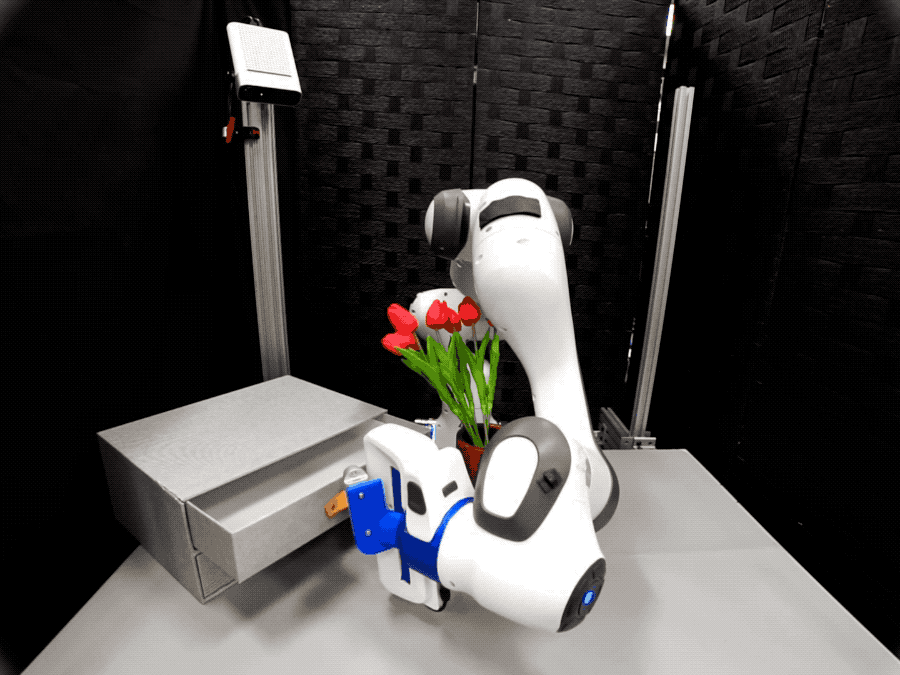
三、怎么做?

 如何实现空间智能?-  技术核心与挑战

李飞飞提出了构建“世界模型”的三大核心能力和面临的巨大技术挑战。

(1)世界模型的三大核心能力:生成性、多模态、交互性

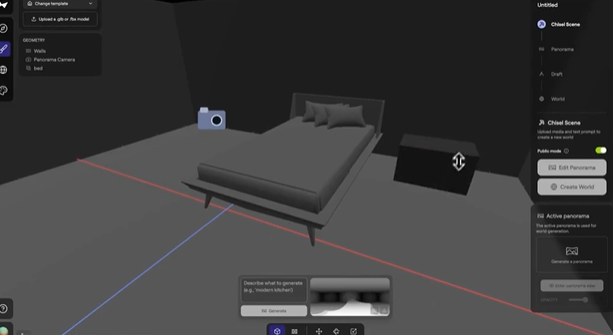
  • 生成性:模型不仅能生成一张逼真的图片,还能生成一个完整的、一致的、可探索的3D环境。这个环境必须在其自身的规则下是“真实”的——物体有体积、不会穿模、符合物理定律(如重力)。例子:你提示“生成一个阳光明媚的海滩”,世界模型会创建一个3D场景,你可以走进这个场景,从任何角度观察,看到海浪拍打沙滩的连续动态,并且捡起的贝壳不会穿透你的手掌。
  • 多模态:模型的“提示”和“输出”都必须是多模态的。输入可以是文本、图像、深度图、手势、动作指令等;输出也应是相应的世界状态(如图像、视频、3D网格、物理模拟数据)。例子:你可以对模型说“把那边蓝色的椅子移到窗户旁边”(语言+手势指向),模型能理解你的指令,并在生成的世界中模拟出椅子被移动的整个过程和结果。
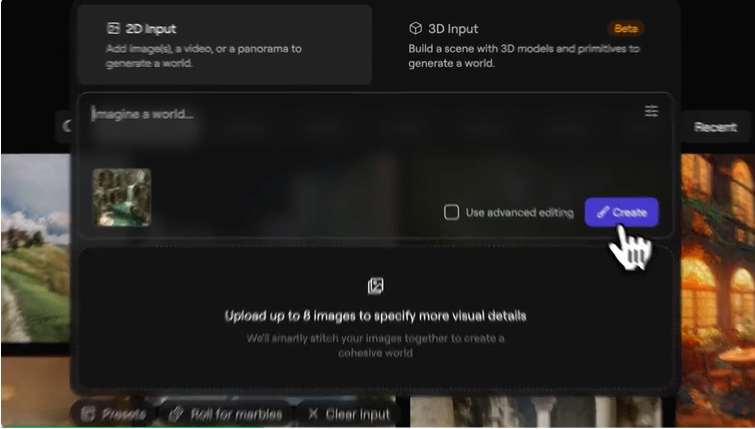
  • 交互性:这是世界模型与LLM的本质区别。模型必须能根据动作来预测世界的下一个状态。这模拟了“感知-行动”循环。例子:在模拟中,你(或AI智能体)推动一个箱子,世界模型能计算出箱子被推动后的新位置,以及它是否会撞到其他物体。这是训练机器人和游戏AI的基础。
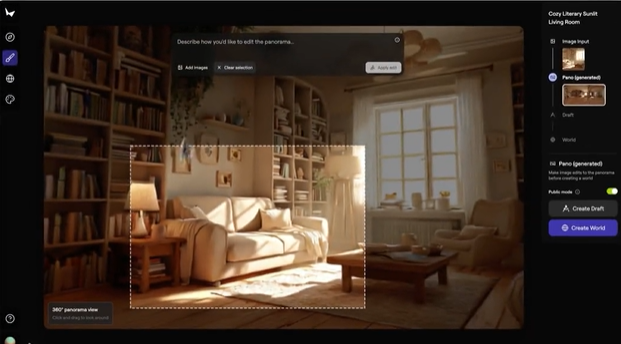
LLM有非常优雅的训练目标——“下一个词预测”。

但对于世界模型,如何设计一个同样强大且通用的训练目标?这个目标必须能同时学习语义、几何、物理等多种约束,极其复杂。

训练世界模型需要海量的、带有丰富空间信息的数据(如3D几何、深度、物理属性)。互联网上虽有海量图片和视频,但它们大多是2D的,缺乏显式的3D和物理信息。

(1)从2D反推3D

开发更强大的算法,从一张普通的照片或一段电影视频里,“猜”出物体的三维形状和远近关系。就像我们人类仅凭一张静态照片,就能在脑海里想象出这个场景的3D结构一样。

(2)利用合成数据

在虚拟引擎(如Unity, Unreal)中生成大量带精确标注的合成数据。这样在虚拟引擎中创造一个“完美的练习世界”,AI学习所用的每一个物体、每一个场景,其精确的尺寸、形状、物理属性都已经被提前完美定义好。让AI能高效、安全地学习世界的三维规则。

(3)新的传感器

鼓励使用能直接捕获深度、触觉等信息的传感器。这相当于让AI天生就拥有了感知立体空间的“超能力”,从根本上解决了从平面信息推断立体世界的难题。
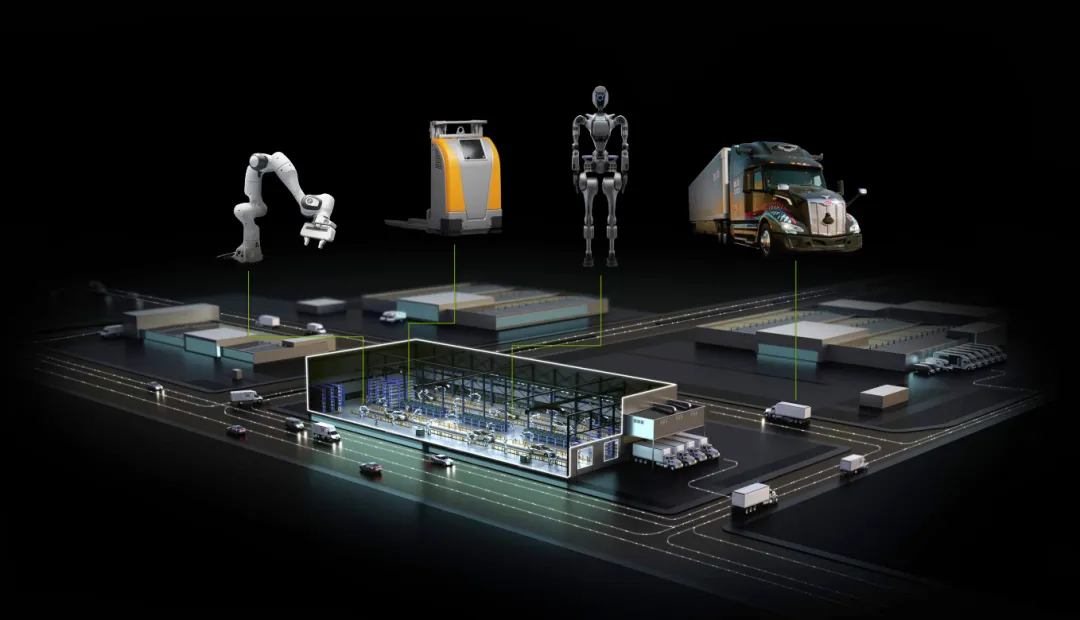
李飞飞创业公司World Labs:引领AI新方向的“大世界模型” 随着人工智能的不断进步,AI领域涌现了许多新兴技术和研究方向。在这其中,李飞飞创办的World Labs凭借其独特的“空间智能”和“大世界模型”(Large World Model, LWM)理念,迅速成为焦点。尤其是在获得了2.3亿美元的融资后,World Labs的愿景引发了广泛关注。这篇文章将深入探讨World Labs的核心技术与战略,探索其在AI领域的独特贡献以及未来的潜在影响。 阅读详情

相关推荐

AI教母李飞飞:从ImageNet到世界模型,空间智能如何定义下一代AI的疆界

摘要:李飞飞博士回顾AI发展历程,从ImageNet突破数据瓶颈开启深度学习革命,到提出以人为本的AI伦理框架。她指出当前大语言模型的局限性,强调空间智能与世界模型(WLM)是AI下一前沿,其团队开发的Marble平台可生成交互式3D环境,应用于影视、医疗等领域。李飞飞认为机器人技术面临物理系统复杂性等独特挑战,呼吁技术创新需以增强人类福祉为核心。全文展现AI从数据驱动到空间认知的范式转变,体现科学家对技术社会价值的深刻思考。(149字) 注:严格控制在150字内,涵盖AI发展历程、技术突破(ImageNe

老孙 | Ethan Sun 的博客:AI 智能体与 AI 原生软件的工程实践 974

全网热评的李飞飞世界生成模型,真的能构建物理世界吗?

还记得《爱丽丝梦游仙境》开头那个神奇的兔子洞吗?现在你不需要追着白兔跳进去,只要点击一下鼠标就行。北京时间12月3日凌晨,李飞飞空间智能World Labs的首个项目推出第一个重磅成果:世界生成。世界生成是一个可以用单个图像生成 3D 物理世界的人工智能系统,World Labs的官方账号连发9条X(原Twitter),更新项目的最新进展:这一更新激发了AI界的热议。英伟达高级研究科学家、李飞飞高徒Jim Fan在X上表示,这是个可以和Sora媲美的跨时代的产品。

xx_nm98的博客 1961

李飞飞 World Labs 新 AI 产品:空间智能模型一张图片生成交互式 3D 世界

在人工智能领域,创新的步伐从未停止。近日,李飞飞的 World Labs 官宣了一款令人惊叹的新 AI 产品,它能够从一张图片生成交互式 3D 世界,为我们带来了全新的视觉体验和无限的创作可能。

xinzhaobuxuan的博客 2343

李飞飞的空间智能(世界模型):为什么你的大模型只是“能言善辩的瞎子“?

李飞飞提出"空间智能"作为超越当前大语言模型局限性的新方向。当前LLM仅能处理文本符号,缺乏对物理世界的真实理解,被称为"能言善辩的瞎子"。空间智能旨在构建"世界模型",使AI具备感知、理解和互动于三维物理世界的能力,实现从"数字世界"到"物理世界"的跨越。这需要开发具有生成性、多模态、交互性的模型,并通过从2D反推3D、利用合成数据、新型传感器等途径解决技术挑战,为AI装上理解物理规则的"大脑"。

m0_65555479的博客 883

李飞飞:AI的下一站——空间智能与世界模型的宏伟宣言

在人工智能领域,语言模型的惊人进展常常让人们误以为文本数据是通往通用人工智能(AGI)的唯一途径。然而,计算机视觉先驱、World Labs创始人李飞飞博士(Fei-Fei Li)的最新研究和深刻思考,正在将聚光灯重新投向被长期忽视但至关重要的领域:空间智能(Spatial Intelligence)。本次访谈深入探讨了如何超越大型语言模型(LLMs)的局限,让AI通过直接感知、视频和多模态交互来理解我们所处的物理世界。文章将基于李飞飞博士的论述,详细解析空间智能的重要性、世界模型的构建路径,以及我们距离真

老孙 | Ethan Sun 的博客:AI 智能体与 AI 原生软件的工程实践 972

李飞飞访谈:空间智能是AI的下一个前沿

摘要:李飞飞博士在Y Combinator访谈中分享了她对AI发展的深刻见解。从开创ImageNet数据集推动深度学习革命,到探索空间智能这一AI新前沿,她始终选择解决"近乎妄想"的根本性问题。访谈揭示了技术创新的规律:真正的突破需要长期坚持和对基础问题的重新思考(如数据驱动方法)。李飞飞特别强调空间智能的挑战性,指出其相比语言模型面临更高维度的复杂性。作为学者与创业者,她建议年轻研究者专注跨学科AI、理论创新等产业界不易涉足的领域。其经历展现了多元化视角对技术创新的价值,以及从学术到产

老孙 | Ethan Sun 的博客:AI 智能体与 AI 原生软件的工程实践 1339

AI教母李飞飞解析:世界模型与语言模型的本质区别

前言|人物介绍李飞飞,女,1976年出生于中国北京,美国国家工程院院士、美国国家医学院院士、美国艺术与科学院院士,美国斯坦福大学首位红杉讲席教授,以人为本人工智能研究院(HAI)院长,AI4ALL联合创始人及主席,Twitter公司董事会独立董事,加拿大风险投资机构Radical Ventures科学合伙人。李飞飞的工作包括括受认知启发的AI,机器学习,深度学习,计算机视觉和AI+医疗保健,尤其是用于医疗保健交付的环境智能系统。她还从事认知和计算神经科学方面的工作。

2401_84495872的博客 1958

超越语言:李飞飞如何为物理世界构建AI

【摘要】AI权威李飞飞与投资人Martin Casado在a16z播客中提出,当前大语言模型(LLMs)存在根本局限——缺乏对物理世界的3D理解。他们创立的WorldLabs致力于构建"世界模型",通过空间智能实现2D到3D的重建、物理模拟和多视角合成。这一技术将颠覆机器人、自动驾驶、创意产业等领域,甚至可能创造无限虚拟宇宙。团队整合了神经辐射场等前沿技术,但面临计算复杂度、数据获取等挑战。该创新标志着AI从语言理解向空间认知的关键转变,或将重塑人机交互范式。

老孙 | Ethan Sun 的博客:AI 智能体与 AI 原生软件的工程实践 1029

李飞飞首个「空间智能」模型发布:一张图,生成一个 3D 世界

来源:学术头条今日凌晨,由「AI 教母」李飞飞联合创办的 World Labs 发布了他们的第一个「空间智能」模型,只需一张图,就可以生成一个逼真的 3D 世界。据介绍,对于输入的图像,这一「空间智能」系统可以估算出 3D 几何图形,填充场景中未见的部分,创建新的内容,实现各个方位的 3D 世界构建。例如,当你输入图片:你会获得这样一个 3D 世界:与生成式 AI 工具生成的图片或视频等 2D 内...

人工智能学家 733

李飞飞:World Labs这样实现「空间智能」

在这次演讲中我想传达的是,在过去几十年,尤其是深度学习发生变革的十多年里,我们在视觉智能方面学会做的事情简直令人叹为观止。在一个 demo 中,我们取了一幅梵高的画作,并围绕它生成了整个场景,风格一致:艺术风格、光线,甚至是那个街区会有什么样的建筑。2012 年,一个名为 AlexNet 的神经网络引爆了 AI 研究界,它的表现远远超过所有其他类型的模型,并赢得了当年的 ImageNet 竞赛。同时,这也是我一直倡导公共部门获得计算资源访问权的部分原因,我自己的经历强调了在足够资源支持下进行创新的重要性。

2404_89473008的博客 1384

sid图像数据_遥感影像数据

影像数据基本概念影像数据是由卫星或飞机上的成像系统获得的影像,多为遥感影像数据。影像数据的每个像元都有一个值,表示传感器探测到像素对应地面面积上目标物的电磁辐射强度,也叫亮度值、灰度值。SuperMap支持的影像数据格式有:*.img、*.tif、*.tiff、*.bmp、*.jpg、*.png、*.gif、*.raw、*.sid等。计算机以二进制记录数据,所以其量化的等级以二进制来划分,即2n。...

weixin_39534395的博客 1626

李飞飞空间智能:世界模型,一文掌握核心要点!

如果当前如火如荼的大语言模型(LLM)只是一个“能言善辩的瞎子”,你还会认为AI真的理解世界吗?AI教母李飞飞一针见血地指出,LLM的知识缺乏“现实根基”。而她提出的下一个前沿——空间智能,目标正是为AI装上“眼睛”和“双手”,让它真正看懂、并走入我们的世界。 李飞飞倡导的“空间智能”,其技术内核是从基于符号的LLM范式,转向基于物理模拟的“世界模型”范式。这是AI想要从“数字世界”走进“物理世界”所必须跨越的技术鸿沟。让我们一起从“是什么”、“为什么”、“怎么做”三个维度,来彻底搞懂她提出的“空间智能”

2401_84204207的博客 904

MLC-LLM框架在安卓设备上的模型编译与部署全流程解析

本文详细解析了如何利用MLC-LLM框架在安卓设备上编译与部署大语言模型。从环境搭建、模型获取与量化编译,到最终的安卓应用打包与调试,提供了完整的实战流程。重点介绍了如何通过MLC-LLM将大型模型优化为适合移动端运行的格式,实现本地、低延迟、隐私安全的AI应用部署。

weixin_29251337的博客 475

【万字全文】李飞飞与Justin深度解读空间智能:数字世界需要三维表征,才能与现实世界融合,解锁无尽场景

李飞飞是一位著名的华裔美籍计算机科学家和人工智能(AI)专家。她于 1975 年出生于中国北京,幼年移居美国,在新泽西州长大。1999 年,她在普林斯顿大学获得了物理学学士学位,并于 2005 年在加州理工学院 (Caltech) 获得了电气工程博士学位。李飞飞的学术生涯以其对人工智能领域的重大贡献为标志。她尤其以在深度学习和计算机视觉方面的工作而闻名。她的研究重点是开发使机器能够解释和理解视觉数据的算法,这对自动驾驶汽车、医学成像和监控系统等应用具有深远的影响。

具身机器人和通用AI 1558

速腾RS-LiDAR-16激光雷达ROS环境搭建与点云可视化实战指南

本文提供速腾RS-LiDAR-16激光雷达在ROS环境下的完整搭建与可视化实战指南。从硬件连接、网络配置、驱动安装编译,到核心参数详解与Rviz点云可视化,手把手解决IP设置、坐标系对齐等常见问题,帮助开发者快速实现激光雷达三维点云数据的采集与显示。

weixin_29271263的博客 367

告别商业软件?实测用gnina(CNN打分版)做分子对接:从安装到跑通第一个案例

本文详细介绍了基于卷积神经网络(CNN)的开源分子对接工具gnina的安装与实战应用。从环境配置、编译安装到运行第一个COVID-19主蛋白酶抑制剂对接案例,全面解析了这款替代商业软件的强大功能,特别适合预算有限的研究团队进行药物发现和虚拟筛选。

weixin_42522320的博客 255

李飞飞终于把空间智能讲明白了:AI 的极限不是语言,世界远比文字更广阔!

但要做到这一点,需要机器人具备能够感知、推理、规划和行动的空间智能,同时——这是最重要的——与人类的目标和行为保持共情的一致。本次大会共设立现代 C++ 最佳实践、架构与设计演化、软件质量建设、安全与可靠、研发效能、大模型驱动的软件开发、AI 算力与优化、异构计算、高性能与低时延、并发与并行、系统级软件、嵌入式系统十二大主题,共同构建了一个全面而立体的知识体系,确保每一位参会者——无论是语言爱好者、系统架构师、性能优化工程师,还是技术管理者——都能在这里找到自己的坐标,收获深刻的洞见与启发。

优快云资讯 4750

ESP32-CAM入门教程

ArduinoESP32-CAM下载模块(接上USB就能用,很方便,如果没有买就只有资金用USB-TTL了)如下图两个合在一起如下图。

qq_48778364的博客 3万+

AI教母李飞飞长文,从语言到世界:空间智能开启 AI 的下一个十年

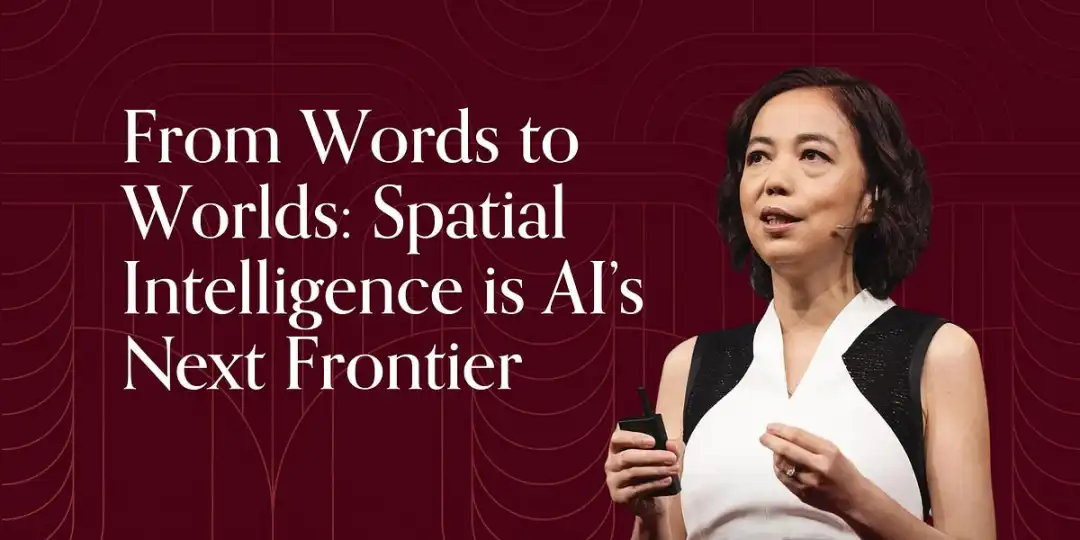
“AI教母”李飞飞发表了一篇信息量非常高密的长文, 名为“From Words to Worlds:Spatial Intelligence is AI’s Next Frontier”。 AI的下一个前沿,是「空间智能」。

墨城的博客 1189

【TouchDesigner】三维渲染

Cmera COMP Uniform Scale(按比例缩放):沿x,y,z三个轴等比例缩放相机(通常不建议改变相机大小)。 Constrain To(约束到):让相机附属到某个指定元件上,跟随指定元件运动。 Look At(朝向):让相机在移动过程中始终面对指定的元件。 Pah SOP(相机的路径):输入SOP元件名字,为相机指定移动路径。 Geometry Comp Geometry COMP中的参数与Camera COMP中的参数用法大部分都相似。特殊的是它的instacne页面的

wangpuqing1997的博客 5459

【YOLO26科研级突破】集成BiFPN双向特征金字塔,让多尺度特征融合效率与精度双跃升

打开确保模型解析器能识别BiFPN模块。通过将BiFPN双向特征金字塔集成到YOLO26中,我们实现了一个“全尺度双向特征流动+加权融合+精准检测”的目标检测模型。这个改进不仅在工程上能大幅提升多尺度、复杂场景下的检测精度,更在科研上提供了“双向特征融合”的创新思路——这种思路可以延伸到其他检测网络(如Faster R-CNN、SSD)的Neck模块改进中,帮你在论文中打造独特的研究点。

LXY_LOVE36的博客 199

“AI 教母”李飞飞最新对话:当空间智能技术成熟时,机器人革命即将开始

李飞飞:“对开源风险最好的防御措施,就是领先于那些会利用这些工具造成危害的人。”文 |王启隆出品 | AI 科技大本营(ID:rgznai100)本文为 优快云 编辑整理,未经授权禁止转载,违者必究。近期,人称“AI 教母”的李飞飞有一段发言在社交媒体上爆火,她表示:“人类智能可以简要归纳为两大智能,「语言智能」和「空间智能」。虽然语言智能备受关注,但空间智能将对 AI 产生巨大影响。”在底下...

AI科技大本营 1万+

2.4 提示词优化

我们在使用大模型的时候,同一任务使用不同表述的提示词,可能得到差异巨大的结果,因为模型的性能高度依赖输入提示词的质量。我们可以通过提示词优化来更高效地获取理想输出。

从0到1,突破自己 1008

AI教母李飞飞:下一站不是更大语言模型,而是能“看懂”世界的空间智能

为什么李飞飞坚持认为 AI 的极限不在语言?本文系统拆解“空间智能”的核心逻辑、技术挑战与落地路径,揭示大模型之后 AI 真正需要补上的关键一课——理解物理世界。从 ImageNet 到世界模型,这不仅是学术转向,更是企业级 AI 落地的下一战场。

打造全国最全的AI Agent开发知识领域的博客 1869

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

李飞飞空间智能来了:AI生成可探索交互的3D世界,颠覆游戏电影VR行业

12月3日,有AI“教母”之称的李飞飞发布了空间智能的一个项目,一经发布就立刻引爆了外网。这个项目是仅仅通过一张图片,AI就可以快速的构建一个3D世界,而且这个世界是可以探索和交互的

公众号:BennuCTech 1693

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

AI教母李飞飞团队发布最新空间智能模型!一张图生成无限3D世界,元宇宙越来越近了

一张图就能生成3D世界,我们离元宇宙还有多远?

SJJS_1的博客 1028

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

上一篇: 监督微调SFT vs 强化学习训练RLHF
下一篇: 重磅喜报|咕泡科技荣膺央广网2025年度“人工智能教育影响力品牌”奖项!
大模型星球
博客等级 码龄5年 1132粉丝 239原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值