当多模态开始卷落地:MiniCPM-o-4.5仅9B覆盖实时图像理解与文本生成;vLLM Omni 同时支持文本与多模态模型的高吞吐部署与服务化

MiniCPM-o 4.5端侧多模态实战:实时语音视觉交互部署指南 多模态AI正在从云端走向端侧,边缘设备上的实时交互能力成为AI落地关键。传统串行识别链路延迟叠加、信息丢失,难以满足自然对话需求。通过统一语义空间融合视觉与音频输入,配合模型量化压缩和流式处理,端侧模型可在有限算力下实现接近真人的交互体验。这种低延迟、离线可用、保护隐私的部署方式,为智能眼镜、教育硬件、车载助手等场景开辟了新可能。MiniCPM-o 4.5正是该路径的典型实践,从架构原理到部署细节,完整展示了如何构建端侧实时语音视觉交互系统,帮助开发者快速上手多模态应用开发。 阅读详情

在多模态大模型从「能用」迈向「好用」的关键节点,参数规模、推理成本和部署门槛,正变得与模型能力同等重要。OpenBMB 最新推出的 MiniCPM-o-4.5,仅用 9B 参数便构建起 Omni 全模态能力,在轻量化与高性能之间找到了更优解。

MiniCPM-o-4.5 采用统一架构实现文本与图像等多模态输入的联合建模与生成输出,强调跨模态对齐能力与推理效率的协同优化。9B 级别的模型规模,使其在主流消费级 GPU 上即可完成推理部署,相比大规模闭源模型,在显存占用与响应延迟上更具工程友好性。

目前,HyperAI超神经官网已上线了「MiniCPM-o-4_5:面壁智能开源的全双工全模态模型」,快来试试吧~

在线使用:https://go.hyper.ai/iOGzO

2 月 24 日-2 月 27 日,hyper.ai 官网更新速览:

* 优质公共数据集:3 个

* 优质教程精选:14 个

* 热门百科词条:5 条

访问官网:hyper.ai

公共数据集精选

1. THINGS-EEG 脑电图数据集

THINGS-EEG 是由美国国立卫生研究院(NIH)国家心理健康研究所、德国马克斯·普朗克学会人类认知与脑科学研究所联合吉森大学医学院等机构发布的一个面向物体认知研究的脑电图数据集,记录了 50 名受试者在观看物体图像时的脑电活动(EEG),用于分析物体加工的时间动态与认知表征。

直接使用:https://go.hyper.ai/kqejl

2. THINGS-MEG 脑磁图数据集

THINGS-MEG 是由美国国立卫生研究院国家心理健康研究所、德国马克斯·普朗克学会人类认知与脑科学研究所联合吉森大学医学院等机构发布的一个面向物体认知研究的脑磁图数据集,记录了受试者观看物体图像时的毫秒级脑电磁活动,用于分析物体加工过程的时间动态。

直接使用:https://go.hyper.ai/eBKWI

3. THINGS-fMRI 功能磁共振成像数据集

THINGS-fMRI 是由美国国立卫生研究院国家心理健康研究所、德国马克斯·普朗克学会人类认知与脑科学研究所联合吉森大学医学院等机构发布的一个面向物体认知研究的高密度功能性磁共振成像数据集,旨在系统刻画人脑对现实世界物体的视觉与语义表征。

直接使用:https://go.hyper.ai/CRbiA

公共教程精选

本周汇总了 3 类优质公共教程:

 * OCR 教程: 4 个

 * 多模态教程: 6 个

 * 大语言模型教程: 4 个

OCR 教程

1.GLM-OCR 轻量级多模态 OCR 识别系统

GLM-OCR 是由智谱 AI 于 2026 年 2 月开源的 0.9B 轻量级多模态 OCR模型,专注于复杂文档场景下的高精度文本识别与结构化解析。该模型以「小尺寸、高精度、易部署」为核心优势,基于 GLM-V 编码器 - 解码器多模态架构,融合自研 CogViT 视觉编码器与 RLHF优化,在 OmniDocBench V1.5 评测榜单中以 94.62 分登顶 SOTA,性能接近 Gemini-3-Pro,适用于办公文档解析、教育科研公式识别、政务金融票据核验、代码片段提取等多类场景。

在线运行:https://go.hyper.ai/kgb3n

图片

2.PaddleOCR-VL-1.5:基于 vLLM 的本地 OCR

PaddleOCR-VL-1.5 是 PaddlePaddle 团队发布的 PaddleOCR 系列的多模态 OCR 模型之一,面向复杂文档场景(票据、合同、论文、扫描件等)提供更强的文字识别与版面理解能力。本教程使用 vLLM 的 OpenAI 兼容接口对接该模型,实现上传图片--返回识别结果的完整链路。凭借其 0.9B 的参数量,在 OmniDocBench v1.5 上达到了 94.5% 的新一代精度。

在线运行:https://go.hyper.ai/cea6x

图片

Demo 页面

3.LightOnOCR-2-1B 轻量级高性能端到端 OCR 模型

LightOnOCR-2-1B 是由 LightOn AI 推出的最新一代端到端视觉语言模型。作为 LightOnOCR 系列中的旗舰级版本,它在一个紧凑的架构中统一了文档理解与文本生成功能,拥有 10 亿参数,能够在消费级显卡上运行。该模型采用 Vision-Language Transformer 架构,并引入了 RLVR训练技术,实现了极高的识别准确率与推理速度,专为需要处理复杂文档、手写体及 LaTeX 公式的应用场景设计。

在线运行:https://go.hyper.ai/cLSj5

图片

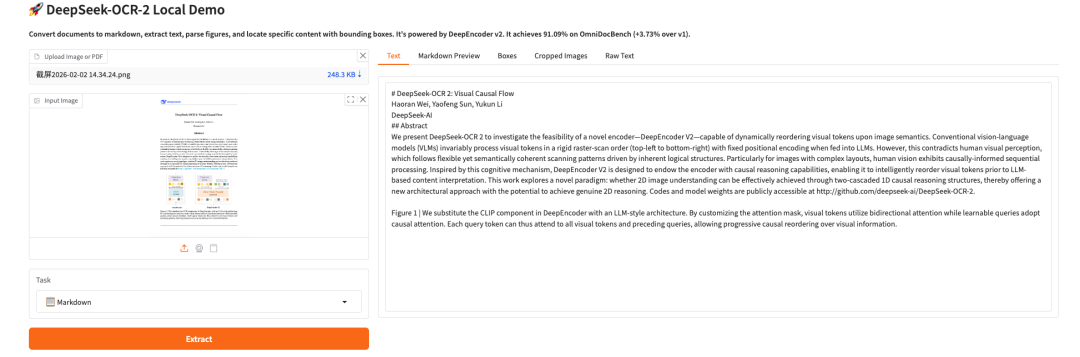
4.DeepSeek-OCR 2视觉因果流

DeepSeek-OCR 2 是由 DeepSeek 团队推出的第二代 OCR 模型,通过引入 DeepEncoder V2 架构,实现从固定扫描到语义推理的范式转变。模型采用因果流查询和双流注意力机制,能动态重排视觉 Token,更精准地还原复杂文档的自然阅读逻辑。在 OmniDocBench v1.5 评测中,模型综合得分达到 91.09%,较前代提升显著,同时显著降低了 OCR 识别结果的重复率,为未来构建全模态编码器提供新路径。

在线运行:https://go.hyper.ai/iOGzO
图片

Demo 页面

多模态教程

1.MiniCPM-o-4.5:面壁智能开源的全双工全模态模型

MiniCPM-o-4.5 是由 Facewall Intelligence 和清华大学自然语言处理实验室于 2026 年 2 月开源的 9B 参数全模态旗舰模型。采用 siglip2、whisper、cosyvoice2、qwen3-8b 的端到端架构。作为业界首个支持「实时自由对话」的模式,它实现了全双工交互--允许用户同时看、听、说,摆脱了传统的回合制「对讲机」模式。该模型具有领先的视觉理解能力、超仿人语音生成能力和语音克隆能力,支持主动交互和实时流媒体处理,并可在边缘设备上运行。它兼容各种国产芯片,如 ascend 和 Hygon,并可通过 llama.cpp 和 vLLM 等框架高效部署。

在线运行:https://go.hyper.ai/iOGzO

2.使用 vLLM-Omni 部署 Qwen-Image-Edit

Qwen-Image-Edit 是阿里巴巴的团队发布的一款功能多样的图像编辑模型。该模型具备语义与外观编辑的双重能力,既能进行低层次的视觉外观编辑(如添加、删除或修改元素),又能进行高层次的视觉语义编辑(如创建 IP、对象旋转、风格转换等)。模型支持对中文和英文双语文本的精准编辑,能够在保留原字体、大小和风格的同时,对图像中的文本进行修改。

在线运行:https://go.hyper.ai/4w6XA

3.Step3-VL-10B:多模态视觉理解与图文对话

Step3-VL-10B 是 StepFun 团队发布的开源视觉语言基础模型,专为多模态理解与复杂推理任务而设计。该模型旨在重新界定效率、推理能力和视觉理解质量之间的平衡,适用于受限参数规模内的多模态模型。尽管其参数规模较小,但该模型在视觉感知、复杂推理和人类指令对齐方面表现出卓越性能。它在多个基准测试中始终优于同等规模的模型,在某些任务上可与参数规模大 10 到 20 倍的模型相媲美。

在线运行:https://go.hyper.ai/RqTTW

图片

Demo 页面

4.使用 vLLM-Omni 部署 Qwen-Image-2512

Qwen-Image-2512 是 Qwen-Image 系列中的一款基础性文本转图像模型,主要面向高质量图像生成以及复杂多模态内容表达场景。重点在于提升生成图像的整体真实感和可用性。肖像生成效果显著提升了自然度,面部结构、皮肤纹理以及光影关系更加接近于真实的摄影效果。在自然场景中,模型能够生成更精细的地貌纹理、植被细节以及诸如动物毛发之类的高频信息。其文本生成与排版能力也得到了提升,从而能够更稳定地呈现可读文本和复杂的字体样式。

在线运行:https://go.hyper.ai/JMmhs

5.TurboDiffusion:图像与文本驱动视频生成系统

TurboDiffusion 是由清华大学团队于 2025 年 12 月开发的一种高效视频扩散生成系统。该系统基于用于高阶蒸馏的 Wan2.1 架构,旨在解决大规模视频模型中推理速度缓慢及计算资源消耗量高等痛点问题,从而实现以最少步骤生成高质量视频的目标。

在线运行:https://go.hyper.ai/VvyVZ

6.Personaplex-7B-v1:实时对话与角色定制语音接口

PersonaPlex-7B-v1 是英伟达发布的 70 亿参数多模态个性化对话模型。它专为实时语音/文本交互、长程人设一致性模拟及多模态感知任务而设计,旨在提供一个具有毫秒级响应速度的沉浸式角色扮演与多模态交互演示系统。

在线运行:https://go.hyper.ai/ndoj0

图片

Demo 页面

大语言模型教程

1.llama.cpp+Open WebUI 部署 Qwen3-VL-8B-Instruct-GGUF

Qwen3-VL-8B-Instruct-GGUF 提供多种精确的语言模型变体和专用的 MMPROJ 视觉编码器。这些型号兼容 llama.cpp 和 Ollama 等工具,非常适合多种硬件,包括 CPU、NVIDIA GPU、苹果硅片和英特尔 GPU。Qwen3-VL-8B-Instruct-GGUF 在 GGUF 格式中明确区分语言和视觉部分。这使得开发者能够灵活选择特定硬件的量化级别,即使在资源有限的CPU环境中也能实现可接受的响应时间,同时在配备 GPU 的系统上释放更多性能。

在线运行:https://go.hyper.ai/EKryC

2.Jacobi Forcing:快速且精确的因果并行解码技术

Jacobi Forcing 是一种由 Hao AI 实验室引入的新型训练技术,它能够将大型语言模型(LLMs)转换为原生因果并行解码器。通过训练模型使其沿着自身的雅可比解码轨迹处理有噪声的未来块,该技术能够解决 AR 到扩散模型的匹配问题,同时保持因果自回归主干结构的完整性。

在线运行:https://go.hyper.ai/fIad4

3.vLLM+Open WebUI 部署 GLM-4.7-Flash

GLM-4.7-Flash 是一款轻量化多模态推理模型,它兼顾了高性能与高吞吐量,原生支持链式思维(CoT)、工具调用和代理功能。GLM-4.7-Flash 采用了专家混合(MoE)架构,利用稀疏激活机制显著降低每次推理的计算成本,同时保持大型模型的表达能力。

在线运行:https://go.hyper.ai/a2IN3

4.vLLM+Open WebUI 部署 LFM2.5-1.2B-Thinking

LFM2.5-1.2B-Thinking 是边缘优化混合型架构模型。作为 LFM2.5 系列中专门针对逻辑推理优化的版本,它在一个紧凑的架构中统一了长序列处理和高效推理功能。该模型拥有 12 亿个参数,能够流畅运行于消费级显卡乃至边缘设备上。该模型采用创新的混合架构(线性动态系统+注意力),实现了极高的内存效率和吞吐量,专为需要实时进行设备上推理而不牺牲智能的场景而设计。

在线运行:https://go.hyper.ai/1XTsV

社区文章解读

1. 20秒完成15天预报,欧洲科研团队提出高分辨率区域海洋预报模型SeaCast**\

不规则的海陆分布、复杂的侧边界条件,以及对垂直分层变量精细刻画的需求,使得现有全球尺度海洋 AI 模型难以直接适配区域任务。针对于此,芬兰赫尔辛基大学、地中海气候变化研究中心与意大利萨伦托大学组成的联合研究团队,研发了专为区域海洋预报设计的图神经网络模型 SeaCast。其在单块 GPU 上仅需 20 秒,即可完成 1/24° 网格下 18 个垂向层次的 15 天预报。

查看完整报道:https://go.hyper.ai/kRXnE

2. 预测成功率超80%!康奈尔大学提出创新AI框架,解码高导电性锂离子电解质的化学机制

盐–溶剂化学支撑着大多数锂离子电池体系中的电解质行为,但其理性设计受到巨大化学空间的限制,该空间涵盖了无数种组合以及非线性的结构–性能耦合关系,而稀疏且分布不均衡的实验数据进一步加剧了这一问题,阻碍了模型的泛化能力。自康奈尔大学的研究团队开发了一种稳健、可解释且数据高效的框架 SCAN,用于盐–溶剂化学的建模与解释。该框架能够有效处理长尾数据,并捕捉盐–溶剂配方的完整谱系。

查看完整报道:https://go.hyper.ai/OrHIt

3. 验证周期缩短40倍,密歇根大学等提出电池寿命预测新方法,「发现学习」节省98%评估时间

准确高效的电池循环寿命预测,是下一代电池研发与规模化应用的关键,直接决定其可靠性、安全性与全生命周期使用成本。近日,来自密歇根大学等研究机构的专家创新性地提出了「发现学习(Discovery Learning,DL)」的科学机器学习方法,将主动学习、物理约束学习和零样本学习有机融合,构建出一个类人推理闭环学习框架。在保守假设条件下,与工业级电池寿命验证流程相比,发现学习可实现 98% 的评估时间节省和 95% 的能耗节省,将验证周期从约 1,333 天缩短至 33 天。

查看完整报道:https://go.hyper.ai/28W2g

4. 论文汇总丨超100篇AI for Science重要成果,一文速览2025年技术创新

过去一年,AI 与科学研究的关系正在发生一场深刻而安静的转变。2025 年,AI for Science 不再只是零散的技术应用,而是演化为一条清晰、系统、可复用的科研创新路径,AI 不再只是工具,而是正在成为科研范式的一部分。HyperAI 超神经整理了医疗健康、材料化学、气象研究、天文学等多个方向的论文方便不同背景的读者快速检索与回顾。

查看完整报道:https://go.hyper.ai/FLJGD

热门百科词条精选

1. 倒数排序融合 RRF

2. Kolmogorov-Arnold 表示定理

3. 大规模多任务语言理解 MMLU

4. 黑盒优化 BlackBox Optimizers

5. 类条件概率 Class-conditional Probability

这里汇编了数百条 AI 相关词条,让你在这里读懂「人工智能」:

https://go.hyper.ai/wiki

以上就是本周编辑精选的全部内容,如果你有想要收录 hyper.ai 官方网站的资源,也欢迎留言或投稿告诉我们哦!

下周再见!

MiniCPM-o 4.5:消费级显卡跑的实时跨模态感知模型 多模态模型指能同时处理图像、语音、文本等异构信息的AI系统,其核心原理在于跨模态对齐与联合表征学习。传统方案因模态割裂导致语义鸿沟与高延迟,而MiniCPM-o 4.5通过Omni-Flow架构实现三路信号统一token化与流式融合,在RTX 4090等消费级显卡上达成320ms端到端实时响应。该技术显著降低部署成本与维护复杂度,适用于工业质检、远程医疗、教育辅导等需‘能听能看能说’的边缘智能场景。本文聚焦其跨模态对齐机制与轻量化实时推理能力。 阅读详情

相关推荐

Spring Boot 构建war 部署到tomcat下无法在Nacos中注册服务

因此,当使用外部容器时,如此处的 Tomcat 来部署项目,AbstractAutoServiceRegistration 就不能监听到容器启动事件了,也就不会尝试向服务注册中心注册当前这个微服务,那么注册就失败了,并且也就没有异常信息了。自定义获取获取外部容器端口的方法, 然后监听应用启动事件,当应用被启动时,获取外部容器启动的端口号,然后将这个 port 设置到 NacosAutoServiceReigistration 中。在启动类同级目录,复制下面代码即可(不需要修改,直接构建war即可)

ttyy1112的专栏 2519

9B 参数实现全双工交互:MiniCPM-o4.5 开源解析与本地部署指南

9B 参数实现全双工交互:MiniCPM-o4.5 开源解析与本地部署指南2026 年 2 月,面壁智能开源的 MiniCPM-o4.5 引发 AI 领域广泛关注 —— 这款仅 9B 参数的全双工全模态大模型,不仅在多模态理解任务中击败 Gemini 2.5 Flash 等顶级闭源模型,更以 11GB 显存占用的轻量化特性,让普通开发者也能部署「边看边听边说」的类人交互系统。本文将从技术架构、核心能力实测、本地部署实践三个维度,带大家深入了解这款开源神器。一、全双工交互:打破传统模态的交互壁垒。

m0_52307083的博客 1602

望获实时Linux与国产芯片协同:打造LinuxCNC数控机床的全栈国产化方案

本文探讨了如何通过望获实时Linux与飞腾、龙芯等国产芯片的深度协同,为LinuxCNC数控机床打造全栈国产化方案。望获实时Linux通过中断隔离等核心技术,提供亚微秒级确定性响应,解决了传统Linux系统实时性不足的痛点,使LinuxCNC得以稳定驱动高精度机床。该方案实现了从硬件、操作系统到应用软件的全栈自主可控,为工业控制领域提供了高性能、可定制的国产化选择。

weixin_29291069的博客 648

重磅开源!MiniCPM-o 4.5 全双工智能实战:9B参数端侧部署,告别AI对讲机时代

面壁智能重磅开源新一代全模态旗舰模型MiniCPM-o 4.5,该模型以9B参数实现高性能与轻量化的平衡,核心突破原生全双工架构,彻底打破传统AI“对讲机式”回合制交互局限,支持视频、音频、文本多模态实时流输入输出,可实现端侧多设备离线部署,配套完整开源工具链与推理框架,大幅降低开发者二次开发与落地成本。

学海无涯,笃行致远 1965

GD32F303调试小记(一)之USART(接收中断、接收空闲中断+DMA、发送DMA)

前言 之前写了GD32F103调试小记(二)之USART(接收中断、接收空闲中断+DMA、发送DMA)一文。这次我们来看看GD32F303的USART是如何配置的,结合这两篇文章,相信大家GD32的USART配置流程会十分熟悉。 DMA 能大大减轻CPU负荷的东西,建议场景合适的情况下,都去用DMA功能。 USART 一种串行通信协议, ...

欢喜6666的博客 3万+

人脸关键点定义汇总

前几天看一份代码临时需要找49个人脸关键点位置定义的图片发现怎么百度都搜不到,最后幸好谷歌可以使用了就用谷歌搜到了。所以在这里汇总一下我所知道的人脸关键点的定义和相关的一点东西,以备不时之需。 68个关键点 最常用的工具是Dlib,网址:http://dlib.net/ dlib的68个特征点检测算法是ERT算法【1】 使用dlib检测68个特征点的python示例见:http://dlib.n...

程序媛 7642

MiniCPM-o 4.5 开源了,登上了开源热榜。

只有 9B 参数,却在视觉理解、文档解析、语音交互等方面,做到接近 Gemini 2.5 Flash 级别,同时又适合在本地设备上跑,比如手机、车机、机器人、平板等。对于想在国产硬件上落地 AI 应用的团队,MiniCPM-o 4.5 已经是一个拿来就能跑的成熟选项,而不是停留在 PPT 阶段。结果是:视频理解的性价比极高,在同样的算力预算下,它能看的内容比同类模型多得多,特别适合端侧设备上做长视频分析、实时摄像头理解。一边看视频、一边听声音时,能理解谁在说话、刚刚发生了什么,而不是分别对待音轨和画面。

公众号:逛逛GitHub 658

Altium Designer操作技巧(4)——如何利用嘉立创EDA来输出3D封装到AD封装库?

本文介绍了利用嘉立创EDA和FreeCAD软件为PCB元件添加3D模型的方法。首先在嘉立创EDA中搜索元件编号并导出3D模型,然后使用FreeCAD删除3D模型中的PCB基板部分,最后将处理后的3D模型导入PCB封装库并更新到PCB设计中。文章详细讲解了每个步骤的操作流程,包括模型导出、基板删除、位置调整等关键环节,并提供了解决常见问题的方法。通过这种方法,电子工程师可以快速获得元器件的3D模型,提高PCB设计的准确性。

u012526819的博客 2588

【VLM】MiniCPM-o 4.5:全双工实时交互

作者巧妙地将语音token生成委托给轻量级Llama语音token解码器(0.3B),利用主干网络的隐藏状态(经MLP reshape)来指导韵律和风格。音频采用Whisper Medium编码器(0.3B)以分块流方式处理,每秒生成50个特征token,再经MLP投影器5倍时间压缩为每秒10个音频token。语音解码器包括:自回归生成离散S3语音token的交错语音token解码器,以及将语音token转换为波形的流式流匹配解码器。所有组件在token级可微分连接,支持端到端梯度传播。

发现问题,并解决问题,批判性思维 677

【WRF-GHG 教程第一期】概述(Overview)

概述(Overview)

WW、forever的博客 511

Qwen-Image(阿里通义千问)技术浅析(一)

Qwen-Image(阿里通义千问多模态模型)是阿里巴巴推出的视觉-语言多模态大模型,能够理解图像内容并完成复杂的跨模态任务。

m0_75253143的博客 678

MiniCPM-o-2_6部署完全指南:llama.cpp CPU推理、int4量化与vLLM高效加速

MiniCPM-o 2.6 是 OpenBMB 推出的 8B 全模态大模型,一个模型同时搞定图像理解、实时语音对话和多模态直播流。本文带你走通三条最实用的部署路线:**llama.cpp CPU 推理**(无显卡的电脑、手机也能跑)、**int4 量化**(GPU 显存降到 7GB)、**vLLM 高效加速**(面向高并发服务),外加一键体验方式,帮你在 3 分钟内选对方案。 ## 一、30秒认

gitblog_00109的博客 325

Xilinx FPGA平台GTX简易使用教程(汇总篇)

Xilinx平台GTX简易使用教程,先“知其然”,慢慢再研究“所以然”。

数字IC/FPGA杂货铺,找一找,或许有你想要的~ 3万+

MiniCPM-o-4_5模型深入解析

MiniCPM-o 4.5 通过这三大创新,实质上是在9B 的小参数量级上,实现了GPT-4o 级别的交互体验。解决的是长文本与推理成本的问题。MiniCPM-o解决的是人机交互自然度与实时性的问题。对于开发者而言,这意味着你可以在消费级显卡(如 RTX 4090)甚至边缘设备上,部署一个能看懂脸色、能随时打断、能主动关怀的“贾维斯”,而不再是一个冷冰冰的问答机器。极速响应 (Zero-Latency Experience)

1193

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

保姆级指南:从零部署MiniCPM-o-4.5-nvidia-FlagOS,打造个人AI助手

本文介绍了如何在星图GPU平台上自动化部署MiniCPM-o-4.5-nvidia-FlagOS镜像,快速打造个人AI助手。该平台简化了部署流程,用户无需复杂配置即可启动服务。部署后,该多模态模型的核心应用场景是进行图文对话,例如上传图片并询问相关内容,实现智能识别与交互。

weixin_28933797的博客 112

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

实测MiniCPM-o-4.5:本地部署图文对话模型,效果惊艳媲美GPT-4o

本文介绍了如何在星图GPU平台上自动化部署MiniCPM-o-4.5-nvidia-FlagOS镜像,快速搭建本地多模态AI应用。该平台简化了部署流程,用户可轻松启动一个具备强大图文对话能力的模型,典型应用场景包括上传图片进行智能描述、内容分析和视觉问答,实现媲美顶级闭源模型的本地化AI体验。

weixin_34162851的博客 168

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

使用 OpenVINO™ 加速部署 MiniCPM-o-4.5 全模态模型

本文将详细介绍如何使用 Intel® OpenVINO™ 工具套件优化和部署 MiniCPM-o-4.5 模型,将其 15 个子模型全部转换为 OpenVINO™ IR 格式并进行 INT4/INT8 量化,在 Intel CPU/GPU 平台上实现高效推理。

OpenVINO的博客 474

MiniCPM-o 4.5 介绍

面壁智能开源的一款 9B 参数全模态、全双工旗舰模型,能够「边看、边听、边说」,在端侧设备上也能提供接近 GPT-4o 级别的交互体验。

SimpleLearning 693

5分钟搞定!MiniCPM-o-4.5智能助手本地部署保姆级教程

本文介绍了如何在星图GPU平台上自动化部署MiniCPM-o-4.5-nvidia-FlagOS镜像,快速搭建本地多模态AI助手。该平台提供预置环境,用户可一键启动,实现包括图片内容理解、语音对话在内的智能交互,适用于智能客服、学习辅导等场景。

weixin_32673065的博客 448

MiniCPM-O-4_5-GGUF 全解析

MiniCPM-O-4_5-GGUF 是面壁智能(OpenBMB)推出的MiniCPM-O-4.5 全模态大模型的轻量化量化版本,采用 GGUF 格式优化,专为端侧与低资源设备设计,是当前开源社区中性能最强、部署门槛最低的全模态小参数模型之一。MiniCPM-O-4.5 作为面壁智能 MiniCPM 系列的旗舰全模态模型,原生支持图像、视频、音频、文本四大模态输入,可实时输出文本与语音,具备全双工多模态流式交互能力(边看、边听、边说)。

ting9452000的专栏 1113

多模态模型:【MiniCPM-o 4.5】

1. 项目简介🚩笔记它来咯!

某人工智能小白的博客 569

MiniCPM-o-4.5入门:Python环境安装与第一个“Hello World”程序

本文介绍了如何在星图GPU平台上自动化部署MiniCPM-o-4.5-nvidia-FlagOS镜像,快速搭建AI大模型开发环境。通过该镜像,开发者可以便捷地安装Python环境并运行首个“Hello World”程序,实现与大模型的对话交互,为后续的AI应用开发奠定基础。

weixin_42323064的博客 333

从提示词到高质量输出:MiniCPM-o-4.5高级调优技巧案例集

本文介绍了如何通过优化提示词技巧,充分释放MiniCPM-o-4.5模型的潜力。借助星图GPU平台,用户可以自动化部署MiniCPM-o-4.5-nvidia-FlagOS镜像,快速搭建AI应用环境。通过具体案例展示了该模型在代码生成、内容创作等场景下的高质量输出能力,显著提升开发与创作效率。

weixin_31569663的博客 50

面壁智能发布 MiniCPM-o 4.5,端侧全双工实时音视频交互;海马爸比推出首款 AI 魔法打印机,语音生图+即时打印丨日报

我们欢迎更多的小伙伴参与。

声网的博客 754

从零到一:MiniCPM-o-4.5多模态AI助手部署与功能实测

本文介绍了如何在星图GPU平台上自动化部署MiniCPM-o-4.5-nvidia-FlagOS镜像,快速搭建多模态AI助手。该平台简化了部署流程,用户可轻松体验该模型的核心功能,例如上传图片并让其进行详细描述与问答,实现高效的图文内容分析与交互。

weixin_35829279的博客 323

手机端GPT-4o级视觉大模型:MiniCPM-V 4.5体验

**导语**:OpenBMB最新发布的MiniCPM-V 4.5以80亿参数实现了与GPT-4o相当的多模态能力,首次将高端视觉理解功能带入普通移动设备,标志着手机端AI视觉交互进入实用化阶段。 **行业现状**:多模态大模型(MLLM)正从云端向终端设备快速渗透,但受限于计算资源,移动端模型普遍面临性能与效率难以兼顾的困境。当前主流方案要么依赖云端计算导致延迟高,要么本地部署模型能力受限。据O

gitblog_00607的博客 505
上一篇: 20秒完成15天预报,欧洲科研团队提出高分辨率区域海洋预报模型SeaCast
下一篇: 【TVM教程】理解 TensorIR 抽象
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值