0.9B PaddleOCR-VL 登顶 SOTA!GPUStack 高效推理部署实战指南

Dyad:本地化开源AI应用构建器,零成本开发与数据隐私保障 AI应用开发正成为技术热点,其核心在于利用大型语言模型(LLM)的生成与推理能力,通过API调用或本地部署实现智能交互。其技术原理涉及提示工程、工具调用与上下文管理,旨在降低开发门槛、加速原型验证。这一技术对独立开发者和小型团队极具价值,能显著控制成本、保障数据隐私,并适用于构建智能客服、代码生成、文档分析等多种场景。本文聚焦于Dyad这一工具,它作为本地化、开源的AI应用构建器,完美融合了Next.js、TypeScript与多模型AI SDK,支持OpenAI、Anthropic及Ollama等模型,为 阅读详情

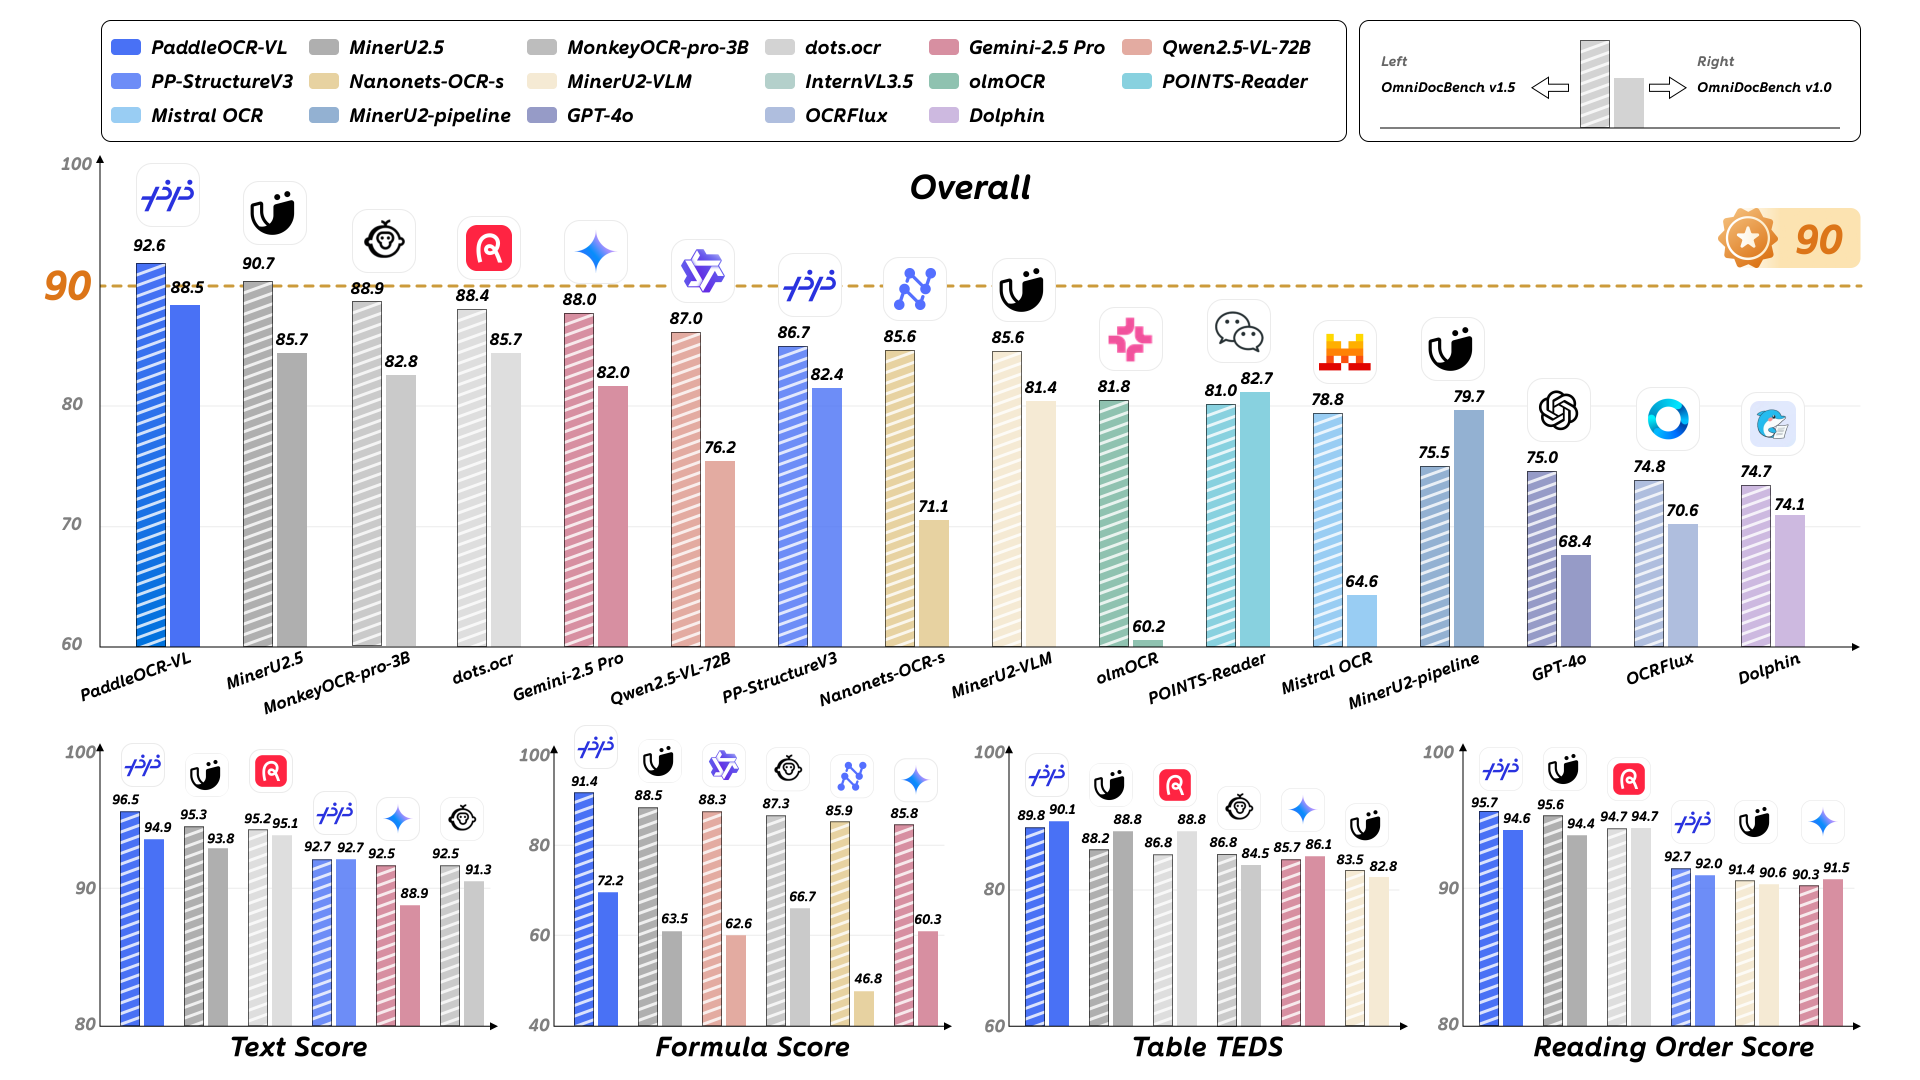
在全球多模态文档解析的激烈竞赛中,百度凭借 PaddleOCR-VL 模型给行业投下了一颗重磅炸弹。这个仅有 0.9B 参数量的轻量级多模态模型,不仅在 OmniDocBench V1.5 榜单上以 92.6 的综合得分登顶全球,更在文本识别、公式识别、表格理解和阅读顺序四大核心能力上全面斩获 SOTA,刷新了文档解析领域的性能天花板。

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。它不仅能精准解析多栏报纸、嵌套表格、数学公式,还能智能还原文档阅读顺序,在真实复杂场景下展现出了近乎人类级的理解能力。支持 109 种语言的它,堪称当前最灵活、最强大的文档解析模型之一。
img

如何在本地或集群环境中高效、稳定地部署这一 SOTA 模型?本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。

部署 GPUStack

首先,参考 GPUStack 官方文档完成安装(https://docs.gpustack.ai/latest/installation/nvidia-cuda/online-installation/)。推荐容器化部署方式,在 NVIDIA GPU 服务器上,根据文档要求完成对应版本的 NVIDIA 驱动、Docker 和 NVIDIA Container Toolkit 安装后,通过 Docker 启动 GPUStack 服务。

以下测试在 NVIDIA RTX4090 GPU 上进行:

检查 NVIDIA 驱动和 NVIDIA Container Toolkit 已正常安装配置:

nvidia-smi >/dev/null 2>&1 && echo "NVIDIA driver OK" || (echo "NVIDIA driver issue"; exit 1) && docker info 2>/dev/null | grep -q "Default Runtime: nvidia" && echo "NVIDIA Container Toolkit OK" || (echo "NVIDIA Container Toolkit not configured"; exit 1)
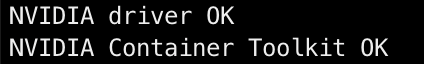
image-20251019170108469

部署 GPUStack:

docker run -d --name gpustack \
    --restart=unless-stopped \
    --gpus all \
    --network=host \
    --ipc=host \
    -v gpustack-data:/var/lib/gpustack \
    gpustack-registry.cn-hangzhou.cr.aliyuncs.com/gpustack/gpustack:v0.7.1-paddle-ocr \
    --disable-rpc-servers

查看容器日志,确认 GPUStack 已正常运行:

docker logs -f gpustack
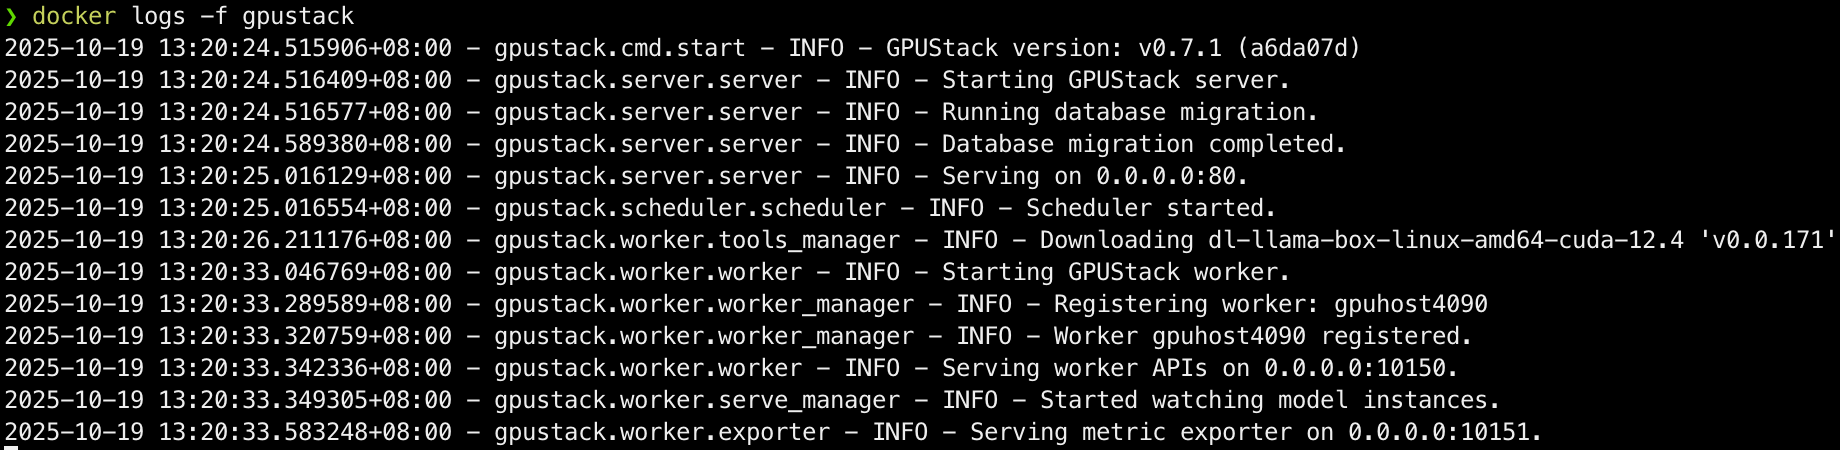
image-20251019132141596

若容器日志显示服务启动正常,使用以下命令获取 GPUStack 控制台的初始登录密码:

docker exec -it gpustack cat /var/lib/gpustack/initial_admin_password

GPUStack 会在部署模型时进行兼容性检查,PaddleOCR-VL 的模型架构目前尚未在 GPUStack 正式版本中支持,需要用自定义的 vLLM 版本绕过架构检查,执行以下命令在 /var/lib/gpustack/bin/ 目录下创建自定义 vLLM 版本的软链:

docker exec -it gpustack ln -sf /usr/local/bin/vllm /var/lib/gpustack/bin/vllm_paddle_ocr

在浏览器中通过服务器 IP 和 80 端口访问 GPUStack 控制台(http://YOUR_HOST_IP),使用默认用户名 admin 和上一步获取的初始密码登录。登录 GPUStack 后,在资源菜单可查看节点的 GPU 资源:
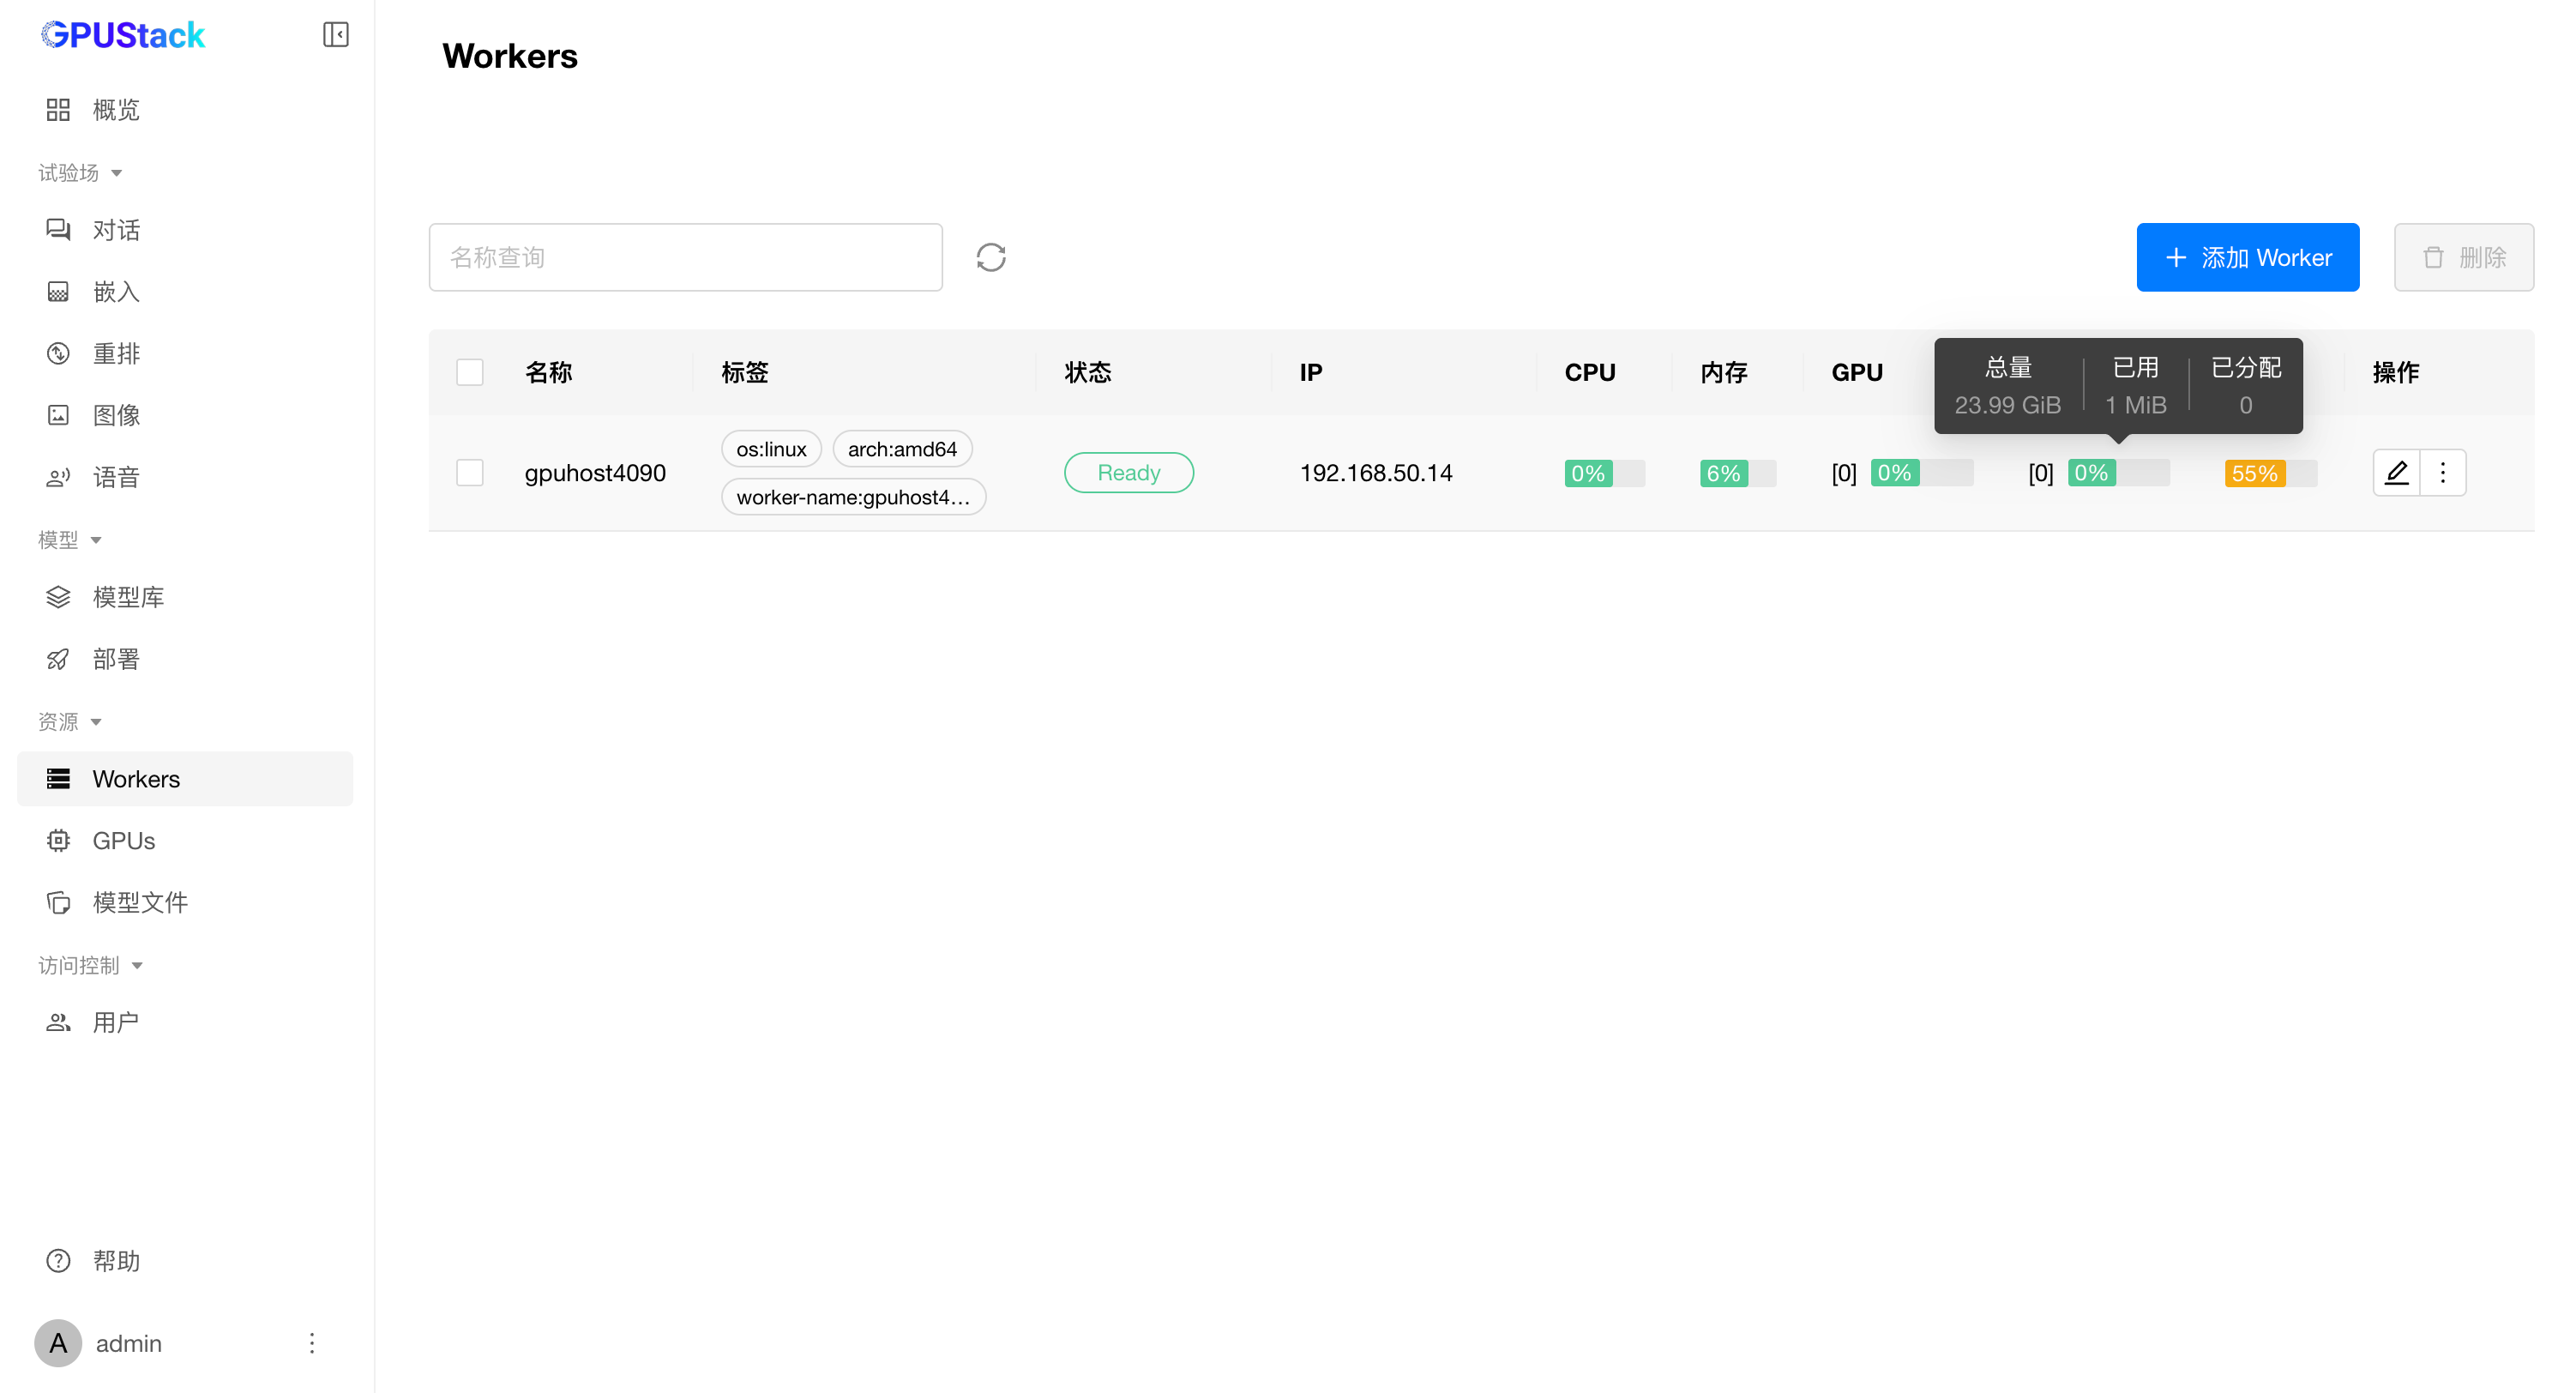
image-20251019132313052

下载 PaddleOCR-VL 模型

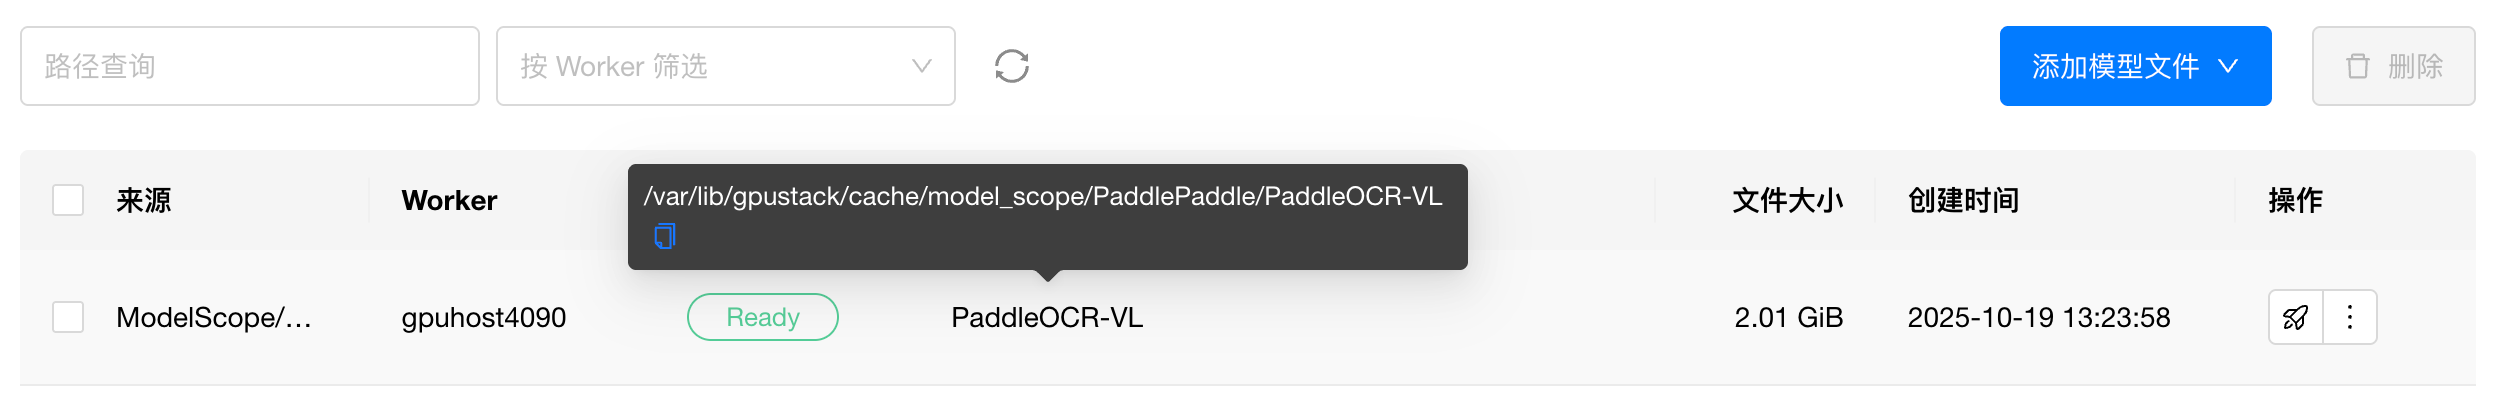
在 GPUStack UI,导航到 资源 - 模型文件,选择添加模型文件,可以选择从 Hugging Face 或 ModelScope 联网搜索并下载 PaddleOCR-VL 模型。国内网络建议从 ModelScope 下载:
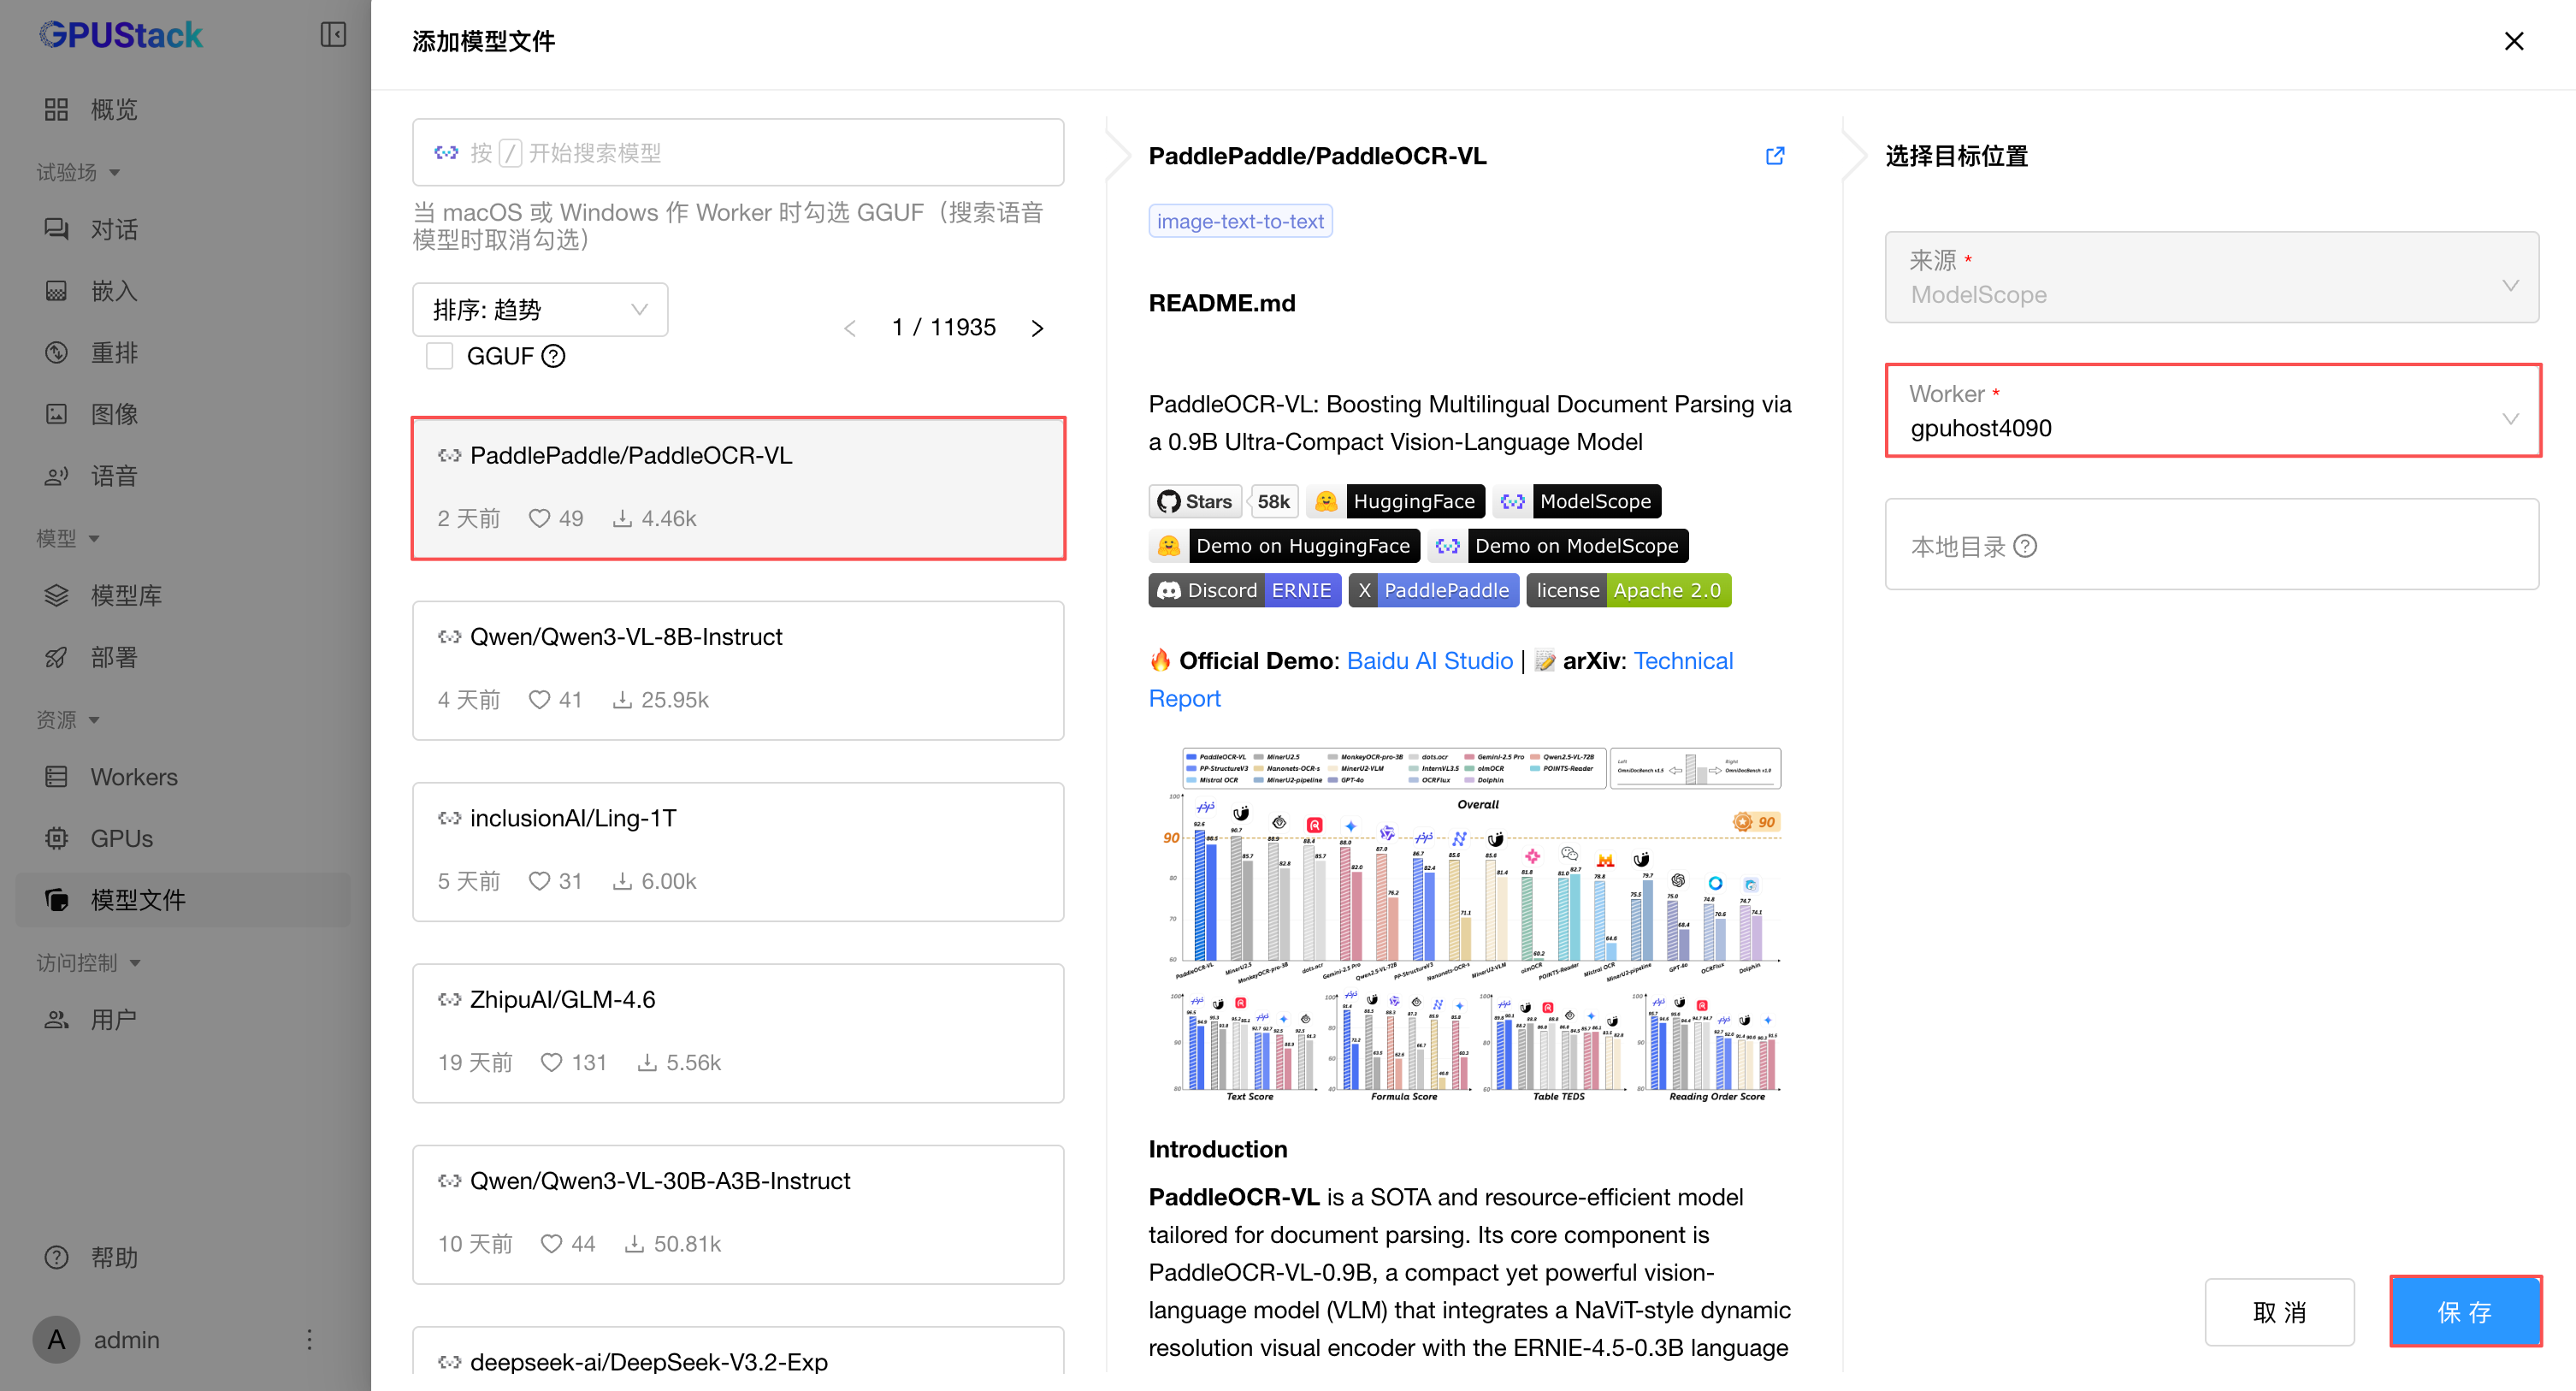
image-20251019132356378

等待模型下载完成:

image-20251019132632095

部署 PaddleOCR-VL 模型

确认模型下载完成后,点击模型文件右侧的部署按钮,部署模型。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。
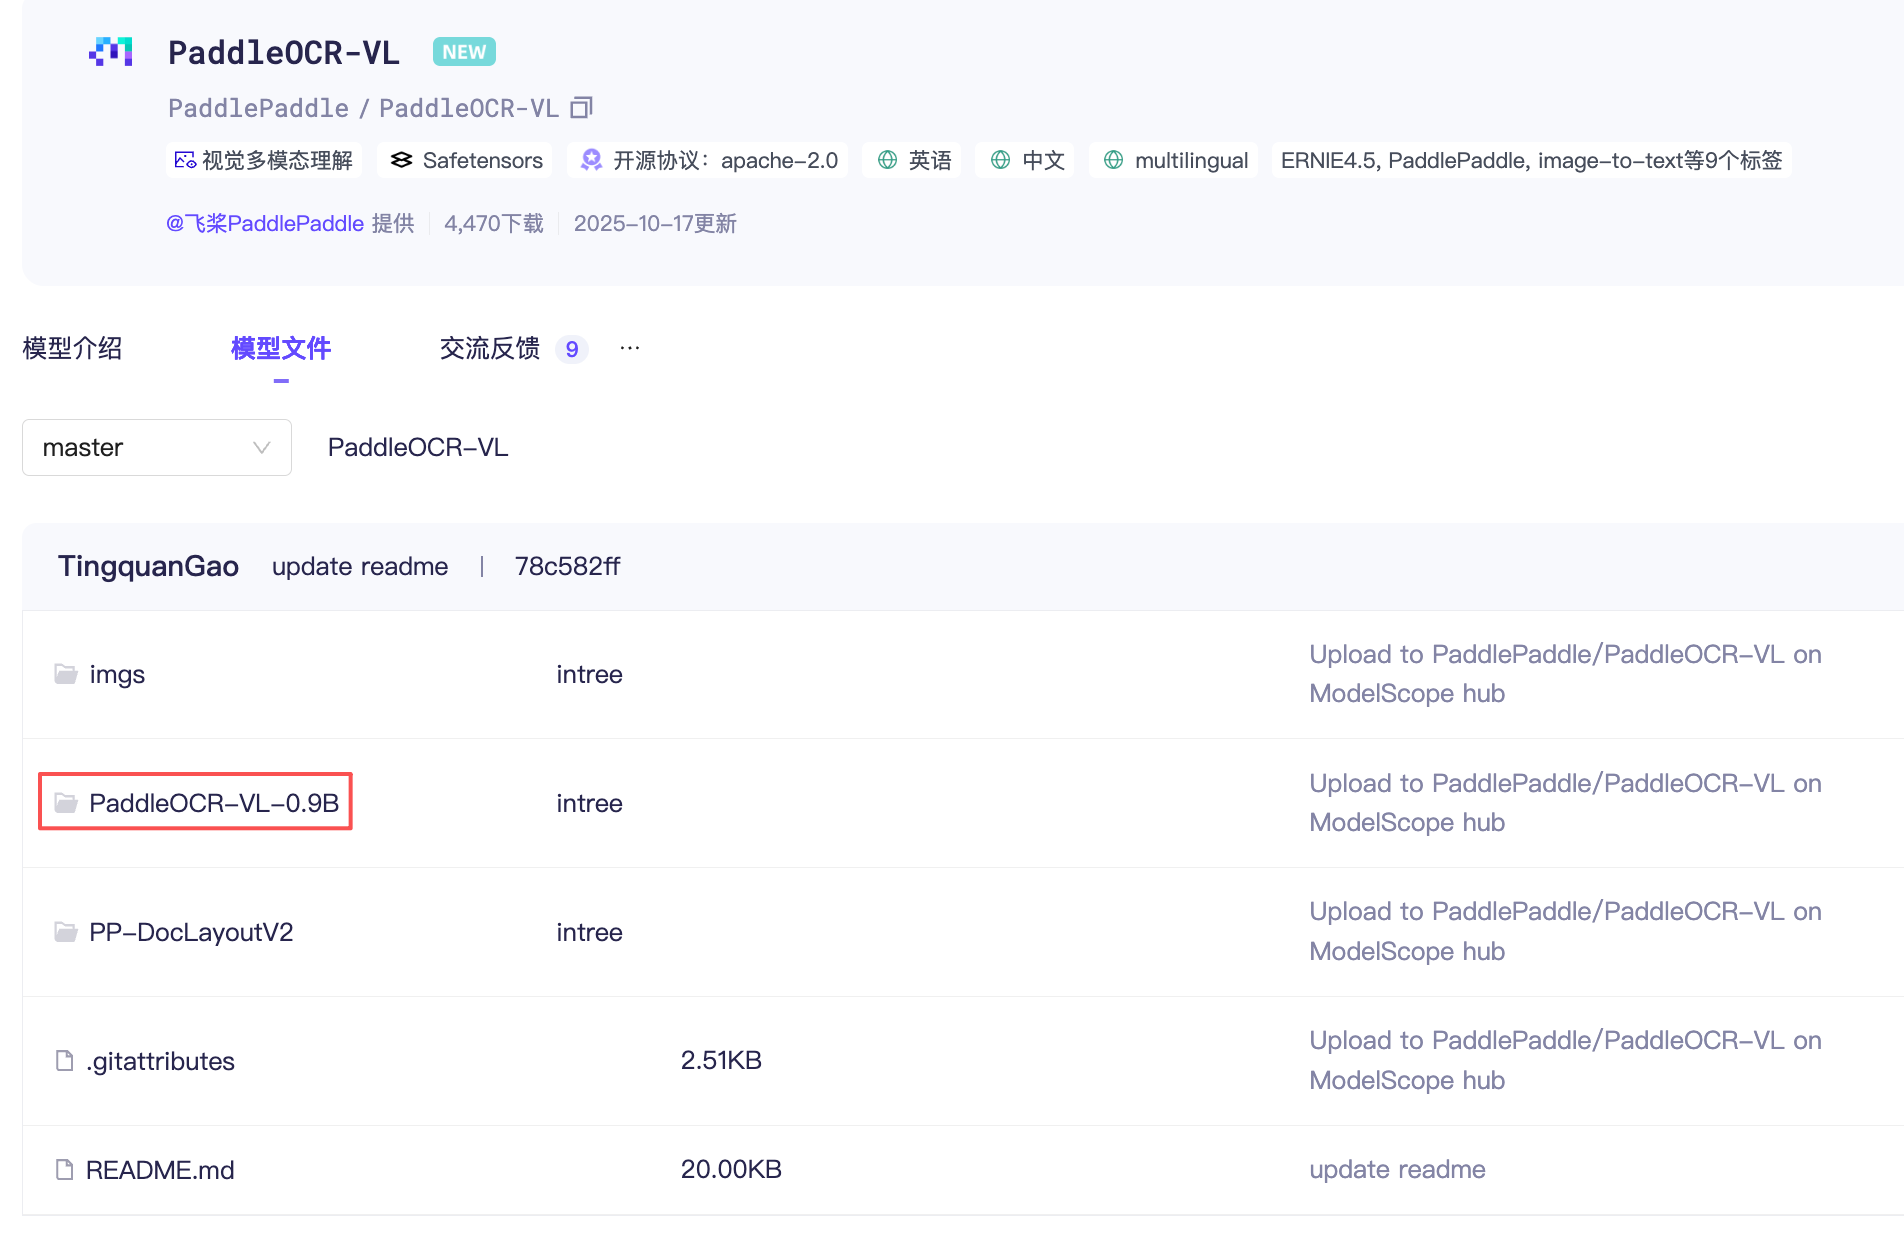
image-20251019132851514

在模型路径输入框,将子路径补充完整:

/var/lib/gpustack/cache/model_scope/PaddlePaddle/PaddleOCR-VL/PaddleOCR-VL-0.9B
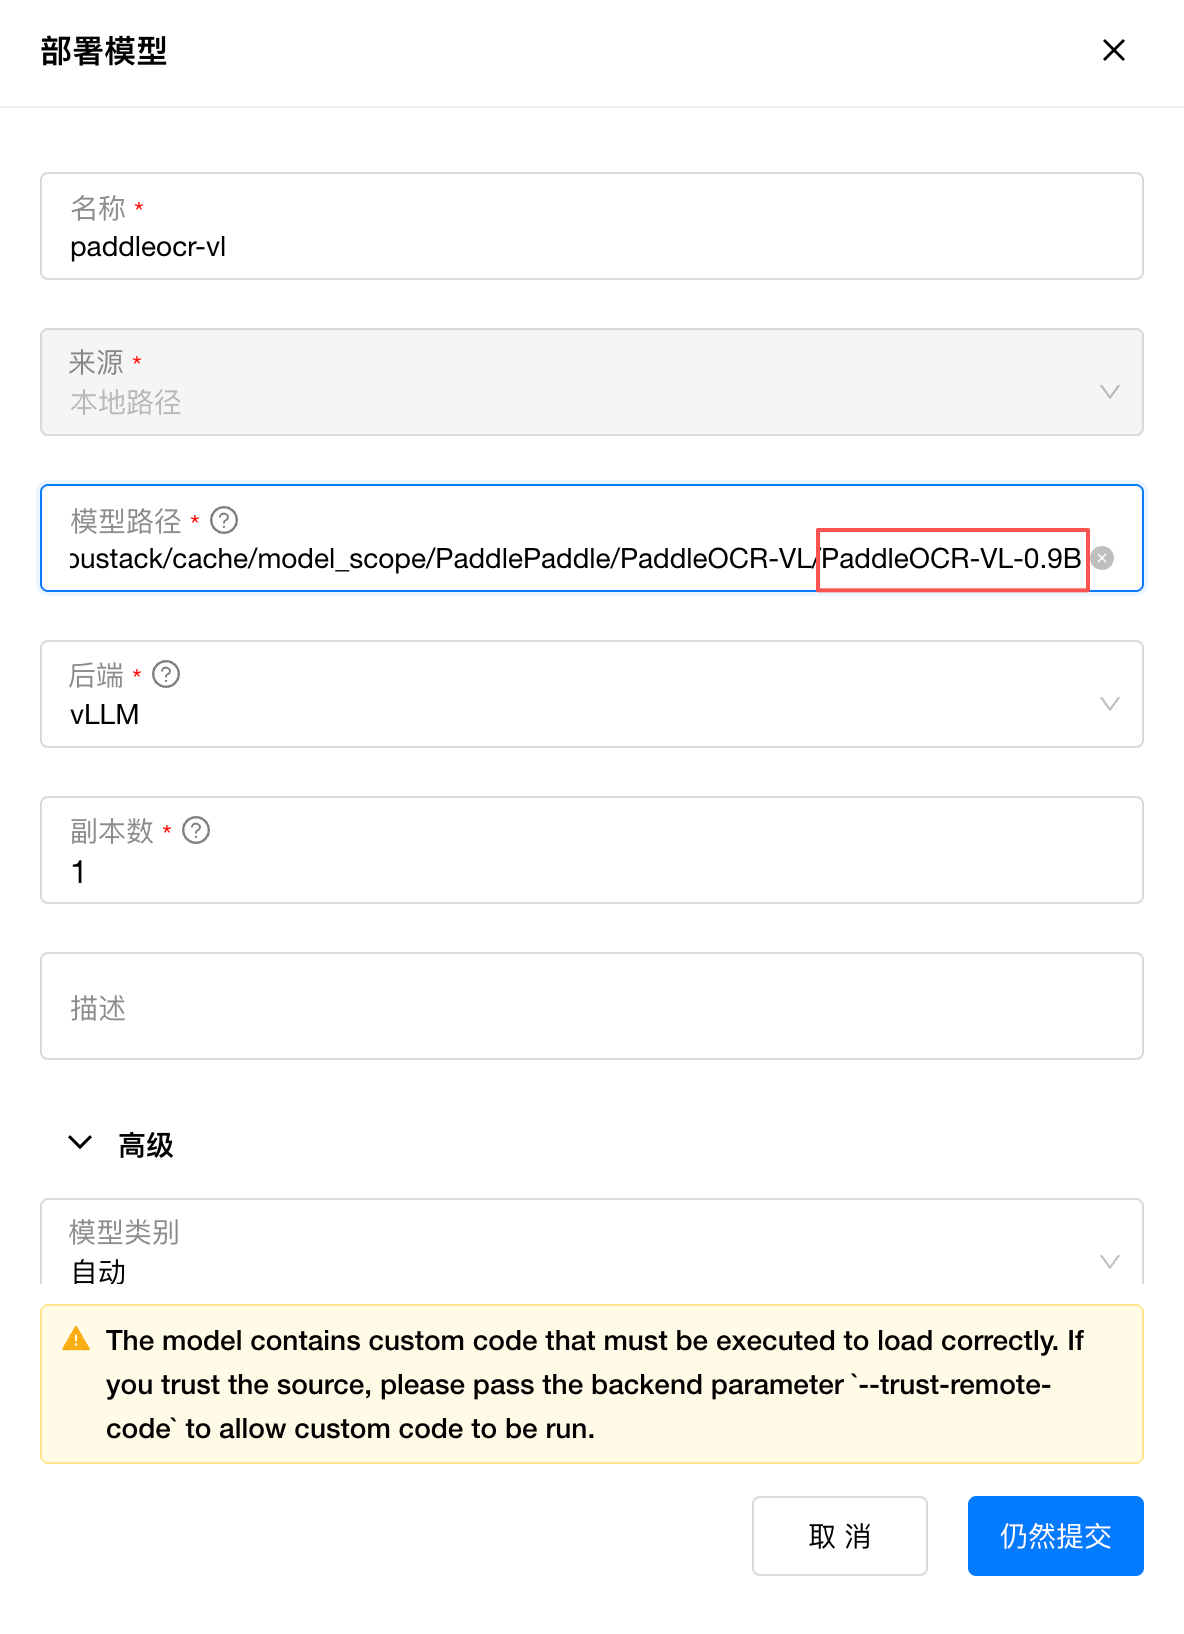
image-20251019133322616

展开高级配置,设置模型类别为 LLM。在后端版本中,填写自定义的后端版本为 paddle_ocr(指向前面步骤软链的 /var/lib/gpustack/bin/vllm_paddle_ocr),GPUStack 会自动调用运行模型。

在后端参数设置以下启动参数:

--trust-remote-code(兼容性检查提示需要信任自定义代码执行)

--max-model-len=32768 (设置上下文大小)

--chat-template=/opt/templates/chat_template.jinja (设置该模型要求的 Chat Template)
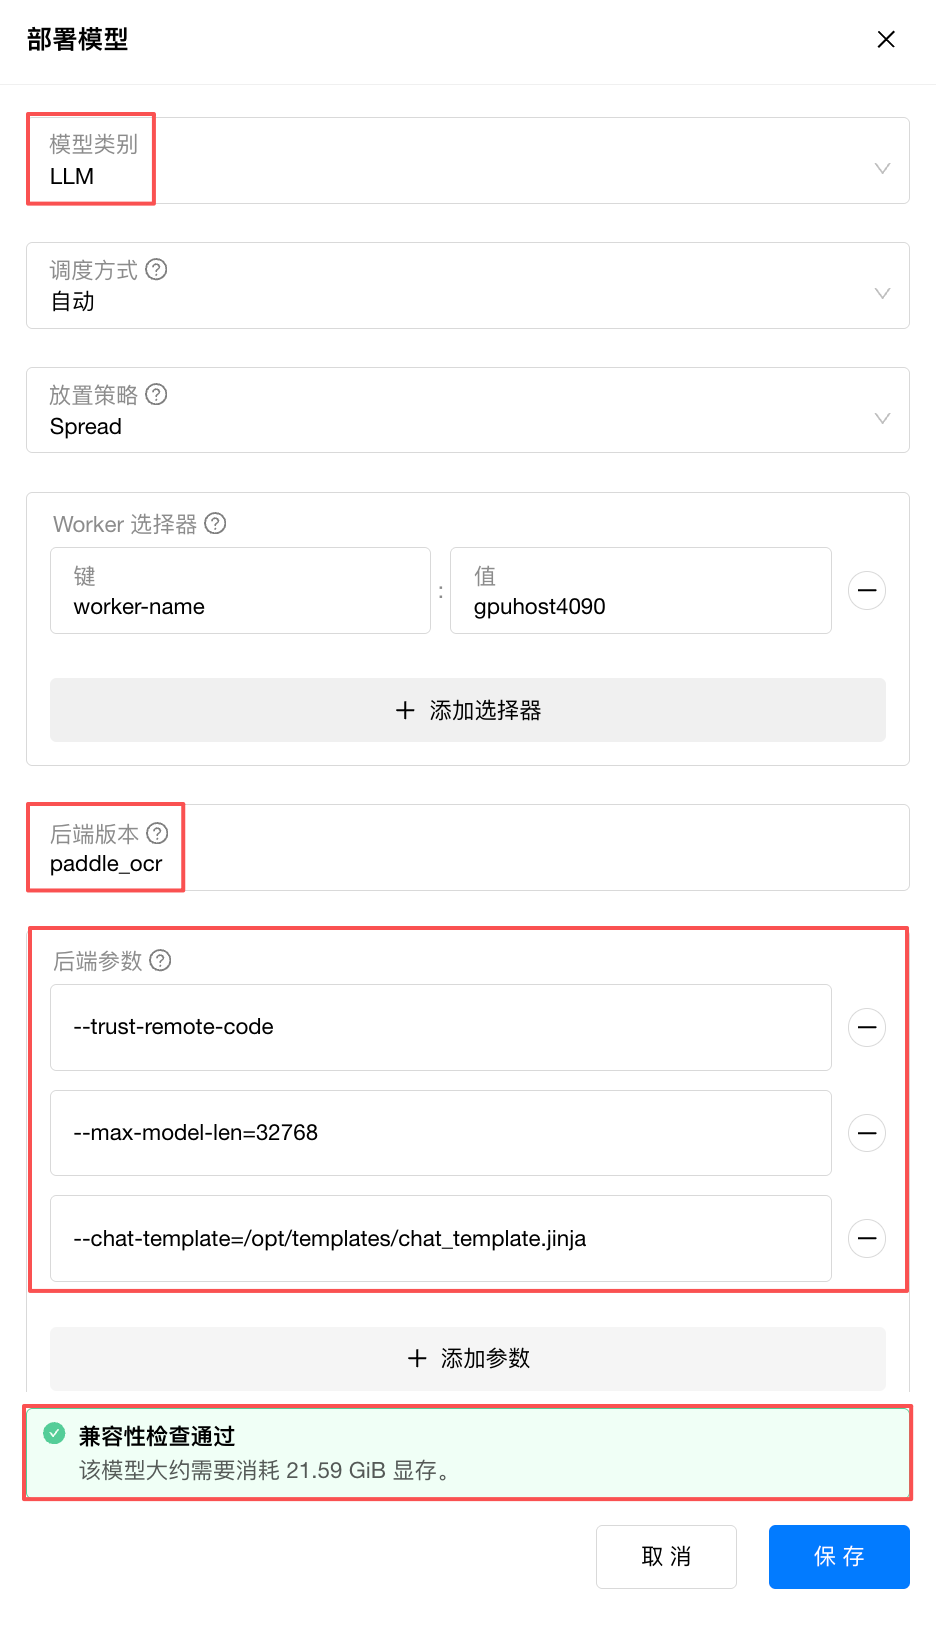
image-20251019134519386

vLLM 默认占用 GPU 的90%显存,若需要部署多个模型,可以通过 --gpu-memory-utilization 参数手动控制模型的 GPU 分配比例(取值范围 0~1):
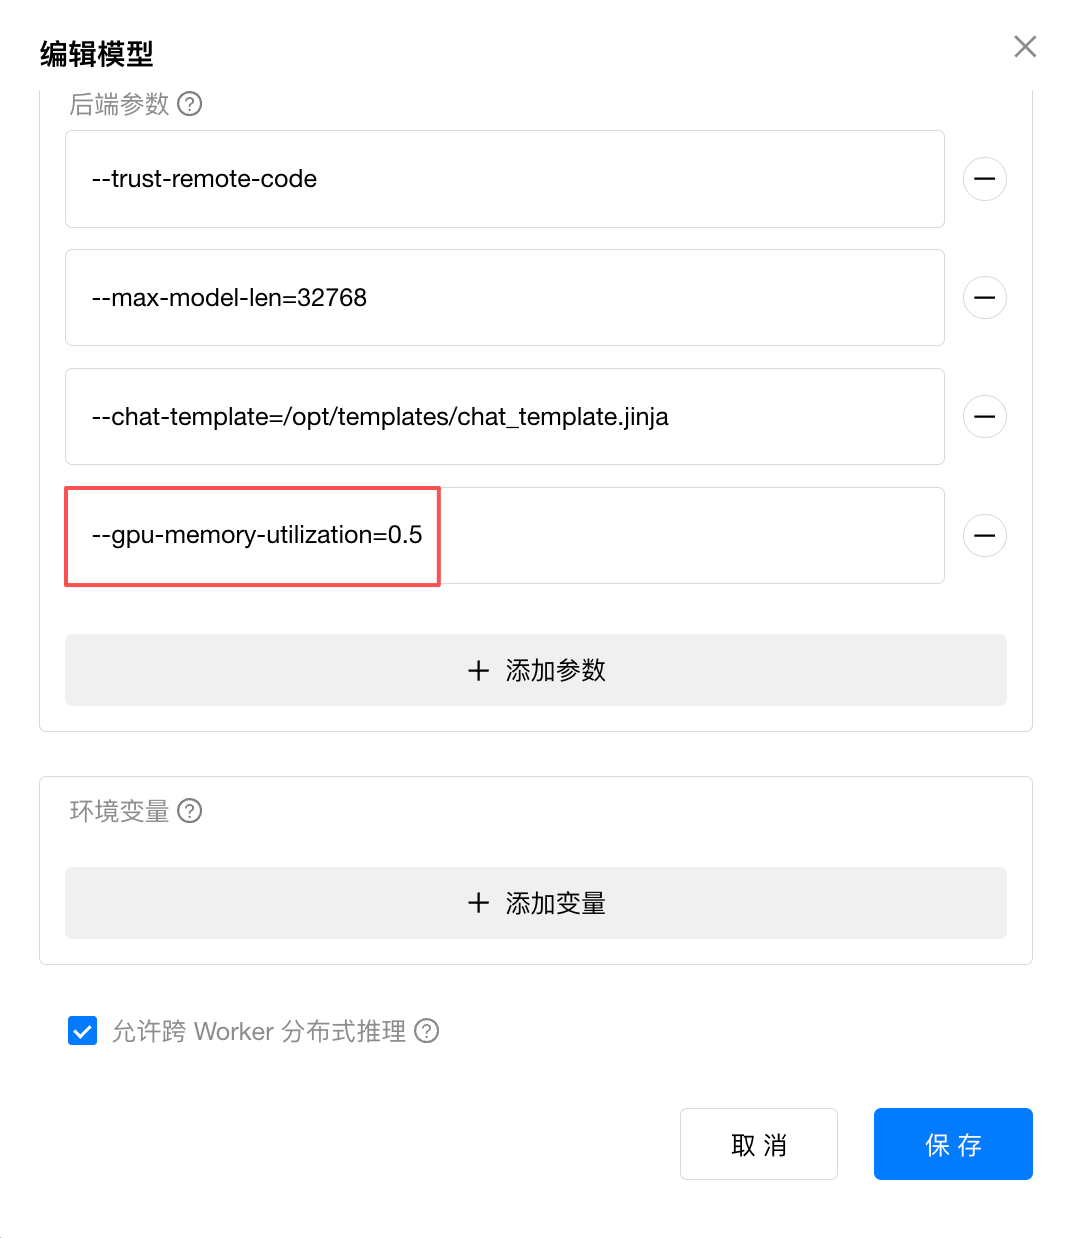
image-20251019152307692

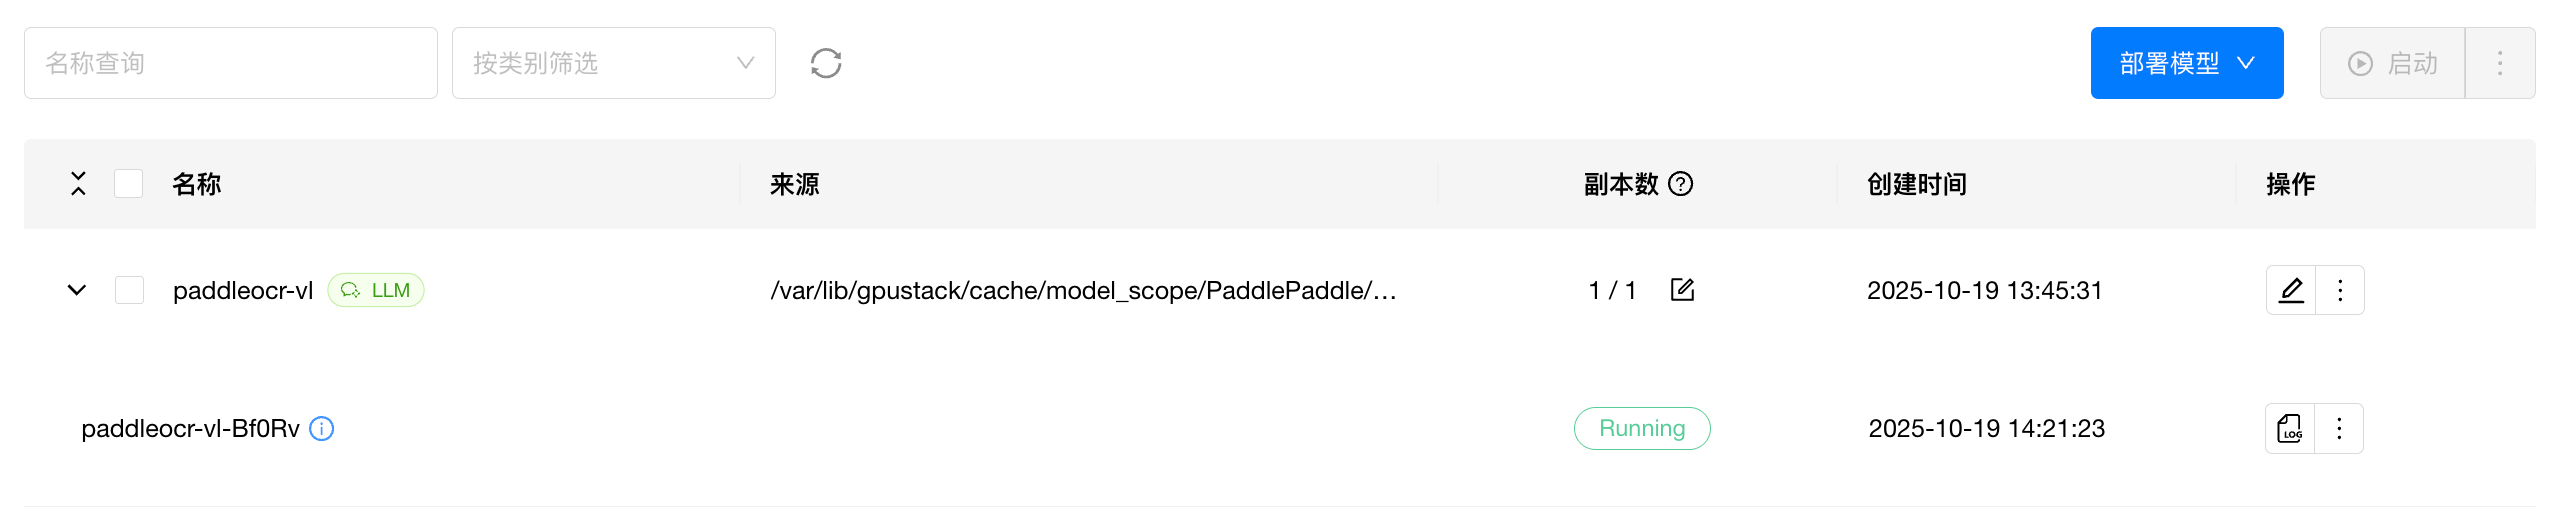
保存部署,等待模型启动完成,确认模型正常运行(Running):

image-20251019151933038

然后可以在试验场测试模型,更多用法参考 PaddleOCR-VL 官方文档:

https://www.paddleocr.ai/latest/en/version3.x/pipeline_usage/PaddleOCR-VL.html

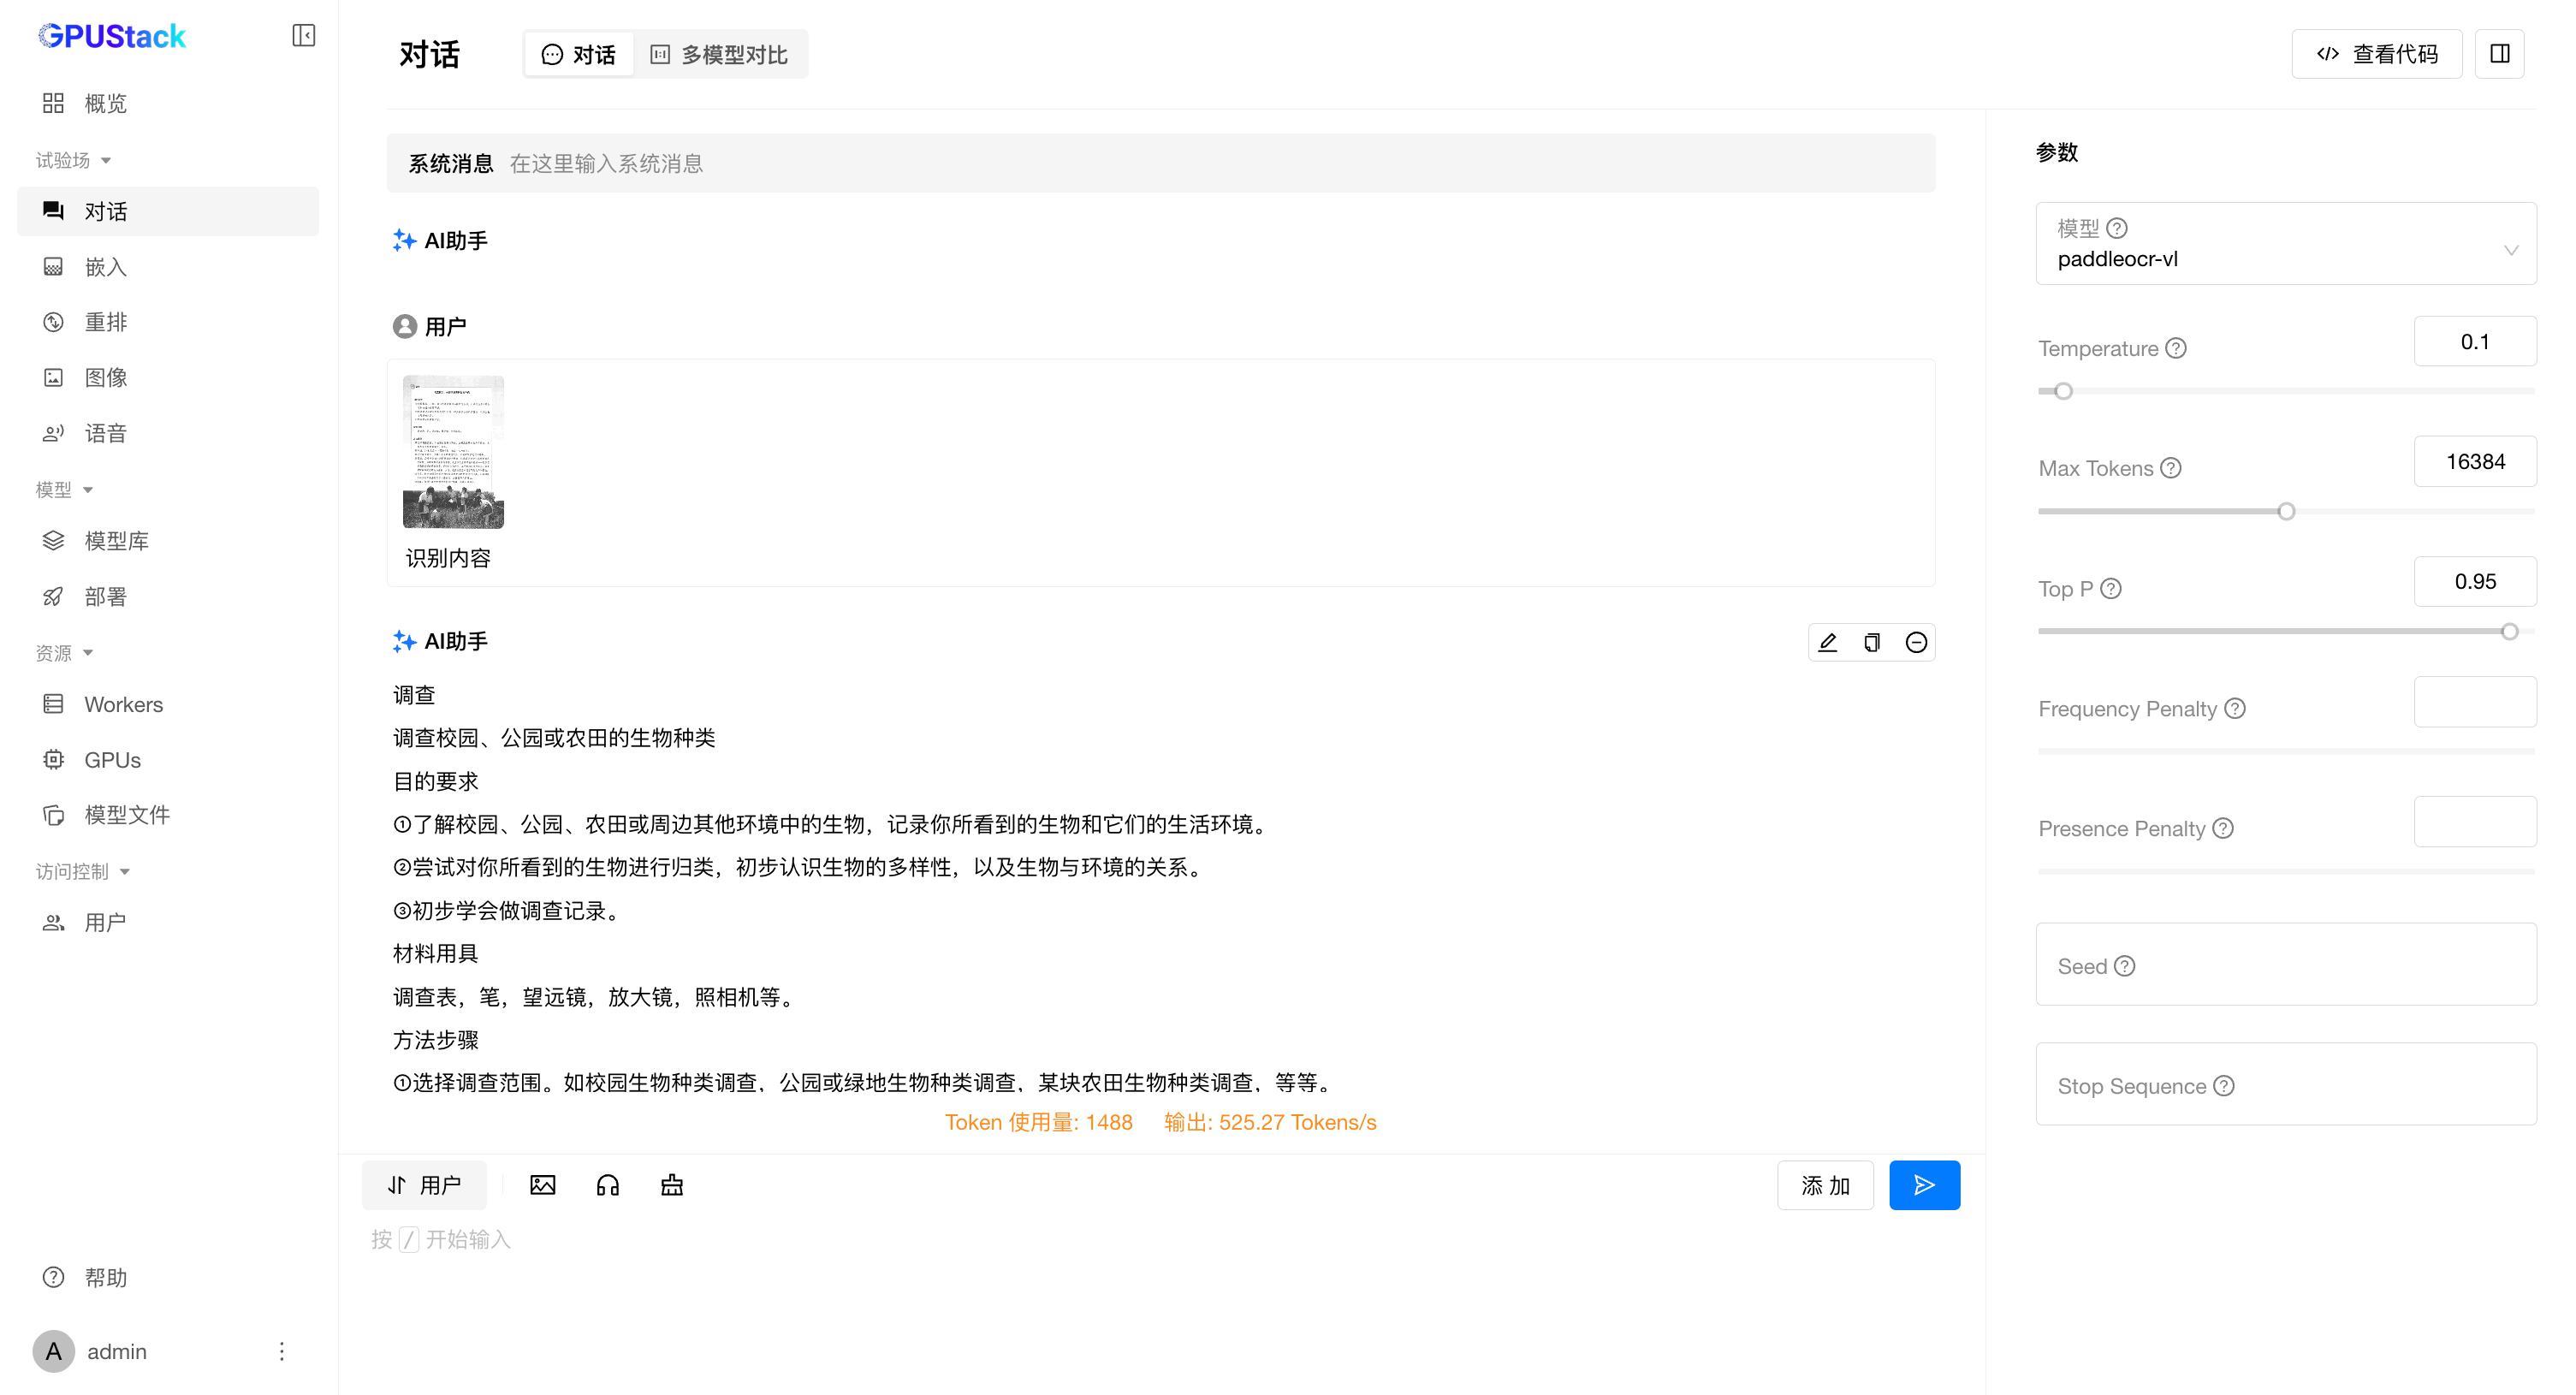
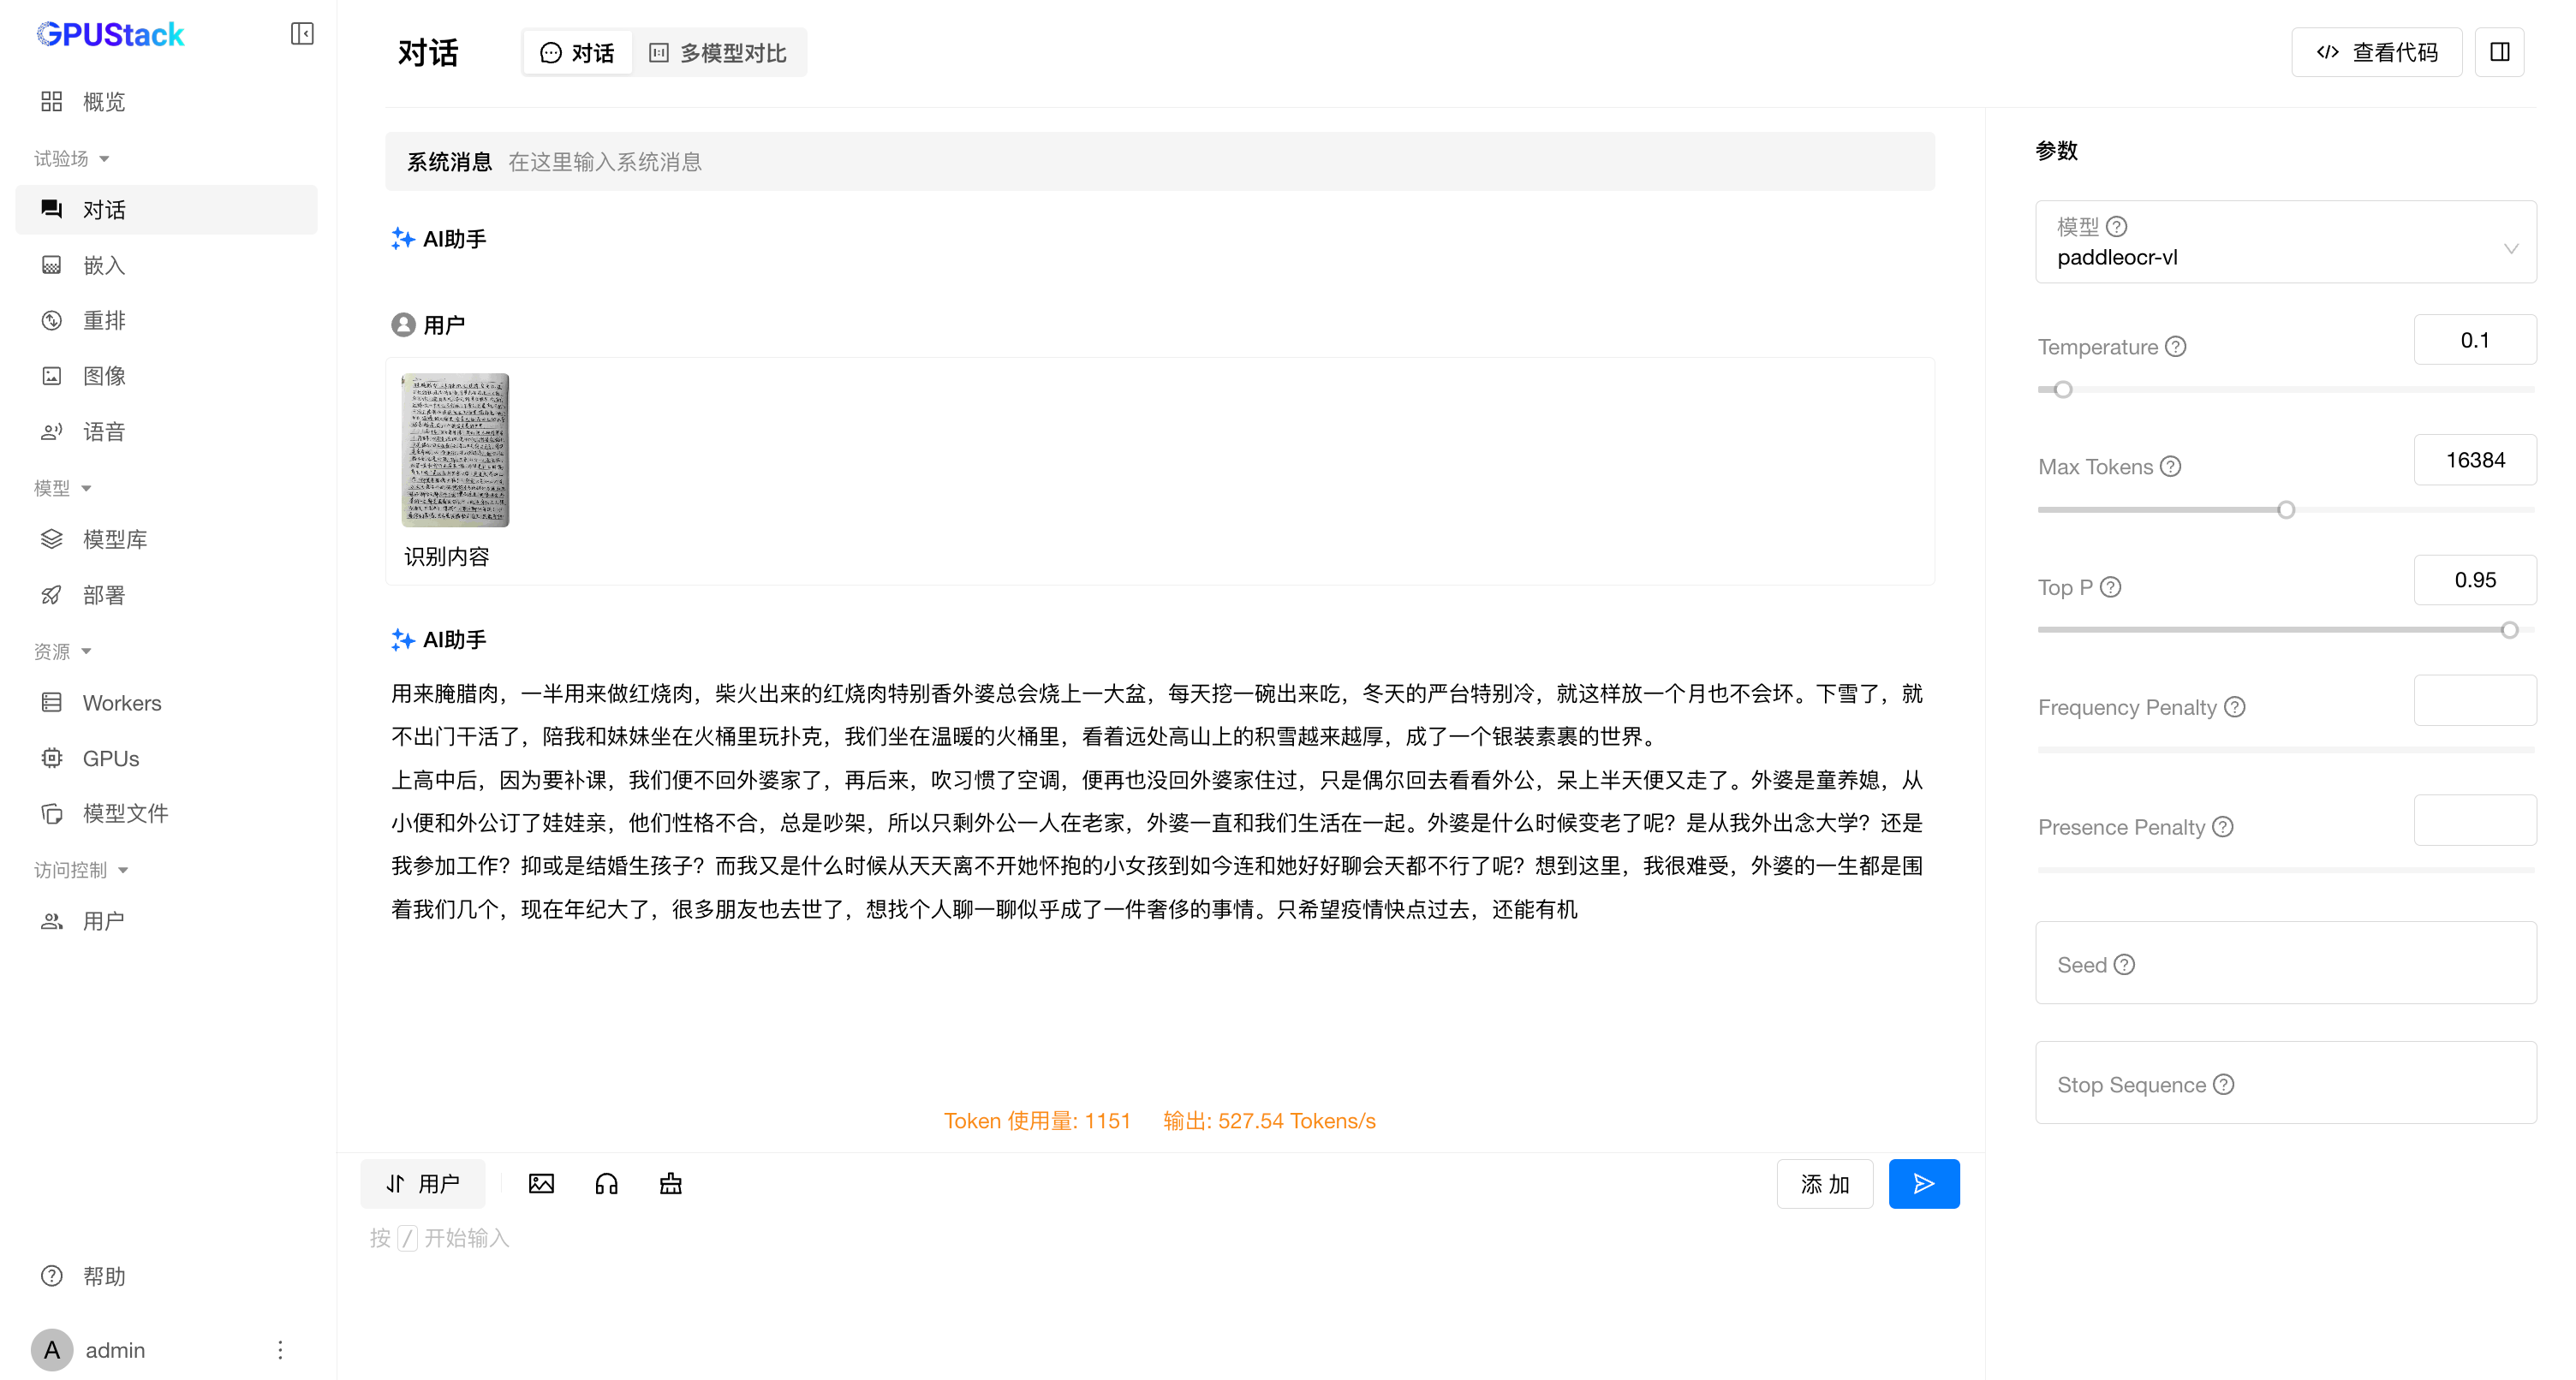
OCR 效果测试

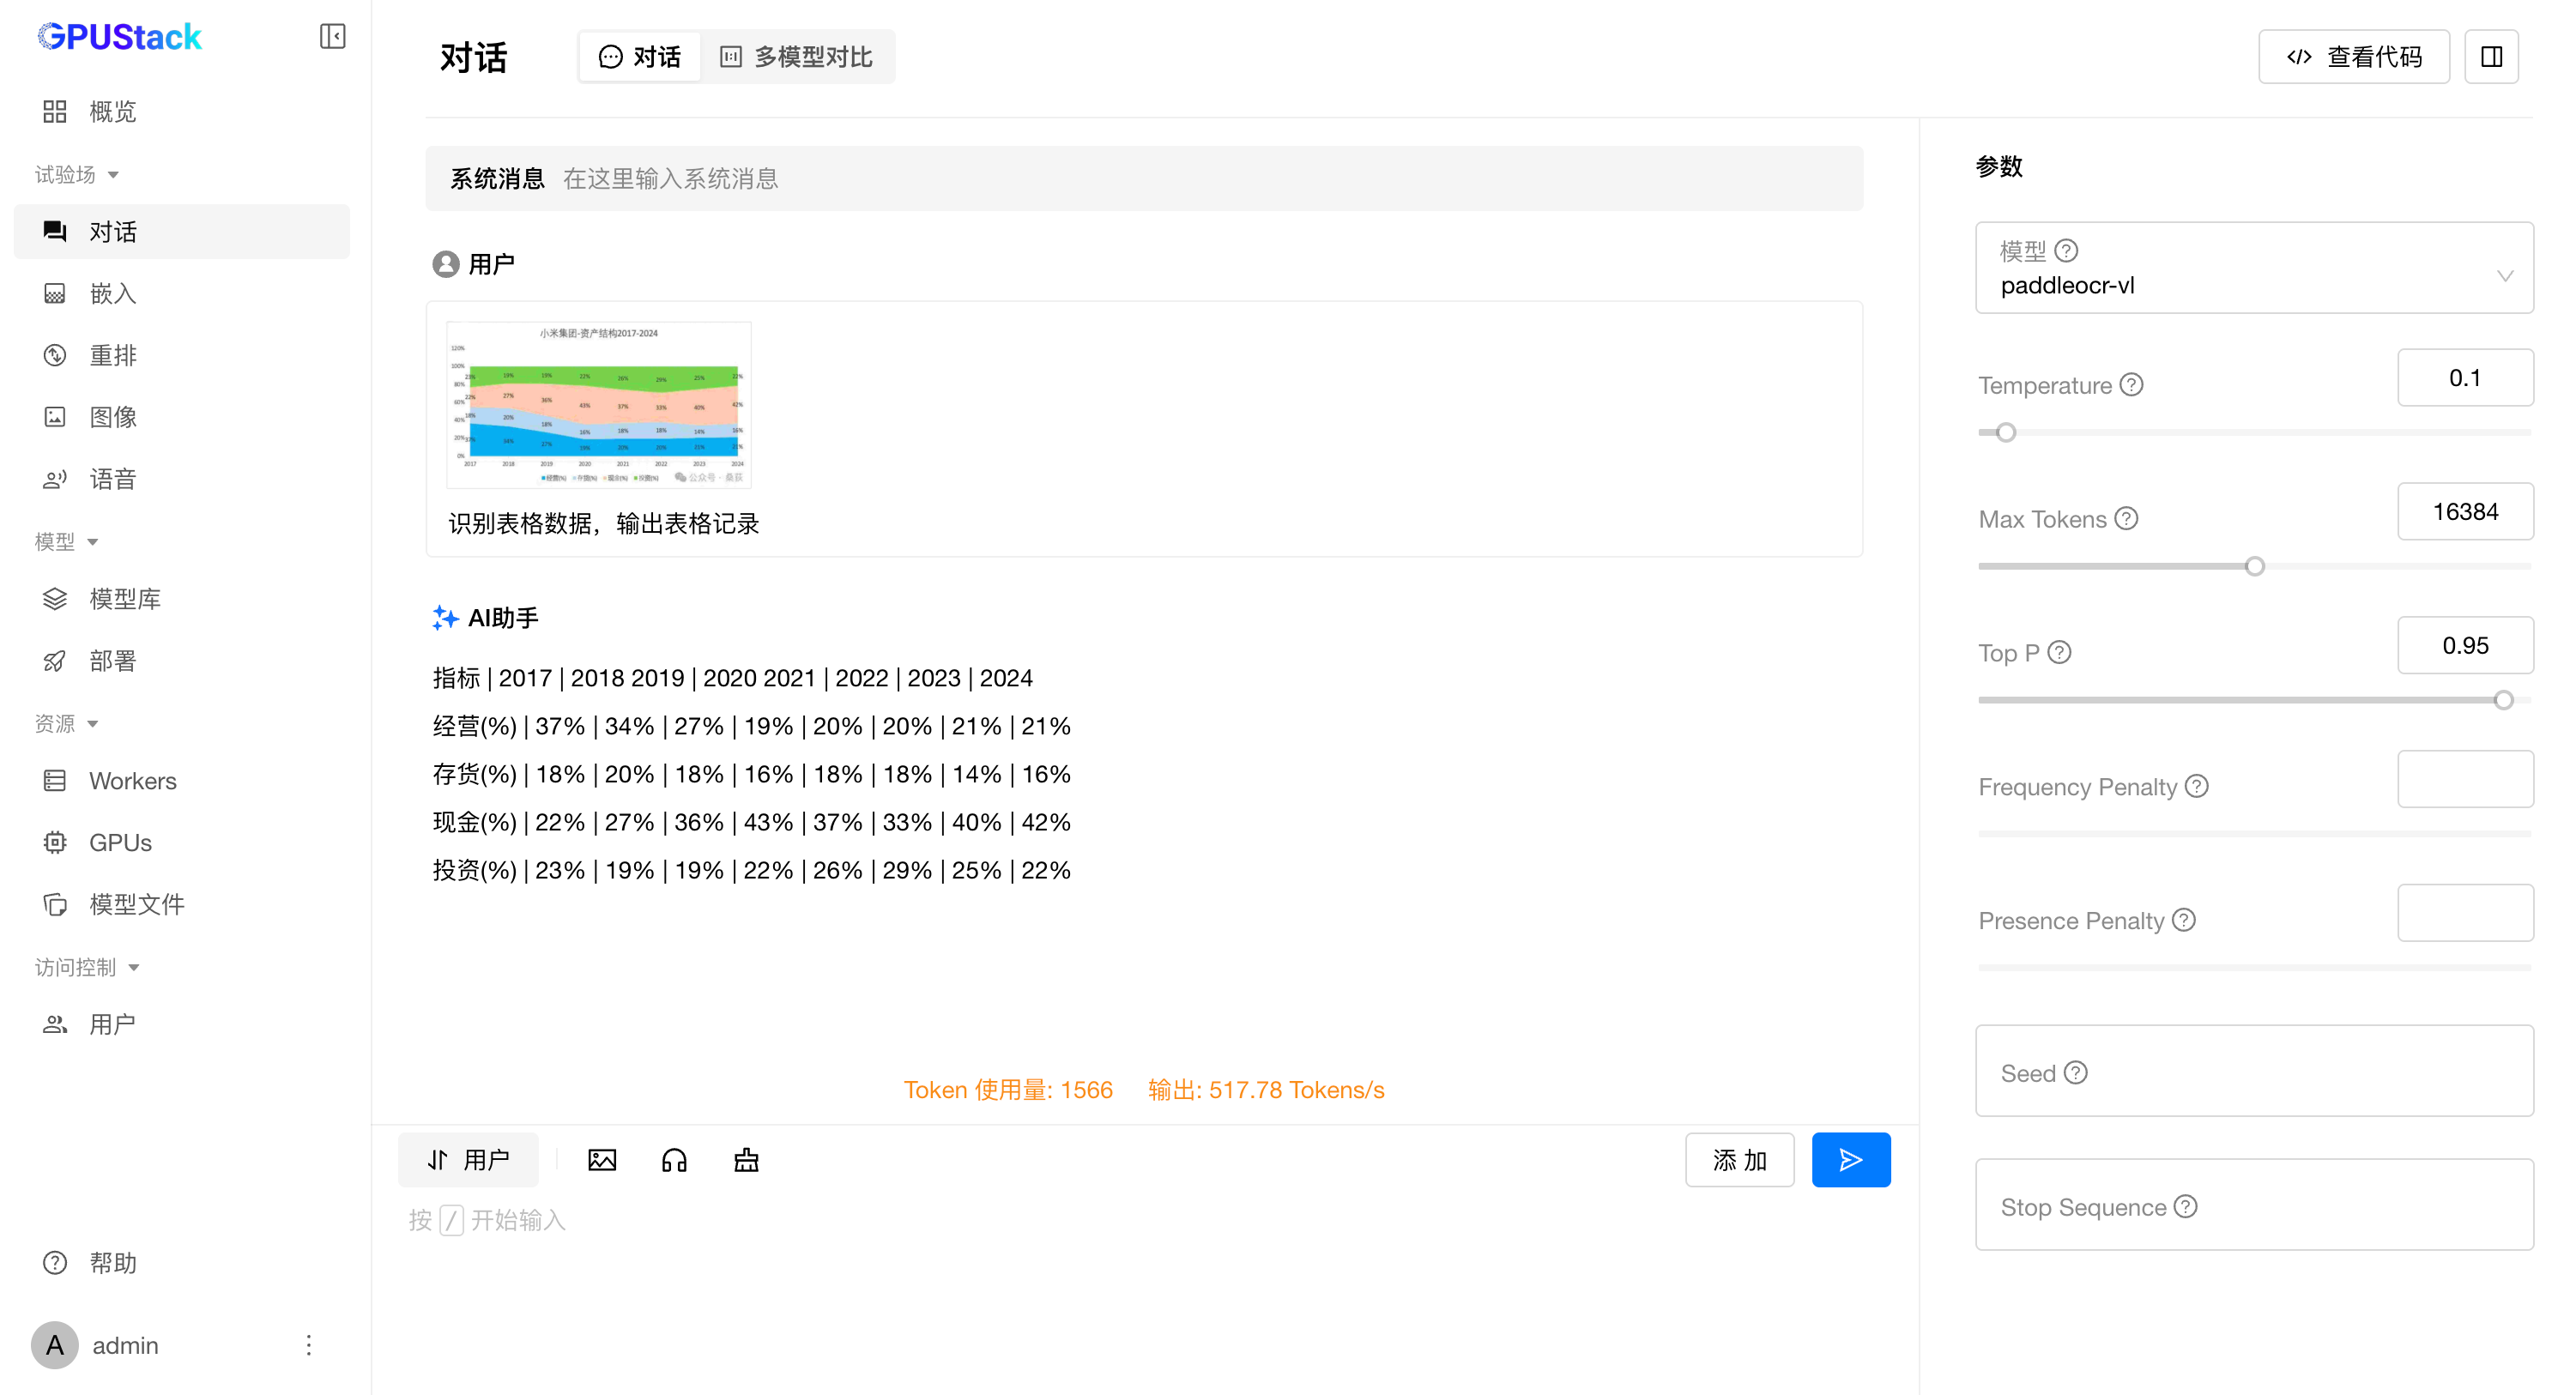
注意:为确保测试效果,推荐按照 PaddleOCR-VL 官方文档说明,将 Temperature 设置为 0.1,Top P 设置为 0.95。

综合文档解析

image-20251019150605276

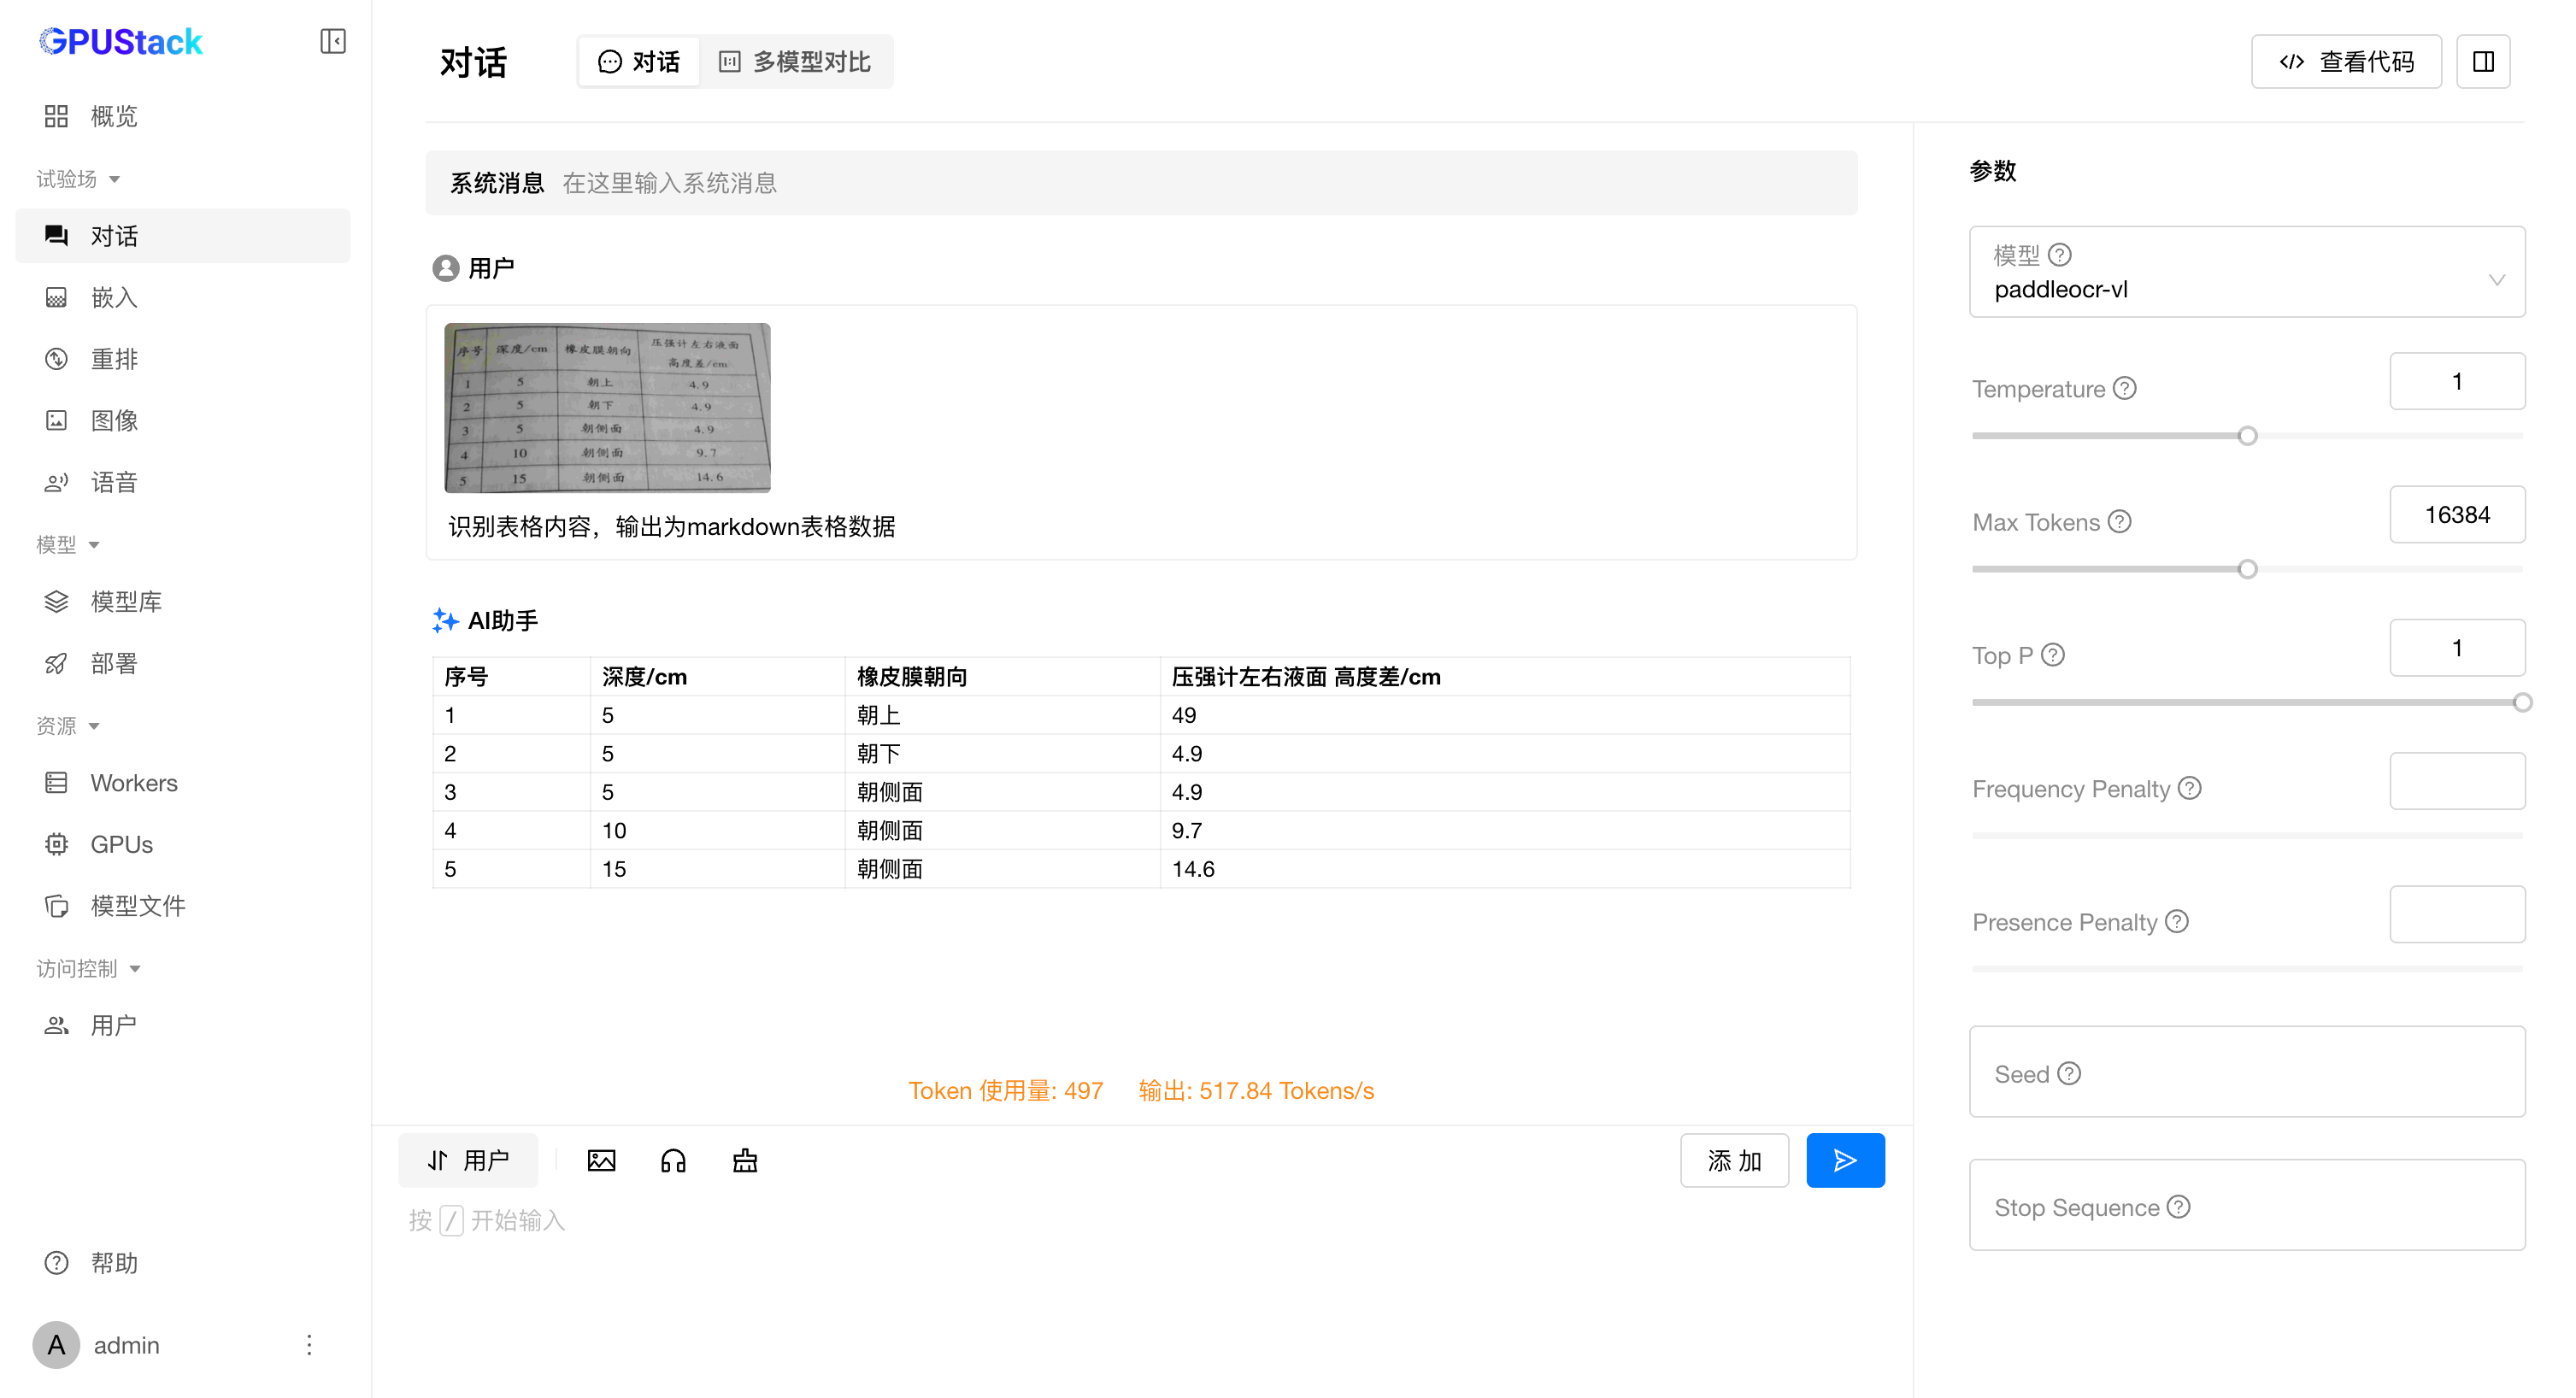
文本

image-20251019151026530

表格

image-20251019144811422

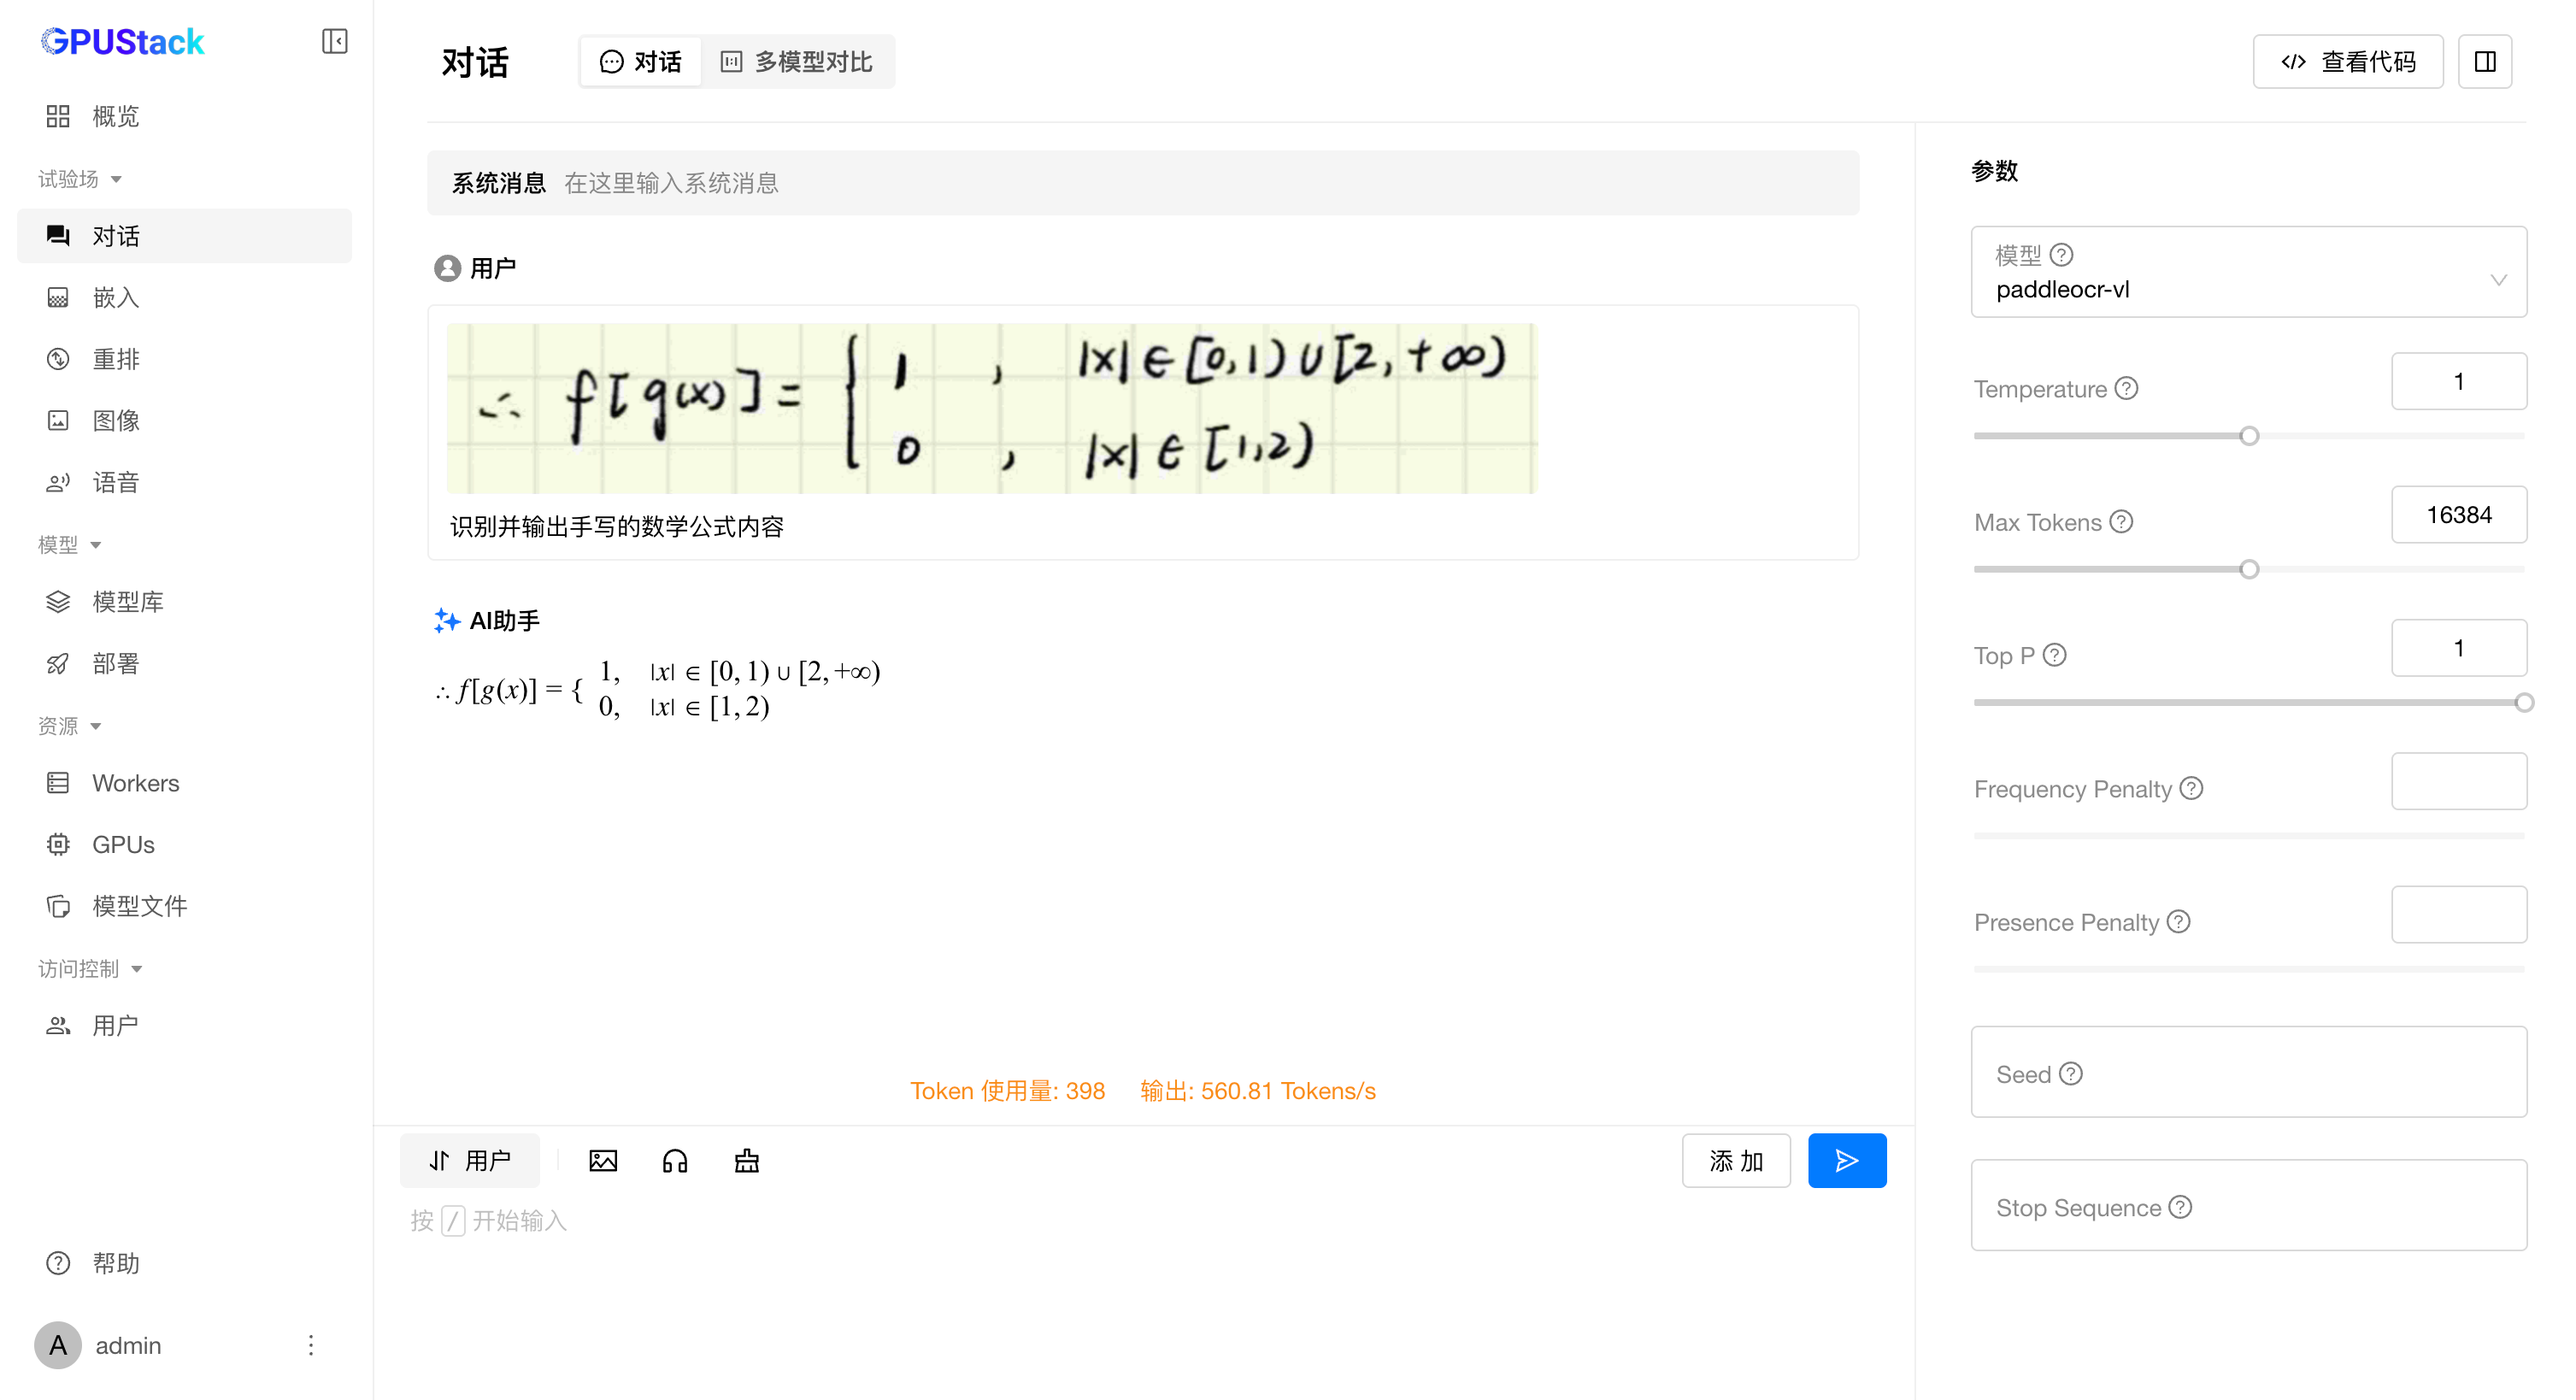
公式

image-20251019143545827

图表

image-20251019141003922

在大模型与推理技术高速演进的浪潮中,新模型层出不穷,推理框架和技术路线也愈加多元。不同模型往往需要特定的后端、配置或依赖,如何在不牺牲灵活性和性能的前提下快速接入并高效运行,已经成为构建 AI 基础设施的关键课题。

在此背景下,GPUStack 正在加速迭代。下一个版本,我们将引入可插拔后端机制与通用 API 代理 —— 让用户能够自由定制任意的推理引擎与运行配置,像搭积木一样灵活打造 MaaS 平台。无论是前沿大模型,还是传统机器学习模型,都能在同一平台上被快速加载、无缝调用。

让每一个开发者、每一家企业,都能更轻松地跟上大模型技术的快速更迭,将创新更快地落地到真实场景中。我们共同见证 GPUStack 的下一次蜕变!

【C++】 详解 lower_bound 和 upper_bound 函数(看不懂来捶我!!!) 这两个函数是我在 LeetCode 上做题见到,看到不熟悉的函数 lower_bound 和 upper_bound让我感觉很难受,于是在C++ 官网去学习,例子就一个是最基础的,我看明白了。虽然是两个函数的接口就两个,但是有时候看别人使用的时候,里面参数还可以放不同的仿函数,我懵逼了。就去网上搜,但是大家讲解的都是它的第一个接口。我只能再把文档一遍一遍过,代码一遍遍的尝试,调试。最终通过查阅资料将其总结如下。 阅读详情

相关推荐

全面讲解电子齿轮比与脉冲数计算

什么是编码器分辨率。

viixin的博客 1万+

图灵社区专访赵劼

“码农人物志”新派码农代表:赵劼,网名@老赵,洋名Jeffrey Zhao,享乐派码农。最爱美女,其次是编程和弹钢琴。 目前就职于IBM,高级咨询师。InfoQ中文站编辑,多次受邀于微软TechED,MSDN WebCast及各微软官方或社区会议中担任技术议题讲师。最近致力于Wind.js项目的开发与推广,并关注F#,Scala语言及mono平台在社区中的发展。编程人生的开始一开始大家都是每天在一...

KEEP的博客 1734

使用LSTM(长短期记忆)模型处理文本数据的典型流程

对于序列到序列的任务(如机器翻译),可以使用LSTM的隐状态来生成目标序列。这些向量捕获了词之间的语义关系,每个词都被表示为一个高维空间中的点,语义上相似的词在向量空间中彼此靠近。这通常是通过创建一个词汇表(vocabulary)来实现的,词汇表中的每个词都会被分配一个唯一的数字ID。:由于LSTM等循环神经网络(RNN)需要固定长度的输入,所以需要将不同长度的句子填充到相同的长度。由于计算机不能直接理解连续的文本,第一步是将文本分割成独立的词或标记(token)。:将词嵌入作为输入传递给LSTM模型。

YHKKun的博客 2499

20位活跃在Github上的国内技术大牛

20位活跃在Github上的国内技术大牛 本文列举了20位在Github上非常活跃的国内大牛,看看其中是不是很多熟悉的面孔? 1. lifesinger(玉伯) Github主页:        https://github.com/lifesinger微博:@        玉伯也叫射雕 玉伯(王保平),淘宝前端类库 KISSY、前端模块化开发框架SeaJS、

leon-这个程序员不闷骚的博客 3万+

K210学习笔记(八)——人脸检测和人脸识别

前言 人脸检测是人脸识别算法的第一步,人脸识别过程主要分为人脸图像获取、人脸检测、人脸配准、人脸表征以及人脸图像匹配与识别。人脸检测的目标是找出图像中所有的人脸对应的位置,算法的输出是人脸外接矩形(椭圆)在图像中的坐标,可能还包括姿态如倾斜角度等信息。人脸检测在安防监控,人证比对,人机交互,社交和娱乐等方面有很强的应用价值。 人脸识别是在人脸检测的基础上除了检测到人脸的位置以外, 还可以识别到这个人是谁,利用分析比较是基于人的脸视觉部特征信息进行身份鉴识别的计算机一种生物识别技术。 一、KPU模块方法 1、

Thousand_drive的博客 1万+

Acgis中实现栅格经纬度和行政区关联

目前已有意大利的shp文件,希望将意大利划分成0.1*0.1经纬度的栅格,并且关联每个栅格中心点所属的省份信息。最终希望得到的输出是一个表格,里面包含栅格的经纬度、所属省份信息。

qq_42183184的博客 3369

深夜总结:使用QGIS切片并用Cesium完成调用

1. 前言 前段时间,有群里看见有个需求,他自己使用QGIS切成的瓦片,但用Cesium调用存在问题。本着对此感兴趣的初衷,自己研究了一番并做出记录。 2. QGIS切片 添加数据 切片 下图的范围很重要,是Cesium调用的重要参数 3. 发布切片 使用nginx发布瓦片服务,在nginx.conf中添加如下配置: server{ listen 8091; server_name localhost; location / {

ONEGISER的博客 6289

ubuntu恢复分区表——testdisk

testdisk恢复ubuntu分区表testdisk介绍安装testdisk使用testdisk恢复分区表 testdisk介绍 testdisk 具有广泛的功能,包括恢复丢失或损坏的分区和使不能启动磁盘可以重新启动,也经常被用来恢复被误删的文件。 安装testdisk 如果系统分区表被删除,需要使用ubuntu的启动盘,选择try ubnutu模式进入试用系统。 1、可以直接在终端安装testdisk: sudo apt-get install testdisk 通过命令直接打开testdisk: t

ZNestor的博客 6459

Dyad 开源项目教程

Dyad 是一个轻量级的、事件驱动的网络库,适用于 C 语言。它旨在简化网络编程,提供了一种简洁的方式来处理网络连接和数据传输。Dyad 的设计理念是尽可能地减少依赖,使得它可以在各种平台上轻松编译和使用。 ## 项目快速启动 要快速启动 Dyad 项目,请按照以下步骤操作: 1. **克隆仓库**: ```bash git clone https://github.com/r...

gitblog_00973的博客 394

Lumerical FDTD新手教程:5步搞定MMI波导光谱模拟(附避坑指南)

本文提供Lumerical FDTD新手教程,详细讲解5步完成MMI波导光谱模拟的实用方法,包括环境准备、结构建模、光源配置、仿真优化和结果分析。特别针对多模干涉耦合器(MMI)的模拟难点,提供避坑指南和优化策略,帮助光学工程师快速掌握FDTD仿真技术。

kite3的博客 359

从零开始:用Kimi API和LangChain打造智能写作助手

本文详细介绍了如何从零开始,利用Kimi API提供的强大AI大模型能力,结合LangChain框架构建一个智能写作助手。通过实战演示了环境搭建、核心写作链构建、以及引入检索增强生成和智能体等进阶功能,旨在解决长文档创作、事实准确性等痛点,打造一个能理解意图、调用工具并保持记忆的智能创作伙伴。

weixin_29294395的博客 138

【GitHub每日速递 】无需注册!本地开源AI应用构建器Dyad,跨平台速下载!

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

adscdshdfbds的博客 494

yolov26改进 | Neck/颈部创新篇 | 独创HFPN利用分层特征融合块HFFB模块融合多层次特征改进yolov26(全网独家创新)

本文提出了一种创新的分层特征融合模块HFFB(Hierarchical Feature Fusion Block)来改进YOLOv26的neck部分,构建了名为HFPN的新型特征金字塔网络。该模块通过三分支结构融合局部特征(CNN提取)、全局特征(Swin Transformer提取)和中间特征,并包含空间注意力(SA)、通道注意力(CA)和残差反向MLP(IRMLP)等组件来优化特征融合效果。实验表明,该方法能针对不同尺度目标(大/中/小)进行自适应检测,可根据具体数据集需求选择不同配置。文章详细提供了核

Snu77的博客 483

优雅求模,一致性哈希算法

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

gMZv3MU7b的博客 324

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

AOP in Asp.net MVC

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94594124的博客 256

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

使用 Visual Studio 快速创建 NuGet 程序包并发布到 NuGet 官网

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94629293的博客 368

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

撸一个功能强大的基于语义的图像检索系统

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94611622的博客 318

PHP 程序员为什么总是瞧不起 PHP ?

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94594124的博客 196

开源(Open Source)那些事儿 (一)

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94611622的博客 246

C# 与 .NET 跨平台开发实战(第一章:开发环境搭建与.NET概述-上篇)

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94594124的博客 228

唐 C# 弃元模式:从语法糖到性能利器的深度解析H

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

sacagfadwafagas的博客 281

探讨 T-SQL 的 EXISTS、EXCEPT、INTERSECT 算符

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94594124的博客 227

Solon v.., v.., v..-M 发布。正式开始 LTS 计划

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94611622的博客 273

一生一芯学习:基础设施()

PaddleOCR-VL 的核心组件是 PaddleOCR-VL-0.9B,它创新性地将 NaViT 风格的动态分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,兼具结构理解力与资源效率。本文将详细演示如何通过 GPUStack 平台,在本地环境中完成 PaddleOCR-VL 模型的推理部署,并展示其在真实文档解析任务中的表现。由于 PaddleOCR-VL-0.9B 模型位于下载的模型目录的 PaddleOCR-VL-0.9B 子目录下,需要修改为指向该目录进行部署。

2501_94611622的博客 429
上一篇: 昇腾多机推理极速上手:10倍简化的 DeepSeek R1 超大规模模型部署
下一篇: GPUStack v2:推理加速释放算力潜能,开源重塑大模型推理下半场
GPUStack
博客等级 码龄2年 150粉丝 65原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值