配置NVIDIA Container Runtime和容器运行GPUStack教程

Containerd 配置使用 Nvidia container runtime 前言 Kubernetes 集群中 Docker 如何使用 GPU,请看这一篇 docker配置Nvidia环境,使用GPU 本文着重讲 Containerd 如何作为容器运行时来使用 GPU CRI Plugin Config Guide CRI 插件配置指南 https://github.com/containerd/containerd/blob/main/docs/cri/config.... 阅读详情
AI摘要

本文是关于设置NVIDIA容器运行时并使用容器方式运行GPUStack的操作教程。GPUStack可聚合不同平台GPU构建异构集群。教程涵盖前置准备,包括验证硬件和GCC,还介绍了安装NVIDIA驱动、Docker Engine、NVIDIA Container Toolkit及GPUStack的步骤,最后可部署和调测模型。

GPUStack 是一个设计用于运行大模型的开源 GPU 集群管理器,提供私有部署的大模型服务,支持大语言模型、Embedding 文本嵌入模型、Reranker 重排序模型、Vision 多模态模型等各种模型。它可以聚合不同平台(如 Apple Mac、Windows PC 和 Linux 服务器)的 GPU,构建一个统一的异构 GPU 集群。

在 Linux 中十分推荐使用 Docker 方式安装 GPUStack,可以避免很多依赖和冲突问题,简化安装过程。

今天带来一篇关于如何设置 NVIDIA 容器运行时并使用容器方式运行 GPUStack 的操作教程。

前置准备

验证当前环境有 NVIDIA GPU 硬件:

lspci | grep -i nvidia

验证系统已安装 GCC:

gcc --version

安装 NVIDIA 驱动

参考:https://developer.nvidia.com/datacenter-driver-downloads

为当前内核安装内核头文件和开发包:

sudo apt-get install linux-headers-$(uname -r)

安装 cuda-keyring 包:

wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/x86_64/cuda-keyring_1.1-1_all.deb
sudo dpkg -i cuda-keyring_1.1-1_all.deb

安装 NVIDIA 驱动:

sudo apt-get update
sudo apt-get install nvidia-open -y

重启系统:

sudo reboot

重新登录并检查 nvidia-smi 命令可用:

nvidia-smi

image-20241118175603256

安装 Docker Engine

参考:https://docs.docker.com/engine/install/ubuntu/

执行以下命令卸载所有冲突的包:

for pkg in docker.io docker-doc docker-compose docker-compose-v2 podman-docker containerd runc; do sudo apt-get remove $pkg; done

设置 Docker 的 apt 仓库:

# Add Docker's official GPG key:
sudo apt-get update
sudo apt-get install ca-certificates curl
sudo install -m 0755 -d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/ubuntu/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc

# Add the repository to Apt sources:
echo \
  "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.asc] https://download.docker.com/linux/ubuntu \
  $(. /etc/os-release && echo "$VERSION_CODENAME") stable" | \
  sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
sudo apt-get update

安装 Docker:

sudo apt-get install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin -y

检查 docker 命令可用:

docker info

安装 NVIDIA Container Toolkit

参考:https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html

配置 NVIDIA Container Toolkit 的生产仓库:

curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg \
  && curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | \
    sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | \
    sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list

安装 NVIDIA Container Toolkit:

sudo apt-get update
sudo apt-get install -y nvidia-container-toolkit -y

使用 nvidia-ctk 命令配置容器运行时:

sudo nvidia-ctk runtime configure --runtime=docker

检查 daemon.json 文件的配置:

cat /etc/docker/daemon.json

重启 Docker daemon:

sudo systemctl restart docker

运行一个示例的 CUDA 容器来验证安装:

sudo docker run --rm --runtime=nvidia --gpus all ubuntu nvidia-smi

image-20241118182113520

安装 GPUStack

参考:https://docs.gpustack.ai/latest/installation/docker-installation/

通过 Docker 安装 GPUStack:

docker run -d --gpus all -p 80:80 --ipc=host --name gpustack \
    -v gpustack-data:/var/lib/gpustack gpustack/gpustack

使用以下命令查看登录密码:

docker exec -it gpustack cat /var/lib/gpustack/initial_admin_password

在浏览器访问 GPUStack( http://YOUR_HOST_IP )以用户名 admin 和密码登录。设置密码后,登录进 GPUStack,查看识别到的 GPU 资源:

image-20241118184913586

(可选)要添加额外的 Worker 节点,构建 GPU 集群,在其它工作节点上执行以下命令:

docker run -d --gpus all --ipc=host --network=host --name gpustack \
    gpustack/gpustack --server-url http://YOUR_HOST_IP --token YOUR_TOKEN

将其中的 http://YOUR_HOST_IP 替换为你的 GPUStack 访问地址,将 YOUR_TOKEN 替换为用于添加 Worker 的认证 Token。要从 GPUStack Server 检索 Token,使用以下命令:

docker exec -it gpustack cat /var/lib/gpustack/token

完成之后,尝试从 Hugging Face 或其它模型仓库部署模型:

image-20241118215525917

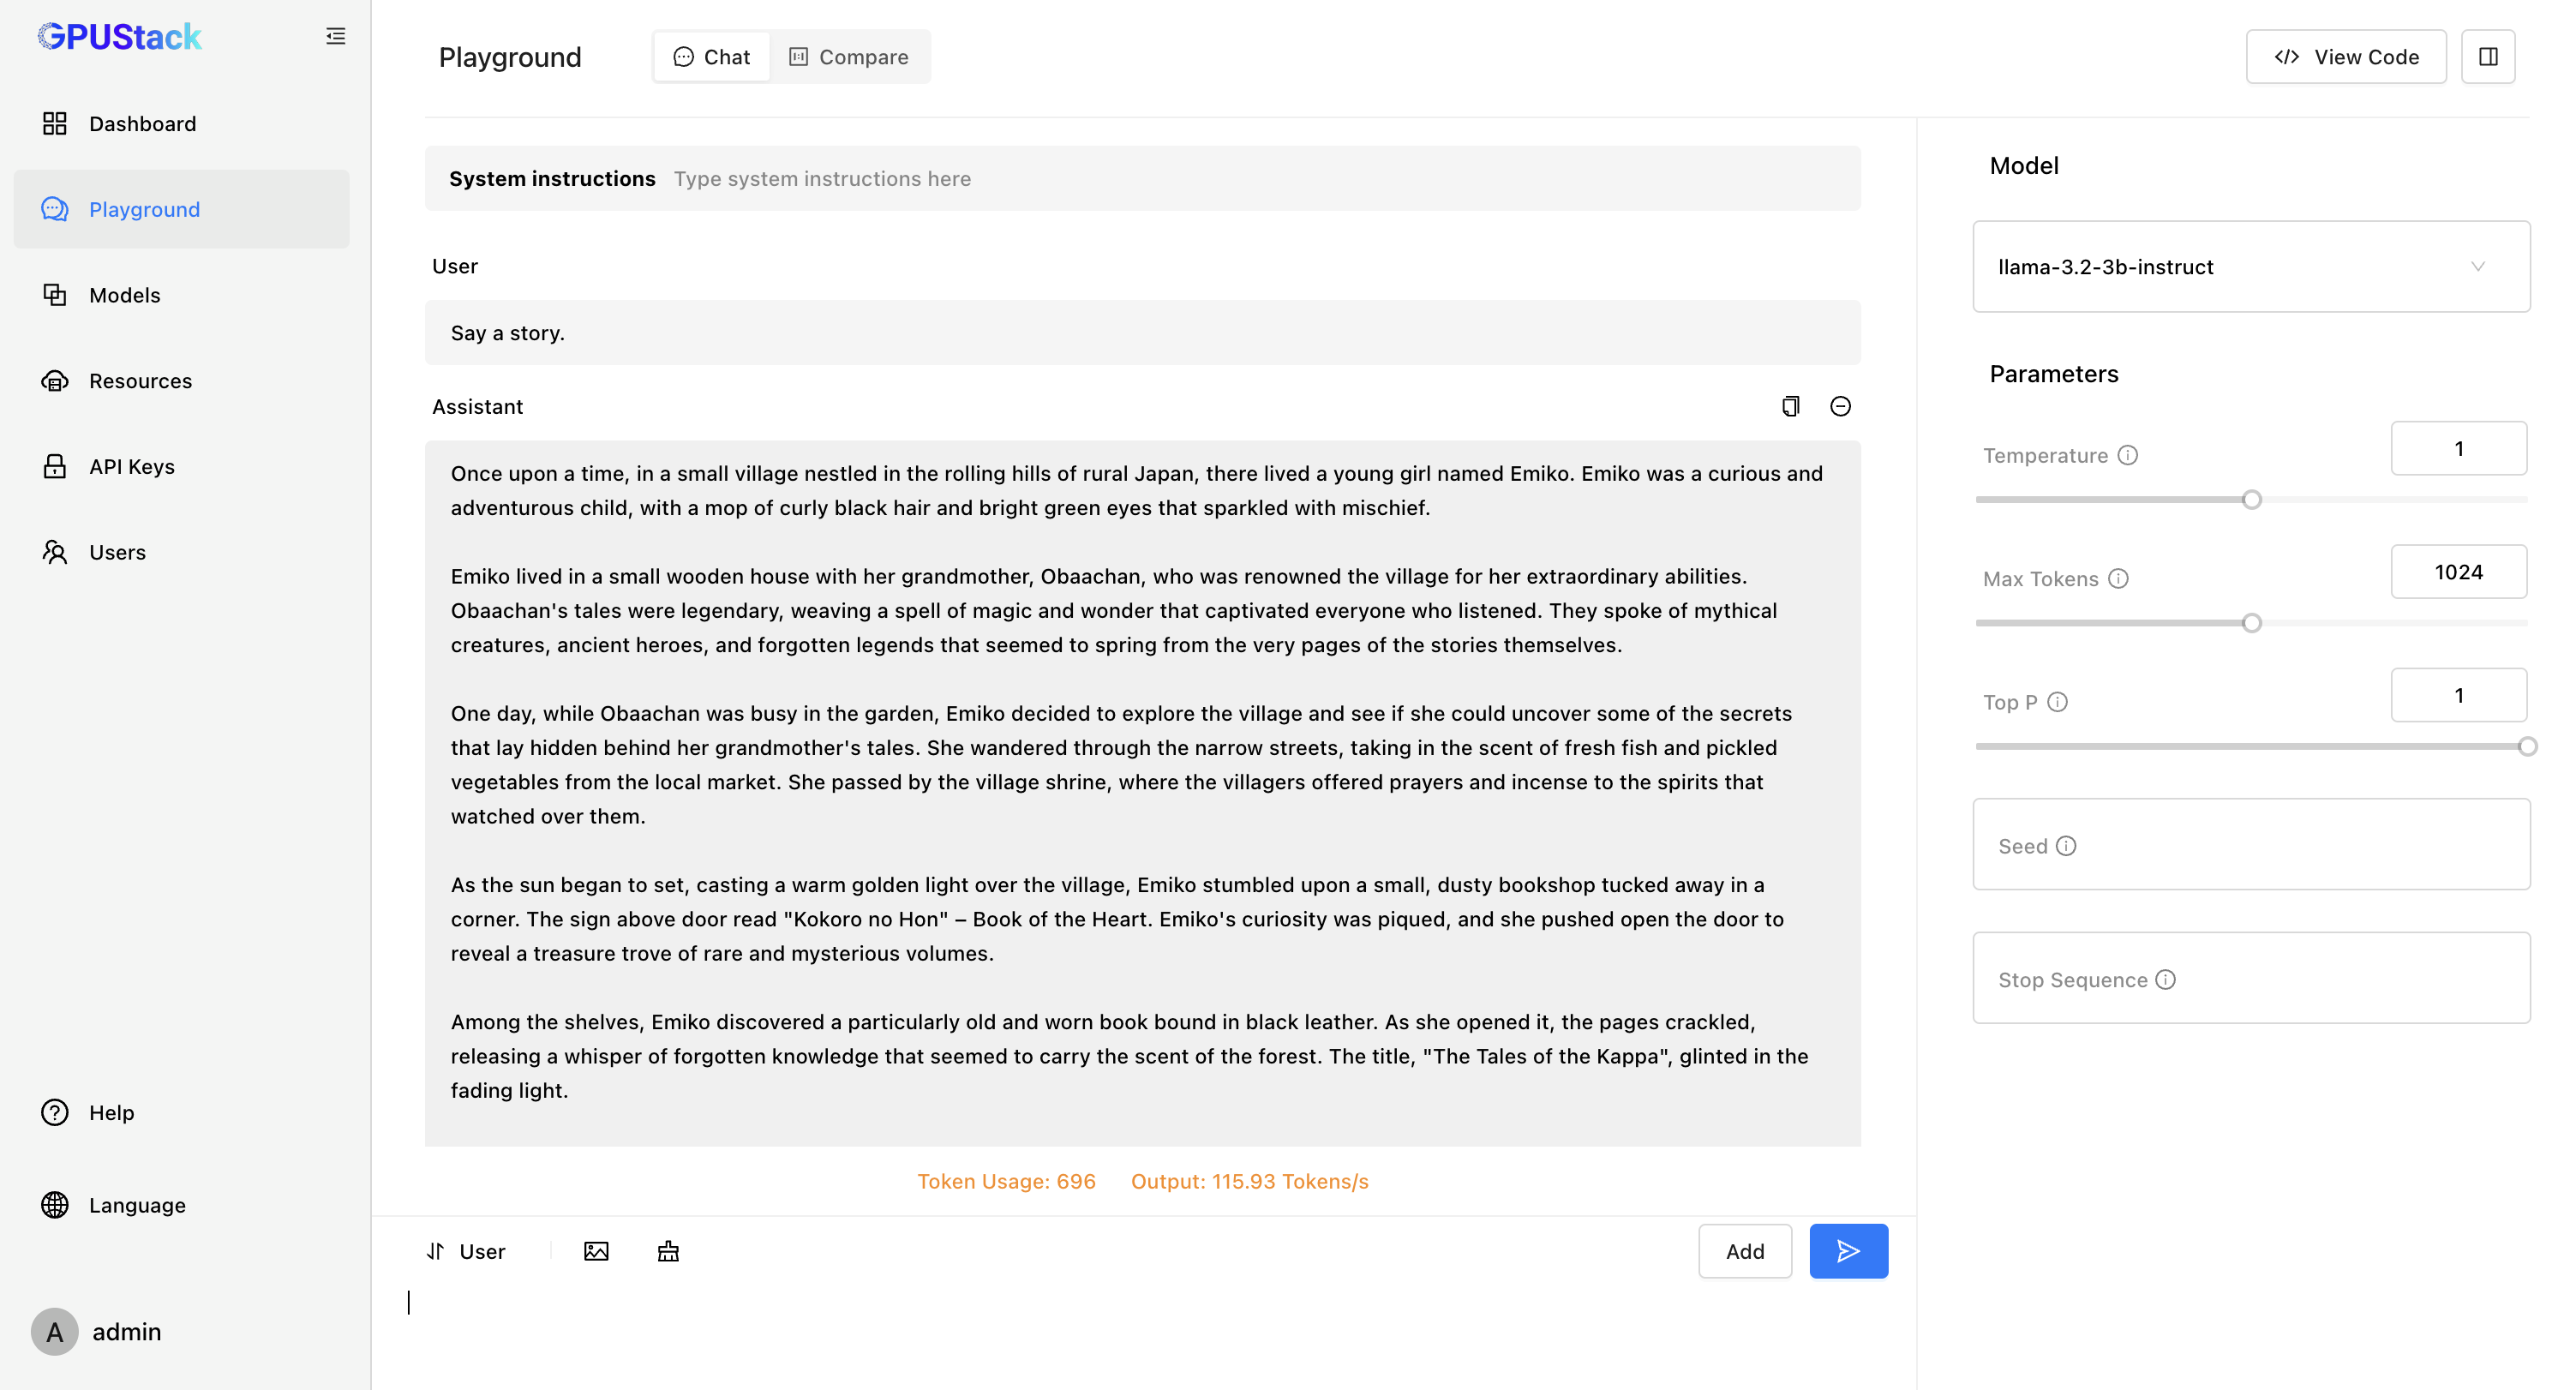
在 Playground 中调测模型:

image-20241118215644218

总结

以上为配置 NVIDIA 容器运行时环境并使用容器方式运行 GPUStack 的操作教程。

如果觉得写得不错,欢迎点赞、转发、关注。

H200部署DeepSeek-V4-Pro:MoE模型推理的系统级调优指南 大语言模型推理正从稠密架构迈向MoE稀疏化,而DeepSeek-V4-Pro作为1.6T参数量的典型MoE模型,其高效推理高度依赖专家并行(Expert Parallelism)与FP8 KV Cache等关键技术。原理上,MoE要求推理引擎原生支持专家切分与动态路由,避免跨卡通信瓶颈;FP8则通过压缩显存占用提升长上下文处理能力,但对数值稳定性极为敏感。技术价值在于显著降低百万级上下文的显存开销与延迟,支撑高并发生产服务。典型应用场景包括金融研报生成、长文档摘要及多轮复杂对话系统。本文聚焦H200硬件平台 阅读详情

相关推荐

保姆级教程:在Ubuntu 22.04上为Docker配置NVIDIA Container Runtime(含国内源加速)

本文提供了一份详细的Ubuntu 22.04系统下配置Docker与NVIDIA Container Runtime的教程,特别针对国内网络环境优化,包含驱动安装、Docker国内源配置、NVIDIA运行时环境设置及常见问题解决方案,助力开发者高效搭建GPU加速的AI开发环境。

weixin_26899659的博客 215

Docker安装GPUStack详细教程

添加 Docker 仓curl -fsSL https://mirrors.aliyun.com/docker-ce/linux/ubuntu/gpg | sudo gpg --dearmor -o /usr/share/keyrings/docker-archi库。# 2. 然后在容器内使用 gpustack 命令。# 添加 Docker 的 GPG 密钥。# 4. 查看 worker 状态。# 安装 containerd。# 1. 首先进入容器。# 3. 查看模型列表。# 重新启动 WSL。

m0_62458145的博客 5597

Qwen3.6-27B部署实战:vLLM与SGLang在GPUStack上的工程落地

大语言模型推理引擎是AI应用落地的核心基础设施,其选型直接决定服务吞吐、延迟稳定性与多模态支持能力。vLLM以张量并行和PagedAttention实现高吞吐文本生成,SGLang则凭借EAGLE推测解码与原生思考链支持,在工具调用与复杂推理场景中展现独特优势。二者均需适配CUDA运行时与GPU资源调度框架,而GPUStack作为统一控制面,提供了模型服务编排、Worker节点纳管与API网关集成的一站式能力。本文聚焦Qwen3.6-27B这一兼具工程友好性与强智能体能力的新型旗舰模型,在双卡RTX 409

A08110123的博客 399

Ubuntu下 NVIDIA Container Runtime 安装与使用

NVIDIA Container Runtime 是一种 GPU 感知容器运行时,与 Docker、CRI-O 和其他流行容器技术使用的 Open Containers Initiative (OCI) 规范兼容。它简化了构建容器化 GPU 加速应用程序并将其部署到桌面、云或数据中心的过程。

MAVER1CK的博客 1万+

Gemma 4本地多模态部署实战:GPUStack+SGLang全链路指南

多模态大模型正从云端服务走向本地化落地,其核心在于视觉-语言联合编码、工具调用协议兼容性与推理引擎的硬件协同优化。Gemma 4通过深度对齐的ViT+LLM架构、原生OpenAI tools schema支持及可插拔思考模式,显著降低多模态智能体工程门槛。在双卡RTX 4090等消费级GPU上,需结合GPUStack资源纳管、SGLang多模态流式推理与CUDA Graph显存优化,才能实现图像识别、结构化输出与工具链闭环的低延迟响应。本文聚焦真实产线场景——如设备铭牌OCR解析、离线产品图谱问答与医疗影像

alexhill2009的博客 379

GPUStack v2:面向生产的大模型推理基础设施平台

大模型推理服务不是简单启动一个vLLM或TGI进程,而是涉及GPU资源调度、模型生命周期管理、服务网格治理与多角色协同的系统工程。GPUStack v2 作为专为AI基础设施设计的声明式运行时平台,将Kubernetes式的编排能力深度适配GPU推理场景,提供InferenceBackend、Model等原生CRD抽象,实现模型加载、后端部署、流量治理、监控告警的一体化管控。其核心价值在于解决团队协作中的配置漂移、环境不一致与运维不可审计等落地痛点,支撑Qwen2-72B、DeepSeek、Phi-3等主流

weixin_30918633的博客 406

nvidia-container-runtime

除了 nvidia-container-runtime,Docker 也支持其他 GPU 运行时,例如 nvidia-docker(早期版本)或 nvidia-container-toolkit。nvidia-container-runtime 是 nvidia-docker2 的核心组件,它允许 Docker 容器直接访问和使用主机上的 NVIDIA GPU。nvidia-docker2 是 NVIDIA 提供的一个工具包,用于在 Docker 容器中实现对 NVIDIA GPU 的支持。

corey_li的博客 4414

centos 如何安装nvidia-container-runtime

centos安装docker相关gpu运行时

NLP与推荐算法 1500

The Book of Shaders 词条精解:GLSL reflect() 反射向量函数原理与实战

本篇技术指南围绕 The Book of Shaders 项目 [glossary/reflect/README-ua.md](https://link.gitcode.com/i/e233dbf99284705c4b0af80b36e44265) 词条展开,系统讲解 GLSL 内置几何函数 `reflect()` 的声明形式、数学公式 `I - 2.0 * dot(N, I) * N`、参数归一

gitblog_00425的博客 195

CMake安装grpc生成gRPCTargets.cmake文件

以下是安装语句: cd grpc_folder git submodule update --init cmake .. make -j 4 sudo make install 然而编写依赖gRPC的程序,发现无法调用gRPC的CMake文件,错误提示如下所示: include could not find load file: /usr/local/lib/cmake/g...

2328

KUKA机器人自动回原点程序

创建两个全局变量分别用于储存机器人的笛卡尔姿态与关节角姿态。打开System文件夹中的config文件创建全局变量的点位。在USER GROBALS用户自定义变量Userdefined variables下创建一个E6POS类型的点位,一个E6AXIS类型的点位。

A567852的博客 5210

GPUStack 使用 Kubernetes 集群添加 GPU 集群完整指南

本教程介绍如何在 GPUStack 中将一个自建 Kubernetes 集群(本教程以 k3s 为例)注册为 GPU 集群:从集群前置准备、创建集群、选择 GPU 厂商、执行环境检查,到应用 worker manifests 并等待 worker 就绪的完整流程。读完本文,你将掌握 GPUStack 注册 Kubernetes 集群的每一步操作、每个表单配置项的含义,以及其背后基于 Helm Ch

gitblog_00905的博客 149

ArduSub程序学习(1)——ardupilot框架整理

AP_HAL层(硬件抽象层)是我们制作 ArduPilot 的方式可移植到许多不同的平台。有一个顶级AP_HAL libraries/AP_HAL,用于定义代码其余部分的接口 有针对具体的板子特性,然后就有了AP_HAL_XXX 子目录,例如,AP_HAL_AVR 用于基于 AVR 的 开发板,AP_HAL_PX4用于 Pixhawk 开发板和 AP_HAL_Linux 基于 Linux 开发板。工具目录tools directories工具目录是杂项支持目录。

weixin_49839886的博客 2812

KOReader PDF 重排与离线查词安装配置指南

KOReader 是一款面向电子墨水屏设备的开源阅读器,核心解决三个问题:扫描版 PDF 重排、离线查词、跨设备同步阅读进度。它运行在 Kindle、Kobo、PocketBook、Cervantes、reMarkable 等墨水屏设备上,也支持 Android 与 Linux。读完这篇指南,你能在自己设备上装好 KOReader,并跑通 PDF 重排与查词两个最高频流程。 ## 📋 定位速览

gitblog_00506的博客 786

超声波雷达探测车位及信号处理方法

在APA泊车中用到了超声波雷达,第一次接触,总结研究之。

周陽讀書 1229

CUDA&PCL 点云体素下采样

CUDA&PCL 点云体素下采样

dayuhaitang1的博客 1268

YiShaAdmin 快速上手指南:首次启动 5 个高频问题的完整避坑方案

YiShaAdmin 是一套基于 .NET Core MVC 的权限管理系统,内置员工管理、部门职位、角色菜单权限、定时任务和代码生成等模块,适合拿来当网站后台、CRM、OA 的起点。本文只解决一类问题:第一次把 YiShaAdmin 跑起来时,启动报错、数据库连不上、登录失败、菜单为空、任务不执行,这 5 类最堵人的坎。适合刚克隆仓库、还没摸熟配置的新手;老用户可以直接拿症状速查表当排障索引。

gitblog_00152的博客 212

[ vulhub漏洞复现篇 ] ActiveMQ反序列化漏洞复现(CVE-2015-5254)

Apache ActiveMQ是美国阿帕奇(Apache)软件基金会所研发的一套开源的消息中间件,它支持Java消息服务、集群、Spring Framework等。由于ActiveMQ是一个纯Java程序,因此只需要操作系统支持Java虚拟机,ActiveMQ便可执行。Apache ActiveMQ 5.13.0之前5.x版本中存在安全漏洞,该漏洞源于程序没有限制可在代理中序列化的类。......

qq_51577576的博客 4444

REFramework 怪物猎人荒野 Mod 框架:从 dinput8.dll 到 Lua 脚本的完整上手指南

REFramework 是一个面向 RE Engine 游戏的 Mod 加载框架与 Lua 脚本平台,一个文件就能给《怪物猎人:荒野》加 VR、FOV 调节、自由相机和自定义脚本。本文带你完成从下载、放置、激活到写出第一个 Lua 脚本的全过程,并解释它为什么在十几款游戏里通用。 ## 准备工作:下载什么、放哪、要装什么依赖 | 项目 | 内容 | | --- | --- | | 下载物 |

gitblog_00230的博客 291

YOLO创新点改进点的消融实验设计规范

YOLO改进的消融实验是一种重要的方法,用于评估和验证模型中不同组件的影响。在进行YOLO改进的消融实验时,我们可以选择一些可能的改进点,比如Backbone网络、Anchor框设计和损失函数设计,然后通过实验来分析它们对模型性能的影响。首先,我们需要确定实验设计。对于每个改进点,我们将设计多个实验组,并针对每个实验组训练模型并进行性能评估。这里以三个改进点为例进行说明:改进点1:Backbone网络 (改进点2:Anchor框设计 (改进点3:损失函数设计 (

crasher123的博客 2909

人工智能训练师三级·模型生命周期真题40题|训练→评估→调优全链路通关

本文为人工智能训练师三级考试真题解析系列第2篇,聚焦模型生命周期全链路(训练→评估→调优)。内容包含40道精选真题,覆盖数据划分、模型训练、评估指标、超参数调优4个核心阶段。重点考察:1)数据集的合理划分方法(留出法、交叉验证);2)模型训练的基本原理;3)关键评估指标(准确率、召回率、F1等)的应用场景;4)超参数调优技术(网格搜索、随机搜索等)。通过真题解析帮助考生系统掌握模型生命周期的闭环迭代方法论,提升从数据准备到模型优化的全流程实践能力。适合备考人工智能训练师三级认证的考生学习参考。

白话机器学习 89

darktable 入门指南:从安装到导出第一张 JPEG 的 RAW 处理全流程

darktable 是一款免费开源的 RAW 照片处理器:它不改动你的 RAW 原文件,所有调色以参数记录,随调随看、随导随出。Linux、macOS、Windows 三平台都有官方安装包,装完半小时就能出第一张图。 ## 30 秒跑通——从双击安装到导出第一张 JPEG 🚀 1. 下载对应平台的安装包:Linux 选 AppImage(或发行版软件包 / Flatpak),macOS(Ap

gitblog_00528的博客 315

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

MineContext 智能上下文管理指南:从本地部署到实际用法

文件、文档、聊天记录、任务散落各处,上下文靠人工整理,重要信息总错过?MineContext 是一款开源的智能上下文管理工具:它把你电脑上的工作自动整理成上下文,主动推送提醒与总结,适合知识工作者和项目团队。 ## 从三个痛点认识 MineContext:为什么需要智能上下文管理 如果你经常处理大量信息,大概率熟悉这三种情况: - **信息散**:需求在文档里、进度在聊天里、任务在脑子里,没

gitblog_00071的博客 576

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

GPUStack v2.1.0:轻量级GPU资源管理与任务调度平台部署指南

在人工智能与深度学习领域,GPU资源的高效管理和调度是提升团队研发效率的关键。容器化技术通过环境隔离和资源控制,为计算任务提供了可复现、可移植的运行环境。其核心原理在于利用操作系统层面的虚拟化,将应用及其依赖打包成标准单元,实现资源隔离与高效利用。这一技术价值在于显著简化了从开发到部署的流程,降低了环境配置的复杂性。在模型训练、推理服务等应用场景中,容器化能确保不同任务互不干扰,并实现计算资源的弹性分配。本文聚焦于GPUStack这一轻量级平台,它专为中小规模GPU集群设计,通过中心化管理节点和计算节点的简

weixin_30709061的博客 441

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Karabiner-Elements 与 Tmux 前缀模式 Shift 组合键失效:三步完整修复指南

Karabiner-Elements 和 Tmux 同时使用时,你会遇到一个典型故障:`Ctrl+b` 进入前缀模式后,`Shift+%` 或 `Shift+"` 的分屏操作毫无反应。卡点往往不在分屏命令本身,而在两套工具的按键处理互相冲突。从诊断、修复到验证,完整路线如下。 ## 🔍 现象自查:Tmux 前缀模式下哪些操作会失灵 这一步解决"我是不是和它有同一个问题"。 典型复现路径:终

gitblog_00496的博客 397
上一篇: RAG三件套运行的新选择 - GPUStack
下一篇: GPUStack v0.4:文生图模型、语音模型、推理引擎版本管理、离线支持和部署本地模型
GPUStack
博客等级 码龄2年 150粉丝 65原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值