探索大语言模型(LLM):提升 RAG 性能的全方位优化策略

RAG中的Rerank技术:原理、实现与优化策略 阅读详情

提升 RAG 性能的全方位优化策略:从理论到实践

在大语言模型(LLM)应用日益普及的今天,检索增强生成(RAG)技术已成为连接外部知识与模型推理的核心桥梁。然而,基础版 RAG 系统往往难以满足复杂业务场景的需求,如何提升其准确性、效率和鲁棒性成为开发者关注的焦点。本文将基于 Milvus 官方技术文档,深入解析 RAG 流水线的优化策略,涵盖查询增强、索引优化、检索器升级、生成器调优及全流程增强等多个维度,助力开发者打造高性能 RAG 应用。

一、RAG 基础:从标准流水线说起

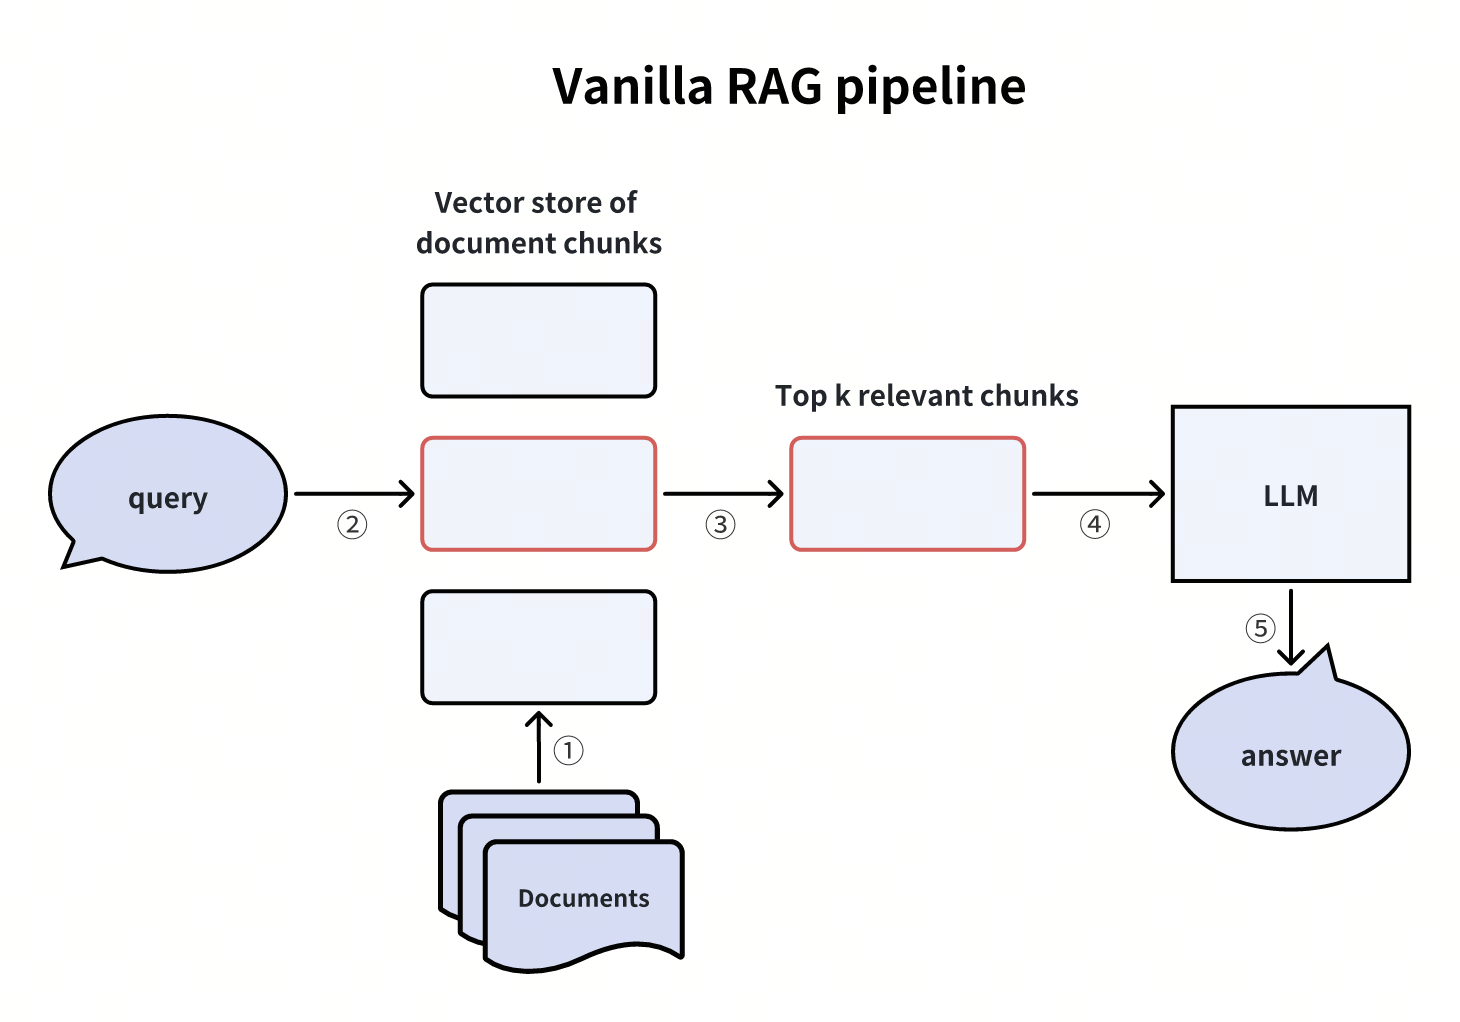
在探讨优化策略前,我们先回顾标准 RAG 流水线的核心流程:

  • 检索:根据用户的查询内容,从知识库中获取相关信息,通过相似性搜索找出最匹配的数据。
  • 增强:将用户的查询内容和检索到的相关知识一起嵌入到一个预设的提示词模板中。
  • 生成:将经过检索增强的提示词内容输入到大语言模型中,以生成所需的输出。

这些步骤共同构成了RAG的工作流程,旨在提高生成模型的准确性和可靠性。
在这里插入图片描述

尽管基础流程简单,但实际应用中需应对跨域检索不对称、复杂查询处理困难等问题。以下将从五个维度展开优化方案。

二、查询增强:让问题 “问对方向”

查询是 RAG 的起点,优化查询表达能直接提升检索精度。主流方法包括:

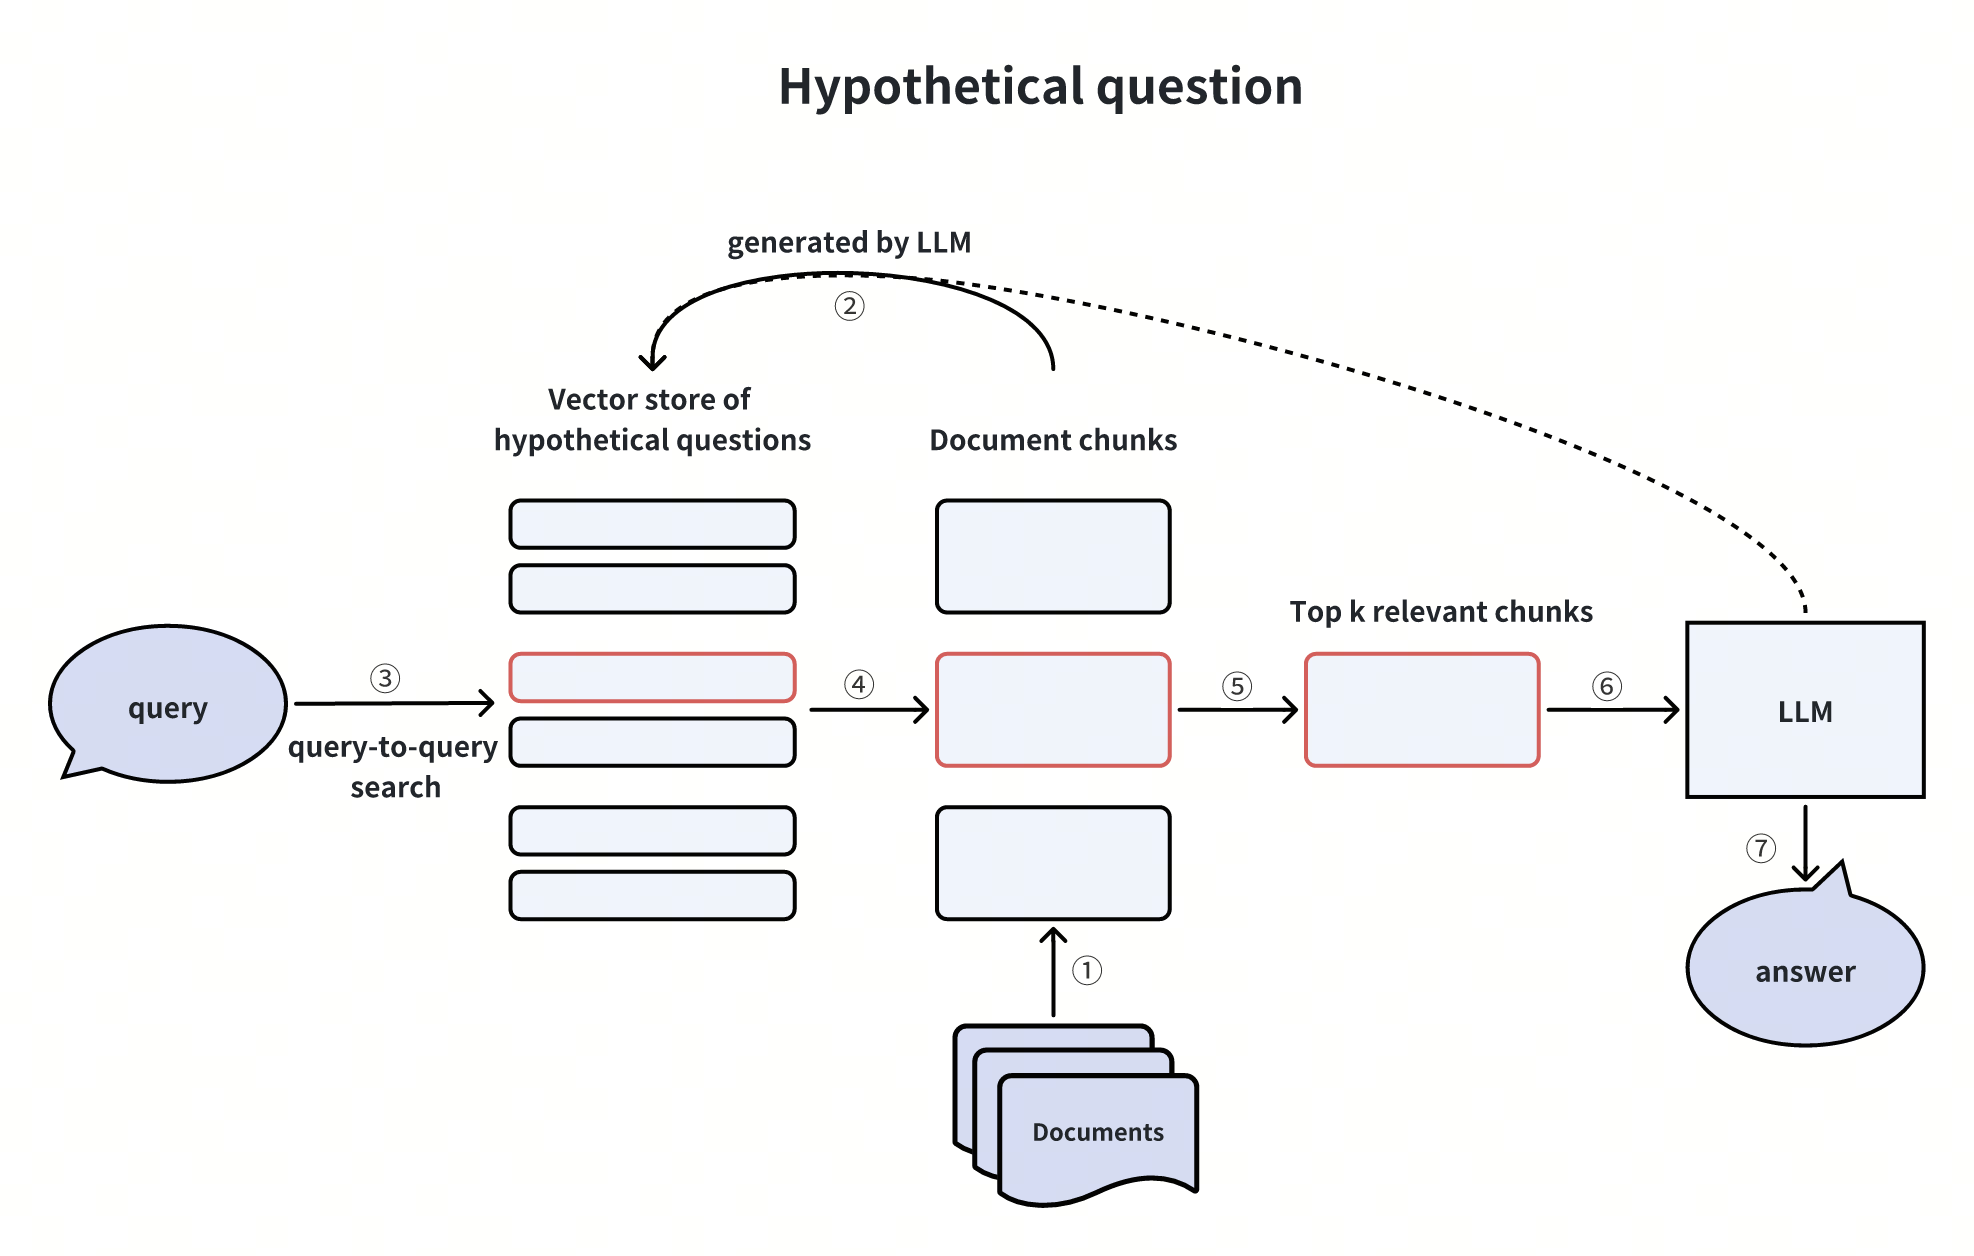
1. 生成假设性问题(Hypothetical Questions)

通过 LLM 为每个文档 chunk 生成可能的用户问题,将这些问题存入向量库。用户查询时,先检索最相关的假设性问题,再关联其对应的文档 chunk。

优势:通过 “查询 - 查询” 匹配规避跨域向量检索偏差;

局限:增加了预生成问题的计算开销。
在这里插入图片描述

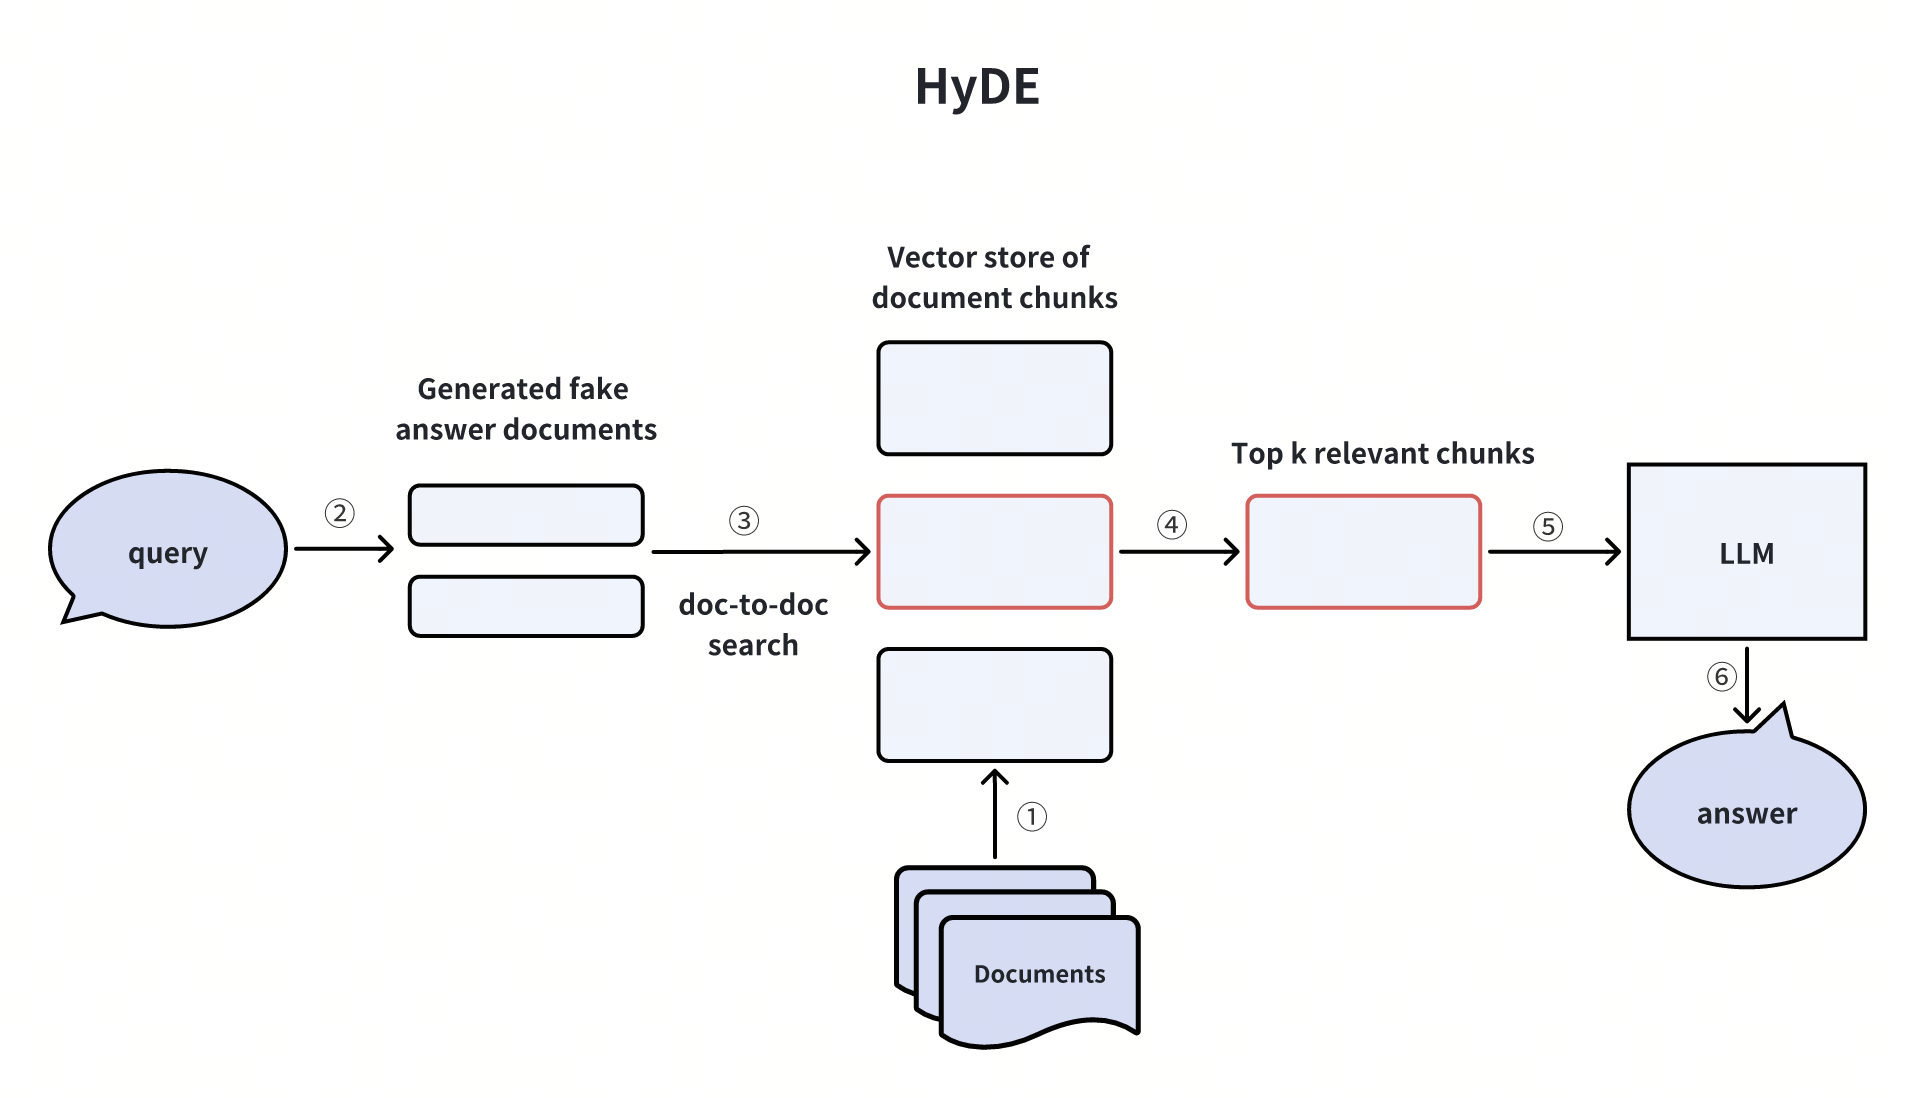
2. 假设性文档嵌入(HyDE)

用 LLM 为用户查询生成 “假文档”(模拟理想答案),将假文档的向量嵌入用于检索真实文档 chunk。

适用场景:用户查询模糊或领域术语复杂时,通过假文档校准检索方向。
在这里插入图片描述

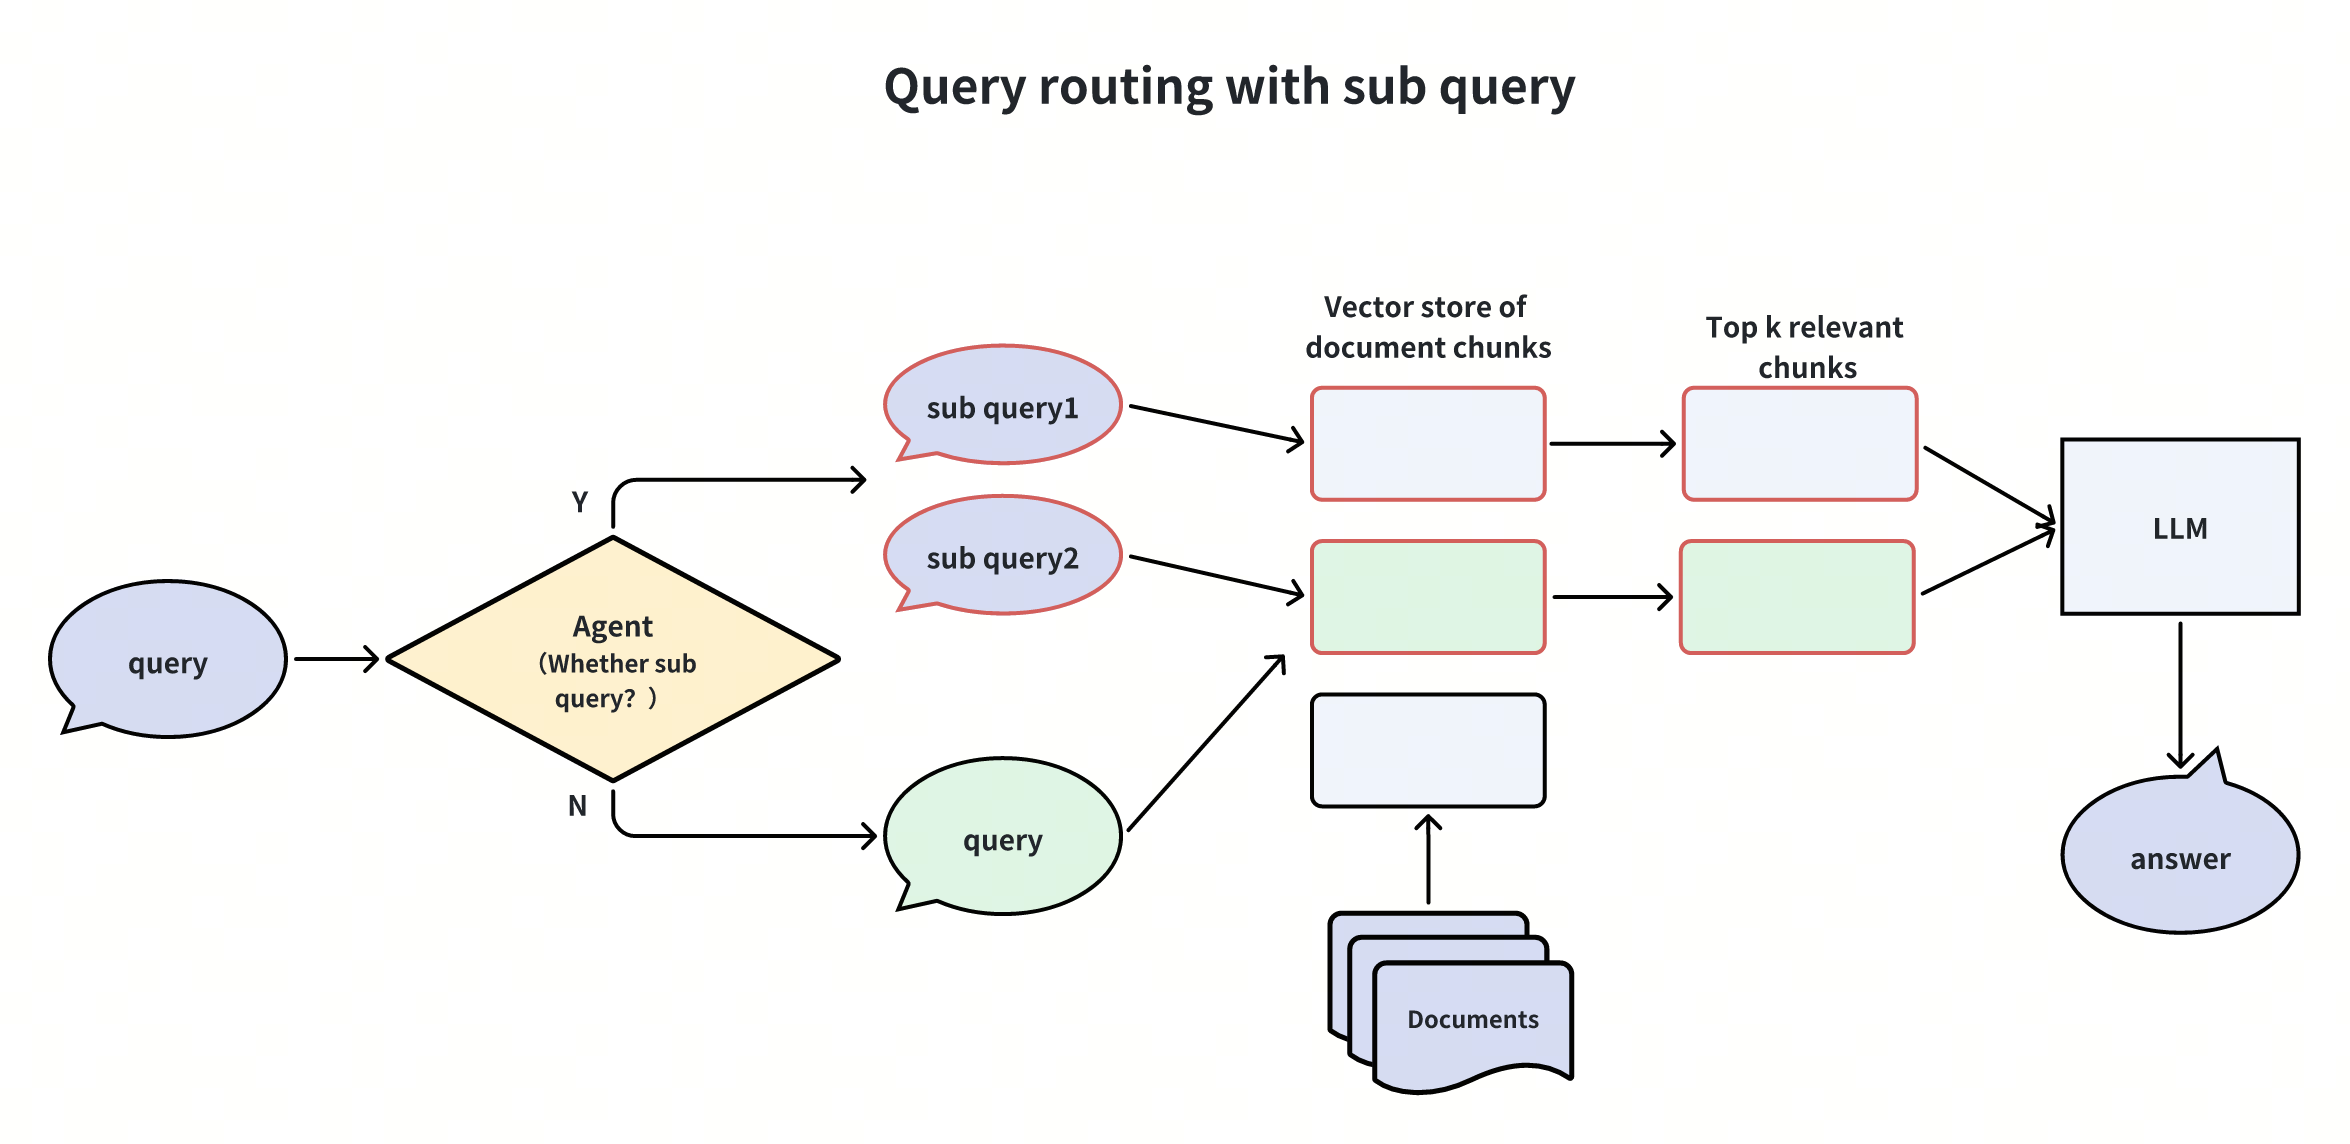
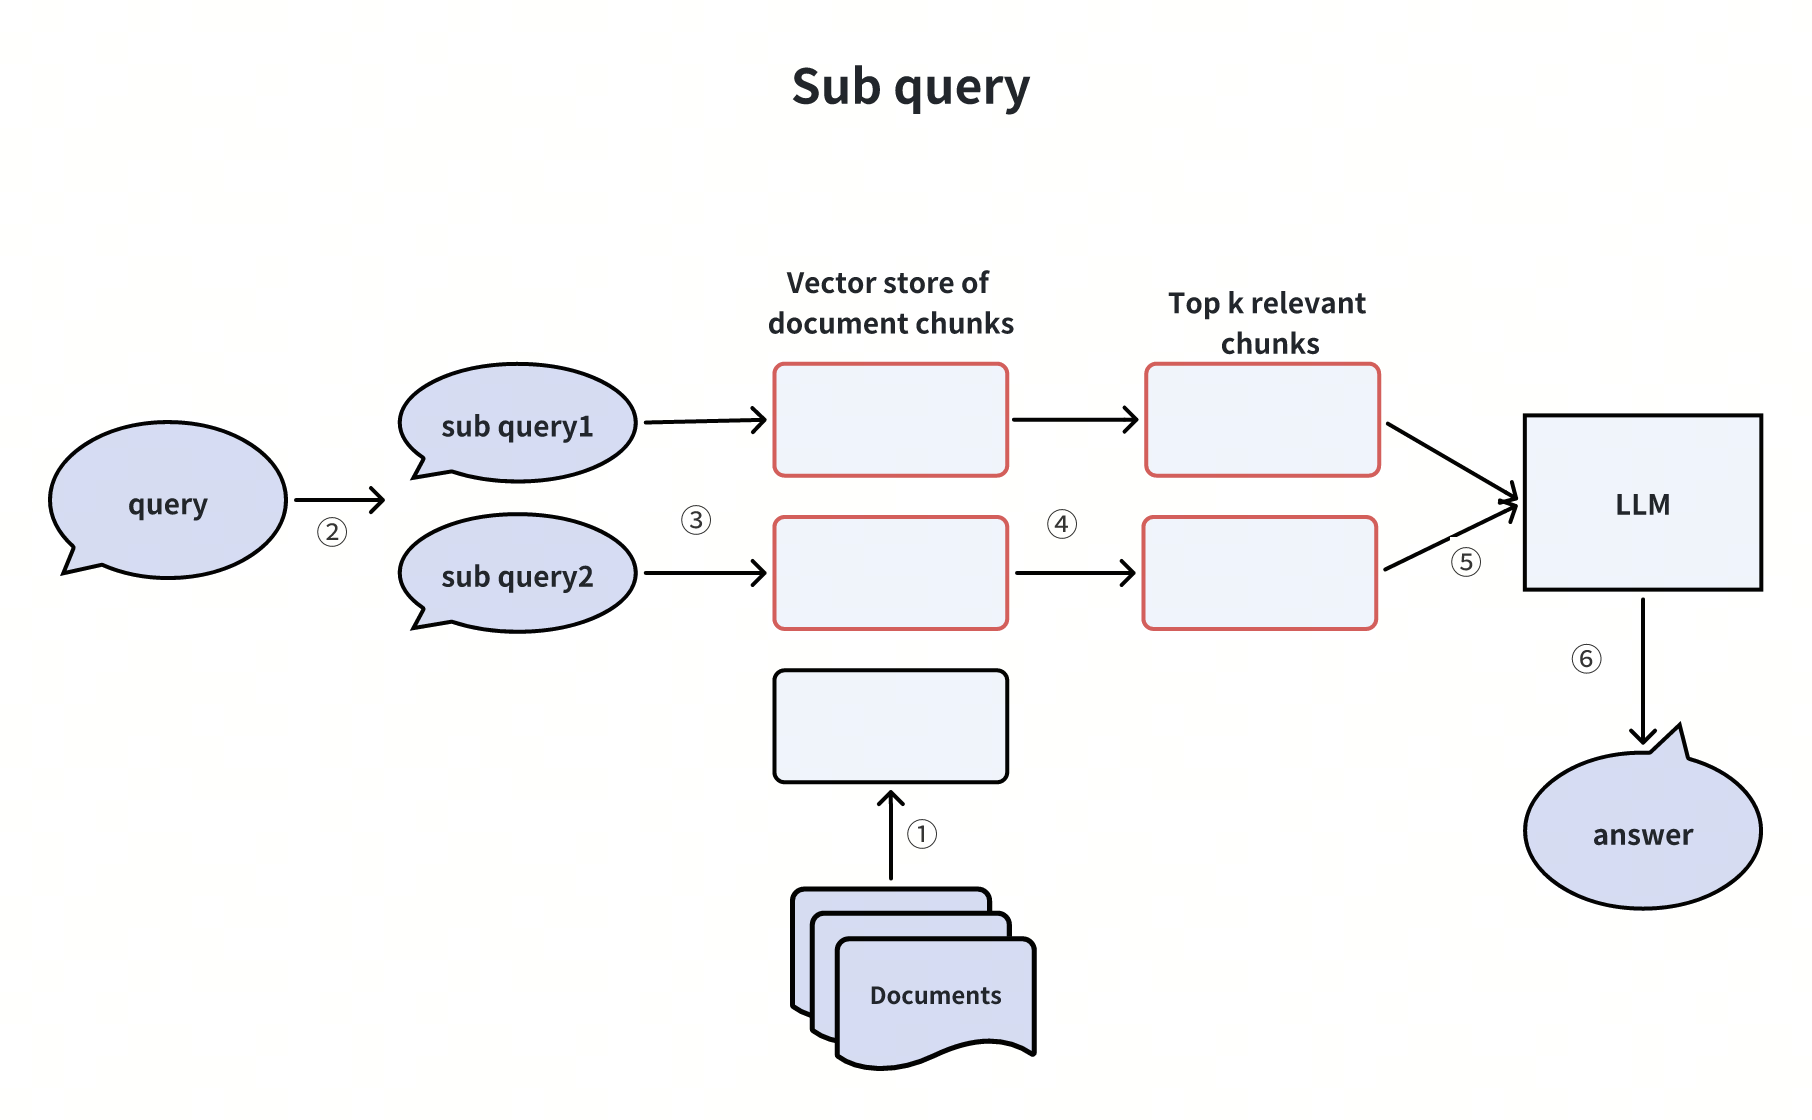
3. 子查询拆分(Sub-Queries)

将复杂问题拆解为简单子问题,分别检索后汇总结果。例如,“Milvus 与 Zilliz Cloud 的功能差异” 可拆分为两个子查询:

  • “Milvus 的核心功能是什么?”

  • “Zilliz Cloud 的核心功能是什么?”

    优势:降低复杂查询的检索难度,提升信息覆盖率。
    在这里插入图片描述

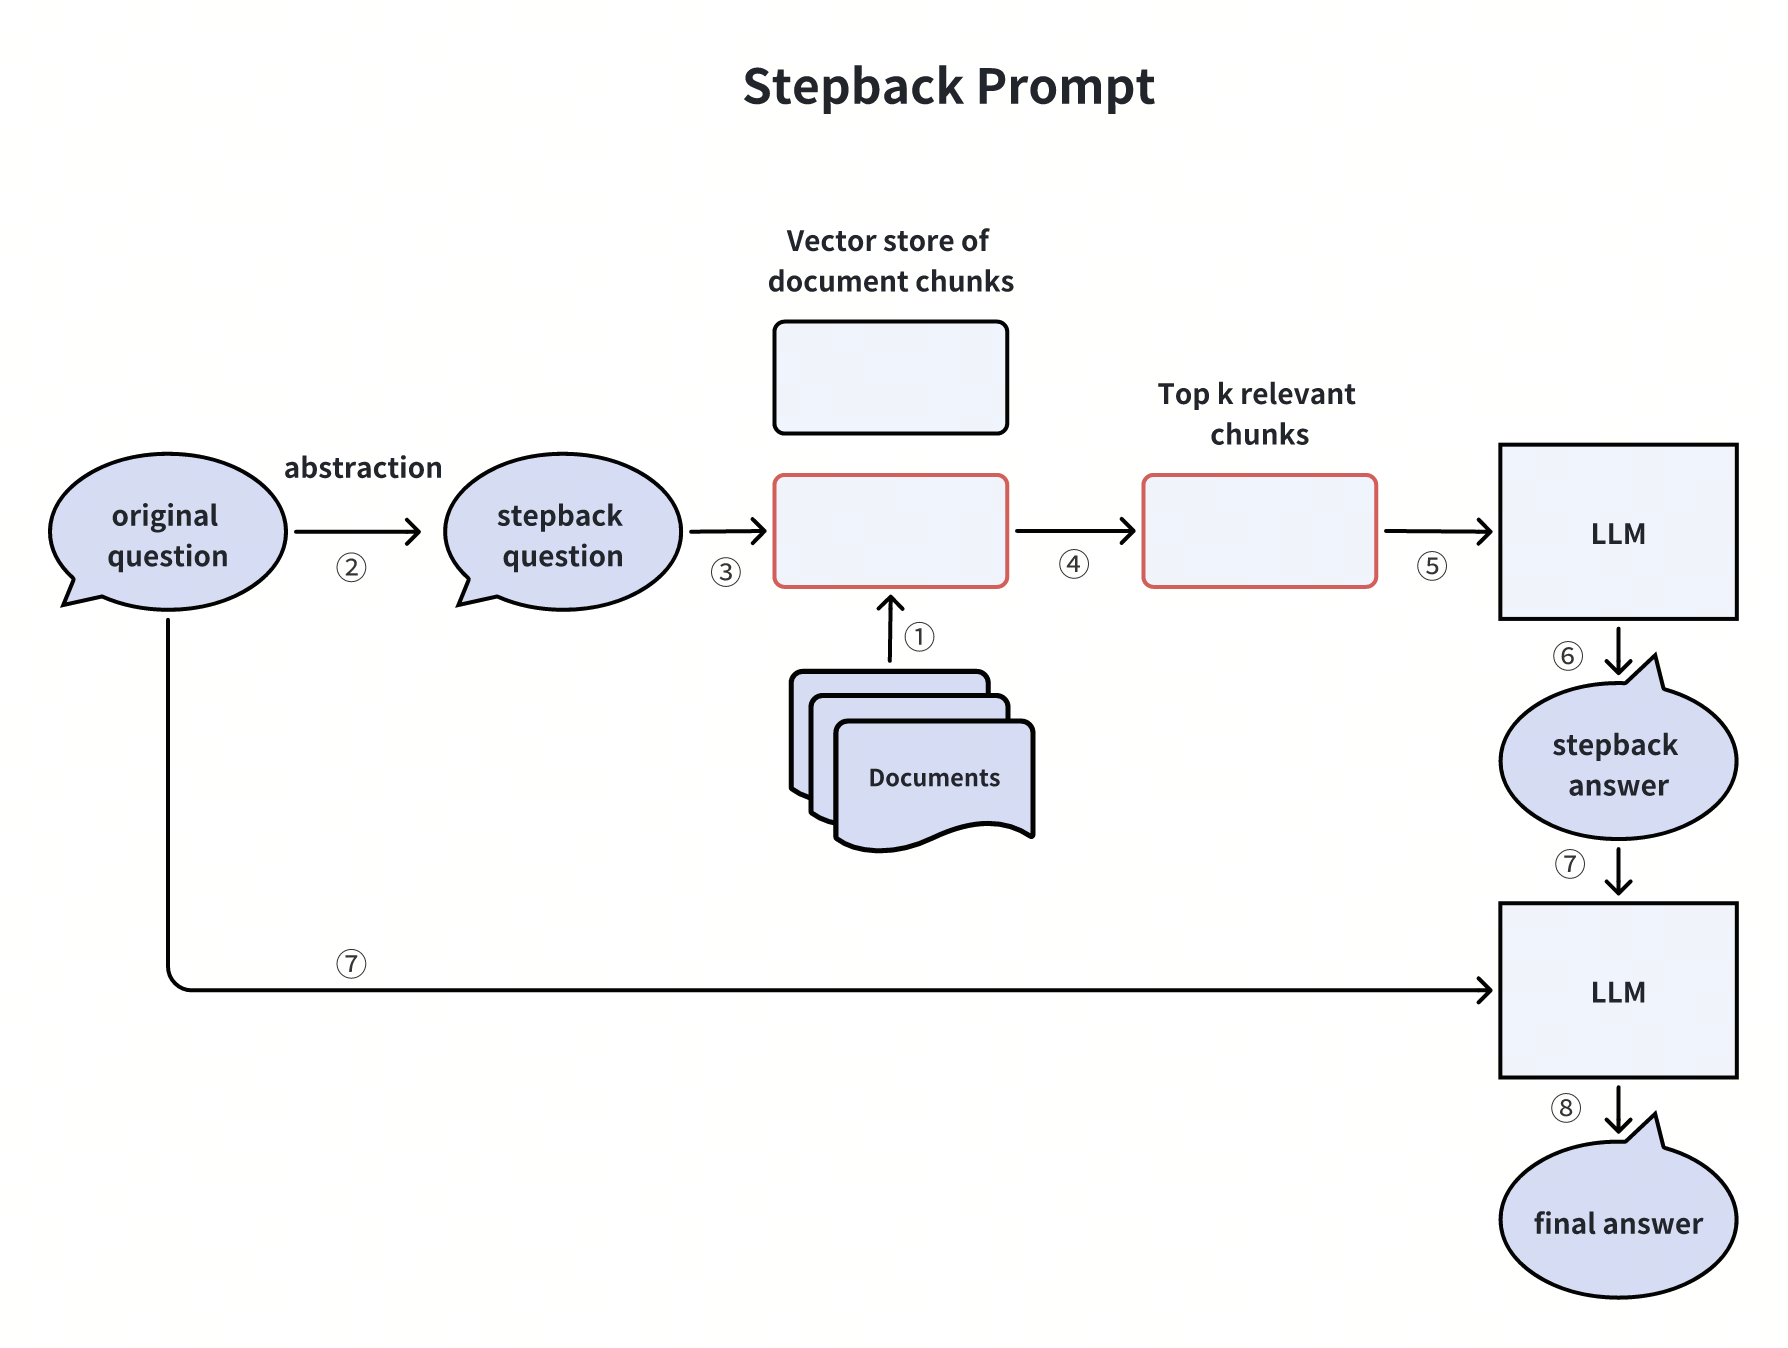
4. 回溯提示(Stepback Prompts)

将具体问题抽象为更通用的 “回溯问题”。例如,“100 亿条记录能否存入 Milvus?” 可抽象为 “Milvus 支持的数据集规模上限是多少?”

价值:通过高层问题定位核心知识,避免因细节束缚检索范围。
在这里插入图片描述

三、索引增强:构建更高效的检索基础

索引是检索的基石,优化索引结构可显著提升检索效率与准确性。

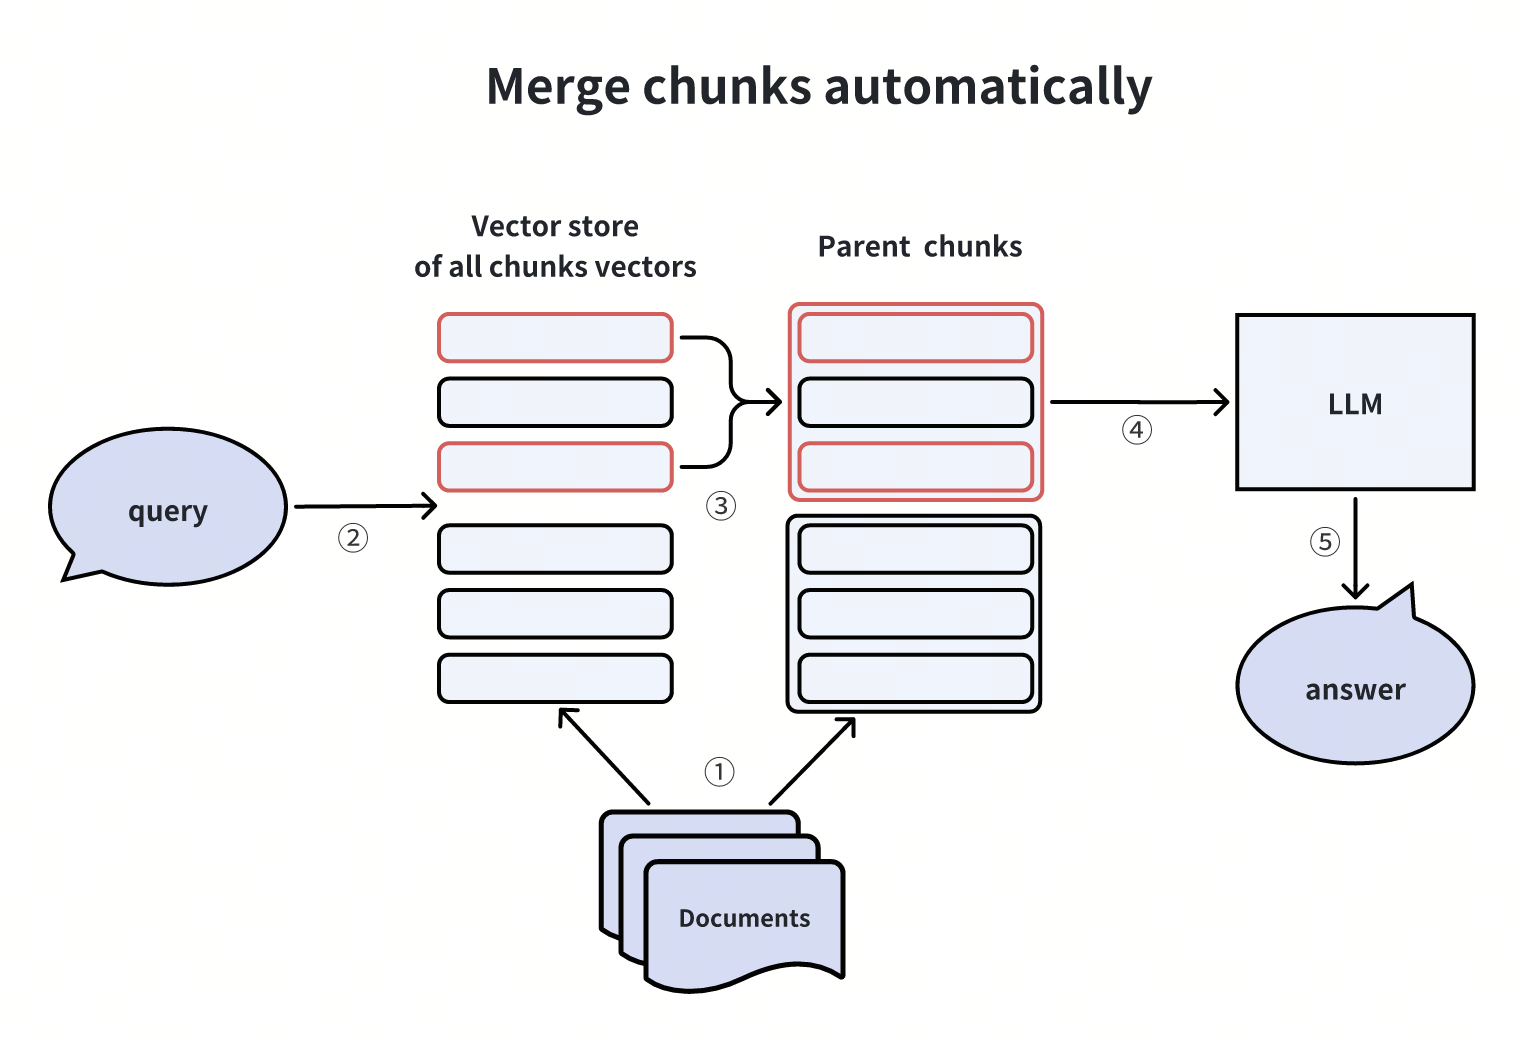
1. 自动合并文档 Chunk

采用 “子 chunk + 父 chunk” 两级粒度:先检索细粒度子 chunk,若前 k 个子 chunk 中有 n 个来自同一父 chunk,则将父 chunk 作为上下文输入 LLM。

实现参考:LlamaIndex 已集成该功能,适用于需要上下文连贯性的场景。
在这里插入图片描述

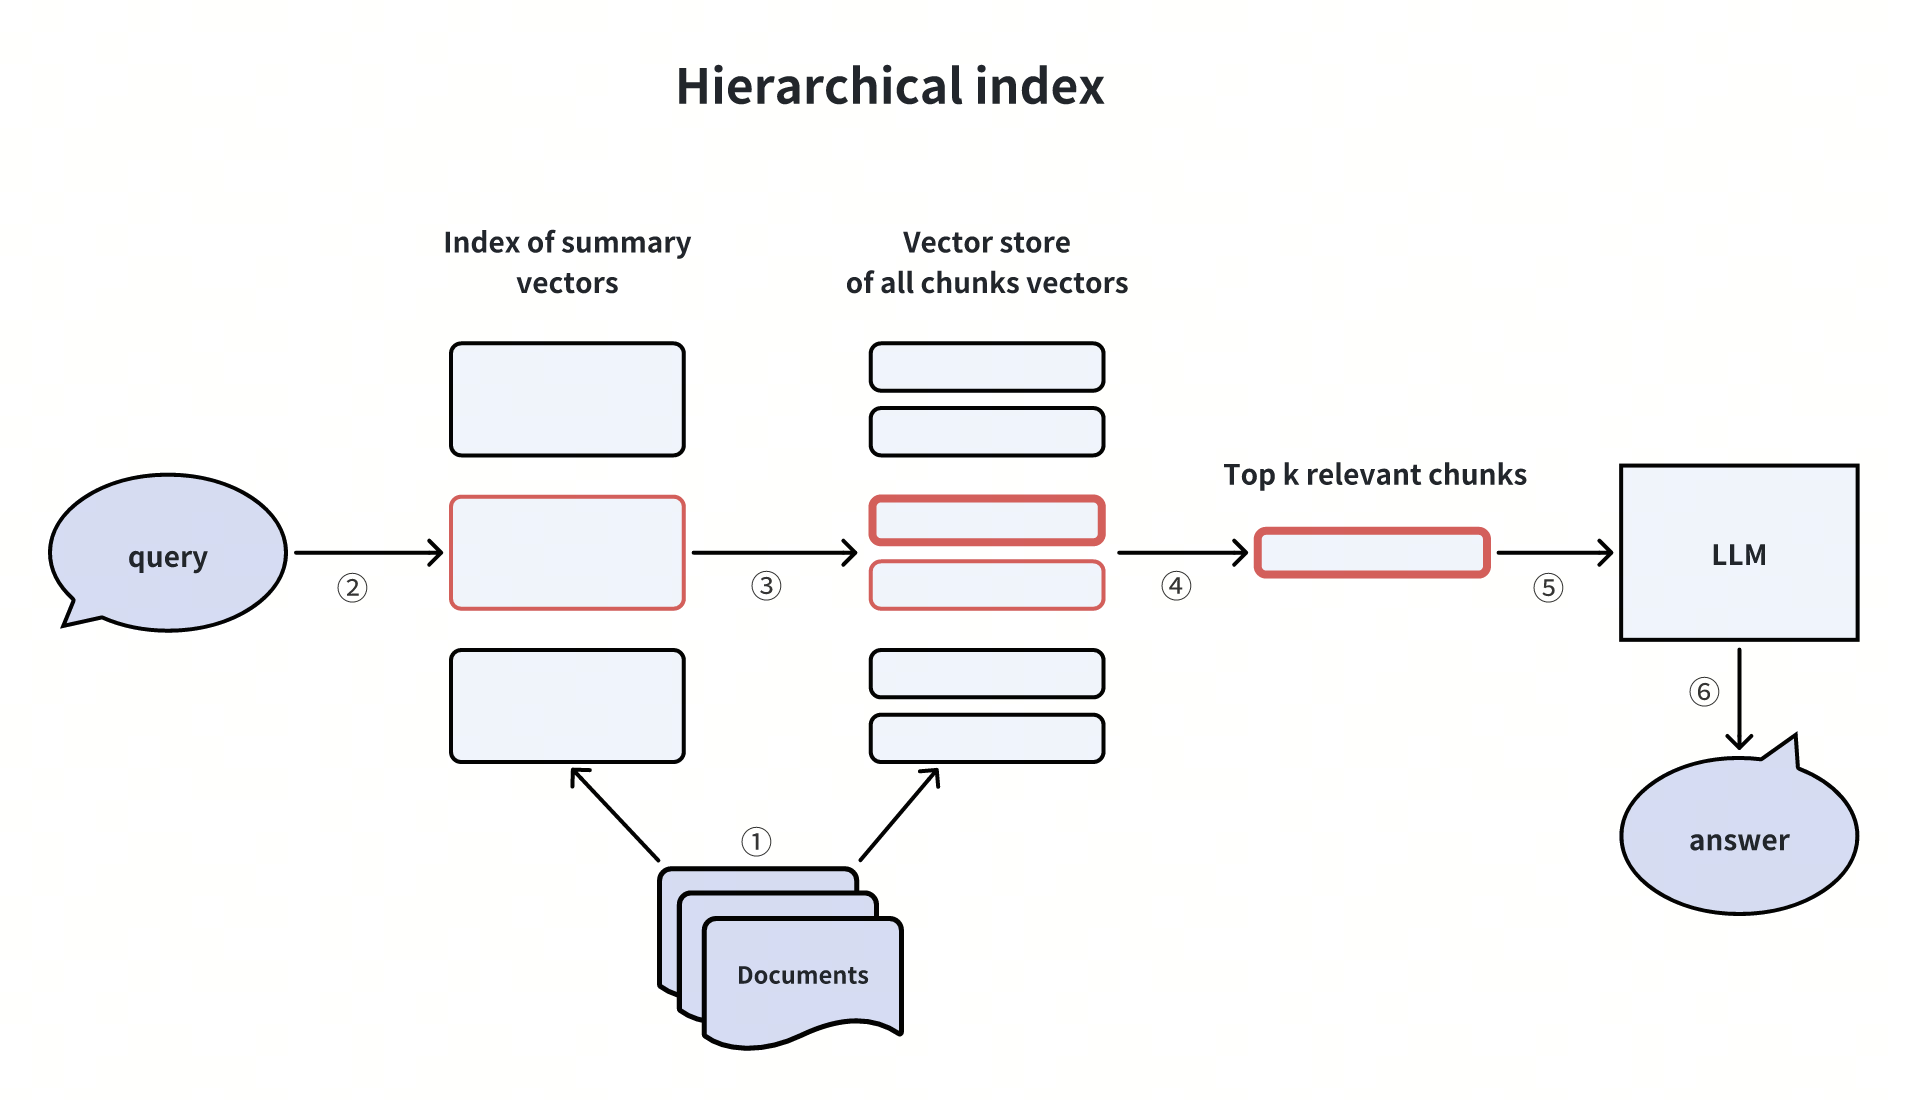
2. 分层索引(Hierarchical Indices)

构建 “文档摘要索引 + 文档 chunk 索引” 两级结构:

  1. 先通过摘要筛选相关文档;

  2. 仅在筛选出的文档内检索具体 chunk。

    适用场景:海量数据或层级化内容(如图书馆馆藏)的检索。
    在这里插入图片描述

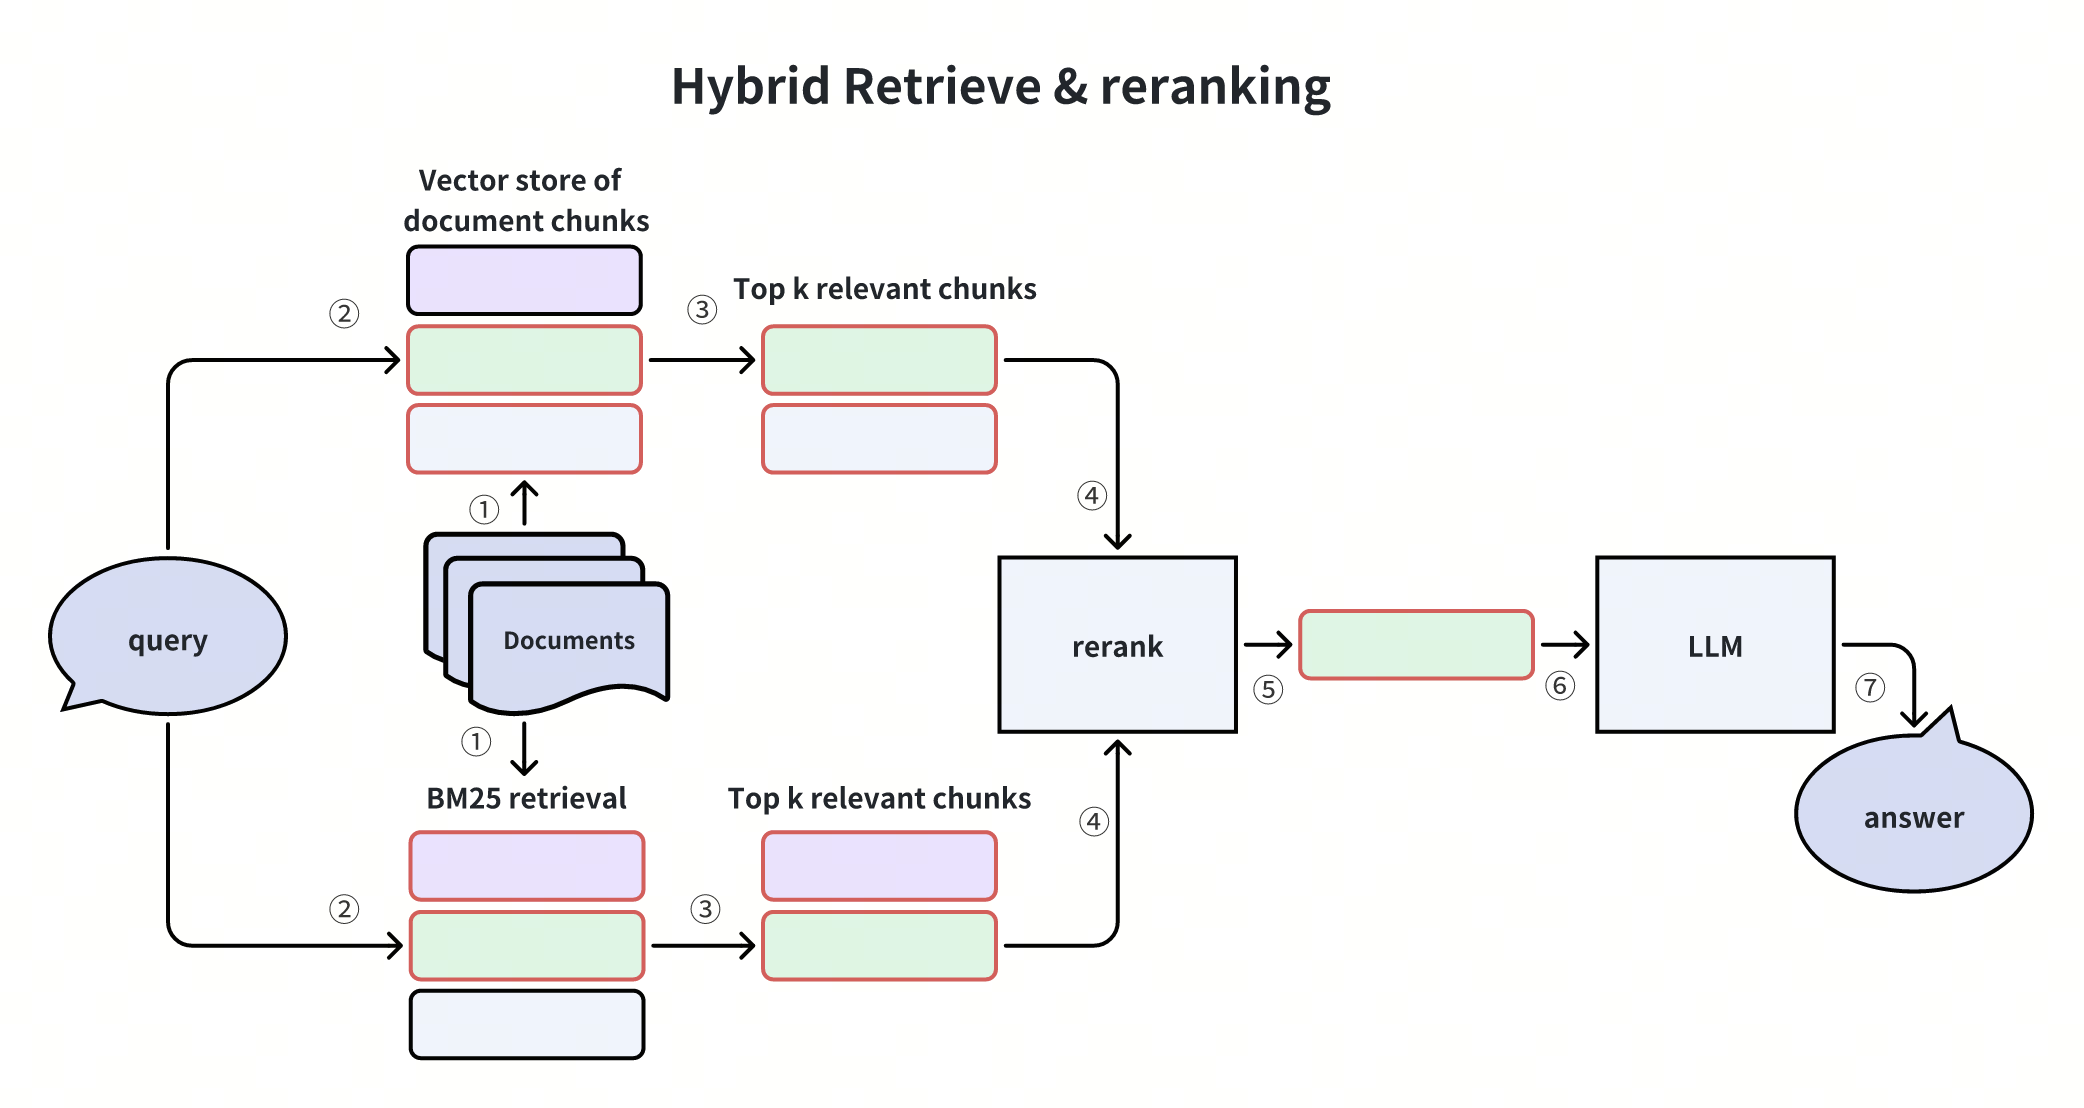
3. 混合检索与重排序(Hybrid Retrieval & Reranking)

结合向量检索(如 Milvus 的向量相似度搜索)与其他检索方法(如 BM25 词频统计、Splade 稀疏嵌入),再通过重排序模型(如 Cross-Encoder)优化结果顺序。

优势:弥补单一检索方法的盲区,提升召回率。
在这里插入图片描述

四、检索器增强:精准定位关键信息

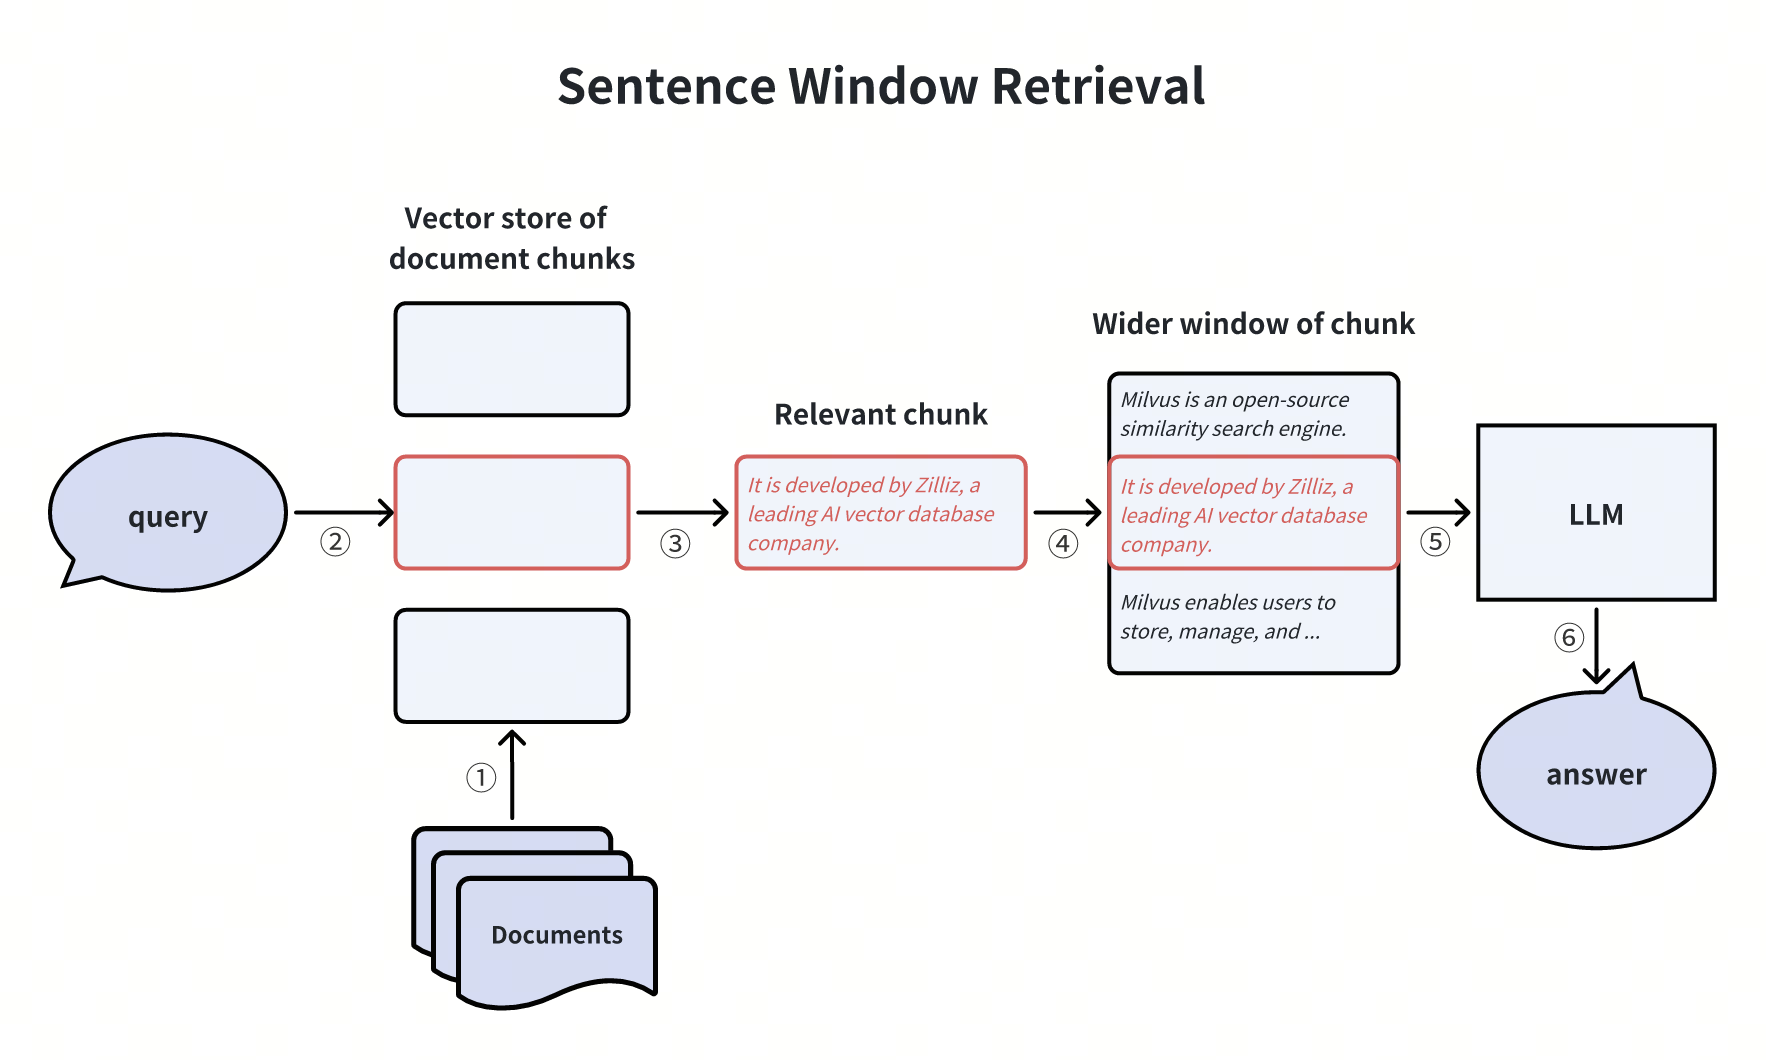
1. 句子窗口检索(Sentence Window Retrieval)

将检索到的句子 chunk 扩展为更大的上下文窗口(如包含前后段落),减少信息丢失。需注意平衡窗口大小与噪声引入的问题。
在这里插入图片描述

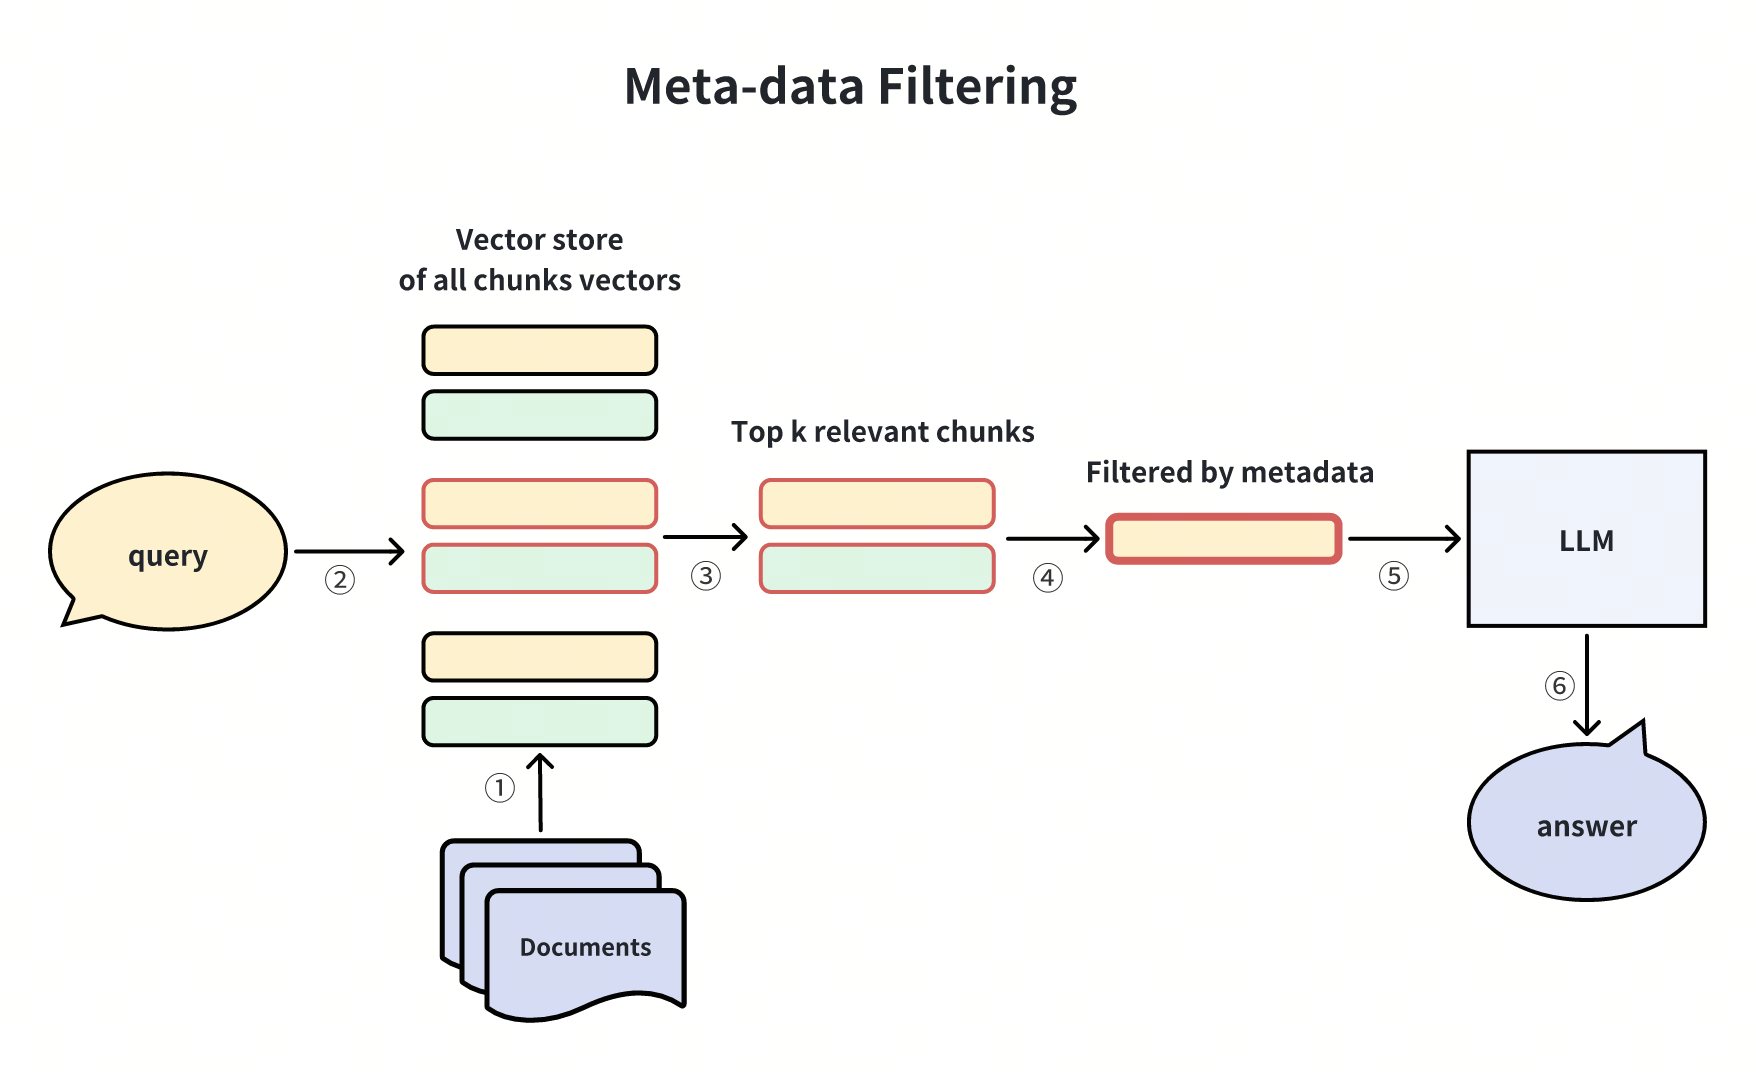
2. 元数据过滤(Meta-data Filtering)

基于时间、类别等元数据筛选检索结果。例如,在金融报告检索中,通过 “年份 = 2024” 过滤过时信息,提升相关性。
在这里插入图片描述

五、生成器增强:让答案更可靠

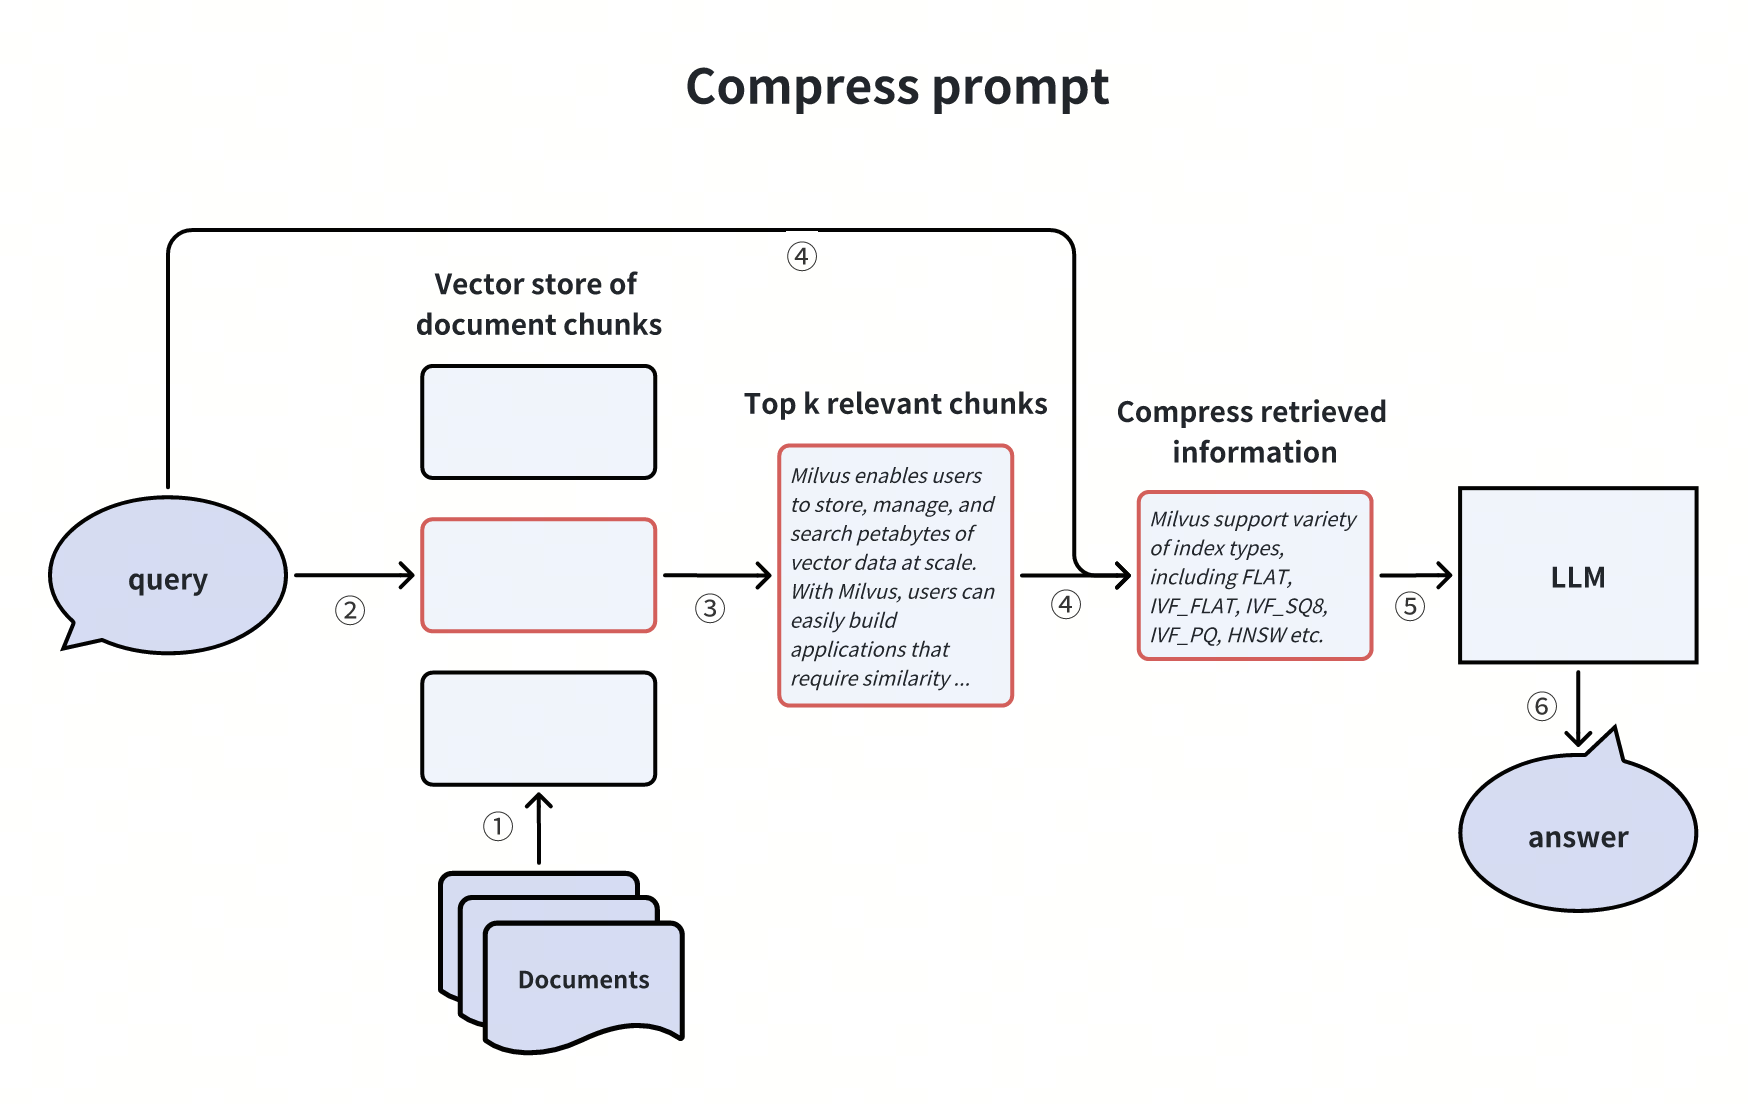
1. 压缩 LLM 提示(Compressing Prompts)

剔除检索到的 chunk 中的冗余信息,聚焦核心内容,缓解 LLM 上下文窗口限制。例如,提炼 “Milvus 支持的索引类型” 相关 chunk 时,仅保留关键技术参数。
在这里插入图片描述

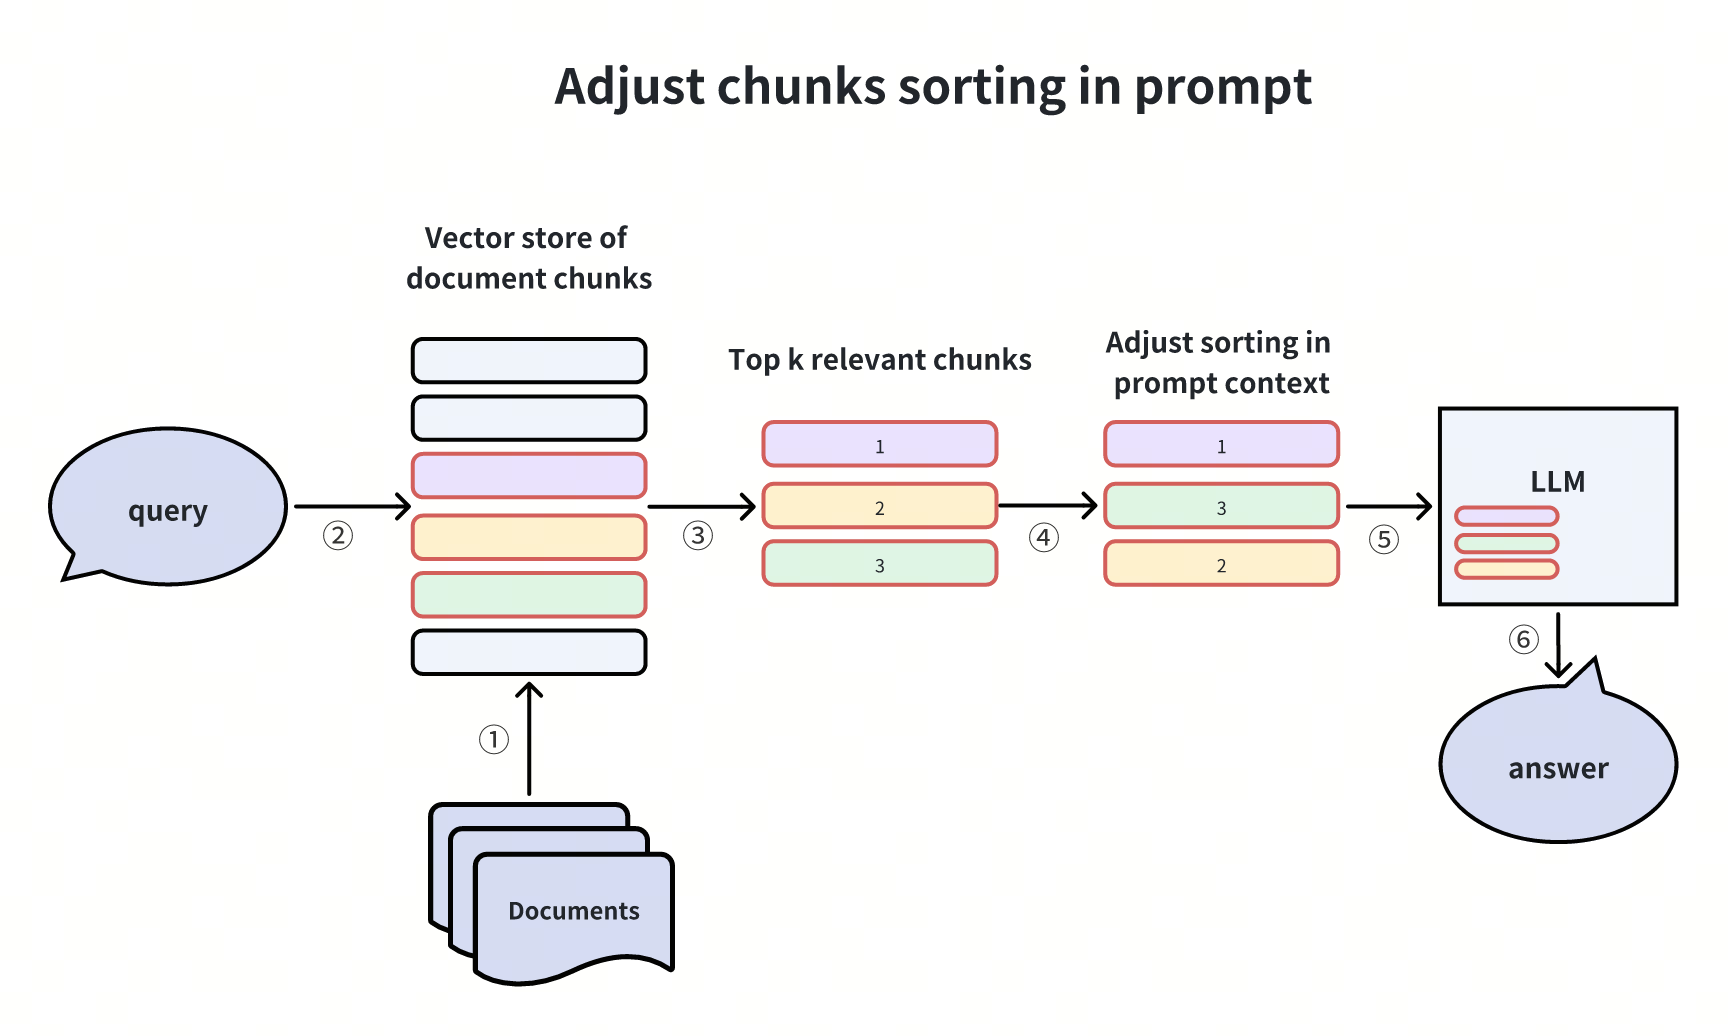
2. 调整 Prompt 中 Chunk 顺序

研究表明,LLM 倾向于关注首尾位置的信息(“Lost in the middle” 现象)。因此,可将高置信度 chunk 置于首尾,低置信度 chunk 放在中间。
在这里插入图片描述

六、全流水线增强:动态优化端到端流程

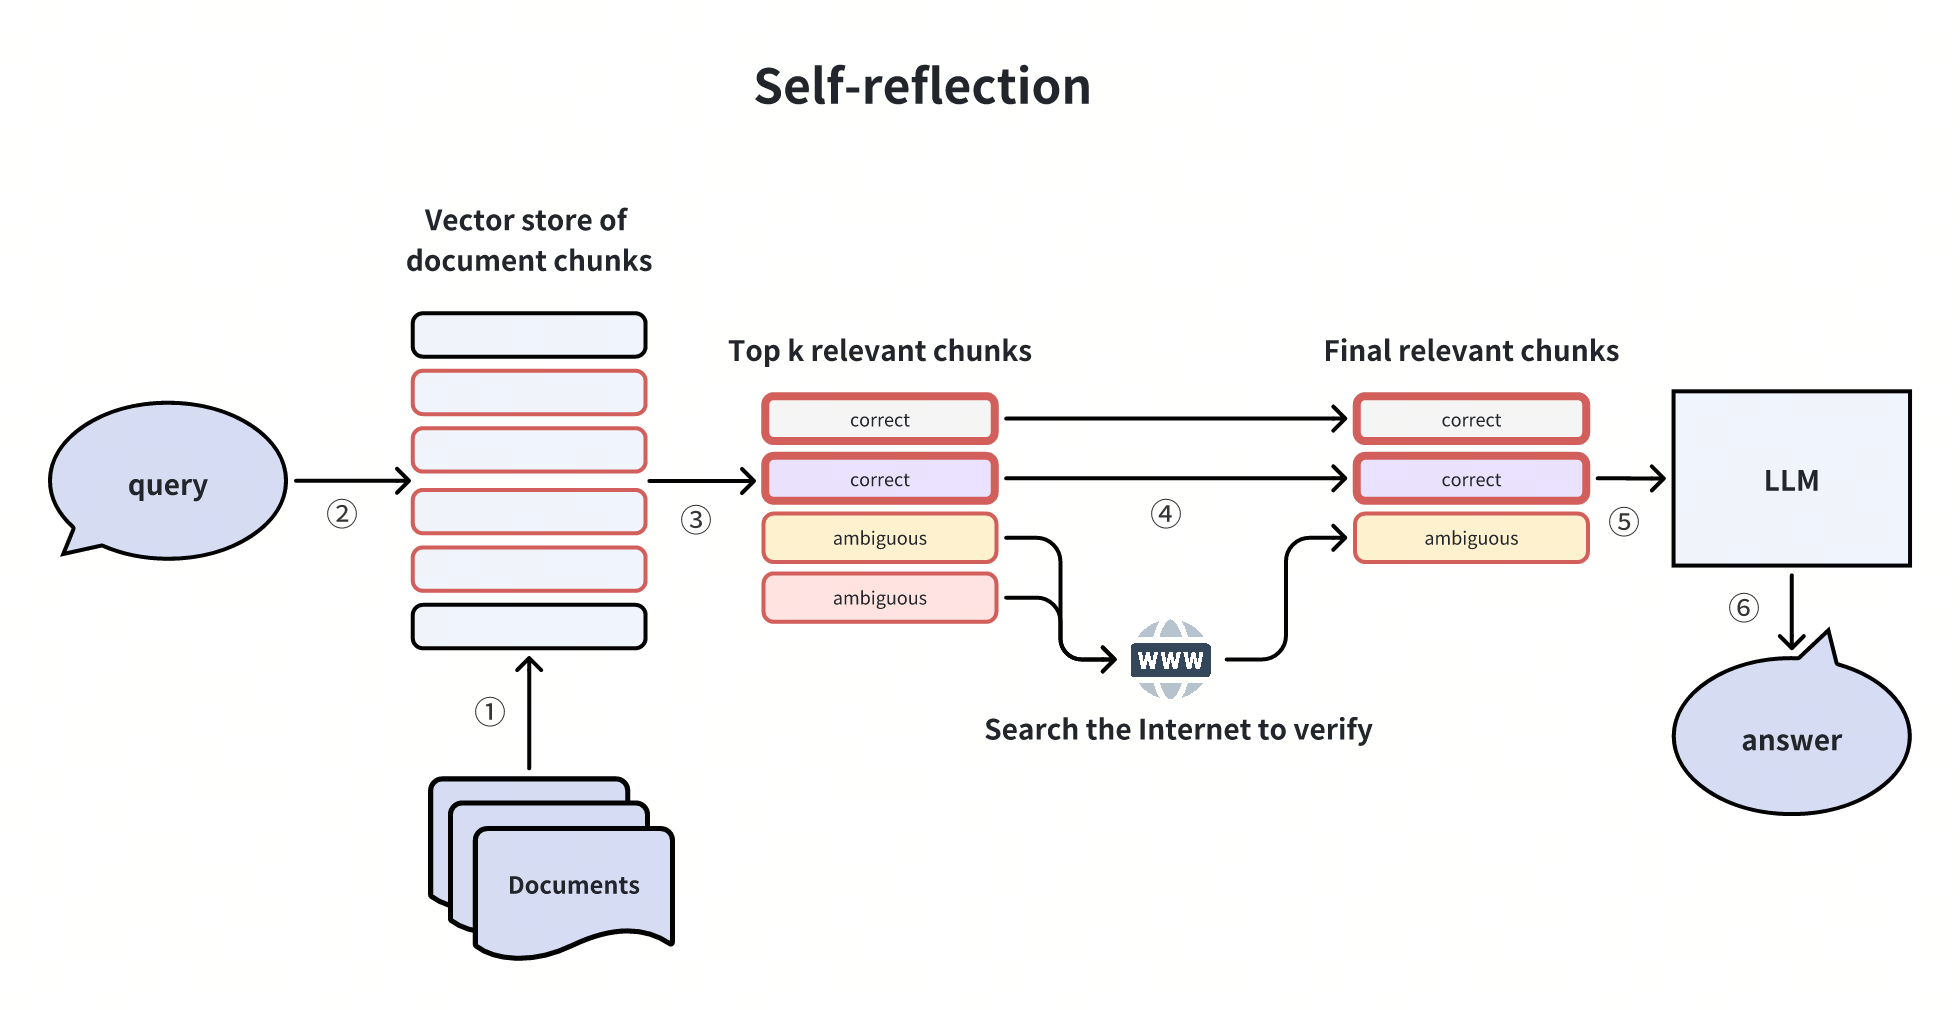
1. 自反思(Self-reflection)

对初检结果进行二次验证,通过 NLI 模型或工具(如互联网搜索)判断 chunk 是否能回答问题,过滤无效信息。参考项目:Self-RAG、Corrective RAG。
在这里插入图片描述

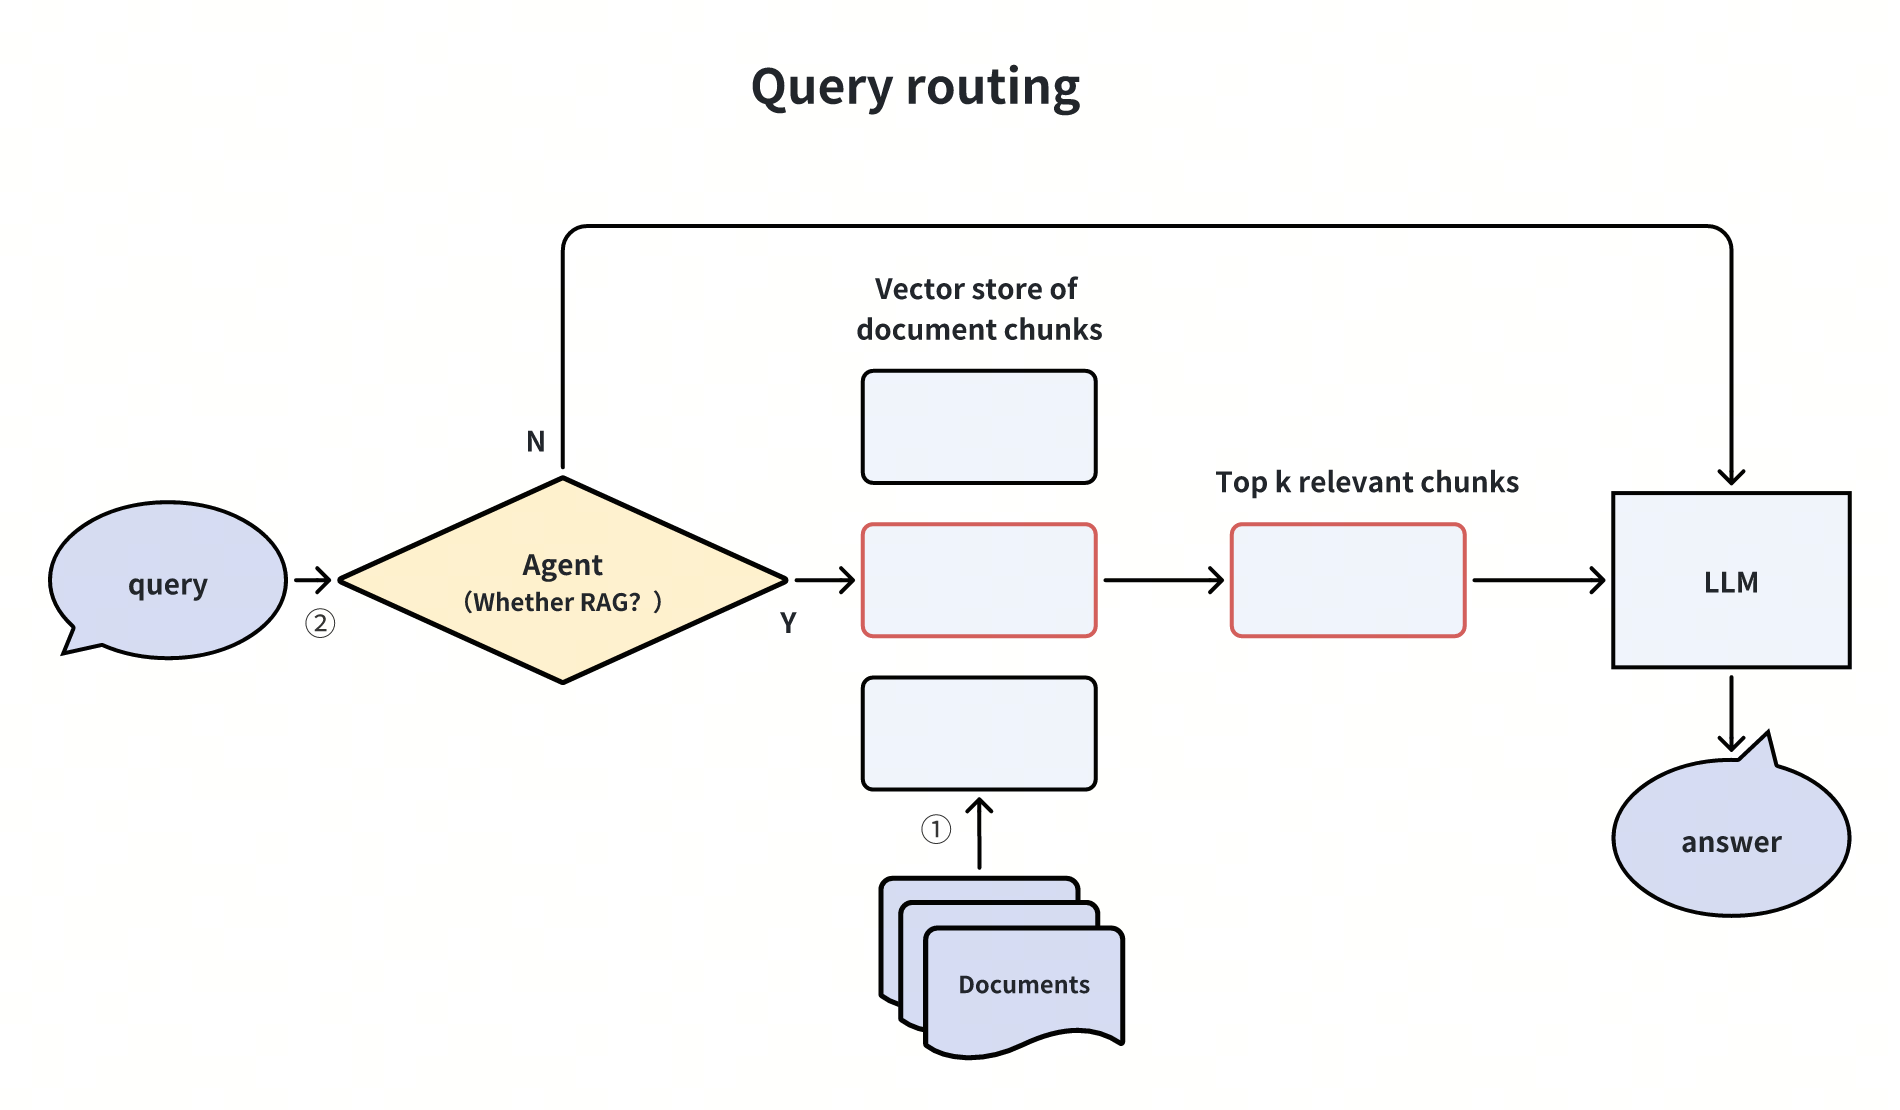
2. 基于 Agent 的查询路由

通过 Agent 判定查询是否需要调用 RAG:

  • 简单问题(如 “2+2 等于几”)直接由 LLM 回答;

  • 复杂问题(如 “Milvus 与 Elasticsearch 的性能对比”)触发 RAG 流程。

    延伸:扩展路由逻辑至工具调用(如网页搜索、子查询生成),实现动态流程调度。
在这里插入图片描述
在这里插入图片描述

七、总结与实践建议

RAG 性能优化需结合业务场景选择合适技术:

  • 复杂查询优先尝试子查询或回溯提示;

  • 海量数据场景推荐分层索引与混合检索;

  • 对响应速度敏感的应用可引入查询路由减少冗余计算。

针对 LLM 应用程序优化 RAG 大型语言模型 (LLM)(如 GPT-4)在生成类似人类的文本方面表现出了令人印象深刻的能力。然而,在保留事实知识方面,它们仍然面临挑战。这就是检索增强生成 (RAG) 的作用所在——将 LLM 的生成能力与外部知识源相结合。RAG 已成为一种有前途的技术,可在保持 LLM 流畅性的同时提高其事实基础。 阅读详情

相关推荐

WPS专业版自带字体

WPS专业版其中一个好处就是自带了部分有版权的字体,就算你安装了没买授权,他也会给你在系统里面安装上这些字体,至于没授权继续用合不合规我不知道。但是带来的实实在在的好处就是有些子他支持的全啊。 /usr/share/fonts/wps-office/FZWBK.TTF: 方正魏碑_GBK,FZWeiBei\-S03:style=Regular /usr/share/fonts/wps-office/FZFSK.TTF: 方正仿宋_GBK,FZFangSong\-Z02:style=Regular /us

chenqioulin的博客 5707

五个向量搜索中的难题,以及我们在Cassandra中如何解决它们

这是你能找到的一个纯粹的RAG应用程序,使用向量搜索将适当的文档呈现给LLM以回应用户的问题。对我们来说,这是一个简单的问题:Cassandra的主要优势是扩展复制,结合新的Cassandra-5.0中的SAI(存储关联索引——参见CEP-7了解它的工作原理——和SAI文档了解如何使用它)为我们的向量搜索实现提供了强大的扩展能力,实际上是免费的。在这个年轻领域的当前艺术状态是尝试在一个“正常”的数据库中做我所称的经典查询,在一个向量数据库中进行向量查询,然后在同时需要两者时用拼凑的方式将两者结合在一起。

610

ABAQUS应用15——Abaqus软件中边界条件与力学中自由度的关系

核心关系:Abaqus通过约束自由度实现边界条件,自由度类型由单元决定。正确设置步骤:确定模型类型(实体/梁/壳)。识别节点的自由度(平动或转动)。根据实际约束施加对应的自由度限制。验证:通过检查变形模式、反力分布等确认边界条件合理性。正确理解自由度与边界条件的关系,是确保有限元模型准确模拟实际物理行为的关键。

George的博客 1545

Query Rewrite —— 基于大模型的query扩展改写,如何减少LLM的幻觉问题,召回提升15%(北大论文)

如何有效的丰富扩展query,是一个提升召回率的关键问题。在大模型时代到来后,大家都开始使用LLM来扩展query。尽管LLM具有显著的文本生成能力,但它也容易产生幻觉,仍然难以代表其训练语料库中包含的完整的长尾知识。在北大的论文中,介绍了通过检索和大模型的结果,提升召回率的方法。论文提出:为了缓解上述模型的幻觉问题,方案是由原始query检索到的文档D,将D提供给模型,作为辅助材料,再让模型生成新的query。先进行一次普通检索,召回数据有可能帮助llm做出更好的预测。

Angus 4059

深入解析BLheli电调固件与Dshot通讯协议:从原理到实践

本文深入解析了无人机动力系统的核心——BLheli电调固件与Dshot通讯协议。详细阐述了BLheli固件从经典版到BLheli_32的演进及其功能特性,并重点剖析了Dshot数字协议如何通过数据包和校验码实现更快、更准、更可靠的电机控制。文章还涵盖了双向Dshot遥测、实战配置与调参指南,帮助玩家充分释放无人机性能。

weixin_28273593的博客 437

英飞凌 AURIX 系列单片机的HSM详解(1)——何为HSM

1. 概述 随着汽车上通信系统越来越复杂,云端远程通信的场景越来越多,信息安全变得越来越重要,在通信领域常用的AES、SHA、RSA等加密算法被越来越多地应用到汽车上。但通常这类加解密算法都需要大量的数学运算,需要消耗很多CPU时间和资源,汽车上的ECU又有比较高的实时性要求,为了节省主CPU的资源,HSM应运而生。 HSM(Hardware Security Module),是MCU上专门用于实现加解密算法的一个外设,它一般会有一个独立的CPU,专门用来进行加解密运算,还有一些针对特定算法的硬件加速器(如

weixin_42967006的博客 4万+

探索大语言模型(LLM):提升 RAG 性能的全方位优化策略,大模型入门到精通,收藏这篇就足够了!

本文将基于 Milvus 官方技术文档,深入解析 RAG 流水线的优化策略,涵盖查询增强、索引优化、检索器升级、生成器调优及全流程增强等多个维度,助力开发者打造高性能 RAG 应用。

2401_82469710的博客 1087

手把手教你学Simulink--四翼无人机滑模控制器设计与仿真

四翼无人机(Quadcopter)滑模控制(Sliding Mode Control, SMC)是一种鲁棒性很强的非线性控制方法,特别适用于存在模型不确定性和外部扰动的情况。滑模控制器通过强制系统状态进入并保持在一个预定义的滑模面上,从而实现对期望轨迹或姿态的精确跟踪。在这个教程中,我们将使用MATLAB和Simulink来设计并仿真一个基于滑模控制策略的四翼无人机系统。

MHD0815的博客 184

混合嵌入与置信度增强:新一代RAG技术如何提升LLM性能

随着大语言模型(LLM)在各领域产生深远影响,如何让模型实时融入最新信息或注入外部知识以构建领域专属模型,已成为研究热点。检索增强生成(RAG)凭借低成本、轻调参的优势,成为一种典型的“推理时扩展”方案。然而,由于训练数据与模型架构的差异,RAG 中使用的各类嵌入模型在不同场景下表现参差不齐,导致相似度计算结果各异,进而影响 LLM 的回答质量。

王哥儿聊AI的博客 1023

【异常】Cursor导入Karpathy指南失败解决方案Failed to import GitHub/GitLab rules: Error executing git: Cloning into

摘要:本文解决了Git克隆单个文件报错的问题,指出git clone只能克隆整个仓库而非单个文件。提供了两种解决方案:1) 推荐手动创建规则文件,在Cursor项目中新建.mdc文件并粘贴Karpathy行为指南完整内容;2) 备选克隆整个仓库获取文件。指南包含编码行为规范,强调简单性、精准修改和明确目标。还说明了如何设置全局规则和即时生效的方法。

奶爸的编程之路,也就一周冷个三天 174

Windows 11 安装 Miniconda + Mamba,配置国内源

本文详细介绍了在 Windows 11 系统下安装 Miniconda 并配置 Mamba 的完整流程,包括选择精简版 Miniconda 的理由、安装过程中的关键选项设置、配置清华大学镜像源以加速包下载,以及在 base 环境中设置 pip 国内源。同时说明了 Mamba 相较 Conda 的性能优势,并指导用户完成 Mamba 安装与 Shell 集成,最终通过命令验证环境管理功能,帮助用户构建高效、轻量的 Python 开发环境。

寒水馨 · 轻量级技术文档 · hanshuixin.org 3346

提升大语言模型的三大策略

在提升大语言模型(LLM)性能的过程中,我发现了三种高效的策略:提示工程、检索增强生成(RAG)和参数高效微调(PEFT)。这三者各有特点,能根据不同需求大幅提升模型表现。首先,提示工程通过优化提问方式,能够显著提高模型的输出质量。这是最简单且立竿见影的方式,尤其适合任务明确且数据量不大的场景。接着,RAG通过引入外部知识库,使得模型能够“查找”最新或领域特定的信息,增强回答的准确性。最后,PEFT利用LoRA等方法,在不修改大部分模型参数的情况下进行高效微调,节省资源同时提升定制化能力。

sdgfafg_25的博客 2145

【花雕学编程】Arduino FOC 之AS5048A磁编码器模块

您的硬件平台、使用场景和Arduino版本可能影响使用方法的选择。在Arduino平台上实现FOC可以提供平滑的运行和高度的扭矩、速度和位置控制,它通过精确控制电机的电流和电压来实现高效率、高精度和低噪声的操作。5、创新:Arduino可以让你用电子的方式来表达你的创意和想象,你可以用Arduino来制作各种有趣和有用的项目,如机器人、智能家居、艺术装置等。1、高性能电机控制:FOC是一种高级的电机控制算法,可以精准控制PMSM(永磁同步电机)和BLDC(无刷直流)电机,实现平滑的转速和扭矩输出。

雕爷学编程 1496

RAG优化策略

​ 在文章《大语言模型落地的关键技术:RAG》中,我们初步了解了RAG的基本概念、发展历史、系统组成以及评估方法,本文将着重讲解LLM落地面临的困难以及RAG技术的优化策略。

产品老A,8年互联网大厂AIPM,专注探索新型人机交互 2501

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

解锁RAG优化秘诀:征服7大挑战,全面提升你的LLM模型性能

本文探讨了使用RAG技术时可能面临的七大挑战,并针对每个挑战提出了具体的优化方案,以提升系统准确性和用户体验。缺失内容:解决方案包括数据清理和提示工程,确保输入数据的质量并引导模型更准确地回答问题。未识别出的最高排名:可通过调整检索参数和优化文件排序来解决,以确保向用户呈现最相关的信息。背景不足:扩大处理范围和调整检索策略至关重要,以包含更广泛的相关信息。格式错误:可以通过改进提示、使用输出解析器和Pydantic解析器实现,有助于按照用户期望的格式获取信息。

m0_63171455的博客 1448

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

LLM应用开发-RAG系统评估与优化

Hello,大家好,我是GISer Liu😁,一名热爱AI技术的GIS开发者,在上一篇文章中,我们学习了如何基于LangChain构建RAG应用,并且通过Streamlit将这个RAG应用部署到了阿里云服务器;😀LLM应用评估策略生成内容评估优化检索内容评估优化三部分,帮助读者学习如何对自己开发的RAG应用进行评估,并通过科学的方法优化结果,提高应用性能;

极限突破者的博客 1780

提升LLM性能的关键:提示工程与优化策略

LLM生成的文本不仅需要语法正确,还必须语义合理,即回答要准确对应问题的内容和主题,并且与问题保持一致,不发生语义偏离或逻辑断裂。

bagell的博客 928

大语言模型(LLM) | 一文解析RAG的5种分块策略

在构建高效的大语言模型(LLM)应用时,数据分块是至关重要的预处理步骤。通过将大型数据文件智能分割为适当大小的片段,我们能够为LLM精准提供执行特定任务所需的信息量 - 既不会因信息过载而影响性能,也不会因信息不足而降低输出质量。为了方便大家更好了解RAG的分块,将分块策略进行一些回顾和总结。

Androiddddd的博客 804

RAG 应用效果不太理想?试试以下RAG优化策略大幅提升问答效果

自从2022年12月 ChatGPT 横空面世以来,AI 领域获得了十足的关注和资本,其实AI的概念在早些年也火过一波,本轮 AI 热潮相比于之前的 AI,最大的区别在于:生成式。通过海量文本训练的、能识别人类语言、执行语言类任务、拥有大量参数的模型,称之为大语言模型。GPT、LLaMA、Mistral、BERT等都是LLM,LLM是对训练文本信息的压缩,同时拥有了泛化能力,不同于数据库和搜索引擎,LLM能创造性地生成历史上没有出现过的文本内容。知识的局限性。

2401_85325397的博客 1517

性能提升300%:RAG在AI原生应用中的优化案例

随着大语言模型(LLM)的普及,AI原生应用(以LLM为核心构建的应用)逐渐成为主流。但直接使用LLM生成内容时,常面临“知识过时”“事实错误”等问题——比如让GPT-4回答2024年某公司的最新产品信息,它可能因训练数据截止到2023年而给出错误答案。RAG(Retrieval-Augmented Generation,检索增强生成)技术通过“先检索后生成”的模式,完美解决了这一问题:先从用户的私有知识库(如文档、数据库)中检索相关信息,再将信息“喂”给LLM生成答案。

项目管理的博客 1119

【2025版】RAG效果不好怎么办?试试以下RAG优化策略大幅提升问答效果

自从2022年12月 ChatGPT 横空面世以来,AI 领域获得了十足的关注和资本,其实AI的概念在早些年也火过一波,本轮 AI 热潮相比于之前的 AI,最大的区别在于:生成式。通过海量文本训练的、能识别人类语言、执行语言类任务、拥有大量参数的模型,称之为大语言模型。GPT、LLaMA、Mistral、BERT等都是LLM,LLM是对训练文本信息的压缩,同时拥有了泛化能力,不同于数据库和搜索引擎,LLM能创造性地生成历史上没有出现过的文本内容。

Python_0011的博客 1029

【RAG】34-RAG优化方法:探讨RAG的优化策略,提升RAG性能的技术与策略

RAG优化方法是一种针对Region Adjacency Graph(RAG,区域邻接图)性能提升的系统性策略。本文将深入探讨RAG优化方法的核心技术和策略,为相关领域的研究者和工程师提供有价值的参考和指导。

rengang66的博客 620
上一篇: RAG技术深度解密:AI界的“学霸外挂”如何炼成?
下一篇: huggingface入门:如何使用国内镜像下载huggingface中的模型
艾醒(AiXing-w)
艾醒(AiXing-w) 2021年度博客之星AI领域top5 2021年度博客之星AI领域top5
博客等级 码龄7年 1万+粉丝 320原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

艾醒(AiXing-w)

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值