


目录
pre_process_variable:自动填充不完整的数据
get_2d_gaussian:生成一个二维高斯分布的函数句柄
get_photon_arrival_data:生成光子到达数据
1. data_utils.py
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

def load_data(data_path):
    # 加载 .npz 文件
    data = np.load(data_path)
    X_train = data['X_train']
    y_train = data['Y_train']
    return X_train, y_train

def preprocess_data(X_train, y_train):
    # 归一化
    scaler_X = StandardScaler()
    X_train = scaler_X.fit_transform(X_train)

    scaler_y = StandardScaler()
    y_train = scaler_y.fit_transform(y_train)

    # 数据集划分
    X_train, X_test, y_train, y_test = train_test_split(X_train, y_train, test_size=0.2, random_state=42)
    X_train, X_val, y_train, y_val = train_test_split(X_train, y_train, test_size=0.1, random_state=42)

    return X_train, X_val, X_test, y_train, y_val, y_test, scaler_X, scaler_y
导入库
from sklearn.model_selection import train_test_split-
库简介:
sklearn.model_selection是scikit-learn库的一部分,提供了模型选择和评估的工具。 -
用途:
train_test_split函数用于将数据集划分为训练集和测试集,是机器学习中常用的数据分割方法。 -
功能:可以指定测试集的比例(
test_size参数),并支持随机分割(通过random_state参数控制随机种子)。
from sklearn.preprocessing import StandardScaler-
库简介:
sklearn.preprocessing也是scikit-learn库的一部分,提供了数据预处理的工具。 -
用途:
StandardScaler是一种标准化方法,用于将数据按列(特征)进行标准化,使得每列的均值为0,标准差为1。 -
功能:通过中心化(减去均值)和缩放(除以标准差),使数据具有统一的比例,这在很多机器学习算法中是必要的,特别是那些对特征尺度敏感的算法(如支持向量机、K-均值聚类等)。
从 .npz 文件中加载训练数据
.npz 文件是 NumPy 库提供的一种文件格式,用于存储多个数组。这种格式类似于 Python 的 .zip 文件,可以包含多个 NumPy 数组。
def load_data(data_path):函数定义:定义了一个函数 load_data,它接受一个参数 data_path表示 .npz 文件的路径。
data = np.load(data_path)加载 .npz 文件:np.load(data_path) 是 NumPy 中用于加载 .npz 文件的函数。它读取位于 data_path 指定路径的 .npz 文件,并返回一个类似字典的对象,其中包含了文件中存储的所有数组。
X_train = data['X_train']
y_train = data['Y_train']
return X_train, y_train提取数据:头两行代码从加载的 .npz 文件对象中提取具体的数组。data['X_train'] 和 data['Y_train'] 分别获取文件中存储的名为 'X_train' 和 'Y_train' 的数组。这些数组通常包含了训练数据的特征和标签(或目标值)。
-
'X_train'通常代表特征数据,即输入变量或用于训练模型的独立变量。 -
'Y_train'通常代表标签或目标数据,即模型需要预测的依赖变量。
返回数据:将提取的特征数据 X_train 和标签数据 y_train 作为元组返回,以便用于后续的数据处理或模型训练步骤。
训练数据预处理:归一化处理和数据集划分
def preprocess_data(X_train, y_train): 函数定义:定义了一个函数 preprocess_data,它接受两个参数:X_train(训练特征数据)和 y_train(训练标签数据)。
scaler_X = StandardScaler()
X_train = scaler_X.fit_transform(X_train)

scaler_y = StandardScaler()
y_train = scaler_y.fit_transform(y_train)
归一化处理:
归一化处理是一种数据预处理技术,它的主要目的是将数据按比例缩放,使之落入一个小的特定区间,通常是[-1,1]。 通过归一化处理,可以消除数据间因量纲不同而产生的差异,使得各个特征在数值上具有可比性。 归一化的目的是使得预处理的数据被限定在一定的范围内,从而消除奇异样本数据导致的不良影响。
- 创建一个
StandardScaler对象scaler_X,用于对特征数据X_train进行归一化处理。 fit_transform方法先计算训练数据的均值和方差,然后对数据进行中心化(减去均值)和缩放(除以标准差)。- 创建另一个
StandardScaler对象scaler_y,用于对标签数据y_train进行归一化处理。同样使用fit_transform方法对标签数据进行中心化和缩放。
X_train, X_test, y_train, y_test =
train_test_split(X_train, y_train, test_size=0.2, random_state=42)

X_train, X_val, y_train, y_val =
train_test_split(X_train, y_train, test_size=0.1, random_state=42)

return X_train, X_val, X_test, y_train, y_val, y_test, scaler_X, scaler_y
数据集划分:
验证集(Validation set):
用途:
验证集主要用于模型选择、超参数调优和防止过拟合。
在训练过程中,可以使用验证集来评估不同模型或不同参数设置的性能。
使用时机:
验证集在模型训练阶段使用,以帮助选择最佳的模型或参数。
通常在每一轮训练(epoch)后或在交叉验证(cross-validation)过程中使用。
数据使用:验证集的数据不会被用于训练模型参数,仅用于评估和选择。
测试集(Test set):
用途:
测试集用于最终评估模型的泛化能力,即模型在未见过的数据上的表现。
测试集应该只使用一次,在模型选择和调优完成后。
使用时机:
测试集在模型训练和验证过程完成后使用。
用于给出模型性能的最终评价,以估计模型在实际应用中的表现。
数据使用:测试集的数据在模型开发过程中是完全隔离的,直到最终评估时才使用。
总结
验证集帮助在开发过程中选择和优化模型,而测试集用于最终评估模型的性能。
验证集可以在训练过程中多次使用,而测试集仅在模型开发完成后使用一次。
验证集有助于防止过拟合并选择最佳模型,测试集则提供了对模型在新数据上性能的无偏估计。
-
使用
train_test_split函数将归一化后的训练数据划分为新的训练集和测试集(test)。 -
test_size=0.2表示测试集占原始训练数据的20%。 -
random_state=42设置随机种子,以确保数据划分的可重复性。 -
进一步使用
train_test_split函数将新的训练集划分为训练集和验证集(val)。 -
test_size=0.1表示验证集占新的训练数据的10%。同样设置random_state参数以确保可重复性。
2. train_model.py
import torch
import torch.nn as nn
from utils.data_utils import load_data, preprocess_data

# 定义模型
class PhotonPositionModel(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super(PhotonPositionModel, self).__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.fc2 = nn.Linear(hidden_size, hidden_size)
        self.fc3 = nn.Linear(hidden_size, output_size)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.relu(self.fc2(x))
        x = self.fc3(x)
        return x

# 加载数据
X_train, y_train = load_data('data/training_data.npz')
X_train, X_val, X_test, y_train, y_val, y_test, scaler_X, scaler_y = preprocess_data(X_train, y_train)

# 转换为 PyTorch 张量
X_train = torch.tensor(X_train, dtype=torch.float32)
y_train = torch.tensor(y_train, dtype=torch.float32)
X_val = torch.tensor(X_val, dtype=torch.float32)
y_val = torch.tensor(y_val, dtype=torch.float32)

# 初始化模型
input_size = X_train.shape[1]
hidden_size = 128
output_size = 2
model = PhotonPositionModel(input_size, hidden_size, output_size)

# 定义损失函数和优化器
criterion = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)

# 训练模型
num_epochs = 100
batch_size = 64

for epoch in range(num_epochs):
    model.train()
    for i in range(0, len(X_train), batch_size):
        X_batch = X_train[i:i+batch_size]
        y_batch = y_train[i:i+batch_size]

        outputs = model(X_batch)
        loss = criterion(outputs, y_batch)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    # 验证集评估
    model.eval()
    with torch.no_grad():
        val_outputs = model(X_val)
        val_loss = criterion(val_outputs, y_val)

    print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {loss.item():.4f}, Val Loss: {val_loss.item():.4f}')

# 保存模型
torch.save(model.state_dict(), 'models/photon_position_model.pth')
print("模型已保存!")
导入库
import torch-
torch是 PyTorch库的简称,可以使用其提供的各种功能,包括张量计算、自动梯度计算、模型构建、优化器等。
import torch.nn as nn-
torch.nn是 PyTorch中专门用于构建神经网络的模块。 -
导入为
nn后,可以方便地使用该模块中的类和函数,如定义网络层(nn.Linear)、激活函数(nn.ReLU)、损失函数(nn.MSELoss)等。
from utils.data_utils import load_data, preprocess_data定义模型
class PhotonPositionModel(nn.Module):类定义:PhotonPositionModel 神经网络模型类定义了一个具有两个隐藏层的前馈神经网络,用于预测光子(例如荧光分子)的位置。这种类型的网络适合于回归任务,其中目标是预测连续的输出值。
def __init__(self, input_size, hidden_size, output_size):初始化方法:
-
__init__方法是类的构造函数,用于初始化模型的层和参数。 -
input_size参数指定了输入特征的数量。 -
hidden_size参数指定了隐藏层神经元的数量。 -
output_size参数指定了输出特征的数量,在这个场景中,通常是二维的(例如,x和y坐标)。 -
super(PhotonPositionModel, self).__init__()调用了父类
nn.Module的构造函数,是初始化模型时必须的步骤。 -
self.fc1 = nn.Linear(input_size, hidden_size)
self.fc2 = nn.Linear(hidden_size, hidden_size)
self.fc3 = nn.Linear(hidden_size, output_size)
这些行定义了模型中的全连接层(
Linear层),也称为线性层。-
fc1是第一个全连接层,将输入特征映射到隐藏层。 -
fc2是第二个全连接层,将第一个隐藏层的输出映射到第二个隐藏层。 -
fc3是第三个全连接层,将第二个隐藏层的输出映射到输出层。
-
-
self.relu = nn.ReLU()定义了一个 ReLU(Rectified Linear Unit)激活函数,它将用于在隐藏层之后引入非线性,帮助模型学习输入特征和输出之间的非线性关系。
def forward(self, x):前向传播方法:
-
forward方法定义了数据通过网络层的正向传播路径。 -
x参数是输入数据。 -
x = self.relu(self.fc1(x))
x = self.relu(self.fc2(x))
x = self.fc3(x)
return x
这些行描述了数据如何通过网络:
-
首先,输入数据
x通过第一个全连接层fc1,然后应用 ReLU 激活函数。 -
接着,经过激活的数据通过第二个全连接层
fc2,再次应用 ReLU 激活函数。 -
最后,数据通过第三个全连接层
fc3得到最终的输出。
-
-
最终的输出
x是模型的预测结果,它将被返回用于后续的损失计算和模型优化。
加载数据
X_train, y_train = load_data('data/training_data.npz')加载数据:
-
load_data函数从指定路径(data/training_data.npz)加载训练数据。 -
该函数返回两个 NumPy 数组:
X_train(特征数据)和y_train(标签数据)。
X_train, X_val, X_test, y_train, y_val, y_test, scaler_X, scaler_y =
preprocess_data(X_train, y_train)
数据预处理:
-
使用
preprocess_data函数对数据进行预处理,包括归一化和划分训练集、验证集和测试集。 -
返回值包括:
-
X_train:训练特征数据。 -
X_val:验证特征数据。 -
X_test:测试特征数据。 -
y_train:训练标签数据。 -
y_val:验证标签数据。 -
y_test:测试标签数据。 -
scaler_X:特征数据的StandardScaler对象,可用于后续数据的归一化。 -
scaler_y:标签数据的StandardScaler对象,可用于后续标签数据的逆归一化(如果需要)。
-
X_train = torch.tensor(X_train, dtype=torch.float32)
y_train = torch.tensor(y_train, dtype=torch.float32)
X_val = torch.tensor(X_val, dtype=torch.float32)
y_val = torch.tensor(y_val, dtype=torch.float32)
转换为PyTorch张量:
将NumPy数组格式的数据转换为PyTorch张量(tensor),以便在模型中使用。
在PyTorch中,张量(Tensor)是进行数值计算的核心数据结构,类似于NumPy中的数组(array)。张量可以存储在CPU或GPU上,并且支持自动求导,这使得PyTorch张量非常适合用于构建和训练深度学习模型。以下是PyTorch张量的主要特性和用途:
1. 多维数组
张量是多维数组,可以看作是NumPy数组的扩展,但提供了更多的功能,特别是在GPU加速计算方面。
2. 自动求导
PyTorch张量支持自动求导,这是深度学习中反向传播算法的基础。当你对张量执行操作时,PyTorch会自动跟踪这些操作以计算梯度,这对于训练神经网络至关重要。
3. 与GPU兼容
张量可以存储在GPU上,这使得大规模数值计算,特别是深度学习中的大规模矩阵运算,可以被大幅加速。
4. 广播机制
张量支持广播(broadcasting)机制,这是一种强大的机制,允许不同形状的张量进行数学运算。广播使得对不同大小的数组进行算术运算成为可能,而无需显式地扩展它们的形状。
5. 用于构建神经网络
在PyTorch中,神经网络层通常由张量表示,输入数据、权重和偏置都是张量。通过操作这些张量,神经网络可以进行前向传播和反向传播。
初始化模型
根据输入数据的特征维度定义模型的输入大小,隐藏层大小设为128,输出大小为2(预测粒子的二维位置)。
input_size = X_train.shape[1]
hidden_size = 128
output_size = 2
model = PhotonPositionModel(input_size, hidden_size, output_size)-
input_size设置为训练数据X_train的特征数量(即每条数据的维度),通过X_train.shape[1]获取。.shape属性返回数据的维度信息,其中.shape[0]是批量大小(样本数量),.shape[1]是特征数量。 -
hidden_size设置为隐藏层的大小,这里选择 128 个神经元,这是一个超参数,可以根据模型复杂度和数据集大小进行调整。 -
output_size设置为输出层的大小,这里是 2,因为我们预测的是二维空间中粒子的位置(例如 x 和 y 坐标)。 -
PhotonPositionModel是之前定义的模型类,model是该类的实例,用给定的输入、隐藏和输出层大小初始化。
定义损失函数和优化器
criterion = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)-
使用均方误差(MSE)作为损失函数:
criterion定义了损失函数,这里使用的是均方误差(MSELoss)。它计算模型预测值和实际值之间差的平方的平均值。
-
使用Adam优化器,学习率设为0.001:
optimizer定义了优化器,这里使用的是 Adam 优化器,它是自适应学习率的优化算法,适用于许多不同的优化问题。model.parameters()获取模型的所有参数,lr=0.001设置学习率为 0.001,控制优化器在更新参数时的步长。
Adam优化器(Adaptive Moment estimation,自适应矩估计)是一种流行的随机梯度下降优化算法,用于训练深度学习模型。它结合了动量法(Momentum)和RMSProp(RMSProp)两种优化算法的优点。Adam优化器因其自适应学习率的特性而广受欢迎,这意味着它不需要手动调整学习率,并且通常能够更快地收敛。
工作原理
Adam优化器通过计算梯度的一阶矩估计(即梯度的期望值)和二阶矩估计(即梯度的未中心化的方差)来更新参数。具体来说:
一阶矩估计(Momentum):Adam优化器跟踪梯度的指数加权平均值,这有助于加速梯度下降的方向,类似于传统的动量法。
二阶矩估计(RMSProp):Adam优化器还跟踪梯度平方的指数加权平均值,这有助于调整学习率,使得参数更新更加稳定。
自适应学习率:Adam优化器利用一阶和二阶矩估计来计算每个参数的自适应学习率,从而为每个参数提供不同的更新步长。
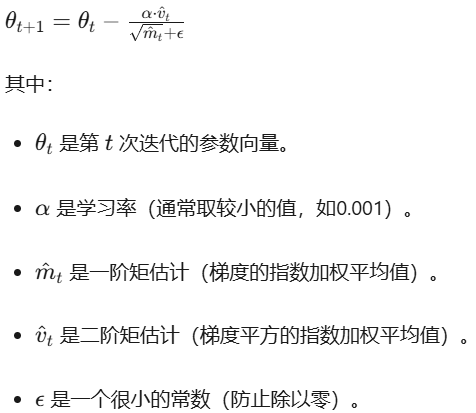
Adam优化器的参数更新公式
训练模型
包括训练过程和验证集评估。设定训练周期(epochs)为100,批大小(batch size)为64;在每个epoch中,模型在训练集上进行训练,并在验证集上进行评估,输出每个epoch的训练损失和验证损失。
num_epochs = 100
batch_size = 64
设置训练参数:
-
num_epochs定义了训练的总轮数(epochs),即模型将在整个训练集上训练100次。 -
batch_size定义了每个批次(batch)中样本的数量,这里设置为64。批处理是训练过程中常用的技术,可以减少内存消耗并加速训练。
训练循环:
for epoch in range(num_epochs):
    model.train()
    for i in range(0, len(X_train), batch_size):
        X_batch = X_train[i:i+batch_size]
        y_batch = y_train[i:i+batch_size]

        outputs = model(X_batch)
        loss = criterion(outputs, y_batch)

        optimizer.zero_grad()
        loss.backward()
optimizer.step()-
外层循环遍历所有的训练轮次。
-
内层循环通过分批次遍历训练集。每次从训练集中取出一个批次的数据
X_batch和对应的标签y_batch。 -
model(X_batch)计算当前批次的预测输出。 -
criterion(outputs, y_batch)计算预测输出和真实标签之间的损失。 -
optimizer.zero_grad()清除之前的梯度信息,为新的梯度计算做准备。 -
loss.backward()执行反向传播,计算损失相对于模型参数的梯度。 -
optimizer.step()根据计算出的梯度更新模型参数。
梯度(Gradient):
梯度是损失函数相对于模型参数的导数,表示损失值随参数变化的速率。梯度向量指示了损失函数在参数空间中增加最快的方向。在优化过程中,我们希望沿着梯度的反方向更新参数,以减少损失值。
反向传播(Backpropagation):
反向传播是一种高效的计算梯度的方法。它利用链式法则,从输出层向输入层递归,依次计算每层的梯度。反向传播的主要步骤包括:
计算输出层的梯度:首先计算损失函数相对于输出层激活值的梯度。
逐层向前传播梯度:利用链式法则,从输出层向隐藏层、输入层逐层向前传播梯度,依次计算每层的梯度。
存储梯度:在每层的参数上存储计算得到的梯度值。
在PyTorch中,
loss.backward()函数触发反向传播过程。当你调用这个函数时,PyTorch会自动计算损失相对于模型所有参数的梯度,并存储在对应的.grad属性中。
验证集评估:
model.eval()
with torch.no_grad():
    val_outputs = model(X_val)
    val_loss = criterion(val_outputs, y_val)

print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {loss.item():.4f}, Val Loss: {val_loss.item():.4f}')-
model.eval()将模型设置为评估模式,这会关闭某些特定层(如Dropout和BatchNorm)的特定行为。 -
torch.no_grad()上下的内容不会跟踪梯度,这有助于减少内存消耗并加速计算。 -
使用验证集数据
X_val和y_val计算模型在验证集上的输出val_outputs和损失val_loss。 -
打印每个epoch结束后的训练损失和验证损失。
保存模型
torch.save(model.state_dict(), 'models/photon_position_model.pth')
print("模型已保存!")
训练完成后,将模型的参数保存到文件中,以便后续使用。
3. transfer_form.py
这个文件用于将MATLAB格式的数据文件(.mat)转换为NumPy格式的文件(.npz),以便在Python中使用。
导入库
import scipy.io
import numpy as npscipy.io:用于加载MATLAB的.mat文件。
scipy.io是 SciPy 中负责输入输出操作的模块,它提供了读取和写入不同类型文件的功能。
numpy:用于保存数据为.npz文件。
加载MATLAB数据文件
data = scipy.io.loadmat('training_data.mat')使用 scipy.io.loadmat 函数加载 .mat 文件。
提取数据
X_train = data['X_train']
Y_train = data['Y_train']
从加载的MATLAB数据中提取训练数据和标签。
保存为NumPy格式
np.savez('training_data.npz', X_train=X_train, Y_train=Y_train)使用 numpy.savez 函数将数据保存为 .npz 文件,这种格式便于在Python中使用NumPy进行数据处理。
4. get_dist2.m
% automatically fill in incomplete data

function d = get_dist2(p1,p2)
[p1,l1] = pre_process_variable(p1);
[p2,l2] = pre_process_variable(p2);

if l1 == l2

    d = sqrt(sum((p1 - p2).^2,2));
    return,
elseif l1 == 1
    p1 = repmat(p1,[l2,1]);
    d = sqrt(sum((p1 - p2).^2,2));
    return,
elseif l2 == 1
    p2 = repmat(p2,[l1,1]);
    d = sqrt(sum((p1 - p2).^2,2));
    return,
else

    error('dimensions of inputs mismatch!')
end
end

function [out,len] = pre_process_variable(in)
if ~isnumeric(in) || ~isreal(in)
   error('invalid input!')
end
if ~ismember(length(size(in)),[1,2])
   error('invalid input!')
end

if prod(size(in)) == 2
    out = [in(:)',0];
    len = 1;
    return,
elseif prod(size(in)) == 3
    out = in(:)';
    len = 1;
    return,
end

if ~ismember(length(in(1,:)),[2,3])
    error('invalid input!')
elseif length(in(1,:)) == 2
    in(:,3) = 0;
     out = in;
    len = length(in(:,1));
else
    out = in;
    len = length(in(:,1));

end
endpre_process_variable:自动填充不完整的数据
用于预处理输入数据,确保输入数据的格式一致,并在必要时自动填充不完整的数据。
function [out, len] = pre_process_variable(in)输入参数:
-
in:输入数据,可以是一个点或点集。
输出参数:
-
out:处理后的数据。 -
len:处理后数据的长度。
if ~isnumeric(in) || ~isreal(in)
    error('invalid input!');
end
if ~ismember(length(size(in)), [1, 2])
    error('invalid input!');
end检查输入数据的有效性:
-
检查输入数据是否为数值类型且为实数。
-
检查输入数据的维度是否为 1 或 2。
if prod(size(in)) == 2
    out = [in(:)', 0];
    len = 1;
    return,
elseif prod(size(in)) == 3
    out = in(:)';
    len = 1;
return,处理单点输入:
-
如果输入数据是一个二维点(2 个元素),自动填充第三个维度为 0。
-
如果输入数据是一个三维点(3 个元素),直接使用。
if ~ismember(length(in(1, :)), [2, 3])
    error('invalid input!');
elseif length(in(1, :)) == 2
    in(:, 3) = 0;
    out = in;
    len = length(in(:, 1));
else
    out = in;
len = length(in(:, 1));处理多点输入:
-
检查每个点的维度是否为 2 或 3。
-
如果每个点的维度为 2,自动填充第三个维度为 0。
-
如果每个点的维度为 3,直接使用。
get_dist2:计算两个点或点集之间的欧几里得距离
function d = get_dist2(p1, p2)-
输入参数:两个点或点集。
-
输出参数
d:两个点或点集之间的欧几里得距离。
[p1, l1] = pre_process_variable(p1);
[p2, l2] = pre_process_variable(p2);预处理输入数据:
-
调用
pre_process_variable函数对输入数据p1和p2进行预处理。 -
pre_process_variable函数返回处理后的数据和数据的长度。
if l1 == l2
    d = sqrt(sum((p1 - p2).^2, 2));
return,检查数据长度是否匹配:
-
如果
p1和p2的长度相同,直接计算它们之间的欧几里得距离。 -
使用
sum((p1 - p2).^2, 2)计算每个点对的平方差,然后取平方根得到欧几里得距离。
elseif l1 == 1
    p1 = repmat(p1, [l2, 1]);
    d = sqrt(sum((p1 - p2).^2, 2));
    return,
elseif l2 == 1
    p2 = repmat(p2, [l1, 1]);
    d = sqrt(sum((p1 - p2).^2, 2));
return,处理单点与多点的情况:
-
如果
p1是单点,而p2是多点,将p1复制l2次,使其与p2的长度匹配。 -
如果
p2是单点,而p1是多点,将p2复制l1次,使其与p1的长度匹配。 -
然后计算它们之间的欧几里得距离。
else
error('dimensions of inputs mismatch!');处理维度不匹配的情况:如果 p1 和 p2 的长度都不为 1 且不相等,抛出错误。
5. photon_arrival_sim.m
classdef photon_arrival_sim < handle
    methods (Static)
        function tf = is_interval_valid(intervals)
            % each interval set must be in non-decreasing order
            row_diffs = diff(intervals, 1, 2);
            tf = ~any(row_diffs(:) < 0);
        end

        function idx = query_intervals(values, intervals)
            if (~photon_arrival_sim.is_interval_valid(intervals))
                error('input interval is invalid')
            end
            if size(values,2) ~= 1 || size(values,1) ~= size(intervals,1)
                error('Dimension mismatch: values must be an N-by-1 column vector and intervals must be an N-by-M array.');
            end
            idx = sum(values > intervals, 2);
        end

        function res = count_freq(nums, values)
            res = zeros(length(values), 1);
            for i = 1 : length(values)
                res(i) = sum(nums == values(i));
            end
        end
    end

    methods (Static)
        function f = get_2d_gaussian(part_pos, psf_size, sig, bgd)
            % returns a function handle used to query (absolute) intensity

            f = @(x) sig.*1./sqrt(2*pi)/psf_size.*exp(-(get_dist2(part_pos, x)).^2/psf_size^2) + bgd;
        end

        function [em_rate, n, data] = get_photon_arrival_data(N, part_pos, detector_pos, psf_size, sig, bgd)
            n_detector = length(detector_pos(:, 1));
            f = photon_arrival_sim.get_2d_gaussian(part_pos, psf_size, sig, bgd);

            % measured intensity = mean of intensity at all detector pos
            detector_int = f(detector_pos);
            em_rate = mean(detector_int);

            rand_nums = rand(N, 1);

            % probability to receive a photon at given detector position
            norm_detector_int = detector_int./sum(detector_int);
            idx = photon_arrival_sim.query_intervals(rand_nums, repmat([0, cumsum(norm_detector_int')], [N, 1]));

            % n: number of photons received at each detector position
            n = photon_arrival_sim.count_freq(idx, 1:n_detector);

            % each simulated photon arrival position
            data = [];
            for i = 1 : n_detector
                data = [data; repmat(detector_pos(i, :), [n(i), 1])];
            end

            % shuffle each row
            data = data(randperm(sum(n)), :);
        end
    end
end
模拟光子到达的场景
类定义
classdef photon_arrival_sim < handle-
photon_arrival_sim是一个继承自handle的类。这意味着该类的对象是通过引用传递的,而不是通过值传递。
handle类用于创建引用类型对象。与普通的值类型对象不同,handle类的对象通过引用传递,而不是通过值传递。这意味着当你将一个handle类的对象赋值给另一个变量时,两个变量会指向同一个对象,而不是创建对象的副本。修改一个变量中的对象属性,另一个变量中的对象属性也会相应地改变。这种行为类似于其他编程语言中的指针或引用。
is_interval_valid:检查输入的区间是否有效
检查每个区间的值是否是非递减的。如果所有区间的值都是非递减的,则返回 true。
methods (Static)
function tf = is_interval_valid(intervals)-
输入参数
intervals是一个二维数组,每一行代表一个区间。例如,[1, 3; 4, 6]表示两个区间[1, 3]和[4, 6]。
% each interval set must be in non-decreasing order
row_diffs = diff(intervals, 1, 2);计算差值:
-
使用
diff函数计算每一行的差值,确保每个区间的值是非递减的。 -
diff(intervals, 1, 2)表示沿着第二维(列)计算差值。表示每个区间的第二个值减去第一个值。 -
例如,对于区间
[1, 3; 4, 6],row_diffs的结果是:[3-1; 6-4] = [2; 2]
        tf = ~any(row_diffs(:) < 0);
end检查差值是否非负:
-
row_diffs(:)将row_diffs展平为一个列向量。 -
any(row_diffs(:) < 0)检查是否有任何差值小于零。如果有,返回true;否则返回false。 -
~是逻辑非运算符,将any(row_diffs(:) < 0)的结果取反。 -
输出参数
tf:如果所有差值都大于等于零,则返回true,否则返回false。
query_intervals:查询每个值在区间中的位置
function idx = query_intervals(values, intervals)-
输入参数:
-
values:一个 N-by-1 的列向量,表示需要查询的值。 -
intervals:一个 N-by-M 的二维数组,表示多个区间。
-
-
输出参数
idx:一个 N-by-1 的列向量,表示每个值在区间中的位置索引。
    if (~photon_arrival_sim.is_interval_valid(intervals))
        error('input interval is invalid')
end检查区间是否有效:
调用 is_interval_valid 方法来检查输入的区间是否有效(即存所有区间的起始点小于结束点)。
    if size(values,2) ~= 1 || size(values,1) ~= size(intervals,1)
        error('Dimension mismatch: values must be an N-by-1 column vector and intervals must be an N-by-M array.');
end检查维度是否匹配:
-
检查
values是否是一个 N-by-1 的列向量。 -
检查
intervals是否是一个 N-by-M 的二维数组。 -
如果
values和intervals的维度不匹配,抛出错误。
    idx = sum(values > intervals, 2);
end计算每个值在区间中的位置:
使用逻辑运算符 > 来确定每个值在区间中的位置,并返回索引。
-
values > intervals:这是一个逻辑运算,比较values中的每个值与intervals中的每个起始点。-
例如,如果
values = [2; 5]和intervals = [1, 3; 4, 6],则比较结果为:[2 > 1, 2 > 3; 5 > 4, 5 > 6] = [true, false; true, false]
-
-
sum(..., 2):沿着第二维(列)计算逻辑数组中true的数量。-
对于上述例子,结果为:
[1; 1]
-
-
因此,
idx表示每个值大于多少个区间的起始点。
count_freq:计算每个值在数组中出现的频率
统计 nums 中每个值在 values 中出现的次数。换句话说,它计算 values 中每个值在 nums 中出现的频率。
function res = count_freq(nums, values)-
输入参数:
-
nums:一个数组,表示一系列的数值。 -
values:一个数组,表示需要统计频率的值。
-
-
输出参数
res:一个与values同样长度的数组,表示每个值在nums中出现的频率。
res = zeros(length(values), 1);初始化结果数组:
-
创建一个与
values同样长度的零数组res,用于存储每个值的频率。
    for i = 1 : length(values)
        res(i) = sum(nums == values(i));
    end
end
遍历 values 中的每个值:
遍历 values 中的每个值,统计它在 nums 中出现的次数,并将结果存储在 res 中。
-
对于每个值
values(i),使用逻辑运算符==比较nums中的每个元素是否等于values(i)。 -
nums == values(i)会生成一个逻辑数组,其中true表示nums中的元素等于values(i),false表示不等于。使用sum函数计算逻辑数组中true的数量,即values(i)在nums中出现的次数。 -
将结果存储在
res(i)中。
get_2d_gaussian:生成一个二维高斯分布的函数句柄
function f = get_2d_gaussian(part_pos, psf_size, sig, bgd)-
输入参数:
-
part_pos:粒子的位置,通常是[x, y]坐标。 -
psf_size:点扩散函数的大小。高斯分布的标准差。 -
sig:信号强度。 -
bgd:背景噪声。
-
-
返回一个匿名函数
f,该函数接受一个位置x作为输入,并返回该位置的强度。
函数句柄(function handle)是一个数据类型,用于存储对函数的引用。通过函数句柄,你可以调用函数,就像直接调用函数一样。函数句柄可以作为参数传递给其他函数,或者存储在数据结构中以便稍后调用。
% returns a function handle used to query (absolute) intensity
    f = @(x) sig.*1./sqrt(2*pi)/psf_size.*exp(-(get_dist2(part_pos, x)).^2/psf_size^2) + bgd;
end-
@(x):定义一个匿名函数,输入参数为x,表示查询位置。 -
sig.*1./sqrt(2*pi)/psf_size:计算高斯分布的归一化系数。-
sig是信号强度。 -
1./sqrt(2*pi)/psf_size是高斯分布的标准归一化系数。
-
-
exp(-(get_dist2(part_pos, x)).^2/psf_size^2):计算高斯分布的核心部分。-
get_dist2(part_pos, x):计算粒子位置part_pos和查询位置x之间的平方距离。 -
-(get_dist2(part_pos, x)).^2/psf_size^2:将平方距离代入高斯分布的指数部分。
-
-
+ bgd:加上背景噪声。
get_photon_arrival_data:生成光子到达数据
计算每个探测器接收到的光子数量(光子的平均强度),模拟光子到达探测器的过程,确定每个光子到达的探测器位置。并生成每个光子的到达位置数据,打乱顺序。
function [em_rate, n, data] = get_photon_arrival_data(N, part_pos, detector_pos, psf_size, sig, bgd)-
输入参数:
-
N:模拟的光子数量。 -
part_pos:粒子的位置。 -
detector_pos:探测器的位置。 -
psf_size:点扩散函数的大小。 -
sig:信号强度。 -
bgd:背景噪声。
-
-
输出参数:
-
em_rate:每个探测器接收到的光子的平均强度。 -
n:每个探测器接收到的光子数量。 -
data:每个光子的到达位置数据。
-
    n_detector = length(detector_pos(:, 1));
    f = photon_arrival_sim.get_2d_gaussian(part_pos, psf_size, sig, bgd);

    % measured intensity = mean of intensity at all detector pos
    detector_int = f(detector_pos);
    em_rate = mean(detector_int);
计算每个探测器位置的强度:
-
计算探测器的数量,
detector_pos是一个二维数组,每行表示一个探测器的位置。 -
调用
get_2d_gaussian函数,生成一个高斯分布的函数句柄f,用于计算任意位置的强度。 -
使用函数句柄
f计算每个探测器位置的强度detector_int。 -
计算所有探测器位置的平均强度
em_rate。
    % probability to receive a photon at given detector position
    norm_detector_int = detector_int./sum(detector_int);
计算每个探测器接收到光子的概率:
将每个探测器的强度归一化,使它们的总和为 1。这表示每个探测器接收到光子的概率,存在norm_detector_int 数组中。
    rand_nums = rand(N, 1);
idx = photon_arrival_sim.query_intervals(rand_nums, repmat([0, cumsum(norm_detector_int')], [N, 1]));查询光子到达的探测器位置:
-
生成
N个随机数,每个随机数在 [0, 1) 范围内,生成光子到达的探测器位置。 -
使用
query_intervals函数返回每个随机数对应的区间索引idx。根据归一化强度和随机数,确定每个光子(每个随机数rand_nums)到达的探测器位置。 -
cumsum(norm_detector_int')计算归一化强度的累积和,生成一个区间数组。norm_detector_int'是norm_detector_int的转置,确保它是一个行向量。
cumsum函数计算数组的累积和。例如:假设
norm_detector_int = [0.2,0.3,0.5];那么
cumsum(norm_detector_int') = [0.2,0.5,1.0];
[0, cumsum(norm_detector_int')] = [0,0.2,0.5,1.0];表示每个探测器的累积概率区间。这个数组表示:
第一个探测器的区间是 [0, 0.2)
第二个探测器的区间是 [0.2, 0.5)
第三个探测器的区间是 [0.5, 1.0)
-
repmat([0, cumsum(norm_detector_int')], [N, 1])将区间数组复制N次,以便对每个光子进行查询。
repmat函数用于复制数组。这里,它将区间数组[0, cumsum(norm_detector_int')]复制N次,形成一个N行的矩阵,每一行都表示相同的区间数组。例如,假设
N = 3:
repmat([0, cumsum(norm_detector_int')], [N, 1]) =
[ 0,0.2,0.5,1.0;
0,0.2,0.5,1.0;
0,0.2,0.5,1.0;
];
    % n: number of photons received at each detector position
    n = photon_arrival_sim.count_freq(idx, 1:n_detector);
计算每个探测器接收到的光子数量:
使用 count_freq 函数,统计每个探测器接收到的光子数量。
    % each simulated photon arrival position
    data = [];
    for i = 1 : n_detector
        data = [data; repmat(detector_pos(i, :), [n(i), 1])];
    end

    % shuffle each row
    data = data(randperm(sum(n)), :);
end
生成每个光子的到达位置数据,并打乱顺序:
-
遍历每个探测器,根据每个探测器接收到的光子数量
n(i),生成每个光子的到达位置数据。 -
repmat(detector_pos(i, :), [n(i), 1])将第i个探测器的位置复制n(i)次,生成一个n(i)行 2 列的矩阵,每行表示一个光子的到达位置。 -
使用
randperm函数打乱数据的顺序,使光子的到达位置数据随机化。
6. demo_sim_photon_arrival.m
%
clear; close all
sig = 10;
bgd = 1;
N = 2e3;
part_pos = [.1, .05];
pos = -.5:.25:.5;
[xx, yy] = meshgrid(pos, pos);
detector_pos = [xx(:), yy(:)];
psf_size = .1;

% 在当前位置生成2000个光子
[em_rate, n, data] = photon_arrival_sim.get_photon_arrival_data(N, part_pos, detector_pos, psf_size, sig, bgd);

% 下面模拟particle移动的情形

dwell_time = 10; % 在每个点停留的时间
dwell_pos = [-.1:.02:.1]';
dwell_pos(:, 2) = 0; % 一系列停留的位置

center_int = 1e5; % 在中心点时的光强

% 先跑一遍确定一下各点探测到的光强
n_dwell_pos = length(dwell_pos(:, 1));

int_data = [];
for i = 1 : n_dwell_pos
    [curr_em_rate, ~, ~] = photon_arrival_sim.get_photon_arrival_data(1, dwell_pos(i, :), detector_pos, psf_size, sig, bgd);
    int_data(i) = curr_em_rate;
end

figure; plot(dwell_pos(:, 1), int_data, 'r-');xlabel('x [um]');ylabel('int [a.u.]')

% 生成模拟数据,注意不同位置的光强差异

curr_t = 0;

% 每个dwell position需要的光子数
photon_count = floor(center_int.*int_data./int_data(ceil(length(int_data)/2))*dwell_time);
photon_arrival_data = [];

for i = 1 : n_dwell_pos
    curr_photon_count = photon_count(i);
    [~, ~, tmp_data] = photon_arrival_sim.get_photon_arrival_data(curr_photon_count, dwell_pos(i, :), detector_pos, psf_size, sig, bgd);
    tmp_data = [tmp_data, linspace(0, 1, curr_photon_count)'.*dwell_time + curr_t];
    photon_arrival_data = [photon_arrival_data; tmp_data];
    curr_t = curr_t + dwell_time;
end

% 分析基于每2000个光子的x,y位置
bin_sz = 2000;
x_est = [];
y_est = [];
t = [];
for i = 1 : bin_sz : length(photon_arrival_data(:, 1)) - bin_sz
    x_est = [x_est, mean(photon_arrival_data(i : i + bin_sz, 1))];
    y_est = [y_est, mean(photon_arrival_data(i : i + bin_sz, 2))];
    t = [t, mean(photon_arrival_data(i : i + bin_sz, 3))];
end
figure; hold on; plot(t, x_est, 'b-'); plot(t, y_est, 'r-'); xlabel('time [s]'); ylabel('est. position [um]')
用于模拟粒子在不同位置的光子到达时间,以及粒子在这些位置上的预期光强。
初始化参数
% clear; close all
sig = 10;
bgd = 1;
N = 2e3;
part_pos = [.1, .05];
pos = -.5:.25:.5;
[xx, yy] = meshgrid(pos, pos);
detector_pos = [xx(:), yy(:)];
psf_size = .1;-
清除所有变量和关闭所有图形窗口。
-
设置信号强度
sig和背景强度bgd。 -
定义要模拟的光子数量
N = 2000。 -
定义粒子的初始位置
part_pos。 -
pos是一个向量,表示在一维空间中的位置范围,从 -0.5 到 0.5,步长为 0.25。 -
meshgrid函数基于pos向量创建一个二维网格,xx和yy分别代表网格的 x 和 y 坐标矩阵。meshgrid函数会将pos数组在 x 和 y 方向上分别扩展,生成两个矩阵xx和yy。xx的每一行都是pos,yy的每一列都是pos。这样,xx和yy的组合就表示了二维平面上的所有点的坐标。xx = -0.5000 -0.2500 0 0.2500 0.5000 -0.5000 -0.2500 0 0.2500 0.5000 -0.5000 -0.2500 0 0.2500 0.5000 -0.5000 -0.2500 0 0.2500 0.5000 -0.5000 -0.2500 0 0.2500 0.5000 yy = -0.5000 -0.5000 -0.5000 -0.5000 -0.5000 -0.2500 -0.2500 -0.2500 -0.2500 -0.2500 0 0 0 0 0 0.2500 0.2500 0.2500 0.2500 0.2500 0.5000 0.5000 0.5000 0.5000 0.5000 -
detector_pos是一个矩阵(二维数组),通过将xx和yy矩阵展平(使用(:)操作),创建一个包含所有网格点坐标的矩阵,用于表示探测器上所有可能的位置。每一行表示一个探测器的位置,第一列是 x 坐标,第二列是 y 坐标。detector_pos = -0.5000 -0.5000 -0.5000 -0.2500 -0.5000 0 -0.5000 0.2500 -0.5000 0.5000 -0.2500 -0.5000 -0.2500 -0.2500 -0.2500 0 -0.2500 0.2500 -0.2500 0.5000 0 -0.5000 0 -0.2500 0 0 0 0.2500 0 0.5000 0.2500 -0.5000 0.2500 -0.2500 0.2500 0 0.2500 0.2500 0.2500 0.5000 0.5000 -0.5000 0.5000 -0.2500 0.5000 0 0.5000 0.2500 0.5000 0.5000 -
定义点扩散函数
psf_size的大小,用于模拟光子检测过程中的扩散效应。
生成光子到达数据
在粒子当前位置生成2000个光子的到达数据。
[em_rate, n, data] =
photon_arrival_sim.get_photon_arrival_data
(N, part_pos, detector_pos, psf_size, sig, bgd);
输出参数:
-
这个变量表示光子的发射率(emission rate),单位通常是光子每秒(photons per second)。它反映了在给定条件下,粒子发射光子的速率。em_rate -
这个变量表示实际生成的光子数量。虽然函数的输入参数nN指定了期望的光子数量,但由于随机性或其他因素,实际生成的光子数量可能略有不同。n提供了实际生成的光子数量。 -
这是一个矩阵,包含了每个光子的光子的到达位置data
输入参数:
-
这是期望生成的光子数量。NN = 2e3,即期望生成 2000 个光子。 -
这是一个二维数组,表示粒子的初始位置。part_pospart_pos = [.1, .05],表示粒子的初始位置在 x = 0.1 和 y = 0.05 的位置。 -
这是一个二维数组,表示探测器的位置。detector_posdetector_pos是通过meshgrid生成的,包含了探测器所有可能的位置。每个位置由其 x 和 y 坐标表示。 -
这表示点扩散函数(Point Spread Function, PSF)的大小。PSF 描述了单个光子在探测器平面上的分布。表示为标准差(宽度)。psf_sizepsf_size = 0.1,表示 PSF 的大小为 0.1。 -
这是信号强度。sigsig = 10。 -
这是背景噪声(background)的强度。bgdbgd = 1,表示背景噪声的强度为 1。
模拟粒子移动
模拟了一个粒子在一系列位置上停留,并测量每个位置的光强。通过绘制光强随位置变化的曲线,可以直观地看到光强在不同位置的变化情况。
dwell_time = 10; % 在每个点停留的时间
dwell_pos = [-.1:.02:.1]';
dwell_pos(:, 2) = 0; % 一系列停留的位置
定义停留时间和位置:
-
dwell_time:粒子在每个位置停留的时间,这里设置为 10 。 -
dwell_pos:定义了一系列粒子停留的位置。[-.1:.02:.1]生成了一个从 -0.1 到 0.1 的数组,步长为 0.02。然后通过转置操作',将其变为列向量。 -
dwell_pos(:, 2) = 0将所有停留位置的 y 坐标设为 0,表示粒子只在 x 轴方向上移动。
center_int = 1e5; % 在中心点时的光强定义中心点的光强:
center_int:在中心点(x = 0)时的光强,这里设置为 100,000。
计算每个停留位置的光强:
n_dwell_pos = length(dwell_pos(:, 1)); % 停留位置的数量
int_data = []; % 初始化光强数据数组
for i = 1 : n_dwell_pos
    [curr_em_rate, ~, ~] = photon_arrival_sim.get_photon_arrival_data(1, dwell_pos(i, :), detector_pos, psf_size, sig, bgd);
    int_data(i) = curr_em_rate;
end-
n_dwell_pos:计算停留位置的数量。dwell_pos是一个二维数组,其中每一行表示一个停留位置的坐标。dwell_pos(:, 1)提取了所有停留位置的 x 坐标。 -
int_data:初始化一个空数组,用于存储每个停留位置的光强。 -
循环遍历每个停留位置(从 1 到
n_dwell_pos),计算每个停留位置的光子发射率 :-
调用
photon_arrival_sim.get_photon_arrival_data函数,传入参数:-
1:表示只模拟 1 个光子。 -
dwell_pos(i, :):当前停留位置。表示第i个停留位置的坐标。 -
detector_pos:探测器位置。 -
psf_size、sig、bgd:PSF 大小、信号强度和背景噪声。
-
-
函数返回光子的发射率
curr_em_rate,将其存储到int_data数组的第i个位置中。 -
~:表示忽略其他两个输出参数(n和data),因为这里只需要光子发射率。
-
figure; % 创建一个新图形窗口
plot(dwell_pos(:, 1), int_data, 'r-'); % 绘制光强随位置变化的曲线
xlabel('x [um]'); % x 轴标签
ylabel('int [a.u.]'); % y 轴标签
绘制光强随位置变化的图像:
-
figure:创建一个新的图形窗口。 -
plot(dwell_pos(:, 1), int_data, 'r-'):绘制光强int_data随位置dwell_pos(:, 1)变化的曲线,使用红色实线表示。 -
xlabel('x [um]'):设置 x 轴标签为 "x [um]"。 -
ylabel('int [a.u.]'):设置 y 轴标签为 "int [a.u.]"(光强,单位为任意单位)。
生成模拟数据
模拟粒子在一系列停留位置(dwell_pos)上移动时,每个位置上发射的光子到达探测器的数据。具体来说,它计算每个停留位置需要的光子数量,并生成这些光子的到达时间和位置信息。
curr_t = 0;初始化当前时间:
curr_t:初始化当前时间为 0,表示模拟的起始时间。
photon_count =
floor(center_int.*int_data./int_data(ceil(length(int_data)/2))*dwell_time);
计算每个停留位置需要的光子数:
-
center_int:中心点的光强(100,000)。 -
int_data:每个停留位置的光强数据,之前通过模拟计算得到。 -
int_data(ceil(length(int_data)/2)):找到int_data中的中心值。假设int_data的长度是奇数,ceil(length(int_data)/2)会取中间位置的光强值。如果长度是偶数,取中间两个值中的第一个。 -
center_int.*int_data./int_data(ceil(length(int_data)/2)):计算每个位置的光强相对于中心光强的比例,然后乘以中心光强,得到每个位置的实际光强。 -
floor(...*dwell_time):将每个位置的实际光强乘以停留时间dwell_time,并向下取整,得到每个位置需要的光子数量。floor函数确保光子数量是整数。
photon_arrival_data = [];初始化光子到达数据数组:
photon_arrival_data:初始化一个空数组,用于存储所有光子的到达时间和位置信息。
for i = 1 : n_dwell_pos
    curr_photon_count = photon_count(i);
    [~, ~, tmp_data] = photon_arrival_sim.get_photon_arrival_data(curr_photon_count, dwell_pos(i, :), detector_pos, psf_size, sig, bgd);
    tmp_data = [tmp_data, linspace(0, 1, curr_photon_count)'.*dwell_time + curr_t];
    photon_arrival_data = [photon_arrival_data; tmp_data];
    curr_t = curr_t + dwell_time;
end
循环生成每个停留位置的光子数据:
-
循环变量
i:从 1 到n_dwell_pos,依次遍历每个停留位置。 -
curr_photon_count:当前停留位置需要的光子数量。 -
photon_arrival_sim.get_photon_arrival_data函数调用:-
输入参数:
-
curr_photon_count:当前停留位置需要的光子数量。 -
dwell_pos(i, :):当前停留位置的坐标。 -
detector_pos:探测器的位置。 -
psf_size:点扩散函数(PSF)的大小。 -
sig:信号强度。 -
bgd:背景噪声的强度。
-
-
输出参数:
-
~:忽略前两个输出参数(光子发射率和实际生成的光子数量)。 -
tmp_data:包含每个光子的到达时间和位置信息的矩阵。
-
-
-
linspace(0, 1, curr_photon_count)':生成一个从 0 到 1 的线性间隔数组,长度为curr_photon_count,表示每个光子在停留时间内的相对时间。然后乘以dwell_time,得到每个光子的实际到达时间。 -
tmp_data = [tmp_data, linspace(0, 1, curr_photon_count)'.*dwell_time + curr_t]:将每个光子的到达时间添加到tmp_data的最后一列。curr_t是当前停留位置的起始时间。 -
photon_arrival_data = [photon_arrival_data; tmp_data]:将当前停留位置的光子数据追加到photon_arrival_data数组中。 -
curr_t = curr_t + dwell_time:更新当前时间,为下一个停留位置做准备。 -
photon_arrival_data:包含所有光子的到达时间和位置信息的矩阵。每一行表示一个光子到达的坐标
分析光子位置
模拟的光子到达数据中提取粒子的位置信息,并绘制粒子随时间的位置变化曲线。具体来说,它将光子数据分段(每段包含一定数量的光子),计算每段的平均位置(x 和 y),然后绘制这些平均位置随时间的变化。
bin_sz = 2000;
x_est = [];
y_est = [];
t = [];
初始化变量:
-
bin_sz:定义了每个分段(bin)的光子数量,这里设置为 2000 个光子。 -
x_est:初始化一个空数组,用于存储每个分段的平均 x 坐标。 -
y_est:初始化一个空数组,用于存储每个分段的平均 y 坐标。 -
t:初始化一个空数组,用于存储每个分段的平均时间。
for i = 1 : bin_sz : length(photon_arrival_data(:, 1)) - bin_sz
    x_est = [x_est, mean(photon_arrival_data(i : i + bin_sz, 1))];
    y_est = [y_est, mean(photon_arrival_data(i : i + bin_sz, 2))];
    t = [t, mean(photon_arrival_data(i : i + bin_sz, 3))];
end
循环处理光子数据:
-
循环变量
i:从 1 开始,每次增加bin_sz,直到length(photon_arrival_data(:, 1)) - bin_sz。这样可以确保每个分段包含bin_sz个光子。 -
photon_arrival_data(i : i + bin_sz, 1):提取第i个到第i + bin_sz个光子的 x 坐标。 -
mean(photon_arrival_data(i : i + bin_sz, 1)):计算这些 x 坐标的平均值,得到当前分段的平均 x 坐标。 -
x_est = [x_est, mean(photon_arrival_data(i : i + bin_sz, 1))]:将当前分段的平均 x 坐标添加到x_est数组中。 -
y_est和t:类似地,计算每个分段的平均 y 坐标和平均时间,并将它们分别添加到y_est和t数组中。
figure; hold on; plot(t, x_est, 'b-');
plot(t, y_est, 'r-');
xlabel('time [s]');
ylabel('est. position [um]');
绘制位置变化曲线:
-
figure:创建一个新的图形窗口。 -
hold on:保持当前图形窗口,允许在同一个图上绘制多条曲线。 -
plot(t, x_est, 'b-'):绘制平均 x 坐标随时间的变化曲线,使用蓝色实线表示。 -
plot(t, y_est, 'r-'):绘制平均 y 坐标随时间的变化曲线,使用红色实线表示。 -
xlabel('time [s]'):设置 x 轴标签为 "time [s]"。 -
ylabel('est. position [um]'):设置 y 轴标签为 "est. position [um]"。

 1061


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


