【AI x FPGA自学笔记】基于参数化FPGA的通用在线神经网络的开发与实现

FPGA实现BP神经网络-原理 FPGA实现BP神经网络 激活函数 1.神经网络激励函数的选择和实现方法 下面将介绍BP神经网络常用的激活函数。 1.1 简单线性函数 神经元功能函数 f 连续取值,输入 x 由连接矩阵 W 加权产生输出,如图: 1.2 Sigmid函数 神经元的输出限制在[-1 :+1]之间的连续非减函数,此时称为双极性Sigmoid函数;同理,当此函数最小值向上平移1个单位长度后,神经元的输出限制在[0 :+1]之间的连续非减函数,此时成为单极性Sigmoid函数。我们生活中默认的S函数指的就是双极性Sigmoid 阅读详情

通过利用FPGA的可重构性,将基于参数化软件的人工神经网络(ANN)和ANN模拟器的灵活性转移到硬件平台上。这样做,我们将使用户能够在硬件上高效地探索设计空间和原型,正如现在在软件中所能做到的那样。

先前研究:羊群抗虫线虫检测的人工神经网络FPGA实现

MLP的构建

由于多层感知器神经网络(multi layer perceptron neural network(MLP))在数据分类和数据估计方面具有很高的效率,我们使用MLP来构建网络。

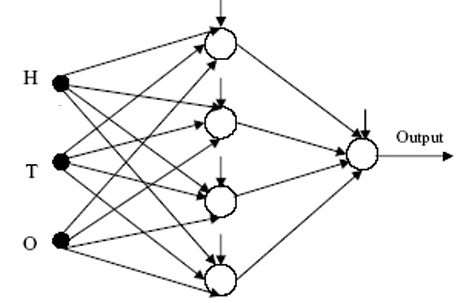
为了制作表1中的人工神经网络数据,使用一些羊群的兽医数据作为神经网络的输入和输出。这些统计数据的目的是建立一个多层感知网络(图1),用于模式识别和数据分类。MLP将用于苯并咪唑(BZD)耐药线虫的鉴定。
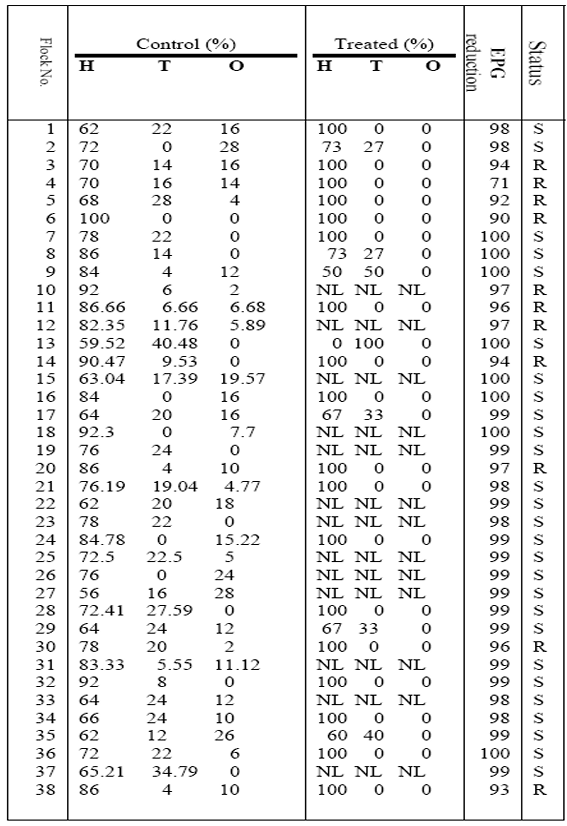
表1:显示了在药物注射前后受测畜群中
H、T、O寄生虫存在的百分比
图1:绵羊BZD耐药线虫多层感知器的构建

对于神经网络的训练,采用一种简单的反向传播方法来达到期望的最小误差。然后将训练得到的权重和偏置因子(bias factors)用于FPGA上的硬件安装。

所有在表1中给出的38行有三个输入和一个用于训练网络的输出。这38行中,前34行数据作为训练数据,后4行作为验证数据。

采用了一个具有一个隐藏层的网络来构建一个用于识别抗苯并噻二唑类杀虫剂的线虫的结构。该网络在输入层有 3 个节点(图 1),这些节点代表在对照组中临床发现的感染性幼虫(H、T 和 O)所占的百分比——这些幼虫无需对动物进行任何治疗。在网络的输出层有一个节点,其目标值被设定为 0 以对应对苯二氮䓬类药物有抗药性的线虫,而为对应易感线虫则设定为 1。网络的隐藏层有 4 个神经元,并使用了 Sigmoid 激活函数。为了训练该网络,从表 1 中选取了 1 到 34号群的数据作为训练数据,并采用反向传播学习规则来调整网络的权重。大约 300 个周期后,学习误差已经大大下降。

通过MATLAB训练得到的权重和偏倚系数如下:

W= [ 20.8274, -25.3639 , -4.8864;

        30.6564, -118.1918, -65.5309;

        43.8998, -60.2949, 145.4259;

        106.9770, -15.0551, -20.7781];

U= [117.1778;

      142.0364;

      106.8569;

      82.6105];

这些权重和偏倚系数将在后续步骤中用于训练和设计的网络的硬件安装。在获得权重和偏差系数后,将表 1 的最后 4 行应用于网络,以验证网络的正常运行情况。

ANN的FPGA实现

我们以上一节中所介绍的网络为例,在FPGA上进行实现。
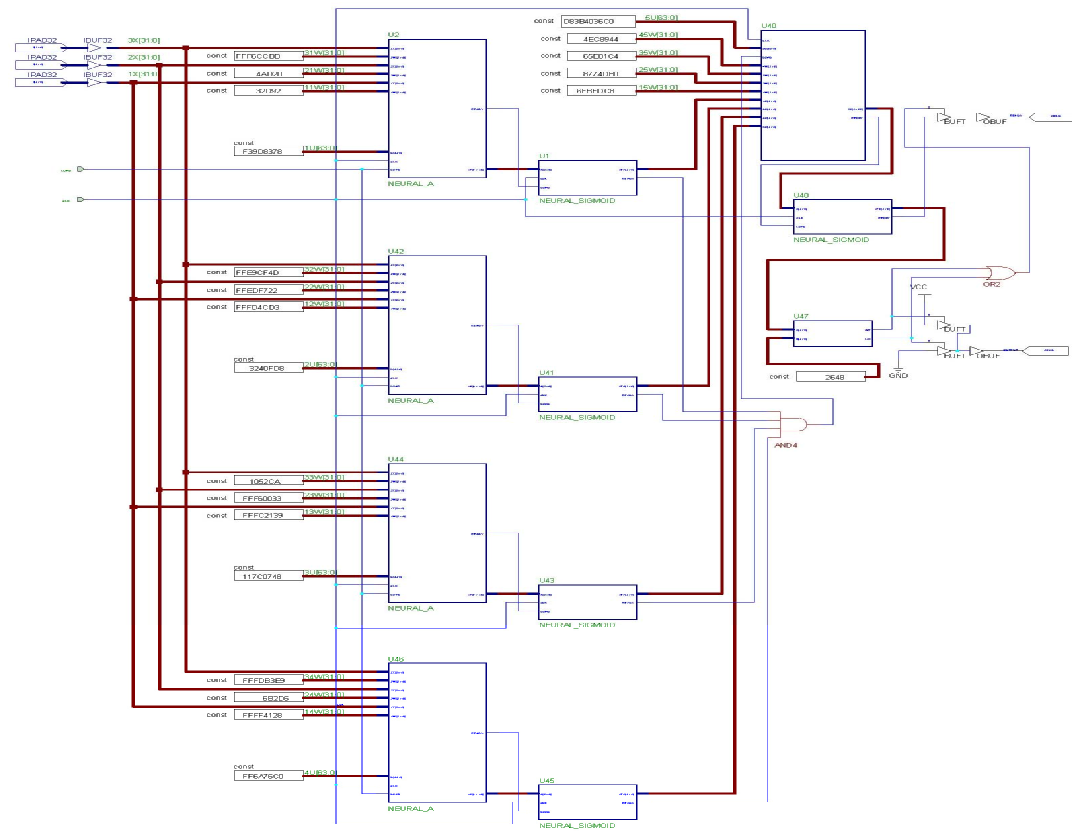
图3:在FPGA上实现网络,XLINK系列XC400

该网络在隐藏层有4个神经元,在输出层有1个神经元,每个隐藏层神经元有3个输入、3个权重因子和1个偏置因子。这些因子经过MATLAB仿真得到,现在可以认为是神经元的恒定输入。每一个隐藏层的神经元被定义为:

a_{j}=\sum ^3_{i=1}w_jx_j+u_j

为了方便地计算WX + U项,权重因子和偏差被乘以10^x倍,直到WX和U的幂相等,并且可以很容易地相加。在神经元的输出中,我们每输入10^3次乘法删除10位LSB。

在与每个隐藏神经元相关的模块中(参照图 4),我们有三个 SOP(Sum of products),其作用是获取以下结果:

a_j=\sum W_1X_1+b\\ =(W_{13}X_3+U)+(W_{12}X_2)+(W_{11}X_1)

y_1=W_{13}X_3+U被获得。它的输出是下一个神经元的输入,我们可以计算:Y_2=W_{21}X_2+Y_1

第三项也有类似的情况,Y_2是它的输入,我们可以计算:a_j=W_{11}X_1+Y_2=\sum_{i=1}W_iX_i+U,这是最后一个神经元的输出。

在每个隐藏神经元的输出路径上有一个单极sigmoid函数(single pole sigmoid function):o_j=\frac{1}{1+e^{-a_j}}

隐层中每个sigmoid函数的输出是输出层中单个神经元的输入,该神经元有4个输入、4个权重因子和1个偏置因子。所以在输出层的神经元中,我们有四个SOP块。如图3所示,我们可以获得:

a_5=\sum W_{JI}O_I+U_J\\ =W_{11}O_1+W_{21}O_2+W_{31}O_3+W_{41}O_4+U

因此,在这个神经元中,Y_1=W_{41}O_4+U首先由SOP1计算获得。然后将Y1作为SOP2的输入,获得Y_2=W_3O_3+Y_1。用类似的方法我们可以得到:Y_3=W_{21}O_2+Y_2。最后SOP4给出:a_5=Y_3+W_{11}O_2

SOP4的输出为单极sigmoid函数,函数为:O_5=\frac{1}{1+e^{-a_5}}

O5进入比较器,与数字98(阈值)进行比较,如果大于等于98,则将1视为网络输出,如果小于98,则将0视为输出。

图4:对输入神经元执行aj = ∑ wji oi + uj

硬件实现

硬件架构的视图。实箭头表示哪些组件总是生成。虚箭头表示根据给定参数可能会生成或可能不会生成的组件。

请注意,本研究仅限于实现具有反向传播学习算法的前馈多层感知器(MLP)。此外,像层数、神经元数量、输入输出大小、互连类型等设计参数,受到可用硬件资源的限制,这取决于所用的FPGA类型。没有通用规则。必须通过实验来推导限制。

数据表示

我们的网络具有可选择的数据宽度(data width),分为整数部分和小数部分。例如,我们的实现包括一个符号位(sign bit, S)、一个整数位(integer place, I)和三个小数位(fractional places, F):SI.FFF

由此可知,网络数据精度(data precision)为2^{-F}(在我们的例子中为0.125),F为小数位的数量,并给数据集D设定最大范围为-2^{N-1}\leq D\leq 2^{N-1}-2^{-F}(在我们的例子中为-2 ≤ D ≤ 1.875),N = 1 + I + F 为总数据宽度(在我们的例子中,I=1,F=3)。

处理部件(PE)

在将PE组件的设计简化到其基本特征时,我们得到一个具有与前一层的神经元数量相等的宽度的乘加函数(multiply accumulate function),选定的压缩函数(squashing function)实现,以及包含突触权重(synaptic weights)和输入缓冲区(input buffers)的存储元素,例如寄存器。

PE由方程(1)y_k = \varphi_k(v_k)和(2)v_k = \sum_{j} w_{kj} i_{kj} + \theta_k描述:

  1. \varphi_k是是处理部件k的压缩函数,其作用是限制局部字段(local field)的值。
  2. w_{k j}是连接上层神经元 j 与神经元 k 的突触权重。
  3. \theta_k是神经元的偏差。

方程(1)是按层顺序计算的,从接收输入层输入的第一个隐藏层开始,到输出层,生成一个与一个输入向量对应的输出向量。网络的行为由其权重和偏差的值所定义。因此,在网络训练中,权重和偏差是训练的对象。训练是在每次网络的前向传递后使用反向传播算法(backpropagation algorithm)进行的。

PE的完整计算如图5所示。在图5中,MACC单元将输入与权重和偏置相乘并求和,以实现\sum_{j} w_{kj} i_{kj} + \theta_k。之后,从MACC得到的最终数量通过压缩函数\varphi(见图右上角)传递,以产生网络输出y。如图5所示,压缩函数利用查找表(lookup table (LUT))(通过“lut_en”指令),如下所述。

图5:PE组件的功能块

压缩函数(Squashing Function)

所选择的非线性压缩函数的直接实现,例如 sigmoid 函数 [参考方程 (6)\varphi(v_j) = \frac{1}{1 + e^{-\alpha v_j}}和 (7)\varphi(v_j) = \frac{e^{\alpha v_j} - e^{-\alpha v_j}}{e^{\alpha v_j} + e^{-\alpha v_j}}.],在硬件上存在一个问题,因为除法和指数运算都需要耗费大量的时间和硬件资源来计算。在硬件中,唯一可行的方法是对该函数进行近似 。然而,为了使训练收敛或获得准确的离线结果,必须达到最低的准确度水平。

更准确的近似将导致更快、更好的收敛,从而获得更准确的结果。已经有大量的研究探讨如何在硬件中有效地近似sigmoid函数,同时保持可接受的准确度和在反向传播学习中所需的连续性。为了创建一个通用设计,我们必须为sigmoid函数的近似添加一个额外的要求,即近似方法必须适用于多种sigmoid函数。

我们可以为在我们的通用设计中实现的 sigmoid 函数选择两种实现风格之一:统一查找表(uniform LUT)或带线性插值(linear interpolation,即通过假设一个函数(如对数函数)在已知值之间是一条直线来估计该函数的方法)的 LUT。

1. 统一查找表(uniform LUT):在块RAM中实现的统一LUT可以用来近似任何形状的函数。LUT通过局部字段(local field)进行寻址。地址是通过取局部字段的符号位的反转,并连接表示映射到LUT的函数的最高输入值所需的最高有效位,直到LUT的地址位数。总的来说,计算只需一个周期,并且所需的硬件仅限于保存表本身。

2. 带线性插值的查找表(LUT With Linear Interpolation):为了应对统一LUT准确度降低的问题,同时保持对各种函数的归纳,我们结合了线性插值和LUT。该解决方案有效地在统一LUT的每个点之间绘制了一条线。最终的激活函数是y=\frac{LUT(d+1)-LUT(d)}{2^{N-M}}q_e+LUT(d)。LUT(d)是由统一LUT返回的值,代表目标函数在索引d上的值;N是局部字段的位宽;M 是 LUT 地址总线的位宽;q_e是量化误差,且q_e=\varphi(v)-LUT(d)

通过将线性插值技术应用于统一查找表(LUT),可以显著减少所需LUT的大小,同时在实现一个加法器和一个乘法器的成本下保持相同的准确度。

反向传播(Backpropagation)算法

由于反向传播算法一次只针对一层执行,我们只需要一套必要的算术组件。

由于乘法器和加法器的数量,以及MACC的大小依赖于给定层及其前驱层的大小,我们必须计算并生成在给定网络设计的详细说明过程中所需的最坏情况下的算术组件数量。用于反向传播计算的算术组件集合随后被打包成BP ALU组件。

BP ALU 由每个反向传播教师(backpropagation teacher)通过一个自动生成的多路复用器(图8)访问,该多路复用器由网络控制器控制。

图8:反向传播的实现
图9:网络控制器的状态机

网络控制器

网络控制器的设计受到网络高度通用设计的强度指导,以及最初决定将功能单元和控制单元(functional and control units)分开的影响。中央控制网络的决策基于的目标是:最小化那些必须多次生成的组件的大小(size)和复杂性(complexity)。

根据生成的网络,网络控制器可以创建为在线(online)或离线(offline)网络控制器。这里,离线表示网络是预训练的,然后网络对象用于测试数据,而没有任何训练能力。这种类型的网络通常由于实现复杂性较低而在硬件实现中使用。另一方面,在线表示网络具有动态训练能力。对于不同的应用,具有不同架构的网络会根据特定的训练方法进行自我训练,例如反向传播,然后再对测试数据进行处理。这提供了一种通用的灵活性,但实现起来较为复杂。

由于在离线模式下生成了一个管道网络(pipelined network),因此需要不同的实现,在线控制器必须包含反向传播算法计算的控制。尽管如此,这两个控制器的实现方式是相同的。

网络控制器是一个Mealy状态机(见图9),基于一个计数器,该计数器指示当前迭代中经过的时钟周期数量(在在线网络的情况下)或经过的总时钟周期数量(在离线网络的情况下)。如上所述,对于在线应用,我们需要具有学习能力的网络。需要注意的是,对于反向传播学习算法,误差需要被反馈(fed back)。因此,Mealy状态机是合适的,因为它是一个有限状态转换器,根据其当前状态和输入生成输出。计数器的值必须有意义,我们必须能够预先计算达到网络的前向和反向传递中的里程碑的延迟。这些里程碑在设计的详细阐述中进行计算。基于这些里程碑,状态机输出一组使能信号以控制网络的流动。相比之下,对于离线应用,不需要训练,因此在网络控制器状态机中不需要反向传递(见图9)。

参考文献:

Development and Implementation of Parameterized FPGA-Based General Purpose Neural Networks for Online Applications (2011)

FPGA implementation of an ANN for detection of anthelmintics resistant nematodes in sheep flocks (2009)

基于FPGA的卷积神经网络实现(一)简介 目录: 简介 框架 资源分配(1) 资源分配(2) 数据量化(1) 数据量化(2) 数据读写 卷积模块 池化、全连接与输出 事先声明,仅用于记录和讨论,有任何问题欢迎批评指正,只是觉得菜的大佬们请绕路,就不用在这里说大实话了,因为本身就是一个粗糙的demo。ISE的v文件在github,由于大家想要vivado工程,我就做了一个,有点大,传到了百度网盘。 链接:https://pan.baidu.com/s/1OEUPTEQ3miRcPFCaWy-3MA 提取码:bqit 提起把项目代码讲解一下的念头主 阅读详情

相关推荐

从神经元到FPGA:揭秘可编程硬件如何成为AI加速的理想载体

在计算机体系结构中,并行处理和硬件加速是提升计算性能的核心技术。其原理在于通过专用电路或可重构逻辑,将算法直接映射到硬件层面执行,从而突破传统处理器串行执行的瓶颈。这种技术价值在于能实现极高的能效比和低延迟,特别适合处理规则化、数据密集型的任务。在应用场景上,从早期的信号处理、图像识别到当前火热的人工智能推理与训练,硬件加速已成为不可或缺的一环。本文聚焦于现场可编程门阵列这一关键技术平台,它通过可编程逻辑单元和互连资源,允许开发者自定义计算架构,为神经网络等并行算法提供接近底层、灵活高效的实现载体,是连接算

weixin_30628801的博客 313

基于FPGA的一维卷积神经网络算法实现(1D-CNN、BNN的FPGA加速实现)

本文介绍一种基于FPGA的1维卷积神经网络算法加速实现的方案,其中为了进一步提升运算速度,除了第一层卷积采用的是普通卷积运算(CONV),其余卷积层和池化层采用的是二值化运算,即二值化的卷积与池化。 运算过程包含了卷积层、池化层、批标准化层、全局池化、二值化卷积、全连接层、激活函数层,均采用RTL级代码实现,即全部采用Verilog HDL代码实现,兼容Intel Altera FPGA 与 AMD Xilinx FPGA,便于移植。

weixin_44384867的博客 6005

Github 上值得关注的 VHDL/Verilog/FPGA 开源项目精选

本文精选了Github上值得关注的VHDL/Verilog/FPGA开源项目,涵盖处理器设计、通信协议、AI加速器等关键领域。重点推荐了RISC-V生态明星项目PicoRV32和VexRiscv,以及高速以太网方案verilog-ethernet等实用工具,帮助开发者快速构建硬件解决方案并提升开发效率。

whisky的博客 1030

FPGA部署神经网络流程和方法

好的。 部署神经网络到FPGA的流程大致如下: 选择合适的FPGA芯片和开发板,确定所需的硬件资源。 在计算机上训练神经网络模型。 将训练好的模型转换为适用于FPGA的格式,通常使用High Level Synthesis(HLS)工具进行转换。 使用FPGA开发工具,如Xilinx Vivado或Intel Quartus,将转换后的代码编译为FPGA可以运行的硬件电路。 将编译好的电...

weixin_35756690的博客 3820

TPU核心脉动阵列RTL实现:从原理到FPGA验证的AI硬件加速实践

在AI硬件加速领域,矩阵乘加运算是深度神经网络的核心计算模式,其性能直接决定了AI推理的效率和能耗。传统冯·诺依曼架构面临“内存墙”瓶颈,即数据搬运的能耗远高于计算本身。为解决这一问题,空间计算架构应运而生,它通过数据复用和局部通信优化计算数据流。脉动阵列作为其典型代表,采用规则排列的处理单元和同步数据流动,实现了极高的能效比。在工程实践中,通过RTL(寄存器传输级)建模可将这一架构具体化,例如在TPU中,脉动阵列以权重固定、输入脉动的方式执行卷积和全连接运算。这不仅能显著降低对外部存储器的带宽需求,还为F

weixin_33701294的博客 329

FPGA中Cordic算法原理与实现优化

Cordic算法是一种硬件友好的数值计算方法,通过移位和加法实现超越函数计算,特别适合FPGA实现。其核心原理是将旋转角度分解为一系列固定角度迭代,利用arctan(2^-i)特性将乘法转化为移位操作。这种算法在数字信号处理中具有重要价值,可实现低资源消耗、高吞吐量的三角函数、开方等运算。典型应用包括数字下变频器、电机控制Park变换等场景。FPGA实现时需考虑定点数优化、流水线设计和精度配置,在雷达信号处理、5G通信等领域展现出色性能。通过相位压缩和混合精度等技术,可进一步提升Cordic在Xilinx等

weixin_34226182的博客 452

当LeNet-5遇见大模型:AI辅助FPGA开发的技术革命与边界探索

本文探讨了当经典卷积神经网络LeNet-5遇见大语言模型时,AI如何从参数生成、VerilogHDL代码辅助到调试优化等多个维度重构FPGA开发流程。通过实际案例与效率对比,揭示了AI辅助设计带来的显著效率提升,并客观分析了当前技术的能力边界与未来演进方向,为FPGA开发者提供了实用的技术洞见。

g9h0i1的博客 1031

基于FPGA的一维卷积神经网络CNN的实现(一)框架

理论建立与效果展示 正在写。。。 环境:Vivado2019.2。 Part:xcku040-ffva1156-2-i,内嵌DSP个数 1920个,BRAM 600个也就是21.1Mb。 说明:通过识别加高斯白噪声的正弦波、余弦波、三角波较简单的实例来利用FPGA实现一维CNN网络,主要是实现CNN网络的搭建。 也就是将下列数据传输至FPGA,识别出下面哪些是正弦波、余弦波、三角波,通过简单实例实践,在融会贯通。 实现流程: 训练参数:通过pytorch对10000个训练集进行训练获得训练参数,反向计算不

Crazzy_M的博客 2万+

用FPGA实现英伟达GPU的解决方案

摘要:FPGA在实现英伟达GPU核心功能上存在技术可行性,但面临显著挑战。FPGA在架构上具有硬件重构灵活性,可实现纳秒级响应和定制计算(如低精度神经网络),但其计算密度和显存带宽明显低于GPU,开发复杂度高且生态不完善。实际案例显示,FPGA在稀疏神经网络推理和图形渲染加速等特定场景能效优于GPU,混合架构可提升系统性能40%。然而,FPGA的高成本和开发门槛限制了其大规模应用,更适合军工、医疗等专用领域。总体而言,FPGA适合替代GPU的特定功能,但完全复现其通用计算能力仍不现实。(150字)

szxinmai的博客 2153

低功耗脉冲神经网络设计

本文提出一种位串行类脉冲神经网络硬件架构SHiNe,采用占空比编码和计数器实现乘积累加运算,结合输入限制与资源优化,在FPGA上实现了低功耗、低资源消耗的神经网络设计。实验表明其在MNIST任务中准确率超过90%,资源节省约45%,功耗降低25%,适用于嵌入式AI应用。

beta5的博客 426

基于Verilog的LeNet-5硬件加速器设计:从CNN算法到FPGA流水线实现

卷积神经网络(CNN)作为计算机视觉的核心算法,其计算密集型特性在软件实现时往往面临性能瓶颈。其原理在于通过卷积核与输入数据的滑动窗口进行乘累加运算,提取空间特征。为了突破通用处理器(CPU/GPU)的能效限制,硬件加速技术应运而生,通过定制化硬件设计(如FPGA)实现算法与硬件的协同优化,从而在边缘计算等场景中实现低延迟、高能效的实时推理。本文以经典的LeNet-5网络为例,深入探讨如何将CNN模型映射为高效的硬件流水线,涉及核心的卷积计算单元(PE)设计、数据流优化以及资源复用策略,最终在FPGA上实现

weixin_29184075的博客 340

基于ZYNQ FPGA的极致性能CNN加速:边缘AI推理完整指南

FPGA神经网络加速技术在边缘计算领域正发挥着越来越重要的作用,特别是在需要低延迟、高能效的AI推理场景中。本文将深入探讨基于ZYNQ FPGA的CNN硬件加速实现方案,重点分析其技术原理、架构设计和性能优势。 ## FPGA并行计算架构详解 本项目采用全并行设计理念,通过Verilog硬件描述语言实现了完整的CNN推理模块。核心架构包含多个专门优化的计算单元,每个模块都针对特定的神经网络操作

gitblog_00671的博客 1076

FPGA上实现CNN:Verilog手写卷积、定点量化与时序收敛

卷积神经网络(CNN)在FPGA上的硬件加速,本质是将算法映射为可控时序的数字电路,而非简单模型移植。其核心原理在于数据流重构——通过定点量化(如Q12.4)压缩位宽、用BRAM/URAM分层缓存权重与特征图、以流水线+并行MAC架构突破带宽墙。技术价值体现在低延迟、确定性调度和边缘端能效比优势,广泛应用于智能摄像头、工业缺陷检测等fpga图像处理场景。本文聚焦fpga fixed point 使用原理与fpga ip核 缓存 索引 重组两大工程难点,提供从Verilog手写conv2d到时序收敛的全链路实

weixin_28703507的博客 307

WARP-LUTs:基于Walsh变换的高效神经网络实现方法

在边缘计算和低功耗AI领域,查找表(LUT)技术因其硬件友好特性成为研究热点。Walsh-Hadamard变换作为一种经典的正交函数变换,能够将布尔函数表示为紧凑的系数形式。WARP-LUTs创新性地结合了Walsh变换与可微松弛训练技术,实现了无乘法运算的神经网络架构。这种方法通过Gumbel重参数化减小离散化差距,在CIFAR-10分类任务上保持准确率的同时,将参数数量减少75%,训练速度提升3倍。特别适用于FPGA部署和边缘AI设备,为粒子物理实验实时处理、物联网终端智能等场景提供了高效解决方案。

java2000.net 405

Disk Drill 使用教程

Disk Drill只需单击几下,即可恢复USB闪存驱动器上已删除的数据,包括丢失的照片,文档和其他文件类型。Disk Drill是真正的多合一应用程序,可在Mac上恢复闪存驱动器。Disk Drill将自动应用最佳的笔式驱动器恢复算法来恢复Mac数据。 USB闪存驱动器是一种传输和存储信息的好方法,但是如果错误地丢失或删除了存储在其中的文件,会发生什么呢?当您需要Mac的闪存驱动器数据恢复软件时,Disk Drill是您的最佳选择。Disk Drill将扫描您的USB闪存驱动器(也称为笔式驱动器)并查找

zjj778899的博客 1万+

【Anaconda】解决“libGL error: MESA-LOADER: failed to open iris”问题

stackoverflow中的“libGL error: MESA-LOADER: failed to open iris”问题。而在自己创建的conda环境中的lib下出现`GLIBCXX_3.4.30’ not found 的情况。在上述解决方案中,将第一行命令的lib路径换成自己创建的conda环境lib路径,运行指令,问题解决。目前问题解决,总结一下查找资料以及解决方法。运行如下命令,发现本地支持。

quintus0505的博客 5024

FPGA参数化卷积加速器设计优化与实践

卷积神经网络(CNN)加速器是嵌入式AI计算的核心组件,其设计需要平衡计算效率与资源约束。FPGA凭借可编程特性成为理想的硬件载体,通过参数化设计可动态适配不同模型结构。关键技术包括:基于HLS的流水线优化、可配置并行度架构、混合精度计算等。在Xilinx Zynq平台上实测显示,这种设计相比固定架构提升1.8倍能效比,特别适合智能摄像头、无人机等边缘设备。参数化加速器的核心价值在于实现计算资源与模型需求的精准匹配,其中AXI-Stream数据流优化和BRAM双缓冲技术可降低23%延迟。当前趋势表明,结合I

weixin_29867767的博客 365

【可不卸载重装】VS2019新建项目里没有CUDA选项

问题:VS2019 新建项目里没有CUDA选项,vs也属性没有cuda。这是因为你在Visual Studio 2019安装之前,先安装了CUDA Toolkit。

qq_62844901的博客 1319

Vitis AI学习笔记(1): Vitis AI 开发工具包概述

** 声明:文章翻译自UG1414 (v1.0) Vitis AI User Guide, 仅供学习参考。 ** 目录Vitis AI 开发工具包概述特点组件深度学习处理单元(DPU)AI Model ZooAI 优化器AI 量化器AI 编译器AI 分析器AI 库AI RuntimeFor 云计算For 边缘计算深度学习处理单元(DPU)DPU-V1 for CloudDPU-v2 for Edg......

falwat的专栏 1万+

【七】Hadoop3.3.4基于ubuntu24的分布式集群安装

本次安装实验基于苹果m2芯片的mac系统,使用vmware fusion搭建三台ubuntu24分布式虚拟机,确保在三台机器上安装了Java jdk8,并配置了免密码登录,网络互通,防火墙关闭,授时服务器已经同步。访问apche官网源,下载3.3.4版本,我们用二进制通用版即可,因为hadoop运行在java环境,跨平台性使得无需编译arm架构版本。至此,Hadoop的安装完成,包括hdfs文件存储系统,mapreduce计算框架,yarn资源管理系统均能正常、稳定使用。

qq_31412425的博客 2160

π_RL:解锁流匹配VLA强化学习后训练的关键技术与实战解析

本文深入解析了π_RL框架如何通过流匹配(flow matching)与强化学习(RL)的结合,解决视觉语言动作模型(VLA)在后训练中的关键挑战。详细介绍了Flow Noise和Flow SDE两大核心技术,以及它们在机器人控制任务中的实战效果,显著提升了模型的性能、数据效率和泛化能力。

weixin_29061531的博客 220

FPGA开发入门:从硬件描述到边缘AI推理的实践指南

现场可编程门阵列(FPGA)是一种半定制化集成电路,其核心原理在于用户可通过硬件描述语言(如Verilog/VHDL)灵活配置内部逻辑电路,从而在硬件层面实现特定功能。这种可重构特性赋予了FPGA并行处理能力强、延迟极低、能效比高的技术价值,使其在算法加速和实时处理领域优势显著。其典型应用场景广泛覆盖了需要高吞吐量与确定低延迟的领域,例如实时视频处理、高频交易以及边缘计算中的AI模型推理。本文聚焦于FPGA的**并行处理能力**与**低延迟**优势,深入剖析其开发流程、资源评估及在**边缘AI**等场景下的

weixin_34198453的博客 432

【QT+PCL】串口读取单线激光雷达数据并在QVtkWidget组件中实时刷新(一)

(本文主要记录开发过程以及遇到的困难及解决方式)

2301_76329543的博客 3068

多输入扩展同或门在FPGA中的实现方式

深入探讨多输入扩展同或门的逻辑设计与优化策略,结合FPGA硬件特性实现高效电路。通过结构化建模方式提升同或门在复杂数字系统中的响应速度与资源利用率,适用于高可靠性场景。

weixin_42571280的博客 1104

睿抗机器人魔力元宝在完成任务过程中如何使机械臂先到达白色盒子上方而不是先到达工作台?

🏆 本文收录于《全栈Bug调优(实战版)》专栏,致力于分享我在项目实战过程中遇到的各类Bug及其原因,并提供切实有效的解决方案。无论你是初学者还是经验丰富的开发者,本文将为你指引出一条更高效的Bug修复之路,助你早日登顶,迈向财富自由的梦想🚀!同时,欢迎大家关注、收藏、订阅本专栏,更多精彩内容正在持续更新中。让我们一起进步,Up!Up!Up!    备注: 部分问题/难题源自互联网,经过精心筛选和整理,结合数位十多年大厂实战经验资深大佬经验总结所得,数条可行方案供所需之人参考。

**My Coding Family** 1378

openbmc mctp i3c适配步骤

本文介绍了在Intel OKS平台下,BMC作为I3C从设备如何适配MCTP over I3C的实现方法。主要内容包括:1)关键术语解释,如MDB(Mandatory Data Byte)值为0xAE,DCR(Device Characteristics Register)和BCR(Bus Characteristics Register)的设置;2)适配流程说明,包括BMC作为控制器主节点分配地址后成为MCTP端点,CPU作为总线所有者的角色转换;3)测试验证步骤,展示通过mctp-client工具发送指

wit_yuan的专栏 132
上一篇: 【AI x FPGA自学笔记】一种加速FPGA实现人工神经网络(ANN)的有效设计方法
下一篇: 【AI x FPGA自学笔记】基于多层神经网络的双质量驱动系统速度估计的FPGA实现
Dead_Simba
博客等级 码龄2年 172粉丝 30原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值