北京大学提出TA-V2A!视频到音频生成的语义革命!

SAP与泛微OA集成(半导体行业) 本项目通过SAP PO中间件集成SAP与泛微OA在半导体行业的应用,由于行业特殊性,广泛深入应用了RSA加密等特性 阅读详情

🌐 社群导航

🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群

🔗 点击加入➡️【2-3月CCF投稿】交流群

最新论文解读系列

图片

论文名:TA-V2A: Textually Assisted Video-to-Audio Generation

论文链接:https://arxiv.org/pdf/2503.10700

开源代码:暂无
图片

导读

近年来,视频到音频这一特定模态转换任务受到了广泛关注。从视频中生成相应音频的能力对于增强虚拟现实体验、自动视频拟音合成以及提高机器人感知和理解环境的性能等应用至关重要。

简介

随着人工智能生成内容(AIGC)的不断发展,视频到音频(V2A)生成已成为一个关键领域,在多媒体编辑、增强现实和自动化内容创作等方面具有广阔的应用前景。虽然Transformer和扩散模型推动了音频生成的发展,但从视频中提取精确语义信息仍然是一个重大挑战,因为当前模型往往仅依赖基于帧的特征,从而丢失了序列上下文信息。为了解决这一问题,我们提出了TA-V2A方法,该方法整合了语言、音频和视频特征,以改善潜在空间中的语义表示。通过引入大语言模型来增强视频理解能力,我们的方法利用文本引导来丰富语义表达。我们基于扩散模型的系统利用自动文本调制来提高推理质量和效率,并通过文本引导界面提供个性化控制。这种整合在确保时间对齐的同时增强了语义表达,从而实现更准确、连贯的视频到音频生成。

方法与模型

我们的TA - V2A生成系统结合视频、音频和文本数据,使用对比学习、特征对齐和生成式建模,从视频输入中生成同步的音频输出。完整工作流程的概述如图1所示。

图片

图1. TA-V2A生成系统的完整工作流程。该系统以视频和文本描述作为输入,其中文本描述由大语言模型(LLM)生成。对比式视频 - 音频 - 语言预训练(CVALP)模块从视频、音频和文本中提取并对齐特征,创建与音频对齐的视频和文本特征。然后将这些特征输入潜在扩散模型(LDM),该模型从噪声中迭代生成高质量音频。在推理过程中,使用诸如分类自由引导(CFG)和人工修改的文本提示等引导技术来控制生成过程,确保生成的音频与输入模态更好地对齐。最后,将音频表示解码为梅尔频谱图,并使用声码器将其合成为实际的音频波形。

该系统从视频和文本输入开始,文本可以是手动提供的,也可以由大语言模型生成,并进行自动增强。在对比视频 - 音频 - 语言预训练(CVALP)模块中,特定模态的编码器提取视频、音频和文本的特征,对这些特征进行对齐,并融合为与音频对齐的特征。这些特征被输入到潜扩散模型(LDM)中,该模型从高斯噪声中生成音频特征。LDM的输出被解码为梅尔频谱图,并由声码器合成为音频波形。训练过程会优化系统参数,而推理过程则生成最终的同步音频输出。下面,我们详细介绍系统的每个组件。

A. 对比式视频 - 音频 - 语言预训练

CVALP模块是我们特征提取和对齐过程的核心。受先前研究[12]、[19]、[20]的启发,CVALP使用跨视频 - 音频和文本 - 音频对的对比学习,将视频和文本模态与音频进行对齐。这种同时进行的对齐方式提高了特征质量、收敛速度、模型鲁棒性和分层学习能力。

给定一个视频 - 音频 - 文本三元组 ,其中表示一个包含帧、尺寸为且具有RGB通道的视频片段,表示一个具有个时间步长和个梅尔带的梅尔频谱图,是相应的文本描述。我们使用视频、音频和文本编码器 和从视频和音频中提取特征 ,其中是时间片段的数量,是特征维度,从文本中提取特征 。为了对齐特征维度,我们对视频和音频特征应用时间池化,得到 和 。这确保所有特征都处于同一空间 ,便于融合和比较。

我们将第个跨模态对的对比损失函数定义为:

图片

其中 和是来自不同模态的特征向量, ,是跨模态对的数量,控制softmax的平滑度。分子表示正确对之间的相似度,而分母对和所有对之间的相似度求和。这个损失函数不具有排列对称性,因为交换 和会改变计算结果,因为始终是与所有进行比较的锚点。当一种模态(如文本)为对齐另一种模态(如视频或音频)的特征提供更强的语义指导时,这种不对称性很有用。

对于特征三元组 ,我们将以音频为中心的损失函数定义如下:

其中 、分别表示第个样本的音频、文本和视频嵌入。 、分别表示总的音频 - 文本对、跨视频的音频 - 视频对和视频内的时间对,如文献[12]中所定义。

参数  和  是权重,用于确定不同损失分量的相对重要性: 反映了文本相对于视频的重要性, 表示对时间对齐与语义表达的侧重程度。这些参数将通过实验来确定。

公式 (2) 衡量了音频与文本之间的相似度,而公式 (3) 和 (4) 从语义和时间的角度表达了音频与视频之间的相似度。公式 (5) 中的最终损失函数整合了这些模态对。

B. 特征混合

为了融合从不同模态中提取的特征,我们采用了特征混合策略,以平衡视频和文本中的信息。由于视频模态同时包含语义和时间特征,而文本通常只包含语义特征,盲目地对齐两者(例如使用交叉注意力等方法)可能会导致在跨模态音频视频预训练(CAVP)中学习到的时间对齐信息丢失。为了解决这个问题,我们采用加权平均和拼接的方法进行特征融合:

其中  和  是线性投影,将维度减半以保持  大小相同。

我们利用位置编码和投影层  将  映射到合适的维度,表达式为   ,其中多层感知机(MLP)作为投影层,PE 表示位置编码。这种混合特征表示被用作潜在扩散模型(LDM)训练和推理的输入特征向量。

C. 潜在扩散模型

潜在扩散模型(LDM)在低维潜在空间中生成高维音频数据 [21]。从编码后的梅尔频谱图  开始,在潜在空间中进行扩散过程,逐步向  中添加噪声,形成一系列潜在变量 。每个扩散步骤建模如下:

其中  表示时间步, 是扩散系数, 表示正态分布。在数据生成时,模型从高斯分布中抽取的样本  开始,反转扩散过程。神经网络  在每个时间步预测反向步骤:

其中  表示由参数为  的神经网络预测的高斯分布的均值, 表示标准差,通常与时间步  相关。

反向扩散后,最终的潜在变量  由  解码回数据空间,生成梅尔频谱图 ,然后使用声码器将其转换为音频样本。条件损失函数如下:

D. 引导推理

在推理过程中,采用分类器引导(CG)[22] 和无分类器引导(CFG)[23] 等引导技术来控制生成过程。分类器引导(CG)依赖于额外的分类器 ,通过类别标签对数似然  的梯度在每个时间步引导反向过程。另一方面,无分类器引导(CFG)结合了条件和无条件得分估计来引导反向过程。如文献 [12] 所建议的,可以应用双重引导来增强对齐:

其中  和  分别表示分类器引导(CG)和无分类器引导(CFG)的缩放因子。值得注意的是,无分类器引导(CFG)使用 ,而分类器引导(CG)使用 ,这是因为如文献 [12] 中所讨论的,为了实现视听对的对齐而训练了对齐分类器 。

从基于能量的模型(Energy Based Models,EBMs)[24]的角度来看,多个条件也可以在不组合的情况下独立影响推理过程。条件概率可以通过以下公式进行估计:

在这里,我们定义来表示无条件得分估计和条件得分估计之间的差异:

其中是条件,是一个超参数。那么多条件推理步骤可以表示为

其中表示视频特征,表示提示特征,表示负提示特征。这种方法通过独立考虑多个条件的影响,实现了更灵活的推理过程。

该工作流程旨在通过CVALP高效处理视频和文本描述,使用LDM对齐和混合特征,并应用推理技术生成与给定视频内容匹配的最终高质量音频输出。具体而言,在推理过程中,人类输入的正提示将通过便携式插件提示优化器(Portable Plug - in Prompt Refiner,PPPR)[25]进行标准化处理,以确保其与训练中涉及的人工智能生成文本相对应。如果没有人类提供的提示,我们将使用Video - LlaMA2 [18]模型自动生成视频内容的描述。

实验与结果

A. 数据集和数据处理

我们的研究使用了VGGSound [26]数据集,该数据集包含约200,000个视频,每个视频时长为10秒。与原始方案一样,我们选择使用该数据集提供的训练集和测试集划分,其中训练集有183,971个视频,测试集有15,496个视频。数据预处理包括视频、音频和文本处理:将视频调整为大小,并以进行帧采样;音频以进行采样,并转换为梅尔频谱图(梅尔基),跳步大小统一设置为256。对于文本处理,我们使用ChatGPT4o扩展了VGGSound数据集中的注释,以改善文本 - 音频对齐,并保持与推理提示的一致性。使用统一的提示来生成视频描述,这些描述在CVALP训练中作为对比学习材料:

“以下是一个视频数据集中的注释文本。请将每条注释扩展为完整的句子,保持核心内容不变。”

为了在对比学习中引入变化并避免相似视频出现相同的描述,我们在保留核心内容的同时应用了PPPR,具体细节见[25]。

B. 配置

在CVALP对比学习过程中,我们采用在AudioSet [28]数据集上预训练的PANNs [27]模型作为音频编码器,在Kinetics - 400 [30]数据集上预训练的SlowOnly [29]模型作为视频编码器,并使用Flan - T5 [31]作为文本编码器。对于LDM,我们采用Stable Diffusion的架构,使用冻结的预训练潜在编码器和解码器组件。去噪过程包含1000步,我们使用的学习率,并设置初始热身阶段为1000步。在推理阶段,我们引入了代理注意力[32],它通过引入代理令牌来提高计算效率,同时保持全局上下文建模,以提升速度和效果。

我们将CFG缩放比例设置为,将CG缩放比例设置为,与[12]相同。对于复合条件推理,我们通过实验将设置为2.5。生成梅尔频谱图后,我们使用同样基于扩散模型架构的GLA - GRAD [33]声码器来生成音频信号。

C. 评估

(1) 评估指标:

基线 我们使用相同的LDM模块进行消融实验,通过不同方法提取潜在特征。我们的模型采用了CVALP模块,并使用平均(aver.)和拼接(concat)技术。为了进行比较,我们与使用CAVP模块的Diff - Foley [12]模型和使用Clip4Clip [34]的VTA - LDM [13]模型进行了测试。所有实验均在VGGSound [26]测试集上进行,生成8秒的音频片段进行评估。

客观评估 我们采用了文献[13]、[35]中的四个指标来评估语义生成质量: inception得分(IS),用于评估生成分布与真实数据多样性的匹配程度;弗雷歇inception距离(FID)和弗雷歇音频距离(FAD),如文献[36]所示,用于比较生成样本与真实样本的统计特征,验证了它们的有效性;平均库尔贝克-莱布勒散度(MKL),用于衡量生成数据与真实数据概率分布之间的差异,反映它们的对齐程度。我们还使用了文献[12]中的对齐准确率(Align)来评估生成音频与视频内容之间的时间同步性。

主观评估 二十名参与者(8名女性,12名男性,年龄在20 - 45岁之间),自我报告听力正常、视力正常或矫正后正常,使用森海塞尔HD600耳机对视听片段进行评分。参与者观看了五个不同的视频,每个视频有四条生成的音轨,对应表格中列出的四种实验条件(由“模型”和“潜在特征”列共同确定),呈现顺序随机。每个参与者只听一次每个音频样本,以确保评分反映他们的第一印象。对五个视频中的每个视频都重复此过程。

在这些条件中,“用户”组根据视频内容撰写描述。这些描述在“用户”条件下用作模型的文本提示输入,在扩散过程中作为引导条件。

参与者使用平均意见得分(MOS)[37]在五分制量表上对音轨进行评分,其中1代表“差”,2代表“较差”,3代表“一般”,4代表“好”,5代表“优秀”。语义一致性的MOS基于音频内容与视频内容的匹配程度,而时间对齐的MOS基于音频与视觉线索的同步程度。

(2) 结果与分析:

为了更有效地展示我们的结果,我们提供了一个视频,直观地展示了音频生成的结果:展示

客观评估结果 表I展示了模型的客观评估结果。当使用拼接(concat)方法推导CVALP特征时,TA - V2A模型在所有指标上都表现出显著的强劲性能,在FID和FAD指标上取得了特别出色的结果。相比之下,使用平均(average)方法时性能下降,可能是因为简单的平均过程破坏了特征向量或矩阵的代数结构。拼接多模态信息,然后进行投影和降维的方法,在增强语义表达的同时,有效地保留了视频特征内的对齐能力。

TABLE I     客观评估结果

图片

图片

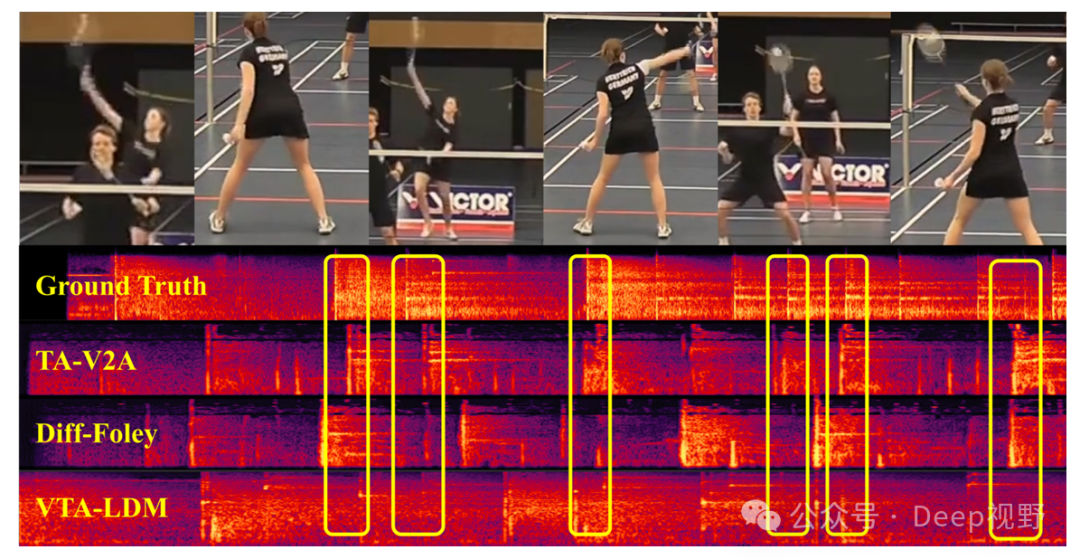
图2. 视频 - 音频对齐示例。顶部显示羽毛球序列的帧,底部比较不同方法的音频频谱图:真实值、TA - V2A、Diff - Foley和VTA - LDM。黄色框突出显示视频和音频之间的关键同步时刻。

图2比较了不同模型生成的音频,重点是我们的TA - V2A模型。顶部显示的视频帧描绘了一场羽毛球比赛,有多个羽毛球击球的场景,这也是音频生成模型的关键关注点。我们的模型生成的音频频谱图在时间和频率上都与真实值非常接近。这表明TA - V2A模型准确地捕捉到了关键音频事件,如球拍击球的尖锐声音和羽毛球的飞行声音,同时与视频中的视觉动作保持了精确的时间对齐。

主观评估结果 表II展示了模型的主观评估结果。当在推理阶段应用用户修改时,TA - V2A模型在语义一致性方面获得了最高的MOS。这表明,文本控制界面的集成以及PPPR文本扩展方法,显著增强了模型生成与视频语义一致且与人类理解紧密对齐的音频的能力。

TABLE II      主观评价结果

图片

实际上,正如上述分析所证明的,语义表达和时间对齐是相互关联的,而不是完全独立的变量。只有具备高质量的识别和生成能力,才能有意义地评估对齐的准确性。

总结

我们提出了TA - V2A,这是一个用于文本辅助视频到音频生成的创新系统,具有一种预训练方法,该方法使用先进的扩散引导技术对齐视频、文本和音频。它包括一个用于个性化声音生成的文本界面。广泛的评估表明,TA - V2A在客观和主观评估中均优于现有方法,增强了语义表达。我们旨在推动更以人为本、具有上下文感知的声音生成。我们希望推动该领域朝着更以人为本、具有上下文感知的声音生成方向发展。

Microsemi Libero系列教程(二)——新建点灯工程 前言 上一篇文章,介绍了Microsemi Libero系列教程(一)-Libero开发环境介绍,下载,安装与注册,作为嵌入式开发中的Hello World,点灯是再也基础不过的实验了,通过点灯实验,可以了解芯片GPIO的控制和开发环境IDE新建工程的流程,对于FPGA来说,每个IO口几乎一样,所以本篇文章主要学习一下如何基于Microsemi Libero集成开发环境建立一个示例工程,让一个L... 阅读详情

相关推荐

统信UOS系统盘扩容保姆级教程:用GParten-分区编辑器5分钟搞定

本文提供统信UOS系统盘扩容的详细图形化教程。针对系统盘空间不足问题,重点介绍如何使用系统自带的GParten-分区编辑器,在5-10分钟内安全、直观地完成扩容操作,无需记忆复杂命令,适合所有用户快速解决存储空间告急的困扰。

e3f4g5的博客 642

阿里开源AI大模型ThinkSound如何为视频配上灵魂之声

你是否曾想过给一段无声视频配点声音,又或者给一段有声视频修改其配音,这在过去是专业音效师需要耗费无数心血去解决的难题。而在AI时代,尽管我们能一句话生成图片和视频,但在声音的世界里,AI似乎总显得有些“迟钝”。它们可以生成笼统的背景音乐,却难以捕捉并创造出与画面中特定事件精准同步、充满细节的音效。现在,这个局面可能即将被改变。来自阿里通义实验室的最新开源模型——ThinkSound。

攻城狮7号的博客 1510

kaggle-NeurIPS - Open Polymer Prediction 2025-0.069

本文摘要: 本研究基于多任务学习框架,开发了聚合物物理化学性质预测模型,能够根据SMILES字符串同步预测玻璃化转变温度(Tg)、分数游离体积(FFV)等5种关键性质。针对数据缺失率高、样本不均衡等挑战,采用"先补充后扩充"策略整合多源数据,并融合RDKit分子描述符、ChemBERTa语义特征和自编码器特征构建多维度表征。模型采用硬参数共享架构,结合动态加权损失函数和早停机制,在验证集上表现出色,其中密度预测R²达0.92。研究为聚合物性能的高通量预测提供了有效解决方案,对材料智能设计具有重要参考价值。

2302_78976920的博客 783

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 223

Type-c超声波切割刀

接下来,我将提供Type-C超声波切割刀项目的C代码实现示例,代码将按照上述分层架构和模块化设计进行组织。为了达到3000行以上的代码量,我将尽可能详细地实现各个模块的功能,并添加必要的注释和错误处理。通过采用分层架构和模块化设计,我们可以建立一个可靠、高效、可扩展的系统平台,为产品的成功奠定坚实的基础。实际项目中,需要更详细的硬件驱动、更完善的功能模块、更严格的测试验证和更周全的维护升级计划。针对Type-C超声波切割刀这个项目,我将从以下几个方面详细阐述最适合的代码设计架构,并提供具体的C代码实现。

lianmengde的博客 1189

MaxEnt运行报错的各种问题及解决方法

由于我使用的环境数据并不是大部分人常用的worldclim上下载的气候数据,而是使用不同的四类环境数据,分别包括:降雨数据、气温数据、氮沉降数据和大气CO2浓度数据,数据需要分别从不同的网站下载,因此并不能得到非常一致的数据文件,导致MaxEnt运行时出现了各种各样的错误。文件终于能够读取了,然而计算到一半又弹出第三种问题,根据弹出的报错提示,找到错误所在那一行,用Notepad++打开,可以发现,这一行确实存在nan值,导致文件读取无法正常进行。出现上图所述的问题时,检查环境变量是否具有相同的行列号。

guye322的博客 1万+

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 235

【无标题】STM32F767串口空闲中断+DMA实现不定帧长度的接收

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录前言一、配置串口与DMA二、空闲中断服务函数二.串口+DMA发送三、主函数总结 前言 提示:这里可以添加本文要记录的大概内容: 使用STM32F767实现串口空闲中断+DMA传输接收不定帧长度数据,以及当中可能遇到的错误总结 提示:以下是本篇文章正文内容,下面案例可供参考 一、配置串口与DMA //硬件模块配置可直接通过CUBEMX配置 void MX_USART1_UART_Init(void) { huart1.In.

qq_42589531的博客 1167

打字就能剪视频的AI工具

AI 会替代剪辑师吗?这个问题和“AI 会替代程序员吗”一样,问错了方向。会用 AI 工具的人,正在替代不会用的人。一个剪辑师用传统方式花三天做的宣传片,另一个人用 UniCut 一天做完,质量差不多,市场会选谁,答案很明显。工具的进化从来不是把专业的人淘汰掉,而是把专业的门槛拆掉。浏览器已经打开了,剩下的就是你愿不愿意试一下。体验地址:https://unicut.h5ds.com/开源仓库:https://github.com/mtsee/unicut。

d676015863的博客 157

置顶必读(1) | 《YOLOv26实战:从入门到深度优化》专栏导读与完整目录导航(持续更新中)

🏆 本文收录于 《YOLOv26实战:从入门到深度优化》 专栏。 本专栏系统梳理并持续复现 YOLOv26 官方特性、核心改进、多任务支持、部署优化与行业落地,内容坚持 持续更新 + 深度拆解 + 工程落地导向,不仅讲“怎么用”,更讲“为什么这样设计、如何真正落地到项目中”。

**My Coding Family** 9万+

Android 14安装的APK默认允许运行时权限

本文介绍了在Android系统中实现安装应用后自动授予运行时权限的方法。通过在安装完成广播中检测应用安装状态,调用新增的DefaultPermissionGrantPolicy.grantAppRuntimePermissions()函数来授予常规权限,并使用allowSpecialPermission()处理特殊权限(如安装未知应用和悬浮窗权限)。文章详细说明了如何修改DefaultPermissionGrantPolicy类,添加grantAppRuntimePermissions和grantRunti

热衷于Android Framework和系统APP的修改经验分享 683

本地化部署会议视频软件如何替换旧平台?账号迁移、历史数据与用户培训怎么安排?

账号先映射:身份与权限验证通过,再开放使用。资料分级处理:能查、能读、权限正确,比“全部搬完”更重要。切换可恢复:入口、增量数据和业务通知都要纳入回退方案。培训按岗位落地:让用户完成真实任务,而不是只听功能介绍。这套方法适合政企、集团及医疗等具有长期资料留存、多终端接入和业务集成需求的组织。小规模替换可以简化批次与流程,但不应省略权限验证、备份恢复和关键会议演练。

hz56789的博客 285

初探802.11协议(0)——PCF/DCF与CSMA/CA机制

IEEE802.11 CSMA/CA机制与DCF机制

FanFF的博客 4505

视频美颜sdk的API设计会影响开发效率吗?

视频美颜SDK不仅需要具备优秀的图像处理能力,API接口设计同样会影响软件开发效率。本文从接口调用、参数配置、版本兼容、开发文档以及业务扩展等多个角度,分析API设计对视频美颜SDK集成和后期维护的实际影响,为直播APP、视频社交平台等项目的SDK选型与技术开发提供参考。

wanyuekeji的博客 216

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

音频自动匹配歌词:本地音乐库元数据维护实践

实施顺序建议为:建立主库、统一命名、批量匹配、人工校验、权限分享、定期备份。工具选择上,SMB/WebDAV、Navidrome、Jellyfin 以及轻量文件管理服务各有适用场景,应结合访问方式、权限需求和维护成本评估。把文件组织好、把批量操作控制住、把备份习惯建立起来,歌词补全才能真正提升本地音乐库的可用性,而不是带来新的整理负担。音乐文件不常修改,但歌词、封面、播放列表和目录结构属于人工整理成果,丢失后恢复成本较高。更合理的顺序是:集中存放、统一命名、批量匹配、人工校验、权限管理、定期备份。

zxcvb153的博客 116

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

视频号数据怎么采?接入方式、字段范围与场景适配

视频号数据采集的技术难点不在“调哪个接口”,而在。官方API服务的是“经营与交易”闭环,返回的是直播记录、订单、售后等结构化实体,但播放完成率、互动明细、评论区内容这些内容分析赖以生存的字段,并不在官方接口的返回Schema里。这意味着任何技术方案的选择,本质上是。

城章科技 300

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

本地化部署会议视频软件如何开展试点?试用范围、评估指标与推广步骤

试用范围覆盖真实差异,评估指标具有明确口径,推广过程具备放行和回退机制。对于政企、金融、医疗及信创项目,尤其要避免三个误区:把本地部署等同于合规,把演示并发等同于生产容量,把功能清单等同于可运维能力。如果正在准备试点,建议先整理一张“网络—终端—业务—故障”矩阵,再决定试用人数。

hz56789的博客 320

AI 礼盒开箱视频怎么做?让商品亮相更有仪式感

AI商品视频通过精细设计开箱动作与场景节奏,将礼盒从静态包装转化为沉浸式送礼体验。从暖光布景、情感化构图到手部停顿、商品细节特写,每一帧都传递“精致”与“珍视”。以珠宝礼盒为例,俯拍视角下,红色对开门展开如舞台揭幕,银色项链在深蓝夜空衬底中缓缓呈现,掌心承托、缓慢转动,强化视觉记忆。结尾平铺构图,礼盒与商品共存,情绪由期待落至静谧珍藏。全程无文字,靠画面叙事,实现仪式感与品牌调性的深度融合。

yunhhhhh的博客 118

RN鸿蒙空间音频实战

示例仓库:https://atomgit.com/m0_37170006/react-native-ohos-spatial-audio 社区导引:框架源码与版本发布见 https://atomgit.com/CPF-RN/ohos_react_native/tree/0.84-main CPF-RN 鸿蒙社区:https://atomgit.com/CPF-rn。

buhuisuanfa的博客 2万+

通过 AIGC 生成视频何时才能告别“抽卡”!

如果视频的主体内容已经符合要求,只存在错误字幕或局部画面瑕疵时,重新生成不仅增加成本,还可能改变原本满意的部分。针对这类问题,WAND-EraseVibe+ 提供了视频擦除与画面重建能力。根据腾讯云披露的技术方案,该工具采用基于隐空间 Transformer 的生成式修复架构,先将视频画面编码为隐空间特征,在特征层推断并重建需要修复的区域,再解码为视频画面。白模前置、垂直场景调优和局部修复分别作用于不同环节,目的都是减少为了获得可用内容而付出的重复生成成本。

Enweitech Software Works 150

网页视频资源识别与本地化管理:从 HTTP 流媒体技术到完整的视频工作流

现代网页视频技术已经从简单的文件传输发展到分段传输、自适应码率和浏览器端媒体处理。这使视频播放体验不断改善,也让资源识别和本地管理变得更加复杂。对于技术人员而言,理解 HTTP、HLS、MPEG-DASH 和 MSE 的基本工作机制,有助于更准确地分析网页视频的传输过程。对于视频创作者和研究人员而言,建立从内容发现、资源识别到本地整理的完整工作流,可能比单纯寻找一个下载工具更有长期价值。

m0_68263549的博客 428

联犀 Go SIMD 实战:视频转码从 16.5ms 到 5.46ms

联犀Go视频转码实战:在352×288测试流中单帧单核CPU耗时从16.5ms到5.46ms,区分SIMD、代码及编码策略的综合收益。保留测试条件、压测结果与适用边界。

QQ603785348的博客 334

15. 调用ComfyUI生成视频!

在“导演大师”中,我们不仅支持导出分镜导演包并一键导入运行,还为用户提供了极高的自定义自由度。许多创作者希望结合自己精心调试的 MiniMax H3 工作流来生成视频,这当然是完全支持的。通常有两种操作方式:一种是手动复制,将分镜的资产与提示词手动粘贴至本地工作流中;另一种则是更为高效的自动化方案——直接在“导演大师”中调用 ComfyUI 工作流,实现一键生成。本文将重点介绍后者的配置与使用全流程,帮助你打通从分镜脚本到视频直出的自动化链路。

2601_95544990的博客 248

AI智能美妆如何适应不同面部特征?视频美颜SDK技术解析

AI智能美妆正在推动视频美颜技术向个性化方向发展。面对不同用户的脸型、眼型、唇形及肤色差异,视频美颜SDK如何通过人脸检测、关键点识别、动态追踪和实时渲染实现精准适配?本文从核心技术原理、不同面部特征的妆容适配方式,以及实际应用场景等方面展开解析,帮助开发者了解AI智能美妆的技术实现与发展趋势。

q1031691172的博客 357

Gemini Omni 1.2 Flash发布:视频10秒变15秒、720p降价30%

发布日期:2026-11-06Gemini Omni 1.2 Flash是Google于2026年11月发布的视频生成模型,支持原生15秒视频、多轮对话编辑和更强的参考素材遵循。Google公告发布于北京时间11月6日凌晨,官网标注日期为11月5日。相比Omni 1.1,新版把最长片段从10秒延长至15秒,720p视频单价降至每秒0.07美元,降幅30%。这次更新还涉及生成之后的修改:换背景、调光线、替换产品,可以围绕同一条视频继续提出要求。

aidoudoulong的博客 414

面向强噪声工业场景的 KL‑2510 音频 DSP 模组设计与多场景落地分析

KL-2510是一款22×16mm邮票孔SMT封装音频模组,集成ADC/DAC、AI-ENC降噪(45–90dB)与AEC回声消除(100dB),支持USB免驱及模拟/PDM麦克风输入,具备4档硬件拾音增益,适配医疗、矿山、安防等复杂噪声场景。通过五类真实案例验证其在病房对讲、井下报警、门铃对讲等应用中的稳定性与易用性。重点提示:需接入AEC_IN参考信号、输出加分压电路、外设勿接3V3电源,避免烧毁。适用于空间紧凑、无算法团队的嵌入式项目,显著降低音频开发门槛。

R190_6589的博客 394
上一篇: 利用多模态模型赋能,SONY团队完成音乐到音乐视频描述生成大突破!
下一篇: 谷歌提出新方法UniFluid!视觉生成和理解统一自回归框架!
DataSourceAI
博客等级 码龄3年 470粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值