


🌐 社群导航
🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群
数源AI 最新论文解读系列
论文名:Unified Autoregressive Visual Generation and Understanding with Continuous Tokens
论文链接:https://arxiv.org/pdf/2503.13436
导读
大型语言模型(LLM)最近已从以文本为中心的架构(如BERT和GPT)发展为能够理解和生成不同模态内容的多模态系统。GPT - 3和PaLM表明,扩展语言模型会产生新兴能力,而Flamingo进一步证明,纳入视觉输入有助于统一的多模态推理。这种向统一视觉 - 语言模型发展的趋势——使用单一模型完成视觉理解和生成的各种任务——在利用跨不同视觉和语言任务转移的知识和推理能力方面具有巨大潜力,最终有助于实现更强大、更具泛化性的多模态表示和建模能力。
简介
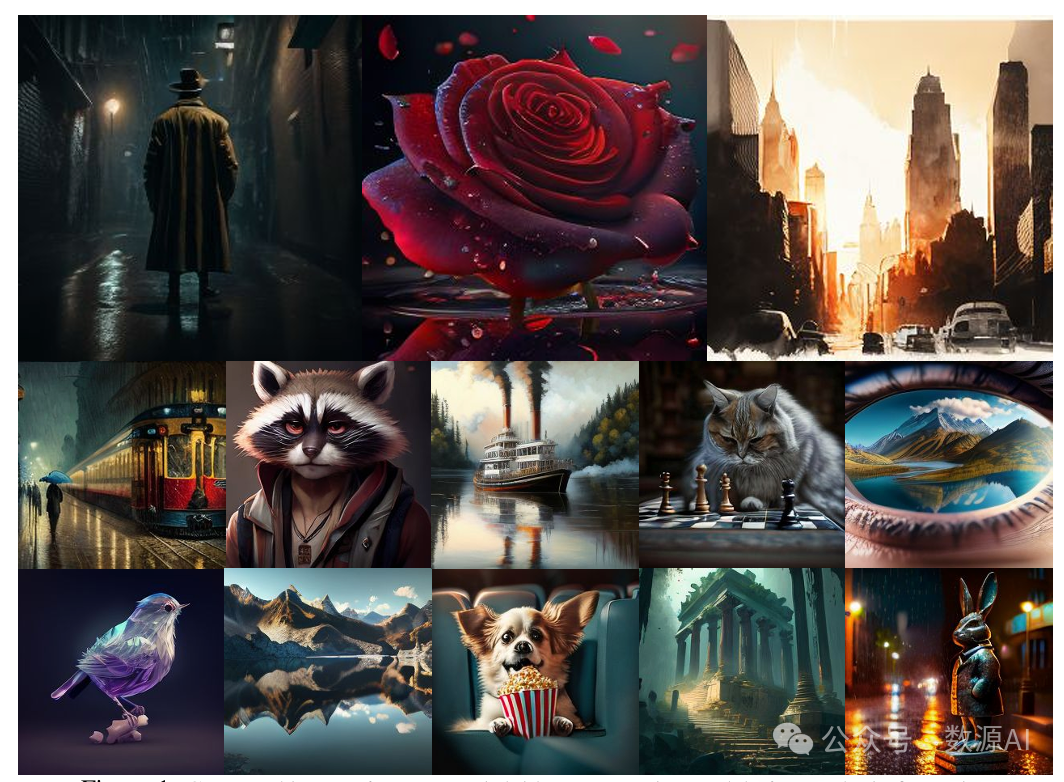
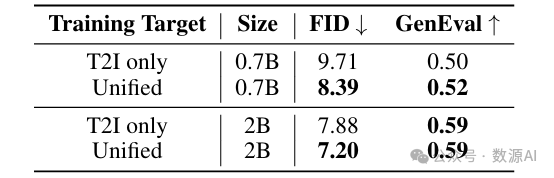
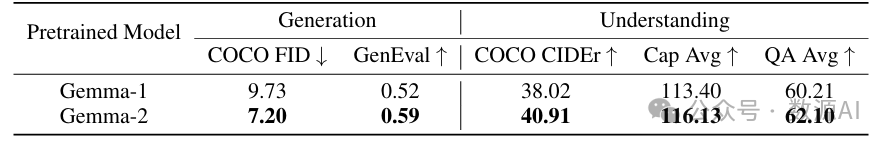
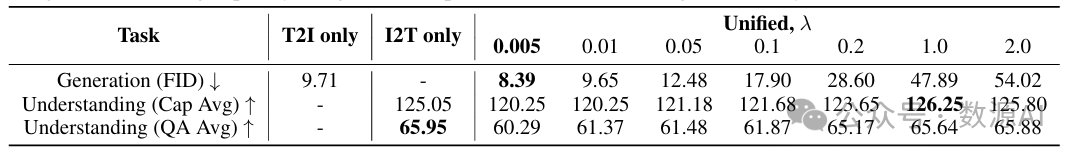
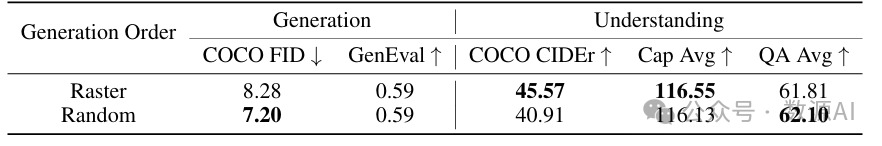
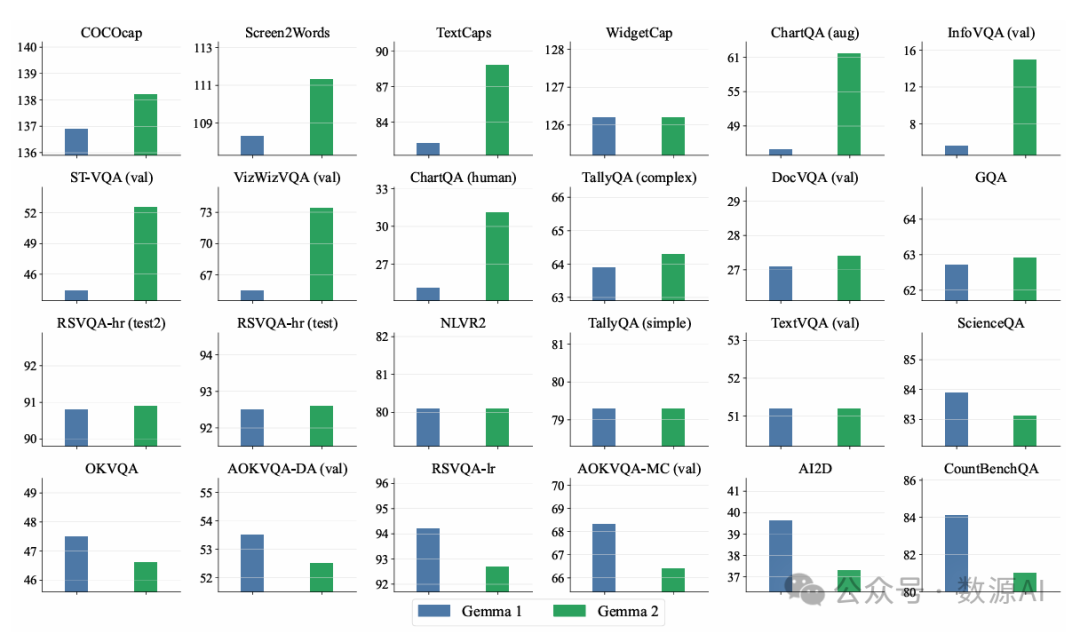
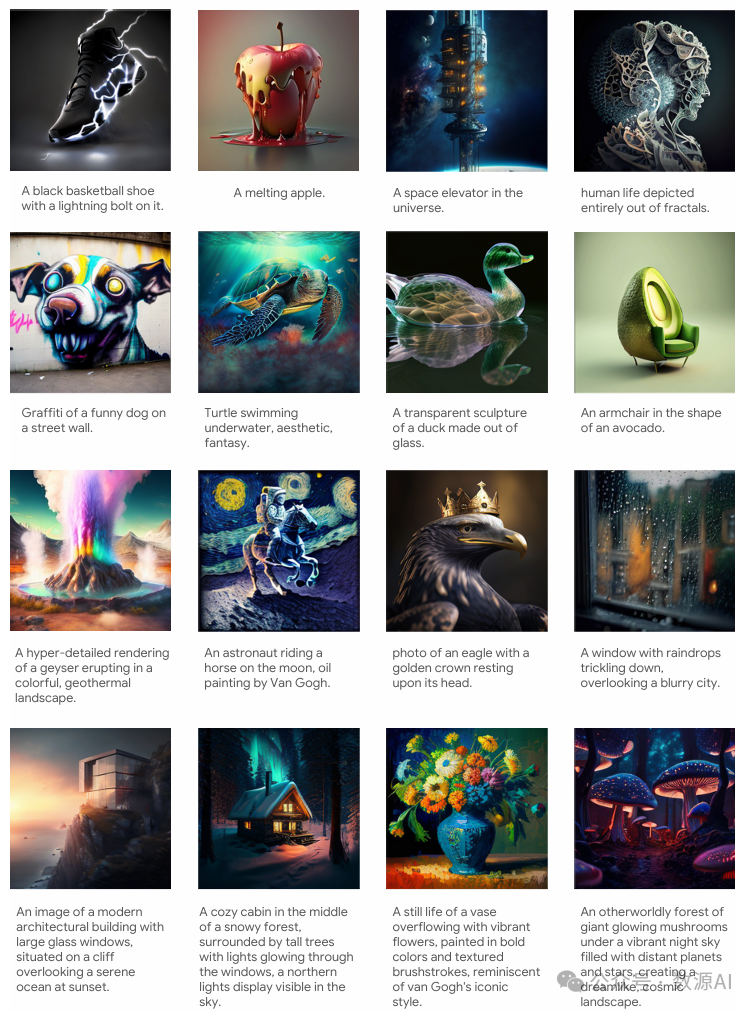
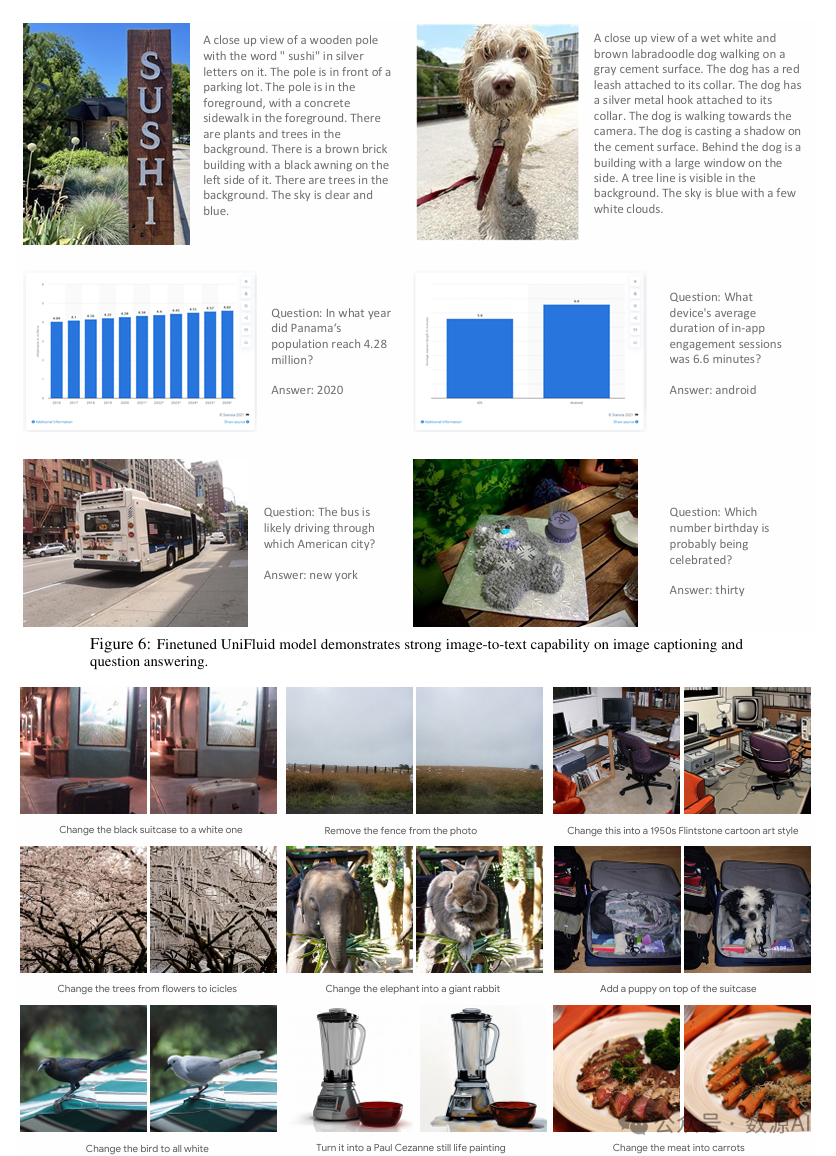
我们提出了UniFluid,这是一个统一的自回归框架,用于利用连续视觉标记进行联合视觉生成和理解。我们的统一自回归架构处理多模态图像和文本输入,为文本生成离散标记,为图像生成连续标记。我们发现,虽然图像生成和理解任务之间存在内在的权衡,但经过精心调整的训练方案可以使它们相互促进。通过选择合适的损失平衡权重,统一模型在这两个任务上取得的结果与单任务基线相当或更优。此外,我们证明了在训练过程中采用更强的预训练大语言模型(LLM)和随机顺序生成对于在这个统一框架内实现高保真图像生成至关重要。基于Gemma模型系列构建的UniFluid在图像生成和理解方面均表现出有竞争力的性能,展示了对各种下游任务的强大迁移能力,包括用于生成的图像编辑,以及用于理解的视觉字幕和问答。
方法与模型
在本节中,我们将阐述我们的UniFluid模型的架构。该模型期望图像和文本序列作为输入,并使用下一标记预测作为训练目标,在生成和理解任务上进行联合训练。
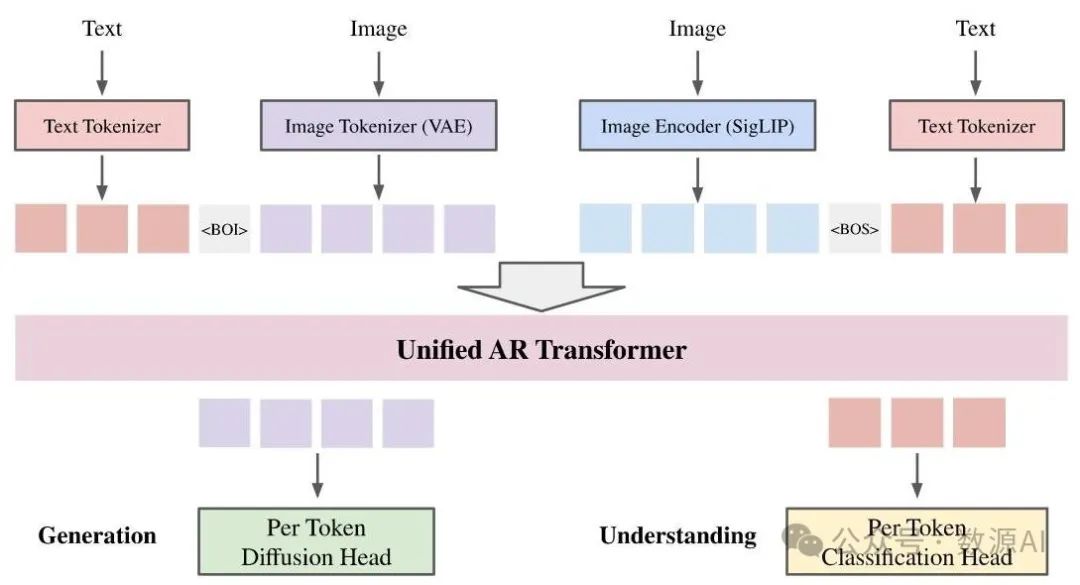
图2:UniFluid的高层示意图。UniFluid通过下一标记预测对图像生成和理解任务进行联合训练。对于图像嵌入,我们使用变分自编码器(VAE)图像标记器进行生成,使用SigLIP图像编码器进行理解。BOI/BOS代表图像/句子的开始。
1. 使用连续视觉标记的统一自回归建模
我们的方法利用自回归范式将视觉理解和生成统一在一个框架内。给定一个有序的标记序列 ,自回归模型 将联合概率分布分解为条件概率的乘积,有效地将生成任务构建为一个顺序的“下一标记预测”问题:。正如MAR [21] 和Fluid [12] 所示,这种自回归公式适用于离散标记和连续标记。在UniFluid中,我们利用这一特性在统一的仅解码器框架下实现连续视觉标记的生成。我们的模型与模态无关;文本和图像标记都被视为一个长统一序列中的元素,它们各自的对数几率由骨干变压器以自回归方式迭代预测。为了适应文本和图像模态的不同性质,我们使用特定于模态的预测头来计算每种模态的适当损失函数并进行采样。这种统一的方法允许模型通过统一的训练过程学习一个共享表示空间,促进协同学习,并实现视觉生成和理解之间的无缝过渡。
2. 架构
如图2所示,UniFluid采用统一框架,将文本和图像输入进行分词处理,并投影到共享嵌入空间。这使其能够利用仅解码器的Transformer作为统一自回归任务的核心骨干网络。文本输入使用SentencePiece分词器进行分词,得到词汇量为的离散词元。对于图像生成,使用连续变分自编码器将图像编码为连续视觉词元。为便于图像理解过程,我们借鉴PaliGemma,使用SigLIP作为单独的图像编码器,从视觉输入中提取高级信息。UniFluid包含一个分类头,用于将Transformer的文本对数几率转换为分类分布;还包含一个扩散头,用于将图像对数几率转换为每个词元的概率分布。
文本固有的线性序列结构与大语言模型(LLM)的标准一维位置嵌入非常匹配,这足以用于文本建模和图像理解任务。然而,图像词元具有的空间结构。为捕捉这种固有的特性,我们引入可学习的二维位置嵌入,并将其添加到图像词元嵌入中。同时,受文献[58]的启发,为实现随机顺序生成,还为每个图像词元添加了下一个预测词元的位置嵌入。为增强模型启动和引导图像生成的能力,我们在连续图像词元序列前添加一个“图像起始”(BOI)词元。这个BOI词元作为一个独特的信号,指示视觉生成过程的开始。鉴于生成图像词元的序列长度是预先定义的(对于图像为256个词元),在我们的情况下不需要显式的“图像结束”词元。
实现
1. 训练
离散文本词元的逐词元分类头。我们使用与Gemma相同的SentencePiece分词器进行文本分词。Transformer输出的文本对数几率被转换为词汇表上的分类概率分布,我们应用标准交叉熵损失(记为)来优化这些离散文本词元的预测。
连续视觉词元的逐词元扩散头。我们采用与Fluid相同的连续分词器,将图像嵌入为个连续词元,并使用大小为2的补丁将4个词元合并为一个。为对这些预测的连续视觉词元的逐词元分布进行建模,我们使用一个轻量级多层感知机(MLP)作为扩散头。我们采用与文献[21,12]相同的扩散过程和损失函数(记为),该函数专门用于连续视觉词元预测。对于理解任务,输入图像分辨率为,我们使用SigLIP作为图像编码器。请注意,SigLIP特征仅在训练期间作为理解任务的前缀使用,并且不会在其上添加额外的损失。
特定任务的训练配置
图像理解:对于图像理解任务,模型以图像嵌入和问题词元作为输入前缀。借鉴PaliGemma,我们对图像和问题词元都应用双向注意力掩码。对答案词元应用因果注意力掩码,确保模型在自回归生成过程中仅关注之前的答案词元。文本词元损失专门针对答案文本词元进行计算。
图像生成:相反,对于图像生成任务,文本提示作为条件输入。为保持适当的信息流,我们对文本提示词元应用双向注意力掩码,使其能够关注所有其他文本词元。对图像词元应用因果注意力掩码,确保每个图像词元仅关注前面的图像词元。视觉词元损失针对生成的图像词元进行计算。
统一损失函数。UniFluid的总训练损失是文本词元预测损失和视觉词元预测损失的加权和,定义为: 其中是一个超参数,表示分配给文本词元预测损失的权重,使我们能够在训练期间平衡两种模态的贡献。
训练详情。我们使用AdamW优化器,以2048的批量大小训练模型,学习率为。训练过程包括100万步,采用恒定学习率调度,热身期为步。遵循文献[58],对于图像生成,在最初的次训练迭代中,图像标记顺序随机排列,然后在到次迭代之间线性退火至光栅顺序,最后在随后的步中保持光栅顺序。除了与Gemma - 1进行比较外,本文所有实验均使用Gemma - 2模型系列作为骨干变压器。
2. 推理
对于文本解码,我们对每个生成的文本预测采用分类采样。然后根据采样的概率分布从词汇表中选择预测的标记。我们使用与PaliGemma相同的解码策略。除下游COCOcap(束搜索n = 2)和TextCaps(束搜索n = 3)任务外,所有任务均使用贪心解码。对于图像解码,我们使用扩散采样过程生成连续的视觉标记。在我们的实现中,扩散采样步骤设置为100。
由于文本和图像生成均在标记级别进行,且在因果注意力机制下一次预测一个标记,因此我们可以有效地利用键值(KV)缓存。这种优化适用于离散的文本标记和连续的视觉标记,显著加速了推理过程。
实验与结果
1. 实验设置
模型架构。为了验证所提出的非自回归(NAR)范式的有效性和可扩展性,我们采用了仅解码器的Transformer架构,遵循先前的研究。通过实现面向维度的解码头,我们的非自回归(NAR)方法本质上适用于二维图像和三维视频生成,分别使用两个和三个解码头。类别条件图像生成。我们在广泛使用的ImageNet数据集上评估非自回归(NAR)方法。使用[44]引入的现成图像分词器对图像进行分词,下采样因子为16。所有模型都以的基础学习率和步长学习率调度器进行300个周期的训练。报告的Inception分数(IS)和Fréchet Inception距离(FID)结果是通过采样50,000张图像并使用ADM的TensorFlow评估套件[11]进行评估计算得出的。
类别条件视频生成。NAR在UCF - 101数据集[43]上进行训练和评估。我们采用了[54]提出的视频分词器,它将一个视频片段编码为个视觉标记。模型以的基础学习率训练3000个轮次,并使用步长学习率调度器。弗雷歇视频距离(Frechet Video Distance,FVD)[51]作为生成任务的主要评估指标。
文本到图像生成。我们从LAION - COCO [1]数据集和使用大型视觉 - 语言模型标注的开源高分辨率图像中精心挑选了一个包含400万图像 - 文本对的数据集[56]。采用了由[44]提出的在LAION - COCO上微调的图像分词器,下采样因子为16。使用预训练的FLAN - T5模型[8]提取文本嵌入,作为图像生成的条件输入。遵循先前的工作[44],训练过程分为两个阶段。在第一阶段,模型在400万LAION - COCO子集上以的分辨率训练60个轮次。在第二阶段,模型在高质量数据集上以的分辨率微调40个轮次。两个训练阶段均使用余弦退火学习率调度器。采用GenEval [15]作为公平且细粒度的基准进行比较。
2. 主要结果
2.1. 类别条件图像生成
在本小节中,我们评估了NAR模型在ImageNet 数据集上的性能,如表1所示。为了进行公平比较,我们采用了与LlamaGen [44]和PAR [58]相同的图像分词器、模型架构和训练流程。所使用的图像分词器仅有个参数,它仅在ImageNet数据集上进行训练,重建FID(rFID)为2.19。尽管之前的并行解码方法PAR与LlamaGen的标准下一个标记预测范式相比提高了生成效率,但其FID在相同模型大小下始终高于LlamaGen。相比之下,采用NAR范式的模型表现出更优的性能和效率。例如,具有3.72亿参数的NAR - L比具有14亿参数的LlamaGen - XXL实现了更低的FID(3.06对3.09),同时将模型前向传播步数减少了(31步对256步),并实现了更高的吞吐量(195.4张图像/秒对14.1张图像/秒)。
另一方面,VAR方法[47]采用了一个具有个参数的更大的图像分词器,它在大规模OpenImages数据集[22]上进行训练。这个分词器的重建FID(rFID)为1.00,为生成性能提供了更高的上限。尽管如此,参数更少的NAR - M比VAR - d16实现了更低的FID(3.27对3.30),同时提供了更高的吞吐量(248.5张图像/秒对129.3张图像/秒)。将NAR与更先进的图像分词器相结合将留作未来工作。
2.2. 类别条件视频生成
在本小节中,我们使用UCF - 101数据集[43]评估非自回归模型(NAR)在基于类别的视频生成中的有效性。如表2所示,我们的NAR模型通过显著减少生成步骤和实际耗时,同时实现更低的FVD(弗雷歇视频距离),超越了其他自回归模型。与采用相同视频分词器且参数数量相当的LARP - L - Long模型[54]相比,我们的NAR - L模型进一步提高了生成质量,将FVD降低了5.8,生成延迟降低了。此外,与专为并行生成设计的PAR模型[58]相比,我们的NAR - XL模型始终表现更优,FVD降低了,且无需进行超参数调整。总体而言,我们提高了自回归范式在图像/视频生成中的可扩展性,使其在使用更少参数和更低延迟的情况下,与基于扩散的和基于掩码的方法相媲美。
2.3. 文本到图像生成
为了验证NAR在文本引导图像生成中的有效性,我们训练了一个文本引导的NAR - XL模型,并在GenEval基准测试[15]上评估其性能,具体结果见表3。仅在600万个公开可用的文本 - 图像对上训练的NAR - XL模型,在GenEval基准测试中显著优于LlamaGen - XL模型[44](得分分别为0.43和0.32),尽管它仅使用了10%的训练数据,且吞吐量提高了。此外,NAR模型的总体得分超过了Chameleon模型[45],Chameleon是一个基于自回归的视觉生成模型,有70亿个参数,在14亿个文本 - 图像对上进行训练。与基于扩散的模型SDv1.5[37]相比,NAR在仅使用的训练数据的情况下实现了相当的性能。这些结果强调了NAR范式在使用最少训练数据的情况下生成高质量图像的能力。
补充材料中提供了展示类别条件图像生成、视频生成和文本引导图像生成的定量可视化结果。
3. 部署效率
在本小节中,我们详细比较了各种自回归生成范式的效率,评估了具有相似FID(弗雷歇初始距离)分数的模型的延迟、内存使用和吞吐量。如图6(a)所示,在生成延迟方面,当批量大小小于32时,VAR - d16的延迟低于NAR - M和LlamaGen - L。这可归因于原始下一个标记自回归和NAR范式在解码过程中的内存瓶颈。然而,随着批量大小的增加,NAR - M的延迟显著降低。例如,当批量大小为256时,与VAR - d16相比,NAR - M的延迟降低了(分别为1.13秒和2.02秒)。此外,如图6(b)所示,对于相同的批量大小,NAR - M始终比VAR - d16需要更少的GPU内存,这是由于NAR的序列长度更短。因此,在相同的硬件上,NAR范式可以容纳更大的批量大小,从而实现更高的吞吐量,如图6(c)所示。例如,在具有80GB显存的A100 GPU上,VAR - d16在推理期间支持的最大批量大小为256,每秒可生成129.3张图像。相比之下,NAR - M支持的批量大小为512,每秒可生成248.5张图像,比VAR - d16的吞吐量高92.1%。与原始下一个标记自回归模型LlamaGen - L相比,NAR - M在实现更优FID的同时,吞吐量提高了。这些结果凸显了NAR范式在延迟、内存使用和吞吐量方面的效率优势,使其成为高性能和高效图像生成的理想选择。
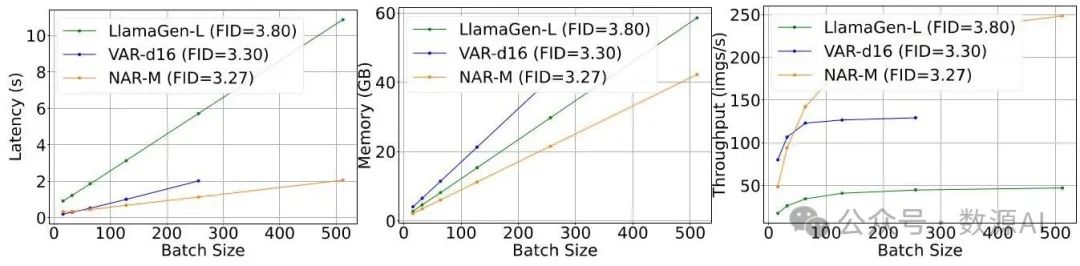
图6. 普通自回归(AR)、向量自回归(VAR)与所提出的非自回归(NAR)视觉生成范式之间的效率比较。当批量大小大于64时,NAR能以更低的延迟、更少的内存使用和显著更高的吞吐量实现更低的弗雷歇 inception 距离(FID)。
4. 消融实验
面向维度的解码头的效果。我们通过将所提出的面向维度的解码头的性能与采用单个头并行预测所有相邻标记的基线方法进行比较,来评估其有效性。为了进行公平比较,所有模型都使用相同的流程和超参数进行训练。如表4所示,没有面向维度的解码头的NAR - L(无维度导向解码头的非自回归语言模型)与具有下一个标记预测目标的LlamaGen - L(大语言模型生成器)相比,性能明显较差,导致FID(弗雷歇 inception 距离)显著提高至66.31。这种性能下降可归因于单个解码头无法充分捕捉不同位置的不同标记分布,对于空间距离较远的标记,这些分布可能会有很大差异。相比之下,配备了所提出的面向维度的解码头的NAR - L实现了显著更低的FID,为3.06,同时将模型前向步骤的数量减少了87.8%(从256步减少到31步)。这一改进凸显了面向维度的解码头在提高生成质量和效率方面的有效性。
混合逻辑采样的效果。如图4所示,不同维度导向的解码头预测的相邻标记之间存在重叠。在推理过程中,这些重叠的标记可以从单个解码头的预测中采样,也可以从多个解码头的预测组合中采样。我们评估了各种解码头配置对类别条件ImageNet 基准测试的影响,结果如表5所示。结果表明,与仅依赖单个解码头相比,结合多个解码头的预测显著提高了生成质量。这一改进体现在FID(弗雷歇 inception 距离,Frechet Inception Distance)显著降低至3.06,IS( inception 得分,Inception Score)提高至263.9。
结论
在本文中,我们提出了邻域自回归建模(Neighboring Autoregressive Modeling,NAR),这是一种用于高效、高质量视觉生成的新型“邻域预测”范式。为了便于对多个等距令牌进行并行解码,我们提出了一组面向维度的解码头,每个解码头负责在时空空间中沿着相互正交的维度预测下一个令牌。在推理过程中,我们的方法能够在单个前向步骤中预测生成令牌的所有相邻令牌,显著减少了自回归视觉生成所需的模型前向步骤数量。大量实验结果表明,NAR在图像和视频生成任务中实现了最先进的生成质量和效率的平衡。
 4万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


