


第一章:什么是 Skills?

Skills 的核心是一个包含 SKILL.md 文件的文件夹。这个文件包含元数据(至少包括 name 和 description),以及告诉 Agent 如何执行特定任务的指令。Skills 还可以捆绑脚本、模板和参考材料。
- 1
- 2
- 3
- 4
- 5
my-skill/
├── SKILL.md          # 必需:指令 + 元数据
├── scripts/          # 可选:可执行代码
├── references/       # 可选:文档资料
└── assets/           # 可选:模板、资源
Skills 的工作原理
Skills 使用渐进式披露来高效管理上下文:
- 发现阶段:启动时,Agent 仅加载每个可用 skill 的名称和描述——刚好足以知道它何时可能相关。
- 激活阶段:当任务匹配某个 skill 的描述时,Agent 将完整的
SKILL.md指令读入上下文。 - 执行阶段:Agent 按照指令操作,根据需要加载引用文件或执行捆绑的代码。
这种方法让 Agent 保持快速运行,同时能够按需获取更多上下文。

SKILL.md 文件
每个 skill 都以一个包含 YAML frontmatter 和 Markdown 指令的 SKILL.md 文件开始:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
---
name: pdf-processing
description: Extract text and tables from PDF files, fill forms, merge documents.
---
# PDF Processing
## When to use this skill
Use this skill when the user needs to work with PDF files...
## How to extract text
1. Use pdfplumber for text extraction...
## How to fill forms
...
SKILL.md 顶部需要以下 frontmatter:
name:简短标识符description:何时使用此 skill
frontmatter 之后的 Markdown 正文包含实际指令,对结构或内容没有特定限制。
这种简单格式有几个关键优势:
- 自文档化:skill 作者或用户可以阅读
SKILL.md并理解它的功能,使得 skills 易于审计和改进。 - 可扩展:Skills 的复杂度可以从纯文本指令到可执行代码、资产和模板不等。
- 可移植:Skills 只是文件,因此易于编辑、版本控制和共享。
第二章:规范
本章定义了 Agent Skills 的格式规范。
目录结构
一个 skill 是一个至少包含 SKILL.md 文件的目录:
- 1
- 2
skill-name/
└── SKILL.md          # 必需
你可以选择性地包含额外目录,如 scripts/、references/ 和 assets/ 来支持你的 skill。
SKILL.md 格式
SKILL.md 文件必须包含 YAML frontmatter,后跟 Markdown 内容。
Frontmatter(必需)
- 1
- 2
- 3
- 4
---
name: skill-name
description: A description of what this skill does and when to use it.
---
带有可选字段:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
---
name: pdf-processing
description: Extract text and tables from PDF files, fill forms, merge documents.
license: Apache-2.0
metadata:
author: example-org
version: "1.0"
---
| 字段 | 必需 | 约束 |
|---|---|---|
name | 是 | 最多 64 个字符。仅限小写字母、数字和连字符。不能以连字符开头或结尾。 |
description | 是 | 最多 1024 个字符。非空。描述 skill 的功能和使用场景。 |
license | 否 | 许可证名称或对捆绑许可证文件的引用。 |
compatibility | 否 | 最多 500 个字符。指示环境要求(目标产品、系统包、网络访问等)。 |
metadata | 否 | 用于额外元数据的任意键值映射。 |
allowed-tools | 否 | 以空格分隔的预批准工具列表。(实验性功能) |


name 字段
必需的 name 字段:
- 必须为 1-64 个字符
- 只能包含 Unicode 小写字母数字字符和连字符(
a-z和-) - 不能以
-开头或结尾 - 不能包含连续连字符(
--) - 必须与父目录名称匹配
有效示例:
- 1
name: pdf-processing
- 1
name: data-analysis
- 1
name: code-review
无效示例:
- 1
name: PDF-Processing # 不允许大写
- 1
name: -pdf # 不能以连字符开头
- 1
name: pdf--processing # 不允许连续连字符
description 字段
必需的 description 字段:
- 必须为 1-1024 个字符
- 应描述 skill 的功能和使用场景
- 应包含帮助 Agent 识别相关任务的特定关键词
好的示例:
- 1
description: ExtractstextandtablesfromPDFfiles,fillsPDFforms,andmergesmultiplePDFs.UsewhenworkingwithPDFdocumentsorwhentheusermentionsPDFs,forms,ordocument extraction.
不好的示例:
- 1
description: Helps with PDFs.
license 字段
可选的 license 字段:
- 指定应用于 skill 的许可证
- 建议保持简短(许可证名称或捆绑许可证文件的名称)
示例:
- 1
license: Proprietary. LICENSE.txt has complete terms
compatibility 字段
可选的 compatibility 字段:
- 如果提供,必须为 1-500 个字符
- 仅在 skill 有特定环境要求时才应包含
- 可以指示目标产品、所需系统包、网络访问需求等
示例:
- 1
compatibility: Designed for Claude Code (or similar products)
- 1
compatibility: Requires git, docker, jq, and access to the internet
大多数 skills 不需要 compatibility 字段。
metadata 字段
可选的 metadata 字段:
- 从字符串键到字符串值的映射
- 客户端可以使用它存储 Agent Skills 规范未定义的额外属性
- 建议使键名合理唯一,以避免意外冲突
示例:
- 1
- 2
- 3
metadata:
author: example-org
version: "1.0"
allowed-tools 字段
可选的 allowed-tools 字段:
- 以空格分隔的预批准运行工具列表
- 实验性功能。不同 Agent 实现对此字段的支持可能不同
示例:
- 1
allowed-tools: Bash(git:*) Bash(jq:*) Read
正文内容
frontmatter 之后的 Markdown 正文包含 skill 指令。对格式没有限制。编写任何有助于 Agent 有效执行任务的内容。
推荐的章节:
- 分步指令
- 输入和输出示例
- 常见边界情况
请注意,Agent 一旦决定激活某个 skill,就会加载整个文件。考虑将较长的 SKILL.md 内容拆分到引用文件中。
可选目录
scripts/
包含 Agent 可以运行的可执行代码。脚本应该:
- 自包含或清楚地记录依赖关系
- 包含有用的错误消息
- 优雅地处理边界情况
支持的语言取决于 Agent 实现。常见选项包括 Python、Bash 和 JavaScript。
references/
包含 Agent 在需要时可以读取的额外文档:
REFERENCE.md- 详细的技术参考FORMS.md- 表单模板或结构化数据格式- 领域特定文件(
finance.md、legal.md等)
保持单个引用文件的聚焦性。Agent 按需加载这些文件,因此较小的文件意味着较少的上下文使用。
assets/
包含静态资源:
- 模板(文档模板、配置模板)
- 图片(图表、示例)
- 数据文件(查找表、Schema)
渐进式披露
Skills 应该被构造为高效使用上下文:
- 元数据(约 100 tokens):所有 skills 的
name和description字段在启动时加载 - 指令(建议 < 5000 tokens):完整的
SKILL.md正文在 skill 被激活时加载 - 资源(按需):文件(例如
scripts/、references/或assets/中的文件)仅在需要时加载
将主 SKILL.md 保持在 500 行以下。将详细的参考材料移到单独的文件中。
文件引用
在 skill 中引用其他文件时,使用从 skill 根目录开始的相对路径:
- 1
- 2
- 3
- 4
See [the reference guide](references/REFERENCE.md) for details.
Run the extraction script:
scripts/extract.py
将文件引用保持在距 SKILL.md 一层深度以内。避免深度嵌套的引用链。
验证
使用 skills-ref[https://github.com/agentskills/agentskills/tree/main/skills-ref] 参考库来验证你的 skills:
- 1
skills-ref validate ./my-skill
这会检查你的 SKILL.md frontmatter 是否有效并遵循所有命名约定。
第三章:将 Skills 集成到你的 Agent 中
本指南解释了如何将 skills 支持添加到 AI Agent 或开发工具中。
集成方式
将 skills 集成到 Agent 中有两种主要方式:
基于文件系统的 Agent 在计算机环境(bash/unix)中运行,是最强大的选项。当模型发出 shell 命令如 cat /path/to/my-skill/SKILL.md 时,skills 被激活。捆绑的资源通过 shell 命令访问。
基于工具的 Agent 没有专用的计算机环境。它们实现工具来让模型触发 skills 并访问捆绑的资产。具体的工具实现由开发者决定。
概览

一个兼容 skills 的 Agent 需要:
- 发现配置目录中的 skills
- 在启动时加载元数据(名称和描述)
- 将用户任务与相关 skills 进行匹配
- 通过加载完整指令来激活 skills
- 根据需要执行脚本和访问资源
Skill 发现
Skills 是包含 SKILL.md 文件的文件夹。你的 Agent 应该扫描配置的目录以查找有效的 skills。
加载元数据
在启动时,仅解析每个 SKILL.md 文件的 frontmatter。这保持了较低的初始上下文使用量。
解析 frontmatter
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
function parseMetadata(skillPath):
content = readFile(skillPath + "/SKILL.md")
frontmatter = extractYAMLFrontmatter(content)
return {
name: frontmatter.name,
description: frontmatter.description,
path: skillPath
}
注入到上下文中
在系统提示中包含 skill 元数据,以便模型知道哪些 skills 可用。
遵循你的平台对系统提示更新的指导。例如,对于 Claude 模型,推荐的格式使用 XML:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
<available_skills>
<skill>
<name>pdf-processing</name>
<description>Extracts text and tables from PDF files, fills forms, merges documents.</description>
<location>/path/to/skills/pdf-processing/SKILL.md</location>
</skill>
<skill>
<name>data-analysis</name>
<description>Analyzes datasets, generates charts, and creates summary reports.</description>
<location>/path/to/skills/data-analysis/SKILL.md</location>
</skill>
</available_skills>
对于基于文件系统的 Agent,包含 location 字段和 SKILL.md 文件的绝对路径。对于基于工具的 Agent,可以省略 location。
保持元数据简洁。每个 skill 应该向上下文添加大约 50-100 个 tokens。
安全考虑
脚本执行会引入安全风险。需要考虑:
- 沙箱化:在隔离环境中运行脚本
- 白名单:仅执行来自受信任 skills 的脚本
- 确认:在运行潜在危险操作之前询问用户
- 日志记录:记录所有脚本执行以供审计
参考实现
skills-ref库提供了用于处理 skills 的 Python 工具和 CLI。
https://github.com/agentskills/agentskills/tree/main/skills-ref
agentskills
例如:
验证 skill 目录:
- 1
skills-ref validate <path>
为 Agent 提示生成 <available_skills> XML:
- 1
skills-ref to-prompt <path>...
使用该库源代码作为参考实现。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
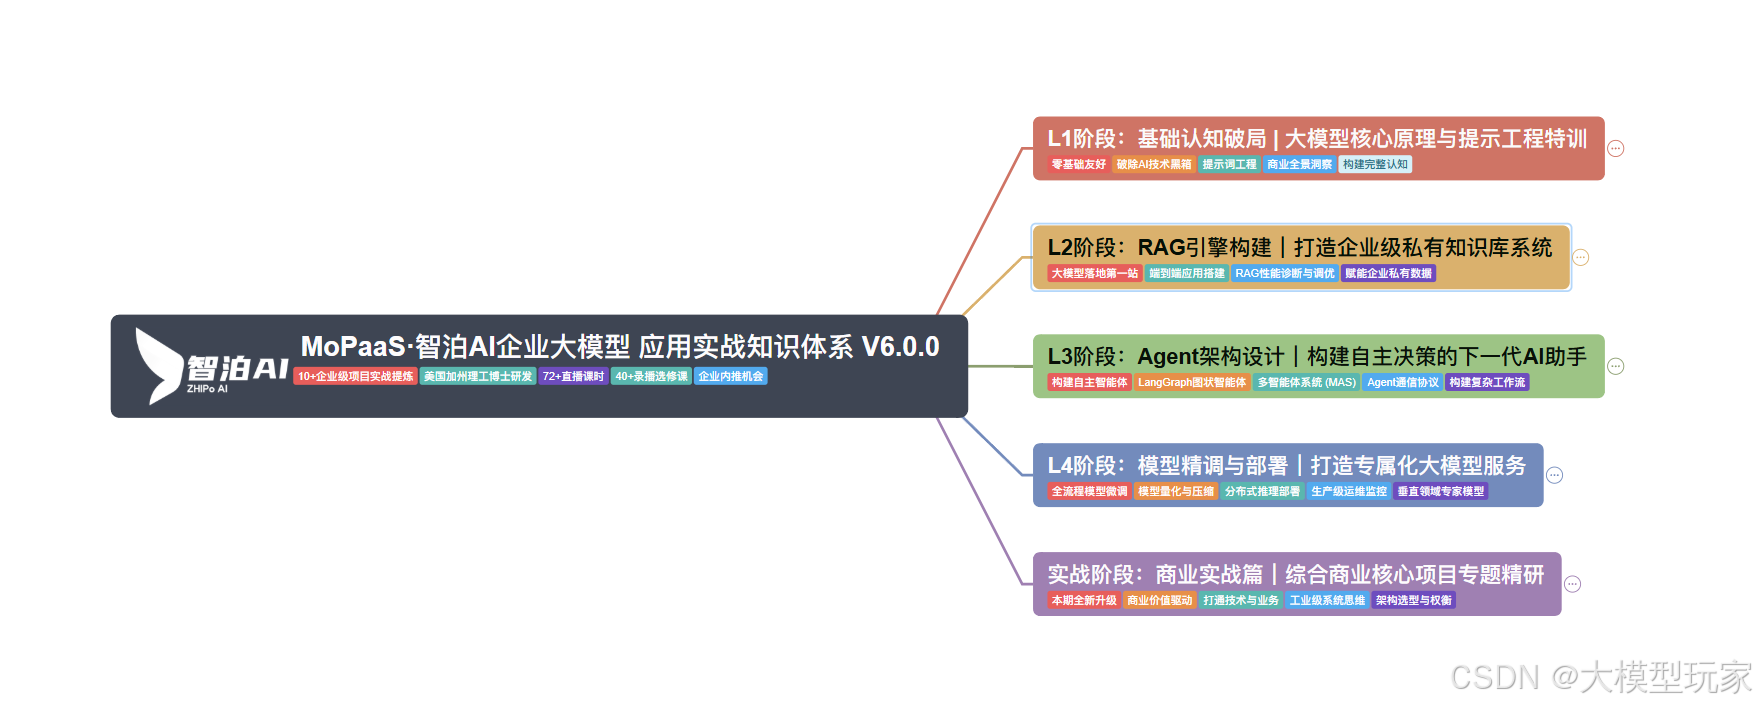
-
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)

07 deepseek部署包+技巧大全

由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


